학습 목표
- 이중 포인터(포인터의 포인터)가 왜 필요한지 설명하고, 함수가 호출자의 포인터를 바꾸게 만들 수 있다
int *a[5],int (*p)[5],int (*f)(int, int)같은 복잡한 선언을 오른쪽-왼쪽 규칙으로 읽을 수 있다- 함수 포인터로 “동작”을 값처럼 넘기고(콜백),
qsort에 비교 함수를 줄 수 있다 - 프로그램의 메모리 영역(코드·데이터·BSS·힙·스택)을 실제 주소로 확인할 수 있다
malloc,calloc,realloc,free의 인자와 반환값을 하나씩 설명하고, 실패했을 때 어떻게 되는지 안다- 메모리 누수, 이중 해제, 해제 후 사용, 범위 초과, 초기화 안 된 읽기를 직접 저질러 보고, Valgrind 로 잡아낸 출력을 한 줄씩 읽을 수 있다
들어가며
6주차에서 포인터의 기본을 배웠습니다. & 로 주소를 얻고, * 로 그 주소를 찾아가고, 함수에 주소를 넘겨서 원본 변수를 바꾸는 법(참조 전달)까지요. 그런데 포인터를 조금만 더 쓰다 보면 곧 이런 벽을 만납니다.
- 함수가 호출자의 포인터 를 바꾸려면? 6주차의
swap은int변수를 바꿨습니다. 그럼 함수가 메모리를 새로 받아서 호출자의 포인터가 그곳을 가리키게 하려면 무엇을 넘겨야 할까요? - “동작”을 값처럼 넘길 수 있을까? 정렬 함수에게 “크기 비교는 이 방법으로 해”라고 알려 주려면, 함수 자체를 인자로 넘길 수 있어야 합니다.
- 크기를 실행 중에야 아는 배열은?
int arr[100];은 컴파일할 때 크기를 못 박아야 합니다. 사용자가 몇 개를 입력할지 모른다면요?
이번 주는 이 세 질문에 차례로 답합니다. 답은 각각 이중 포인터, 함수 포인터, 동적 메모리 할당입니다. 그리고 세 번째 답을 얻는 순간, C 프로그래머가 평생 짊어지는 책임도 함께 받게 됩니다. “빌린 메모리는 반드시, 정확히 한 번 돌려준다.” 이 책임을 어겼을 때 무슨 일이 일어나는지 이번 주에 일부러 어겨 보고, 1주차에 설치해 둔 Valgrind 로 잡아내 보겠습니다.
예제 준비
이번 주 예제는 저장소의 week07 폴더에 있습니다. 5주차에 배운 make 로 한 번에 빌드합니다.
$ cd week07
$ make
컴파일: examples/calloc_realloc.c
...
✓ 모든 파일 빌드 완료!
$ ls build
calloc_realloc  double_pointer  dynamic_2d_array  dynamic_array  ...
실행 파일은 build/ 폴더에 모입니다. 이 글의 짧은 실험 코드들은 저장소에 따로 없으니, 1주차처럼 파일로 저장해서 직접 컴파일해 보세요. 컴파일 명령은 늘 같습니다.
$ gcc -Wall -Wextra -std=c11 -g 파일이름.c -o 파일이름
주소는 실행할 때마다 다릅니다. 이 글에는 실제로 실행해서 얻은 주소(
0x7ffef6ce591c같은)가 많이 나옵니다. 여러분이 실행하면 다른 숫자가 나오는 게 정상입니다. 리눅스는 보안을 위해 프로그램을 실행할 때마다 메모리 배치를 무작위로 바꿉니다(1주차 7절의pie, 24주차에서 자세히). 숫자 자체보다 주소 사이의 차이와 관계에 주목하세요.
1. 이중 포인터 (Double Pointer)
1.1 문제부터: 함수가 포인터를 바꾸지 못한다
6주차에서 배운 원칙 하나를 떠올려 봅시다. C의 함수 인자는 항상 “값이 복사되어” 넘어갑니다. int 를 넘기면 정수가 복사되고, int * 를 넘기면 주소 값이 복사됩니다. 그래서 함수 안에서 *p = 10; 으로 가리키는 곳은 바꿀 수 있지만, p = 다른주소; 로 포인터 자체를 바꾸면 복사본만 바뀝니다.
이게 실제로 어떤 사고를 부르는지 봅시다. 함수 안에서 메모리를 할당해서(3절에서 배울 malloc), 호출자의 포인터가 그곳을 가리키게 하고 싶습니다. examples/pointer_to_pointer.c 의 “잘못된 방법”입니다.
// 잘못된 방법: 포인터 값 전달
void allocate_wrong(int *ptr) {
    ptr = (int *)malloc(sizeof(int));
    if (ptr) {
        *ptr = 42;
        printf("  함수 내부: ptr = %p, *ptr = %d\n", (void *)ptr, *ptr);
    }
    // ptr은 지역 변수, 함수 종료 후 손실됨
    // 게다가 메모리 누수 발생!
}
main 에서 int *ptr1 = NULL; 을 만들고 allocate_wrong(ptr1); 을 부르면 이렇게 됩니다.
$ ./build/pointer_to_pointer
...
=== 잘못된 방법 (포인터 값 전달) ===
호출 전: ptr1 = (nil)
  함수 내부: ptr = 0x6273ceb7e2b0, *ptr = 42
호출 후: ptr1 = (nil) (여전히 NULL!)
(nil) 은 printf 의 %p 가 NULL 포인터를 찍는 방식입니다. 함수 안에서는 분명 0x6273ceb7e2b0 을 받았는데, 함수가 끝나자 ptr1 은 여전히 NULL 입니다. 무슨 일이 일어났는지 그림으로 그려 보면 이렇습니다.
 main 의 ptr1           allocate_wrong 의 ptr        힙
┌──────────────┐       ┌──────────────┐        ┌─────────┐
│    NULL      │  복사  │    NULL      │        │         │
└──────────────┘ ────▶ └──────────────┘        └─────────┘
                           │ ptr = malloc(...)
                           ▼
┌──────────────┐       ┌──────────────┐        ┌─────────┐
│    NULL      │       │ 0x...e2b0    │──────▶ │   42    │
└──────────────┘       └──────────────┘        └─────────┘
                           │ 함수 끝: ptr 사라짐
                           ▼
┌──────────────┐                               ┌─────────┐
│    NULL      │     (아무도 가리키지 않음)      │   42    │ ← 새어 나간 4바이트
└──────────────┘                               └─────────┘
더 나쁜 것은 마지막 줄입니다. 할당한 4바이트를 가리키던 유일한 변수 ptr 이 사라졌으니, 이 메모리는 아무도 돌려줄 수 없는 상태가 됐습니다. 이것을 메모리 누수(memory leak) 라고 합니다. 4절에서 Valgrind 로 이 4바이트를 정확히 잡아낼 겁니다.
해결책은 6주차의 swap 과 같은 발상입니다. 바꾸고 싶은 것의 주소를 넘긴다. 바꾸고 싶은 것이 int * 이니, 그 주소는 int ** 입니다. 이것이 이중 포인터입니다.
1.2 이중 포인터란?
이중 포인터는 포인터 변수의 주소를 담는 포인터입니다. 새로운 개념이 아닙니다. 포인터 변수도 메모리 어딘가에 사는 변수이니 당연히 주소가 있고, 그 주소를 담는 변수를 만든 것뿐입니다.
int x = 10;
int *p = &x;      // p 는 x 를 가리킴
int **pp = &p;    // pp 는 p 를 가리킴
examples/double_pointer.c 를 실행하면 세 변수의 값과 주소를 표로 보여 줍니다.
$ ./build/double_pointer
...
변수  │      값        │       주소
──────┼────────────────┼───────────────────
  x   │             10 │ 0x7ffef6ce591c
  p   │ 0x7ffef6ce591c │ 0x7ffef6ce5938
  pp  │ 0x7ffef6ce5938 │ 0x7ffef6ce5940
이 실제 숫자로 메모리 그림을 그려 봅시다.
   pp                         p                          x
┌──────────────────┐     ┌──────────────────┐     ┌──────────┐
│ 0x7ffef6ce5938   │────▶│ 0x7ffef6ce591c   │────▶│    10    │
└──────────────────┘     └──────────────────┘     └──────────┘
 주소 0x7ffef6ce5940       주소 0x7ffef6ce5938       주소 0x7ffef6ce591c
 (8바이트)                 (8바이트)                 (4바이트)
표를 대각선으로 읽어 보세요. x 의 주소가 p 의 값이고, p 의 주소가 pp 의 값입니다. 사슬처럼 이어져 있죠.
크기도 봅시다. 64비트 리눅스에서 모든 포인터는 8바이트입니다. int * 든 int ** 든 char * 든 주소 하나를 담는 것은 같기 때문입니다. 반면 x 는 int 라서 4바이트입니다. p 와 pp 의 주소 차이가 정확히 8(0x...5940 - 0x...5938)인 것도 p 가 8바이트 변수이기 때문입니다.
1.3 * 를 하나씩 벗겨 읽기
**pp 처럼 * 가 여러 개 붙으면 헷갈립니다. 요령은 * 하나에 화살표 하나입니다. 위 그림에서 * 를 하나 붙일 때마다 오른쪽으로 한 칸 이동한다고 생각하세요.
| 식 | 타입 | 뜻 | 실제 값 |
|---|---|---|---|
pp |
int ** |
pp 에 담긴 값 = p 의 주소 | 0x7ffef6ce5938 |
*pp |
int * |
화살표 한 번 = p 의 값 = x 의 주소 | 0x7ffef6ce591c |
**pp |
int |
화살표 두 번 = x 의 값 | 10 |
&pp |
int *** |
pp 자신의 주소 | 0x7ffef6ce5940 |
* 를 하나 붙일 때마다 타입에서 * 가 하나씩 빠진다는 것도 보세요. int ** 에 * 를 붙이면 int *, 한 번 더 붙이면 int 입니다. 반대로 & 를 붙이면 * 가 하나 늘어납니다. 타입의 * 개수를 세는 습관은 포인터 오류를 잡는 가장 확실한 방법입니다.
프로그램 출력에서도 확인할 수 있습니다.
=== 값 접근 방법 ===
x    = 10
*p   = 10 (p가 가리키는 값)
**pp = 10 (pp가 가리키는 포인터가 가리키는 값)

=== 주소 관계 ===
&x   = 0x7ffef6ce591c
p    = 0x7ffef6ce591c (같음)
*pp  = 0x7ffef6ce591c (같음)

&p   = 0x7ffef6ce5938
pp   = 0x7ffef6ce5938 (같음)
1.4 이중 포인터로 할 수 있는 두 가지
이중 포인터 pp 하나로 두 단계의 대상을 모두 바꿀 수 있습니다.
① **pp = ... : 맨 끝의 값(x)을 바꾼다
=== 이중 포인터로 값 수정 ===
수정 전: x = 10
**pp = 100; 실행 후
수정 후: x = 100
화살표를 두 번 따라가서 x 에 100 을 썼습니다. *p = 100; 과 같은 효과입니다.
② *pp = ... : 가운데 포인터(p)가 가리키는 곳을 바꾼다
=== 이중 포인터로 포인터 재지정 ===
y = 200 (주소: 0x7ffef6ce5920)
수정 전: p가 가리키는 값 = 100
*pp = &y; 실행 후
수정 후: p가 가리키는 값 = 200
p = 0x7ffef6ce5920 (y의 주소와 같음)
이번에는 화살표를 한 번만 따라가서 p 자체에 y 의 주소를 썼습니다. p 가 이제 y 를 가리킵니다. 1.1절의 문제를 푸는 열쇠가 바로 이 ②번입니다. 함수가 int ** 를 받으면, *ptr = ... 으로 호출자의 포인터 변수를 바꿀 수 있습니다.
1.5 함수가 호출자의 포인터를 바꾸기
이제 1.1절의 함수를 제대로 고쳐 봅시다.
#include <stdio.h>
#include <stdlib.h>

// 포인터 자체를 수정해야 할 때
void allocate_memory(int **ptr, int size) {
    *ptr = malloc(size * sizeof(int));     // 호출자의 포인터에 새 주소를 쓴다
    if (*ptr != NULL) {
        for (int i = 0; i < size; i++) {
            (*ptr)[i] = i * 10;
        }
    }
}

int main(void) {
    int *arr = NULL;

    allocate_memory(&arr, 5);  // arr 의 "주소"를 넘긴다

    if (arr != NULL) {
        for (int i = 0; i < 5; i++) {
            printf("%d ", arr[i]);  // 0 10 20 30 40
        }
        printf("\n");
        free(arr);
    }

    return 0;
}
한 줄씩 짚어 봅시다.
allocate_memory(&arr, 5);:arr은int *이고,&arr은int **입니다. 1.3절의 규칙대로&가*를 하나 늘렸습니다.*ptr = malloc(...);:ptr은main의arr을 가리키므로,*ptr은arr그 자체입니다. 여기에 새 주소를 쓰면main의arr이 바뀝니다.(*ptr)[i]: 괄호가 꼭 필요합니다.[]가*보다 먼저 계산되기 때문에,*ptr[i]라고 쓰면*(ptr[i]), 즉 “ptr을 배열로 보고i번째 칸을 역참조”가 됩니다. 우리가 원하는 것은 “*ptr(= arr) 의i번째 칸”이므로(*ptr)[i]입니다.
examples/pointer_to_pointer.c 의 “올바른 방법”이 이 구조입니다.
=== 올바른 방법 (이중 포인터) ===
호출 전: ptr2 = (nil)
  함수 내부: *ptr = 0x6273ceb7e2d0, **ptr = 42
호출 후: ptr2 = 0x6273ceb7e2d0, *ptr2 = 42
이번에는 함수가 끝난 뒤에도 ptr2 가 새 주소를 들고 있습니다.
실험:
(*ptr)[i]의 괄호를 빼고*ptr[i] = i * 10;으로 고쳐서 컴파일해 보세요.$ gcc -Wall -Wextra -std=c11 -g noparen.c -o noparen $ ./noparen 세그멘테이션 오류 (코어 덤프됨) $ echo $? 139컴파일은 경고 하나 없이 됩니다. 타입이 우연히 맞기 때문입니다(
ptr[i]는int *, 거기에*를 붙이면int). 그런데 실행하면 죽습니다.*ptr[i]는*(ptr[i]), 즉 “ptr을 포인터 배열로 보고i번째 칸의 주소를 따라가라”는 뜻입니다.i가 0 일 때는ptr[0]이 곧arr이라 우연히 맞지만,i가 1 이 되면main의arr옆 메모리를 주소로 믿고 따라가다가 엉뚱한 곳에 쓰려 해서 운영체제가 프로그램을 멈춰 세웁니다. 세그멘테이션 오류(segmentation fault) 는 “접근이 허락되지 않은 메모리를 건드렸다”는 뜻이고, 종료 코드 139 는 “신호 11번(SIGSEGV)으로 죽었다”(128 + 11)는 표시입니다. 컴파일러가 잡아 주지 못하는 포인터 실수의 전형이고, 4절의 Valgrind 가 이런 것을 잡습니다.다른 해법: 반환값으로 돌려주기. 포인터 하나만 돌려주면 된다면
int *allocate_memory(int size)처럼 반환값으로 새 주소를 돌려주는 것이 더 간단합니다.malloc자신도 그렇게 합니다. 이중 포인터가 꼭 필요한 것은 반환값을 이미 다른 용도(성공/실패 코드)로 쓰고 있거나, 포인터를 여러 개 바꿔야 할 때입니다. 5절의 연결 리스트append(Node **head, ...)가 그런 예입니다.
1.6 이미 써 본 이중 포인터: argv
사실 이중 포인터는 처음 보는 게 아닙니다. main 이 명령줄 인자를 받는 모양을 떠올려 보세요.
int main(int argc, char **argv)
argv 가 char ** 입니다. 문자열 하나는 char *(첫 글자의 주소)이고, 문자열 여러 개의 목록은 char * 들의 배열이니, 그 배열의 첫 칸 주소는 char ** 입니다. 직접 찍어 봅시다. args.c:
#include <stdio.h>

int main(int argc, char **argv) {
    printf("argc = %d\n", argc);
    for (int i = 0; i < argc; i++) {
        printf("argv[%d] = %s\n", i, argv[i]);
    }
    printf("argv[%d] = %p\n", argc, (void *)argv[argc]);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 args.c -o args
$ ./args hello "two words" 3
argc = 4
argv[0] = ./args
argv[1] = hello
argv[2] = two words
argv[3] = 3
argv[4] = (nil)
세 가지를 확인할 수 있습니다.
argv[0]은 프로그램 자신의 이름입니다. 그래서 인자를 3개 줬는데argc는 4 입니다.- 쉘은 띄어쓰기로 인자를 나누지만, 따옴표로 감싼
"two words"는 하나로 넘깁니다(1주차 2절의 “띄어쓰기가 구분자”가 여기서 다시 나옵니다). argv[argc]는 항상 NULL 입니다. C 표준이 보장합니다. 그래서argc없이for (char **a = argv; *a != NULL; a++)처럼 NULL 이 나올 때까지 도는 방법도 쓸 수 있습니다. 문자열이\0으로 끝나듯(1주차), 포인터 목록은 NULL 로 끝을 표시하는 관례입니다.
그리고 3 도 문자열 "3" 으로 들어왔다는 점을 기억해 두세요. 숫자로 쓰려면 변환해야 합니다(atoi, strtol).
1.7 복잡한 선언을 읽는 법: 오른쪽-왼쪽 규칙
이번 주에는 int *a[5], int (*p)[5], int (*f)(int, int) 처럼 괄호와 * 가 뒤섞인 선언이 쏟아집니다. 외우려고 하면 끝이 없습니다. 대신 읽는 규칙 하나만 익히면 됩니다.
오른쪽-왼쪽 규칙 (right-left rule) 1. 이름에서 시작한다. 2. 오른쪽을 본다.
[N]이면 “N칸짜리 배열”,(...)이면 “함수(인자는 …)”. 괄호)를 만나거나 끝나면 멈춘다. 3. 왼쪽을 본다.*이면 “포인터”. 괄호(를 만나면 괄호 밖으로 나가 다시 2번부터. 4. 마지막에 맨 왼쪽의 타입(int등)을 붙인다.
규칙의 핵심은 [] 와 () 가 * 보다 먼저 붙는다는 것입니다. 그래서 오른쪽을 먼저 보고, 괄호로 순서를 바꾼 것만 예외입니다. 예제로 연습해 봅시다.
| 선언 | 읽는 순서 | 뜻 |
|---|---|---|
int *p |
p → (왼쪽) * → int |
p 는 int 를 가리키는 포인터 |
int **pp |
pp → * → * → int |
pp 는 int 를 가리키는 포인터를 가리키는 포인터 |
int a[5] |
a → (오른쪽) [5] → int |
a 는 int 5개짜리 배열 |
int *a[5] |
a → (오른쪽) [5] → (왼쪽) * → int |
a 는 “int 를 가리키는 포인터” 5개짜리 배열 |
int (*p)[5] |
p → (오른쪽은 ) 라 멈춤) 왼쪽 * → 괄호 밖 오른쪽 [5] → int |
p 는 “int 5개짜리 배열”을 가리키는 포인터 |
int f(int) |
f → (오른쪽) (int) → int |
f 는 int 를 받아 int 를 돌려주는 함수 |
int *f(int) |
f → (int) → * → int |
f 는 int 를 받아 “int 를 가리키는 포인터”를 돌려주는 함수 |
int (*f)(int) |
f → * → 괄호 밖 (int) → int |
f 는 “int 를 받아 int 를 돌려주는 함수”를 가리키는 포인터 |
char **argv |
argv → * → * → char |
argv 는 char 포인터를 가리키는 포인터 |
int *a[5] 와 int (*p)[5] 의 차이, int *f(int) 와 int (*f)(int) 의 차이가 전부 괄호 하나에서 나옵니다. 괄호가 없으면 오른쪽의 [] 나 () 가 먼저 붙고, 괄호로 * 를 이름에 먼저 붙이면 “포인터”가 먼저 됩니다.
1.8 포인터 배열 vs 배열 포인터
규칙을 연습했으니, 이름이 비슷해서 가장 많이 헷갈리는 두 가지를 실제로 비교해 봅시다.
int *arr_of_ptr[5];    // 포인터 배열: 포인터 5개가 든 배열
int (*ptr_to_arr)[5];  // 배열 포인터: "int 5개짜리 배열" 하나를 가리키는 포인터
한국어 이름은 뒤쪽 단어가 정체입니다. “포인터 배열“은 배열이고, “배열 포인터“는 포인터입니다. 말로만 들으면 와닿지 않으니 sizeof 로 크기를 재 보고, + 1 을 했을 때 주소가 얼마나 움직이는지 봅시다. decl.c:
#include <stdio.h>

int main(void) {
    int matrix[3][5] = {{0}};
    int *arr_of_ptr[5];
    int (*ptr_to_arr)[5] = matrix;

    printf("sizeof(arr_of_ptr) = %zu\n", sizeof(arr_of_ptr));
    printf("sizeof(ptr_to_arr) = %zu\n", sizeof(ptr_to_arr));
    printf("sizeof(*ptr_to_arr) = %zu\n", sizeof(*ptr_to_arr));
    printf("\n");
    printf("arr_of_ptr     = %p\n", (void *)arr_of_ptr);
    printf("arr_of_ptr + 1 = %p\n", (void *)(arr_of_ptr + 1));
    printf("ptr_to_arr     = %p\n", (void *)ptr_to_arr);
    printf("ptr_to_arr + 1 = %p\n", (void *)(ptr_to_arr + 1));
    printf("&matrix[1][0]  = %p\n", (void *)&matrix[1][0]);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 decl.c -o decl && ./decl
sizeof(arr_of_ptr) = 40
sizeof(ptr_to_arr) = 8
sizeof(*ptr_to_arr) = 20

arr_of_ptr     = 0x7ffe50a3c7d0
arr_of_ptr + 1 = 0x7ffe50a3c7d8
ptr_to_arr     = 0x7ffe50a3c800
ptr_to_arr + 1 = 0x7ffe50a3c814
&matrix[1][0]  = 0x7ffe50a3c814
숫자 하나하나가 정의를 그대로 증명합니다.
| 결과 | 왜 |
|---|---|
sizeof(arr_of_ptr) = 40 |
포인터(8바이트) 5개가 든 배열이니 8 × 5 = 40 |
sizeof(ptr_to_arr) = 8 |
무엇을 가리키든 포인터 하나는 8바이트 |
sizeof(*ptr_to_arr) = 20 |
가리키는 대상이 “int 5개짜리 배열”이니 4 × 5 = 20 |
arr_of_ptr + 1 이 8 증가 (7d0 → 7d8) |
배열 원소 하나(포인터 하나)가 8바이트 |
ptr_to_arr + 1 이 20(16진수 0x14) 증가 (800 → 814) |
가리키는 대상(int 5개짜리 배열) 하나가 20바이트 |
ptr_to_arr + 1 == &matrix[1][0] |
한 칸 가면 2차원 배열의 다음 행이 나온다 |
6주차에서 “포인터에 1을 더하면 가리키는 타입의 크기만큼 주소가 움직인다”고 배웠습니다. 배열 포인터는 “5칸짜리 행 하나”를 가리키니, 1을 더하면 한 행을 통째로 건너뜁니다. 그림으로 보면 이렇습니다.
matrix[3][5] (int 15개, 60바이트가 한 줄로 이어져 있음)

 0x...800                  0x...814                  0x...828
 ├── 행 0 (20바이트) ──────┼── 행 1 (20바이트) ──────┼── 행 2 ───────┤
 │ [0][0] [0][1] ... [0][4]│ [1][0] [1][1] ... [1][4]│ [2][0] ...    │
 ▲                         ▲                         ▲
 ptr_to_arr               ptr_to_arr + 1            ptr_to_arr + 2
그래서 배열 포인터는 2차원 배열을 함수에 넘길 때 쓰입니다. 2차원 배열 matrix 의 이름은 “첫 행의 주소”로 바뀌는데(6주차의 배열 이름 붕괴), 첫 행의 타입이 int[5] 이므로 그 주소는 int (*)[5] 입니다.
void print_matrix(int (*m)[5], int rows) {   // int m[][5] 라고 써도 같은 뜻
    for (int i = 0; i < rows; i++) {
        for (int j = 0; j < 5; j++) {
            printf("%3d", m[i][j]);          // m[i] 는 i 번째 행
        }
        printf("\n");
    }
}
반면 포인터 배열은 “포인터를 여러 개 모아 둔 것”이라, 각 칸이 서로 떨어진 곳을 가리킬 수 있습니다. argv 가 대표적이고, 길이가 제각각인 문자열 목록에 씁니다.
const char *names[] = {"C", "Python", "JavaScript"}; // 포인터 3개짜리 배열
 names (포인터 배열, 24바이트)
┌───────────┬───────────┬───────────┐
│  주소 ────┼──▶ "C"    │           │
│           │  주소 ────┼──▶ "Python"
│           │           │  주소 ────┼──▶ "JavaScript"
└───────────┴───────────┴───────────┘
2차원 char 배열(char names[3][11])로 만들면 가장 긴 이름에 맞춰 모든 행이 11바이트씩 차지하지만, 포인터 배열은 각 문자열이 딱 자기 길이만큼만 차지합니다.
실험:
decl.c에printf("%zu\n", sizeof(matrix));와printf("%zu\n", sizeof(matrix[0]));를 추가해서 60과 20이 나오는지 확인해 보세요. 그리고int (*ptr_to_arr)[5] = matrix;를int (*ptr_to_arr)[4] = matrix;로 바꿔서 컴파일해 보세요.initialization of ‘int (*)[4]’ from incompatible pointer type ‘int (*)[5]’경고가 나옵니다. 컴파일러는 행의 길이까지 타입으로 따집니다.
2. 함수 포인터 (Function Pointer)
지금까지 함수는 코드에 이름을 적어서 부르는, 고정된 대상이었습니다. qsort 로 정렬한다고 생각해 봅시다. 정수를 오름차순으로 정렬할 수도 있고, 내림차순으로 할 수도 있고, 학생 구조체를 점수 순으로 할 수도 있습니다. 정렬 알고리즘은 똑같고 “둘 중 무엇이 앞인가”를 판단하는 방법만 다릅니다. 그렇다면 정렬 함수에게 그 판단 방법을 함수 째로 넘겨줄 수 있다면 좋겠죠. 이것을 가능하게 하는 것이 함수 포인터입니다.
2.1 함수에도 주소가 있다
1주차 7절에서 컴파일된 프로그램을 objdump 로 들여다봤습니다. main 이 0x1149 번지에 있었죠. 함수도 결국 메모리의 코드 영역에 놓인 기계어 바이트들이니, 시작 주소가 있습니다. 확인해 봅시다. fpaddr.c:
#include <stdio.h>

int add(int a, int b) { return a + b; }

int main(void) {
    int (*fp)(int, int) = add;
    printf("add  = %p\n", (void *)add);
    printf("&add = %p\n", (void *)&add);
    printf("fp   = %p\n", (void *)fp);
    printf("fp(3, 5) = %d, (*fp)(3, 5) = %d\n", fp(3, 5), (*fp)(3, 5));
    printf("sizeof(fp) = %zu\n", sizeof(fp));
    return 0;
}
주소를 nm 과 비교하기 쉽도록 이번 한 번만 -no-pie 옵션으로 컴파일합니다. 실행할 때마다 주소가 바뀌지 않게 하는 옵션입니다.
$ gcc -Wall -Wextra -std=c11 -g -no-pie fpaddr.c -o fpaddr && ./fpaddr
add  = 0x401136
&add = 0x401136
fp   = 0x401136
fp(3, 5) = 8, (*fp)(3, 5) = 8
sizeof(fp) = 8
$ nm fpaddr | grep -w add
0000000000401136 T add
add,&add,fp가 모두0x401136이고,nm이 알려 준add의 위치(T, 코드 영역)와 정확히 같습니다. 함수 포인터에 담기는 것은 함수 기계어의 시작 주소입니다.- 함수 이름
add만 써도 주소로 바뀝니다. 배열 이름이 첫 원소의 주소로 바뀌는 것(6주차)과 같은 규칙이라,fp = add;와fp = &add;는 똑같습니다. - 부를 때도
fp(3, 5)와(*fp)(3, 5)가 같습니다. 이 강좌에서는 짧은fp(3, 5)를 씁니다. - 함수 포인터도 64비트에서 8바이트입니다.
(void *)로 바꿔 찍는 것에 대해:%p는void *를 받으므로 함수 포인터를(void *)로 바꿔서 찍었습니다. 리눅스에서는 잘 동작하지만, 엄밀히 말하면 C 표준은 함수 포인터와 데이터 포인터 사이의 변환을 보장하지 않습니다.-Wpedantic을 켜면ISO C forbids conversion of function pointer to object pointer type경고가 나옵니다. 주소를 눈으로 확인하는 실험에서만 쓰고, 실제 코드에서는 함수 포인터를 데이터 포인터로 바꾸지 마세요.
2.2 함수 포인터 선언 읽기
1.7절의 규칙으로 읽으면 어렵지 않습니다.
int (*fp)(int, int);
fp 에서 시작 → 오른쪽은 ) 라 멈춤 → 왼쪽 * : “포인터” → 괄호 밖 오른쪽 (int, int) : “int 두 개를 받는 함수” → 맨 왼쪽 int : “int 를 돌려주는”. 즉 “int 두 개를 받아 int 를 돌려주는 함수”를 가리키는 포인터입니다.
선언을 만드는 요령도 있습니다. 함수 선언을 복사하고, 이름을 (*이름) 으로 바꾸면 끝입니다.
int add(int a, int b);          // 함수 선언
int (*fp)(int a, int b);        // 이름을 (*fp) 로 → 함수 포인터
int (*fp)(int, int);            // 매개변수 이름은 생략 가능
괄호를 빼먹으면 전혀 다른 것이 됩니다.
int *fp(int, int); // 괄호 없음!
1.7절 표에서 봤듯, 이것은 “int 두 개를 받아 int * 를 돌려주는 함수” fp 의 선언입니다. 포인터 변수가 아니라 함수가 하나 선언된 것이라, fp = add; 를 하면 컴파일 오류가 납니다.
몇 가지 모양을 더 연습해 봅시다.
| 선언 | 가리킬 수 있는 함수 |
|---|---|
int (*fp1)(int, int); |
int add(int, int) 처럼 int 2개 → int |
void (*fp2)(const char *); |
void greet(const char *) 처럼 문자열 → 반환 없음 |
double (*fp3)(double); |
double sqrt(double) 처럼 double → double |
int (*fp4)(void); |
int getchar(void) 처럼 인자 없음 → int |
examples/func_pointer_basic.c 가 이 모양들을 실제로 만들어 부릅니다.
$ ./build/func_pointer_basic
...
=== 다른 함수로 변경 ===
10 + 5 = 15 (add)
10 - 5 = 5 (subtract)
10 * 5 = 50 (multiply)
10 / 5 = 2 (divide)

=== 다양한 함수 포인터 형태 ===
void (*greet_ptr)(const char *);
안녕하세요, 홍길동님!

double (*pi_ptr)(void);
pi_ptr() = 3.14159
같은 포인터 변수 operation 에 add, subtract, multiply, divide 를 차례로 넣어 가며 부릅니다. 호출하는 코드는 operation(10, 5) 한 줄인데 결과가 매번 다릅니다. 이게 함수 포인터의 힘입니다. “무엇을 할지”가 코드가 아니라 변수의 값이 된 것입니다.
2.3 타입이 맞아야 한다
함수 포인터에는 반환 타입과 매개변수 타입이 정확히 같은 함수만 넣어야 합니다. 다른 것을 넣으면 어떻게 될까요? fpwrong.c:
#include <stdio.h>

int add(int a, int b) { return a + b; }
double half(double x) { return x / 2; }

int main(void) {
    int (*op)(int, int) = half;   /* 타입이 다른 함수 */
    printf("%d\n", op(10, 4));
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g fpwrong.c -o fpwrong
fpwrong.c: In function ‘main’:
fpwrong.c:7:27: warning: initialization of ‘int (*)(int,  int)’ from incompatible pointer type ‘double (*)(double)’ [-Wincompatible-pointer-types]
    7 |     int (*op)(int, int) = half;   /* 타입이 다른 함수 */
      |                           ^~~~
$ ./fpwrong
-118283935
GCC가 두 타입을 나란히 보여 주며 경고합니다. int (*)(int, int) 자리에 double (*)(double) 을 넣으려 한다고요. 경고를 무시하고 실행하면 엉터리 값이 나옵니다. 다시 실행하면 또 다른 엉터리 값이 나올 수 있습니다. op(10, 4) 는 “정수 두 개를 넘기고 정수 하나를 받는” 방식으로 불렀는데, half 는 “실수 하나를 받고 실수 하나를 돌려주는” 방식으로 동작했기 때문입니다. 1주차 7절에서 본 호출 규약을 떠올리면, 정수와 실수는 서로 다른 레지스터로 주고받습니다. 부르는 쪽과 불리는 쪽이 서로 다른 칸을 보고 있으니 결과가 의미 없는 숫자가 된 것입니다.
경고 이름의 incompatible pointer type 은 앞으로도 자주 보게 됩니다. 포인터 타입이 안 맞는다는 경고는 거의 항상 진짜 버그입니다.
2.4 typedef 로 이름 붙이기
함수 포인터 타입은 길어서, 여러 번 쓰면 코드가 읽기 어려워집니다. typedef 로 이름을 붙일 수 있습니다.
typedef int (*Operation)(int, int);
읽는 법: typedef 를 떼고 보면 int (*Operation)(int, int);, 즉 “Operation 이라는 함수 포인터 변수 선언”입니다. 앞에 typedef 를 붙이면 그 변수 이름이 타입 이름이 됩니다. 이제 Operation 은 “int 두 개를 받아 int 를 돌려주는 함수를 가리키는 포인터” 타입입니다.
Operation op1 = add;
Operation op2 = subtract;
printf("%d\n", op1(100, 30));   // 130
typedef 는 8주차 구조체에서 본격적으로 배웁니다. 지금은 “긴 타입에 짧은 별명을 붙이는 문법”이라고만 알아 두세요.
2.5 콜백: 동작을 인자로 넘기기
함수 포인터를 인자로 받아서, 필요한 순간에 불러 주는 패턴을 콜백(callback) 이라고 합니다. “나중에 다시 불러(call back) 줄게”라는 뜻입니다.
#include <stdio.h>

// 콜백 함수 타입: int 하나를 받고 아무것도 돌려주지 않는 함수
typedef void (*Callback)(int);

// 콜백을 받는 함수: 배열의 모든 원소에 cb 를 적용한다
void process_array(int *arr, int size, Callback cb) {
    for (int i = 0; i < size; i++) {
        cb(arr[i]);  // 넘겨받은 함수를 호출
    }
}

// 콜백으로 넘길 함수들
void print_item(int x) {
    printf("%d ", x);
}

void print_square(int x) {
    printf("%d ", x * x);
}

int main(void) {
    int arr[] = {1, 2, 3, 4, 5};

    printf("원본: ");
    process_array(arr, 5, print_item);
    printf("\n");

    printf("제곱: ");
    process_array(arr, 5, print_square);
    printf("\n");

    return 0;
}
원본: 1 2 3 4 5
제곱: 1 4 9 16 25
process_array 는 배열을 어떻게 순회할지만 알고, 각 원소로 무엇을 할지는 모릅니다. 그 부분을 호출하는 쪽이 print_item 이냐 print_square 냐로 정합니다. 반복 코드를 한 번만 쓰고, 동작만 갈아 끼우는 것입니다.
주의할 점은 process_array(arr, 5, print_item) 에서 print_item 뒤에 괄호가 없다는 것입니다. print_item() 이라고 쓰면 그 자리에서 함수를 불러 버리고 그 반환값을 넘기려는 것이 됩니다. 넘기는 것은 함수 자체(주소)이므로 이름만 씁니다.
examples/func_pointer_callback.c 는 이 발상을 넓혀서 filter(조건에 맞는 것만 고르기), map(각 원소를 변환), reduce(하나로 합치기)를 만듭니다.
$ ./build/func_pointer_callback
...
=== filter 콜백 ===
원본: -5 12 -3 45 8 -20 67 0 33
양수만: 12 45 8 67 33
짝수만: 12 8 -20 0
>50: 67

=== reduce 콜백 ===
배열: 1 2 3 4 5
합계: 15
곱: 120
최대값: 5
같은 filter 함수가 “양수인가?”, “짝수인가?”, “50보다 큰가?” 라는 판단 함수만 바꿔 끼워서 세 가지 결과를 냅니다. Python 이나 JavaScript 를 해 봤다면 익숙한 filter, map, reduce 가 C 에서는 이렇게 함수 포인터로 만들어집니다.
2.6 qsort: 표준 라이브러리의 콜백
C 표준 라이브러리에는 콜백을 받는 대표적인 함수가 있습니다. 정렬 함수 qsort 입니다. 1주차 3절에서 설치한 C 함수 설명서로 man 3 qsort 를 열면 자세한 설명이 나옵니다. 함수의 모양은 이렇습니다.
#include <stdlib.h>

void qsort(void *base, size_t nmemb, size_t size,
           int (*compar)(const void *, const void *));
마지막 인자를 1.7절 규칙으로 읽으면 “const void * 두 개를 받아 int 를 돌려주는 함수를 가리키는 포인터”입니다. 인자 네 개를 하나씩 봅시다.
| 인자 | 타입 | 뜻 |
|---|---|---|
base |
void * |
정렬할 배열의 시작 주소. void * 라서 어떤 타입의 배열이든 받습니다 |
nmemb |
size_t |
원소의 개수 (number of members) |
size |
size_t |
원소 하나의 크기(바이트). int 배열이면 sizeof(int) |
compar |
함수 포인터 | 두 원소의 주소를 받아 비교 결과를 돌려주는 함수 |
qsort 는 배열에 무엇이 들었는지 모릅니다. void * 로 받았으니 “몇 바이트짜리 덩어리가 몇 개”라는 것밖에 모릅니다. 그래서 크기(size)를 알려 줘야 덩어리를 옮길 수 있고, 비교 방법(compar)을 알려 줘야 순서를 정할 수 있습니다. 이것이 제네릭 프로그래밍의 C 식 해법이고, 10주차에서 void * 와 함께 qsort 의 원리를 더 깊이 들여다봅니다.
비교 함수는 약속을 지켜야 합니다.
| 돌려주는 값 | 뜻 |
|---|---|
| 음수 | 첫째(a)가 앞에 와야 한다 |
| 0 | 둘은 같다 |
| 양수 | 첫째(a)가 뒤에 와야 한다 |
정수 오름차순 비교 함수를 만들어 봅시다.
int compare_asc(const void *a, const void *b) {
    int x = *(const int *)a;
    int y = *(const int *)b;
    return (x > y) - (x < y);
}
const void *a는 “무엇인지 모르는 원소의 주소”입니다. 우리는 이 배열이int배열인 것을 알기 때문에(const int *)로 바꿔서 역참조합니다.(x > y) - (x < y)는 재미있는 식입니다. C 에서 비교 연산의 결과는 참이면 1, 거짓이면 0 입니다.x > y이면1 - 0 = 1,x < y이면0 - 1 = -1, 같으면0 - 0 = 0. 정확히 약속대로입니다.
실험: return x - y; 가 위험한 이유
인터넷의 많은 예제가 비교 함수를 이렇게 씁니다.
int cmp_sub(const void *a, const void *b) {
    return *(const int *)a - *(const int *)b;       /* 흔하지만 위험한 방법 */
}
짧고 그럴듯합니다. a 가 크면 양수, 작으면 음수가 나오니까요. 정말 괜찮은지, 극단적인 값으로 시험해 봅시다. cmp.c:
#include <limits.h>
#include <stdio.h>
#include <stdlib.h>

int cmp_sub(const void *a, const void *b) {
    return *(const int *)a - *(const int *)b;       /* 흔하지만 위험한 방법 */
}

int cmp_safe(const void *a, const void *b) {
    int x = *(const int *)a, y = *(const int *)b;
    return (x > y) - (x < y);
}

void show(const char *label, const int *arr, int n) {
    printf("%s:", label);
    for (int i = 0; i < n; i++) {
        printf(" %d", arr[i]);
    }
    printf("\n");
}

int main(void) {
    int a[] = {INT_MAX, -10, INT_MIN, 5};
    int b[] = {INT_MAX, -10, INT_MIN, 5};
    int n = 4;

    qsort(a, n, sizeof(int), cmp_sub);
    qsort(b, n, sizeof(int), cmp_safe);
    show("빼기 비교 ", a, n);
    show("안전 비교 ", b, n);
    printf("\nINT_MAX - (-10) = %d\n", cmp_sub(&(int){INT_MAX}, &(int){-10}));
    return 0;
}
INT_MAX, INT_MIN 은 <limits.h> 에 정의된 int 의 최댓값(2147483647)과 최솟값(-2147483648)입니다.
$ gcc -Wall -Wextra -std=c11 -g cmp.c -o cmp && ./cmp
빼기 비교 : 5 2147483647 -2147483648 -10
안전 비교 : -2147483648 -10 5 2147483647

INT_MAX - (-10) = -2147483639
빼기로 비교한 쪽은 정렬이 완전히 틀렸습니다. 마지막 줄이 이유를 보여 줍니다. INT_MAX - (-10) 은 수학적으로 2147483657 인데, 이것은 int 가 담을 수 있는 최댓값을 넘습니다. 넘친 값은 한 바퀴 돌아 음수가 되어 버렸고(정확히는 C 표준에서 정의되지 않은 동작입니다), 비교 함수는 “INT_MAX 가 -10 보다 작다”고 답했습니다. 2주차에서 본 정수 오버플로가 정렬을 망가뜨린 것입니다.
평소 다루는 작은 숫자로는 절대 드러나지 않다가, 어느 날 큰 값이 들어오면 조용히 틀린 결과를 냅니다. 이 강좌의 예제들이 (x > y) - (x < y) 를 쓰는 이유입니다.
실험: 내림차순 비교 함수
compare_desc를 만들어 보세요. 힌트는x와y의 자리를 바꾸는 것입니다.examples/func_pointer_callback.c의 “정렬 콜백” 결과(90 64 34 25 22 12 11)와 비교해 보세요.
2.7 함수 포인터 배열: 점프 테이블
함수 포인터도 변수이니 배열로 모을 수 있습니다.
#include <stdio.h>

int add(int a, int b) { return a + b; }
int sub(int a, int b) { return a - b; }
int mul(int a, int b) { return a * b; }
int divide(int a, int b) { return b != 0 ? a / b : 0; }

int main(void) {
    // 함수 포인터 배열
    int (*operations[])(int, int) = {add, sub, mul, divide};
    const char *names[] = {"+", "-", "*", "/"};

    int a = 20, b = 5;

    for (int i = 0; i < 4; i++) {
        printf("%d %s %d = %d\n", a, names[i], b, operations[i](a, b));
    }

    return 0;
}
20 + 5 = 25
20 - 5 = 15
20 * 5 = 100
20 / 5 = 4
선언 int (*operations[])(int, int) 을 규칙으로 읽어 봅시다. operations → 오른쪽 []: “배열” → 왼쪽 *: “포인터” → 괄호 밖 오른쪽 (int, int): “int 두 개를 받는 함수” → int. 즉 “int 두 개를 받아 int 를 돌려주는 함수를 가리키는 포인터”들의 배열입니다. [] 안이 비어 있는 것은 초기값 개수(4)로 크기를 정하라는 뜻입니다. typedef 를 쓰면 훨씬 읽기 쉽습니다.
typedef int (*Operation)(int, int);
Operation operations[] = {add, sub, mul, divide};
이런 배열을 점프 테이블(jump table) 이라고 부릅니다. 번호로 함수를 골라 부를 수 있으니, 메뉴 번호에 따라 기능을 실행하는 프로그램을 switch 없이 만들 수 있습니다. examples/func_pointer_array.c 가 이 방식의 계산기를 보여 줍니다.
$ ./build/func_pointer_array
...
데모: 15와 4의 모든 연산
  15 + 4 = 19
  15 - 4 = 11
  15 * 4 = 60
  15 / 4 = 3
  15 % 4 = 3
...
=== 동적 연산 선택 ===
계산 (우선순위 없이 왼쪽부터): 10 + 3 * 5 - 2 = 63
마지막 줄을 보세요. 수학에서 10 + 3 * 5 - 2 는 곱셈부터 해서 23 인데, 결과는 63 입니다. 이 코드는 연산자를 왼쪽부터 차례로 하나씩 적용하기 때문에 ((10 + 3) * 5) - 2 = 63 을 계산했습니다. 우선순위를 지키는 계산기를 만들려면 3주차의 연산자 우선순위를 코드로 구현해야 합니다. 함수 포인터는 “어떤 연산을 할지”만 골라 줄 뿐이라는 좋은 예입니다.
이 출력은 원래
계산: 10 + 3 * 5 - 2 = 63이라고 찍혀서, 우선순위를 무시했다는 사실이 드러나지 않았습니다. 이번에 출력 문구를 고쳤습니다.
2.8 함수 포인터를 돌려주는 함수
함수가 함수 포인터를 반환할 수도 있습니다. 연산자 문자를 받아 해당 함수를 돌려주는 함수를 만들어 봅시다.
typedef int (*Operation)(int, int);

Operation get_operation(char op) {
    switch (op) {
        case '+': return add;
        case '-': return sub;
        case '*': return mul;
        case '/': return divide;
        default:  return NULL;      // 모르는 연산자
    }
}

int main(void) {
    Operation op = get_operation('+');
    if (op != NULL) {
        printf("10 + 5 = %d\n", op(10, 5));
    }
    return 0;
}
typedef 가 없으면 이 함수의 선언은 이렇게 됩니다.
int (*get_operation(char op))(int, int);
규칙으로 읽어 봅시다. get_operation → 오른쪽 (char op): “char 를 받는 함수” → 오른쪽은 ) 라 멈추고 왼쪽 *: “포인터를 돌려주는” → 괄호 밖 오른쪽 (int, int): “int 두 개를 받는 함수” → int. 즉 “char 를 받아서, ‘int 두 개를 받아 int 를 돌려주는 함수’의 포인터를 돌려주는 함수” 입니다. 읽을 수는 있지만 쓰고 싶지는 않은 모양이죠. typedef 가 왜 필요한지 이 한 줄이 보여 줍니다.
default 에서 NULL 을 돌려주는 것도 중요합니다. 함수 포인터도 포인터라서 NULL 이 될 수 있고, NULL 함수 포인터를 부르면 프로그램이 죽습니다. 그래서 if (op != NULL) 로 확인한 뒤에 부릅니다.
3. 동적 메모리 할당
지금까지 쓴 int arr[100]; 같은 배열은 크기를 코드에 숫자로 적어야 했습니다. 그런데 프로그램을 짜다 보면 크기를 실행해 봐야 아는 경우가 대부분입니다. 파일에 몇 줄이 들었는지, 사용자가 학생을 몇 명 입력할지는 코드를 쓰는 시점에는 모릅니다. 넉넉하게 int arr[10000000]; (천만 개, 40MB)으로 잡으면 어떨까요? 대부분 낭비이고, 그래도 넘치는 날이 오며, 무엇보다 실행하자마자 죽습니다.
$ cat bigstack.c
#include <stdio.h>
int main(void){ int arr[10000000]; arr[0]=1; printf("%d\n", arr[0]); return 0; }
$ gcc -std=c11 bigstack.c -o bigstack && ./bigstack
세그멘테이션 오류 (코어 덤프됨)
$ ulimit -s
8192
지역 변수는 곧 보게 될 스택이라는 영역에 놓이는데, 리눅스의 기본 스택 크기는 ulimit -s 가 보여 주듯 8192KB, 즉 8MB 입니다. 40MB 배열은 들어갈 수 없어서 넘쳐 버린 것입니다.
동적 메모리 할당이 이 문제를 풉니다. 실행 중에 “지금 이만큼 필요하다”고 운영체제(정확히는 C 라이브러리)에게 빌리고, 다 쓰면 직접 돌려줍니다. 이 절에서는 빌리는 함수 셋(malloc, calloc, realloc)과 돌려주는 함수 하나(free)를 인자 하나, 반환값 하나까지 뜯어봅니다. 그 전에, 빌린 메모리가 어디에서 오는지부터 봅시다.
3.1 정적 할당 vs 동적 할당
| 구분 | 지역 변수·배열 | 전역·static 변수 |
동적 할당 |
|---|---|---|---|
| 예 | int arr[100]; (함수 안) |
int count; (함수 밖) |
malloc(100 * sizeof(int)) |
| 크기 결정 | 컴파일할 때 | 컴파일할 때 | 실행 중에 |
| 언제 생기나 | 함수에 들어갈 때 | 프로그램 시작할 때 | malloc 을 부를 때 |
| 언제 사라지나 | 함수가 끝날 때 (자동) | 프로그램 끝날 때 (자동) | free 를 부를 때 (수동) |
| 사는 곳 | 스택 | 데이터 / BSS | 힙 |
예전 표에는 지역 변수가 “컴파일할 때 할당된다”고 적혀 있었는데, 정확하지 않습니다. 지역 변수의 크기는 컴파일할 때 정해지지만, 실제 자리는 함수가 호출될 때마다 스택에 새로 잡히고 함수가 끝나면 없어집니다. 그래서 재귀 함수를 부를 때마다 지역 변수가 따로 생기는 것입니다(5주차).
동적 할당만 가진 성질이 표의 마지막 두 줄입니다. 크기를 실행 중에 정할 수 있고, 수명을 내가 정한다. 함수가 끝나도 사라지지 않으니, 함수 안에서 만든 데이터를 밖으로 돌려줄 수 있습니다(1.5절이 그것이었습니다). 대신 내가 free 하지 않으면 아무도 치워 주지 않습니다.
3.2 메모리 영역: 실제 주소로 확인하기
프로그램이 실행되면 운영체제는 프로그램에게 메모리 공간을 주고, 그 공간을 용도별 영역으로 나눠 씁니다. 교과서에 흔히 나오는 그림은 이렇습니다.
┌─────────────────────┐  높은 주소
│      Stack          │  ← 지역 변수, 함수 호출 정보. 아래로 자란다
├─────────────────────┤
│         ↓           │
│      (빈 공간)       │
│         ↑           │
├─────────────────────┤
│       Heap          │  ← malloc 이 주는 메모리. 위로 자란다
├─────────────────────┤
│   BSS               │  ← 0 으로 시작하는 전역/static 변수
├─────────────────────┤
│   Data              │  ← 초깃값이 있는 전역/static 변수
├─────────────────────┤
│   Text (코드)        │  ← 기계어 (함수들)
└─────────────────────┘  낮은 주소
그림만 보고 믿지 말고, 각 영역에 변수를 하나씩 두고 실제 주소를 찍어 봅시다. regions.c:
#include <stdio.h>
#include <stdlib.h>

int global_init = 42;      /* Data 영역 */
int global_zero;           /* BSS 영역 */

int main(void) {
    int local = 7;                        /* Stack */
    int *heap = malloc(sizeof(int));      /* Heap  */
    static int static_local = 1;          /* Data  */

    printf("코드  (main)         : %p\n", (void *)main);
    printf("Data  (global_init)  : %p\n", (void *)&global_init);
    printf("Data  (static_local) : %p\n", (void *)&static_local);
    printf("BSS   (global_zero)  : %p\n", (void *)&global_zero);
    printf("Heap  (malloc)       : %p\n", (void *)heap);
    printf("Stack (local)        : %p\n", (void *)&local);

    free(heap);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 regions.c -o regions && ./regions
코드  (main)         : 0x5609404f31a9
Data  (global_init)  : 0x5609404f6010
Data  (static_local) : 0x5609404f6014
BSS   (global_zero)  : 0x5609404f601c
Heap  (malloc)       : 0x56095e2e32a0
Stack (local)        : 0x7ffdde9f166c
아래에서 위로 읽어 보면 그림과 순서가 정확히 같습니다. 코드(...31a9) < Data(...6010) < BSS(...601c) < 힙(0x5609 5e2e...) < 스택(0x7ffd...). 몇 가지 눈여겨볼 점이 있습니다.
- 코드, Data, BSS 는 붙어 있습니다. 셋 다 실행 파일 안에 들어 있던 것을 메모리에 올린 것이기 때문입니다.
global_init(4바이트) 바로 뒤에static_local이 4바이트 차이로 붙어 있습니다. static_local은 함수 안에 있는데도 Data 영역에 있습니다.static을 붙인 지역 변수는 이름만 함수 안에서 보일 뿐, 사는 곳은 전역 변수와 같고 프로그램이 끝날 때까지 살아 있습니다(5주차).- 힙은 Data 에서 조금 떨어진 곳에서 시작합니다.
- 스택은 완전히 다른 동네(
0x7ff...)에 있습니다. 주소 공간의 거의 맨 위입니다.
리눅스에서는 이 배치를 운영체제에게 직접 물어볼 수도 있습니다. 실행 중인 프로그램은 /proc/self/maps 라는 특별한 파일을 읽으면 자기 자신의 메모리 지도를 볼 수 있습니다. 프로그램 안에서 이 파일을 열어 출력하는 maps.c 를 만들어 실행한 결과에서 중요한 줄만 골랐습니다(경로는 줄였습니다).
main=0x5cdb8456f229 g=0x5cdb84572010 h=0x5cdbc15812a0 l=0x7ffd56b297ec
5cdb8456e000-5cdb8456f000 r--p 00000000 fc:00 798809      ./maps
5cdb8456f000-5cdb84570000 r-xp 00001000 fc:00 798809      ./maps
5cdb84570000-5cdb84571000 r--p 00002000 fc:00 798809      ./maps
5cdb84571000-5cdb84572000 r--p 00002000 fc:00 798809      ./maps
5cdb84572000-5cdb84573000 rw-p 00003000 fc:00 798809      ./maps
5cdbc1581000-5cdbc15a2000 rw-p 00000000 00:00 0           [heap]
7b2602400000-7b2602428000 r--p 00000000 fc:00 42482100    /usr/lib/x86_64-linux-gnu/libc.so.6
7b2602428000-7b26025b1000 r-xp 00028000 fc:00 42482100    /usr/lib/x86_64-linux-gnu/libc.so.6
...
7ffd56b0a000-7ffd56b2c000 rw-p 00000000 00:00 0           [stack]
한 줄이 “이 주소부터 이 주소까지는 무엇이고, 권한은 무엇”입니다. 첫 줄에서 찍은 네 주소가 어느 칸에 들어가는지 찾아봅시다.
| 찍은 값 | 들어가는 구간 | 권한 | 뜻 |
|---|---|---|---|
main=0x5cdb8456f229 |
5cdb8456f000-5cdb84570000 |
r-xp |
읽기(r)와 실행(x) 가능. 코드 영역 |
g=0x5cdb84572010 |
5cdb84572000-5cdb84573000 |
rw-p |
읽기와 쓰기(w) 가능. 데이터 영역 |
h=0x5cdbc15812a0 |
[heap] |
rw-p |
힙 |
l=0x7ffd56b297ec |
[stack] |
rw-p |
스택 |
1주차 2절에서 배운 파일 권한 rwx 가 메모리에도 똑같이 있습니다. 코드 영역은 실행은 되지만 쓰기가 안 되고(r-x), 데이터 영역은 쓰기는 되지만 실행이 안 됩니다(rw-). 그래서 실수로(또는 공격으로) 데이터 영역에 기계어를 써 넣어도 실행되지 않습니다. 24주차 보안 프로그래밍에서 이 보호 장치(NX)를 다시 만납니다. 그리고 1주차 7절에서 본 libc.so.6 이 실제로 메모리에 올라와 있는 것도 보입니다. printf 와 malloc 의 몸통이 저기 있습니다.
이번 주의 주인공은 [heap] 줄입니다. malloc 이 주는 메모리는 모두 이 구간에서 나옵니다. 크기를 보면 0x5cdbc15a2000 - 0x5cdbc1581000 = 0x21000, 132KB 입니다. 우리는 16바이트만 달라고 했는데, C 라이브러리는 운영체제에게서 일단 넉넉하게 받아 두고 그 안에서 잘라 나눠 줍니다. 매번 운영체제에게 부탁하면 느리기 때문입니다.
3.3 malloc 함수
memory allocation, “메모리 할당”입니다. 동적 할당의 기본 함수입니다. 먼저 예제를 실행해 보고, 하나씩 뜯어봅시다.
$ ./build/malloc_basic
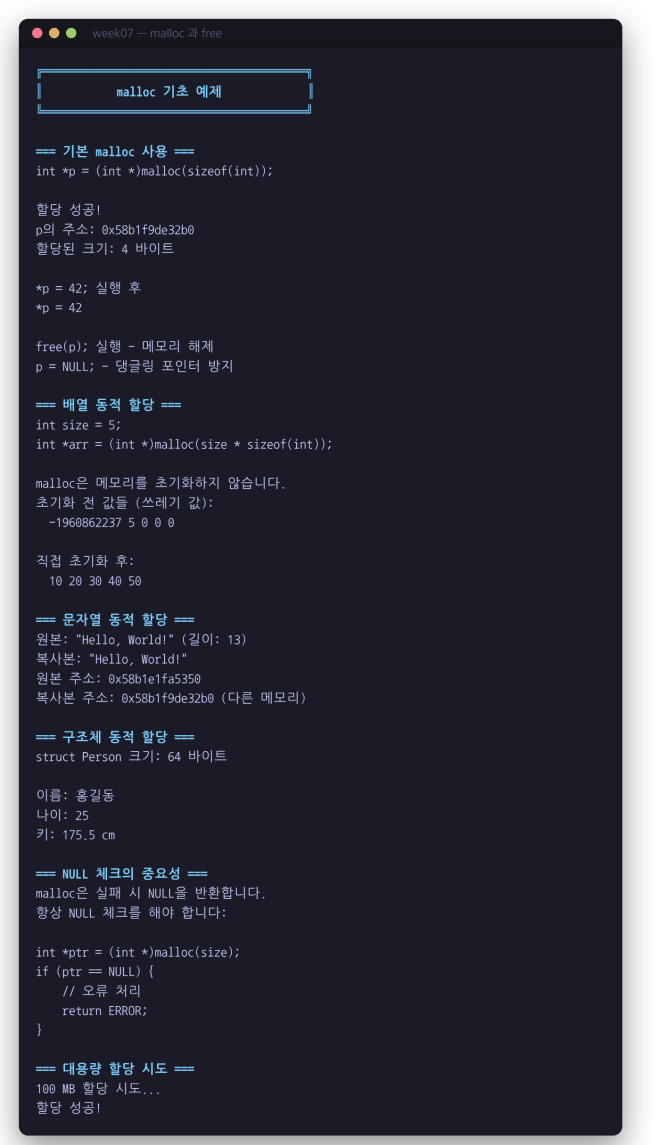
malloc 과 free
함수의 모양
#include <stdlib.h>

void *malloc(size_t size);
| 부분 | 뜻 |
|---|---|
#include <stdlib.h> |
malloc 의 선언이 들어 있는 헤더. standard library. 빼먹으면 1주차 10절의 “implicit declaration” 경고가 납니다 |
size_t size |
몇 바이트가 필요한지. size_t 는 크기를 나타내는 부호 없는 정수 타입으로, 64비트에서는 8바이트입니다. printf 로 찍을 때는 %zu 를 씁니다 |
void * (반환) |
할당된 메모리의 시작 주소. 무엇을 담을지 모르니 “타입 없는 포인터” void * 로 돌려줍니다 |
| 실패하면 | NULL 을 돌려줍니다 |
인자가 바이트 수라는 것이 핵심입니다. malloc 은 우리가 int 를 담을지 구조체를 담을지 모릅니다. 그래서 필요한 바이트 수를 우리가 계산해서 알려 줘야 하고, 그 계산에 sizeof 를 씁니다.
기본 사용법
#include <stdio.h>
#include <stdlib.h>

int main(void) {
    int n = 10;

    // ① int 10개를 담을 메모리를 달라
    int *arr = malloc(n * sizeof(int));

    // ② 실패했는지 확인
    if (arr == NULL) {
        fprintf(stderr, "메모리 할당 실패\n");
        return 1;
    }

    // ③ 보통 배열처럼 쓴다
    for (int i = 0; i < n; i++) {
        arr[i] = i * 10;
    }
    for (int i = 0; i < n; i++) {
        printf("%d ", arr[i]);
    }
    printf("\n");

    // ④ 다 썼으면 돌려준다
    free(arr);
    arr = NULL;

    return 0;
}
0 10 20 30 40 50 60 70 80 90
네 단계를 하나씩 봅시다.
① malloc(n * sizeof(int)): sizeof(int) 는 4 이니 40바이트를 달라는 뜻입니다. malloc(40) 이라고 숫자를 직접 써도 동작하지만, 그러면 int 크기가 다른 환경에서 틀리고, 나중에 double 로 바꿀 때 숫자 고치는 것을 잊기 쉽습니다. 더 안전한 관용구는 변수 쪽 크기를 쓰는 것입니다.
int *arr = malloc(n * sizeof *arr); // *arr 의 크기 = int 의 크기
sizeof *arr 는 “arr 이 가리키는 것 하나의 크기”입니다. sizeof 는 실제로 역참조하지 않고 타입만 보고 크기를 계산하므로, 아직 아무 곳도 가리키지 않는 arr 에 써도 안전합니다. 이렇게 쓰면 나중에 arr 의 타입을 double * 로 바꿔도 크기가 자동으로 따라옵니다.
반환값이 void * 인데 int * 에 그냥 넣었다는 것도 보세요. C 에서는 void * 가 다른 포인터 타입으로 자동 변환됩니다. 그래서 (int *)malloc(...) 처럼 캐스트를 붙이지 않아도 됩니다. 옛날 코드와 C++ 에서는 캐스트가 필요해서 많이 보이는데, C 에서는 오히려 붙이지 않는 것이 권장됩니다. 캐스트를 붙이면 #include <stdlib.h> 를 빼먹은 실수를 컴파일러가 알려 주지 못하게 되는 옛날 함정이 있었기 때문입니다. 이 글의 옛 예제들에는 캐스트가 남아 있지만, 둘 다 올바르게 동작합니다.
② NULL 확인: malloc 은 메모리를 줄 수 없으면 NULL 을 돌려줍니다. 확인하지 않고 쓰면 NULL 주소에 쓰려다가 1.5절에서 본 세그멘테이션 오류로 죽습니다. 실제로 실패하는지 시험해 봅시다.
size_t huge = SIZE_MAX / 2;
errno = 0;
void *h = malloc(huge);
printf("malloc(%zu) = %p, errno = %d (%s)\n", huge, h, errno, strerror(errno));
malloc(9223372036854775807) = (nil), errno = 12 (Cannot allocate memory)
SIZE_MAX 는 size_t 가 담을 수 있는 가장 큰 수로, 그 절반은 약 8 엑사바이트입니다. 당연히 줄 수 없으니 NULL 이 나왔습니다. 그리고 errno 라는 전역 변수에 실패 이유가 번호로 남습니다. 12번은 ENOMEM(메모리 부족)이고, strerror 는 번호를 설명 문장으로 바꿔 줍니다(<errno.h>, <string.h> 가 필요합니다). errno 는 18주차 POSIX 시스템 프로그래밍부터 매일 보게 됩니다.
평범한 크기의 malloc 이 실패하는 일은 요즘 컴퓨터에서 드뭅니다. 그래도 NULL 확인은 항상 합니다. 임베디드 기기처럼 메모리가 작은 곳, 오래 도는 서버처럼 메모리가 바닥나는 곳에서는 실제로 일어나고, 확인 한 줄이 “알 수 없는 곳에서 죽는 프로그램”과 “메모리 부족이라고 말하고 끝나는 프로그램”을 가릅니다.
③ 사용: arr 은 평범한 int * 이므로 6주차에서 배운 대로 arr[i] 로 씁니다. 배열과 똑같이 쓸 수 있다는 것이 중요합니다. 단, sizeof(arr) 는 배열 크기(40)가 아니라 포인터 크기(8) 입니다. 동적으로 받은 메모리의 크기는 C 가 기억해 주지 않으므로 우리가 변수(n)로 따로 들고 다녀야 합니다.
④ free(arr); arr = NULL;: 3.6절에서 자세히 봅니다.
malloc 은 메모리를 비워 주지 않는다
malloc 이 준 메모리에는 무엇이 들어 있을까요? malloc_basic 의 두 번째 부분이 이것을 보여 줍니다.
=== 배열 동적 할당 ===
int size = 5;
int *arr = (int *)malloc(size * sizeof(int));

malloc은 메모리를 초기화하지 않습니다.
초기화 전 값들 (쓰레기 값):
  1279095377 6 0 0 0
1279095377, 6 같은 의미 없는 값이 들어 있습니다. 이전에 그 메모리를 쓰던 누군가가 남긴 흔적입니다. malloc 은 메모리를 찾아서 주기만 할 뿐, 청소하지 않습니다. 0 으로 채워져 있기를 기대하고 쓰면 안 됩니다. 이렇게 초기화하지 않은 값을 읽는 것 자체도 오류라서, 4.6절에서 Valgrind 가 이 줄을 오류로 잡아냅니다.
구조체도 똑같이
malloc_basic 의 네 번째 부분은 구조체를 할당합니다. 구조체는 다음 주(8주차)에 제대로 배우니, 지금은 “여러 값을 한 덩어리로 묶은 타입”이라고만 보세요.
=== 구조체 동적 할당 ===
struct Person 크기: 64 바이트

이름: 홍길동
나이: 25
키: 175.5 cm
malloc(sizeof(struct Person)) 으로 64바이트를 받아서 이름, 나이, 키를 넣었습니다. 크기를 몰라도 sizeof 가 계산해 줍니다. 구조체의 크기가 멤버 크기의 단순 합보다 클 수 있다는 것(패딩)은 8주차와 10주차에서 다룹니다.
실험: malloc(0) 은?
void *z = malloc(0);
printf("malloc(0) = %p\n", z);
free(z);
malloc(0) = 0x5e5c2460c2a0
0바이트를 달라고 했는데 NULL 이 아닌 주소가 나왔습니다. C 표준은 malloc(0) 이 NULL 을 돌려줘도 되고, 아무것도 쓸 수 없는 유효한 주소를 돌려줘도 된다고 정해 놓았습니다. 리눅스(glibc)는 후자입니다. 이 주소에 무언가를 쓰면 안 되지만, free 는 해야 합니다. 이런 “구현마다 다름”에 기대는 코드는 피하는 게 좋습니다.
3.4 calloc 함수
cleared allocation, “비워서 할당”이라는 뜻으로 알려져 있습니다(이름의 유래는 공식적으로 정해져 있지 않습니다).
void *calloc(size_t nmemb, size_t size);
| 인자 | 뜻 |
|---|---|
nmemb |
원소의 개수 (number of members) |
size |
원소 하나의 크기 |
| 반환 | nmemb * size 바이트를 0 으로 채워서 그 시작 주소를. 실패하면 NULL |
malloc 과 다른 점은 두 가지입니다. 인자를 개수와 크기로 나눠서 받는다는 것, 그리고 메모리를 0 으로 채워 준다는 것입니다.
int *arr1 = malloc(10 * sizeof(int));   // 내용은 쓰레기 값
int *arr2 = calloc(10, sizeof(int));    // 내용은 모두 0
examples/calloc_realloc.c 로 확인해 봅시다.
$ ./build/calloc_realloc
...
calloc 배열 (0으로 초기화됨):
  0 0 0 0 0

=== calloc으로 구조체 배열 ===
Student 배열 초기 상태 (0으로 초기화):
  students[0]: id=0, name="", score=0.0
  students[1]: id=0, name="", score=0.0
  students[2]: id=0, name="", score=0.0
구조체 배열도 모든 바이트가 0 이라서, 정수는 0, 문자열은 빈 문자열(\0 으로 시작하니까요, 1주차 6절), 실수는 0.0 이 됐습니다.
인자를 나눠 받는 진짜 이유: 곱셈 오버플로
0 으로 채워 주는 것만이 장점이라면 malloc 후에 직접 0 을 채워도 됩니다. calloc 이 개수와 크기를 따로 받는 데는 더 중요한 이유가 있습니다. 2.6절의 qsort 비교 함수에서 본 오버플로가 여기서도 일어납니다. 실험해 봅시다.
size_t n = SIZE_MAX / 4 + 2;       /* 원소 개수 */
size_t bytes = n * sizeof(int);    /* 넘친다! */
printf("n = %zu\n", n);
printf("n * sizeof(int) = %zu  (넘쳐서 작아짐)\n", bytes);
int *a = malloc(n * sizeof(int));
printf("malloc(n * sizeof(int)) = %p\n", (void *)a);
int *b = calloc(n, sizeof(int));
printf("calloc(n, sizeof(int))  = %p\n", (void *)b);
n = 4611686018427387905
n * sizeof(int) = 4  (넘쳐서 작아짐)
malloc(n * sizeof(int)) = 0x5e5c2460c2a0
calloc(n, sizeof(int))  = (nil)
int 를 약 460경 개 달라는 요청입니다. 바이트로 계산하면 size_t 가 담을 수 있는 한계를 넘어서, 한 바퀴 돌아 4 가 되었습니다. size_t 는 부호 없는 정수라서 넘치면 0 부터 다시 셉니다(2주차).
malloc은 이미 계산이 끝난4만 받았으니, 아무 의심 없이 4바이트짜리 메모리를 줬습니다. 프로그램은 460경 개를 담을 수 있다고 믿고 쓰기 시작할 테니, 곧바로 남의 메모리를 덮어쓰게 됩니다. 실제 보안 사고로 이어진 유명한 버그 유형입니다.calloc은 개수와 크기를 따로 받았기 때문에, 곱하기 전에 “이 곱셈은 넘친다”는 것을 알아채고 NULL 로 거절했습니다.
그래서 “원소 개수 × 크기” 모양의 할당에는 calloc 이 더 안전합니다. 개수가 사용자 입력에서 오는 경우라면 더욱 그렇습니다. malloc 을 쓸 때는 곱하기 전에 if (n > SIZE_MAX / sizeof(int)) 처럼 직접 검사해야 합니다.
3.5 realloc 함수
re–allocation, “다시 할당”입니다. 이미 받은 메모리의 크기를 바꿉니다.
void *realloc(void *ptr, size_t size);
| 인자 | 뜻 |
|---|---|
ptr |
크기를 바꿀 메모리. malloc·calloc·realloc 이 돌려준 주소여야 합니다 |
size |
새 크기(바이트). 늘릴 수도 줄일 수도 있습니다 |
| 반환 | 크기가 바뀐 메모리의 주소. 원래 주소와 다를 수 있습니다. 실패하면 NULL |
동작은 이렇습니다.
- 원래 자리 뒤쪽에 여유가 있으면 그 자리에서 늘립니다. 반환값은 원래 주소와 같습니다.
- 여유가 없으면 새 자리를 받아서, 내용을 복사하고, 원래 자리는
free합니다. 반환값은 새 주소입니다. - 새 자리조차 못 구하면 NULL 을 돌려주고, 원래 메모리는 그대로 둡니다.
두 번째 경우가 핵심입니다. 정말 이사하는지 확인해 봅시다. rmove.c:
#include <stdio.h>
#include <stdlib.h>

int main(void) {
    int *arr = malloc(4 * sizeof(int));
    int *other = malloc(4 * sizeof(int));   /* 바로 뒤에 다른 블록을 하나 둔다 */
    printf("arr   = %p (16바이트)\n", (void *)arr);
    printf("other = %p\n", (void *)other);

    int *t = realloc(arr, 8 * sizeof(int));
    printf("realloc(arr, 32)   -> %p %s\n", (void *)t, t == arr ? "(제자리)" : "(이사함!)");
    arr = t;

    t = realloc(arr, 6 * sizeof(int));
    printf("realloc(arr, 24)   -> %p %s\n", (void *)t, t == arr ? "(제자리)" : "(이사함!)");
    arr = t;

    free(other);
    free(arr);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g rmove.c -o rmove && ./rmove
arr   = 0x5a4f086a52a0 (16바이트)
other = 0x5a4f086a52c0
realloc(arr, 32)   -> 0x5a4f086a62f0 (이사함!)
realloc(arr, 24)   -> 0x5a4f086a62f0 (제자리)
arr(...52a0) 바로 뒤 32바이트 지점(...52c0)에 other 가 있어서, 32바이트로 늘릴 자리가 없습니다. 그래서 realloc 은 완전히 다른 주소(...62f0)로 이사했습니다. 반면 24바이트로 줄일 때는 제자리에서 끝났습니다.
arr 과 other 의 주소 차이가 16 이 아니라 32바이트라는 것도 눈여겨보세요. 16바이트를 달라고 했는데 다음 블록은 32바이트 뒤에 있습니다. malloc 이 블록마다 크기 같은 관리 정보를 몰래 붙여 두기 때문입니다. free 가 크기를 묻지 않고도 얼마를 돌려받을지 아는 비밀이 여기 있습니다. 5.2절의 2차원 배열에서 이 차이를 다시 보게 됩니다.
realloc 의 두 가지 함정
함정 1: 옛 주소를 계속 쓰기. 이사했다면 원래 자리는 이미 free 된 곳입니다. realloc 을 부르기 전에 arr 을 다른 변수에 복사해 뒀다면, 그 복사본은 이제 해제된 메모리를 가리킵니다(4.4절의 “해제 후 사용”). realloc 뒤에는 반드시 반환값으로 포인터를 바꿔야 합니다.
함정 2: 반환값을 원래 포인터에 바로 받기.
arr = realloc(arr, new_size); // 위험!
실패하면 realloc 은 NULL 을 돌려주고 원래 메모리는 그대로 둡니다. 그런데 이 코드는 그 NULL 을 arr 에 바로 넣었으니, 원래 메모리의 주소를 잃어버립니다. 1.1절과 같은 누수입니다. 올바른 방법은 임시 변수로 받는 것입니다.
int *temp = realloc(arr, new_size);
if (temp == NULL) {
    // 실패: arr 은 여전히 유효하다. 필요하면 정리하고 오류 처리
    free(arr);
    return 1;
}
arr = temp;     // 성공했을 때만 바꾼다
examples/calloc_realloc.c 가 늘리기와 줄이기를 보여 줍니다.
=== realloc으로 배열 확장 ===
초기 배열 (크기 5): 10 20 30 40 50

크기를 10칸으로 확장...
기존 데이터 유지됨: 10 20 30 40 50
새 데이터 추가 후: 10 20 30 40 50 60 70 80 90 100

=== realloc으로 배열 축소 ===
크기를 3칸으로 축소...
축소 후 (앞부분 유지): 10 20 30
늘려도 원래 내용(10~50)은 보존됩니다. 이사하더라도 realloc 이 복사해 주기 때문입니다. 다만 새로 늘어난 부분은 malloc 처럼 쓰레기 값이라서, 60~100 은 직접 채웠습니다. 줄이면 앞부분만 남습니다.
이 예제의 출력은 원래
초기 배열 (크기 5): : 10 20 ...처럼 콜론이 두 번 찍히고,크기를 10로 확장처럼 조사가 어색했습니다. 이번에 고쳤습니다.
특수한 경우 두 가지
realloc(NULL, size)는malloc(size)와 같습니다. 그래서 “처음엔 NULL 에서 시작해서 필요할 때마다realloc으로 늘리는” 코드를 짤 수 있습니다.realloc(ptr, 0)은 피하세요. C17 까지는 “구현마다 다름”이었고, 최신 표준 C23 에서는 정의되지 않은 동작이 됐습니다. 리눅스에서 실제로 해 보면 메모리를 해제하고 NULL 을 돌려주는데, Valgrind 는realloc() with size 0이라며 오류로 표시합니다. 메모리를 돌려주고 싶으면free를 쓰세요.
3.6 free 함수
빌린 메모리를 돌려주는 함수입니다.
void free(void *ptr);
| 인자 | 뜻 |
|---|---|
ptr |
malloc·calloc·realloc 이 돌려준 주소 그대로. 또는 NULL |
| 반환 | 없음 |
단순해 보이지만 규칙이 엄격합니다.
규칙 1: 받은 주소 그대로 돌려준다. free(arr + 1) 처럼 중간 주소를 넘기거나, malloc 으로 받지 않은 주소를 넘기면 안 됩니다. 스택 변수의 주소를 넘기면 어떻게 될까요? fstack.c:
#include <stdlib.h>
int main(void) {
    int x = 5;
    int *p = &x;
    free(p);     /* malloc 으로 받은 게 아니다 */
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g fstack.c -o fstack
fstack.c: In function ‘main’:
fstack.c:5:5: warning: ‘free’ called on unallocated object ‘x’ [-Wfree-nonheap-object]
    5 |     free(p);     /* malloc 으로 받은 게 아니다 */
      |     ^~~~~~~
fstack.c:3:9: note: declared here
    3 |     int x = 5;
      |         ^
$ ./fstack
free(): invalid pointer
중지됨 (코어 덤프됨)
$ echo $?
134
GCC 가 컴파일 단계에서 “할당하지 않은 객체 x 를 free 한다”고 경고했고, 실행하면 C 라이브러리가 free(): invalid pointer 라고 외치며 프로그램을 강제로 중지시킵니다. 종료 코드 134 는 128 + 6, 즉 “신호 6번(SIGABRT, 스스로 중단)으로 끝났다”는 뜻입니다. 3.5절에서 본 관리 정보가 있어야 할 자리에 엉뚱한 값이 있으니, free 가 “이건 내가 준 메모리가 아니다”라고 알아챈 것입니다.
규칙 2: free(NULL) 은 아무 일도 하지 않는다. 표준이 보장합니다. 그래서 if (p != NULL) free(p); 처럼 확인할 필요가 없습니다.
규칙 3: 같은 주소를 두 번 free 하지 않는다. 4.3절에서 실제로 해 봅니다.
규칙 4: free 는 포인터 변수를 바꾸지 않는다. 이것이 가장 중요하고, 가장 오해하기 쉽습니다. free(arr) 를 해도 arr 변수에는 여전히 같은 주소가 들어 있습니다. free 는 주소를 값으로 받았으니(1.1절!), 호출자의 변수를 바꿀 방법이 없습니다. 메모리는 돌려줬는데 주소는 남아 있는 이 포인터를 댕글링 포인터(dangling pointer), “허공에 매달린 포인터”라고 합니다. 그래서 관용적으로 free 바로 뒤에 NULL 을 넣습니다.
free(arr);
arr = NULL;     // 이제 arr 을 실수로 써도 NULL 이라 바로 드러나고, 다시 free 해도 안전
examples/pointer_to_pointer.c 의 마지막 부분은 이 두 줄을 한 함수로 묶기 위해 1절의 이중 포인터를 씁니다. free 가 못 하는 “호출자의 변수를 NULL 로 바꾸기”를 이중 포인터로 해내는 것입니다.
=== 안전한 해제 함수 ===
해제 전: ptr3 = 0x6273ceb7e2d0, *ptr3 = 999
해제 후: ptr3 = (nil) (자동으로 NULL)
다시 해제: 안전하게 무시됨
free 는 메모리를 운영체제에 돌려줄까?
대부분의 경우 아닙니다. 3.2절에서 C 라이브러리가 운영체제에게 132KB 를 한꺼번에 받아 뒀던 것을 기억하세요. free 는 그 안의 블록을 “빈 자리” 목록에 다시 올려 둘 뿐이고, 다음 malloc 이 그 자리를 다시 줍니다. 실제로 1.5절의 출력을 다시 보면, allocate_wrong 이 받은 ...e2b0 다음에 받은 메모리들이 계속 ...e2d0 을 재사용하고 있습니다. 앞서 쓰던 블록이 free 되자 같은 자리가 다시 나간 것입니다. 이 재사용 때문에 “해제한 메모리를 실수로 써도 당장은 멀쩡해 보이는” 무서운 일이 생깁니다. 4.4절에서 봅니다.
3.7 동적 할당 패턴
지금까지 배운 것을 모으면 동적 할당의 기본 모양이 나옵니다.
// 1. 할당
int *ptr = malloc(n * sizeof *ptr);

// 2. NULL 확인
if (ptr == NULL) {
    // 오류 처리
    return -1;
}

// 3. 사용
// ...

// 4. 해제하고 NULL
free(ptr);
ptr = NULL;
실전에서는 이 기본 모양을 만드는 함수와 없애는 함수 한 쌍으로 감싸는 경우가 많습니다.
구조체 동적 할당: create / destroy 짝
typedef struct {
    char name[50];
    int age;
} Person;

Person *create_person(const char *name, int age) {
    Person *p = malloc(sizeof *p);
    if (p != NULL) {
        strncpy(p->name, name, sizeof p->name - 1);
        p->name[sizeof p->name - 1] = '\0';
        p->age = age;
    }
    return p;
}

void destroy_person(Person *p) {
    free(p);
}
p->name 은 “포인터 p 가 가리키는 구조체의 name“, 즉 (*p).name 의 줄임말입니다. 8주차에 자세히 배웁니다.
strncpy 로 복사한 뒤 마지막 칸에 직접 \0 을 넣은 이유는, strncpy 가 원본이 너무 길면 \0 을 붙이지 않기 때문입니다(4주차). sizeof p->name - 1 은 49 입니다. 숫자 49 를 직접 쓰는 대신 이렇게 쓰면, 나중에 배열 크기를 바꿔도 따라옵니다.
destroy_person 은 지금은 free 한 줄뿐이지만, 나중에 구조체 안에 또 동적 할당한 멤버가 생기면 여기서 함께 정리하면 됩니다. “create_xxx 로 만든 것은 destroy_xxx 로 없앤다” 는 짝을 지키면, 누가 무엇을 해제할 책임이 있는지 헷갈리지 않습니다.
동적 배열: 꽉 차면 두 배로
realloc 의 가장 흔한 쓰임새는 크기가 저절로 늘어나는 배열입니다. 넣을 자리가 없으면 realloc 으로 용량을 두 배로 늘립니다.
typedef struct {
    int *data;       // 실제 원소들이 있는 동적 메모리
    int size;        // 지금 들어 있는 원소 수
    int capacity;    // 지금 받아 둔 칸 수
} DynamicArray;

int da_push(DynamicArray *da, int value) {
    if (da->size >= da->capacity) {
        int new_cap = da->capacity * 2;
        int *temp = realloc(da->data, new_cap * sizeof *temp);
        if (temp == NULL) {
            return -1;              // 실패해도 기존 data 는 멀쩡하다
        }
        da->data = temp;
        da->capacity = new_cap;
    }
    da->data[da->size++] = value;
    return 0;
}
examples/dynamic_array.c 가 이 구조의 완성본입니다. size 와 capacity 가 어떻게 변하는지 보세요.
$ ./build/dynamic_array
...
=== push 연산 ===
push(10): [10] (size=1, capacity=4)
push(20): [10, 20] (size=2, capacity=4)
push(30): [10, 20, 30] (size=3, capacity=4)
push(40): [10, 20, 30, 40] (size=4, capacity=4)
push(50): [10, 20, 30, 40, 50] (size=5, capacity=8)
push(60): [10, 20, 30, 40, 50, 60] (size=6, capacity=8)
네 번째 push 까지는 처음 받은 4칸에 들어가고, 다섯 번째에서 용량이 8로 두 배가 됐습니다. 왜 하나씩이 아니라 두 배로 늘릴까요? realloc 은 이사할 때마다 전체를 복사합니다. 한 칸씩 늘리면 원소를 넣을 때마다 복사가 일어나 1000개를 넣는 데 약 50만 번의 복사가 필요합니다. 두 배씩 늘리면 이사가 4 → 8 → 16 → … 처럼 가끔만 일어나서, 전체 복사량이 원소 수의 2배 정도로 끝납니다. 이 계산은 10주차에서 동적 배열(벡터)을 제대로 만들면서 확인합니다.
4. 메모리 오류: 직접 저지르고 잡아내기
동적 메모리의 자유에는 책임이 따른다고 했습니다. 이 절에서는 그 책임을 일부러 어겨 봅니다. 저지를 수 있는 실수는 크게 다섯 가지입니다.
| 오류 | 한 줄 설명 |
|---|---|
| 메모리 누수 (leak) | 빌린 메모리를 돌려주지 않음 |
| 이중 해제 (double free) | 같은 메모리를 두 번 돌려줌 |
| 해제 후 사용 (use after free) | 돌려준 메모리를 계속 씀 |
| 범위 초과 (buffer overflow) | 빌린 크기보다 넘게 씀 |
| 초기화 안 된 읽기 | 아무것도 넣지 않은 메모리를 읽음 |
먼저 저장소의 memory_errors 예제로 각 오류의 “잘못된 코드”와 “올바른 코드”를 훑어봅시다. 이 예제는 설명만 할 뿐 오류를 실제로 저지르지는 않습니다.
$ ./build/memory_errors
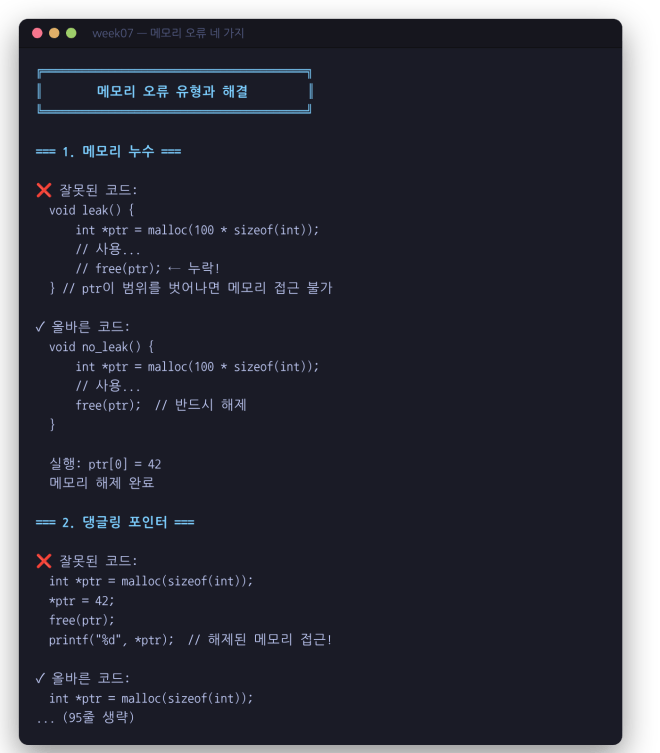
메모리 오류 네 가지
이 절의 진짜 목적은 설명이 아니라 확인입니다. 오류마다 짧은 프로그램을 만들어 ① 그냥 실행하면 어떻게 되는지, ② Valgrind 로 실행하면 무엇이 보이는지를 나란히 봅니다. ①에서 아무 일도 일어나지 않는 경우가 많다는 것, 그게 이 절에서 가장 무서운 교훈입니다.
Valgrind 사용법
1주차 3절에서 설치한 Valgrind 는 프로그램을 가상의 CPU 위에서 한 명령씩 실행하면서, 모든 메모리 읽기와 쓰기를 감시하는 도구입니다. 그래서 프로그램이 평소보다 수십 배 느려지지만, 메모리를 잘못 쓰는 순간을 정확히 잡아냅니다.
$ gcc -Wall -Wextra -std=c11 -g 파일.c -o 파일     # -g 가 중요합니다
$ valgrind --leak-check=full ./파일
-g로 컴파일해야 합니다. 1주차 5절에서 본 “기계어와 소스 줄의 대응표”가 있어야 Valgrind 가 “leak.c의 5번째 줄”이라고 알려 줄 수 있습니다. 없으면 기계어 주소만 나옵니다.--leak-check=full은 프로그램이 끝날 때 새어 나간 메모리를 하나하나 어디서 할당했는지까지 보여 달라는 옵션입니다.
Valgrind 가 출력하는 줄은 모두 ==12345== 로 시작합니다. 이 숫자는 프로세스 번호로, 실행할 때마다 다릅니다(이 글에서는 12345 로 통일했습니다). 이 표시가 없는 줄은 우리 프로그램이 직접 출력한 것입니다. 둘이 섞여 나오니 구분해서 읽으세요.
4.1 메모리 누수 (Memory Leak)
leak.c:
#include <stdio.h>
#include <stdlib.h>

void make_leak(void) {
    int *ptr = malloc(10 * sizeof(int));
    ptr[0] = 1;
    printf("ptr[0] = %d\n", ptr[0]);
    /* free(ptr); 를 잊었다 */
}

int main(void) {
    make_leak();
    return 0;
}
① 그냥 실행
$ gcc -Wall -Wextra -std=c11 -g leak.c -o leak
$ ./leak
ptr[0] = 1
$ echo $?
0
컴파일러 경고도 없고, 실행도 정상이고, 종료 코드도 0 입니다. 아무 문제가 없어 보입니다. 이게 누수의 무서운 점입니다. 짧게 돌고 끝나는 프로그램은 끝날 때 운영체제가 메모리를 전부 회수하니 정말로 아무 일도 없습니다. 하지만 서버처럼 몇 달씩 도는 프로그램에서 이 함수가 초당 수천 번 불린다면, 메모리 사용량이 계속 늘어나다 결국 시스템을 멈춰 세웁니다.
② Valgrind 로 실행
$ valgrind --leak-check=full ./leak
==12345== Memcheck, a memory error detector
==12345== Copyright (C) 2002-2022, and GNU GPL'd, by Julian Seward et al.
==12345== Using Valgrind-3.22.0 and LibVEX; rerun with -h for copyright info
==12345== Command: ./leak
==12345==
ptr[0] = 1
==12345==
==12345== HEAP SUMMARY:
==12345==     in use at exit: 40 bytes in 1 blocks
==12345==   total heap usage: 2 allocs, 1 frees, 4,136 bytes allocated
==12345==
==12345== 40 bytes in 1 blocks are definitely lost in loss record 1 of 1
==12345==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==12345==    by 0x10917E: make_leak (leak.c:5)
==12345==    by 0x1091B8: main (leak.c:12)
==12345==
==12345== LEAK SUMMARY:
==12345==    definitely lost: 40 bytes in 1 blocks
==12345==    indirectly lost: 0 bytes in 0 blocks
==12345==      possibly lost: 0 bytes in 0 blocks
==12345==    still reachable: 0 bytes in 0 blocks
==12345==         suppressed: 0 bytes in 0 blocks
==12345==
==12345== For lists of detected and suppressed errors, rerun with: -s
==12345== ERROR SUMMARY: 1 errors from 1 contexts (suppressed: 0 from 0)
처음 보면 길지만, 덩어리별로 읽으면 간단합니다.
머리말 (1~5줄): Memcheck 는 Valgrind 의 여러 도구 중 메모리 검사기 이름입니다. Command: ./leak 은 무엇을 실행했는지. 여기까지는 매번 같습니다.
ptr[0] = 1: == 가 없으니 우리 프로그램의 출력입니다.
HEAP SUMMARY (힙 요약):
in use at exit: 40 bytes in 1 blocks— 프로그램이 끝날 때 돌려받지 못한 메모리가 40바이트, 1덩어리 남았습니다.int10개 = 40바이트, 우리가malloc한 그대로입니다.total heap usage: 2 allocs, 1 frees, 4,136 bytes allocated— 프로그램 전체에서 할당 2번, 해제 1번이 있었습니다. 어? 우리는malloc을 한 번만 했는데 왜 2번일까요? 나머지 한 번은printf가 했습니다.printf는 출력을 모아 뒀다가 한꺼번에 내보내려고 4,096바이트짜리 버퍼를malloc합니다(4,136 = 40 + 4,096). 그 버퍼는 프로그램이 끝날 때 C 라이브러리가 알아서free합니다. 그래서 할당 2, 해제 1 이고, 해제되지 않은 1개가 우리 것입니다. (실제로printf를 빼고 돌려 보면1 allocs, 0 frees, 40 bytes allocated로 바뀝니다.)
누수 상세 (가장 중요한 덩어리):
==12345== 40 bytes in 1 blocks are definitely lost in loss record 1 of 1
==12345==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==12345==    by 0x10917E: make_leak (leak.c:5)
==12345==    by 0x1091B8: main (leak.c:12)
- 첫 줄: 40바이트짜리 1덩어리가 확실히 새어 나갔다(definitely lost).
- 그 아래는 그 메모리가 어디서 할당됐는지 거슬러 올라가는 기록입니다. 이것을 호출 스택(call stack) 또는 백트레이스(backtrace) 라고 합니다. 위에서 아래로 “누가 불렀나” 를 따라 읽습니다.
at ... malloc: 할당은malloc안에서 일어났다 (Valgrind 가 가로챈malloc)by ... make_leak (leak.c:5): 그malloc을 부른 것은make_leak함수,leak.c의 5번째 줄by ... main (leak.c:12):make_leak을 부른 것은main의 12번째 줄
그러니 “leak.c 5번째 줄에서 할당한 40바이트를 아무도 해제하지 않았다” 는 뜻입니다. 5번째 줄은 int *ptr = malloc(10 * sizeof(int)); 입니다. 해결책은 make_leak 이 끝나기 전에 free(ptr); 를 넣는 것입니다. -g 로 컴파일하지 않았다면 (leak.c:5) 대신 알 수 없는 주소만 나왔을 겁니다.
LEAK SUMMARY (누수 요약): 누수를 종류별로 합산합니다. 종류는 4.2절에서 봅니다.
ERROR SUMMARY: 발견한 오류가 모두 몇 개인지. 여기가 0 errors 가 되는 것이 목표입니다.
우리 예제 속 누수 찾기
1.1절에서 pointer_to_pointer 의 “잘못된 방법”이 4바이트를 새게 만든다고 했습니다. 정말 그런지 확인해 봅시다.
$ valgrind --leak-check=full ./build/pointer_to_pointer
...
==12345== 4 bytes in 1 blocks are definitely lost in loss record 1 of 1
==12345==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==12345==    by 0x109242: allocate_wrong (pointer_to_pointer.c:12)
==12345==    by 0x1094EA: main (pointer_to_pointer.c:85)
...
==12345==    definitely lost: 4 bytes in 1 blocks
allocate_wrong 함수(12번째 줄의 malloc)에서 할당한 4바이트가 정확히 잡혔습니다. 이 예제는 잘못된 방법을 시연하느라 일부러 누수를 남겨 둔 것이라 고치지 않았습니다. 이 저장소의 다른 예제들은 모두 Valgrind 로 확인했을 때 누수가 0 입니다.
4.2 Valgrind 누수 종류 읽기
LEAK SUMMARY 의 다섯 줄은 누수를 “얼마나 확실히 잃어버렸나”로 나눈 것입니다.
| 종류 | 뜻 | 심각도 |
|---|---|---|
| definitely lost | 그 메모리를 가리키는 포인터가 하나도 남아 있지 않음. 확실한 누수 | 반드시 고친다 |
| indirectly lost | 가리키는 포인터는 있지만, 그 포인터가 들어 있는 블록이 또 잃어버린 블록임 | definitely lost 를 고치면 대개 같이 사라진다 |
| possibly lost | 블록의 시작이 아니라 중간을 가리키는 포인터만 남아 있음 | 조사가 필요하다 |
| still reachable | 프로그램이 끝날 때 아직 가리키는 포인터가 있음(예: 전역 변수). 해제는 안 했지만 잃어버리지는 않음 | 되도록 고친다 |
| suppressed | 알려진 라이브러리 내부 동작이라 Valgrind 가 일부러 무시한 것 | 신경 쓰지 않는다 |
indirectly lost 는 연결된 구조에서 나옵니다. 노드 두 개짜리 연결 리스트를 만들고 머리를 잃어버려 봅시다. listleak.c:
#include <stdlib.h>

typedef struct Node {
    int data;
    struct Node *next;
} Node;

int main(void) {
    Node *head = malloc(sizeof(Node));
    head->data = 1;
    head->next = malloc(sizeof(Node));
    head->next->data = 2;
    head->next->next = NULL;

    head = NULL;   /* 머리를 잃어버렸다 */
    return 0;
}
$ valgrind --leak-check=full ./listleak
...
==12345== 32 (16 direct, 16 indirect) bytes in 1 blocks are definitely lost in loss record 2 of 2
==12345==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==12345==    by 0x10915E: main (listleak.c:9)
==12345==
==12345== LEAK SUMMARY:
==12345==    definitely lost: 16 bytes in 1 blocks
==12345==    indirectly lost: 16 bytes in 1 blocks
- 첫 번째 노드(9번째 줄, 16바이트)는 가리키는 포인터가 하나도 없으니 definitely lost 입니다.
- 두 번째 노드는 첫 번째 노드의
next가 가리키고 있으니 “잃어버린” 것은 아니지만, 그next가 들어 있는 첫 노드 자체를 잃어버렸으니 indirectly lost 입니다. - Valgrind 는 둘을 묶어
32 (16 direct, 16 indirect)라고 보여 줍니다. 머리 하나만 고치면 둘 다 해결된다는 뜻입니다.
노드 하나가 16바이트인 것도 보세요. int(4) + 포인터(8) = 12 인데 16 입니다. 포인터를 8의 배수 주소에 두려고 사이에 빈 4바이트가 들어갔기 때문입니다. 이것이 8주차와 10주차에서 다룰 패딩입니다.
still reachable 은 전역 변수로 붙잡고 있는 메모리에서 나옵니다.
#include <stdlib.h>
int *keep;
int main(void) {
    keep = malloc(100);
    return 0;
}
==12345== LEAK SUMMARY:
==12345==    definitely lost: 0 bytes in 0 blocks
==12345==    indirectly lost: 0 bytes in 0 blocks
==12345==      possibly lost: 0 bytes in 0 blocks
==12345==    still reachable: 100 bytes in 1 blocks
==12345==         suppressed: 0 bytes in 0 blocks
프로그램이 끝나는 순간에도 전역 변수 keep 이 그 100바이트를 가리키고 있으니 “잃어버리지는 않았다”고 봅니다. 기본 설정에서는 어디서 할당했는지 보여 주지 않는데, --show-leak-kinds=all 옵션을 더하면 still reachable 도 할당 위치를 보여 줍니다. 끝날 때 한 번에 정리되는 메모리라 급하지는 않지만, 끝나기 전에 free 하는 습관이 좋습니다.
4.3 이중 해제 (Double Free)
dfree.c:
#include <stdlib.h>

int main(void) {
    int *ptr = malloc(sizeof(int));
    free(ptr);
    free(ptr);   /* 두 번째 해제 */
    return 0;
}
① 컴파일: 요즘 GCC 는 이 정도로 뻔한 경우는 잡아 줍니다.
$ gcc -Wall -Wextra -std=c11 -g dfree.c -o dfree
dfree.c: In function ‘main’:
dfree.c:6:5: warning: pointer ‘ptr’ used after ‘free’ [-Wuse-after-free]
    6 |     free(ptr);   /* 두 번째 해제 */
      |     ^~~~~~~~~
dfree.c:5:5: note: call to ‘free’ here
    5 |     free(ptr);
      |     ^~~~~~~~~
“free 한 뒤에 ptr 을 썼다”고 합니다. 두 번째 free 도 ptr 을 “쓴” 것이기 때문입니다. 하지만 이 경고는 두 free 가 같은 함수 안에 가까이 있을 때만 나옵니다. 서로 다른 함수에서 해제하면 컴파일러는 알 수 없습니다.
② 그냥 실행
$ ./dfree
free(): double free detected in tcache 2
중지됨 (코어 덤프됨)
$ echo $?
134
이번에는 C 라이브러리가 스스로 알아채고 프로그램을 중단했습니다. tcache 는 glibc 가 최근 해제된 블록을 빠르게 재사용하려고 모아 두는 빈 블록 목록의 이름인데, 같은 블록이 그 목록에 두 번 들어가려 하자 알아챈 것입니다. 3.6절의 free(): invalid pointer 와 같은 SIGABRT(134) 입니다.
이렇게 바로 죽는 것은 운이 좋은 경우입니다. 해제와 재해제 사이에 다른 할당이 끼어들면 glibc 도 알아채지 못하고, 같은 블록이 두 번 나눠지면서 서로 다른 두 변수가 같은 메모리를 쓰는 괴상한 버그가 됩니다. 공격자가 이것을 이용해 프로그램을 장악하는 기법도 있습니다(24주차).
③ Valgrind 로 실행
$ valgrind --leak-check=full ./dfree
...
==12345== Invalid free() / delete / delete[] / realloc()
==12345==    at 0x484988F: free (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==12345==    by 0x10919A: main (dfree.c:6)
==12345==  Address 0x4aac040 is 0 bytes inside a block of size 4 free'd
==12345==    at 0x484988F: free (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==12345==    by 0x10918E: main (dfree.c:5)
==12345==  Block was alloc'd at
==12345==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==12345==    by 0x10917E: main (dfree.c:4)
...
==12345==   total heap usage: 1 allocs, 2 frees, 4 bytes allocated
Valgrind 의 오류 보고는 항상 세 부분으로 되어 있습니다. 이 모양을 익혀 두면 모든 메모리 오류를 같은 방식으로 읽을 수 있습니다.
| 부분 | 이 예에서 | 뜻 |
|---|---|---|
| ① 무슨 일이, 어디서 | Invalid free() … main (dfree.c:6) |
6번째 줄에서 잘못된 free 를 했다 |
| ② 그 주소의 정체 | Address 0x4aac040 is 0 bytes inside a block of size 4 free'd … (dfree.c:5) |
그 주소는 4바이트 블록의 시작(0바이트 안쪽)이고, 이미 5번째 줄에서 해제됐다 |
| ③ 그 블록의 출생지 | Block was alloc'd at … (dfree.c:4) |
그 블록은 4번째 줄에서 할당됐다 |
오류가 난 곳, 먼저 해제한 곳, 처음 할당한 곳을 줄 번호로 모두 알려 줍니다. 실제 프로그램에서는 이 세 줄이 서로 다른 파일, 다른 함수에 흩어져 있기 때문에 이 정보가 결정적입니다. total heap usage 의 1 allocs, 2 frees 도 할당보다 해제가 많다는 것을 그대로 보여 줍니다.
예방법은 3.6절의 관용구입니다. free(ptr); ptr = NULL; 로 두면 두 번째 free(ptr) 은 free(NULL) 이 되어 아무 일도 없습니다.
4.4 해제 후 사용 (Use After Free)
uaf.c:
#include <stdio.h>
#include <stdlib.h>

int main(void) {
    int *ptr = malloc(sizeof(int));
    *ptr = 42;
    free(ptr);
    printf("해제 후 *ptr = %d\n", *ptr);   /* 해제 후 사용 */
    return 0;
}
GCC 는 이것도 -Wuse-after-free 로 경고합니다(4.3절과 같은 모양). 그냥 실행해 봅시다.
$ ./uaf
해제 후 *ptr = 1968410302
$ echo $?
0
죽지 않았습니다! 42 대신 엉뚱한 숫자를 조용히 찍고 정상 종료했습니다. free 된 블록은 glibc 가 빈 블록 목록(tcache)에 넣으면서 그 자리에 목록 관리용 값을 써넣는데, 우리는 그 값을 정수로 읽은 것입니다. 실행할 때마다 다른 숫자가 나올 수 있습니다.
Valgrind 로 돌려 보면 재미있는 일이 생깁니다.
$ valgrind --leak-check=full ./uaf
...
==12345== Invalid read of size 4
==12345==    at 0x1091BD: main (uaf.c:8)
==12345==  Address 0x4aac040 is 0 bytes inside a block of size 4 free'd
==12345==    at 0x484988F: free (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==12345==    by 0x1091B8: main (uaf.c:7)
==12345==  Block was alloc'd at
==12345==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==12345==    by 0x10919E: main (uaf.c:5)
==12345==
해제 후 *ptr = 42
- 세 부분 구조 그대로입니다. ① 8번째 줄에서 4바이트를 잘못 읽었다(Invalid read of size 4) —
int하나를 읽었으니 4바이트입니다. ② 그 주소는 7번째 줄에서 해제된 블록 안이다. ③ 그 블록은 5번째 줄에서 태어났다. - 그런데 이번에는 프로그램이 42 를 찍었습니다. Valgrind 는 오류를 잡으려고 해제된 블록을 당분간 재사용하지 않고 그대로 보관하기 때문입니다. 그래서 원래 값이 남아 있었습니다.
이 차이가 “해제 후 사용”이 얼마나 교활한지 보여 줍니다. 환경에 따라 맞는 값이 나오기도 하고 틀린 값이 나오기도 합니다. 테스트할 때는 우연히 맞게 나오다가, 실제 사용자 환경에서 틀린 값으로 조용히 동작하는 버그가 되는 것입니다. 3.6절에서 본 대로 free 뒤에 ptr = NULL; 을 해 두면, 이 코드는 NULL 을 역참조해서 그 자리에서 바로 세그멘테이션 오류로 죽습니다. 조용히 틀린 값을 내는 것보다 요란하게 죽는 것이 훨씬 고치기 쉽습니다.
4.5 범위 초과 (Buffer Overflow)
overflow.c:
#include <stdio.h>
#include <stdlib.h>

int main(void) {
    int *arr = malloc(5 * sizeof(int));
    for (int i = 0; i <= 5; i++) {   /* <= 때문에 한 칸 넘친다 */
        arr[i] = i * 10;
    }
    printf("arr[4] = %d\n", arr[4]);
    free(arr);
    return 0;
}
반복 조건이 i < 5 가 아니라 i <= 5 라서 arr[5], 즉 여섯 번째 칸에 씁니다. 4주차 10.1절에서 경고했던 off-by-one(하나 차이) 오류의 전형입니다.
$ gcc -Wall -Wextra -std=c11 -g overflow.c -o overflow
$ ./overflow
arr[4] = 40
$ echo $?
0
컴파일 경고 없음, 실행 정상, 종료 코드 0. 누수와 마찬가지로 아무 증상이 없습니다. 3.5절에서 본 대로 블록 뒤에는 malloc 의 관리 정보나 여유 공간이 있어서, 4바이트쯤 넘쳐 써도 당장은 티가 나지 않습니다. 넘친 자리에 다른 블록의 관리 정보가 있었다면 나중에 전혀 상관없는 malloc 이나 free 에서 프로그램이 죽고, 원인을 찾는 데 며칠이 걸립니다.
$ valgrind --leak-check=full ./overflow
...
==12345== Invalid write of size 4
==12345==    at 0x1091CD: main (overflow.c:7)
==12345==  Address 0x4aac054 is 0 bytes after a block of size 20 alloc'd
==12345==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==12345==    by 0x10919E: main (overflow.c:5)
- ① 7번째 줄에서 4바이트를 잘못 썼다(Invalid write). 읽기면
read, 쓰기면write로 구분해 줍니다. - ② 그 주소는 20바이트 블록의 끝에서 0바이트 뒤(0 bytes after a block of size 20). 20바이트 =
int5개. 블록이 끝난 바로 그 자리에 썼다는 뜻입니다.4 bytes after라면 한 칸을 건너뛰고 썼다는 뜻이 됩니다. - ③ 이번에는 해제된 블록이 아니라 살아 있는 블록이라,
free'd대신alloc'd로 할당 위치만 알려 줍니다.
4.3~4.5절의 ②번 줄을 비교해 보면, Valgrind 가 주소의 정체를 어떻게 설명하는지 패턴이 보입니다.
| ②번 줄 | 뜻 |
|---|---|
N bytes inside a block of size M free'd |
해제된 블록의 안쪽 → 해제 후 사용, 이중 해제 |
N bytes after a block of size M alloc'd |
살아 있는 블록의 끝을 넘어선 곳 → 범위 초과 |
N bytes before a block of size M alloc'd |
블록의 시작보다 앞 → 음수 인덱스 (arr[-1]) |
4.6 초기화 안 된 메모리 읽기
3.3절에서 malloc 이 준 메모리에는 쓰레기 값이 들어 있다고 했습니다. 그 값을 읽어서 판단에 쓰면 어떻게 될까요? uninit.c:
#include <stdio.h>
#include <stdlib.h>

int main(void) {
    int *arr = malloc(3 * sizeof(int));
    arr[0] = 1;                 /* arr[1], arr[2] 는 비워 둔다 */
    int sum = 0;
    for (int i = 0; i < 3; i++) {
        sum += arr[i];
    }
    if (sum > 10) {
        printf("큼\n");
    } else {
        printf("작음\n");
    }
    free(arr);
    return 0;
}
$ valgrind ./uninit
...
==12345== Conditional jump or move depends on uninitialised value(s)
==12345==    at 0x1091E4: main (uninit.c:11)
==12345==
작음
오류 이름이 독특합니다. “조건 분기가 초기화되지 않은 값에 따라 결정된다“. 11번째 줄은 if (sum > 10) 입니다. Valgrind 는 쓰레기 값을 읽는 순간에는 조용히 있다가, 그 값이 프로그램의 흐름을 바꾸는 순간(if, 반복 조건, 출력 등)에 오류를 냅니다. 쓰레기 값을 복사만 하는 것은 흔하고 무해할 수 있지만, 그 값으로 결정을 내리면 결과가 실행마다 달라질 수 있기 때문입니다.
그런데 11번째 줄은 결과가 드러난 곳일 뿐, 원인은 아닙니다. 쓰레기 값이 어디서 왔는지 알고 싶으면 --track-origins=yes 를 더합니다.
$ valgrind --track-origins=yes ./uninit
...
==12345== Conditional jump or move depends on uninitialised value(s)
==12345==    at 0x1091E4: main (uninit.c:11)
==12345==  Uninitialised value was created by a heap allocation
==12345==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==12345==    by 0x10919E: main (uninit.c:5)
“그 초기화 안 된 값은 5번째 줄의 힙 할당에서 생겼다”. 이제 원인(malloc 한 뒤 arr[1], arr[2] 를 채우지 않음)이 보입니다. 해결책은 전부 채우거나, calloc 으로 0 을 받는 것입니다. 느려지는 대신 정보가 많아지는 옵션이니, 이 종류의 오류가 나오면 켜세요.
3.3절의 malloc_basic 예제도 쓰레기 값을 일부러 출력하기 때문에 Valgrind 로 돌리면 이 오류가 20개 나옵니다. 교육용으로 쓰레기 값을 보여 주려고 남겨 둔 것입니다.
4.7 한눈에 보기
| 오류 | 그냥 실행하면 | GCC 경고 | Valgrind 메시지 |
|---|---|---|---|
| 누수 | 아무 일 없음 | 없음 | definitely lost (LEAK SUMMARY) |
| 이중 해제 | glibc 가 알아채면 중단 (134) | 가까우면 -Wuse-after-free |
Invalid free() |
| 해제 후 사용 | 엉뚱한 값, 정상 종료 | 가까우면 -Wuse-after-free |
Invalid read/write + inside a block ... free'd |
| 범위 초과 | 아무 일 없음 (나중에 엉뚱한 곳에서 터질 수 있음) | 대개 없음 | Invalid write/read + after a block ... alloc'd |
| 초기화 안 된 읽기 | 실행마다 다른 결과 | 가끔 (-Wuninitialized, 지역 변수) |
Conditional jump ... uninitialised |
힙이 아닌 주소 free |
중단 (134) | -Wfree-nonheap-object |
Invalid free() |
“그냥 실행하면” 열을 보세요. 다섯 가지 중 세 가지가 아무 증상 없이 지나갑니다. 프로그램이 한 번 잘 돌았다고 메모리를 올바르게 쓰고 있다는 뜻이 아닙니다. 그래서 이번 주부터는 동적 할당을 쓰는 프로그램을 만들 때마다 Valgrind 를 한 번씩 돌려서 ERROR SUMMARY: 0 errors 와 All heap blocks were freed -- no leaks are possible 를 확인하는 것을 습관으로 삼으세요. 1주차에서 “경고 0개”를 목표로 삼았던 것처럼요.
$ valgrind --leak-check=full ./build/dynamic_array 2>&1 | grep -E "All heap|ERROR SUMMARY"
==12345== All heap blocks were freed -- no leaks are possible
==12345== ERROR SUMMARY: 0 errors from 0 contexts (suppressed: 0 from 0)
Valgrind 는 자기 보고를 오류 출력(stderr) 으로 내보내고, 프로그램의 출력은 표준 출력으로 나옵니다. 2>&1 은 둘을 합쳐서 파이프로 넘기라는 뜻이고, grep -E "All heap|ERROR SUMMARY" 는 그중 두 줄만 골라냅니다. 이 두 줄이 이렇게 나오면 합격입니다.
5. 실전 예제
지금까지 배운 세 도구(이중 포인터, 동적 할당, 해제 규칙)를 모아서 실제로 쓸 만한 코드를 만들어 봅시다. 예제마다 마지막에 Valgrind 로 확인한 결과를 붙였습니다. 여러분도 따라 치고 나면 반드시 Valgrind 를 돌려서 같은 결과가 나오는지 보세요.
5.1 동적 문자열
C 의 문자열은 char 배열이라, 크기를 미리 정해야 하는 문제가 그대로 있습니다. 문자열을 복사하거나 이어 붙인 결과를 딱 필요한 크기만큼 동적으로 만들어 봅시다.
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

char *string_duplicate(const char *src) {
    if (src == NULL) return NULL;

    size_t len = strlen(src) + 1;          // +1 은 끝의 '\0' 자리
    char *dup = malloc(len);

    if (dup != NULL) {
        memcpy(dup, src, len);             // '\0' 까지 len 바이트 복사
    }
    return dup;
}

char *string_concat(const char *s1, const char *s2) {
    if (s1 == NULL || s2 == NULL) return NULL;

    size_t len1 = strlen(s1);
    size_t len2 = strlen(s2);
    char *result = malloc(len1 + len2 + 1);

    if (result != NULL) {
        memcpy(result, s1, len1);              // s1 의 글자들 (\0 은 빼고)
        memcpy(result + len1, s2, len2 + 1);   // 그 뒤에 s2 를 \0 까지
    }
    return result;
}

int main(void) {
    char *str1 = string_duplicate("Hello, ");
    char *str2 = string_duplicate("World!");
    char *str3 = string_concat(str1, str2);

    if (str3) {
        printf("%s\n", str3);
    }

    free(str1);
    free(str2);
    free(str3);

    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g strdup_demo.c -o strdup_demo && ./strdup_demo
Hello, World!
$ valgrind --leak-check=full ./strdup_demo 2>&1 | grep -E "All heap|ERROR SUMMARY"
==12345== All heap blocks were freed -- no leaks are possible
==12345== ERROR SUMMARY: 0 errors from 0 contexts (suppressed: 0 from 0)
+ 1 을 꼭 봐야 합니다. 1주차 6절에서 “C 문자열 끝에는 보이지 않는 \0 이 있다”고 했습니다. strlen("Hello, ") 은 7 이지만 실제로 필요한 메모리는 \0 까지 8바이트입니다. 이 + 1 을 빼먹으면 어떻게 될까요? string_duplicate 의 + 1 을 지우고 돌려 보았습니다.
$ ./strdup_bug
Hello, World!
$ valgrind ./strdup_bug
...
==12345== Invalid read of size 1
==12345==    at 0x484F234: strlen (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==12345==    by 0x10925F: string_concat (strdup_bug.c:20)
==12345==    by 0x109319: main (strdup_bug.c:34)
==12345==  Address 0x4aac047 is 0 bytes after a block of size 7 alloc'd
==12345==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==12345==    by 0x109202: string_duplicate (strdup_bug.c:9)
==12345==    by 0x1092EF: main (strdup_bug.c:32)
...
세 가지가 눈에 띕니다.
- 그냥 실행하면 여전히
Hello, World!가 멀쩡히 나옵니다. 7바이트 블록 바로 뒤에 우연히 0 이 있었기 때문입니다. 4.5절의 교훈 그대로입니다. - 오류가 난 곳은 복사한
string_duplicate가 아니라, 그 결과를 받아 쓴string_concat안의strlen입니다.\0이 없으니strlen이 끝을 찾아 블록 밖(0 bytes after a block of size 7)까지 읽어 나간 것입니다. 할당 위치(③)는string_duplicate를 가리키니, 두 정보를 합쳐야 원인이 보입니다. - 쓰기(
write)가 아니라 읽기(read) 오류입니다. 빠진 1바이트 때문에 쓰는 쪽은 넘치지 않았지만, 읽는 쪽이 넘쳤습니다. 실수한 곳과 증상이 나타난 곳이 다른 전형적인 경우입니다.
두 함수 모두 새 메모리를 만들어 돌려주므로, 받은 쪽(main)이 free 할 책임을 집니다. 함수 이름이나 주석에 “호출자가 해제해야 함”을 밝혀 두는 것이 좋습니다. 표준 라이브러리에도 strdup 이라는 같은 일을 하는 함수가 있는데(C23 부터 표준, 그 전에는 POSIX), 역시 free 는 호출자의 몫입니다.
string_concat 의 result + len1 은 6주차의 포인터 산술입니다. result 에서 len1 칸 뒤, 즉 s1 을 복사한 바로 다음 자리입니다.
5.2 동적 2차원 배열
크기를 실행 중에 정하는 2차원 배열(행렬)은 방법이 여러 가지입니다. examples/dynamic_2d_array.c 가 세 가지를 비교합니다.
$ ./build/dynamic_2d_array
방법 1: 포인터 배열 (행마다 따로 할당)
1.8절의 포인터 배열을 동적으로 만든 것입니다. 행 포인터들의 배열을 먼저 받고, 각 행을 따로 받습니다.
int **create_matrix(int rows, int cols) {
    int **matrix = malloc(rows * sizeof *matrix);     // 행 포인터 rows 개
    if (matrix == NULL) return NULL;

    for (int i = 0; i < rows; i++) {
        matrix[i] = calloc(cols, sizeof **matrix);    // 각 행: int cols 개
        if (matrix[i] == NULL) {
            // 중간에 실패하면 지금까지 받은 행들을 돌려주고 포기한다
            for (int j = 0; j < i; j++) {
                free(matrix[j]);
            }
            free(matrix);
            return NULL;
        }
    }
    return matrix;
}

void free_matrix(int **matrix, int rows) {
    if (matrix == NULL) return;

    for (int i = 0; i < rows; i++) {
        free(matrix[i]);        // 행들을 먼저
    }
    free(matrix);               // 행 포인터 배열은 마지막에
}
     matrix (int **)
┌────────────┐
│  주소 ─────┼──▶ ┌──────────┬──────────┬──────────┐
└────────────┘    │ 행0 주소  │ 행1 주소  │ 행2 주소  │   ← 행 포인터 배열 (힙)
                  └────┬─────┴────┬─────┴────┬─────┘
                       ▼          ▼          ▼
                    [1 2 3 4]  [5 6 7 8]  [9 10 11 12]  ← 각 행 (힙, 따로따로)
sizeof *matrix 는 int * 의 크기(8), sizeof **matrix 는 int 의 크기(4)입니다. 3.3절의 “변수 쪽 크기” 관용구가 이중 포인터에서도 그대로 통합니다. matrix[i][j] 는 “matrix[i] 로 i 번째 행의 주소를 얻고, 그 행의 j 번째 칸”입니다.
해제 순서가 중요합니다. 행 포인터 배열을 먼저 free 하면, 그 안에 있던 행들의 주소를 잃어버려서 4.2절의 indirectly lost 누수가 됩니다. 만든 순서의 반대로 해제하세요. 중간에 실패했을 때 지금까지 받은 것을 모두 돌려주는 create_matrix 의 실패 처리도 같은 원리입니다.
실제 주소를 보면 이 방법의 약점이 드러납니다.
=== 방법 1: 포인터 배열 ===
...
메모리 주소:
  행 0: 0x61cc1a4652d0
  행 1: 0x61cc1a4652f0
  행 2: 0x61cc1a465310
  (각 행이 다른 주소에 있음)
한 행은 int 4개 = 16바이트인데, 행과 행 사이는 32바이트(0x...2d0 → 0x...2f0) 떨어져 있습니다. 3.5절에서 본 malloc 의 관리 정보 때문입니다. 행을 따로 받을 때마다 관리 정보가 붙으니, 데이터 16바이트를 위해 32바이트를 쓰는 셈입니다. 그리고 행들이 메모리에 흩어질 수 있어서, 행을 넘어갈 때 CPU 캐시가 덜 효율적입니다(23주차 성능 최적화). 장점은 행마다 길이를 다르게 할 수 있다는 것입니다(들쭉날쭉한 배열, jagged array).
방법 2: 한 덩어리로 받고 행 포인터만 나누기
데이터 전체를 한 번에 받고, 행 포인터가 그 안을 나눠 가리키게 합니다.
=== 방법 2: 연속 메모리 할당 ===
...
메모리 주소:
  행 0: 0x61cc1a465330
  행 1: 0x61cc1a465340 (이전 행과 차이: 16 바이트)
  행 2: 0x61cc1a465350 (이전 행과 차이: 16 바이트)
  (연속된 메모리)
이번에는 행 사이가 정확히 16바이트입니다. 관리 정보 없이 데이터가 빈틈없이 이어져 있습니다. malloc 도 두 번(행 포인터 배열, 데이터 전체)만 부르니 해제도 두 번이면 끝납니다.
방법 3: 1차원 배열을 2차원처럼 쓰기
행 포인터조차 없이, rows * cols 칸짜리 1차원 배열 하나만 받고 인덱스를 계산합니다.
=== 방법 3: 구조체 기반 행렬 ===
...
인덱스 계산: arr[i][j] = data[i * cols + j]
예: arr[1][2] = data[1 * 4 + 2] = data[6] = 7
1.8절의 그림에서 본 것처럼, C 의 2차원 배열도 메모리에서는 한 줄로 이어진 1차원 배열이고, 컴파일러가 i * cols + j 를 대신 계산해 줄 뿐입니다. 이 방법은 그 계산을 우리가 직접 하는 것입니다. 데이터는 malloc 한 번, free 한 번이면 되고(예제는 행과 열 수를 함께 들고 다니려고 구조체를 하나 더 할당합니다), 메모리 낭비가 없고, 캐시 효율이 가장 좋습니다. 실무에서 이미지나 행렬 계산처럼 큰 2차원 데이터에는 거의 이 방법을 씁니다. 29주차 고성능 컴퓨팅에서 다시 만납니다.
| 방법 | malloc 횟수 |
행 길이 다르게 | 메모리 연속 | m[i][j] 문법 |
|---|---|---|---|---|
| 1. 행마다 따로 | rows + 1 | 가능 | 아님 | 됨 |
| 2. 한 덩어리 + 행 포인터 | 2 | 불가 | 연속 | 됨 |
| 3. 1차원 + 인덱스 계산 | 데이터 1 (예제는 구조체까지 2) | 불가 | 연속 | 안 됨 (data[i*cols+j]) |
5.3 연결 리스트 기초
동적 배열(3.7절)은 중간에 원소를 끼워 넣으려면 뒤의 원소들을 전부 한 칸씩 밀어야 합니다. 연결 리스트(linked list) 는 원소마다 따로 메모리를 받고, 각 원소가 다음 원소의 주소를 들고 있게 해서 사슬처럼 잇습니다.
#include <stdio.h>
#include <stdlib.h>

typedef struct Node {
    int data;              // 이 칸의 값
    struct Node *next;     // 다음 칸의 주소 (마지막이면 NULL)
} Node;

Node *create_node(int data) {
    Node *node = malloc(sizeof *node);
    if (node) {
        node->data = data;
        node->next = NULL;
    }
    return node;
}

void append(Node **head, int data) {
    Node *new_node = create_node(data);
    if (new_node == NULL) return;

    if (*head == NULL) {          // 빈 리스트: 새 노드가 머리가 된다
        *head = new_node;         // ← 호출자의 head 를 바꾼다 (이중 포인터!)
        return;
    }

    Node *current = *head;
    while (current->next != NULL) {   // 꼬리까지 걸어간다
        current = current->next;
    }
    current->next = new_node;
}

void print_list(Node *head) {
    for (Node *current = head; current != NULL; current = current->next) {
        printf("%d -> ", current->data);
    }
    printf("NULL\n");
}

void free_list(Node *head) {
    Node *current = head;
    while (current != NULL) {
        Node *next = current->next;   // free 하기 전에 다음 주소를 챙긴다
        free(current);
        current = next;
    }
}

int main(void) {
    Node *list = NULL;

    append(&list, 10);
    append(&list, 20);
    append(&list, 30);

    print_list(list);

    free_list(list);
    return 0;
}
10 -> 20 -> 30 -> NULL
 list
┌──────┐    ┌──────┬──────┐    ┌──────┬──────┐    ┌──────┬──────┐
│  ●───┼──▶ │  10  │  ●───┼──▶ │  20  │  ●───┼──▶ │  30  │ NULL │
└──────┘    └──────┴──────┘    └──────┴──────┘    └──────┴──────┘
             data   next        data   next        data   next
이번 주에 배운 것이 전부 들어 있습니다.
struct Node *next: 구조체가 자기 자신과 같은 타입을 가리키는 포인터를 품고 있습니다. 구조체 자체를 품을 수는 없지만(크기가 무한해지니까요), 포인터는 8바이트로 크기가 정해져 있으니 됩니다. 8주차에서 자세히 봅니다.append(Node **head, ...): 1.5절의 이중 포인터입니다. 리스트가 비어 있을 때는 새 노드가 머리가 되어야 하는데, 머리는main의list변수입니다. 호출자의 포인터를 바꿔야 하니&list를 넘깁니다.free_list의next챙기기:free(current)를 한 뒤에current->next를 읽으면 4.4절의 해제 후 사용입니다. 그래서 해제하기 전에 다음 주소를 따로 받아 둡니다. 연결 리스트 코드에서 가장 흔한 실수입니다.
Valgrind 로 확인하면 All heap blocks were freed -- no leaks are possible, ERROR SUMMARY: 0 errors 입니다. free_list 를 빼먹으면 4.2절에서 본 것처럼 첫 노드는 definitely lost, 나머지는 indirectly lost 로 나옵니다.
연결 리스트의 삽입·삭제·뒤집기, 이중 연결 리스트는 10주차에서 본격적으로 다룹니다. 6.2절의 프로젝트가 그 예고편입니다.
6. 프로젝트
projects/ 폴더의 네 프로젝트는 이번 주 내용을 하나씩 조합한 완성품입니다. 코드를 처음부터 끝까지 읽어 보고, 실행해 보고, Valgrind 로 돌려 보세요. 네 프로젝트 모두 이 글을 쓰면서 Valgrind 로 확인했고 ERROR SUMMARY: 0 errors 입니다.
dynamic_stack 과 linked_list 는 메뉴를 보여 주고 번호를 입력받는 대화형 프로그램입니다. 데모 번호를 입력하면 기능을 한 번에 보여 주고, 0 으로 끝냅니다. 입력을 파이프로 줄 수도 있습니다.
$ printf '8\n0\n' | ./build/dynamic_stack
printf '8\n0\n' 이 출력한 “8 엔터 0 엔터”가 프로그램의 키보드 입력 대신 들어갑니다. Valgrind 로 확인할 때도 이렇게 하면 됩니다.
6.1 동적 스택 (dynamic_stack)
스택(stack) 은 접시 쌓기처럼 마지막에 넣은 것을 먼저 꺼내는 자료구조입니다(Last In, First Out). 3.2절의 “스택 영역”도 함수 호출이 이 순서로 쌓이고 풀리기 때문에 붙은 이름입니다. 이 프로젝트는 3.7절의 동적 배열 위에 스택을 만들어서, 꽉 차면 두 배로 늘어납니다.
1. 여러 값 Push:
  Push 10: Stack: [10] (size=1, capacity=8)
  ...
  Push 80: Stack: [10, 20, 30, 40, 50, 60, 70, 80] (size=8, capacity=8)
  [스택 확장: 8 -> 16]
  Push 90: Stack: [10, 20, 30, 40, 50, 60, 70, 80, 90] (size=9, capacity=16)
  ...
2. 일부 값 Pop:
  Pop: 120 -> Stack: [10, 20, 30, 40, 50, 60, 70, 80, 90, 100, 110] (size=11, capacity=16)
  ...
4. 괄호 검사 시뮬레이션:
  수식: ((a+b)*(c-d))
  결과: 유효한 괄호
아홉 번째 push 에서 realloc 으로 용량이 8 → 16 이 되는 것이 보입니다. 마지막의 괄호 검사는 스택의 대표적인 쓰임새입니다. 여는 괄호를 만나면 넣고, 닫는 괄호를 만나면 꺼내서 짝이 맞는지 봅니다. 1주차 10절에서 GCC 가 “괄호가 안 맞는다”고 알려 줬던 것도 컴파일러 안에서 비슷한 일을 하기 때문입니다.
읽어 볼 곳: stack_push 의 확장 부분이 3.5절의 “임시 변수로 받는 realloc” 규칙을 지키는지, stack_clone(복제) 이 원본과 다른 메모리를 새로 받아 내용을 복사하는지(그래야 하나를 free 해도 다른 쪽이 멀쩡합니다).
6.2 연결 리스트 (linked_list)
5.3절의 기초를 완성한 버전입니다. 앞·뒤·중간 삽입, 세 가지 삭제, 검색, 정렬, 뒤집기를 모두 갖췄습니다. 11번(데모 실행)을 골라 봅시다.
$ printf '11\n0\n' | ./build/linked_list

연결 리스트
1. 데이터 삽입:
  push_back(30): List: 30 -> NULL (size=1)
  ...
  push_back(40): List: 30 -> 10 -> 50 -> 20 -> 40 -> NULL (size=5)

2. 앞에 삽입:
  push_front(5): List: 5 -> 30 -> 10 -> 50 -> 20 -> 40 -> NULL (size=6)

3. 중간에 삽입:
  insert_at(3, 25): List: 5 -> 30 -> 10 -> 25 -> 50 -> 20 -> 40 -> NULL (size=7)
...
6. 리스트 뒤집기:
  뒤집기 후: List: 50 -> 40 -> 30 -> 25 -> 20 -> 10 -> 5 -> NULL (size=7)

7. 값 삭제:
  remove(25): List: 50 -> 40 -> 30 -> 20 -> 10 -> 5 -> NULL (size=6)
insert_at(3, 25) 를 보세요. 동적 배열이었다면 25 를 넣기 위해 뒤의 50, 20, 40 을 한 칸씩 밀어야 했을 겁니다. 연결 리스트는 화살표 두 개만 바꾸면 됩니다. 10 의 next 가 25 를 가리키게 하고, 25 의 next 가 50 을 가리키게 하는 것이죠. 대신 3번째 자리를 찾으려면 머리부터 걸어가야 합니다. 배열처럼 arr[3] 으로 바로 갈 수 없습니다. 어느 쪽이 빠른지는 상황에 따라 다르고, 10주차 “배열 vs 리스트: 성능의 진실”에서 실제로 재 봅니다.
읽어 볼 곳: 리스트를 관리하는 구조체가 head 뿐 아니라 size 도 들고 있는 이유, remove 가 삭제할 노드의 앞 노드를 찾아야 하는 이유, 뒤집기가 prev, current, next 세 포인터를 어떻게 돌리는지를 종이에 5.3절 같은 그림을 그려 가며 따라가 보세요.
6.3 메모리 풀 (memory_pool)
malloc 을 아주 자주 부르는 프로그램(게임, 네트워크 서버)에서는 malloc 과 free 자체가 느려지고, 3.5절에서 본 관리 정보 때문에 메모리 낭비도 커집니다. 메모리 풀(memory pool) 은 큰 덩어리 하나를 미리 받아 두고, 같은 크기의 작은 블록으로 잘라서 직접 나눠 주고 돌려받는 방법입니다. 우리만의 작은 malloc 을 만드는 셈입니다.
$ ./build/memory_pool
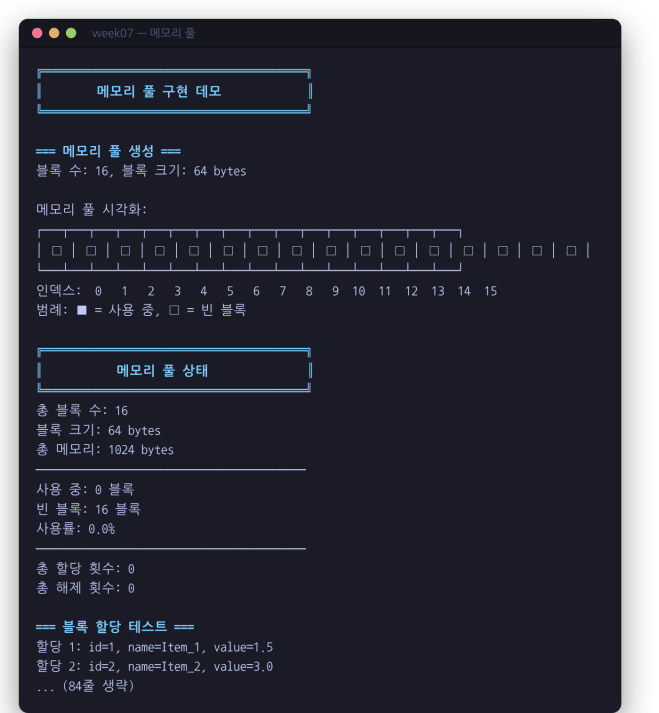
메모리 풀
64바이트 블록 16개, 1024바이트짜리 풀을 만들고 10개를 할당하면 이렇게 됩니다.
=== 블록 할당 테스트 ===
할당 1: id=1, name=Item_1, value=1.5
...
할당 10: id=10, name=Item_10, value=15.0

메모리 풀 시각화:
┌───┬───┬───┬───┬───┬───┬───┬───┬───┬───┬───┬───┬───┬───┬───┬───┐
│ □ │ □ │ □ │ □ │ □ │ □ │ ■ │ ■ │ ■ │ ■ │ ■ │ ■ │ ■ │ ■ │ ■ │ ■ │
└───┴───┴───┴───┴───┴───┴───┴───┴───┴───┴───┴───┴───┴───┴───┴───┘
인덱스:  0   1   2   3   4   5   6   7   8   9  10  11  12  13  14  15
수수께끼: 10개를 할당했는데 0번부터가 아니라 15번부터 거꾸로 채워졌습니다. 왜일까요?
pool_alloc 의 코드를 보면 답이 있습니다.
int block_index = pool->free_list[--pool->free_count];
빈 블록 번호들을 free_list 라는 배열에 0, 1, 2, ..., 15 순서로 넣어 두고, 맨 뒤에서부터 꺼내 씁니다. 6.1절의 스택과 같은 방식입니다. 맨 뒤에서 꺼내면 원소를 옮길 필요 없이 개수만 하나 줄이면 되니 가장 빠릅니다. 그래서 첫 할당은 15번, 다음은 14번… 이 됩니다.
그다음 세 개를 해제합니다.
=== 일부 블록 해제 ===
data[2], data[5], data[7] 해제 (풀 블록 번호: 13, 10, 8)

메모리 풀 시각화:
┌───┬───┬───┬───┬───┬───┬───┬───┬───┬───┬───┬───┬───┬───┬───┬───┐
│ □ │ □ │ □ │ □ │ □ │ □ │ ■ │ ■ │ □ │ ■ │ □ │ ■ │ ■ │ □ │ ■ │ ■ │
└───┴───┴───┴───┴───┴───┴───┴───┴───┴───┴───┴───┴───┴───┴───┴───┘
data[2] 는 세 번째로 할당받은 것이니 13번 블록, data[5] 는 10번, data[7] 은 8번입니다. 변수의 번호와 블록의 번호는 다릅니다. 이 예제는 원래 “인덱스 2, 5, 7 해제”라고만 출력해서, 그림에서 13, 10, 8 이 비는 것과 맞지 않아 보였습니다. 이번에 실제 블록 번호를 함께 찍도록 고쳤습니다.
해제된 블록 번호는 다시 free_list 의 맨 뒤에 들어가므로, 다음 할당은 가장 최근에 해제된 8번 블록을 받습니다. 실제 glibc 의 malloc 도 최근 해제된 블록을 먼저 재사용합니다(4.3절의 tcache 가 바로 그것입니다). 3.6절에서 “해제 후 사용이 당장은 멀쩡해 보이는” 이유가 이 재사용 순서에 있습니다.
읽어 볼 곳: pool_free 가 잘못된 포인터를 어떻게 걸러 내는지. 이 풀에서 나간 주소인지(범위 검사), 블록의 시작 주소인지(나머지 검사), 이미 빈 블록인지(이중 해제 검사)를 차례로 확인합니다. 4절에서 glibc 와 Valgrind 가 잡아 줬던 오류들을 우리 코드가 직접 잡는 것입니다.
6.4 문자열 빌더 (string_builder)
5.1절의 동적 문자열을 3.7절의 “꽉 차면 늘리기”와 합친 것입니다. 글자를 계속 이어 붙여도 알아서 용량을 늘려 줍니다.
=== 문자열 추가 ===
append("Hello"): "Hello"
append(", "): "Hello, "
append("World"): "Hello, World"
append_char('!'): "Hello, World!"
길이: 13, 용량: 16, 사용률: 81.2%
...
=== 대량 추가 (자동 확장) ===
초기 길이: 0, 용량: 44, 사용률: 0.0%
20개 아이템 추가 후:
내용: "Item0 Item1 Item2 ... Item19 "
길이: 130, 용량: 176, 사용률: 73.9%
길이(length) 와 용량(capacity) 이 따로 있다는 것이 핵심입니다. 길이는 지금 들어 있는 글자 수, 용량은 받아 둔 메모리 크기입니다. 용량이 넉넉하면 realloc 없이 바로 붙이고, 모자랄 때만 늘립니다. 문자열을 한 글자씩 수천 번 붙이는 프로그램에서 이 차이가 속도를 좌우합니다.
읽어 볼 곳: 용량을 셀 때 \0 자리 1바이트를 어떻게 따로 챙기는지, insert 와 delete 가 memmove 로 뒤쪽 글자들을 미는 방법. memcpy 대신 memmove 를 쓰는 이유는, 옮기는 원본과 목적지가 겹칠 때 memcpy 는 결과를 보장하지 않기 때문입니다.
7. 메모리 관리 모범 사례
4절에서 본 오류들은 대부분 “이 메모리를 누가 해제하지?” 가 불분명해서 생깁니다. 그래서 규칙들은 결국 소유권(ownership) 을 분명히 하는 방법입니다.
7.1 소유권 규칙
규칙 1: 해제할 책임은 한 곳에만. 어떤 메모리든 “이것을 free 할 책임이 있는 코드”가 정확히 하나여야 합니다. 둘이면 이중 해제, 없으면 누수입니다.
규칙 2: 만들고 없애는 함수를 짝으로. 3.7절의 create_person / destroy_person 처럼, 무언가를 할당해서 돌려주는 함수를 만들었다면 그것을 정리하는 함수도 함께 만듭니다. 사용하는 쪽은 안에서 malloc 을 몇 번 했는지 몰라도 destroy 한 번만 부르면 됩니다.
Person *create_person(const char *name, int age);   // 호출자가 소유권을 받는다
void destroy_person(Person *p);                     // 소유권을 돌려준다
규칙 3: 새 메모리를 돌려주는 함수는 그렇다고 밝힌다. 5.1절의 string_duplicate 처럼 새로 할당한 메모리를 돌려주는 함수는, 이름(create_, _dup, _new)이나 주석으로 “호출자가 해제해야 한다”를 드러냅니다. 반대로 strlen 처럼 빌려 보기만 하는 함수에 넘긴 메모리는 여전히 호출자 것입니다.
규칙 4: 실패하면 받은 것을 모두 돌려주고 나간다. 5.2절의 create_matrix 처럼, 여러 번 할당하다 중간에 실패하면 그때까지 받은 것을 역순으로 전부 해제하고 실패를 알립니다. 반쯤 만들어진 것을 돌려주면 호출자는 무엇을 해제해야 할지 알 수 없습니다.
7.2 해제와 NULL 을 한 번에
free(p); p = NULL; 두 줄을 매번 쓰기 번거로워서, 흔히 이런 도우미를 만듭니다. 예전 글에는 이렇게 적혀 있었습니다.
// 흔히 보이지만 권하지 않는 방법
void safe_free(void **ptr) {
    if (ptr != NULL && *ptr != NULL) {
        free(*ptr);
        *ptr = NULL;
    }
}

int *arr = malloc(10 * sizeof *arr);
safe_free((void **)&arr);
1.5절의 이중 포인터로 호출자의 변수를 NULL 로 바꾸는 발상은 좋습니다. 그런데 (void **)&arr 이 문제입니다. void * 는 어떤 데이터 포인터로든 자동 변환되지만, void ** 는 그렇지 않습니다. int ** 를 void ** 로 억지로 바꿔서 그 안에 쓰는 것은 C 표준이 보장하지 않는 동작입니다. 우리 컴퓨터에서는 모든 포인터가 같은 8바이트 모양이라 우연히 동작할 뿐입니다. 캐스트를 빼면 GCC 가 바로 incompatible pointer type 경고를 냅니다(2.3절에서 본 그 경고입니다).
더 안전한 방법은 매크로입니다. 매크로는 전처리기가 코드를 그대로 바꿔 끼우는 것이라(1주차 7절), 타입 변환 없이 원래 변수에 직접 NULL 을 넣습니다.
#define FREE_AND_NULL(p) do { free(p); (p) = NULL; } while (0)

int *arr = malloc(10 * sizeof *arr);
FREE_AND_NULL(arr);          // free(arr); arr = NULL; 로 바뀐다
do { ... } while (0) 은 여러 문장짜리 매크로를 if 문 안에서도 안전하게 쓰기 위한 C 의 오래된 관용구입니다. 함수처럼 쓰는 매크로의 함정들은 11주차에서 자세히 다룹니다.
7.3 할당 실패 처리
malloc 이 실패할 때마다 같은 오류 처리를 반복하기 싫다면, 실패하면 프로그램을 끝내는 도우미를 만들기도 합니다.
void *xmalloc(size_t size) {
    void *ptr = malloc(size);
    if (ptr == NULL && size > 0) {
        fprintf(stderr, "메모리 할당 실패: %zu bytes\n", size);
        exit(EXIT_FAILURE);
    }
    return ptr;
}
exit(EXIT_FAILURE) 는 프로그램을 즉시 끝내고 쉘에 실패(1)를 알립니다(1주차 5절의 종료 코드). 작은 도구 프로그램에서는 “메모리가 없으면 할 수 있는 게 없다”가 합리적이라 이 방식을 많이 씁니다. 반면 라이브러리나 서버는 함부로 끝나면 안 되므로, NULL 을 돌려받아 호출자에게 실패를 알리는 쪽을 택합니다. 이름 앞의 x 는 “실패하면 끝내는 버전”이라는 관례적 표시입니다.
7.4 C 식 자원 관리: 만들기 함수 안에서 정리까지
구조체가 여러 동적 메모리를 품고 있으면, 만들다 실패했을 때의 정리가 복잡해집니다.
typedef struct {
    int *data;
    size_t size;
} Resource;

Resource *resource_create(size_t size) {
    Resource *r = malloc(sizeof *r);
    if (r == NULL) {
        return NULL;
    }
    r->data = calloc(size, sizeof *r->data);
    if (r->data == NULL) {
        free(r);                 // 바깥 껍데기도 돌려준다 (규칙 4)
        return NULL;
    }
    r->size = size;
    return r;
}

void resource_destroy(Resource *r) {
    if (r != NULL) {
        free(r->data);           // 안쪽 먼저
        free(r);                 // 바깥은 나중에 (5.2절의 해제 순서)
    }
}
C++ 같은 언어에는 변수가 사라질 때 정리 함수를 자동으로 불러 주는 기능(RAII)이 있지만, C 에는 없습니다. 그래서 C 에서는 이렇게 만드는 함수가 실패를 스스로 정리하고, 없애는 함수가 안쪽부터 바깥쪽 순서로 정리하는 규칙을 사람이 지킵니다. 규칙을 지켰는지는 Valgrind 가 확인해 줍니다.
8. 정리
이번 주의 세 가지 답
| 질문 | 답 | 핵심 한 줄 |
|---|---|---|
| 함수가 호출자의 포인터를 바꾸려면? | 이중 포인터 T ** |
바꾸고 싶은 것의 주소를 넘긴다. int * 를 바꾸려면 int ** |
| “동작”을 값처럼 넘기려면? | 함수 포인터 R (*f)(A) |
함수 이름은 코드의 주소. 타입(반환·매개변수)이 정확히 맞아야 한다 |
| 크기를 실행 중에 정하려면? | 동적 할당 | malloc/calloc/realloc 으로 빌리고, free 로 정확히 한 번 돌려준다 |
선언 읽기
| 선언 | 뜻 |
|---|---|
int **pp |
int 포인터를 가리키는 포인터 |
int *a[5] |
int 포인터 5개짜리 배열 (포인터 배열) |
int (*p)[5] |
int 5개짜리 배열을 가리키는 포인터 (배열 포인터) |
int *f(int) |
int 포인터를 돌려주는 함수 |
int (*f)(int) |
int 를 받아 int 를 돌려주는 함수를 가리키는 포인터 |
오른쪽-왼쪽 규칙: 이름에서 시작해서 오른쪽([], ())을 먼저, 그다음 왼쪽(*), 괄호를 만나면 밖으로.
동적 메모리 함수
| 함수 | 인자 | 내용 | 실패하면 | 기억할 것 |
|---|---|---|---|---|
malloc(size) |
바이트 수 | 쓰레기 값 | NULL | n * sizeof *p 로 크기 계산. 곱셈 오버플로 주의 |
calloc(n, size) |
개수, 크기 | 0 | NULL | 곱셈 오버플로를 검사해 준다 |
realloc(p, size) |
기존 주소, 새 바이트 수 | 앞부분 보존, 늘어난 곳은 쓰레기 값 | NULL (원본 유지) | 주소가 바뀔 수 있다. 임시 변수로 받는다 |
free(p) |
받은 주소 그대로 | — | — | free(NULL) 은 안전. 포인터 변수는 안 바뀐다 → p = NULL |
메모리 오류와 Valgrind 메시지
| 오류 | Valgrind 가 말하는 것 |
|---|---|
| 누수 | definitely lost / indirectly lost |
| 이중 해제 | Invalid free() |
| 해제 후 사용 | Invalid read/write + inside a block of size N free'd |
| 범위 초과 | Invalid read/write + after a block of size N alloc'd |
| 초기화 안 된 읽기 | Conditional jump or move depends on uninitialised value(s) (--track-origins=yes 로 출처 확인) |
Valgrind 오류 보고는 항상 ① 무슨 일이, 어디서 ② 그 주소의 정체 ③ 그 블록의 출생지 순서입니다.
체크리스트
이번 주를 마쳤다면 스스로 확인해 보세요. 각 항목을 설명할 수 있으면 체크합니다.
- [ ] 함수에
int *를 넘겨서는 호출자의 포인터를 바꿀 수 없는 이유를 그림으로 설명할 수 있다 - [ ]
pp,*pp,**pp의 타입과 값을 실제 주소로 설명할 수 있다 - [ ]
int *a[5]와int (*p)[5]의sizeof와+ 1의 차이를 안다 - [ ] 오른쪽-왼쪽 규칙으로 함수 포인터 선언을 읽을 수 있다
- [ ] 콜백 함수를 만들어 넘길 수 있고,
qsort비교 함수를 오버플로 없이 쓸 수 있다 - [ ]
/proc/self/maps나 주소 출력으로 코드·데이터·BSS·힙·스택 영역을 확인할 수 있다 - [ ]
malloc의 인자, 반환값, 실패했을 때의 동작을 안다 - [ ]
malloc(n * size)가 위험할 수 있고calloc(n, size)가 안전한 이유를 안다 - [ ]
realloc의 반환값을 원래 포인터에 바로 받으면 안 되는 이유를 안다 - [ ]
free뒤에 포인터를 NULL 로 두는 이유를 안다 - [ ] 누수, 이중 해제, 해제 후 사용, 범위 초과, 초기화 안 된 읽기를 직접 만들고 Valgrind 로 잡아 봤다
- [ ] Valgrind 출력의
at/by줄을 따라가 원인이 된 소스 줄을 찾을 수 있다 - [ ] 동적 할당을 쓰는 프로그램마다 Valgrind 로
0 errors,no leaks are possible을 확인하는 습관을 들였다
연습 문제
각 문제를 풀고 나면 Valgrind 로 0 errors 와 누수 없음을 확인하는 것까지가 한 문제입니다.
기초
- 포인터 교환: 두
int *변수가 가리키는 대상을 서로 맞바꾸는 함수void swap_ptr(int **a, int **b)를 작성하세요.int값을 바꾸는 6주차의swap과 무엇이 다른지 설명해 보세요. (examples/pointer_to_pointer.c의 “포인터 교환”과 비교) - 함수 포인터 계산기:
+ - * /네 연산을 함수 포인터 배열로 만들고, 사용자에게3 + 4처럼 입력받아 계산하세요. 0 으로 나누기는 어떻게 처리할까요? - 입력한 개수만큼: 몇 개의 정수를 입력할지 먼저 묻고, 그만큼
malloc해서 입력받은 뒤 합계와 평균을 출력하세요. 개수로 음수나 아주 큰 수를 넣으면 어떻게 되는지도 시험해 보세요. - 선언 읽기: 다음을 오른쪽-왼쪽 규칙으로 한국어로 읽어 보세요.
char *names[10];,double (*fp)(double, double);,int (*table[4])(int, int);,char **(*get_list)(void);
중급
- 동적 스택:
realloc으로 두 배씩 늘어나는 정수 스택을 직접 만드세요(push,pop,peek,destroy).projects/dynamic_stack.c는 다 만든 뒤에 비교용으로만 보세요. - 한 줄 읽기: 키보드에서 길이 제한 없이 한 줄을 읽어 동적 문자열로 돌려주는
char *read_line(void)를 작성하세요.getchar로 한 글자씩 읽고, 모자라면realloc으로 늘립니다. 입력이 끝났을 때(EOF)도 처리하세요. - 행렬 곱셈: 5.2절의 세 방법 중 하나로 크기를 입력받는 행렬 두 개를 만들고 곱하세요.
examples/dynamic_2d_array.c의 “행렬 곱셈 예제” 결과(58 64 / 139 154)로 검산할 수 있습니다. - qsort 활용: 문자열 배열(
char *words[])을qsort와strcmp로 사전 순 정렬하세요. 비교 함수가 받는const void *가 실제로는char **라는 점이 함정입니다. 왜 그런지 설명해 보세요.
심화
- 연결 리스트 완성: 5.3절의 코드에
push_front,remove_value,find,reverse를 추가하세요.reverse는 새 노드를 만들지 말고 화살표만 뒤집어야 합니다. - 일부러 망가뜨리기: 9번의 코드에서 4절의 다섯 가지 오류를 하나씩 일부러 넣고, Valgrind 가 각각을 어떤 메시지로 잡는지 기록하세요. 그중 Valgrind 없이 실행했을 때 아무 증상도 없는 것이 몇 개인지 세어 보세요.
- 메모리 풀 확장:
projects/memory_pool.c를 고쳐서, 풀이 가득 찼을 때 실패하는 대신 두 번째 풀을 새로 만들어 이어 붙이게 해 보세요.
다음 주 예고
이번 주에 구조체를 여러 번 “미리” 썼습니다. Person, Node, DynamicArray… 다음 주에는 이 구조체를 제대로 배웁니다.
8주차: 구조체와 공용체 – 구조체는 메모리에 어떤 모양으로 놓일까? Node 가 12바이트가 아니라 16바이트였던 이유(4.2절) – p->name 과 (*p).name 은 정말 같을까? – 구조체를 함수에 통째로 넘기는 것과 포인터로 넘기는 것의 차이 – 하나의 메모리를 여러 타입으로 읽는 공용체(union) – 이름 붙은 상수 목록, 열거형(enum) – typedef 로 struct 를 매번 쓰지 않는 법
예제 코드
이 글의 예제는 week07 폴더에 있습니다. make 로 빌드하면 실행 파일이 build/ 에 만들어집니다.
examples/ — 개념별 예제
| 파일 | 내용 | 글의 위치 |
|---|---|---|
double_pointer.c |
이중 포인터 기초, 실제 주소 표 | 1.2~1.4 |
pointer_to_pointer.c |
함수에서 포인터 수정 (잘못된 방법의 누수 포함) | 1.1, 1.5, 3.6, 4.1 |
func_pointer_basic.c |
함수 포인터 선언과 호출, typedef | 2.1~2.4 |
func_pointer_callback.c |
콜백: foreach, filter, map, reduce, 정렬 | 2.5, 2.6 |
func_pointer_array.c |
함수 포인터 배열(점프 테이블), 함수 포인터 반환 | 2.7, 2.8 |
malloc_basic.c |
malloc 과 free, 초기화 안 된 값 | 3.3 |
calloc_realloc.c |
calloc 과 realloc | 3.4, 3.5 |
dynamic_array.c |
두 배로 늘어나는 동적 배열 | 3.7 |
dynamic_2d_array.c |
동적 2차원 배열 세 가지 방법, 행렬 곱셈 | 5.2 |
memory_errors.c |
메모리 오류 일곱 가지의 잘못된/올바른 코드 | 4 |
projects/ — 조합 프로젝트
| 파일 | 내용 | 글의 위치 |
|---|---|---|
dynamic_stack.c |
동적 스택, 괄호 검사 | 6.1 |
linked_list.c |
단순 연결 리스트 (삽입·삭제·검색·정렬·뒤집기) | 6.2 |
memory_pool.c |
고정 크기 블록 메모리 풀 | 6.3 |
string_builder.c |
자동으로 늘어나는 문자열 | 6.4 |