들어가며
3주차에서 조건문과 반복문을 배웠습니다. 이제 프로그램이 “상황에 따라 다르게”, “같은 일을 여러 번” 할 수 있게 됐습니다. 그런데 한 가지 불편한 점이 남아 있습니다. 지금까지 우리가 다룬 변수는 값을 딱 하나씩만 담을 수 있었습니다.
학생 다섯 명의 점수를 저장해야 한다고 해 봅시다. 2주차에서 배운 방법으로는 이렇게 할 수밖에 없습니다.
int score1 = 85;
int score2 = 90;
int score3 = 78;
int score4 = 92;
int score5 = 88;
다섯 명이면 참을 만합니다. 그런데 한 반이 30명이라면? 전교생 500명이라면? 게다가 3주차에서 배운 for 반복문은 이 변수들을 차례로 돌 수가 없습니다. score1, score2 는 이름이 다른 별개의 변수라서, “i번째 점수”라는 말을 코드로 쓸 방법이 없기 때문입니다.
이 문제를 푸는 것이 배열(array) 입니다. 같은 종류의 값 여러 개를 하나의 이름 아래 번호를 붙여 나란히 저장하는 방법입니다. 배열을 쓰면 위 다섯 줄이 이렇게 됩니다.
int scores[5] = {85, 90, 78, 92, 88};
그리고 “i번째 점수”는 scores[i] 로 쓸 수 있습니다. 반복문과 배열이 만나면, 500명이든 5만 명이든 코드 길이는 똑같습니다.
이번 주의 두 번째 주제는 문자열(string) 입니다. 1주차부터 우리는 "Hello, World!\n" 같은 문자열을 계속 써 왔습니다. 그런데 문자열이 메모리에 정확히 어떤 모양으로 들어 있는지는 아직 본 적이 없습니다. 1주차 6절에서 “C 문자열은 \0 으로 끝난다”는 말을 한 줄 하고 넘어갔는데, 이번 주에 그 한 줄의 의미를 제대로 파헤칩니다. 미리 말하면 C의 문자열은 그냥 char 배열입니다. 그래서 배열을 이해하면 문자열이 저절로 이해되고, 배열에서 조심해야 할 것은 문자열에서도 똑같이 조심해야 합니다.
이번 주는 길고, 중요합니다. C가 “위험한 언어”라는 소리를 듣는 이유의 절반이 이번 주 내용에 있습니다. 배열의 칸 밖을 건드려도 C는 막지 않고, 문자열 끝의 \0 한 칸을 잊으면 프로그램이 엉뚱한 메모리를 읽습니다. 이 글에서는 그 사고를 일부러 내 보고, 화면에 무엇이 찍히는지 직접 확인합니다. 한 번 눈으로 본 사고는 다시 내지 않게 됩니다.
이번 주에 배울 것
| 절 | 내용 | 한 줄 요약 |
|---|---|---|
| 1~3 | 배열 선언, 초기화, 메모리 모양 | 같은 타입의 칸이 주소 순서대로 붙어 있다 |
| 4 | 배열의 경계 | C는 칸 밖을 막지 않는다. 직접 확인한다 |
| 5~7 | 반복문, 함수, 정렬 | 배열을 도는 패턴과 버블 정렬 |
| 8 | 2차원 배열 | 표 모양이지만 메모리에서는 한 줄 |
| 9~10 | 문자와 문자열, 입출력 | 문자열 = char 배열 + \0 |
| 11~13 | string.h 함수와 안전한 사용법, 직접 구현 |
크기를 모르는 함수와 아는 함수 |
| 14~15 | ctype.h, 문자열 배열 |
문자 분류와 이름 목록 |
| 16 | 실습 프로젝트 4개 | 문자열 뒤집기, 단어 세기, 시저 암호, 성적 관리 |
이번 주 예제 준비
이번 주 예제는 저장소의 week04 폴더에 있습니다. examples 에 개념 예제 17개, projects 에 실습 프로젝트 4개가 들어 있습니다. 1주차에서 배운 명령으로 하나씩 컴파일해도 되고,
$ cd week04
$ gcc -Wall -Wextra -std=c11 examples/array_basic.c -o array_basic && ./array_basic
폴더에 들어 있는 Makefile 로 한꺼번에 만들 수도 있습니다.
$ make
$ ./build/examples/array_basic
make 는 5주차에 직접 만들어 볼 도구입니다. 지금은 “Makefile 에 적힌 대로 gcc 명령들을 대신 쳐 주는 프로그램”이라고만 알아 두세요. 실행 파일은 build/examples/, build/projects/ 에 생깁니다.
이 글의 모든 출력과 오류 메시지는 우분투 24.04, GCC 13.3 에서 실제로 실행한 결과입니다. 주소처럼 실행할 때마다 달라지는 값은 여러분 화면에서 다르게 나오는 것이 정상입니다.
1. 배열이란?
메모리 속 사물함
배열을 가장 잘 설명하는 비유는 번호가 붙은 사물함입니다. 복도에 같은 크기의 사물함이 한 줄로 쭉 붙어 있고, 문마다 0, 1, 2, 3… 번호가 적혀 있습니다. 사물함 줄 전체에는 scores 같은 이름표가 하나 붙어 있고요.
int scores[5]; 라고 쓰면 컴퓨터 메모리에 정확히 이런 모양이 만들어집니다.
이름표: scores
         ┌────────┬────────┬────────┬────────┬────────┐
  값     │   ?    │   ?    │   ?    │   ?    │   ?    │
         └────────┴────────┴────────┴────────┴────────┘
  번호     [0]      [1]      [2]      [3]      [4]
  크기    4바이트  4바이트  4바이트  4바이트  4바이트    = 총 20바이트
세 가지를 기억하세요.
- 칸은 모두 같은 종류(타입)입니다.
int배열의 칸에는int만 들어갑니다. 한 칸은int, 옆 칸은double같은 것은 안 됩니다(그런 묶음은 8주차의 구조체가 합니다). - 칸은 메모리에 빈틈없이 붙어 있습니다. 이것이 배열의 핵심 성질이고, 곧 직접 주소를 찍어서 확인합니다.
- 번호는 0부터 시작합니다. 5칸짜리 배열의 번호는 0, 1, 2, 3, 4입니다. 5번 칸은 없습니다.
배열 선언의 생김새
int scores[5];
이 한 줄을 조각내 봅시다.
| 조각 | 뜻 |
|---|---|
int |
칸 하나에 들어갈 값의 타입 (요소 타입) |
scores |
배열 전체의 이름 |
[5] |
칸의 개수 (배열의 크기, 길이) |
; |
문장 끝 |
다른 타입도 똑같은 모양입니다.
int    scores[5];      // int 5칸   → 4바이트 × 5 = 20바이트
double temps[7];       // double 7칸 → 8바이트 × 7 = 56바이트
char   name[20];       // char 20칸 → 1바이트 × 20 = 20바이트
2주차 10절에서 sizeof(int) 가 4, sizeof(double) 이 8, sizeof(char) 가 1이라는 것을 확인했습니다. 배열 전체의 크기는 칸 하나의 크기 × 칸 수입니다.
크기 자리에는 컴파일할 때 값이 정해진 정수를 쓰는 것이 원칙입니다. 숫자를 직접 쓰거나, 2주차 8절에서 배운 #define 상수를 씁니다.
#define NUM_STUDENTS 30

int scores[NUM_STUDENTS];     // 좋은 습관: 크기에 이름을 붙인다
나중에 학생 수가 바뀌면 #define 한 줄만 고치면 됩니다. 크기 30 을 코드 여기저기에 직접 쓰면, 바꿀 때 한 군데를 빠뜨리기 쉽습니다.
변수로 크기를 정하면?
int n = 30; int a[n];처럼 변수로 크기를 정하는 것도 C99부터 가능합니다. 이것을 가변 길이 배열(VLA) 이라고 합니다. 그런데 이렇게 만든 배열은= {0}으로 초기화할 수 없고(error: variable-sized object may not be initialized except with an empty initializer), 크기가 너무 크면 프로그램이 죽는 등 까다로운 점이 많아서 C11부터는 컴파일러가 지원하지 않아도 되는 선택 기능이 되었습니다. 이 강좌에서는 쓰지 않습니다. 크기가 실행 중에 정해져야 하는 경우는 10주차의 동적 메모리로 해결합니다.
칸에 접근하기: 인덱스
배열의 각 칸을 요소(element), 칸 번호를 인덱스(index) 라고 합니다. 요소에 접근할 때는 배열 이름 뒤에 대괄호로 번호를 씁니다.
int scores[5];

scores[0] = 85;     // 0번 칸에 85를 넣는다 (첫 번째 요소)
scores[1] = 90;     // 1번 칸에 90
scores[4] = 88;     // 4번 칸에 88 (마지막 요소)

printf("%d\n", scores[1]);    // 90 출력
scores[1] 은 그 자체로 int 변수 하나처럼 동작합니다. 대입도 되고(scores[1] = 90), 계산에 써도 되고(scores[1] + 5), printf 에 넘겨도 됩니다.
그리고 여기가 배열의 진짜 힘입니다. 대괄호 안에 변수를 쓸 수 있습니다.
int i = 3;
scores[i] = 92;     // scores[3] = 92 와 같다
i 를 반복문으로 0부터 4까지 바꾸면, 코드 한 줄로 다섯 칸을 모두 다룰 수 있습니다. score1 ~ score5 로는 절대 할 수 없던 일입니다.
왜 0부터 시작할까?
사람은 1부터 세는데, C는 왜 0부터 셀까요? 인덱스의 정체가 “첫 칸에서 몇 칸 떨어져 있는가” 이기 때문입니다.
- 첫 번째 칸은 첫 칸에서 0칸 떨어져 있으니
[0] - 두 번째 칸은 1칸 떨어져 있으니
[1] - 다섯 번째 칸은 4칸 떨어져 있으니
[4]
컴퓨터는 scores[i] 를 보면 “scores 의 시작 주소 + i × 4바이트” 위치를 읽습니다. 번호가 곧 거리이니, 0부터 시작해야 계산이 가장 간단합니다. 이 계산은 말로만 하지 말고 직접 확인해 봅시다.
실험: 배열은 정말 붙어 있을까?
모든 변수는 메모리 어딘가에 자리를 차지하고, 그 자리에는 주소라는 번호가 있습니다. 변수 이름 앞에 & 를 붙이면 주소를 얻을 수 있고, printf 의 %p 로 출력할 수 있습니다. 2주차 7절에서 scanf("%d", &age) 에 붙였던 바로 그 & 입니다. “이 변수의 위치를 알려 줄 테니 거기에 넣어 달라”는 뜻이었죠.
addr.c:
#include <stdio.h>

int main(void) {
    int scores[5] = {85, 90, 78, 92, 88};

    for (int i = 0; i < 5; i++) {
        printf("scores[%d] = %d, 주소 = %p\n", i, scores[i], (void *)&scores[i]);
    }
    printf("sizeof(scores) = %zu, sizeof(scores[0]) = %zu\n",
           sizeof(scores), sizeof(scores[0]));
    printf("scores      = %p\n", (void *)scores);
    printf("&scores[0]  = %p\n", (void *)&scores[0]);
    return 0;
}
(void *) 는 %p 에 주소를 넘길 때 붙이는 형식입니다. 6주차 포인터에서 이유를 배우니 지금은 “주소를 출력할 때 붙이는 것”으로 받아들이세요.
$ gcc -Wall -Wextra -std=c11 addr.c -o addr && ./addr
scores[0] = 85, 주소 = 0x7ffec7b6bb90
scores[1] = 90, 주소 = 0x7ffec7b6bb94
scores[2] = 78, 주소 = 0x7ffec7b6bb98
scores[3] = 92, 주소 = 0x7ffec7b6bb9c
scores[4] = 88, 주소 = 0x7ffec7b6bba0
sizeof(scores) = 20, sizeof(scores[0]) = 4
scores      = 0x7ffec7b6bb90
&scores[0]  = 0x7ffec7b6bb90
주소는 0x 로 시작하는 16진수입니다. 끝자리만 보세요. ...b90, ...b94, ...b98, ...b9c, ...ba0. 정확히 4씩 늘어납니다(16진수에서 c 다음은 d, e, f, 그다음이 10 이라서 b9c + 4 = ba0 입니다). int 가 4바이트이니, 칸들이 한 바이트의 빈틈도 없이 붙어 있다는 뜻입니다. 앞의 그림이 그대로 사실입니다.
주소는 실행할 때마다 바뀝니다. 보안을 위해 운영체제가 실행할 때마다 메모리 위치를 일부러 섞기 때문입니다. 이것을 ASLR(주소 공간 배치 무작위화)라고 하며, 1주차 7절에서 본 pie executable 도 같은 목적으로 코드의 위치까지 섞을 수 있게 만든 형식입니다. 하지만 4씩 늘어난다는 사실은 언제 실행해도 같습니다.
마지막 두 줄도 보세요. 배열 이름 scores 를 그냥 출력하면 0번 칸의 주소가 나옵니다. 배열 이름은 대부분의 경우 “첫 칸의 주소”로 바뀝니다. 이 사실이 6절(배열을 함수에 넘기기)과 10절(scanf 에 & 를 안 붙이는 이유)의 열쇠이고, 6주차 포인터의 출발점입니다.
그림으로 정리하면 이렇습니다.
주소 (끝자리만)   b90      b94      b98      b9c      ba0      ba4
               ┌────────┬────────┬────────┬────────┬────────┐
scores         │   85   │   90   │   78   │   92   │   88   │  ← 여기부터는 scores 가 아님
               └────────┴────────┴────────┴────────┴────────┘
인덱스            [0]      [1]      [2]      [3]      [4]
scores[i] 의 주소 = b90 + i × 4
2. 첫 번째 배열 프로그램
학생 다섯 명의 점수를 배열에 넣고, 출력하고, 합계·평균·최고점·최저점을 구해 봅시다.
examples/array_basic.c:
/*
 * array_basic.c - 배열 기초 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>

int main(void) {
    // 배열 선언
    int scores[5];

    // 배열에 값 저장
    scores[0] = 85;
    scores[1] = 90;
    scores[2] = 78;
    scores[3] = 92;
    scores[4] = 88;

    // 배열 요소 출력
    printf("=== 학생 점수 ===\n");
    for (int i = 0; i < 5; i++) {
        printf("학생 %d: %d점\n", i + 1, scores[i]);
    }

    // 합계와 평균 계산
    int sum = 0;
    for (int i = 0; i < 5; i++) {
        sum += scores[i];
    }

    printf("\n합계: %d점\n", sum);
    printf("평균: %.1f점\n", (double)sum / 5);

    // 최댓값, 최솟값 찾기
    int max = scores[0];
    int min = scores[0];
    for (int i = 1; i < 5; i++) {
        if (scores[i] > max) max = scores[i];
        if (scores[i] < min) min = scores[i];
    }
    printf("최고점: %d점\n", max);
    printf("최저점: %d점\n", min);

    return 0;
}
$ gcc -Wall -Wextra -std=c11 examples/array_basic.c -o array_basic && ./array_basic
=== 학생 점수 ===
학생 1: 85점
학생 2: 90점
학생 3: 78점
학생 4: 92점
학생 5: 88점

합계: 433점
평균: 86.6점
최고점: 92점
최저점: 78점
한 덩어리씩 읽기
① 선언 int scores[5]; 로 int 다섯 칸을 만듭니다. 이 순간 칸 안에는 무엇이 들어 있을까요? 아무도 모릅니다. 3절에서 직접 확인합니다.
② 저장 scores[0] = 85; 부터 scores[4] = 88; 까지 다섯 줄로 각 칸에 점수를 넣습니다. 인덱스가 0부터 4까지라는 것을 다시 눈에 새겨 두세요.
③ 출력 반복문
for (int i = 0; i < 5; i++) {
    printf("학생 %d: %d점\n", i + 1, scores[i]);
}
3주차에서 배운 for 입니다. i 가 0, 1, 2, 3, 4로 바뀌면서 scores[i] 가 차례로 각 칸을 가리킵니다. 두 가지를 짚어 봅시다.
- 조건이
i < 5입니다.i <= 5가 아닙니다. 칸 번호는 4까지이므로,i가 5가 되면 멈춰야 합니다. “배열 크기보다 작을 때까지”가 배열 반복문의 기본형입니다.<=로 잘못 쓰면 어떤 일이 생기는지는 4절에서 봅니다. - 사람에게 보여 줄 때는
i + 1을 씁니다. 컴퓨터 안에서는 0번 학생이지만, 화면에는 “학생 1″이 자연스럽죠. 인덱스(0부터)와 사람이 세는 번호(1부터)를 헷갈리지 않도록, 출력하는 순간에만 1을 더합니다.
④ 합계 sum 을 0으로 시작해서 칸마다 더합니다. 3주차의 “누적” 패턴이 그대로 배열에 쓰였습니다. sum 을 0으로 초기화하지 않으면 쓰레기 값에서부터 더해지니 꼭 초기화하세요.
⑤ 평균 (double)sum / 5 에서 (double) 을 빼면 어떻게 될까요? 3주차 1절의 정수 나눗셈입니다. 433 / 5 는 86이 되고 .6 이 버려집니다. 2주차 9절의 명시적 형 변환으로 sum 을 실수로 바꾼 다음 나눠야 86.6이 나옵니다.
⑥ 최댓값과 최솟값
int max = scores[0];
int min = scores[0];
for (int i = 1; i < 5; i++) {
    if (scores[i] > max) max = scores[i];
    if (scores[i] < min) min = scores[i];
}
“지금까지 본 것 중 가장 큰 값”을 max 에 기억해 두고, 더 큰 값을 만나면 바꿔 치기합니다. 여기서 두 가지 질문을 해 봅시다.
왜 max 를 0이 아니라 scores[0] 으로 시작할까요? 점수가 전부 음수인 배열(예: 온도 {-5, -3, -8})을 생각해 보세요. max 를 0으로 시작하면 어떤 요소도 0보다 크지 않으니 최댓값이 0이라는 틀린 답이 나옵니다. 배열 안에 실제로 있는 값으로 시작해야 어떤 경우에도 맞습니다.
그럼 왜 반복문은 i = 1 부터일까요? 0번 칸은 이미 max 와 min 의 시작값으로 썼으니 다시 비교할 필요가 없어서입니다. i = 0 부터 해도 결과는 같지만 비교를 한 번 헛되게 합니다.
반복문이 도는 동안 max 가 어떻게 바뀌는지 표로 따라가 봅시다.
| 단계 | i |
scores[i] |
scores[i] > max ? |
max |
|---|---|---|---|---|
| 시작 | – | – | – | 85 |
| 1 | 1 | 90 | 90 > 85 참 | 90 |
| 2 | 2 | 78 | 78 > 90 거짓 | 90 |
| 3 | 3 | 92 | 92 > 90 참 | 92 |
| 4 | 4 | 88 | 88 > 92 거짓 | 92 |
마지막에 max 는 92입니다. 이렇게 변수 값의 변화를 표로 추적하는 것은 반복문을 이해하는 가장 확실한 방법입니다. 헷갈리는 반복문을 만나면 종이에 이런 표를 그려 보세요.
직접 해 보기: 점수를
{-5, -3, -8, -1, -9}로 바꾸고,max와min의 시작값을0으로 바꿔서 실행해 보세요. 최고점이 0으로 나올 겁니다. 배열에 없는 값이 답으로 나오는 버그입니다.
3. 배열 초기화
array_basic.c 에서는 선언한 다음 다섯 줄로 값을 넣었습니다. 선언하면서 한 번에 넣는 방법이 있습니다. 초기화 목록이라고 부르는 중괄호 { } 입니다.
int arr1[5] = {10, 20, 30, 40, 50};    // 다섯 칸 모두 지정
int arr2[5] = {10, 20};                // 앞 두 칸만 지정 → 나머지는 0
int arr3[5] = {0};                     // 모두 0
int arr4[]  = {10, 20, 30};            // 크기 생략 → 값 개수로 크기 결정 (3)
각 줄이 정확히 무엇을 하는지 예제로 확인합시다.
examples/array_init.c:
/*
 * array_init.c - 배열 초기화 방법 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>

int main(void) {
    // 다양한 초기화 방법
    int arr1[5] = {1, 2, 3, 4, 5};   // 모든 요소 초기화
    int arr2[5] = {1, 2};             // 나머지는 0
    int arr3[5] = {0};                // 모두 0
    int arr4[] = {10, 20, 30, 40};    // 크기 자동 결정

    // 출력
    printf("=== 배열 초기화 방법 ===\n\n");

    printf("arr1[5] = {1, 2, 3, 4, 5}: ");
    for (int i = 0; i < 5; i++) printf("%d ", arr1[i]);
    printf("\n");

    printf("arr2[5] = {1, 2}: ");
    for (int i = 0; i < 5; i++) printf("%d ", arr2[i]);
    printf("(나머지는 0)\n");

    printf("arr3[5] = {0}: ");
    for (int i = 0; i < 5; i++) printf("%d ", arr3[i]);
    printf("(모두 0)\n");

    // 크기 계산
    int size4 = sizeof(arr4) / sizeof(arr4[0]);
    printf("arr4[] = {10, 20, 30, 40}: ");
    for (int i = 0; i < size4; i++) printf("%d ", arr4[i]);
    printf("(크기 자동 결정: %d)\n", size4);

    // sizeof 설명
    printf("\n=== sizeof 사용법 ===\n");
    printf("sizeof(arr4) = %zu (배열 전체 바이트)\n", sizeof(arr4));
    printf("sizeof(arr4[0]) = %zu (요소 하나 바이트)\n", sizeof(arr4[0]));
    printf("배열 크기 = %zu / %zu = %d\n",
           sizeof(arr4), sizeof(arr4[0]), size4);

    return 0;
}
$ gcc -Wall -Wextra -std=c11 examples/array_init.c -o array_init && ./array_init
=== 배열 초기화 방법 ===

arr1[5] = {1, 2, 3, 4, 5}: 1 2 3 4 5
arr2[5] = {1, 2}: 1 2 0 0 0 (나머지는 0)
arr3[5] = {0}: 0 0 0 0 0 (모두 0)
arr4[] = {10, 20, 30, 40}: 10 20 30 40 (크기 자동 결정: 4)

=== sizeof 사용법 ===
sizeof(arr4) = 16 (배열 전체 바이트)
sizeof(arr4[0]) = 4 (요소 하나 바이트)
배열 크기 = 16 / 4 = 4
새로 나온 문법 하나. for (int i = 0; i < 5; i++) printf("%d ", arr1[i]); 처럼 반복할 문장이 하나뿐이면 { } 없이 한 줄로 쓸 수 있습니다. 3주차에서 본 규칙입니다. 다만 나중에 문장을 추가하다가 { } 를 빼먹는 실수가 흔하니, 이 강좌의 다른 코드는 대부분 { } 를 씁니다.
초기화 규칙 네 가지
규칙 1: 일부만 주면 나머지는 0입니다. arr2 가 1 2 0 0 0 이 된 것이 그 증거입니다. 이것은 “운 좋게 0이 들어 있었다”가 아니라 C 표준이 보장하는 규칙입니다. 초기화 목록을 하나라도 쓰면, 목록에 없는 칸은 전부 0으로 채워집니다.
규칙 2: 그래서 {0} 은 “전부 0″입니다. 사실 {0} 은 “0번 칸을 0으로, 나머지는 규칙 1에 따라 0으로”입니다. 결과적으로 전부 0이 되니, 배열을 0으로 초기화하는 관용구로 널리 씁니다. 그러면 {5} 는 전부 5가 될까요? 아닙니다. 0번 칸만 5이고 나머지는 0입니다. 헷갈리기 쉬운 부분입니다.
규칙 3: 크기를 생략하면 값 개수로 정해집니다. arr4[] 에 값을 넷 줬으니 크기가 4입니다.
규칙 4: 크기보다 많이 주면 경고입니다.
int a[3] = {1, 2, 3, 4};
$ gcc -Wall -Wextra -std=c11 toomany.c -o toomany
toomany.c: In function ‘main’:
toomany.c:4:26: warning: excess elements in array initializer
    4 |     int a[3] = {1, 2, 3, 4};
      |                          ^
toomany.c:4:26: note: (near initialization for ‘a’)
“배열 초기화 목록에 요소가 넘친다(excess elements)”는 경고입니다. 넘친 4 는 버려집니다. 오류가 아니라 경고라서 실행 파일이 만들어진다는 점에 주의하세요. 1주차에서 말한 “경고 0개” 원칙이 여기서도 중요합니다.
배열 크기를 계산하는 공식
arr4 처럼 크기를 생략했거나, 크기를 바꿨을 때 반복문의 5 를 일일이 고치기 싫다면, 크기를 계산할 수 있습니다.
int size = sizeof(arr) / sizeof(arr[0]);
| 식 | 뜻 | arr4 에서 |
|---|---|---|
sizeof(arr) |
배열 전체가 차지하는 바이트 수 | 16 |
sizeof(arr[0]) |
칸 하나가 차지하는 바이트 수 | 4 |
| 나눈 값 | 칸의 개수 | 16 / 4 = 4 |
sizeof(arr[0]) 대신 sizeof(int) 라고 써도 지금은 같은 값입니다. 하지만 나중에 배열 타입을 double 로 바꾸면 sizeof(int) 는 틀린 값이 됩니다. sizeof(arr[0]) 은 배열 타입이 무엇이든 항상 맞으니 이쪽을 쓰세요.
이 공식에는 치명적인 함정이 하나 있습니다. 배열을 함수에 넘긴 다음 함수 안에서 이 공식을 쓰면 틀린 답이 나옵니다. 6절에서 직접 확인합니다.
번호를 지정해서 초기화하기
C99부터는 특정 칸만 골라서 초기화할 수도 있습니다. 지정 초기화(designated initializer) 라고 합니다.
int days[12] = {[0] = 31, [1] = 28, [11] = 31};
31 28 0 0 0 0 0 0 0 0 0 31
[번호] = 값 으로 쓰고, 지정하지 않은 칸은 역시 0입니다. 큰 배열에서 몇 칸만 값이 있을 때 편합니다.
실험: 초기화하지 않은 배열에는 무엇이 들어 있을까?
int scores[5]; 처럼 초기화하지 않은 배열을 바로 출력하면 무엇이 나올까요? 1주차 10절에서 초기화하지 않은 변수는 “쓰레기 값”을 가진다고 했습니다. 그 쓰레기의 정체를 직접 확인해 봅시다.
garbage.c:
#include <stdio.h>

void leave_traces(void) {
    int temp[5] = {11, 22, 33, 44, 55};
    printf("leave_traces: temp[0] = %d\n", temp[0]);
}

void show_uninit(void) {
    int arr[5];                      /* 초기화하지 않음 */
    for (int i = 0; i < 5; i++) {
        printf("arr[%d] = %d\n", i, arr[i]);
    }
}

int main(void) {
    leave_traces();
    show_uninit();
    return 0;
}
함수를 두 개 만들었습니다. 함수는 5주차에 정식으로 배우지만, 3주차의 flush_line() 처럼 “이름을 붙인 코드 묶음을 불러 쓰는 것”이라고 생각하면 됩니다. main 이 leave_traces() 를 먼저 부르고, 그다음 show_uninit() 을 부릅니다.
$ gcc -Wall -Wextra -std=c11 garbage.c -o garbage
garbage.c:11:9: warning: ‘arr’ may be used uninitialized [-Wmaybe-uninitialized]
garbage.c:9:9: note: ‘arr’ declared here
$ ./garbage
leave_traces: temp[0] = 11
arr[0] = 11
arr[1] = 22
arr[2] = 33
arr[3] = 44
arr[4] = 55
show_uninit 의 arr 에는 아무것도 넣지 않았는데, 앞 함수 leave_traces 가 temp 에 넣었던 11, 22, 33, 44, 55 가 그대로 나왔습니다.
무슨 일이 일어났을까요? 함수 안에서 만든 변수는 스택(stack) 이라는 메모리 구역에 자리를 잡습니다. 함수가 끝나면 그 자리는 “비었다”고 표시될 뿐, 안의 값을 지우지는 않습니다. 다음에 불린 함수가 같은 자리를 받으면, 앞 함수가 남긴 값이 그대로 보이는 것입니다. 호텔 방을 청소하지 않고 다음 손님을 들인 것과 같습니다.
이것이 “쓰레기 값”의 정체입니다. 무작위 숫자가 아니라 누군가 그 메모리를 쓰고 남긴 흔적입니다. 그래서 더 위험합니다. 프로그램에 따라 우연히 0일 수도 있고, 우연히 그럴듯한 숫자일 수도 있어서, 버그가 몇 달 동안 숨어 있다가 드러나기도 합니다. GCC가 -Wall 로 “초기화되지 않은 채 쓰일 수 있다(may be used uninitialized)”고 경고한 것을 흘려듣지 마세요.
교훈: 배열은 선언할 때 초기화합니다. 쓸 값이 아직 없으면 = {0} 으로라도 초기화하세요.
실험: 배열을 통째로 대입할 수 있을까?
변수는 b = a; 로 값을 복사할 수 있었습니다. 배열도 될까요?
int a[3] = {1, 2, 3};
int b[3];
b = a;
$ gcc -Wall -Wextra -std=c11 assign.c -o assign
assign.c: In function ‘main’:
assign.c:6:7: error: assignment to expression with array type
    6 |     b = a;
      |       ^
오류입니다. “배열 타입인 식에는 대입할 수 없다.” C에서 배열은 = 로 통째로 복사할 수 없습니다. 앞에서 봤듯 배열 이름은 대부분 “첫 칸의 주소”로 바뀌는데, 주소를 다른 주소에 덮어쓰는 것은 말이 안 되기 때문입니다. 배열을 복사하려면 반복문으로 한 칸씩 복사해야 합니다. 6절의 copy_array 함수가 바로 그 일을 합니다. 같은 이유로 == 로 배열 두 개를 비교할 수도 없는데, 이것은 문자열에서 아주 흔한 실수가 되므로 11절에서 다시 봅니다.
4. 배열의 경계 — C는 막아 주지 않는다
이번 절은 이번 주에서, 어쩌면 이 강좌 전체에서 가장 중요한 절입니다.
5칸짜리 배열의 인덱스는 0부터 4까지입니다. 그럼 arr[5] 를 쓰면 어떻게 될까요? 파이썬이나 자바 같은 언어라면 “범위를 벗어났다”는 오류를 내고 멈춥니다. C는 어떨까요?
C는 검사하지 않습니다. arr[5] 는 그냥 “시작 주소 + 5 × 4바이트” 위치를 읽고 씁니다. 그 자리에 무엇이 있든 상관하지 않습니다. 1절의 그림에서 ba4 번지, “여기부터는 scores 가 아님”이라고 적어 둔 그 자리입니다.
왜 C는 이렇게 만들어졌을까요? 검사하려면 배열에 접근할 때마다 “인덱스가 범위 안인가?”를 확인하는 코드가 추가로 실행돼야 합니다. C는 그 비용조차 아끼는, 프로그래머를 믿고 빠르게 달리는 언어로 설계되었습니다. 대신 경계를 지키는 책임은 전부 프로그래머에게 있습니다. 그 책임을 놓치면 무슨 일이 생기는지, 이제 직접 봅시다.
실험 1: 칸 밖을 읽으면
oob.c (out of bounds, 범위 밖):
#include <stdio.h>

int main(void) {
    int before = 111;
    int arr[5] = {10, 20, 30, 40, 50};
    int after = 222;

    printf("arr[4]  = %d\n", arr[4]);
    printf("arr[5]  = %d\n", arr[5]);
    printf("arr[10] = %d\n", arr[10]);
    printf("arr[-1] = %d\n", arr[-1]);
    printf("before = %d, after = %d\n", before, after);
    return 0;
}
배열 앞뒤에 변수 before 와 after 를 하나씩 두었습니다. 컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=c11 oob.c -o oob
$ ./oob
arr[4]  = 50
arr[5]  = 32765
arr[10] = 1348641226
arr[-1] = 222
before = 111, after = 222
관찰할 것이 많습니다.
- 컴파일러가 아무 경고도 하지 않았습니다.
-Wall -Wextra를 켰는데도요. - 프로그램이 멀쩡히 실행됐습니다. 오류도, 멈춤도 없습니다.
arr[5]와arr[10]은 의미 없는 숫자입니다. 배열 뒤에 있던, 우리와 상관없는 메모리의 값입니다.arr[-1]이 222입니다. 222는after변수의 값입니다! 음수 인덱스는 “시작 주소에서 앞으로 한 칸”이고, 컴파일러가 그 자리에after를 두었던 것입니다. 우리는 배열을 읽었다고 생각했지만, 실제로는 옆 변수를 읽었습니다.
변수들이 메모리에 어떤 순서로 놓일지는 컴파일러가 정합니다. 코드에 쓴 순서와 같다는 보장이 없습니다(이번에는 after 가 배열 바로 앞에 왔습니다). 그래서 범위 밖 접근의 결과는 예측할 수 없습니다. C 표준은 이런 상황을 정의되지 않은 동작(undefined behavior) 이라고 부릅니다. “무슨 일이 일어나도 컴파일러 책임이 아니다”라는 뜻입니다.
최적화를 켜면 GCC가 좀 더 깊이 분석해서 일부를 잡아 주기도 합니다.
$ gcc -Wall -Wextra -std=c11 -O2 oob.c -o oob2
oob.c:9:5: warning: array subscript 5 is above array bounds of ‘int[5]’ [-Warray-bounds=]
    9 |     printf("arr[5]  = %d\n", arr[5]);
...
oob.c:10:5: warning: array subscript 10 is above array bounds of ‘int[5]’ [-Warray-bounds=]
“인덱스 5는 int[5] 배열의 범위를 넘는다.” 이렇게 인덱스가 숫자로 박혀 있으면 잡아낼 수 있습니다. 하지만 인덱스가 변수이고, 그 값이 실행 중에 정해지면 컴파일러도 알 수 없습니다. 실제 버그는 거의 항상 그런 경우입니다.
실험 2: 칸 밖에 쓰면
읽기보다 더 위험한 것이 쓰기입니다. 반복문 조건을 < 대신 <= 로 잘못 쓰는, 아주 흔한 실수를 해 봅시다.
oobw.c:
#include <stdio.h>

int main(void) {
    int arr[5] = {0};

    for (int i = 0; i <= 5; i++) {    /* <= 가 실수 */
        arr[i] = 100 + i;
    }
    printf("arr[4] = %d\n", arr[4]);
    return 0;
}
i 가 5일 때 arr[5] = 105 가 실행됩니다. 5칸짜리 배열의 여섯 번째 칸에 쓰는 것입니다.
$ gcc -Wall -Wextra -std=c11 oobw.c -o oobw
$ ./oobw
arr[4] = 104
$ echo $?
0
아무 일도 없었던 것처럼 끝났습니다. 종료 코드도 0(성공)입니다. 105라는 값은 배열 뒤 어딘가의 메모리를 덮어썼는데, 이번에는 우연히 중요하지 않은 자리였습니다. 이것이 가장 무서운 경우입니다. 버그가 있는데 증상이 없으니, 테스트를 통과하고 배포된 뒤 다른 조건에서 터집니다.
이번에는 크게 넘쳐 보겠습니다. 5칸짜리 배열에 20칸을 씁니다.
oobw2.c:
#include <stdio.h>

int main(void) {
    int arr[5] = {0};

    for (int i = 0; i < 20; i++) {
        arr[i] = 100 + i;
    }
    printf("arr[4] = %d\n", arr[4]);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 oobw2.c -o oobw2
$ ./oobw2
*** stack smashing detected ***: terminated
중지됨 (코어 덤프됨)
$ echo $?
134
이번에는 프로그램이 죽었습니다. stack smashing detected 는 “스택이 부서진 것을 감지했다”는 뜻입니다. 우분투의 GCC는 함수의 변수 영역 끝에 카나리아(canary) 라는 감시용 값을 몰래 넣어 둡니다. 광부들이 탄광에 카나리아를 데리고 들어가 유독 가스를 감지했던 데서 온 이름입니다. 함수가 끝날 때 이 값이 바뀌었으면 “누군가 배열 밖에 썼다”고 판단하고 프로그램을 강제로 끝냅니다. 종료 코드 134는 128 + 6으로, “6번 신호(중단 신호, SIGABRT)로 죽었다”는 뜻입니다. 신호는 18주차에 배웁니다.
이 감시 장치가 없다면 어떻게 될까요? 함수 변수 영역 바로 뒤에는 “이 함수가 끝나면 어디로 돌아갈지” 를 적어 둔 주소가 있습니다. 배열이 넘쳐서 그 주소를 덮어쓰면, 함수가 끝날 때 엉뚱한 곳으로 점프합니다. 공격자가 넘칠 내용을 조작할 수 있다면, 원하는 코드로 점프하게 만들 수도 있습니다. 이것이 수십 년 동안 가장 흔했던 해킹 기법인 버퍼 오버플로우 공격입니다. 24주차 보안 프로그래밍에서 직접 다룹니다. 지금은 “배열 밖에 쓰는 것은 단순한 버그가 아니라 보안 구멍”이라는 것만 기억하세요.
실험 3: 도구로 잡아내기
증상이 없는 버그(실험 2의 oobw)는 어떻게 찾을까요? GCC에는 AddressSanitizer 라는 검사 도구가 들어 있습니다. -fsanitize=address 옵션으로 컴파일하면, 모든 메모리 접근에 경계 검사 코드를 넣어 줍니다. 파이썬처럼 검사하는 C를 잠시 빌려 쓰는 셈입니다.
$ gcc -std=c11 -g -fsanitize=address oobw.c -o oobw_asan
$ ./oobw_asan
=================================================================
==2489951==ERROR: AddressSanitizer: stack-buffer-overflow on address 0x7dc4eb600034 ...
WRITE of size 4 at 0x7dc4eb600034 thread T0
    #0 0x6098a6cf23d1 in main oobw.c:7
...
조용히 넘어갔던 oobw 가 이번에는 정확히 잡혔습니다. 읽어 봅시다.
stack-buffer-overflow: 스택에 있는 배열이 넘쳤다WRITE of size 4: 4바이트(int하나)를 쓰다가in main oobw.c:7:oobw.c의 7번째 줄에서
7번째 줄은 arr[i] = 100 + i; 입니다. 1주차 5절에서 -g 가 “소스 코드와 기계어의 대응표”를 넣는다고 했는데, 그 덕분에 줄 번호까지 나옵니다.
AddressSanitizer 는 프로그램을 느리게 만들어서 완성품에는 쓰지 않지만, 공부하고 개발하는 동안에는 켜 두면 아주 좋습니다. 이번 주에 배열이나 문자열 코드가 이상하게 동작하면 먼저 이 옵션으로 다시 컴파일해 보세요. 7주차에는 같은 일을 하는 다른 도구 Valgrind 도 배웁니다.
경계를 지키는 습관
| 습관 | 예 |
|---|---|
반복문 조건은 < 크기 |
for (int i = 0; i < SIZE; i++) |
| 크기는 숫자 대신 이름으로 | #define SIZE 5 또는 sizeof(arr) / sizeof(arr[0]) |
| 인덱스를 계산으로 만들 때는 범위를 확인 | if (idx >= 0 && idx < SIZE) arr[idx] = v; |
| 개발 중에는 검사 도구를 켠다 | -fsanitize=address |
5. 배열과 반복문 — 자주 쓰는 패턴
배열은 반복문과 함께 쓸 때 진짜 힘을 발휘합니다. 실무 코드에서 배열을 다루는 반복문은 대부분 몇 가지 패턴의 변형입니다. 이 패턴들을 손에 익혀 두면, 새로운 문제를 만났을 때 “이건 검색 패턴이구나”, “이건 누적 패턴이구나” 하고 바로 뼈대를 잡을 수 있습니다.
examples/array_loop.c:
/*
 * array_loop.c - 배열과 반복문 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>

int main(void) {
    int numbers[] = {64, 34, 25, 12, 22, 11, 90};
    int size = sizeof(numbers) / sizeof(numbers[0]);

    // 모든 요소 출력
    printf("=== 배열 요소 출력 ===\n");
    printf("배열: ");
    for (int i = 0; i < size; i++) {
        printf("%d ", numbers[i]);
    }
    printf("\n");

    // 역순 출력
    printf("역순: ");
    for (int i = size - 1; i >= 0; i--) {
        printf("%d ", numbers[i]);
    }
    printf("\n");

    // 합계 계산
    int sum = 0;
    for (int i = 0; i < size; i++) {
        sum += numbers[i];
    }
    printf("\n합계: %d\n", sum);
    printf("평균: %.2f\n", (double)sum / size);

    // 최댓값 찾기
    printf("\n=== 최댓값/최솟값 찾기 ===\n");
    int max = numbers[0];
    int max_idx = 0;
    for (int i = 1; i < size; i++) {
        if (numbers[i] > max) {
            max = numbers[i];
            max_idx = i;
        }
    }
    printf("최댓값: %d (인덱스: %d)\n", max, max_idx);

    // 최솟값 찾기
    int min = numbers[0];
    int min_idx = 0;
    for (int i = 1; i < size; i++) {
        if (numbers[i] < min) {
            min = numbers[i];
            min_idx = i;
        }
    }
    printf("최솟값: %d (인덱스: %d)\n", min, min_idx);

    // 특정 값 검색
    printf("\n=== 값 검색 ===\n");
    int target = 25;
    int found = -1;
    for (int i = 0; i < size; i++) {
        if (numbers[i] == target) {
            found = i;
            break;
        }
    }

    if (found >= 0) {
        printf("%d를 인덱스 %d에서 찾았습니다.\n", target, found);
    } else {
        printf("%d를 찾지 못했습니다.\n", target);
    }

    // 짝수만 출력
    printf("\n=== 조건에 맞는 요소 ===\n");
    printf("짝수: ");
    for (int i = 0; i < size; i++) {
        if (numbers[i] % 2 == 0) {
            printf("%d ", numbers[i]);
        }
    }
    printf("\n");

    return 0;
}
$ gcc -Wall -Wextra -std=c11 examples/array_loop.c -o array_loop && ./array_loop
=== 배열 요소 출력 ===
배열: 64 34 25 12 22 11 90
역순: 90 11 22 12 25 34 64

합계: 258
평균: 36.86

=== 최댓값/최솟값 찾기 ===
최댓값: 90 (인덱스: 6)
최솟값: 11 (인덱스: 5)

=== 값 검색 ===
25를 인덱스 2에서 찾았습니다.

=== 조건에 맞는 요소 ===
짝수: 64 34 12 22 90
첫 두 줄을 먼저 보세요. numbers[] 로 크기를 생략하고, 크기는 3절의 공식으로 계산했습니다. 이제 이 코드는 배열에 값을 추가하거나 빼도 다른 곳을 하나도 고칠 필요가 없습니다. 반복문들이 전부 size 를 쓰기 때문입니다.
이 예제에 들어 있는 패턴을 정리합니다.
| 패턴 | 뼈대 | 예제에서 |
|---|---|---|
| 순회 | for (i = 0; i < size; i++) 로 모든 칸 방문 |
모든 요소 출력 |
| 역순 순회 | for (i = size - 1; i >= 0; i--) |
역순 출력 |
| 누적 | 변수를 0으로 두고 칸마다 더함 | 합계 |
| 최대/최소 + 위치 | 첫 칸으로 시작, 더 크면 값과 인덱스를 함께 갱신 | max_idx |
| 검색 | 찾으면 인덱스를 기록하고 break, 못 찾으면 -1 |
25 찾기 |
| 걸러내기(필터) | 조건에 맞는 칸만 처리 | 짝수만 출력 |
몇 가지를 자세히 봅시다.
역순 순회의 조건 i >= 0: 마지막 칸의 인덱스는 size 가 아니라 size - 1 입니다. 시작을 i = size 로 잘못 쓰면 첫 바퀴에서 바로 4절의 범위 밖 읽기가 됩니다. 그리고 i 를 줄여 가다가 0번 칸까지 처리해야 하니 조건은 i >= 0 입니다.
최댓값의 위치까지 기억하기: 값만 기억하면 “90이 제일 크다”는 알지만 “몇 번째인가”는 모릅니다. max_idx 를 함께 갱신하면 둘 다 알 수 있습니다. 사실 인덱스만 기억해도 충분합니다. 인덱스를 알면 값은 numbers[max_idx] 로 언제든 꺼낼 수 있으니까요. 연습 삼아 max 변수 없이 max_idx 하나로 고쳐 보세요.
검색의 -1: 찾지 못했다는 것을 어떻게 알릴까요? 인덱스는 0 이상이므로, 절대 인덱스가 될 수 없는 -1 을 “못 찾음” 표시로 씁니다. 이런 특별한 표시 값을 센티널(sentinel, 보초) 이라고 합니다. 뒤에서 볼 strchr 같은 표준 함수들도 같은 발상으로 “못 찾으면 NULL” 을 돌려줍니다.
검색의 break: 찾았으면 더 볼 필요가 없으니 3주차 14절의 break 로 반복을 끝냅니다. 25는 인덱스 2에 있으므로 반복문은 세 바퀴만 돌고 멈춥니다. 같은 값이 여러 개 있다면? break 덕분에 첫 번째로 나온 위치를 찾습니다.
직접 해 보기 1.
target을 100으로 바꿔서 “찾지 못했습니다”가 나오는지 확인하세요. 2.numbers에25를 하나 더 넣고(예: 맨 끝),break를 지웠을 때found가 어떻게 바뀌는지 예상한 뒤 실행해 보세요.break가 없으면 마지막으로 찾은 위치가 남습니다. 3. 짝수 개수를 세는 코드를 추가해 보세요. “걸러내기 + 누적” 두 패턴의 조합입니다.
6. 배열과 함수
프로그램이 커지면 “배열을 출력하는 코드”, “합계를 구하는 코드”를 여러 번 쓰게 됩니다. 이런 코드를 함수로 묶어 두면 이름만 불러서 다시 쓸 수 있습니다. 함수는 5주차의 주제지만, 배열을 제대로 쓰려면 “배열을 함수에 넘기면 무슨 일이 생기는가”를 지금 알아야 합니다. 그래서 함수의 모양만 먼저 간단히 보겠습니다.
함수의 생김새 (5주차 미리보기)
int sum_array(int arr[], int size) {
    int sum = 0;
    for (int i = 0; i < size; i++) {
        sum += arr[i];
    }
    return sum;
}
1주차에서 main 을 뜯어봤던 것처럼 읽으면 됩니다.
| 조각 | 뜻 |
|---|---|
int (맨 앞) |
이 함수가 일을 마치고 돌려주는 값의 타입. void 면 돌려주는 값이 없음 |
sum_array |
함수 이름 |
(int arr[], int size) |
이 함수가 받는 값(매개변수) 두 개: 정수 배열 arr, 정수 size |
{ ... } |
함수가 하는 일 |
return sum; |
sum 의 값을 돌려주고 함수를 끝냄 |
부르는 쪽에서는 sum_array(scores, 5) 처럼 이름 뒤 괄호에 값을 넣습니다. 그러면 arr 자리에 scores 가, size 자리에 5 가 들어간 채로 함수가 실행되고, return 한 값이 그 자리의 결과가 됩니다.
배열을 넘기는 예제
examples/array_function.c:
/*
 * array_function.c - 배열과 함수 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>

// 배열 출력 함수
void print_array(int arr[], int size) {
    printf("[ ");
    for (int i = 0; i < size; i++) {
        printf("%d ", arr[i]);
    }
    printf("]\n");
}

// 배열 합계 함수
int sum_array(int arr[], int size) {
    int sum = 0;
    for (int i = 0; i < size; i++) {
        sum += arr[i];
    }
    return sum;
}

// 배열 평균 함수
double avg_array(int arr[], int size) {
    if (size == 0) return 0.0;
    return (double)sum_array(arr, size) / size;
}

// 배열 최댓값 함수
int max_array(int arr[], int size) {
    if (size == 0) return 0;
    int max = arr[0];
    for (int i = 1; i < size; i++) {
        if (arr[i] > max) max = arr[i];
    }
    return max;
}

// 배열 최솟값 함수
int min_array(int arr[], int size) {
    if (size == 0) return 0;
    int min = arr[0];
    for (int i = 1; i < size; i++) {
        if (arr[i] < min) min = arr[i];
    }
    return min;
}

// 배열 요소 모두 2배로 (원본 수정!)
void double_array(int arr[], int size) {
    for (int i = 0; i < size; i++) {
        arr[i] *= 2;
    }
}

// 배열 복사
void copy_array(int dest[], int src[], int size) {
    for (int i = 0; i < size; i++) {
        dest[i] = src[i];
    }
}

// 배열 역순
void reverse_array(int arr[], int size) {
    for (int i = 0; i < size / 2; i++) {
        int temp = arr[i];
        arr[i] = arr[size - 1 - i];
        arr[size - 1 - i] = temp;
    }
}

int main(void) {
    int scores[] = {85, 90, 78, 92, 88};
    int size = sizeof(scores) / sizeof(scores[0]);

    printf("=== 배열과 함수 ===\n\n");

    printf("원본 배열: ");
    print_array(scores, size);

    printf("\n합계: %d\n", sum_array(scores, size));
    printf("평균: %.1f\n", avg_array(scores, size));
    printf("최댓값: %d\n", max_array(scores, size));
    printf("최솟값: %d\n", min_array(scores, size));

    // 배열 수정 (원본이 바뀜!)
    printf("\n=== 배열 수정 (원본 변경됨!) ===\n");
    double_array(scores, size);
    printf("2배 후: ");
    print_array(scores, size);

    // 배열 역순
    printf("\n=== 배열 역순 ===\n");
    int arr[] = {1, 2, 3, 4, 5};
    int arr_size = sizeof(arr) / sizeof(arr[0]);

    printf("원본: ");
    print_array(arr, arr_size);

    reverse_array(arr, arr_size);
    printf("역순: ");
    print_array(arr, arr_size);

    return 0;
}
$ gcc -Wall -Wextra -std=c11 examples/array_function.c -o array_function && ./array_function
=== 배열과 함수 ===

원본 배열: [ 85 90 78 92 88 ]

합계: 433
평균: 86.6
최댓값: 92
최솟값: 78

=== 배열 수정 (원본 변경됨!) ===
2배 후: [ 170 180 156 184 176 ]

=== 배열 역순 ===
원본: [ 1 2 3 4 5 ]
역순: [ 5 4 3 2 1 ]
함수 이름만 읽어도 무엇을 하는지 알 수 있습니다. main 이 “무엇을 하는지”만 보여 주고, “어떻게 하는지”는 각 함수에 숨어 있습니다. 5절의 array_loop.c 와 비교해 보면 훨씬 읽기 편합니다.
그런데 이 코드에는 두 가지 수수께끼가 있습니다.
- 왜 모든 함수가
size를 따로 받을까요? 배열 안에 크기 정보가 없나요? double_array는arr을 고쳤을 뿐인데, 왜main의scores가 바뀌었을까요?
수수께끼 1: 함수 안에서 sizeof 를 쓰면?
함수 안에서 3절의 크기 공식을 쓰면 size 를 따로 받지 않아도 되지 않을까요? 해 봅시다.
sizefn.c:
#include <stdio.h>

void show_size(int arr[]) {
    printf("함수 안: sizeof(arr) = %zu\n", sizeof(arr));
}

int main(void) {
    int scores[5] = {85, 90, 78, 92, 88};
    printf("main 안: sizeof(scores) = %zu\n", sizeof(scores));
    show_size(scores);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 sizefn.c -o sizefn
sizefn.c: In function ‘show_size’:
sizefn.c:4:50: warning: ‘sizeof’ on array function parameter ‘arr’ will return size of ‘int *’ [-Wsizeof-array-argument]
    4 |     printf("함수 안: sizeof(arr) = %zu\n", sizeof(arr));
      |                                                  ^
sizefn.c:3:20: note: declared here
    3 | void show_size(int arr[]) {
      |                ~~~~^~~~~
$ ./sizefn
main 안: sizeof(scores) = 20
함수 안: sizeof(arr) = 8
같은 배열인데 main 에서는 20, 함수 안에서는 8 입니다. 5칸짜리 int 배열이 8바이트일 리가 없습니다. GCC의 경고가 답을 알려 줍니다. “배열 매개변수 arr 에 sizeof 를 쓰면 int * 의 크기가 나온다.”
int * 는 “int 를 가리키는 주소”라는 타입입니다(6주차의 주인공인 포인터입니다). 64비트 컴퓨터에서 주소 하나는 8바이트입니다. 즉 함수가 받은 것은 배열 전체가 아니라 배열의 시작 주소 하나였던 것입니다.
1절 실험을 떠올려 보세요. 배열 이름 scores 를 출력하면 0번 칸의 주소가 나왔습니다. show_size(scores) 라고 쓰는 순간에도 scores 는 “첫 칸의 주소”로 바뀌어 넘어갑니다. 함수의 int arr[] 라는 표기는 배열처럼 보이지만, 컴파일러는 이것을 int *arr, 즉 주소를 받는 변수로 취급합니다.
main 의 메모리                              show_size 가 받은 것
┌────┬────┬────┬────┬────┐
│ 85 │ 90 │ 78 │ 92 │ 88 │   ←──────────── arr = 첫 칸의 주소 (8바이트짜리 값 하나)
└────┴────┴────┴────┴────┘
scores (20바이트)                           "몇 칸짜리인지"는 모름
주소 하나만으로는 거기서부터 몇 칸이 이어지는지 알 수 없습니다. 그래서 배열을 받는 함수는 크기를 반드시 따로 받아야 합니다. C의 거의 모든 배열 함수가 (배열, 크기) 짝으로 매개변수를 받는 이유입니다. 이번 주 뒤에서 보는 fgets(buf, sizeof(buf), stdin), snprintf(buf, sizeof(buf), ...) 도 같은 이유로 크기를 따로 받습니다. 거꾸로 크기를 받지 않는 함수(strcpy, gets 등)는 경계를 지킬 방법이 없어서 위험합니다. 이 사실이 12절 “안전한 문자열 처리”의 뿌리입니다.
수수께끼 2: 왜 원본이 바뀔까?
5주차에 배우겠지만, C에서 함수에 값을 넘기면 원래는 복사본이 넘어갑니다. 함수 안에서 매개변수를 바꿔도 부른 쪽의 변수는 그대로입니다. 그런데 배열은 바뀌었습니다.
수수께끼 1의 답이 여기서도 답입니다. 넘어간 것이 주소이기 때문입니다. 주소도 복사되긴 하지만, 복사된 주소도 같은 메모리를 가리킵니다. 친구에게 우리 집 주소를 적은 쪽지를 복사해 줬다고, 집이 두 채가 되지는 않는 것과 같습니다. 친구가 그 주소로 찾아가 가구를 옮기면, 우리 집 가구가 옮겨집니다.
그래서 double_array(scores, size) 는 main 의 scores 칸을 직접 두 배로 만듭니다. 이것은 버그가 아니라 의도된 동작이고, 아주 유용합니다. 20만 칸짜리 배열을 함수에 넘길 때마다 통째로 복사한다면 얼마나 느리겠습니까. 대신 원본을 바꾸면 안 되는 함수는 이렇게 표시하는 습관을 들이세요.
int sum_array(const int arr[], int size); // const: 이 함수는 arr 을 고치지 않는다
const 는 2주차 8절에서 배운 “바꿀 수 없음” 표시입니다. 매개변수에 붙이면, 함수 안에서 실수로 arr[i] = 0; 같은 코드를 쓸 때 컴파일러가 오류로 막아 줍니다. 11절의 표준 문자열 함수들이 strlen(const char *str) 처럼 const 를 붙이고 있는 것도 같은 약속입니다.
reverse_array 를 한 줄씩
reverse_array 는 배열을 제자리에서 뒤집습니다. 새 배열을 만들지 않고 양 끝 칸을 서로 맞바꾸면서 안쪽으로 들어옵니다.
for (int i = 0; i < size / 2; i++) {
    int temp = arr[i];
    arr[i] = arr[size - 1 - i];
    arr[size - 1 - i] = temp;
}
{1, 2, 3, 4, 5} 로 따라가 봅시다. size 는 5, size / 2 는 정수 나눗셈이라 2입니다.
i |
맞바꾸는 칸 | 결과 |
|---|---|---|
| 시작 | – | 1 2 3 4 5 |
| 0 | [0] ↔ [4] |
5 2 3 4 1 |
| 1 | [1] ↔ [3] |
5 4 3 2 1 |
끝 (i = 2, 2 < 2 거짓) |
가운데 [2] 는 그대로 |
5 4 3 2 1 |
맞바꾸기(swap) 에 temp 가 필요한 이유도 짚어 둡시다. arr[i] = arr[size-1-i]; 를 먼저 하면 arr[i] 의 원래 값이 사라집니다. 그래서 먼저 temp 에 대피시켜 둡니다. 두 컵의 음료를 바꾸려면 빈 컵이 하나 필요한 것과 같습니다. 이 세 줄은 7절 정렬에서 계속 나옵니다.
왜 size / 2 까지만 돌까요? size 까지 돌면, 뒤쪽 절반에서 한 번 더 맞바꿔서 원래대로 돌아가 버립니다. 직접 i < size 로 바꿔 실행해 보세요. 배열이 뒤집히지 않고 그대로 나옵니다.
덤: arr[i] 의 정체
arr[i] 는 사실 “시작 주소에서 i 칸 떨어진 곳”의 줄임 표기라고 했습니다. C는 이것을 문자 그대로 *(arr + i) 로 번역합니다. * 는 “이 주소에 있는 값”이라는 뜻입니다(6주차). 덧셈은 순서를 바꿔도 같으니… 다음 코드가 컴파일될까요?
int arr[5] = {10, 20, 30, 40, 50};

printf("arr[2]     = %d\n", arr[2]);
printf("*(arr + 2) = %d\n", *(arr + 2));
printf("2[arr]     = %d\n", 2[arr]);
$ gcc -Wall -Wextra -std=c11 weird.c -o weird && ./weird
arr[2]     = 30
*(arr + 2) = 30
2[arr]     = 30
경고도 없이 셋 다 30입니다. 2[arr] 는 *(2 + arr) 가 되고, 그건 *(arr + 2) 와 같기 때문입니다. 실제로 이렇게 쓰는 사람은 없지만(쓰면 동료에게 혼납니다), 대괄호가 주소 계산의 줄임 표기라는 것을 이보다 확실하게 보여 주는 예는 없습니다. 6주차에 포인터를 배우면 이 줄이 무슨 뜻인지 완전히 이해하게 됩니다.
7. 배열 정렬: 버블 정렬
배열로 할 수 있는 가장 대표적인 일이 정렬(sort) 입니다. 성적순, 이름순, 날짜순… 거의 모든 프로그램에 정렬이 들어갑니다. 정렬 방법은 수십 가지인데, 그중 가장 이해하기 쉬운 버블 정렬(bubble sort) 을 직접 만들어 봅니다.
아이디어
옆 칸끼리 비교해서 순서가 틀렸으면 맞바꾼다. 이것을 끝까지 반복한다.
앞에서부터 옆 칸끼리 비교하며 큰 값을 뒤로 보내면, 한 바퀴를 돌았을 때 가장 큰 값이 맨 끝에 도착합니다. 물속의 거품(bubble)이 위로 떠오르듯 큰 값이 끝으로 떠오른다고 해서 붙은 이름입니다. 두 번째 바퀴는 맨 끝을 빼고 다시 하면 두 번째로 큰 값이 그 앞에 자리 잡습니다. 이렇게 한 바퀴(패스)마다 하나씩 자리가 확정됩니다.
{64, 34, 25, 12, 22, 11, 90} 의 첫 번째 패스를 손으로 따라가 봅시다. [ ] 는 지금 비교하는 두 칸입니다.
j=0: [64 34] 25 12 22 11 90   64 > 34 → 바꿈 → 34 64 25 12 22 11 90
j=1:  34 [64 25] 12 22 11 90   64 > 25 → 바꿈 → 34 25 64 12 22 11 90
j=2:  34 25 [64 12] 22 11 90   64 > 12 → 바꿈 → 34 25 12 64 22 11 90
j=3:  34 25 12 [64 22] 11 90   64 > 22 → 바꿈 → 34 25 12 22 64 11 90
j=4:  34 25 12 22 [64 11] 90   64 > 11 → 바꿈 → 34 25 12 22 11 64 90
j=5:  34 25 12 22 11 [64 90]   64 > 90 ? 아님 → 그대로
패스 1 결과:                                   34 25 12 22 11 64 [90] ← 확정
64가 한 칸씩 뒤로 밀려가다가 더 큰 90을 만나 멈췄고, 90이 맨 끝에 확정됐습니다. 이제 코드를 봅시다.
examples/bubble_sort.c:
/*
 * bubble_sort.c - 버블 정렬 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>

void print_array(int arr[], int size) {
    for (int i = 0; i < size; i++) {
        printf("%d ", arr[i]);
    }
    printf("\n");
}

void bubble_sort(int arr[], int size) {
    printf("=== 버블 정렬 과정 ===\n\n");

    for (int i = 0; i < size - 1; i++) {
        int swapped = 0;

        // 각 패스에서 인접한 요소 비교 및 교환
        for (int j = 0; j < size - 1 - i; j++) {
            if (arr[j] > arr[j + 1]) {
                // 교환 (swap)
                int temp = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = temp;
                swapped = 1;
            }
        }

        printf("패스 %d: ", i + 1);
        print_array(arr, size);

        // 교환이 없으면 이미 정렬됨
        if (!swapped) {
            printf("(이미 정렬됨 - 조기 종료)\n");
            break;
        }
    }
}

// 내림차순 버블 정렬
void bubble_sort_desc(int arr[], int size) {
    for (int i = 0; i < size - 1; i++) {
        for (int j = 0; j < size - 1 - i; j++) {
            if (arr[j] < arr[j + 1]) {  // 부등호 방향 변경
                int temp = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = temp;
            }
        }
    }
}

int main(void) {
    int arr1[] = {64, 34, 25, 12, 22, 11, 90};
    int size1 = sizeof(arr1) / sizeof(arr1[0]);

    printf("정렬 전: ");
    print_array(arr1, size1);
    printf("\n");

    bubble_sort(arr1, size1);

    printf("\n정렬 후 (오름차순): ");
    print_array(arr1, size1);

    // 내림차순 정렬
    printf("\n=== 내림차순 정렬 ===\n");
    int arr2[] = {3, 1, 4, 1, 5, 9, 2, 6};
    int size2 = sizeof(arr2) / sizeof(arr2[0]);

    printf("정렬 전: ");
    print_array(arr2, size2);

    bubble_sort_desc(arr2, size2);

    printf("정렬 후 (내림차순): ");
    print_array(arr2, size2);

    return 0;
}
bubble_sort 를 실행하면 패스가 끝날 때마다 배열이 어떻게 바뀌는지 찍힙니다.
$ gcc -Wall -Wextra -std=c11 examples/bubble_sort.c -o bubble_sort && ./bubble_sort
정렬 전: 64 34 25 12 22 11 90

=== 버블 정렬 과정 ===

패스 1: 34 25 12 22 11 64 90
패스 2: 25 12 22 11 34 64 90
패스 3: 12 22 11 25 34 64 90
패스 4: 12 11 22 25 34 64 90
패스 5: 11 12 22 25 34 64 90
패스 6: 11 12 22 25 34 64 90
(이미 정렬됨 - 조기 종료)

정렬 후 (오름차순): 11 12 22 25 34 64 90

=== 내림차순 정렬 ===
정렬 전: 3 1 4 1 5 9 2 6
정렬 후 (내림차순): 9 6 5 4 3 2 1 1
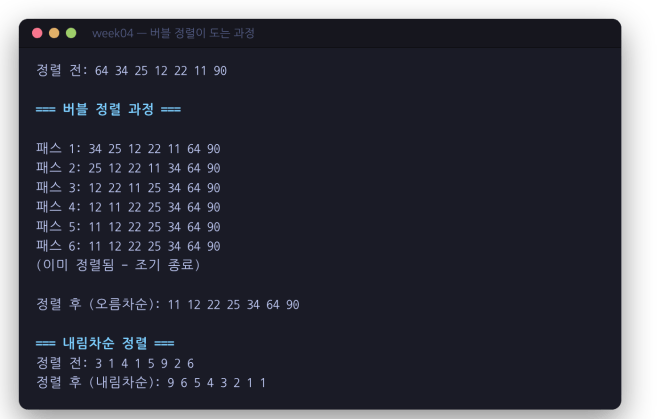
버블 정렬이 도는 과정
패스 1의 결과가 손으로 따라간 것과 정확히 같습니다. 그리고 패스마다 뒤에서부터 90, 64, 34, 25… 가 차례로 자리를 잡는 것을 볼 수 있습니다.
두 반복문의 범위
for (int i = 0; i < size - 1; i++) {           // 바깥: 패스 번호
    for (int j = 0; j < size - 1 - i; j++) {   // 안쪽: 비교할 위치
        if (arr[j] > arr[j + 1]) { ... }
안쪽 j < size - 1 - i: 두 가지를 뺐습니다.
- 1:arr[j]와arr[j + 1]을 비교하므로,j가 마지막 칸(size - 1)이 되면j + 1이 배열 밖이 됩니다. 4절의 범위 밖 읽기죠. 그래서j는size - 2까지만 갑니다.- i: 패스i가 끝날 때마다 뒤에서 한 칸씩 자리가 확정됩니다. 이미 확정된 칸은 다시 볼 필요가 없습니다.
바깥 i < size - 1: 7칸이면 6번의 패스로 충분합니다. 6개가 제자리를 찾으면 남은 하나는 저절로 제자리이기 때문입니다.
조기 종료: swapped
출력을 자세히 보면 패스 5에서 이미 정렬이 끝났습니다. 그런데 프로그램은 패스 6을 한 번 더 돌고 나서야 “(이미 정렬됨 – 조기 종료)”를 찍었습니다. 왜일까요?
패스 5가 끝난 시점에는 배열이 정렬됐는지 알 수 없습니다. 패스 5에서도 맞바꾸기가 있었으니까요(12와 11). 정렬이 끝났다는 증거는 “한 바퀴를 다 돌았는데 한 번도 맞바꾸지 않았다” 는 것뿐입니다. 그래서 패스 6을 돌아 보고, swapped 가 0으로 남아 있는 것을 확인한 뒤에 멈춥니다.
swapped 는 3주차에서 본 깃발(flag) 변수입니다. 패스를 시작할 때 0으로 내려 두고, 맞바꾸는 순간 1로 올립니다. 패스가 끝났는데 깃발이 내려가 있으면 정렬 완료입니다. !swapped 는 “swapped 가 0이면(거짓이면) 참”이라는 3주차 5절의 논리 부정입니다.
이미 정렬된 배열을 넣으면 이 조기 종료 덕분에 패스 1번만 돌고 끝납니다. 직접 arr1 을 {1, 2, 3, 4, 5, 6, 7} 로 바꿔서 확인해 보세요.
내림차순은 부등호 하나
bubble_sort_desc 는 bubble_sort 와 부등호 하나만 다릅니다. arr[j] > arr[j + 1](앞이 크면 바꿈 → 작은 것이 앞으로)을 arr[j] < arr[j + 1](앞이 작으면 바꿈 → 큰 것이 앞으로)로 뒤집었습니다. 정렬의 뼈대는 그대로 두고 “순서가 틀렸다”의 기준만 바꾸면 어떤 순서로든 정렬할 수 있습니다. 15절에서 이 기준을 strcmp 로 바꿔 이름을 정렬하고, 16절 성적 관리 프로그램에서는 평균 점수로 바꿉니다.
버블 정렬은 얼마나 느릴까?
버블 정렬은 이해하기 쉬운 대신 느립니다. 조기 종료가 없다고 할 때, 비교 횟수를 세어 보면 이렇습니다.
$ ./bubblecount
n =   10 : 비교 45번
n =  100 : 비교 4950번
n = 1000 : 비교 499500번
(bubblecount.c 는 버블 정렬의 두 반복문에서 if 대신 compares++ 만 하는 프로그램입니다.)
배열이 10배 커질 때마다 비교는 약 100배 늘어납니다. 비교 횟수가 정확히 n × (n – 1) / 2 이고, 대략 n² 에 비례하기 때문입니다. 100만 개를 정렬하면 약 5천억 번 비교해야 합니다. 실무에서는 n × log n 에 비례하는 빠른 정렬 방법들을 쓰고, C 표준 라이브러리에도 qsort 라는 함수가 들어 있습니다(7주차 함수 포인터에서 씁니다). 15주차 “정렬과 검색 알고리즘”에서 여러 정렬 방법을 직접 만들고 속도를 비교합니다.
8. 2차원 배열
표 모양의 데이터
학생 3명의 과목 4개 점수, 달력, 바둑판, 엑셀 시트처럼 행과 열이 있는 표 모양의 데이터가 많습니다. 이런 데이터는 2차원 배열로 표현합니다.
int matrix[3][4]; // 3행 4열: int 12칸
[3] 이 행(가로줄)의 개수, [4] 가 열(세로줄)의 개수입니다. 요소는 matrix[행][열] 로 접근합니다.
            열 0   열 1   열 2   열 3
          ┌──────┬──────┬──────┬──────┐
   행 0   │  1   │  2   │  3   │  4   │   matrix[0][...]
          ├──────┼──────┼──────┼──────┤
   행 1   │  5   │  6   │  7   │  8   │   matrix[1][...]   matrix[1][2] = 7
          ├──────┼──────┼──────┼──────┤
   행 2   │  9   │  10  │  11  │  12  │   matrix[2][...]
          └──────┴──────┴──────┴──────┘
초기화는 행마다 중괄호로 묶습니다.
int matrix[3][4] = {
    {1, 2, 3, 4},       // 행 0
    {5, 6, 7, 8},       // 행 1
    {9, 10, 11, 12}     // 행 2
};
3절의 규칙이 그대로 적용됩니다. 행 안에서 일부만 주면 나머지는 0이고, = {0} 이면 전부 0입니다.
int m[3][4] = {
    {1, 2},          // 1 2 0 0
    {5},             // 5 0 0 0
    {9, 10, 11}      // 9 10 11 0
};
행 중괄호 없이 {1, 2, 3, ..., 12} 로 쭉 나열해도 됩니다. 왜 그게 되는지는 곧 메모리를 보면 알게 됩니다.
2차원 배열 예제
examples/array_2d.c:
/*
 * array_2d.c - 2차원 배열 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>

int main(void) {
    // 3x4 행렬
    int matrix[3][4] = {
        {1, 2, 3, 4},
        {5, 6, 7, 8},
        {9, 10, 11, 12}
    };

    // 행렬 출력
    printf("=== 3x4 행렬 ===\n");
    for (int i = 0; i < 3; i++) {
        for (int j = 0; j < 4; j++) {
            printf("%3d ", matrix[i][j]);
        }
        printf("\n");
    }

    // 특정 요소 접근
    printf("\n=== 요소 접근 ===\n");
    printf("matrix[0][0] = %d (첫 번째 행, 첫 번째 열)\n", matrix[0][0]);
    printf("matrix[1][2] = %d (두 번째 행, 세 번째 열)\n", matrix[1][2]);
    printf("matrix[2][3] = %d (세 번째 행, 네 번째 열)\n", matrix[2][3]);

    // 행별 합계
    printf("\n=== 행별 합계 ===\n");
    for (int i = 0; i < 3; i++) {
        int row_sum = 0;
        for (int j = 0; j < 4; j++) {
            row_sum += matrix[i][j];
        }
        printf("행 %d 합계: %d\n", i, row_sum);
    }

    // 열별 합계
    printf("\n=== 열별 합계 ===\n");
    for (int j = 0; j < 4; j++) {
        int col_sum = 0;
        for (int i = 0; i < 3; i++) {
            col_sum += matrix[i][j];
        }
        printf("열 %d 합계: %d\n", j, col_sum);
    }

    // 전체 합계
    int total = 0;
    for (int i = 0; i < 3; i++) {
        for (int j = 0; j < 4; j++) {
            total += matrix[i][j];
        }
    }
    printf("\n전체 합계: %d\n", total);

    // 최댓값 찾기
    int max = matrix[0][0];
    int max_row = 0, max_col = 0;
    for (int i = 0; i < 3; i++) {
        for (int j = 0; j < 4; j++) {
            if (matrix[i][j] > max) {
                max = matrix[i][j];
                max_row = i;
                max_col = j;
            }
        }
    }
    printf("최댓값: %d (위치: [%d][%d])\n", max, max_row, max_col);

    return 0;
}
$ gcc -Wall -Wextra -std=c11 examples/array_2d.c -o array_2d && ./array_2d
=== 3x4 행렬 ===
  1   2   3   4
  5   6   7   8
  9  10  11  12

=== 요소 접근 ===
matrix[0][0] = 1 (첫 번째 행, 첫 번째 열)
matrix[1][2] = 7 (두 번째 행, 세 번째 열)
matrix[2][3] = 12 (세 번째 행, 네 번째 열)

=== 행별 합계 ===
행 0 합계: 10
행 1 합계: 26
행 2 합계: 42

=== 열별 합계 ===
열 0 합계: 15
열 1 합계: 18
열 2 합계: 21
열 3 합계: 24

전체 합계: 78
최댓값: 12 (위치: [2][3])
이중 반복문 읽기
2차원 배열은 3주차 11절의 중첩 for 로 돕니다. 이 예제에서 가장 눈여겨볼 것은 행별 합계와 열별 합계의 차이입니다.
// 행별 합계: 바깥이 행(i), 안쪽이 열(j)
for (int i = 0; i < 3; i++) {
    int row_sum = 0;
    for (int j = 0; j < 4; j++) {
        row_sum += matrix[i][j];
    }
}

// 열별 합계: 바깥이 열(j), 안쪽이 행(i)
for (int j = 0; j < 4; j++) {
    int col_sum = 0;
    for (int i = 0; i < 3; i++) {
        col_sum += matrix[i][j];
    }
}
matrix[i][j] 라는 접근 코드는 똑같습니다. 어느 쪽을 바깥 반복문에 두느냐만 바뀌었습니다. 바깥 반복문이 “한 묶음”을 정하고, 안쪽 반복문이 그 묶음 안을 훑습니다. 행 합계를 원하면 행을 바깥에, 열 합계를 원하면 열을 바깥에 두면 됩니다.
그리고 row_sum = 0 이 바깥 반복문 안에 있다는 점을 보세요. 행마다 새로 0부터 세야 하니까요. 이 줄을 반복문 밖으로 빼면 어떻게 될지 예상해 보고 직접 확인해 보세요. 행 합계가 10, 36, 78로 계속 누적됩니다.
출력의 %3d 는 2주차 6절에서 배운 폭 지정입니다. 숫자를 3칸 폭에 오른쪽 정렬해서, 한 자리 수와 두 자리 수가 섞여도 열이 가지런합니다. %d 로 바꿔서 표가 어떻게 무너지는지 비교해 보세요.
2차원 배열의 진짜 모양: 메모리는 한 줄
표 모양으로 그렸지만, 메모리는 1절에서 본 것처럼 주소가 한 줄로 이어진 공간입니다. 그럼 2차원 배열은 메모리에 어떻게 들어갈까요? 직접 주소를 찍어 봅시다.
addr2d.c:
#include <stdio.h>

int main(void) {
    int m[3][4] = {
        {1, 2, 3, 4},
        {5, 6, 7, 8},
        {9, 10, 11, 12}
    };

    for (int i = 0; i < 3; i++) {
        for (int j = 0; j < 4; j++) {
            printf("m[%d][%d]=%2d @ %p\n", i, j, m[i][j], (void *)&m[i][j]);
        }
    }
    printf("sizeof(m) = %zu, sizeof(m[0]) = %zu, sizeof(m[0][0]) = %zu\n",
           sizeof(m), sizeof(m[0]), sizeof(m[0][0]));
    printf("m[0][4] = %d (사실은 m[1][0])\n", m[0][4]);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 addr2d.c -o addr2d && ./addr2d
m[0][0]= 1 @ 0x7ffda6f2ead0
m[0][1]= 2 @ 0x7ffda6f2ead4
m[0][2]= 3 @ 0x7ffda6f2ead8
m[0][3]= 4 @ 0x7ffda6f2eadc
m[1][0]= 5 @ 0x7ffda6f2eae0
m[1][1]= 6 @ 0x7ffda6f2eae4
m[1][2]= 7 @ 0x7ffda6f2eae8
m[1][3]= 8 @ 0x7ffda6f2eaec
m[2][0]= 9 @ 0x7ffda6f2eaf0
m[2][1]=10 @ 0x7ffda6f2eaf4
m[2][2]=11 @ 0x7ffda6f2eaf8
m[2][3]=12 @ 0x7ffda6f2eafc
sizeof(m) = 48, sizeof(m[0]) = 16, sizeof(m[0][0]) = 4
m[0][4] = 5 (사실은 m[1][0])
주소가 ad0 부터 4씩 끊김 없이 12칸 이어집니다. 행 0의 네 칸이 먼저 오고, 바로 뒤에 행 1, 그 뒤에 행 2가 붙습니다. 이것을 행 우선(row-major) 저장이라고 합니다.
주소(끝자리)  ad0 ad4 ad8 adc  ae0 ae4 ae8 aec  af0 af4 af8 afc
            ┌───┬───┬───┬───┬───┬───┬───┬───┬───┬───┬───┬───┐
            │ 1 │ 2 │ 3 │ 4 │ 5 │ 6 │ 7 │ 8 │ 9 │10 │11 │12 │
            └───┴───┴───┴───┴───┴───┴───┴───┴───┴───┴───┴───┘
            └──── 행 0 ────┘ └──── 행 1 ────┘ └──── 행 2 ────┘
sizeof 를 보면 구조가 더 분명해집니다. m 전체는 48바이트(12칸 × 4), m[0] 은 16바이트, 즉 int 4칸짜리 배열 하나입니다. 2차원 배열은 “4칸짜리 배열”을 3개 담은 배열, 배열의 배열입니다. 그래서 m[1] 은 “두 번째 줄 전체”이고, m[1][2] 는 “두 번째 줄의 세 번째 칸”입니다.
마지막 줄이 흥미롭습니다. m[0][4] 는 행 0에 없는 다섯 번째 칸인데, 5가 나왔습니다. 메모리에서 행 0의 바로 뒤가 행 1의 첫 칸이기 때문입니다. m[i][j] 의 위치는 결국 “시작 + (i × 4 + j) × 4바이트” 로 계산되고, m[0][4] 는 0 × 4 + 4 = 4번째 칸 = m[1][0] 입니다. 행 중괄호 없이 12개를 쭉 나열해도 초기화가 되는 이유도 이것입니다.
그렇다고
m[0][4]를 쓰면 안 됩니다. 결과가 5로 나오긴 했지만, C 표준은 각 행의 범위를 벗어난 접근을 정의되지 않은 동작으로 봅니다. 최적화를 켜면 컴파일러가 “m[0]은 4칸이니[4]는 쓰일 리 없다”고 가정하고 코드를 바꿀 수 있습니다. 메모리 모양을 이해하는 실험으로만 쓰세요.
2차원 배열을 함수에 넘기기
1차원 배열은 int arr[] 처럼 크기를 비워 두고 받을 수 있었습니다. 2차원 배열도 그렇게 해 볼까요?
void print_matrix(int mat[][], int rows) { ... }
$ gcc -Wall -Wextra -std=c11 noncol.c -o noncol
noncol.c:3:23: error: array type has incomplete element type ‘int[]’
    3 | void print_matrix(int mat[][], int rows) {
      |                       ^~~
noncol.c:3:23: note: declaration of ‘mat’ as multidimensional array must have bounds for all dimensions except the first
오류입니다. note 가 규칙을 알려 줍니다. “다차원 배열 선언은 첫 번째를 제외한 모든 차원의 크기가 있어야 한다.”
앞의 주소 계산 공식이 이유입니다. mat[i][j] 의 위치는 “시작 + (i × 열 개수 + j) × 4″ 입니다. 컴파일러가 이 계산을 하려면 한 행이 몇 칸인지(열 개수) 를 꼭 알아야 합니다. 반대로 행이 몇 개인지는 계산에 필요 없습니다. 그래서 첫 번째 크기(행)는 비워도 되고, 두 번째 크기(열)는 반드시 적어야 합니다.
void print_matrix(int mat[][4], int rows); // 열 4 는 필수, 행은 따로 받는다
행렬 연산
2차원 배열의 대표적인 쓰임새가 수학의 행렬입니다. 게임의 3D 그래픽, 인공지능, 이미지 처리가 전부 행렬 계산입니다(29주차 고성능 컴퓨팅에서 행렬 곱셈을 빠르게 만드는 법을 배웁니다). 두 3×3 행렬의 덧셈, 뺄셈, 곱셈, 전치를 함수로 만들어 봅니다.
examples/matrix_ops.c:
/*
 * matrix_ops.c - 행렬 연산 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>

#define ROWS 3
#define COLS 3

// 행렬 출력
void print_matrix(int mat[ROWS][COLS], const char *name) {
    printf("%s:\n", name);
    for (int i = 0; i < ROWS; i++) {
        printf("  ");
        for (int j = 0; j < COLS; j++) {
            printf("%4d ", mat[i][j]);
        }
        printf("\n");
    }
}

// 행렬 덧셈
void matrix_add(int a[ROWS][COLS], int b[ROWS][COLS], int result[ROWS][COLS]) {
    for (int i = 0; i < ROWS; i++) {
        for (int j = 0; j < COLS; j++) {
            result[i][j] = a[i][j] + b[i][j];
        }
    }
}

// 행렬 뺄셈
void matrix_sub(int a[ROWS][COLS], int b[ROWS][COLS], int result[ROWS][COLS]) {
    for (int i = 0; i < ROWS; i++) {
        for (int j = 0; j < COLS; j++) {
            result[i][j] = a[i][j] - b[i][j];
        }
    }
}

// 행렬 곱셈
void matrix_mul(int a[ROWS][COLS], int b[ROWS][COLS], int result[ROWS][COLS]) {
    for (int i = 0; i < ROWS; i++) {
        for (int j = 0; j < COLS; j++) {
            result[i][j] = 0;
            for (int k = 0; k < COLS; k++) {
                result[i][j] += a[i][k] * b[k][j];
            }
        }
    }
}

// 행렬 전치
void matrix_transpose(int mat[ROWS][COLS], int result[COLS][ROWS]) {
    for (int i = 0; i < ROWS; i++) {
        for (int j = 0; j < COLS; j++) {
            result[j][i] = mat[i][j];
        }
    }
}

int main(void) {
    int A[ROWS][COLS] = {
        {1, 2, 3},
        {4, 5, 6},
        {7, 8, 9}
    };

    int B[ROWS][COLS] = {
        {9, 8, 7},
        {6, 5, 4},
        {3, 2, 1}
    };

    int result[ROWS][COLS];

    printf("=== 행렬 연산 ===\n\n");

    print_matrix(A, "행렬 A");
    printf("\n");
    print_matrix(B, "행렬 B");

    // 덧셈
    printf("\n=== A + B ===\n");
    matrix_add(A, B, result);
    print_matrix(result, "결과");

    // 뺄셈
    printf("\n=== A - B ===\n");
    matrix_sub(A, B, result);
    print_matrix(result, "결과");

    // 곱셈
    printf("\n=== A * B ===\n");
    matrix_mul(A, B, result);
    print_matrix(result, "결과");

    // 전치
    printf("\n=== A의 전치 행렬 ===\n");
    int transposed[COLS][ROWS];
    matrix_transpose(A, transposed);
    print_matrix(transposed, "A^T");

    return 0;
}
matrix_ops 를 실행한 결과입니다.
$ gcc -Wall -Wextra -std=c11 examples/matrix_ops.c -o matrix_ops && ./matrix_ops
=== 행렬 연산 ===

행렬 A:
     1    2    3
     4    5    6
     7    8    9

행렬 B:
     9    8    7
     6    5    4
     3    2    1

=== A + B ===
결과:
    10   10   10
    10   10   10
    10   10   10

=== A - B ===
결과:
    -8   -6   -4
    -2    0    2
     4    6    8

=== A * B ===
결과:
    30   24   18
    84   69   54
   138  114   90

=== A의 전치 행렬 ===
A^T:
     1    4    7
     2    5    8
     3    6    9

2차원 배열과 행렬
결과를 매개변수로 받는 이유: matrix_add 는 결과를 return 하지 않고 result 라는 세 번째 매개변수에 써 넣습니다. 6절에서 봤듯이 C 함수는 배열을 통째로 돌려줄 수 없고, 대신 배열을 넘기면 함수가 원본을 고칠 수 있습니다. 그래서 “결과를 담을 배열을 부르는 쪽이 준비해서 넘기는” 방식이 C의 관용구입니다. 12절의 strcpy(dest, src) 도 같은 모양입니다.
const char *name: print_matrix 의 두 번째 매개변수는 "행렬 A" 같은 문자열을 받습니다. 문자열도 배열이니 첫 글자의 주소가 넘어오고, 그 주소의 타입이 char * 입니다. const 는 “이 함수는 문자열을 고치지 않는다”는 약속입니다. 9절부터 문자열을 자세히 봅니다.
행렬 곱셈의 세 겹 반복문: 덧셈은 같은 자리끼리 더하면 되지만, 곱셈은 다릅니다. 결과의 [i][j] 칸은 A의 i행과 B의 j열을 차례로 곱해서 더한 값입니다. 결과 첫 칸 30이 어떻게 나왔는지 따라가 봅시다.
result[0][0] = A[0][0]×B[0][0] + A[0][1]×B[1][0] + A[0][2]×B[2][0]
             =    1   ×   9    +    2   ×   6    +    3   ×   3
             =        9        +       12        +        9        = 30
코드의 가장 안쪽 반복문 k 가 0, 1, 2로 돌면서 이 세 곱셈을 더합니다. result[1][0] 이 84인지도 직접 계산해 보세요(4 × 9 + 5 × 6 + 6 × 3).
전치(transpose): 행과 열을 맞바꾼 행렬입니다. result[j][i] = mat[i][j] 한 줄이 전부입니다. A의 첫 행 1 2 3 이 전치 행렬의 첫 열이 된 것을 확인하세요.
9. 문자와 문자열
이제 이번 주의 두 번째 주인공, 문자열입니다. 문자열을 이해하려면 먼저 문자(char) 가 무엇인지 다시 짚어야 합니다.
char 는 사실 숫자입니다
2주차 3절에서 char 가 “가장 작은 정수형”이라고 배웠습니다. char 는 1바이트짜리 정수이고, 그 정수를 글자 번호로 약속해서 씁니다. 이 번호표가 ASCII 코드입니다. 'A' 는 65번, 'a' 는 97번, '0' 은 48번입니다.
작은따옴표 'A' 는 “A의 번호”를 뜻하는 숫자입니다. 그래서 계산을 할 수 있습니다.
chars.c:
#include <stdio.h>

int main(void) {
    char c = 'A';
    char digit = '7';

    printf("'A' 의 값: %d\n", c);
    printf("'A' + 1 = %d = '%c'\n", c + 1, c + 1);
    printf("'a' - 'A' = %d\n", 'a' - 'A');
    printf("'7' 의 값: %d, '7' - '0' = %d\n", digit, digit - '0');
    return 0;
}
$ gcc -Wall -Wextra -std=c11 chars.c -o chars && ./chars
'A' 의 값: 65
'A' + 1 = 66 = 'B'
'a' - 'A' = 32
'7' 의 값: 55, '7' - '0' = 7
같은 값을 %d 로 찍으면 숫자, %c 로 찍으면 글자가 나옵니다. 값은 하나이고, 보여 주는 방식만 다릅니다.
여기서 나온 두 가지 계산은 이번 주에 계속 씁니다.
- 대문자와 소문자는 정확히 32 차이입니다. ASCII 표에서
'A'~'Z'는 65~90,'a'~'z'는 97~122 로 나란히 놓여 있기 때문입니다. 그래서 대문자에 32를 더하면 소문자가 됩니다. 14절의tolower가 하는 일이 본질적으로 이것입니다. - 숫자 글자
'7'에서'0'을 빼면 진짜 숫자 7이 됩니다.'0'~'9'가 48~57 로 연속이기 때문입니다. 글자로 된 숫자를 계산 가능한 숫자로 바꾸는 가장 기본적인 방법입니다.
ASCII 표 전체는 터미널에서 man ascii 로 볼 수 있습니다.
문자열 = char 배열 + ‘\0’
C에는 “문자열 타입”이 따로 없습니다. 문자열은 그냥 char 배열이고, 딱 하나의 약속이 붙어 있습니다.
문자열의 끝에는 값이 0인 글자
'\0'(널 문자)을 둔다.
"Hello" 라는 문자열은 메모리에 이렇게 들어 있습니다.
인덱스     [0]   [1]   [2]   [3]   [4]   [5]
         ┌─────┬─────┬─────┬─────┬─────┬─────┐
글자      │ 'H' │ 'e' │ 'l' │ 'l' │ 'o' │'\0' │
         ├─────┼─────┼─────┼─────┼─────┼─────┤
값(ASCII) │  72 │ 101 │ 108 │ 108 │ 111 │  0  │
         └─────┴─────┴─────┴─────┴─────┴─────┘
                    글자 5개               + 끝 표시 1개 = 6바이트
글자는 다섯 개인데 여섯 칸이 필요합니다. 마지막 칸의 '\0' 이 “여기서 문자열이 끝난다”는 표시입니다. '\0' 은 1주차 6절에서 본 이스케이프 시퀀스로, 숫자 0과 같은 값입니다(글자 '0' 인 48과는 다릅니다).
왜 이런 방식을 쓸까요? 1주차 6절 실험을 떠올려 보세요. printf("abc\0def\n") 가 abc 까지만 찍었습니다. printf 는 문자열의 길이를 모릅니다. 첫 글자의 주소만 받아서(6절에서 봤듯 배열은 주소로 넘어갑니다), 한 글자씩 찍다가 '\0' 을 만나면 멈춥니다. 문자열을 받는 모든 C 함수가 이 방식으로 끝을 찾습니다. 그래서 '\0' 이 빠지면 함수는 멈출 곳을 모른 채 메모리를 계속 읽어 나갑니다. 곧 직접 봅니다.
문자열을 만드는 네 가지 방법
char str1[6] = {'H', 'e', 'l', 'l', 'o', '\0'};  // ① 한 글자씩 (끝 표시도 직접)
char str2[6] = "Hello";                          // ② 문자열로 (끝 표시는 자동)
char str3[]  = "Hello";                          // ③ 크기 생략 (6으로 자동 결정)
char str4[20] = "Hello";                         // ④ 여유 있게 (남는 칸은 전부 '\0')
- ①은 배열 초기화 그대로입니다.
'\0'을 직접 써야 합니다. - ②는 큰따옴표 문자열로 초기화합니다. 컴파일러가 끝에
'\0'을 자동으로 붙여 줍니다. 그래서 크기는 글자 수보다 1 커야 합니다. - ③은 크기를 비워 두면 컴파일러가
'\0'까지 세어 6으로 정합니다. 가장 실수가 적은 방법입니다. - ④는 나중에 더 긴 문자열을 넣을 수 있게 칸을 넉넉히 잡은 것입니다. 3절 규칙 1(“나머지는 0”)에 따라 남은 14칸은 전부
'\0'으로 채워집니다.
examples/string_basic.c:
/*
 * string_basic.c - 문자열 기초 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>

int main(void) {
    // 문자열 선언 방법들
    char str1[6] = {'H', 'e', 'l', 'l', 'o', '\0'};  // 문자 배열로
    char str2[6] = "Hello";                          // 문자열 리터럴로
    char str3[] = "Hello";                           // 크기 자동 결정
    char str4[20] = "Hello";                         // 여유 공간 있음

    printf("=== 문자열 선언 방법 ===\n");
    printf("str1 (문자 배열): %s\n", str1);
    printf("str2 (크기 지정): %s\n", str2);
    printf("str3 (크기 자동): %s\n", str3);
    printf("str4 (여유 공간): %s\n", str4);

    // 크기 확인
    printf("\n=== sizeof 결과 ===\n");
    printf("sizeof(str1) = %zu\n", sizeof(str1));  // 6
    printf("sizeof(str2) = %zu\n", sizeof(str2));  // 6
    printf("sizeof(str3) = %zu\n", sizeof(str3));  // 6
    printf("sizeof(str4) = %zu\n", sizeof(str4));  // 20

    // 문자열 내부 구조 확인
    printf("\n=== str3의 내부 구조 ===\n");
    printf("인덱스  문자    ASCII\n");
    printf("------------------------\n");
    for (int i = 0; i < 6; i++) {
        if (str3[i] == '\0') {
            printf("  %d     '\\0'     %d\n", i, str3[i]);
        } else {
            printf("  %d      '%c'     %d\n", i, str3[i], str3[i]);
        }
    }

    // 문자열 수정
    printf("\n=== 문자열 수정 ===\n");
    printf("수정 전 str4: %s\n", str4);
    str4[0] = 'J';
    str4[4] = 'y';
    printf("수정 후 str4: %s\n", str4);

    // 문자열 길이 직접 계산
    printf("\n=== 문자열 길이 계산 ===\n");
    int len = 0;
    while (str3[len] != '\0') {
        len++;
    }
    printf("str3의 길이: %d (\\0 제외)\n", len);

    // 빈 문자열
    printf("\n=== 빈 문자열 ===\n");
    char empty[] = "";
    printf("빈 문자열: \"%s\"\n", empty);
    printf("sizeof(empty) = %zu\n", sizeof(empty));  // 1 ('\0'만 있음)

    return 0;
}
$ gcc -Wall -Wextra -std=c11 examples/string_basic.c -o string_basic && ./string_basic
=== 문자열 선언 방법 ===
str1 (문자 배열): Hello
str2 (크기 지정): Hello
str3 (크기 자동): Hello
str4 (여유 공간): Hello

=== sizeof 결과 ===
sizeof(str1) = 6
sizeof(str2) = 6
sizeof(str3) = 6
sizeof(str4) = 20

=== str3의 내부 구조 ===
인덱스  문자    ASCII
------------------------
  0      'H'     72
  1      'e'     101
  2      'l'     108
  3      'l'     108
  4      'o'     111
  5     '\0'     0

=== 문자열 수정 ===
수정 전 str4: Hello
수정 후 str4: Jelly

=== 문자열 길이 계산 ===
str3의 길이: 5 (\0 제외)

=== 빈 문자열 ===
빈 문자열: ""
sizeof(empty) = 1
한 덩어리씩 읽기
%s: printf 에서 문자열을 출력하는 서식 지정자입니다. 1주차 6절에서 “여기에 문자열을 끼워 넣어라”라고 잠깐 봤죠. %s 에는 배열 이름을 넘깁니다. 배열 이름은 첫 칸의 주소이고, printf 는 그 주소부터 '\0' 까지 찍습니다.
sizeof 는 모두 6(또는 20) 입니다. 글자 5개 + '\0' 1개입니다. str4 는 선언한 크기 그대로 20입니다. sizeof 는 “배열이 몇 칸인가”이지, “문자열이 몇 글자인가”가 아닙니다. 이 둘을 구분하는 것이 11절 strlen 의 핵심입니다.
내부 구조 표: 예상대로 5번 칸에 값 0이 들어 있습니다. 코드에서 '\\0' 이라고 백슬래시를 두 번 쓴 것은, 화면에 \0 이라는 두 글자를 보여 주기 위해서입니다(1주차 6절의 \\).
문자열 수정: str4[0] = 'J'; str4[4] = 'y'; 로 “Hello” 가 “Jelly” 가 됐습니다. 문자열이 배열이니 칸 하나하나를 고칠 수 있습니다. 여기서 쓴 'J' 는 작은따옴표입니다. 칸 하나에는 글자 하나가 들어가니까요. str4[0] = "J"; 라고 큰따옴표를 쓰면 오류가 납니다. "J" 는 'J' 와 '\0' 두 칸짜리 문자열이기 때문입니다.
길이 직접 계산: '\0' 이 나올 때까지 세는 이 while 이 사실상 strlen 의 전부입니다. 13절에서 표준 함수를 직접 만들 때 다시 봅니다.
빈 문자열 "": 글자는 0개지만 '\0' 한 칸은 있습니다. 그래서 sizeof 가 1입니다. “아무것도 없는 문자열”도 1바이트를 차지합니다.
실험: ‘\0’ 자리가 없으면?
char word[5] = "Hello"; 처럼 5칸에 5글자를 넣으면 '\0' 이 들어갈 자리가 없습니다. 컴파일러가 막아 줄까요?
nonul.c:
#include <stdio.h>

int main(void) {
    char next[8] = "WORLD";
    char word[5] = "Hello";          /* 5칸에 5글자: '\0' 자리가 없다 */

    printf("word = %s\n", word);
    printf("sizeof(word) = %zu\n", sizeof(word));
    printf("next = %s\n", next);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 nonul.c -o nonul
$ ./nonul
word = HelloWORLD
sizeof(word) = 5
next = WORLD
경고가 하나도 없습니다. C는 이 선언을 허용합니다. 크기가 정확히 글자 수와 같으면 '\0' 없이 5글자만 채워 넣는 것이 C의 규칙입니다(C++ 에서는 오류입니다).
그리고 출력이 HelloWORLD 입니다! printf 는 word 의 5글자를 찍은 뒤 '\0' 을 찾지 못해 계속 읽어 나갔고, 메모리에서 바로 뒤에 있던 next 배열의 WORLD 까지 찍었습니다. 그리고 next 끝의 '\0' 에서 겨우 멈췄습니다. 두 배열이 메모리에 이렇게 붙어 있었던 것입니다.
         word (5칸)                      next (8칸)
┌───┬───┬───┬───┬───┐┌───┬───┬───┬───┬───┬────┬────┬────┐
│ H │ e │ l │ l │ o ││ W │ O │ R │ L │ D │ \0 │ \0 │ \0 │
└───┴───┴───┴───┴───┘└───┴───┴───┴───┴───┴────┴────┴────┘
 printf 는 여기서 시작 ────────────────────▶ 여기서 겨우 멈춤
이번에는 바로 뒤에 다른 문자열이 있었지만, 뒤에 무엇이 있을지는 운입니다. 쓰레기 값이 찍힐 수도, 프로그램이 죽을 수도 있습니다. 이것이 C 문자열 버그의 가장 흔한 모습입니다. 문자열 배열의 크기는 항상 “글자 수 + 1” 이상으로 잡으세요. 크기를 생략하는(char word[] = "Hello";) 것이 가장 안전합니다.
문자열 리터럴과 배열의 차이
큰따옴표로 쓴 "Hello" 자체를 문자열 리터럴이라고 합니다. 리터럴로 배열을 초기화하는 것과, 리터럴의 주소를 받아 두는 것은 전혀 다릅니다.
char arr[] = "Hello";       // 배열: 리터럴의 글자들을 내 배열로 **복사**
char *ptr  = "Hello";       // 포인터: 리터럴이 있는 곳의 **주소**만 저장
char * 는 6절에서 본 “주소를 담는 변수(포인터)”입니다. 둘 다 printf("%s") 로 찍으면 똑같이 Hello가 나오지만, 고치려고 하면 차이가 드러납니다.
litmod.c:
#include <stdio.h>

int main(void) {
    char arr[] = "Hello";
    char *ptr = "Hello";

    arr[0] = 'J';
    printf("arr = %s\n", arr);

    ptr[0] = 'J';
    printf("ptr = %s\n", ptr);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 litmod.c -o litmod
$ ./litmod
arr = Jello
세그멘테이션 오류 (코어 덤프됨)
$ echo $?
139
arr 은 잘 고쳐졌는데, ptr[0] = 'J' 에서 프로그램이 죽었습니다. 경고도 없었습니다.
1주차 7절의 어셈블리를 떠올려 보세요. "Hello, World!" 는 .section .rodata 에 들어 있었습니다. read-only, 읽기 전용 영역입니다. 문자열 리터럴은 프로그램 안의 읽기 전용 영역에 딱 한 벌 저장되고, ptr 은 그곳을 가리킵니다. 거기에 쓰려고 하니 운영체제가 “쓰기 금지 구역을 건드렸다”며 프로그램을 멈춘 것입니다. 이것이 세그멘테이션 오류(segmentation fault), 줄여서 세그폴트입니다. 종료 코드 139는 128 + 11, 즉 11번 신호(SIGSEGV)로 죽었다는 뜻입니다. 앞으로 C를 하면서 가장 자주 만날 오류입니다.
반면 arr 은 스택에 만든 내 배열에 글자를 복사해 둔 것이라 마음대로 고칠 수 있습니다.
그래서 리터럴을 가리키는 포인터는 const char * 로 선언하는 것이 규칙입니다.
const char *ptr = "Hello";    // "이 주소의 글자는 고치지 않는다"
ptr[0] = 'J';                 // 이제는 컴파일 오류로 막힌다
const 를 붙이면 실수로 고치려 할 때 실행 전에 컴파일러가 잡아 줍니다. 8절의 print_matrix(..., const char *name) 가 이 모양이었습니다. 포인터는 6주차에 제대로 배우니, 지금은 “고칠 문자열은 배열로, 고치지 않을 문자열 상수는 const char * 로” 만 기억하세요.
10. 문자열 입출력
scanf 로 단어 하나 읽기
char name[50];
scanf("%49s", name);
2주차 7절에서 scanf("%d", &age) 처럼 변수 앞에 & 를 붙였습니다. 그런데 문자열을 읽을 때는 & 를 붙이지 않습니다. 왜일까요?
scanf 가 원하는 것은 “값을 써 넣을 주소“입니다. int 변수 age 는 값이라서 &age 로 주소를 만들어 줘야 했습니다. 그런데 1절에서 봤듯 배열 이름 name 은 이미 첫 칸의 주소입니다. 그래서 그냥 name 이라고 쓰면 됩니다.
%s 앞의 49 는 “최대 49글자까지만 읽어라”는 폭 제한입니다. 배열이 50칸이니 49글자 + '\0' 한 칸이 딱 맞습니다. 폭은 항상 배열 크기 – 1 로 잡습니다. 이 숫자가 왜 생명줄인지 곧 실험으로 봅니다.
scanf("%s") 에는 함정이 두 개 있습니다.
함정 1: 공백에서 끊깁니다. %s 는 “공백이 아닌 글자들”을 읽고, 공백(스페이스, 탭, 줄바꿈)을 만나면 멈춥니다. Kim Cheolsu 를 입력하면 Kim 만 읽힙니다. 나머지 Cheolsu 와 줄바꿈은 입력 버퍼에 남아 있다가 다음 입력 함수가 읽어 갑니다. 2주차 7절의 “scanf 버퍼 문제”와 같은 이야기입니다.
함정 2: 폭을 안 쓰면 넘칩니다. 이것을 직접 확인해 봅시다.
실험: 폭 제한 없는 scanf
scanov.c:
#include <stdio.h>

int main(void) {
    char name[10];

    printf("이름: ");
    if (scanf("%s", name) != 1) {
        return 1;
    }
    printf("안녕하세요, %s님!\n", name);
    return 0;
}
name 은 10칸, 즉 9글자까지 담을 수 있습니다. 1주차에서 배운 | 로 입력을 넣어 봅시다. echo 가 출력한 글자가 프로그램의 키보드 입력으로 들어갑니다.
$ gcc -Wall -Wextra -std=c11 scanov.c -o scanov
$ echo "Kim" | ./scanov
이름: 안녕하세요, Kim님!
$ echo "Wolfeschlegelsteinhausenbergerdorff" | ./scanov
*** stack smashing detected ***: terminated
중지됨 (코어 덤프됨)
$ echo $?
134
짧은 이름은 잘 됩니다. 그런데 35글자짜리 이름을 넣으니 4절의 oobw2 와 똑같이 스택이 부서졌습니다. scanf 는 name 이 몇 칸인지 모른 채 35글자와 '\0' 을 전부 써 넣었고, 그 26바이트가 name 뒤의 메모리를 덮어썼습니다. 컴파일러는 경고조차 하지 않았습니다.
이 프로그램에서는 입력을 넣는 사람이 메모리를 덮어쓸 수 있습니다. 4절에서 말한 버퍼 오버플로우 공격이 바로 이런 코드를 노립니다.
이제 %s 를 %9s 로 바꿉니다.
$ echo "Wolfeschlegelsteinhausenbergerdorff" | ./scansafe
이름: 안녕하세요, Wolfeschl님!
$ echo $?
0
앞 9글자만 읽고 멈춥니다. 이름은 잘렸지만 프로그램은 안전합니다. scanf 로 문자열을 읽을 때는 예외 없이 폭을 쓰세요. 폭이 없는 %s 는 이 강좌에서 금지입니다.
fgets 로 한 줄 통째로 읽기
공백이 들어간 문장을 읽으려면 fgets 를 씁니다. 1주차에서 배운 대로 man 3 fgets 로 설명서부터 봅시다.
char *fgets(char *s, int size, FILE *stream);
| 매개변수 | 뜻 | 보통 넘기는 값 |
|---|---|---|
s |
읽은 글자를 저장할 배열 | 배열 이름 |
size |
배열의 크기 ('\0' 자리 포함) |
sizeof(배열) |
stream |
어디서 읽을지 | stdin (키보드, 표준 입력) |
| 반환값 | 성공하면 s, 읽을 것이 없으면(입력 끝) NULL |
fgets 는 줄바꿈을 만나거나, size - 1 글자를 채우거나, 입력이 끝날 때까지 읽고, 끝에 항상 '\0' 을 붙입니다. 6절에서 말한 “크기를 따로 받는 함수”라서 절대 넘치지 않습니다. stdin 은 standard input, 표준 입력의 이름입니다. 9주차 파일 입출력에서 이 자리에 파일을 넣게 됩니다.
fgets 에는 알아 둘 성질이 두 가지 있습니다.
- 줄바꿈
'\n'까지 배열에 넣습니다.Hi를 입력하고 엔터를 치면 배열에는H,i,\n,\0이 들어갑니다. - 줄이 배열보다 길면 잘라서 읽고, 나머지는 다음
fgets가 읽습니다.
8칸짜리 배열로 확인해 봅시다.
fgetsw.c:
#include <stdio.h>
#include <string.h>

int main(void) {
    char line[8];
    int n = 0;

    while (fgets(line, sizeof(line), stdin) != NULL) {
        n++;
        printf("%d번째 fgets: [%s] (strlen = %zu)\n", n, line, strlen(line));
    }
    return 0;
}
fgets 가 NULL 을 돌려줄 때까지(입력이 끝날 때까지) 계속 읽습니다. 각 결과를 [ ] 로 감싸서 줄바꿈이 어디 있는지 보이게 했습니다.
$ gcc -Wall -Wextra -std=c11 fgetsw.c -o fgetsw
$ printf 'Hi\n' | ./fgetsw
1번째 fgets: [Hi
] (strlen = 3)
$ printf 'Hello, World!\n' | ./fgetsw
1번째 fgets: [Hello, ] (strlen = 7)
2번째 fgets: [World!
] (strlen = 7)
printf 는 1주차 5절에서 쓴 명령으로, echo 처럼 글자를 출력하되 \n 을 해석해 줍니다.
첫 번째 결과에서 ] 가 다음 줄로 밀렸습니다. Hi 뒤의 줄바꿈이 배열에 들어 있다는 증거입니다. 길이도 2가 아니라 3입니다.
두 번째 결과는 14글자짜리 줄을 8칸 배열로 읽은 것입니다. 첫 fgets 는 7글자(Hello,)만 읽고 '\0' 을 붙였고, 남은 World!\n 은 두 번째 fgets 가 읽었습니다. 한 줄이 두 번에 나뉘어 읽힌 것입니다. 배열을 넉넉하게 잡는 이유이고, 긴 줄을 제대로 다루려면 “끝에 '\n' 이 있는가”로 줄이 다 읽혔는지 확인해야 합니다.
fgets 가 남긴 줄바꿈 지우기
대부분의 경우 끝의 '\n' 은 필요 없습니다. 두 가지 방법이 있습니다.
// 방법 1: 마지막 글자가 '\n' 이면 '\0' 으로 바꾼다
size_t len = strlen(line);
if (len > 0 && line[len - 1] == '\n') {
    line[len - 1] = '\0';
}

// 방법 2: 한 줄로
line[strcspn(line, "\n")] = '\0';
방법 1은 뜻이 그대로 읽힙니다. strlen 은 11절에서 볼 “길이 구하기” 함수입니다. len > 0 을 먼저 확인하는 이유는, 빈 문자열이면 line[len - 1] 이 line[-1](4절의 범위 밖)이 되기 때문입니다.
방법 2의 strcspn(line, "\n") 은 “line 에서 "\n" 에 들어 있는 글자가 처음 나오는 위치“를 돌려줍니다. 줄바꿈이 없으면 문자열 끝('\0' 의 위치)을 돌려주므로, 그 자리에 '\0' 을 써도 아무 일도 일어나지 않습니다. 어느 경우든 안전해서 이번 주 프로젝트들은 모두 이 한 줄을 씁니다.
예제: 입력 받고 출력하기
examples/string_input.c:
/*
 * string_input.c - 문자열 입출력 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>
#include <string.h>

/*
 * 입력 버퍼를 줄 끝까지 비웁니다.
 *
 * EOF 를 반드시 같이 봐야 합니다. 이렇게 쓰면
 *
 *     while (getchar() != '\n');
 *
 * 파이프로 입력을 주거나 파일에서 읽을 때 여기서 영원히 돕니다.
 * 입력이 끝나면 getchar() 는 '\n' 이 아니라 EOF 를 계속 돌려주니까요.
 * 터미널에서 직접 치면 잘 돌아가서 더 찾기 어려운 버그입니다.
 */
static void flush_line(void)
{
    int c;

    while ((c = getchar()) != '\n' && c != EOF)
        ;
}

int main(void) {
    char word[50];
    char sentence[200];

    // scanf로 입력 (공백 전까지만!)
    printf("=== scanf 입력 (공백에서 끊김) ===\n");
    printf("단어 하나 입력: ");
    if (scanf("%49s", word) != 1) {   // 폭 49: 버퍼 오버플로우 방지
        printf("\n입력이 없습니다. 종료합니다.\n");
        return 1;
    }
    printf("입력된 단어: \"%s\"\n", word);

    // 버퍼 비우기 (scanf 후 남은 문자들)
    flush_line();

    // fgets로 입력 (공백 포함, 안전)
    printf("\n=== fgets 입력 (공백 포함) ===\n");
    printf("문장 입력: ");
    if (fgets(sentence, sizeof(sentence), stdin) == NULL) {
        printf("\n입력이 없습니다. 종료합니다.\n");
        return 1;
    }

    // fgets는 개행문자도 포함하므로 제거
    size_t len = strlen(sentence);
    if (len > 0 && sentence[len - 1] == '\n') {
        sentence[len - 1] = '\0';
        len--;
    }

    printf("입력된 문장: \"%s\"\n", sentence);
    printf("문장 길이: %zu\n", len);

    // puts로 출력 (자동 개행)
    printf("\n=== puts 출력 (자동 개행) ===\n");
    puts("Hello, World!");  // printf("Hello, World!\n"); 과 동일
    puts(sentence);

    // 문자 단위 입출력
    printf("\n=== 문자 단위 출력 ===\n");
    printf("문장을 문자 단위로: ");
    for (int i = 0; sentence[i] != '\0'; i++) {
        putchar(sentence[i]);
    }
    putchar('\n');

    // 문자열 길이 정보
    printf("\n=== 문자열 정보 ===\n");
    printf("배열 크기: %zu 바이트\n", sizeof(sentence));
    printf("문자열 길이: %zu 문자\n", strlen(sentence));
    printf("사용 가능 공간: %zu 문자\n", sizeof(sentence) - strlen(sentence) - 1);

    return 0;
}
flush_line() 은 3주차 13절에서 만든 그 함수입니다. 줄 끝까지 남은 글자를 읽어서 버립니다.
이 프로그램은 입력이 필요합니다. 직접 실행해서 키보드로 쳐도 되고, 입력 두 줄을 파이프로 넣어도 됩니다.
$ gcc -Wall -Wextra -std=c11 examples/string_input.c -o string_input
$ printf 'Kim Cheolsu\nI love C programming\n' | ./string_input
=== scanf 입력 (공백에서 끊김) ===
단어 하나 입력: 입력된 단어: "Kim"

=== fgets 입력 (공백 포함) ===
문장 입력: 입력된 문장: "I love C programming"
문장 길이: 20

=== puts 출력 (자동 개행) ===
Hello, World!
I love C programming

=== 문자 단위 출력 ===
문장을 문자 단위로: I love C programming

=== 문자열 정보 ===
배열 크기: 200 바이트
문자열 길이: 20 문자
사용 가능 공간: 179 문자
파이프로 넣으면 입력한 글자가 화면에 보이지 않아서 단어 하나 입력: 입력된 단어: 처럼 붙어 나옵니다. 키보드로 직접 치면 입력한 글자가 사이에 보입니다.
입력 흐름을 따라가 봅시다. 첫 줄 Kim Cheolsu 에서 scanf("%49s") 는 공백 앞의 Kim 만 가져갑니다. 입력 버퍼에는 Cheolsu\n 이 남습니다. flush_line() 이 이것을 줄 끝까지 읽어서 버립니다. 그래서 fgets 는 깨끗하게 둘째 줄 I love C programming\n 을 읽습니다.
만약 flush_line() 이 없었다면? fgets 는 남아 있던 Cheolsu\n 을 한 줄로 읽어 버리고, 사용자가 문장을 입력할 기회도 없이 넘어갑니다. 직접 flush_line(); 줄을 지우고 실행해 보세요. 2주차 7절에서 겪었던 “입력이 건너뛰어지는” 문제와 같은 원인입니다.
새로 나온 출력 함수 두 개:
puts(문자열): 문자열을 출력하고 자동으로 줄을 바꿉니다. 1주차 7절에서 GCC가printf("...\n")를 몰래 바꿔 부르던 바로 그 함수입니다.putchar(글자): 글자 하나를 출력합니다.printf("%c", c)와 같지만 더 가볍습니다.
배열 크기와 문자열 길이: 마지막 부분이 9절의 요점을 숫자로 보여 줍니다. 배열은 200칸이지만 문자열은 20글자이고, 앞으로 179글자를 더 넣을 수 있습니다(200 – 20 – '\0' 1칸).
실험: 입력 반환값을 확인하지 않으면
이 예제는 scanf 가 1을 돌려주는지, fgets 가 NULL 이 아닌지 확인합니다. 원래 저장소의 예제는 이 확인이 없었는데, 이 글을 쓰면서 입력 없이 실행해 봤더니 이런 일이 있었습니다.
$ ./string_input < /dev/null          # (반환값 확인이 없던 버전)
=== scanf 입력 (공백에서 끊김) ===
단어 하나 입력: 입력된 단어: "0�a��"

=== fgets 입력 (공백 포함) ===
문장 입력: 입력된 문장: "@"
문장 길이: 1
< /dev/null 은 “입력으로 아무것도 주지 않는다”는 뜻입니다. /dev/null 은 항상 비어 있는 특별한 파일입니다. 읽을 것이 없으니 scanf 는 실패했고 word 에 아무것도 넣지 않았습니다. 그런데 프로그램은 확인 없이 word 를 출력했고, 초기화되지 않은 배열의 쓰레기(3절)가 문자열인 척 찍혔습니다. fgets 도 마찬가지입니다.
입력 함수가 성공했는지 확인하지 않으면, 실패했을 때 쓰레기를 믿고 계속 달립니다. 지금 버전은 확인을 넣었기 때문에 이렇게 끝납니다.
$ ./string_input < /dev/null
=== scanf 입력 (공백에서 끊김) ===
단어 하나 입력:
입력이 없습니다. 종료합니다.
$ echo $?
1
11. 문자열 함수 (string.h)
문자열 길이 재기, 복사, 이어 붙이기, 비교, 검색은 너무 자주 하는 일이라 C 표준 라이브러리가 함수로 제공합니다. #include <string.h> 를 쓰면 됩니다. 각 함수를 “무엇을 받고, 무엇을 돌려주고, 무엇을 안 해 주는가” 로 봅니다. 마지막 질문이 특히 중요합니다.
| 함수 | 하는 일 | 크기를 아는가 |
|---|---|---|
strlen(s) |
길이 | – |
strcpy(dst, src) |
복사 | 모름 |
strncpy(dst, src, n) |
최대 n바이트 복사 | 앎 (함정 있음) |
strcat(dst, src) |
이어 붙이기 | 모름 |
strncat(dst, src, n) |
최대 n글자 이어 붙이기 | 앎 |
strcmp(a, b) |
비교 | – |
strncmp(a, b, n) |
앞 n글자 비교 | – |
strchr(s, c) / strrchr(s, c) |
글자 찾기 (앞에서 / 뒤에서) | – |
strstr(s, sub) |
부분 문자열 찾기 | – |
모든 함수는 man 3 함수이름 으로 설명서를 볼 수 있습니다. 설명서의 SYNOPSIS 에서 매개변수에 const 가 붙어 있으면 “이 함수는 그 문자열을 고치지 않는다”는 뜻입니다(6절).
strlen — 길이
size_t strlen(const char *s);
s 부터 '\0' 앞까지 글자(바이트) 수를 셉니다. '\0' 은 세지 않습니다. 반환 타입 size_t 는 “크기를 나타내는 부호 없는 정수”로, 2주차 10절에서 sizeof 의 결과 타입으로 봤고 %zu 로 출력합니다.
examples/strlen_example.c:
/*
 * strlen_example.c - strlen 함수 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>
#include <string.h>

// strlen 직접 구현
size_t my_strlen(const char *str) {
    size_t len = 0;
    while (str[len] != '\0') {
        len++;
    }
    return len;
}

int main(void) {
    char str1[] = "Hello";
    char str2[] = "Hello, World!";
    char str3[] = "";
    char str4[] = "한글 테스트";  // UTF-8에서는 한글 1글자 = 3바이트

    printf("=== strlen 함수 ===\n\n");

    printf("strlen(\"%s\") = %zu\n", str1, strlen(str1));
    printf("strlen(\"%s\") = %zu\n", str2, strlen(str2));
    printf("strlen(\"%s\") = %zu (빈 문자열)\n", str3, strlen(str3));
    printf("strlen(\"%s\") = %zu (UTF-8 바이트 수)\n", str4, strlen(str4));

    // sizeof vs strlen 비교
    printf("\n=== sizeof vs strlen ===\n");
    printf("str1[] = \"%s\"\n", str1);
    printf("sizeof(str1) = %zu (배열 전체 크기, \\0 포함)\n", sizeof(str1));
    printf("strlen(str1) = %zu (문자 개수, \\0 제외)\n", strlen(str1));

    // 직접 구현한 함수 테스트
    printf("\n=== my_strlen (직접 구현) ===\n");
    printf("my_strlen(\"%s\") = %zu\n", str1, my_strlen(str1));
    printf("my_strlen(\"%s\") = %zu\n", str2, my_strlen(str2));

    // 실용적 사용
    printf("\n=== 실용적 사용 ===\n");
    char message[100] = "Hello";
    size_t used = strlen(message);
    size_t remaining = sizeof(message) - used - 1;  // -1은 '\0' 공간

    printf("메시지: \"%s\"\n", message);
    printf("사용된 공간: %zu 바이트\n", used);
    printf("남은 공간: %zu 바이트\n", remaining);

    return 0;
}
$ gcc -Wall -Wextra -std=c11 examples/strlen_example.c -o strlen_example && ./strlen_example
=== strlen 함수 ===

strlen("Hello") = 5
strlen("Hello, World!") = 13
strlen("") = 0 (빈 문자열)
strlen("한글 테스트") = 16 (UTF-8 바이트 수)

=== sizeof vs strlen ===
str1[] = "Hello"
sizeof(str1) = 6 (배열 전체 크기, \0 포함)
strlen(str1) = 5 (문자 개수, \0 제외)

=== my_strlen (직접 구현) ===
my_strlen("Hello") = 5
my_strlen("Hello, World!") = 13

=== 실용적 사용 ===
메시지: "Hello"
사용된 공간: 5 바이트
남은 공간: 94 바이트
"한글 테스트" 의 길이가 16입니다. 여섯 글자(한글 5 + 공백 1)인데요. 1주차 6절의 UTF-8을 떠올리세요. 한글 한 글자는 3바이트입니다. 한글 5자 × 3 + 공백 1 = 16. strlen 은 글자 수가 아니라 바이트 수를 셉니다. 영어만 쓸 때는 둘이 같아서 차이를 못 느끼지만, 한글이 섞이면 “글자 수”와 “바이트 수”를 구분해야 합니다. 16절 프로젝트에서 이 차이 때문에 생기는 문제를 여러 번 만납니다.
sizeof 와 strlen 의 차이를 표로 정리합니다.
sizeof(arr) |
strlen(arr) |
|
|---|---|---|
| 무엇을 재나 | 배열이 차지하는 칸 수 | '\0' 앞까지의 글자 수 |
| 언제 결정되나 | 컴파일할 때 | 실행할 때 (한 글자씩 세어서) |
char s[20] = "Hi"; |
20 | 2 |
| 함수 매개변수에 쓰면 | 주소 크기 8 (6절) | 정상 |
strlen 은 문자열을 처음부터 '\0' 까지 매번 세어서 길이를 구합니다. 그래서 for (int i = 0; i < strlen(s); i++) 처럼 반복문 조건에 넣으면, 반복할 때마다 문자열 전체를 다시 셉니다. 긴 문자열에서는 느려지니, 길이를 변수에 한 번 받아 두고 쓰는 습관을 들이세요.
strcpy, strncpy — 복사
3절에서 배열은 = 로 복사할 수 없다고 했습니다. 문자열도 배열이니 마찬가지입니다. name = "Kim"; 은 오류입니다. 대신 strcpy 를 씁니다.
char *strcpy(char *dst, const char *src);
char *strncpy(char *dst, const char *src, size_t n);
순서에 주의하세요. 목적지가 먼저, 원본이 뒤입니다. 대입문 dst = src 와 같은 순서라고 기억하면 됩니다. 1주차 2절의 cp 원본 사본 과는 반대입니다.
examples/strcpy_example.c:
/*
 * strcpy_example.c - strcpy, strncpy 함수 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>
#include <string.h>

int main(void) {
    char src[] = "Hello, World!";
    char dest1[50];
    char dest2[50];
    char dest3[8];  // 작은 버퍼

    printf("=== strcpy 함수 ===\n");
    printf("원본: \"%s\"\n\n", src);

    // strcpy: 전체 복사
    strcpy(dest1, src);
    printf("strcpy(dest1, src):\n");
    printf("  결과: \"%s\"\n", dest1);

    // 여러 번 복사
    strcpy(dest1, "First");
    printf("\nstrcpy(dest1, \"First\"): \"%s\"\n", dest1);
    strcpy(dest1, "Second String");
    printf("strcpy(dest1, \"Second String\"): \"%s\"\n", dest1);

    // strncpy: n개만 복사 (안전)
    printf("\n=== strncpy 함수 ===\n");
    strncpy(dest2, src, 5);
    dest2[5] = '\0';  // 수동으로 널 종료 필요!
    printf("strncpy(dest2, src, 5):\n");
    printf("  결과: \"%s\"\n", dest2);

    // strncpy로 버퍼 크기 제한
    printf("\n=== 버퍼 오버플로우 방지 ===\n");
    printf("작은 버퍼 (크기: %zu)에 긴 문자열 복사\n", sizeof(dest3));

    // 안전한 복사 방법
    strncpy(dest3, src, sizeof(dest3) - 1);
    dest3[sizeof(dest3) - 1] = '\0';  // 항상 널 종료 보장
    printf("strncpy 결과: \"%s\"\n", dest3);

    // 빈 문자열 복사
    printf("\n=== 특수 케이스 ===\n");
    strcpy(dest1, "");
    printf("빈 문자열 복사: \"%s\" (길이: %zu)\n", dest1, strlen(dest1));

    // 자기 자신에게 복사 (주의: 정의되지 않은 동작!)
    // strcpy(src, src);  // 하지 마세요!

    return 0;
}
$ gcc -Wall -Wextra -std=c11 examples/strcpy_example.c -o strcpy_example && ./strcpy_example
=== strcpy 함수 ===
원본: "Hello, World!"

strcpy(dest1, src):
  결과: "Hello, World!"

strcpy(dest1, "First"): "First"
strcpy(dest1, "Second String"): "Second String"

=== strncpy 함수 ===
strncpy(dest2, src, 5):
  결과: "Hello"

=== 버퍼 오버플로우 방지 ===
작은 버퍼 (크기: 8)에 긴 문자열 복사
strncpy 결과: "Hello, "
strcpy 는 src 의 글자를 '\0' 까지 전부 dst 로 복사합니다. dst 가 충분히 큰지는 전혀 확인하지 않습니다. 6절에서 말한 “크기를 받지 않는 함수”입니다. dest1 은 50칸이라 문제가 없었지만, 작은 배열이었다면 12절에서 볼 사고가 납니다.
"First" 를 복사한 뒤 "Second String" 을 복사하면, 이전 내용은 새 글자로 덮이고 새 '\0' 이 끝을 표시합니다. 이전 내용 뒤쪽이 메모리에 남아 있더라도 '\0' 뒤라서 보이지 않습니다.
strncpy(dst, src, n) 은 최대 n바이트만 복사합니다. 크기를 받으니 안전해 보이지만, 함정이 있습니다. 예제 코드의 두 군데에서 복사한 직후 dest2[5] = '\0';, dest3[sizeof(dest3) - 1] = '\0'; 처럼 '\0' 을 손으로 넣은 것을 보세요. strncpy 는 src 가 n바이트보다 길면 '\0' 을 붙이지 않고 딱 n바이트만 복사하고 끝나기 때문입니다. 12절에서 이것을 빼먹으면 무슨 일이 생기는지 직접 봅니다.
작은 버퍼 결과는 "Hello, ", 쉼표 뒤의 공백까지 7글자입니다. 8칸 중 7칸에 글자, 마지막 한 칸에 '\0' 입니다.
strcat, strncat — 이어 붙이기
char *strcat(char *dst, const char *src);
char *strncat(char *dst, const char *src, size_t n);
dst 에 들어 있는 문자열의 끝('\0' 자리)부터 src 를 이어 붙입니다. cat 은 1주차의 cat 명령처럼 concatenate(이어 붙이다)입니다.
examples/strcat_example.c:
/*
 * strcat_example.c - strcat, strncat 함수 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>
#include <string.h>

int main(void) {
    char str1[50] = "Hello";
    char str2[50] = "Hello";
    char result[100] = "";

    printf("=== strcat 함수 ===\n");
    printf("초기값: \"%s\"\n\n", str1);

    // strcat: 문자열 연결
    strcat(str1, ", ");
    printf("strcat(str1, \", \"): \"%s\"\n", str1);

    strcat(str1, "World!");
    printf("strcat(str1, \"World!\"): \"%s\"\n", str1);

    // strncat: n개만 연결
    printf("\n=== strncat 함수 ===\n");
    printf("초기값: \"%s\"\n", str2);

    strncat(str2, ", World!", 7);  // 7문자만 연결
    printf("strncat(str2, \", World!\", 7): \"%s\"\n", str2);

    // 여러 문자열 연결
    printf("\n=== 여러 문자열 연결 ===\n");
    strcat(result, "I ");
    strcat(result, "love ");
    strcat(result, "C ");
    strcat(result, "programming!");
    printf("연결 결과: \"%s\"\n", result);
    printf("결과 길이: %zu\n", strlen(result));

    // 안전한 연결 (버퍼 크기 확인)
    printf("\n=== 안전한 연결 ===\n");
    char safe_buf[20] = "Hello";
    const char *to_add = ", World! This is a long string.";

    size_t current_len = strlen(safe_buf);
    size_t remaining = sizeof(safe_buf) - current_len - 1;

    printf("버퍼 크기: %zu\n", sizeof(safe_buf));
    printf("현재 길이: %zu\n", current_len);
    printf("남은 공간: %zu\n", remaining);

    strncat(safe_buf, to_add, remaining);
    printf("안전한 연결 결과: \"%s\"\n", safe_buf);
    printf("최종 길이: %zu\n", strlen(safe_buf));

    return 0;
}
$ gcc -Wall -Wextra -std=c11 examples/strcat_example.c -o strcat_example && ./strcat_example
=== strcat 함수 ===
초기값: "Hello"

strcat(str1, ", "): "Hello, "
strcat(str1, "World!"): "Hello, World!"

=== strncat 함수 ===
초기값: "Hello"
strncat(str2, ", World!", 7): "Hello, World"

=== 여러 문자열 연결 ===
연결 결과: "I love C programming!"
결과 길이: 21

=== 안전한 연결 ===
버퍼 크기: 20
현재 길이: 5
남은 공간: 14
안전한 연결 결과: "Hello, World! This "
최종 길이: 19
strcat 이 붙이는 과정을 그림으로 보면 이렇습니다.
strcat(str1, ", ") 전:   H e l l o \0 ? ? ? ...
                                  ↑ 여기서부터 붙인다
strcat(str1, ", ") 후:   H e l l o ,  _ \0 ? ...     (_ 는 공백)
result[100] = "": 빈 문자열로 초기화한 이유가 있습니다. strcat 은 dst 의 '\0' 을 찾아 거기서부터 붙이는데, 초기화하지 않으면 '\0' 이 어디 있는지 모릅니다. 3절의 쓰레기 값 뒤 어딘가에 붙이게 됩니다. strcat 으로 채울 배열은 반드시 "" 로 시작하세요.
strncat(dst, src, n): src 에서 최대 n글자를 붙이고, '\0' 은 항상 붙여 줍니다. strncpy 와 이름은 비슷한데 이 점이 반대입니다. ", World!" 에서 7글자 ", World" 만 붙었습니다.
안전한 연결의 계산을 보세요. n에는 “붙일 수 있는 남은 칸 수” 를 넘겨야 합니다. 배열 크기(20)가 아니라 20 - 현재 길이(5) - '\0' 한 칸(1) = 14 입니다. 결과는 14글자가 붙어 19글자, 20칸 배열에 딱 맞게 잘렸습니다. n에 sizeof(safe_buf) 를 그대로 넘기는 것은 아주 흔한 실수이고, 그러면 넘칩니다.
strcmp, strncmp — 비교
문자열이 같은지 비교하고 싶을 때 == 를 쓰고 싶어집니다. 해 봅시다.
eqcmp.c:
#include <stdio.h>
#include <string.h>

int main(void) {
    char a[] = "apple";
    char b[] = "apple";

    if (a == b) {
        printf("a == b : 같다\n");
    } else {
        printf("a == b : 다르다\n");
    }
    if (strcmp(a, b) == 0) {
        printf("strcmp : 같다\n");
    }
    printf("a 의 주소 = %p\nb 의 주소 = %p\n", (void *)a, (void *)b);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 eqcmp.c -o eqcmp
eqcmp.c: In function ‘main’:
eqcmp.c:8:11: warning: comparison between two arrays [-Warray-compare]
    8 |     if (a == b) {
      |           ^~
eqcmp.c:8:11: note: use ‘&a[0] == &b[0]’ to compare the addresses
$ ./eqcmp
a == b : 다르다
strcmp : 같다
a 의 주소 = 0x7ffd3a70bf4c
b 의 주소 = 0x7ffd3a70bf52
글자가 똑같은데 == 는 다르다고 합니다. GCC의 note 가 이유를 알려 줍니다. a == b 는 사실 &a[0] == &b[0], 즉 두 배열의 주소를 비교하고 있습니다. a 와 b 는 메모리에서 서로 다른 자리(...f4c 와 ...f52)에 있는 배열이니 주소가 다를 수밖에 없습니다. 내용을 비교하려면 반드시 strcmp 를 써야 합니다.
if (name == "Kim") 처럼 문자열 리터럴과 비교하면 더 나쁩니다.
eqlit.c:6:11: warning: comparison with string literal results in unspecified behavior [-Waddress]
“문자열 리터럴과의 비교는 결과가 정해져 있지 않다.” 우연히 참이 될 수도, 거짓이 될 수도 있다는 뜻입니다. 문자열 비교에 == 를 쓰는 것은 C 초보자의 가장 흔한 실수 중 하나입니다. 파이썬이나 자바스크립트에서 넘어온 사람일수록 자주 합니다.
int strcmp(const char *s1, const char *s2);
int strncmp(const char *s1, const char *s2, size_t n);
strcmp 는 두 문자열을 앞에서부터 한 글자씩 비교하다가, 처음으로 다른 글자가 나오면 그 두 글자의 크고 작음으로 결과를 정합니다.
| 반환값 | 뜻 |
|---|---|
0 |
두 문자열이 같다 |
| 음수 | s1 이 사전순으로 앞 (s1 < s2) |
| 양수 | s1 이 사전순으로 뒤 (s1 > s2) |
“같으면 0″이라서 if (strcmp(a, b)) 는 “다르면“이라는 뜻이 됩니다. 헷갈리니 항상 == 0 이나 != 0 을 명시해서 쓰세요.
examples/strcmp_example.c:
/*
 * strcmp_example.c - strcmp, strncmp 함수 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>
#include <string.h>

int main(void) {
    char str1[] = "apple";
    char str2[] = "banana";
    char str3[] = "apple";
    char str4[] = "Apple";
    char str5[] = "application";

    printf("=== strcmp 함수 ===\n\n");

    // 기본 비교
    printf("strcmp(\"%s\", \"%s\") = %d", str1, str2, strcmp(str1, str2));
    printf(" (음수: str1 < str2)\n");

    printf("strcmp(\"%s\", \"%s\") = %d", str1, str3, strcmp(str1, str3));
    printf(" (0: 같음)\n");

    printf("strcmp(\"%s\", \"%s\") = %d", str2, str1, strcmp(str2, str1));
    printf(" (양수: str2 > str1)\n");

    // 대소문자 구분
    printf("\n=== 대소문자 구분 ===\n");
    printf("strcmp(\"%s\", \"%s\") = %d\n", str1, str4, strcmp(str1, str4));
    printf("'a' ASCII = %d, 'A' ASCII = %d\n", 'a', 'A');
    printf("결론: 대문자가 소문자보다 작음 (ASCII 순)\n");

    // 문자열 같은지 확인
    printf("\n=== 문자열 동등 비교 ===\n");
    if (strcmp(str1, str3) == 0) {
        printf("\"%s\"와 \"%s\"는 같습니다.\n", str1, str3);
    }

    if (strcmp(str1, str4) != 0) {
        printf("\"%s\"와 \"%s\"는 다릅니다.\n", str1, str4);
    }

    // strncmp: 처음 n개만 비교
    printf("\n=== strncmp 함수 ===\n");
    printf("str1 = \"%s\"\n", str1);
    printf("str5 = \"%s\"\n", str5);

    printf("strncmp(str1, str5, 4) = %d", strncmp(str1, str5, 4));
    printf(" (처음 4글자 \"appl\" 비교: 같음)\n");

    printf("strncmp(str1, str5, 5) = %d", strncmp(str1, str5, 5));
    printf(" (5번째 글자 'e'와 'i'가 다름)\n");

    printf("strcmp(str1, str5) = %d", strcmp(str1, str5));
    printf(" (전체 비교: str1 < str5)\n");

    // 실용적 사용: 접두사 확인
    printf("\n=== 접두사 확인 ===\n");
    char filename[] = "image.png";
    if (strncmp(filename, "image", 5) == 0) {
        printf("\"%s\"는 'image'로 시작합니다.\n", filename);
    }

    // 정렬된 순서 확인
    printf("\n=== 사전순 정렬 ===\n");
    char *words[] = {"banana", "apple", "cherry", "date"};
    int n = 4;

    // 버블 정렬
    for (int i = 0; i < n - 1; i++) {
        for (int j = 0; j < n - 1 - i; j++) {
            if (strcmp(words[j], words[j + 1]) > 0) {
                char *temp = words[j];
                words[j] = words[j + 1];
                words[j + 1] = temp;
            }
        }
    }

    printf("정렬 결과: ");
    for (int i = 0; i < n; i++) {
        printf("%s ", words[i]);
    }
    printf("\n");

    return 0;
}
$ gcc -Wall -Wextra -std=c11 examples/strcmp_example.c -o strcmp_example && ./strcmp_example
=== strcmp 함수 ===

strcmp("apple", "banana") = -1 (음수: str1 < str2)
strcmp("apple", "apple") = 0 (0: 같음)
strcmp("banana", "apple") = 1 (양수: str2 > str1)

=== 대소문자 구분 ===
strcmp("apple", "Apple") = 32
'a' ASCII = 97, 'A' ASCII = 65
결론: 대문자가 소문자보다 작음 (ASCII 순)

=== 문자열 동등 비교 ===
"apple"와 "apple"는 같습니다.
"apple"와 "Apple"는 다릅니다.

=== strncmp 함수 ===
str1 = "apple"
str5 = "application"
strncmp(str1, str5, 4) = 0 (처음 4글자 "appl" 비교: 같음)
strncmp(str1, str5, 5) = -4 (5번째 글자 'e'와 'i'가 다름)
strcmp(str1, str5) = -4 (전체 비교: str1 < str5)

=== 접두사 확인 ===
"image.png"는 'image'로 시작합니다.

=== 사전순 정렬 ===
정렬 결과: apple banana cherry date
반환값의 크기에는 의미를 두지 마세요. 이 컴퓨터(glibc)에서는 처음 다른 두 글자의 차이가 그대로 나왔습니다. 'a' – 'b' = -1, 'a' – 'A' = 32, 'e' – 'i' = -4 입니다. 하지만 C 표준이 약속하는 것은 부호(음수, 0, 양수)뿐입니다. 다른 시스템에서는 -1, 0, 1만 나올 수도 있습니다. 그러니 if (strcmp(a, b) == -1) 처럼 쓰면 안 되고, 항상 < 0, == 0, > 0 으로 비교하세요.
대소문자: "apple" 과 "Apple" 은 다른 문자열이고, 첫 글자 'a'(97)가 'A'(65)보다 크므로 "apple" 이 뒤입니다. strcmp 의 “사전순”은 사실 ASCII 번호순이라서, 대문자로 시작하는 모든 단어가 소문자 단어보다 앞에 옵니다. "Zebra" 가 "apple" 보다 앞입니다.
strncmp(a, b, n) 은 앞 n글자만 비교합니다. "apple" 과 "application" 은 앞 4글자 appl 은 같고 5번째 글자에서 'e' 와 'i' 로 갈립니다. 그래서 n이 4면 0, 5면 음수입니다. “이 파일 이름이 image 로 시작하는가” 같은 접두사 확인에 유용합니다.
이 예제에서 찾은 버그: 원래 예제는
strncmp(str1, str5, 5)를 쓰면서 설명에 “(처음 5글자 비교: 같음)”이라고 적어 두었습니다. 그런데 출력은 0이 아니라 -4였습니다. 설명이 결과와 어긋나 있었던 것이죠. 설명과 실행 결과가 다르면 둘 중 하나가 틀린 것입니다. 출력을 꼼꼼히 읽는 습관이 이런 버그를 잡습니다.
마지막 char *words[] 는 문자열 주소 네 개를 담은 배열입니다. 정렬할 때 글자를 복사하지 않고 주소만 맞바꾸면 되어서 편한데, 이 모양은 6주차 포인터를 배운 뒤 7주차에서 제대로 다룹니다. 15절에서는 글자를 직접 복사하는 방식으로 정렬하는 예제를 봅니다.
strchr, strrchr, strstr — 검색
char *strchr(const char *s, int c);           // 글자 c 가 처음 나오는 곳
char *strrchr(const char *s, int c);          // 글자 c 가 마지막으로 나오는 곳 (r = reverse)
char *strstr(const char *s, const char *sub); // 문자열 sub 가 처음 나오는 곳
반환 타입이 char *, 주소입니다. 찾으면 찾은 위치의 주소를, 못 찾으면 NULL(아무것도 가리키지 않는 특별한 주소)을 돌려줍니다. 5절에서 본 센티널 -1 과 같은 발상입니다. 주소를 돌려받으면 두 가지를 할 수 있습니다.
- 그 주소를
%s로 출력하면, 찾은 곳부터 끝까지의 문자열이 나옵니다. - 찾은 주소 – 시작 주소를 계산하면 인덱스가 나옵니다. 1절에서 주소가 칸 크기만큼 늘어나는 것을 봤죠.
char는 1바이트라 주소 차이가 곧 칸 수입니다.
examples/search_example.c:
/*
 * search_example.c - strchr, strstr 검색 함수 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>
#include <string.h>

int main(void) {
    char str[] = "Hello, World! Hello, C Programming!";

    printf("원본 문자열: \"%s\"\n\n", str);

    // strchr: 문자 검색
    printf("=== strchr (문자 검색) ===\n");
    char *p1 = strchr(str, 'o');
    if (p1) {
        printf("첫 번째 'o' 위치: %td\n", p1 - str);
        printf("'o'부터의 문자열: \"%s\"\n", p1);
    }

    // strrchr: 마지막 문자 검색
    printf("\n=== strrchr (뒤에서 검색) ===\n");
    char *p2 = strrchr(str, 'o');
    if (p2) {
        printf("마지막 'o' 위치: %td\n", p2 - str);
        printf("마지막 'o'부터: \"%s\"\n", p2);
    }

    // strstr: 문자열 검색
    printf("\n=== strstr (문자열 검색) ===\n");
    char *p3 = strstr(str, "World");
    if (p3) {
        printf("\"World\" 시작 위치: %td\n", p3 - str);
        printf("\"World\"부터: \"%s\"\n", p3);
    }

    char *p4 = strstr(str, "Hello");
    if (p4) {
        printf("\"Hello\" 시작 위치: %td\n", p4 - str);
    }

    // 찾지 못한 경우
    printf("\n=== 찾지 못한 경우 ===\n");
    char *p5 = strchr(str, 'z');
    if (p5 == NULL) {
        printf("'z' 문자를 찾지 못했습니다.\n");
    }

    char *p6 = strstr(str, "Python");
    if (p6 == NULL) {
        printf("\"Python\"을 찾지 못했습니다.\n");
    }

    // 모든 발생 위치 찾기
    printf("\n=== 모든 'o' 위치 찾기 ===\n");
    char *ptr = str;
    int count = 0;
    while ((ptr = strchr(ptr, 'o')) != NULL) {
        printf("위치 %td: '%c'\n", ptr - str, *ptr);
        ptr++;  // 다음 위치로
        count++;
    }
    printf("총 %d개 발견\n", count);

    // 모든 "Hello" 위치 찾기
    printf("\n=== 모든 \"Hello\" 위치 찾기 ===\n");
    ptr = str;
    count = 0;
    while ((ptr = strstr(ptr, "Hello")) != NULL) {
        printf("위치 %td에서 발견\n", ptr - str);
        ptr++;  // 다음 위치로
        count++;
    }
    printf("총 %d개 발견\n", count);

    return 0;
}
$ gcc -Wall -Wextra -std=c11 examples/search_example.c -o search_example && ./search_example
원본 문자열: "Hello, World! Hello, C Programming!"

=== strchr (문자 검색) ===
첫 번째 'o' 위치: 4
'o'부터의 문자열: "o, World! Hello, C Programming!"

=== strrchr (뒤에서 검색) ===
마지막 'o' 위치: 25
마지막 'o'부터: "ogramming!"

=== strstr (문자열 검색) ===
"World" 시작 위치: 7
"World"부터: "World! Hello, C Programming!"
"Hello" 시작 위치: 0

=== 찾지 못한 경우 ===
'z' 문자를 찾지 못했습니다.
"Python"을 찾지 못했습니다.

=== 모든 'o' 위치 찾기 ===
위치 4: 'o'
위치 8: 'o'
위치 18: 'o'
위치 25: 'o'
총 4개 발견

=== 모든 "Hello" 위치 찾기 ===
위치 0에서 발견
위치 14에서 발견
총 2개 발견
인덱스를 직접 세어 확인해 봅시다.
H  e  l  l  o  ,     W  o  r  l  d  !     H  e  l  l  o  ,     C     P  r  o  g ...
0  1  2  3  4  5  6  7  8  9  10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26
            ↑                 ↑                 ↑                             ↑
          첫 'o'             'o'               'o'                        마지막 'o'
if (p1): NULL 은 거짓으로 취급되므로, “찾았으면”이라는 뜻입니다. 찾지 못했는데 p1 을 %s 로 출력하면 세그멘테이션 오류가 나니, 검색 함수의 결과는 반드시 NULL 인지 확인하고 씁니다.
%td: 두 주소의 차이는 ptrdiff_t 라는 타입이고, 그 전용 서식 지정자가 %td 입니다. 원래 예제는 %ld 를 썼는데, 64비트 리눅스에서는 우연히 같은 크기라 동작하지만 다른 시스템에서는 틀릴 수 있어서 이번에 %td 로 고쳤습니다. 2주차 6절에서 본 것처럼 값의 타입에 맞는 서식 지정자를 쓰는 것이 원칙입니다.
모든 위치 찾기: 반복문 조건 (ptr = strchr(ptr, 'o')) != NULL 은 “검색해서 결과를 ptr 에 넣고, 그게 NULL 이 아닌 동안”이라는 뜻입니다. 3주차의 (c = getchar()) != EOF 와 같은 모양입니다. 찾은 다음 ptr++ 로 한 칸 뒤부터 다시 찾습니다. 이 줄을 빼면 같은 'o' 를 계속 찾아서 무한 반복에 빠집니다. 직접 지워 보고 Ctrl + C 로 멈춰 보세요.
ptr++ 처럼 주소에 1을 더해 다음 칸으로 가는 것을 포인터 연산이라고 하고, 6주차의 중심 주제입니다. 지금은 “주소에 1을 더하면 다음 글자”라는 것만 기억하세요.
12. 안전한 문자열 처리
지금까지 본 것을 한 문장으로 요약하면 이렇습니다. C의 문자열 함수는 대부분 목적지가 얼마나 큰지 모릅니다. strcpy, strcat, 폭 없는 scanf("%s") 는 원본이 얼마나 길든 목적지에 그대로 써 넣습니다. 목적지보다 길면 4절의 범위 밖 쓰기가 되고, 이것이 버퍼 오버플로우입니다. 이 절에서는 문자열 사고를 직접 내 보고, 표준적인 방어법을 정리합니다.
off-by-one: 한 칸의 비극
크기 N인 배열에 담을 수 있는 글자는 N-1개입니다. '\0' 자리 한 칸 때문이죠. 이 한 칸을 잊는 실수를 off-by-one 오류(하나 차이 오류)라고 합니다.
char buf[5];
strcpy(buf, "hello");    // 글자 5개 + '\0' = 6칸 필요, buf 는 5칸
이 경우는 컴파일러가 잡아 줍니다.
$ gcc -Wall -Wextra -std=c11 cpy5.c -o cpy5
cpy5.c: In function ‘main’:
cpy5.c:6:5: warning: ‘__builtin_memcpy’ writing 6 bytes into a region of size 5 overflows the destination [-Wstringop-overflow=]
    6 |     strcpy(buf, "hello");
      |     ^~~~~~~~~~~~~~~~~~~~
cpy5.c:5:10: note: destination object ‘buf’ of size 5
    5 |     char buf[5];
      |          ^~~
“6바이트를 5바이트 공간에 쓰려 한다.” 원본이 리터럴이라 길이를 알 수 있었기 때문입니다. 하지만 원본이 사용자 입력이면 컴파일러는 알 수 없습니다. 그리고 이 코드는 실행하면 멀쩡히 hello 를 찍고 끝납니다. 4절의 oobw 처럼 증상 없는 버그입니다.
절대 쓰면 안 되는 함수: gets
옛날 C에는 한 줄을 읽는 gets(buf) 라는 함수가 있었습니다. fgets 에서 크기와 stdin 을 뺀 모양입니다. 크기를 받지 않으니 막을 방법이 없습니다. 입력이 배열보다 길면 무조건 넘칩니다. 1988년 인터넷 역사상 첫 대형 웜(모리스 웜)이 바로 gets 를 쓴 프로그램의 버퍼 오버플로우를 이용했습니다.
그래서 gets 는 C11 표준에서 완전히 삭제되었습니다. 지금 써 보면 이렇게 됩니다.
$ gcc -Wall -Wextra -std=c11 gets.c -o gets
gets.c: In function ‘main’:
gets.c:5:5: warning: implicit declaration of function ‘gets’; did you mean ‘fgets’? [-Wimplicit-function-declaration]
    5 |     gets(buf);
      |     ^~~~
      |     fgets
/usr/bin/ld: /tmp/ccyFQqXn.o: in function `main':
gets.c:(.text+0x28): warning: the `gets' function is dangerous and should not be used.
두 가지 메시지가 나옵니다. 컴파일러는 “gets 의 선언이 없다. fgets 를 말한 것 아니냐”고 묻습니다. stdio.h 에서 gets 의 선언 자체가 빠졌기 때문입니다(1주차 10절의 “헤더 파일 누락”과 같은 경고). 그리고 링커(1주차 7절)는 “gets 함수는 위험하니 쓰지 말라”고 경고합니다. 오래된 책이나 인터넷 예제에서 gets 를 보면 무조건 fgets 로 바꾸세요.
strncpy 의 함정: ‘\0’ 이 없는 결과
11절에서 strncpy 는 원본이 길면 '\0' 을 붙이지 않는다고 했습니다. 붙이는 것을 잊으면 어떻게 될까요?
ncpy.c:
#include <stdio.h>
#include <string.h>

int main(void) {
    char dest[8];
    char after[8] = "AFTER";

    strncpy(dest, "Hello, World!", sizeof(dest));    /* 8바이트 복사, '\0' 없음 */
    printf("dest  = %s\n", dest);

    dest[sizeof(dest) - 1] = '\0';                   /* 마지막 칸을 직접 막는다 */
    printf("dest  = %s\n", dest);
    printf("after = %s\n", after);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 ncpy.c -o ncpy
ncpy.c:8:5: warning: ‘strncpy’ output truncated copying 8 bytes from a string of length 13 [-Wstringop-truncation]
$ ./ncpy
dest  = Hello, WAFTER
dest  = Hello,
after = AFTER
첫 출력이 Hello, WAFTER 입니다. 9절 nonul.c 와 같은 사고입니다. strncpy 는 8칸을 Hello, W 로 꽉 채우고 '\0' 없이 끝났고, printf 는 dest 를 넘어 옆 배열 after 까지 읽었습니다. GCC도 “13글자짜리에서 8바이트만 복사해 잘렸다(truncated)”고 경고했습니다.
마지막 칸에 '\0' 을 손으로 넣은 뒤에는 Hello, 7글자로 정상입니다. strncpy 를 쓴 다음에는 반드시 마지막 칸을 '\0' 으로 막으세요. 이 한 줄을 빼먹기 쉬워서, 아래의 snprintf 를 더 권합니다.
현대 C의 표준 도구: snprintf
여러 값을 조립해서 문자열을 만들 때 가장 안전하고 편한 도구는 snprintf 입니다.
int snprintf(char *s, size_t size, const char *format, ...);
printf 와 똑같이 서식을 쓰되, 결과를 화면이 아니라 배열 s 에 씁니다. 그리고 size 를 받아서 절대 넘치지 않고, 항상 '\0' 으로 끝냅니다. 반환값은 “잘리지 않았다면 필요했을 길이”라서, 이 값이 size 이상이면 잘렸다는 뜻입니다.
snp.c:
#include <stdio.h>

int main(void) {
    char msg[16];
    int need;

    need = snprintf(msg, sizeof(msg), "%s님 %d점", "철수", 95);
    printf("[%s] 필요한 길이 %d, 버퍼 %zu\n", msg, need, sizeof(msg));

    need = snprintf(msg, sizeof(msg), "%s님의 점수는 %d점입니다.", "철수", 95);
    printf("[%s] 필요한 길이 %d, 버퍼 %zu\n", msg, need, sizeof(msg));
    if (need >= (int)sizeof(msg)) {
        printf("잘렸습니다!\n");
    }
    return 0;
}
$ gcc -Wall -Wextra -std=c11 snp.c -o snp
snp.c:10:49: warning: ‘님의 점수는 ’ directive output truncated writing 17 bytes into a region of size 10 [-Wformat-truncation=]
snp.c:10:12: note: ‘snprintf’ output 39 bytes into a destination of size 16
$ ./snp
[철수님 95점] 필요한 길이 15, 버퍼 16
[철수님의 �] 필요한 길이 38, 버퍼 16
잘렸습니다!
첫 번째는 15바이트(한글 4자 × 3 + 공백 1 + 숫자 2)라 16칸에 들어갔습니다. 두 번째는 38바이트가 필요한데 16칸밖에 없어서 15바이트까지만 쓰고 '\0' 으로 막았습니다. 넘치지는 않았고, 반환값 38로 잘렸다는 것도 알 수 있습니다.
그런데 두 번째 결과 끝에 � 가 보입니다. 15바이트에서 자르다 보니 한글 한 글자(3바이트)의 중간에서 잘렸기 때문입니다. 철수님의 까지가 13바이트이고, 다음 글자 점 의 3바이트 중 앞 2바이트만 들어가서, 터미널이 그것을 글자로 그리지 못하고 �(깨진 글자 표시)로 보여 준 것입니다. 바이트 단위로 자르면 UTF-8 글자가 부서질 수 있습니다. 11절의 “strlen 은 바이트 수”와 같은 뿌리의 문제입니다.
정리: 위험한 방법과 안전한 방법
| 상황 | 위험 | 안전 |
|---|---|---|
| 단어 입력 | scanf("%s", buf) |
scanf("%49s", buf) (폭 = 크기 – 1) |
| 한 줄 입력 | gets(buf) (C11에서 삭제) |
fgets(buf, sizeof(buf), stdin) |
| 복사 | strcpy(dst, src) (길이 확인 없이) |
길이를 먼저 확인하거나, snprintf(dst, sizeof(dst), "%s", src) |
| 제한 복사 | strncpy 후 '\0' 을 안 넣음 |
strncpy 후 dst[sizeof(dst) - 1] = '\0'; |
| 이어 붙이기 | strcat 반복 |
strncat(dst, src, 남은칸), 또는 snprintf 로 한 번에 |
| 입력 결과 | 반환값 확인 없이 사용 | scanf(...) != 1, fgets(...) == NULL 확인 |
원칙은 하나입니다. 버퍼에 무언가를 쓸 때는 언제나 그 버퍼의 크기를 함께 넘긴다. 크기를 받지 않는 함수는 크기를 받는 함수로 바꾸면 됩니다. 24주차 보안 프로그래밍에서 이 원칙이 왜 생명줄인지, 공격하는 쪽의 시점에서 다시 봅니다.
13. 문자열 함수 직접 만들기
표준 함수를 쓸 줄 알게 됐으니, 이제 직접 만들어 봅시다. 직접 만들어 보면 “strcmp 는 왜 이렇게 동작하지?”, “strncpy 는 왜 '\0' 을 안 붙이지?” 같은 궁금증이 저절로 풀립니다. 그리고 문자열을 다루는 반복문 패턴이 손에 익습니다.
examples/string_implement.c 의 함수들을 하나씩 봅니다. 함수 이름 앞의 my_ 는 표준 함수와 이름이 겹치지 않게 붙인 것입니다.
my_strlen: ‘\0’ 까지 세기
size_t my_strlen(const char *str) {
    size_t len = 0;
    while (str[len] != '\0') {
        len++;
    }
    return len;
}
9절 string_basic.c 의 길이 계산을 함수로 만든 것입니다. 매개변수가 char str[] 가 아니라 const char *str 인 것은, 6절에서 봤듯 배열 매개변수는 어차피 주소로 받기 때문에 표준 함수들과 같은 모양으로 쓴 것입니다. str[len] 처럼 배열처럼 쓸 수 있는 것도 6절의 arr[i] = *(arr + i) 덕분입니다.
my_strcpy: ‘\0’ 까지 복사, 그리고 ‘\0’ 도
char *my_strcpy(char *dest, const char *src) {
    int i = 0;
    while (src[i] != '\0') {
        dest[i] = src[i];
        i++;
    }
    dest[i] = '\0';
    return dest;
}
반복문이 끝나는 조건이 src[i] != '\0' 이라서, '\0' 자체는 반복문 안에서 복사되지 않습니다. 그래서 반복문이 끝난 뒤 dest[i] = '\0'; 으로 끝 표시를 따로 붙입니다. 이 한 줄을 잊으면 9절 nonul.c 의 사고가 납니다.
이 함수 어디에도 dest 의 크기를 확인하는 코드가 없다는 것을 보세요. 표준 strcpy 도 똑같습니다. 확인하고 싶어도 크기를 받지 않으니 할 수가 없습니다.
반환값이 dest 인 것도 표준을 따른 것입니다. 이렇게 하면 printf("%s", my_strcpy(buf, "hi")); 처럼 결과를 바로 쓸 수 있습니다.
my_strncpy: 표준이 왜 ‘\0’ 을 안 붙이는지
char *my_strncpy(char *dest, const char *src, size_t n) {
    size_t i;
    for (i = 0; i < n && src[i] != '\0'; i++) {
        dest[i] = src[i];
    }
    for (; i < n; i++) {
        dest[i] = '\0';  // 나머지는 '\0'으로 채움
    }
    return dest;
}
첫 반복문은 n글자를 채우거나 src 가 끝나면 멈춥니다. 두 번째 반복문은 남은 칸을 '\0' 으로 채웁니다. for (; i < n; i++) 의 비어 있는 첫 칸은 “초기화는 하지 않고, 첫 반복문이 끝난 i 에서 이어 간다”는 뜻입니다.
여기서 strncpy 의 정체가 드러납니다. src 가 n보다 짧으면 두 번째 반복문이 '\0' 을 채워 줍니다. 그런데 src 가 n 이상으로 길면 첫 반복문이 n칸을 꽉 채우고, 두 번째 반복문은 한 번도 돌지 않습니다. '\0' 을 쓸 자리가 없는 것입니다. strncpy 는 원래 “고정 폭 칸에 이름을 채워 넣는” 옛날 용도로 만들어진 함수라서 이렇게 동작합니다. 안전한 복사 함수로 설계된 것이 아니었던 거죠.
my_strcmp: 왜 unsigned char 일까
int my_strcmp(const char *s1, const char *s2) {
    int i = 0;
    while (s1[i] != '\0' && s2[i] != '\0') {
        if (s1[i] != s2[i]) {
            return (unsigned char)s1[i] - (unsigned char)s2[i];
        }
        i++;
    }
    return (unsigned char)s1[i] - (unsigned char)s2[i];
}
두 문자열을 같은 인덱스끼리 비교하다가, 다른 글자를 만나면 두 글자의 차이를 돌려줍니다. 11절에서 glibc가 -1, 32, -4 를 돌려준 것과 같은 방식입니다.
반복문이 끝난 뒤의 return 은 한쪽 문자열이 먼저 끝난 경우입니다. "apple" 과 "application" 은 앞 4글자가 같고, 5번째에서 'e' 와 'i' 가 달라 반복문 안에서 끝납니다. 그런데 "app" 과 "apple" 이면 "app" 이 먼저 끝나고, 반복문 뒤에서 '\0'(0) – 'l'(108) = 음수를 돌려줍니다. 짧은 쪽이 사전순으로 앞이라는, 우리가 아는 사전의 규칙 그대로입니다. 두 문자열이 완전히 같으면 둘 다 '\0' 에서 멈추고 0 – 0 = 0 입니다.
(unsigned char) 로 바꾸는 이유: char 는 부호가 있는 타입(-128~127)인 경우가 많습니다. x86 리눅스가 그렇습니다. 그런데 한글처럼 128 이상인 바이트(UTF-8 한글의 바이트는 모두 128 이상입니다)는 부호 있는 char 에서 음수로 저장됩니다. 그러면 'a'(97)와 한글 바이트(음수)를 비교할 때 한글이 더 작다고 판단해 버립니다. unsigned char 로 바꾸면 모든 바이트가 0~255로 비교되어, 표준 strcmp 와 같은 결과가 됩니다. C 표준도 “strcmp 는 각 글자를 unsigned char 로 해석해 비교한다”고 정해 두었습니다.
my_strcat, my_strchr, my_strstr
// strcat 직접 구현
char *my_strcat(char *dest, const char *src) {
    size_t dest_len = my_strlen(dest);
    int i = 0;
    while (src[i] != '\0') {
        dest[dest_len + i] = src[i];
        i++;
    }
    dest[dest_len + i] = '\0';
    return dest;
}
dest 의 길이를 재서 '\0' 이 있던 자리부터 src 를 복사합니다. my_strcpy 와 똑같고, 쓰기 시작하는 위치만 dest_len 만큼 밀려 있습니다. 11절의 strcat 그림과 비교해 보세요.
// strchr 직접 구현
char *my_strchr(const char *str, int c) {
    while (*str != '\0') {
        if (*str == (char)c) {
            return (char *)str;
        }
        str++;
    }
    // '\0'도 찾을 수 있음
    if (c == '\0') {
        return (char *)str;
    }
    return NULL;
}
이 함수는 인덱스 대신 주소를 직접 한 칸씩 옮기는 방식으로 썼습니다. *str 은 “str 이 가리키는 곳의 글자”(str[0] 과 같음)이고, str++ 는 11절에서 본 “다음 칸으로”입니다. 같은 일을 인덱스로 쓰면 이렇습니다.
for (int i = 0; str[i] != '\0'; i++) {
    if (str[i] == (char)c) {
        return (char *)&str[i];
    }
}
두 방식은 완전히 같은 일을 합니다. 주소를 직접 옮기는 방식은 6주차 포인터에서 자세히 다루고, 실무 C 코드에서 아주 흔하게 쓰니 모양에 익숙해져 두세요.
my_strstr 은 haystack(건초 더미)에서 needle(바늘)을 찾습니다. “건초 더미에서 바늘 찾기”라는 영어 관용구에서 온 이름으로, 표준 설명서도 이 이름을 씁니다. 전체 코드는 examples/string_implement.c 에 있습니다. 동작은 이렇습니다. haystack 의 각 위치에서 “여기서부터 needle 과 한 글자씩 맞춰 보기”를 하고, needle 끝('\0')까지 전부 맞으면 그 위치를 돌려줍니다. 16주차 “문자열 알고리즘”에서는 이 단순한 방법보다 훨씬 빠른 검색 방법들을 배웁니다.
실행
$ gcc -Wall -Wextra -std=c11 examples/string_implement.c -o string_implement && ./string_implement
=== 직접 구현한 문자열 함수 ===

my_strlen("Hello") = 5
my_strcpy -> "Hello"
my_strcmp("Hello", "Hello") = 0
my_strcmp("Hello", "World") = -15
my_strcat -> "Hello, World"
my_strchr: 'o' at position 4
my_strstr: "World" at position 7

모든 함수가 정상 동작합니다!
my_strcmp("Hello", "World") 가 -15 인 것을 확인해 보세요. 첫 글자 'H'(72)와 'W'(87)가 달라서 72 – 87 = -15 입니다.
직접 해 보기:
my_strlen의 조건str[len] != '\0'을str[len] != 0으로 바꿔도 똑같이 동작합니다. 왜 그럴까요? 그리고'0'으로 바꾸면 어떻게 될까요? 9절의 “'\0'과'0'은 다르다”를 떠올려 예상해 본 뒤 실행해 보세요.
14. 문자 처리 함수 (ctype.h)
“이 글자가 알파벳인가?”, “숫자인가?”, “대문자로 바꾸면?” 같은 질문은 문자열을 다룰 때 끊임없이 나옵니다. 9절에서 본 ASCII 번호로 직접 계산할 수도 있지만(c >= 'a' && c <= 'z'), 표준 라이브러리 <ctype.h> 에 이런 함수들이 준비되어 있습니다. 이름이 모두 is(~인가?) 또는 to(~로 바꾸기)로 시작합니다.
| 함수 | 질문 / 동작 | 참이 되는 글자 |
|---|---|---|
isalpha(c) |
알파벳인가? (alphabet) | A~Z, a~z |
isdigit(c) |
숫자인가? (digit) | 0~9 |
isalnum(c) |
알파벳이나 숫자인가? (alphabet + number) | 위 둘 |
isspace(c) |
공백 문자인가? | 스페이스, \t, \n, \r 등 |
isupper(c) / islower(c) |
대문자인가? / 소문자인가? | |
ispunct(c) |
구두점인가? (punctuation) | !, ,, ., ? 등 |
toupper(c) / tolower(c) |
대문자로 / 소문자로 바꾼 값을 돌려줌 | 알파벳이 아니면 그대로 돌려줌 |
규칙 두 가지
규칙 1: is 함수의 결과는 “0 아니면 0이 아닌 값”입니다. 1이 아닙니다. 직접 찍어 봤습니다.
0x61 ('a'): isalpha=1024 isdigit=0    isupper=0
0x5a ('Z'): isalpha=1024 isdigit=0    isupper=256
0x35 ('5'): isalpha=0    isdigit=2048 isupper=0
glibc의 isalpha 는 참일 때 1024를, isdigit 는 2048을 돌려줍니다. 그래서 if (isalpha(c) == 1) 은 항상 거짓이 됩니다. if (isalpha(c)) 처럼 참/거짓으로만 쓰세요. 3주차에서 배운 대로 C에서는 0이 아닌 모든 값이 참입니다.
규칙 2: char 를 넘길 때는 (unsigned char) 로 바꿔서 넘깁니다. 설명서(man 3 isalpha)에 이렇게 적혀 있습니다. “인자는 unsigned char 로 표현할 수 있는 값이거나 EOF 여야 한다. 그렇지 않으면 동작이 정의되지 않는다.” 13절에서 봤듯 한글 바이트는 부호 있는 char 에서 음수가 됩니다. 음수를 그대로 넘기는 것은 규칙 위반입니다. glibc에서는 우연히 동작하지만, 다른 시스템에서는 프로그램이 죽을 수도 있습니다. 이번에 이번 주 예제와 프로젝트의 ctype 호출에 이 변환을 모두 넣었습니다.
char c = str[i];
if (isalpha((unsigned char)c)) { ... }       // 바른 방법
예제
examples/ctype_example.c:
/*
 * ctype_example.c - ctype.h 문자 처리 함수 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>
#include <ctype.h>
#include <string.h>

int main(void) {
    char str[] = "Hello, World! 123 ABC abc";

    printf("문자열: \"%s\"\n\n", str);

    // 각 문자 분석
    printf("=== 문자 분석 ===\n");
    printf("문자  알파벳 숫자  공백  대문자 소문자 구두점\n");
    printf("------------------------------------------------\n");

    for (int i = 0; str[i] != '\0'; i++) {
        unsigned char c = (unsigned char)str[i];   // ctype 함수에는 unsigned char 값을 넘긴다

        if (c == ' ') {
            printf("' '");
        } else {
            printf("'%c'", c);
        }

        printf("     %d      %d     %d      %d      %d      %d\n",
               isalpha(c) ? 1 : 0,
               isdigit(c) ? 1 : 0,
               isspace(c) ? 1 : 0,
               isupper(c) ? 1 : 0,
               islower(c) ? 1 : 0,
               ispunct(c) ? 1 : 0);
    }

    // 대문자로 변환
    printf("\n=== 대문자로 변환 ===\n");
    printf("원본: %s\n", str);
    printf("대문자: ");
    for (int i = 0; str[i] != '\0'; i++) {
        putchar(toupper((unsigned char)str[i]));
    }
    printf("\n");

    // 소문자로 변환
    printf("\n=== 소문자로 변환 ===\n");
    printf("소문자: ");
    for (int i = 0; str[i] != '\0'; i++) {
        putchar(tolower((unsigned char)str[i]));
    }
    printf("\n");

    // 알파벳만 추출
    printf("\n=== 알파벳만 추출 ===\n");
    printf("알파벳: ");
    for (int i = 0; str[i] != '\0'; i++) {
        if (isalpha((unsigned char)str[i])) {
            putchar(str[i]);
        }
    }
    printf("\n");

    // 숫자만 추출
    printf("\n=== 숫자만 추출 ===\n");
    printf("숫자: ");
    for (int i = 0; str[i] != '\0'; i++) {
        if (isdigit((unsigned char)str[i])) {
            putchar(str[i]);
        }
    }
    printf("\n");

    // 알파벳/숫자만 추출
    printf("\n=== 알파벳+숫자만 추출 ===\n");
    printf("알파벳/숫자: ");
    for (int i = 0; str[i] != '\0'; i++) {
        if (isalnum((unsigned char)str[i])) {
            putchar(str[i]);
        }
    }
    printf("\n");

    // 통계
    printf("\n=== 문자 통계 ===\n");
    int alpha_count = 0, digit_count = 0, space_count = 0, other_count = 0;
    for (int i = 0; str[i] != '\0'; i++) {
        if (isalpha((unsigned char)str[i])) alpha_count++;
        else if (isdigit((unsigned char)str[i])) digit_count++;
        else if (isspace((unsigned char)str[i])) space_count++;
        else other_count++;
    }
    printf("알파벳: %d개\n", alpha_count);
    printf("숫자: %d개\n", digit_count);
    printf("공백: %d개\n", space_count);
    printf("기타: %d개\n", other_count);

    return 0;
}
$ gcc -Wall -Wextra -std=c11 examples/ctype_example.c -o ctype_example && ./ctype_example
문자열: "Hello, World! 123 ABC abc"

=== 문자 분석 ===
문자  알파벳 숫자  공백  대문자 소문자 구두점
------------------------------------------------
'H'     1      0     0      1      0      0
'e'     1      0     0      0      1      0
'l'     1      0     0      0      1      0
'l'     1      0     0      0      1      0
'o'     1      0     0      0      1      0
','     0      0     0      0      0      1
' '     0      0     1      0      0      0
'W'     1      0     0      1      0      0
...
'1'     0      1     0      0      0      0
...

=== 대문자로 변환 ===
원본: Hello, World! 123 ABC abc
대문자: HELLO, WORLD! 123 ABC ABC

=== 소문자로 변환 ===
소문자: hello, world! 123 abc abc

=== 알파벳만 추출 ===
알파벳: HelloWorldABCabc

=== 숫자만 추출 ===
숫자: 123

=== 알파벳+숫자만 추출 ===
알파벳/숫자: HelloWorld123ABCabc

=== 문자 통계 ===
알파벳: 16개
숫자: 3개
공백: 4개
기타: 2개
isalpha(c) ? 1 : 0: 3주차 7절의 삼항 연산자입니다. 규칙 1 때문에 isalpha 가 1024 같은 값을 돌려주니, 표를 가지런히 찍으려고 “참이면 1, 거짓이면 0″으로 바꿨습니다.
toupper 는 원본을 바꾸지 않습니다. 바꾼 값을 돌려줄 뿐입니다. 그래서 putchar(toupper(...)) 로 바로 출력했고, str 은 그대로입니다. 문자열 자체를 대문자로 바꾸고 싶다면 str[i] = toupper((unsigned char)str[i]); 처럼 결과를 다시 넣어야 합니다. toupper 는 알파벳이 아닌 글자(,, 1, 공백)를 넣으면 그대로 돌려주니 따로 확인할 필요가 없습니다.
통계의 else if: 한 글자가 한 분류에만 들어가도록 else if 로 이었습니다. 쉼표와 느낌표 2개가 “기타”입니다.
직접 해 보기:
str에 한글을 넣어 보세요(예:"Hello 세상"). 한글 바이트는isalpha도isdigit도 아니라서 모두 “기타”로 세어지고, 한 글자가 3바이트이니 한글 두 글자가 “기타 6개”로 나옵니다.ctype.h함수들은 기본 설정(C 로케일)에서 영어 ASCII 글자만 판단합니다. 한글 같은 다국어 글자를 제대로 다루는 방법은 16주차 문자열 알고리즘에서 봅니다.
15. 문자열 배열
이름 목록, 과목 목록, 메뉴 항목처럼 문자열 여러 개를 다뤄야 할 때가 많습니다. 문자열이 char 배열이니, 문자열 여러 개는 char 배열의 배열, 즉 8절의 2차원 char 배열입니다.
char names[5][20] = {"Charlie", "Eve", "Alice", "David", "Bob"};
[5] 는 문자열 개수, [20] 은 문자열 하나가 쓸 수 있는 칸 수('\0' 포함)입니다. 메모리 모양은 이렇습니다.
          [0] [1] [2] [3] [4] [5] [6] [7] [8] ... [19]
names[0]   C   h   a   r   l   i   e   \0  \0 ...  \0     ← 20칸
names[1]   E   v   e   \0  \0  \0  \0  \0  \0 ...  \0     ← 20칸
names[2]   A   l   i   c   e   \0  \0  \0  \0 ...  \0
names[3]   D   a   v   i   d   \0  \0  \0  \0 ...  \0
names[4]   B   o   b   \0  \0  \0  \0  \0  \0 ...  \0
names[0] 은 8절의 m[0] 처럼 한 줄 전체, 즉 20칸짜리 char 배열이고, 그 자체가 문자열입니다. 그래서 printf("%s", names[0]), strlen(names[1]), strcmp(names[2], ...) 처럼 문자열 함수에 그대로 넘길 수 있습니다. names[0][2] 는 첫 이름의 세 번째 글자 'a' 입니다.
모든 줄이 똑같이 20칸을 차지하므로 "Eve" 처럼 짧은 이름은 칸이 많이 남습니다. 대신 이름을 마음대로 고치고 바꿀 수 있습니다.
examples/string_array.c:
/*
 * string_array.c - 문자열 배열 예제
 * 4주차: 배열과 문자열
 */

#include <stdio.h>
#include <string.h>

int main(void) {
    // 문자열 배열 (2차원 문자 배열)
    char names[5][20] = {
        "Charlie",
        "Eve",
        "Alice",
        "David",
        "Bob"
    };

    printf("=== 이름 목록 ===\n");
    for (int i = 0; i < 5; i++) {
        printf("%d. %s (길이: %zu)\n", i + 1, names[i], strlen(names[i]));
    }

    // 이름 검색
    printf("\n=== 이름 검색 ===\n");
    char target[] = "Charlie";
    int found = -1;

    for (int i = 0; i < 5; i++) {
        if (strcmp(names[i], target) == 0) {
            found = i;
            break;
        }
    }

    if (found >= 0) {
        printf("\"%s\"를 인덱스 %d에서 찾았습니다.\n", target, found);
    } else {
        printf("\"%s\"를 찾지 못했습니다.\n", target);
    }

    // 이름 정렬 (버블 정렬)
    printf("\n=== 이름순 정렬 ===\n");
    printf("정렬 전: ");
    for (int i = 0; i < 5; i++) {
        printf("%s ", names[i]);
    }
    printf("\n");

    for (int i = 0; i < 4; i++) {
        for (int j = 0; j < 4 - i; j++) {
            if (strcmp(names[j], names[j + 1]) > 0) {
                char temp[20];
                strcpy(temp, names[j]);
                strcpy(names[j], names[j + 1]);
                strcpy(names[j + 1], temp);
            }
        }
    }

    printf("정렬 후: ");
    for (int i = 0; i < 5; i++) {
        printf("%s ", names[i]);
    }
    printf("\n");

    // 문자열 포인터 배열 (읽기 전용)
    printf("\n=== 문자열 포인터 배열 ===\n");
    const char *fruits[] = {
        "Apple",
        "Banana",
        "Cherry",
        "Date",
        "Elderberry"
    };
    int fruit_count = sizeof(fruits) / sizeof(fruits[0]);

    for (int i = 0; i < fruit_count; i++) {
        printf("%d. %s\n", i + 1, fruits[i]);
    }

    // 가장 긴 문자열 찾기
    printf("\n=== 가장 긴 이름 ===\n");
    int max_len = 0;
    int max_idx = 0;
    for (int i = 0; i < 5; i++) {
        if ((int)strlen(names[i]) > max_len) {
            max_len = strlen(names[i]);
            max_idx = i;
        }
    }
    printf("가장 긴 이름: %s (%d글자)\n", names[max_idx], max_len);

    return 0;
}
$ gcc -Wall -Wextra -std=c11 examples/string_array.c -o string_array && ./string_array
=== 이름 목록 ===
1. Charlie (길이: 7)
2. Eve (길이: 3)
3. Alice (길이: 5)
4. David (길이: 5)
5. Bob (길이: 3)

=== 이름 검색 ===
"Charlie"를 인덱스 0에서 찾았습니다.

=== 이름순 정렬 ===
정렬 전: Charlie Eve Alice David Bob
정렬 후: Alice Bob Charlie David Eve

=== 문자열 포인터 배열 ===
1. Apple
2. Banana
3. Cherry
4. Date
5. Elderberry

=== 가장 긴 이름 ===
가장 긴 이름: Charlie (7글자)
이 예제에는 지금까지 배운 것이 전부 모여 있습니다.
- 검색: 5절의 검색 패턴인데, 비교를
==대신strcmp(...) == 0으로 했습니다(11절). - 정렬: 7절의 버블 정렬인데, “순서가 틀렸다”의 기준이
strcmp(...) > 0입니다. 7절에서 “부등호만 바꾸면 기준이 바뀐다”고 한 것이 여기서 쓰였습니다. - 맞바꾸기: 6절의
temp를 쓴 맞바꾸기인데, 문자열이라=대신strcpy를 세 번 씁니다. 3절에서 배열은=로 복사할 수 없다고 했으니까요.temp도 이름 하나를 담을 20칸 배열입니다. - 가장 긴 이름: 5절의 최댓값 패턴이고, 비교 대상이
strlen입니다.(int)strlen(...)으로 바꾼 것은strlen의 결과(size_t, 부호 없음)와int를 비교할 때-Wextra가 “부호가 다른 값 비교”를 경고하기 때문입니다.
이 예제에서 고친 것: 원래 예제는 이름을 처음부터
Alice,Bob,Charlie,David,Eve순서로 넣어 두었습니다. 이미 정렬된 목록이라 “정렬 전”과 “정렬 후”가 똑같이 나왔고, 정렬 코드가 제대로 동작하는지 알 수 없었습니다. 이번에 순서를 섞었습니다. 테스트 데이터가 이미 정답이면 테스트가 아무것도 확인하지 못한다는 교훈입니다.
두 가지 문자열 배열
예제 뒷부분의 fruits 는 모양이 다릅니다.
char names[5][20] = { ... };       // 2차원 char 배열: 글자를 **복사**해서 갖고 있음
const char *fruits[] = { ... };    // 주소의 배열: 리터럴의 **주소**만 갖고 있음
9절의 “배열 vs const char *” 차이가 그대로 적용됩니다.
char names[5][20] |
const char *fruits[] |
|
|---|---|---|
| 갖고 있는 것 | 글자들 자체 (5 × 20 = 100바이트) | 주소 5개 (5 × 8 = 40바이트) |
| 글자 수정 | 됨 | 안 됨 (읽기 전용 리터럴) |
| 길이 제한 | 한 문자열당 19글자 | 없음 (리터럴 길이 그대로) |
| 정렬할 때 | strcpy 세 번으로 글자를 옮김 |
주소만 맞바꾸면 됨 (11절 strcmp_example) |
고치지 않을 고정 목록(메뉴 항목, 과목 이름)은 const char * 배열이 편하고, 사용자가 입력한 이름처럼 바뀌는 문자열은 2차원 char 배열에 담습니다. 16절의 성적 관리 프로그램에서 과목 이름은 const char *subject_names[], 학생 이름은 char name[30] 인 것도 이 이유입니다.
16. 실습 프로젝트
projects/ 폴더에는 이번 주 내용을 종합한 프로그램 네 개가 있습니다. 모두 수백 줄짜리 메뉴형 프로그램이라 여기서 전체 코드를 싣지는 않고, 핵심 함수를 읽고, 입력을 넣어 실행해 보고, 고쳐 보는 순서로 봅니다. 전체 코드는 VS Code 로 파일을 열어 함께 보세요.
네 프로그램 모두 입력을 파이프로 넣어서 실행할 수 있습니다. 메뉴 번호와 입력을 순서대로 printf 로 만들어 넘기면, 사람이 키보드로 치는 것과 똑같이 동작합니다. 입력이 끝나면 각 파일 위쪽에 있는 exit_if_eof() 함수가 프로그램을 정상 종료시킵니다. 입력이 끝난 뒤 scanf 는 계속 실패를 돌려주는데, 이것을 “잘못된 입력”으로만 처리하면 메뉴를 다시 찍고 또 읽으려 하면서 영원히 돕니다. feof(stdin) 으로 “입력이 끝났는가”를 따로 확인하는 것이 이 함수입니다. 함수 위의 주석에 실제 사고 이야기가 적혀 있으니 꼭 읽어 보세요. 입력 없이 돌린 메뉴 프로그램이 초당 0.7GB를 쏟아낸 이야기입니다.
프로젝트 1: 문자열 뒤집기 (string_reverse.c)
문자열을 세 가지 방법으로 뒤집고, 회문(앞으로 읽으나 뒤로 읽으나 같은 말)인지 검사하고, 단어 순서를 뒤집습니다.
방법 1: 새 배열에 거꾸로 복사
void reverse_copy(const char *src, char *dest) {
    int len = strlen(src);
    for (int i = 0; i < len; i++) {
        dest[i] = src[len - 1 - i];
    }
    dest[len] = '\0';
}
dest 의 i 번 칸에 src 의 뒤에서 i 번째 글자를 넣습니다. 마지막에 '\0' 을 붙이는 것, 이제 자연스럽게 보이죠? 원본 src 는 const 라서 그대로 남습니다.
방법 2: 제자리 뒤집기는 6절의 reverse_array 와 똑같습니다. 양 끝을 맞바꾸며 len / 2 까지 들어옵니다. 방법 3은 같은 일을 인덱스 대신 주소 두 개(start, end)를 옮기며 합니다. 13절 my_strchr 에서 본 스타일입니다.
이 프로젝트에서 고친 것: 방법 3은
end = str + strlen(str) - 1로 마지막 글자의 주소를 구합니다. 그런데 빈 문자열이 들어오면strlen이 0이라서end가 배열 시작보다 한 칸 앞을 가리키게 됩니다. 4절에서 본arr[-1]과 같은 범위 밖 주소입니다. 반복문 조건(start < end)이 거짓이라 실제로 읽지는 않지만, C 표준은 배열 밖을 가리키는 주소를 계산하는 것만으로도 정의되지 않은 동작으로 봅니다. 그래서 함수 맨 앞에 빈 문자열이면 바로 돌아가는 검사를 넣었습니다.
단어 순서 뒤집기는 재미있는 요령을 씁니다.
원본:                 I love C programming
① 전체를 뒤집는다:     gnimmargorp C evol I
② 단어마다 다시 뒤집는다: programming C love I
전체를 뒤집으면 단어 순서는 원하는 대로 바뀌지만 각 단어도 뒤집힙니다. 그래서 공백으로 구분된 단어마다 한 번 더 뒤집어 제자리로 돌립니다. 추가 배열 없이 제자리에서 해결하는 영리한 방법입니다.
실행해 봅시다. 메뉴 번호, 입력 문자열을 한 줄씩 넣습니다.
$ gcc -Wall -Wextra -std=c11 projects/string_reverse.c -o string_reverse
$ printf '1\nHello World\n4\nlevel\n4\nnever odd or even\n5\nI love C programming\n0\n' | ./string_reverse
...
[방법 1: 새 배열에 복사]
원본: "Hello World"
결과: "dlroW olleH"
원본 유지: "Hello World"
...
[회문 검사]
문자열: "level"
결과: 회문입니다! ✓
(공백 무시 시: 회문)
...
[회문 검사]
문자열: "never odd or even"
결과: 회문이 아닙니다.
(공백 무시 시: 회문)
...
[단어 순서 뒤집기]
원본: "I love C programming"
결과: "programming C love I"
never odd or even 은 글자 그대로는 회문이 아니지만(공백 위치가 대칭이 아닙니다), 공백을 빼고 neveroddoreven 으로 보면 회문입니다. is_palindrome_ignore_space 가 양 끝에서 공백을 건너뛰며 비교하기 때문입니다.
실험: 한글을 뒤집으면?
$ printf '2\n안녕\n0\n' | ./string_reverse
...
[방법 2: 제자리 뒤집기]
원본: "안녕"
결과: "��눕�"
글자가 깨집니다. 뒤집기 함수는 바이트를 뒤집습니다. 안녕 은 6바이트이고, 뒤집으면 각 글자의 3바이트 순서까지 뒤집혀서 더 이상 올바른 UTF-8 글자가 아니게 됩니다.
원본 바이트:  [ec 95 88] [eb 85 95]       = 안 녕
뒤집은 바이트: [95 85 eb] [88 95 ec]       = 올바르지 않은 UTF-8
11절(strlen 은 바이트 수), 12절(snprintf 가 한글 중간에서 잘림)에 이어 세 번째로 만나는 같은 문제입니다. C의 문자열 함수는 “글자”가 아니라 “바이트”를 다룬다. 한글을 글자 단위로 제대로 다루려면 UTF-8 규칙에 따라 몇 바이트씩 묶어야 하고, 이것은 16주차 문자열 알고리즘에서 다룹니다.
프로젝트 2: 단어 개수 세기 (word_count.c)
여러 줄의 글을 입력받아 글자·단어·줄 수와 알파벳 빈도를 셉니다. 빈 줄을 입력하면 입력을 끝냅니다.
통계를 담는 부분에 처음 보는 문법이 있습니다.
typedef struct {
    int total_chars;      // 전체 문자 수
    int alpha_chars;      // 알파벳 수
    ...
    int word_count;       // 단어 수
    int line_count;       // 줄 수
    int char_freq[26];    // 알파벳 빈도 (a-z)
} TextStats;
struct 는 여러 종류의 값을 한 덩어리로 묶는 문법으로, 8주차의 주제입니다. 1절에서 “배열은 같은 타입만”이라고 했는데, 타입이 다른 값을 묶고 싶을 때 씁니다. 지금은 “TextStats 라는 이름의 상자에 정수 여러 개와 26칸짜리 배열이 들어 있다” 정도로 읽으면 충분합니다. stats->word_count 처럼 -> 로 안의 값을 꺼냅니다.
알파벳 빈도를 세는 요령을 보세요.
stats->char_freq[tolower(c) - 'a']++;
char_freq 는 26칸 배열이고, 0번 칸이 a, 25번 칸이 z 의 개수입니다. 글자를 소문자로 바꾼 뒤 'a' 를 빼면 a → 0, b → 1, …, z → 25 가 됩니다. 9절에서 본 “'7' - '0' = 7″ 과 같은 요령입니다. 글자를 배열 인덱스로 바꾸는 이 방법은 개수 세기 문제에서 아주 자주 씁니다.
단어 경계 판단은 3주차의 깃발 패턴입니다.
if (isalpha(c)) {
    ...
    if (!in_word) {          // 단어 밖에 있다가 글자를 만났다 → 새 단어 시작
        stats->word_count++;
        in_word = 1;
    }
} else if (isspace(c)) {
    in_word = 0;             // 공백을 만났다 → 단어 밖으로
}
“단어 밖 → 단어 안”으로 바뀌는 순간에만 하나를 셉니다. 그래서 공백이 여러 개 이어져 있어도 단어 수가 틀어지지 않습니다.
영어 두 줄과 빈 줄, 그리고 검색할 단어 하나를 넣어 word_count 를 실행해 봅시다.
$ gcc -Wall -Wextra -std=c11 projects/word_count.c -o word_count
$ printf 'the cat and the hat\nC is fun, C is fast!\n\nthe\n' | ./word_count
...
=== 기본 통계 ===
총 문자 수: 39
알파벳:     28
숫자:       0
공백:       9
구두점:     2
단어 수:    11
줄 수:      2

=== 알파벳 빈도 ===
a: 4 [████]
c: 3 [███]
...
t: 5 [█████]
u: 1 [█]

=== 최빈 문자 ===
가장 많이 나온 문자: 't' (5회)

=== 줄별 분석 ===
줄 1: 5단어, 19문자
줄 2: 6단어, 20문자

가장 긴 단어: "fast" (4글자)

=== 단어 검색 ===
검색할 단어를 입력하세요 (건너뛰려면 엔터): "the"가 2번 나타났습니다.

단어 세기
입력의 세 번째 줄이 빈 줄이라 입력이 끝났고, 네 번째 줄 the 는 “검색할 단어”로 쓰였습니다.
단어 검색이 정확한 이유: count_word_occurrences 는 11절의 strstr 로 the 를 찾되, 찾은 위치의 앞뒤 글자가 알파벳이나 숫자가 아닌지 확인합니다. 그냥 strstr 로만 세면 theory 나 bathe 안의 the 까지 세어 버리기 때문입니다. 이렇게 “단어의 경계”를 확인하는 것이 검색 기능의 핵심입니다.
실험: 한글을 넣으면?
$ printf '안녕 hello\n\n\n' | ./word_count
...
=== 기본 통계 ===
총 문자 수: 12
알파벳:     5
숫자:       0
공백:       1
구두점:     0
단어 수:    1
안녕 hello 는 사람 눈에는 단어 2개, 글자 8개입니다. 그런데 프로그램은 단어 1개, 문자 12개라고 합니다. 문자 수는 바이트 수(한글 2자 × 3 + 공백 1 + 영어 5 = 12)이고, 단어 수는 isalpha 가 한글을 알파벳으로 보지 않아서(14절) 안녕 을 단어로 세지 않았습니다. 이 프로그램은 영어 글을 위한 프로그램이라는 한계가 드러납니다. 연습 문제에서 한글 단어도 세도록 고쳐 봅니다.
이 프로젝트에서 고친 것:
isalpha(c)처럼char를 그대로 넘기던 ctype 호출을 14절 규칙 2에 맞게unsigned char로 바꿨습니다. 한글 바이트가 음수로 넘어가던 부분입니다.
프로젝트 3: 시저 암호 (caesar_cipher.c)
2천 년 전 율리우스 카이사르가 편지를 숨길 때 썼다는 암호입니다. 모든 알파벳을 정해진 칸 수(shift)만큼 밀어서 씁니다. shift가 3이면 A→D, B→E, …, X→A, Y→B, Z→C 입니다.
핵심은 한 글자를 바꾸는 식입니다.
if (isupper(c)) {
    ciphertext[i] = 'A' + (c - 'A' + shift) % 26;
} else if (islower(c)) {
    ciphertext[i] = 'a' + (c - 'a' + shift) % 26;
} else {
    ciphertext[i] = c;       // 알파벳이 아니면 그대로
}
'Y' 를 shift 3 으로 바꾸는 과정을 따라가 봅시다.
| 단계 | 식 | 값 |
|---|---|---|
| ① 알파벳 번호로 | 'Y' - 'A' |
24 |
| ② 밀기 | 24 + 3 | 27 |
| ③ 26을 넘으면 처음으로 | 27 % 26 | 1 |
| ④ 다시 글자로 | 'A' + 1 |
'B' |
③의 % 26 이 핵심입니다. 3주차 1절의 나머지 연산이 알파벳을 원형으로 한 바퀴 돌게 만듭니다. 시계에서 11시 + 3시간 = 2시가 되는 것과 같은 원리입니다.
함수 맨 앞의 shift = ((shift % 26) + 26) % 26; 은 shift 가 음수이거나 26보다 커도 0~25로 맞추는 식입니다. -3 을 넣으면 ((-3 % 26) + 26) % 26 = (-3 + 26) % 26 = 23 이 됩니다. 앞으로 23칸 미는 것은 뒤로 3칸 미는 것과 같죠. 복호화는 그래서 26 - shift 만큼 암호화하는 것과 같습니다.
caesar_cipher 로 암호화하고, 그 결과를 다시 복호화해 봅시다.
$ gcc -Wall -Wextra -std=c11 projects/caesar_cipher.c -o caesar_cipher
$ printf '1\nHello, World!\n3\n2\nKhoor, Zruog!\n3\n0\n' | ./caesar_cipher
...
[암호화 결과]
평문: Hello, World!
암호문: Khoor, Zruog!
shift: 3
...
[복호화 결과]
암호문: Khoor, Zruog!
평문: Hello, World!
카이사르 암호
쉼표, 공백, 느낌표는 그대로 남았습니다. 대문자는 대문자로, 소문자는 소문자로 바뀌었습니다.
암호를 깨는 세 가지 방법
이 프로그램의 진짜 재미는 암호를 푸는 쪽에 있습니다. shift 를 모르는 암호문을 받았다고 합시다.
1. 브루트 포스(무차별 대입): shift 가 0~25 중 하나이니, 26가지를 전부 해 보면 됩니다. 메뉴 4번이 그 결과를 전부 출력하고, 사람이 읽을 수 있는 줄을 찾으면 됩니다. 경우의 수가 26가지뿐이라서 시저 암호는 아주 약한 암호입니다.
2. 빈도 분석: 영어 글에서는 e 가 가장 많이 나옵니다. 그러니 암호문에서 가장 많이 나온 글자가 원래 e 였을 가능성이 높습니다. 프로젝트 2의 알파벳 빈도 세기와 같은 방법(freq[tolower(c) - 'a']++)으로 셉니다.
$ printf '5\nAol zljyla tllapun pz ha aol vsk ayll ulhy aol ypcly\n0\n' | ./caesar_cipher
...
=== 빈도 분석 ===
가장 빈번한 문자: 'l' (11회)
영어에서 가장 흔한 문자는 'e'입니다.
추정 shift 값: 7
추정 해독 결과: The secret meeting is at the old tree near the river
암호문에서 l 이 11번으로 가장 많았고, l 과 e 의 거리가 7이니 shift 7 로 추정해서 정확히 풀었습니다. 하지만 글이 짧으면 틀립니다.
$ printf '5\nKhoor Zruog\n0\n' | ./caesar_cipher
...
가장 빈번한 문자: 'o' (3회)
추정 shift 값: 10
추정 해독 결과: Axeeh Phkew
Hello World 에는 e 가 하나뿐이고 l 과 o 가 더 많습니다. 통계는 표본이 커야 맞는다는 것을 보여 줍니다.
3. 자동 해독: 26가지를 모두 해 보면서, 결과에 the, and, for 같은 흔한 영어 단어가 들어 있으면 그것을 답으로 고릅니다. 11절의 strstr 로 확인합니다.
$ printf '6\nWkh txlfn eurzq ira\n0\n' | ./caesar_cipher
...
=== 자동 해독 시도 ===
shift 3에서 영어 단어 발견!
해독 결과: The quick brown fox
암호를 만드는 코드는 몇 줄인데, 깨는 방법은 여러 가지이고 각각 한계가 있다는 점이 흥미롭습니다. 24주차 보안 프로그래밍에서 진짜 암호가 왜 이런 공격에 강한지 다시 봅니다.
프로젝트 4: 학생 성적 관리 시스템 (grade_manager.c)
이번 주의 종합 프로젝트입니다. 학생을 추가하고, 조회하고, 검색하고, 통계를 내고, 정렬하고, 삭제하고, 점수를 고칩니다. 처음 써 본다면 메뉴 10번(샘플 데이터 5명 추가)부터 누르세요.
학생 한 명의 정보는 프로젝트 2처럼 struct 로 묶었습니다.
typedef struct {
    char name[MAX_NAME_LEN];          // 이름: 문자열 (15절의 "바뀌는 문자열")
    int scores[NUM_SUBJECTS];         // 과목 점수 3개: int 배열
    double average;
    char grade;                       // 학점: 'A' ~ 'F' 글자 하나
} Student;

Student students[MAX_STUDENTS];       // 학생 50명을 담는 배열
이번 주에 배운 것이 전부 들어 있습니다. 문자열(name), 정수 배열(scores), 그리고 그것들을 묶은 덩어리의 배열(students). 과목 이름은 바뀌지 않으니 15절의 const char *subject_names[] = {"국어", "영어", "수학"}; 로 둡니다.
정렬(sort_by_average, sort_by_name)은 7절의 버블 정렬입니다. 기준이 평균 점수이거나 strcmp(15절)일 뿐입니다. 한 가지 편한 점은, struct 는 배열과 달리 = 로 통째로 복사할 수 있다는 것입니다. 그래서 학생을 맞바꿀 때 이름, 점수를 따로 복사하지 않고 Student temp = students[j]; 로 한 번에 옮깁니다(8주차에서 자세히).
삭제는 배열의 한가운데를 지우는 방법을 보여 줍니다.
for (int i = num - 1; i < student_count - 1; i++) {
    students[i] = students[i + 1];
}
student_count--;
배열에는 “칸을 없애는” 기능이 없습니다. 그래서 지울 칸 뒤의 모든 칸을 한 칸씩 앞으로 당기고, 학생 수를 하나 줄입니다. 맨 뒤 칸에는 옛 데이터가 남아 있지만, student_count 가 줄었으니 더 이상 읽지 않습니다. 학생이 1만 명이면 맨 앞 학생을 지울 때 9,999번을 옮겨야 합니다. 이런 비효율을 해결하는 자료구조가 10주차의 연결 리스트입니다.
표가 어긋나는 문제와 해결
이 프로젝트의 print_all_students 는 원래 이름 칸을 printf("%8s", name) 으로 출력했습니다. 2주차 6절에서 배운 “8칸 폭으로 오른쪽 정렬”이죠. 그런데 샘플 데이터로 실행하면 표가 이렇게 나왔습니다.
║ 번호 │   이름   │ 국어 │ 영어 │ 수학 │  평균  │ 학점 ║
╠══════════════════════════════════════════════════════════════╣
║    1 │ 김철수 │   85 │   90 │   78 │  84.33 │  B   ║
║    2 │ 이영희 │   92 │   88 │   95 │  91.67 │  A   ║
이름 칸이 머리글보다 좁아서 오른쪽 칸들이 전부 왼쪽으로 밀렸습니다. 게다가 머리글 줄과 테두리 줄의 폭도 서로 달랐습니다. 왜 이름 칸이 좁아졌을까요?
%8s 의 8은 바이트 수이기 때문입니다. 김철수 는 9바이트라 8보다 길어서 공백을 하나도 채우지 않았습니다. 그런데 화면에서는 한글 한 글자가 2칸(1주차 8절)이라 6칸만 차지합니다. 8칸을 기대했는데 6칸이니 2칸이 어긋난 것입니다. 바이트 수, 글자 수, 화면 칸 수가 모두 다르다는 것을 보여 주는 좋은 예입니다.
| 이름 | 바이트 (strlen) |
글자 수 | 화면 칸 수 |
|---|---|---|---|
Alexander |
9 | 9 | 9 |
김철수 |
9 | 3 | 6 |
그래서 화면 칸 수를 세는 함수를 만들어 넣었습니다.
int display_width(const char *str) {
    int width = 0;
    for (int i = 0; str[i] != '\0'; i++) {
        unsigned char b = (unsigned char)str[i];
        if ((b & 0xC0) == 0x80) {
            continue;               // 글자의 둘째·셋째 바이트
        }
        width += (b >= 0xE0) ? 2 : 1;
    }
    return width;
}

void print_padded(const char *str, int width) {
    printf("%s", str);
    for (int i = display_width(str); i < width; i++) {
        putchar(' ');
    }
}
UTF-8의 규칙을 이용합니다. 여러 바이트로 된 글자에서 둘째 이후의 바이트는 항상 10xxxxxx 모양입니다. b & 0xC0 은 3주차 6절의 비트 AND로 앞 두 비트만 남기는 연산이고, 그 결과가 0x80(10000000)이면 “글자의 뒷부분 바이트”이니 세지 않습니다. 글자의 첫 바이트가 0xE0 이상이면 3바이트 이상짜리 글자(한글, 한자)라서 2칸으로 칩니다. 이 강좌에서 다루는 글자에는 이 정도 규칙으로 충분합니다.
print_padded 는 이름을 찍은 뒤 화면 칸 수가 원하는 폭이 될 때까지 공백을 채웁니다. 고친 뒤의 결과입니다.
$ gcc -Wall -Wextra -std=c11 projects/grade_manager.c -o grade_manager
$ printf '10\n1\nAlexander\n100\n95\n90\n2\n0\n' | ./grade_manager
...
╔══════════════════════════════════════════════════════╗
║                    전체 학생 성적표                  ║
╠══════╤════════════╤══════╤══════╤══════╤════════╤════╣
║ 번호 │ 이름       │ 국어 │ 영어 │ 수학 │  평균  │학점║
╠══════╪════════════╪══════╪══════╪══════╪════════╪════╣
║    1 │ 김철수     │   85 │   90 │   78 │  84.33 │ B  ║
║    2 │ 이영희     │   92 │   88 │   95 │  91.67 │ A  ║
║    3 │ 박지민     │   76 │   82 │   79 │  79.00 │ C  ║
║    4 │ 최수진     │   88 │   85 │   91 │  88.00 │ B  ║
║    5 │ 정민호     │   65 │   70 │   68 │  67.67 │ D  ║
║    6 │ Alexander  │  100 │   95 │   90 │  95.00 │ A  ║
╚══════╧════════════╧══════╧══════╧══════╧════════╧════╝
총 6명의 학생
한글 이름과 영어 이름이 섞여도 모든 줄이 56칸으로 맞습니다. 입력을 보면 메뉴 10(샘플 추가) → 1(학생 추가: 이름, 국어, 영어, 수학) → 2(전체 조회) → 0(종료) 순서입니다.
이 프로젝트들에서 함께 고친 것: 네 프로젝트의 제목 상자(
╔═══╗모양) 대부분이 가운데 줄만 한 칸씩 길어서 오른쪽 테두리가 삐져나와 있었습니다. 1주차 8절의 계산기 상자와 같은 문제로, 한글 칸 수를 세어 공백을 하나씩 뺐습니다.
17. 연습 문제
기본 문제
- 배열 역순 저장: 정수 배열을 받아 역순으로 새 배열에 저장하는 함수
void reverse_to(const int src[], int dst[], int size)를 만드세요. 6절의reverse_array와 무엇이 다른지 설명해 보세요. - 배열 회전: 배열을 왼쪽으로 한 칸 회전하세요.
{1, 2, 3, 4, 5}→{2, 3, 4, 5, 1}. 힌트: 첫 칸을temp에 대피시킨 뒤 나머지를 한 칸씩 당깁니다(16절의 삭제와 비슷합니다). 그다음 n칸 회전으로 늘려 보세요. - 두 번째로 큰 값: 배열에서 두 번째로 큰 값을 반복문 한 번으로 찾으세요. 가장 큰 값이 여러 개일 때는 어떻게 할지 정하고 설명하세요.
- 문자열 압축:
"aaabbc"→"a3b2c1". 결과를 담을 배열 크기는 원본의 몇 배면 충분할까요? - 아나그램 판별: 두 영어 단어가 같은 글자들로 이루어졌는지(예:
listen과silent) 판별하세요. 힌트: 16절 프로젝트 2의freq[c - 'a']++요령을 두 단어에 쓰고 비교합니다. - 대소문자 무시 비교:
strcmp처럼 동작하되 대소문자를 구분하지 않는my_strcasecmp를 13절의my_strcmp를 고쳐서 만드세요.
심화 문제
- 행렬 전치 (정사각형이 아닌): 8절의
matrix_transpose를 2×3 행렬에 쓸 수 있도록 고치세요. 결과 배열의 크기는 어떻게 선언해야 할까요? - 문자열 토큰화:
"apple,banana,,cherry"를 쉼표로 나눠apple,banana, (빈 문자열),cherry를 한 줄씩 출력하세요. 빈 칸을 어떻게 처리할지도 정하세요. - 범위 밖 탐정: 4절의
oob.c에서before,arr,after의 주소를%p로 찍어,arr[-1]이 왜after였는지 주소로 설명해 보세요.-O2로 컴파일하면 달라지나요? - 한글 단어 세기: 16절 프로젝트 2의
analyze_line을 고쳐서 한글 단어도 단어로 세게 하세요. 힌트:display_width처럼 첫 바이트가0x80이상이면 “글자”로 취급합니다. - 틱택토: 3×3
char배열로 두 사람이 번갈아 두는 틱택토 게임을 만드세요. 승리 판정은 가로 3줄, 세로 3줄, 대각선 2줄을 확인하는 함수로 만드세요.
18. 마무리
이번 주에 배운 것
배열
- 배열은 같은 타입의 칸이 메모리에 빈틈없이 붙어 있는 것입니다. 주소를 찍어 4바이트씩 늘어나는 것을 확인했습니다.
- 인덱스는 첫 칸에서 떨어진 거리라서 0부터 시작합니다.
arr[i]는 “시작 주소 + i × 칸 크기”입니다. - 초기화 목록을 하나라도 쓰면 나머지는 0입니다. 초기화하지 않은 배열에는 누군가 남긴 흔적이 들어 있습니다.
- C는 경계를 검사하지 않습니다. 칸 밖을 읽으면 옆 변수가 읽히고, 칸 밖에 쓰면 조용히 넘어가거나 스택이 부서집니다.
-fsanitize=address가 잡아 줍니다. - 배열 이름은 대부분 첫 칸의 주소로 바뀝니다. 그래서
=로 복사할 수 없고, 함수에는 주소가 넘어가서 크기를 따로 넘겨야 하며, 함수가 원본을 고칠 수 있습니다. - 2차원 배열은 배열의 배열이고, 메모리에서는 행 순서대로 한 줄입니다.
문자열
- C 문자열은
char배열 + 끝의'\0'입니다. 크기 N인 배열에 N-1글자까지 담을 수 있습니다. '\0'이 없으면 함수들은 옆 메모리까지 읽습니다(HelloWORLD,Hello, WAFTER).- 문자열 리터럴은 읽기 전용입니다. 고칠 문자열은 배열로, 고정 문자열은
const char *로. - 비교는
==가 아니라strcmp로. 결과는 부호만 믿습니다. - 크기를 받지 않는 함수(
strcpy,strcat,%s,gets)는 위험합니다. 폭 지정scanf,fgets,strncat,snprintf처럼 크기를 받는 함수를 씁니다. - 입력 함수의 반환값을 확인합니다.
- C 문자열 함수는 바이트를 다룹니다. 한글은 글자 수, 바이트 수, 화면 칸 수가 모두 다릅니다.
다음 주 예고
이번 주에 함수를 “미리보기”로 여러 번 썼습니다. print_array, sum_array, bubble_sort… 5주차에서는 함수를 제대로 배웁니다.
- 함수에 값을 넘기면 정확히 무슨 일이 일어날까? 배열은 원본이 바뀌었는데
int는 왜 안 바뀔까? - 함수 안에서 만든 변수는 함수가 끝나면 어디로 갈까? (3절
garbage.c의 비밀) - 함수가 자기 자신을 부르면? (재귀)
- 프로그램을 여러
.c파일로 나누고, 이번 주에make로 빌드한 그Makefile을 직접 만들어 봅니다.
그리고 이번 주에 계속 “6주차에서”라고 미뤄 둔 주소와 포인터가 그다음 주에 기다리고 있습니다. 이번 주에 본 arr[i] = *(arr + i), 2[arr], 함수 안의 sizeof 가 8이던 것, strchr 이 돌려준 주소에서 인덱스를 계산한 것… 전부 포인터 하나로 설명됩니다.
19. 체크리스트
각 항목을 설명할 수 있으면 체크하세요.
- [ ] 배열을 선언하고, 초기화 목록의 세 가지 규칙(나머지는 0,
{0}, 크기 생략)을 설명할 수 있다 - [ ] 배열 요소의 주소가 칸 크기만큼 늘어나는 것을
%p로 직접 확인했다 - [ ] 인덱스가 0부터 시작하는 이유를 “거리”로 설명할 수 있다
- [ ]
sizeof(arr) / sizeof(arr[0])로 크기를 구할 수 있고, 함수 안에서는 왜 안 되는지 안다 - [ ] 범위 밖 읽기와 쓰기를 직접 해 보고, 결과가 예측 불가능하다는 것을 확인했다
- [ ]
-fsanitize=address로 범위 밖 접근을 잡을 수 있다 - [ ] 배열을 함수에 넘기면 원본이 바뀌는 이유를 안다
- [ ] 순회, 누적, 최댓값, 검색, 걸러내기 패턴을 쓸 수 있다
- [ ] 버블 정렬을 손으로 한 패스 따라가고, 코드로 쓸 수 있다
- [ ] 2차원 배열이 메모리에 어떻게 들어 있는지 그림으로 그릴 수 있다
- [ ] 문자열이
char배열 +'\0'이라는 것과,'\0'이 없을 때 생기는 일을 안다 - [ ] 문자열 배열과
const char *의 차이를 안다 - [ ]
scanf에 폭을 쓰는 이유와fgets의 두 가지 성질을 안다 - [ ]
strlen,strcpy,strcat,strcmp,strchr,strstr를 쓸 수 있고, 어느 것이 크기를 모르는지 안다 - [ ] 문자열 비교에
==를 쓰면 안 되는 이유를 안다 - [ ]
strncpy뒤에'\0'을 넣어야 하는 이유와snprintf의 장점을 안다 - [ ]
strlen,strcmp를 직접 구현할 수 있다 - [ ] ctype 함수에
(unsigned char)를 붙이는 이유를 안다 - [ ] 한글 문자열에서 바이트 수, 글자 수, 화면 칸 수가 다르다는 것을 안다
모두 체크했다면 5주차로 넘어갈 준비가 되었습니다!