학습 목표
이번 주차를 마치면 다음을 할 수 있습니다.
void *와 함수 포인터를 조합해 “타입에 얽매이지 않는” 제네릭 코드를 작성하고, 표준 함수qsort가 어떻게 모든 타입을 정렬하는지 설명할 수 있다- 구조체의 실제 크기가 멤버 크기의 합과 다른 이유(정렬과 패딩)를
offsetof로 직접 확인하고 설명할 수 있다 realloc이 무엇을 돌려주는지, 왜 결과를 임시 변수에 받아야 하는지 알고, 자동으로 크기가 늘어나는 동적 배열(Vector)을 구현할 수 있다- 단일, 이중, 원형 연결 리스트의 삽입과 삭제를 메모리 그림으로 그리며 구현할 수 있다
- 배열과 리스트의 성능 차이를 직접 측정하고, 그 원인을 CPU 캐시로 설명할 수 있다
- valgrind 보고서를 한 줄씩 읽고 누수, 범위 밖 접근, 해제 후 사용, 이중 해제를 구분할 수 있다
들어가며
드디어 Part 2: 자료구조와 알고리즘편의 시작입니다.
지난 9주 동안 우리는 C 언어의 문법을 배웠습니다. 변수, 제어문, 함수, 포인터, 구조체, 파일 입출력까지. 이제 여러분은 C로 “말할 수” 있습니다. Part 2에서는 그 언어로 “무언가를 만드는” 법을 배웁니다. 그 첫걸음이 자료구조입니다.
자료구조가 왜 중요할까요? 프로그램은 결국 데이터를 담고, 찾고, 바꾸는 일의 반복입니다. 데이터를 어떤 모양으로 담느냐에 따라 같은 작업이 1밀리초에 끝나기도 하고 수백 밀리초가 걸리기도 합니다. 이번 주 5절에서 직접 재 보면 같은 100만 개의 데이터로 같은 일을 하는데 수만 배 차이가 나는 것을 보게 됩니다.
이번 주를 시작하기 전에 몇 가지 질문을 던져 보겠습니다. 답을 짐작해 보고, 이 글을 읽으면서 맞춰 보세요.
- 7주차에서
malloc이void *를 돌려준다고 배웠습니다.void는 “없음”이라는 뜻인데, “없음을 가리키는 포인터”란 도대체 무엇일까요? int4바이트와 포인터 8바이트를 담는 구조체는 몇 바이트일까요? 12바이트? 그 구조체를malloc으로 만들면 실제로 몇 바이트의 메모리를 쓸까요?realloc으로 배열을 늘렸는데, 늘리기 전에 챙겨 둔 포인터로 값을 읽었더니 엉뚱한 숫자가 나왔습니다. 왜일까요?- 교과서는 “연결 리스트의 삽입은 O(1)”이라고 합니다. 그런데 실무 개발자들은 “웬만하면 배열을 쓰라”고 합니다. 누구 말이 맞을까요?
이번 주차는 7주차(포인터 심화)에서 배운 malloc, realloc, free 를 실전 도구로 승격시키는 주입니다. 7주차에서 연결 리스트를 “맛보기”로 만들어 봤다면, 이번에는 실제 프로젝트에 쓸 수 있는 수준으로 완성합니다. 그리고 모든 코드를 valgrind 로 검사해 누수 0 을 확인하는 습관을 들입니다.
준비: 예제 빌드하고 실행하기
이번 주의 예제는 examples/ 폴더에, 프로젝트는 projects/ 폴더에 있습니다. week10 폴더에서 make 를 치면 전부 컴파일되어 build/ 폴더에 실행 파일이 생깁니다.
$ cd week10
$ make
컴파일: examples/cll_basic.c
컴파일: examples/dll_basic.c
...
✓ 모든 파일 빌드 완료!
$ ls build/
cll_basic  dll_basic  generic_sort  generic_vector  list_editor  memory_layout
perf_compare  pool_allocator  sll_basic  sll_reverse  valgrind_lab  vector_generic
vector_int  void_pointer
make 는 5주차에서 배운 대로 Makefile 의 규칙에 따라 컴파일합니다. 이 주차의 컴파일 옵션은 1주차부터 써 온 -Wall -Wextra -std=c11 -g 입니다. 파일 하나만 직접 컴파일하고 싶다면 이렇게 합니다.
$ gcc -Wall -Wextra -std=c11 -g examples/void_pointer.c -o build/void_pointer
$ ./build/void_pointer
글 중간중간 “실험” 이 나옵니다. 저장소에 없는 작은 프로그램을 직접 만들어 보는 부분입니다. 예제 폴더를 어지럽히지 않도록 실험용 폴더를 하나 만들어 두세요.
$ mkdir -p ~/c_programming/week10/lab
$ cd ~/c_programming/week10/lab
1. void 포인터와 제네릭 프로그래밍
1.1 void 포인터란?
지금까지 포인터는 항상 타입이 있었습니다. int * 는 int 를, char * 는 char 를 가리켰죠. 그 타입 덕분에 컴파일러는 두 가지를 압니다.
- 역참조할 때 몇 바이트를 읽을지:
*ip는 4바이트를 읽어 int 로 해석합니다. +1하면 몇 바이트를 전진할지:ip + 1은 주소를 4 늘립니다(6주차).
그런데 이런 고민이 생깁니다.
“int 배열을 정렬하는 함수를 만들었다. double 배열도 정렬하고 싶다. 똑같은 코드를 타입만 바꿔서 또 짜야 하나?”
C의 대답이 void 포인터입니다. void * 는 “타입이 정해지지 않은 주소” 입니다. 주소 값은 들고 있지만, 그 주소에 무엇이 몇 바이트 있는지는 모르는 포인터입니다. 그래서 어떤 타입의 주소든 담을 수 있습니다.
int    num = 42;
double pi  = 3.141592;

void *vp;           /* 타입 없는 포인터 */
vp = #          /* int 주소 OK */
vp = π           /* double 주소도 OK */
int * 에 double * 를 넣으면 컴파일러가 경고하지만, void * 에는 무엇을 넣어도 조용합니다. 반대로 void * 를 다른 포인터 변수에 넣을 때도 캐스팅이 필요 없습니다. 7주차에서 int *p = malloc(...) 이라고 캐스팅 없이 쓸 수 있었던 이유입니다.
첫 번째 질문의 답이 여기 있습니다. void * 는 “없음을 가리키는” 포인터가 아니라 “무엇을 가리키는지 말하지 않는” 포인터입니다. malloc 은 우리가 받은 메모리를 int 로 쓸지 구조체로 쓸지 모르니, 타입을 정하지 않은 주소를 돌려주는 것입니다.
대신 치러야 할 대가가 두 가지 있습니다. 둘 다 “크기를 모른다”는 한 가지 사실에서 나옵니다.
대가 1: 그대로는 역참조할 수 없다
실험 폴더에 vderef.c 를 만들어 봅시다.
#include <stdio.h>
int main(void) {
int num = 42;
void *vp = #
printf("%d\n", *vp);
return 0;
}
$ gcc -Wall -Wextra -std=c11 vderef.c -o vderef
vderef.c: In function ‘main’:
vderef.c:6:20: warning: dereferencing ‘void *’ pointer
    6 |     printf("%d\n", *vp);
      |                    ^~~
vderef.c:6:20: error: invalid use of void expression
“void * 를 역참조했다”는 경고에 이어 “void 표현식을 잘못 썼다”는 오류입니다. *vp 는 “그 주소에 있는 값”인데, 몇 바이트를 읽어 무엇으로 해석할지 모르니 값을 만들 수가 없습니다. 원래 타입을 알려 주는 캐스팅이 필요합니다.
printf("%d\n", *(int *)vp); /* "이 주소를 int 주소로 보고, 거기 있는 int 를 읽어라" */
*(int *)vp 는 안쪽부터 읽습니다. (int *)vp 로 “int 를 가리키는 포인터”로 바꾼 다음, 앞의 * 로 역참조합니다. 캐스팅은 컴파일러에게 약속하는 것입니다. 그 주소에 정말 int 가 있는지는 컴파일러가 확인하지 않습니다. double 의 주소를 (int *) 로 읽으면 double 의 앞 4바이트를 int 로 해석한 엉뚱한 값이 나옵니다. 약속을 지키는 것은 프로그래머의 책임입니다.
대가 2: 포인터 산술을 할 수 없다 (표준 C에서는)
vp + 1 은 몇 바이트를 전진해야 할까요? 가리키는 대상의 크기를 모르니 표준 C는 이 연산을 허용하지 않습니다. 그런데 GCC로 실험해 보면 의외의 결과가 나옵니다. varith.c:
#include <stdio.h>

int main(void) {
    int arr[3] = {10, 20, 30};
    void *vp = arr;
    void *next = vp + 1;
    printf("vp   = %p\n", vp);
    printf("vp+1 = %p\n", next);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 varith.c -o varith
$ ./varith
vp   = 0x7ffe1081a06c
vp+1 = 0x7ffe1081a06d
경고 하나 없이 컴파일되고, 주소가 1 늘었습니다. GCC는 확장 기능으로 void * 산술을 “1바이트 단위”로 처리해 줍니다. 편해 보이지만, 표준 C가 아니라서 다른 컴파일러에서는 오류가 납니다. 1주차에서 배운 -Wpedantic 을 켜면 GCC도 이것을 알려 줍니다.
$ gcc -Wall -Wextra -std=c11 -Wpedantic varith.c -o varith
varith.c: In function ‘main’:
varith.c:6:21: warning: pointer of type ‘void *’ used in arithmetic [-Wpointer-arith]
    6 |     void *next = vp + 1;
      |                     ^
$ gcc -Wall -Wextra -std=c11 -pedantic-errors varith.c -o varith
varith.c:6:21: error: pointer of type ‘void *’ used in arithmetic [-Wpointer-arith]
-pedantic-errors 는 “표준 위반을 경고가 아니라 오류로 처리하라”는 옵션입니다. 그러니 이식성 있는 코드는 void * 로 산술을 하지 않습니다. 바이트 단위로 움직이고 싶으면 char * (또는 unsigned char *)로 바꿔서 계산합니다. char 는 표준이 정확히 1바이트로 정해 둔 타입이기 때문입니다.
int arr[3] = {10, 20, 30};
void *vp = arr;
int *second = (int *)((char *)vp + sizeof(int));   /* 4바이트 뒤 = arr[1] */
괄호가 많아 보이지만 안쪽부터 읽으면 됩니다. ① (char *)vp 로 1바이트 단위 포인터로 바꾸고, ② + sizeof(int) 로 4바이트 전진하고, ③ (int *) 로 다시 int 포인터로 바꿉니다. 이 “char * 로 바꿔서 바이트 단위로 계산” 패턴은 이번 주 내내 나옵니다.
examples/void_pointer.c 를 실행하면 이 내용을 한 번에 확인할 수 있습니다.
$ ./build/void_pointer
=== void 포인터 기초 ===

int를 가리킬 때   : 42
double을 가리킬 때: 3.141592
char를 가리킬 때  : A

char* 캐스팅 후 이동: arr[1] = 20
...
1.2 제네릭 swap 만들기
void * 의 힘을 보여 주는 첫 예제입니다. 어떤 타입이든 맞바꾸는 swap 함수를 만들어 봅시다. 6주차에서 만든 swap 은 이랬습니다.
void swap_int(int *a, int *b) {
    int temp = *a;
    *a = *b;
    *b = temp;
}
int 전용입니다. double 을 바꾸려면 swap_double 을, 구조체를 바꾸려면 또 다른 함수를 만들어야 합니다. 핵심 아이디어는 이것입니다. “타입은 몰라도, 크기만 알면 바이트를 하나씩 맞바꿀 수 있다.” int 든 double 이든 구조체든, 메모리에서는 결국 바이트의 나열이니까요.
첫 시도: 임시 버퍼에 통째로 복사
처음 떠올리기 쉬운 방법은 임시 버퍼를 만들어 memcpy 로 통째로 옮기는 것입니다. memcpy(목적지, 원본, 바이트수) 는 원본의 바이트를 목적지로 그대로 복사하는 <string.h> 의 함수입니다.
void generic_swap(void *a, void *b, size_t size) {
    unsigned char temp[64];
    if (size > sizeof(temp)) {
        return;                  /* 버퍼보다 크면 그냥 돌아간다 */
    }
    memcpy(temp, a, size);       /* temp <- a */
    memcpy(a, b, size);          /* a    <- b */
    memcpy(b, temp, size);       /* b    <- temp */
}
int 와 double 로 시험하면 잘 됩니다. 그런데 이 함수에는 함정이 있습니다. 실험해 봅시다. swap_big.c 맨 위에 #include <stdio.h> 와 #include <string.h> 를 쓰고, 위 함수와 이 main 을 붙입니다.
typedef struct {
    char name[100];
    int  score;
} Student;

int main(void) {
    Student s1 = {"철수", 90};
    Student s2 = {"영희", 80};
    printf("sizeof(Student) = %zu\n", sizeof(Student));
    generic_swap(&s1, &s2, sizeof(Student));
    printf("swap 후: s1=%s(%d), s2=%s(%d)\n", s1.name, s1.score, s2.name, s2.score);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g swap_big.c -o swap_big && ./swap_big
sizeof(Student) = 104
swap 후: s1=철수(90), s2=영희(80)
아무것도 바뀌지 않았습니다. 104바이트가 버퍼 64바이트보다 크니 함수가 그냥 돌아간 것입니다. 경고도, 오류도, 종료 코드도 없습니다. 이런 조용한 실패가 가장 찾기 어려운 버그입니다. 호출한 쪽은 교환됐다고 믿고 다음 일을 계속하기 때문입니다.
고친 버전: 한 바이트씩 맞바꾸기
버퍼 없이 한 바이트씩 교환하면 크기 제한이 사라집니다. examples/void_pointer.c 의 실제 코드입니다.
void generic_swap(void *a, void *b, size_t size) {
    unsigned char *p = a;                /* 바이트 단위로 보기 위해 */
    unsigned char *q = b;
    for (size_t i = 0; i < size; i++) {
        unsigned char t = p[i];          /* 한 바이트씩 교환 */
        p[i] = q[i];
        q[i] = t;
    }
}
한 줄씩 봅시다.
void *a, void *b: 어떤 타입의 주소든 받습니다.size_t size: 바꿀 대상 하나의 크기(바이트)입니다. 타입을 모르니 크기는 호출하는 쪽이 알려 줘야 합니다.size_t는sizeof가 돌려주는 타입으로, 크기와 개수를 담는 부호 없는 정수입니다.unsigned char *p = a;:void *를 1바이트 단위 포인터로 봅니다.void *는 다른 포인터 변수에 캐스팅 없이 대입할 수 있다고 했죠. 왜 그냥char가 아니라unsigned char일까요?char는 시스템에 따라 음수가 될 수 있어서, “순수한 바이트 값 0~255″를 다룰 때는unsigned char가 관례입니다.for루프:p[i]와q[i]는 각각 i번째 바이트입니다. 6주차의 swap 과 똑같은 세 줄을 바이트마다 반복합니다.
같은 실험을 이 버전으로 다시 하면 이렇게 됩니다.
$ ./swap_fixed
sizeof(Student) = 104
swap 후: s1=영희(80), s2=철수(90)
사용할 때는 항상 주소와 크기를 함께 넘깁니다.
int x = 1, y = 2;
generic_swap(&x, &y, sizeof(int));        /* int 교환 */

double d1 = 1.5, d2 = 9.9;
generic_swap(&d1, &d2, sizeof(double));   /* double 도 같은 함수로! */

char s1[16] = "hello", s2[16] = "world";
generic_swap(s1, s2, sizeof(s1));          /* 배열 16바이트를 통째로 */
배열 s1 에는 & 가 없는 것을 보세요. 4주차에서 배운 대로 배열 이름은 첫 원소의 주소로 바뀌기 때문입니다.
$ ./build/void_pointer
...
=== 제네릭 swap ===
swap 전: x=1, y=2
swap 후: x=2, y=1
swap 전: d1=1.5, d2=9.9
swap 후: d1=9.9, d2=1.5
swap 전: s1=hello, s2=world
swap 후: s1=world, s2=hello
한 함수로 세 가지 타입을 모두 바꿨습니다. 이것이 제네릭(generic) 프로그래밍, 타입에 얽매이지 않는 코드의 가장 단순한 형태입니다.
실험: 서로 다른 타입을 넘기면?
int x = 1; 과 double d1 = 1.5; 를 두고 generic_swap(&x, &d1, sizeof(double)); 처럼 섞어서 불러 보세요(swap_mismatch.c).
$ gcc -Wall -Wextra -std=c11 -g swap_mismatch.c -o swap_mismatch
$ ./swap_mismatch
x = 0, d1 = 0.000000
컴파일러는 아무 말도 하지 않았고, 프로그램도 멀쩡히 끝났습니다. 그런데 값은 엉망입니다. x 는 4바이트인데 8바이트를 바꿨으니, x 너머의 4바이트까지 건드린 것입니다. 어디까지 건드렸는지는 GCC에 들어 있는 검사 도구 AddressSanitizer(-fsanitize=address)로 컴파일하면 드러납니다. 메모리 경계를 넘는 순간 프로그램을 멈추고 알려 주는 도구입니다.
$ gcc -std=c11 -g -fsanitize=address swap_mismatch.c -o swap_asan && ./swap_asan
=================================================================
==2525405==ERROR: AddressSanitizer: stack-buffer-overflow on address 0x77ce48800034 ...
READ of size 1 at 0x77ce48800034 thread T0
    #0 ... in generic_swap swap_mismatch.c:7
    #1 ... in main swap_mismatch.c:16
“스택 버퍼를 넘쳐서 읽었다(stack-buffer-overflow)”는 보고와 함께, 7번째 줄(p[i] 를 읽는 곳)과 그것을 부른 16번째 줄을 짚어 줍니다. void * 는 타입 검사를 꺼 버리므로 컴파일러는 이 실수를 잡지 못합니다. 제네릭 코드의 유연함은 타입 검사를 포기한 대가라는 것을 기억하세요.
1.3 함수 포인터와 조합: qsort 의 원리
swap 은 “크기”만 알면 됐습니다. 정렬은 하나가 더 필요합니다. “둘 중 어느 것이 더 큰가?” 를 판단해야 합니다. int 는 숫자로 비교하고, 문자열은 사전 순으로 비교하고, 학생 구조체는 점수로 비교할 수도 이름으로 비교할 수도 있습니다. 정렬 함수가 이 판단을 스스로 할 수는 없습니다.
해결책은 7주차에서 배운 함수 포인터입니다. 비교하는 방법을 함수로 만들어서, 그 함수의 주소를 정렬 함수에 넘깁니다. 정렬 함수는 “비교가 필요할 때마다 받은 함수를 불러서 물어보는” 식으로 동작합니다. 이렇게 넘겨받아 나중에 불러 쓰는 함수를 콜백(callback) 이라고 합니다.
| 도구 | 하는 일 |
|---|---|
void * + 크기 |
데이터가 어디 있고 얼마나 큰지만 안다. 타입과 무관하게 옮기고 바꾼다 |
| 함수 포인터 | “어느 쪽이 큰가“의 판단을 호출자에게 맡긴다. 비교 규칙을 바깥에서 끼워 넣는다 |
examples/generic_sort.c 의 제네릭 버블 정렬입니다.
void generic_bubble_sort(void *base, size_t count, size_t size,
                         int (*cmp)(const void *, const void *)) {
    unsigned char *arr = base;           /* 바이트 단위 계산을 위해 char*로 */

    if (count < 2) {
        return;
    }

    for (size_t i = 0; i + 1 < count; i++) {
        for (size_t j = 0; j + 1 < count - i; j++) {
            unsigned char *a = arr + j * size;         /* j번째 원소 주소 */
            unsigned char *b = arr + (j + 1) * size;   /* j+1번째 원소 주소 */

            if (cmp(a, b) > 0) {         /* a가 b보다 크면 교환 */
                for (size_t k = 0; k < size; k++) {   /* 한 바이트씩 */
                    unsigned char t = a[k];
                    a[k] = b[k];
                    b[k] = t;
                }
            }
        }
    }
}
매개변수 네 개를 먼저 봅시다.
| 매개변수 | 뜻 | int 배열 6개를 정렬할 때 |
|---|---|---|
void *base |
배열의 시작 주소 | nums |
size_t count |
원소 개수 | 6 |
size_t size |
원소 하나의 크기 | sizeof(int) = 4 |
int (*cmp)(const void *, const void *) |
비교 함수의 주소 | compare_int_asc |
네 번째 매개변수가 복잡해 보이지만 7주차의 함수 포인터 선언 그대로입니다. 안쪽부터 읽으면 “cmp 는 포인터이고(*cmp), 그것이 가리키는 것은 const void * 두 개를 받아((const void *, const void *)) int 를 돌려주는 함수”입니다.
본문의 핵심은 j번째 원소의 주소 계산입니다.
unsigned char *a = arr + j * size;
int 배열이라면 &nums[j] 로 쓰면 됩니다. 하지만 이 함수는 원소의 타입을 모르니 [j] 를 쓸 수 없습니다. 대신 “시작 주소 + j × 원소 크기” 를 바이트 단위로 직접 계산합니다. 사실 nums[j] 도 컴파일러가 뒤에서 똑같은 계산을 해 주는 것입니다. 4바이트 int 배열이라면 이렇습니다.
base(arr) = 1000번지라고 하면

j=0 : arr + 0*4 = 1000   ┌────┬────┬────┬────┬────┬────┐
j=1 : arr + 1*4 = 1004   │ 5  │ 2  │ 8  │ 1  │ 9  │ 3  │
j=2 : arr + 2*4 = 1008   └────┴────┴────┴────┴────┴────┘
 ...                      1000 1004 1008 1012 1016 1020
비교는 콜백에게 맡깁니다. if (cmp(a, b) > 0) 은 “비교 함수야, a 와 b 중 a 가 크니?”라고 묻는 것입니다. 정렬 함수는 a 와 b 가 무엇인지 전혀 모른 채 주소만 넘깁니다.
비교 함수의 약속
비교 함수는 표준 qsort 와 같은 약속을 따릅니다.
| 돌려주는 값 | 뜻 |
|---|---|
| 음수 | a 가 b 보다 앞에 와야 한다 (a < b) |
| 0 | 둘은 같다 |
| 양수 | a 가 b 보다 뒤에 와야 한다 (a > b) |
int 오름차순 비교 함수입니다.
int compare_int_asc(const void *a, const void *b) {
    int x = *(const int *)a;
    int y = *(const int *)b;
    return (x > y) - (x < y);    /* 음수/0/양수 반환 */
}
const void *: 비교 함수는 값을 읽기만 하고 바꾸지 않겠다는 약속입니다. 그래서 캐스팅도(const int *)로 합니다.*(const int *)a: 1.1절에서 본 캐스팅 후 역참조입니다. “a 는 사실 int 의 주소이니, 거기 있는 int 를 읽어라.”(x > y) - (x < y): 비교식은 참이면 1, 거짓이면 0 입니다(3주차). x 가 크면1 - 0 = 1, 같으면0 - 0 = 0, 작으면0 - 1 = -1. 약속한 음수/0/양수가 정확히 나옵니다.
내림차순은 인자 순서만 뒤집으면 됩니다.
int compare_int_desc(const void *a, const void *b) {
    return compare_int_asc(b, a);        /* 인자만 뒤집으면 내림차순 */
}
실험: 왜 return x - y; 를 쓰면 안 될까?
인터넷의 많은 예제가 비교 함수를 return x - y; 한 줄로 씁니다. 더 짧고, x 가 크면 양수, 작으면 음수가 나오니 맞아 보입니다. 정말 그럴까요? cmp_overflow.c 로 두 방식을 비교해 봅시다.
#include <stdio.h>
#include <stdlib.h>

int cmp_sub(const void *a, const void *b) {
    int x = *(const int *)a;
    int y = *(const int *)b;
    return x - y;                    /* 위험한 방식 */
}

int cmp_safe(const void *a, const void *b) {
    int x = *(const int *)a;
    int y = *(const int *)b;
    return (x > y) - (x < y);        /* 안전한 방식 */
}

void print(const char *label, const int *arr, size_t n) {
    printf("%s:", label);
    for (size_t i = 0; i < n; i++) printf(" %d", arr[i]);
    printf("\n");
}

int main(void) {
    int a[] = {2000000000, -2000000000, 0, 1500000000, -5};
    int b[] = {2000000000, -2000000000, 0, 1500000000, -5};
    size_t n = sizeof(a) / sizeof(a[0]);

    qsort(a, n, sizeof(int), cmp_sub);
    qsort(b, n, sizeof(int), cmp_safe);
    print("x - y 방식   ", a, n);
    print("비교식 방식  ", b, n);

    int x = 2000000000, y = -2000000000;
    printf("\n%d - (%d) = %d\n", x, y, x - y);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g cmp_overflow.c -o cmp_overflow && ./cmp_overflow
x - y 방식   : -5 0 1500000000 2000000000 -2000000000
비교식 방식  : -2000000000 -5 0 1500000000 2000000000

2000000000 - (-2000000000) = -294967296
x - y 방식은 -20억을 맨 뒤로 보냈습니다. 틀린 정렬입니다. 마지막 줄이 이유를 보여 줍니다. 20억 − (−20억) = 40억인데, int 가 담을 수 있는 최댓값은 약 21억(2,147,483,647)입니다. 넘친 값이 한 바퀴 돌아 음수 -294967296 이 되었고, 비교 함수는 “20억이 -20억보다 작다”고 답해 버렸습니다. 2주차에서 본 정수 오버플로우입니다.
부호 있는 정수의 오버플로우는 C에서 미정의 동작입니다. GCC의 검사 도구 -fsanitize=undefined 로 컴파일하면 실행 중에 잡아 줍니다.
$ gcc -std=c11 -g -fsanitize=undefined cmp_overflow.c -o cmp_ub && ./cmp_ub
cmp_overflow.c:7:14: runtime error: signed integer overflow: 2000000000 - -2000000000 cannot be represented in type 'int'
...
평범한 숫자로 테스트하면 절대 드러나지 않고, 큰 값이 섞이는 순간에만 틀리는 버그입니다. 그래서 비교 함수는 뺄셈 대신 비교식으로 씁니다.
문자열 배열 정렬: 캐스팅이 한 단계 더
문자열 배열을 정렬할 때는 한 번 더 생각해야 합니다.
const char *names[] = {"cherry", "apple", "banana", "date"};
이 배열의 원소 하나는 const char *(문자열의 주소)입니다. 정렬 함수는 비교 함수에 “원소의 주소”를 넘깁니다. 원소가 포인터이니, 원소의 주소는 포인터의 포인터입니다.
names 배열 (원소 = 문자열의 주소, 8바이트씩)
┌──────────┬──────────┬──────────┬──────────┐
│ 주소 ────┼─▶"cherry"│          │          │
└──────────┴──────────┴──────────┴──────────┘
  ▲
  비교 함수가 받는 a 는 바로 여기(원소의 위치)를 가리킨다
  → a 는 char ** 이고, *a 를 해야 문자열 "cherry" 의 주소가 나온다
그래서 비교 함수는 이렇게 됩니다.
int compare_string(const void *a, const void *b) {
    const char *x = *(const char *const *)a;   /* char** 로 보고 역참조 */
    const char *y = *(const char *const *)b;
    return strcmp(x, y);
}
(const char *const *)a 는 “a 는 const char * 를 가리키는 (그리고 그 포인터 자체도 바꾸지 않을) 포인터”라는 뜻입니다. 앞의 * 로 역참조하면 문자열의 주소가 나옵니다. strcmp 는 4주차에서 배운 대로 사전 순 비교 결과를 음수/0/양수로 돌려주니 그대로 넘기면 됩니다.
실험: 캐스팅을 한 단계 빼먹으면?
이 캐스팅을 헷갈려서 strcmp((const char *)a, (const char *)b) 로 쓰는 실수가 아주 흔합니다. 어떻게 될까요? cmp_wrongcast.c:
int compare_wrong(const void *a, const void *b) {
    return strcmp((const char *)a, (const char *)b);    /* 잘못된 캐스팅 */
}
$ gcc -Wall -Wextra -std=c11 -g cmp_wrongcast.c -o cmp_wrongcast && ./cmp_wrongcast
잘못된 캐스팅: cherry apple banana date
올바른 캐스팅: apple banana cherry date
경고도 없고, 프로그램도 죽지 않습니다. 정렬만 안 됩니다. 잘못된 버전은 문자열이 아니라 배열 안에 저장된 주소 값의 바이트들을 글자인 양 비교했습니다. 결과는 주소가 우연히 어떻게 놓였느냐에 달려 있어서, 순서가 뒤죽박죽이 됩니다. void * 는 타입 검사를 꺼 버리므로 컴파일러가 도와줄 수 없습니다. “비교 함수는 원소의 주소를 받는다. 원소가 포인터면 포인터의 포인터를 받는다.” 이 한 문장을 기억하세요.
실행 결과
$ ./build/generic_sort
=== 제네릭 정렬 (직접 구현) ===

원본        : 5 2 8 1 9 3
오름차순    : 1 2 3 5 8 9
내림차순    : 9 8 5 3 2 1

double 정렬 : 0.1 1.7 2.5 3.9
문자열 정렬 : apple banana cherry date

qsort 결과  : 3 7 19 42 88

핵심: void*(타입 무관 주소) + 함수 포인터(비교 규칙 주입) = 제네릭
마지막 qsort 결과 를 보세요. 우리가 만든 비교 함수 compare_int_asc 를 표준 라이브러리의 qsort 에 그대로 넘겼습니다. qsort 가 선언된 헤더 파일을 직접 열어 봅시다(1주차 2절에서 less 로 stdio.h 를 열어 봤던 것처럼).
$ grep -n -A1 "^extern void qsort" /usr/include/stdlib.h
970:extern void qsort (void *__base, size_t __nmemb, size_t __size,
971-           __compar_fn_t __compar) __nonnull ((1, 4));
밑줄이 많고 __compar_fn_t 라는 낯선 이름이 있지만, __compar_fn_t 는 같은 파일에서 int (*)(const void *, const void *) 에 붙인 별명입니다(typedef, 8주차). 밑줄을 걷어 내면 이렇습니다.
void qsort(void *base, size_t nmemb, size_t size,
           int (*compar)(const void *, const void *));
우리가 만든 generic_bubble_sort 와 매개변수가 정확히 같습니다. 이제 qsort 가 어떻게 “모든 타입”을 정렬하는지 설명할 수 있을 겁니다. 차이는 내부 알고리즘뿐입니다. 버블 정렬은 원소가 N개면 비교를 약 N²/2 번 하지만, qsort 는 훨씬 빠른 알고리즘을 씁니다. 정렬 알고리즘은 15주차에서 직접 구현하고 비교해 봅니다.
2. 메모리 정렬과 패딩
자료구조를 만들면 구조체를 수십만, 수백만 개 할당하게 됩니다. 그때 구조체 하나의 크기가 정확히 몇 바이트인지가 중요해집니다. 그런데 그 크기가 우리의 계산과 다릅니다.
2.1 구조체 크기의 미스터리
struct BadLayout {
    char   a;    /* 1바이트 */
    double b;    /* 8바이트 */
    char   c;    /* 1바이트 */
    int    d;    /* 4바이트 */
};
멤버를 더하면 1 + 8 + 1 + 4 = 14바이트입니다. examples/memory_layout.c 로 확인해 봅시다.
$ ./build/memory_layout
=== 기본 타입의 크기와 정렬 요구사항 ===
char     크기= 1, 정렬= 1
int      크기= 4, 정렬= 4
double   크기= 8, 정렬= 8
void*    크기= 8, 정렬= 8

=== 구조체 패딩: 멤버 순서가 크기를 바꾼다 ===
BadLayout  멤버 합: 14바이트 -> 실제 크기: 24바이트
GoodLayout 멤버 합: 14바이트 -> 실제 크기: 16바이트
...
24바이트입니다. 10바이트가 어디서 늘어났을까요? 범인은 정렬(alignment) 입니다.
첫 번째 표의 “정렬” 칸을 보세요. _Alignof(타입) 은 C11 에서 추가된 연산자로, “이 타입은 몇의 배수 주소에 놓여야 하는가” 를 알려 줍니다. int 는 4의 배수 주소에, double 과 포인터는 8의 배수 주소에 있어야 합니다.
왜 그럴까요? CPU는 메모리를 1바이트씩 읽지 않고, 4바이트나 8바이트 같은 덩어리 단위로 읽습니다. 8바이트 double 이 8의 배수 주소에 있으면 한 번에 읽히지만, 만약 5번지부터 시작하면 두 덩어리(0~7, 8~15)에 걸쳐 있게 되어 두 번 읽고 이어 붙여야 합니다. 느려질 뿐 아니라, 어떤 CPU(ARM 의 일부 명령 등)는 아예 읽기를 거부하고 프로그램을 죽입니다. 그래서 컴파일러는 멤버를 제자리에 놓으려고 멤버 사이에 보이지 않는 빈 공간을 끼워 넣습니다. 이것을 패딩(padding) 이라고 합니다.
offsetof(구조체, 멤버) 매크로(<stddef.h>)로 각 멤버가 구조체 시작에서 몇 바이트 떨어져 있는지 볼 수 있습니다.
=== BadLayout 내부 배치 (offsetof) ===
a: 오프셋  0 (크기 1)
b: 오프셋  8 (크기 8)  <- a 뒤에 패딩 7바이트
c: 오프셋 16 (크기 1)
d: 오프셋 20 (크기 4)  <- c 뒤에 패딩 3바이트
바이트 지도로 그리면 이렇습니다. · 가 패딩입니다.
오프셋: 0   1   2   3   4   5   6   7   8 ~ 15            16  17  18  19  20 ~ 23
      ┌───┬───┬───┬───┬───┬───┬───┬───┬─────────────────┬───┬───┬───┬───┬───────────┐
      │ a │ · │ · │ · │ · │ · │ · │ · │        b        │ c │ · │ · │ · │     d     │
      └───┴───┴───┴───┴───┴───┴───┴───┴─────────────────┴───┴───┴───┴───┴───────────┘
        1   └──── 패딩 7 ────┘         8 (8의 배수 ✓)      1   └패딩 3┘   4 (4의 배수 ✓)
a는 0번지. 1바이트라 어디든 괜찮습니다.b는 double 이라 8의 배수여야 합니다. 1번지는 안 되니 7바이트를 건너뛰어 8번지에 놓습니다.c는 16번지. 1바이트라 바로 이어 놓습니다.d는 int 라 4의 배수여야 합니다. 17번지는 안 되니 3바이트를 건너뛰어 20번지에 놓습니다.
합계 24바이트, 그중 10바이트가 패딩입니다. 거의 절반이 빈 공간입니다.
2.2 멤버 순서만 바꿔도 크기가 준다
같은 멤버를 큰 것부터 배치해 봅시다.
struct GoodLayout {
    double b;    /* 8 */
    int    d;    /* 4 */
    char   a;    /* 1 */
    char   c;    /* 1 */
};
=== GoodLayout 내부 배치 ===
b: 오프셋  0
d: 오프셋  8
a: 오프셋 12
c: 오프셋 13
오프셋: 0 ~ 7             8 ~ 11      12  13  14  15
      ┌─────────────────┬───────────┬───┬───┬───┬───┐
      │        b        │     d     │ a │ c │ · │ · │
      └─────────────────┴───────────┴───┴───┴───┴───┘
                                              └패딩2┘
큰 멤버가 앞에 오면 뒤의 작은 멤버들은 자연스럽게 정렬 조건을 만족해서, 중간 패딩이 사라집니다. 그런데 끝에 2바이트 패딩이 남았습니다. 14바이트로 끝내면 안 될까요?
실험: 끝에 붙는 패딩은 왜 필요할까?
구조체는 배열로 늘어놓일 수 있어야 합니다. struct GoodLayout arr[2]; 에서 arr[1] 은 arr[0] 바로 뒤에 붙습니다. 만약 크기가 14라면 arr[1].b 는 14번지에서 시작하게 되는데, 14는 8의 배수가 아닙니다. 그래서 구조체 크기 자체를 가장 큰 정렬 단위(여기서는 8)의 배수로 맞춰 두는 것입니다. 작은 구조체로 확인해 봅시다. tailpad.c:
#include <stdio.h>
#include <stddef.h>

struct T { double b; char a; };

int main(void) {
    struct T arr[2];
    printf("sizeof(struct T) = %zu\n", sizeof(struct T));
    printf("arr[0] 주소: %p\narr[1] 주소: %p\n", (void *)&arr[0], (void *)&arr[1]);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 tailpad.c -o tailpad && ./tailpad
sizeof(struct T) = 16
arr[0] 주소: 0x7ffd20467c80
arr[1] 주소: 0x7ffd20467c90
멤버는 8 + 1 = 9바이트인데 크기는 16입니다. 두 원소의 주소 차이도 0x90 - 0x80 = 16 입니다. 끝의 7바이트 패딩 덕분에 arr[1].b 가 16의 배수 주소에 제대로 놓였습니다.
“겨우 몇 바이트?”라고 생각할 수 있지만, 자료구조에서는 이야기가 다릅니다. BadLayout 을 100만 개 할당하면 24MB, GoodLayout 이면 16MB입니다. 멤버 순서만 바꿨는데 8MB가 줄어듭니다.
2.3 연결 리스트 노드의 실제 크기
이번 주에 가장 많이 만들 구조체는 연결 리스트의 노드입니다.
struct Node {
    int data;            /* 4바이트 */
    struct Node *next;   /* 8바이트 */
};
4 + 8 = 12바이트일까요? memory_layout 의 마지막 부분입니다.
=== 자료구조 설계와의 관계 ===
Node(int + 포인터) 크기: 16바이트 (4+8=12가 아니라 16)
노드 100만 개면 패딩만으로 4000000바이트(약 3.8MB)가 추가로 든다

구조체 패딩과 노드의 실제 크기
next 는 포인터라 8의 배수 위치여야 하므로, data 뒤에 4바이트 패딩이 들어가 16바이트가 됩니다.
오프셋: 0 ~ 3   4 ~ 7    8 ~ 15
      ┌───────┬───────┬─────────────────┐
      │ data  │ ····· │      next       │
      └───────┴───────┴─────────────────┘
               패딩 4   ← next 는 오프셋 8 에 있다. 이 숫자를 기억해 두세요 (4.4절)
두 번째 질문의 전반부 답이 나왔습니다. 12가 아니라 16바이트입니다. 그럼 이 노드를 malloc(sizeof(Node)) 로 만들면 실제로 메모리를 몇 바이트 쓸까요? 16바이트일까요? 실험해 봅시다. node_addr.c:
#include <stdio.h>
#include <stdlib.h>
#include <malloc.h>

typedef struct Node {
    int data;
    struct Node *next;
} Node;

int main(void) {
    Node *nodes[5];
    for (int i = 0; i < 5; i++) {
        nodes[i] = malloc(sizeof(Node));
        nodes[i]->data = (i + 1) * 10;
        nodes[i]->next = NULL;
    }

    printf("sizeof(Node)          = %zu\n", sizeof(Node));
    printf("malloc_usable_size    = %zu\n\n", malloc_usable_size(nodes[0]));
    for (int i = 0; i < 5; i++) {
        printf("노드 %d (data=%d) 주소: %p", i, nodes[i]->data, (void *)nodes[i]);
        if (i > 0) printf("   앞 노드와의 거리: %td바이트",
                          (char *)nodes[i] - (char *)nodes[i - 1]);
        printf("\n");
    }

    for (int i = 0; i < 5; i++) free(nodes[i]);
    return 0;
}
malloc_usable_size 는 glibc(리눅스의 C 라이브러리)가 제공하는 함수로, “이 블록에 실제로 쓸 수 있는 바이트 수”를 알려 줍니다. 표준 함수가 아니라 <malloc.h> 에 있습니다. 두 주소의 차이는 char * 로 바꿔서 빼면 바이트 단위가 됩니다(1.1절). %td 는 포인터끼리 뺀 값(ptrdiff_t)을 출력하는 서식입니다.
$ gcc -Wall -Wextra -std=c11 -g node_addr.c -o node_addr && ./node_addr
sizeof(Node)          = 16
malloc_usable_size    = 24

노드 0 (data=10) 주소: 0x60038e4f92a0
노드 1 (data=20) 주소: 0x60038e4f92c0   앞 노드와의 거리: 32바이트
노드 2 (data=30) 주소: 0x60038e4f92e0   앞 노드와의 거리: 32바이트
노드 3 (data=40) 주소: 0x60038e4f9300   앞 노드와의 거리: 32바이트
노드 4 (data=50) 주소: 0x60038e4f9320   앞 노드와의 거리: 32바이트
16바이트를 달라고 했는데, 노드들이 32바이트 간격으로 놓였습니다. malloc 은 블록마다 앞에 8바이트짜리 관리 정보(헤더) 를 붙이고(블록 크기 등을 기록해 두어야 나중에 free 가 얼마를 돌려받을지 알 수 있습니다), 전체를 16바이트 단위로 맞추기 때문입니다. 그래서 16바이트 요청은 32바이트를 차지하고, 그중 우리가 쓸 수 있는 것이 24바이트입니다.
      ┌──────────┬───────────────────────────┐┌──────────┬──────────── ...
      │ 헤더 8B  │ 노드 16B (+ 여유 8B)       ││ 헤더 8B  │ 다음 노드
      └──────────┴───────────────────────────┘└──────────┴──────────── ...
                 ▲ 92a0                                  ▲ 92c0
                 └──────────── 32바이트 ─────────────────┘
그러니 int 하나(4바이트)를 연결 리스트에 담으면 실제로는 32바이트를 씁니다. 8배입니다. int 배열이라면 딱 4바이트씩입니다. 이 숫자는 5절에서 배열과 리스트를 비교할 때 다시 나옵니다. 그리고 주소가 92a0, 92c0, 92e0... 처럼 차례로 붙어 있다는 것도 눈여겨보세요. 이것도 5절의 중요한 단서입니다.
주소는 실행할 때마다 바뀝니다. 보안을 위해 운영체제가 프로그램을 매번 다른 위치에 올리기 때문입니다(1주차 7절의
pie). 하지만 끝자리2a0, 2c0, 2e0과 32바이트 간격은 매번 같습니다.
기억할 것 세 가지
- 구조체 크기는 반드시
sizeof로만 판단합니다. 손으로 더하면 틀립니다. 9주차에서fwrite로 구조체를 저장할 때도 그랬습니다. - 큰 멤버부터 배치하면 패딩을 줄일 수 있습니다.
- 대량으로 할당하는 구조체일수록 패딩과
malloc헤더의 낭비가 커집니다.
3. 동적 배열(Vector) 만들기
3.1 “크기가 자동으로 늘어나는 배열”
배열의 가장 큰 약점은 크기가 고정이라는 것입니다. int scores[10]; 에 11번째 점수가 오면 넣을 곳이 없습니다. 처음부터 int scores[1000000]; 으로 크게 잡으면 어떨까요? 데이터가 10개뿐일 때도 4MB를 차지하고, 100만 1개째가 오면 똑같은 문제가 생깁니다. 게다가 함수 안의 큰 배열은 스택(7주차)을 넘쳐 프로그램을 죽이기도 합니다.
7주차에서 realloc 으로 힙의 배열을 늘리는 법을 배웠습니다. 하지만 원소를 넣을 때마다 “자리가 있나? 없으면 늘리고…”를 손으로 챙기기는 번거롭고 실수하기 쉽습니다. 그래서 이 일을 대신 해 주는 자료구조를 만들어 씁니다. C++의 std::vector, 파이썬의 list, 자바의 ArrayList 가 전부 이 방식입니다. 핵심은 세 개의 필드입니다.
typedef struct {
    int   *data;        /* 실제 데이터가 저장되는 힙 공간 */
    size_t size;        /* 현재 담긴 원소 개수 */
    size_t capacity;    /* 확보해 둔 칸 수 */
} IntVector;
size 와 capacity 를 분리하는 것이 비결입니다. 창고(capacity)를 넉넉히 확보해 두고, 실제 물건(size)은 그 안에 차곡차곡 쌓습니다. 창고가 가득 찼을 때만 더 큰 창고로 이사(realloc)합니다. 원소 6개가 들어 있고 16칸을 확보해 둔 상태를 그리면 이렇습니다.
IntVector vec (스택)                    힙
┌──────────────────┐        ┌────┬────┬────┬────┬────┬────┬────┬ ─ ─ ┬────┐
│ data     ────────┼───────▶│ 10 │ 20 │ 30 │ 40 │ 50 │ 60 │    │ ... │    │
│ size     = 6     │        └────┴────┴────┴────┴────┴────┴────┴ ─ ─ ┴────┘
│ capacity = 16    │         └──── size = 6 (사용 중) ────┘└─ 빈 자리 10칸 ─┘
└──────────────────┘         └──────────────── capacity = 16 ────────────────┘
구조체 vec 자체는 스택에 있고(작습니다. 포인터 하나와 숫자 두 개, 24바이트), 실제 데이터는 data 가 가리키는 힙에 있습니다. 이 “작은 관리 구조체 + 힙의 큰 데이터” 모양은 앞으로 만들 거의 모든 자료구조의 기본형입니다.
3.2 realloc 다시 보기
벡터를 만들기 전에, 핵심 도구인 realloc 을 정확히 알고 넘어갑시다. 7주차에서 배웠지만, 이번 주에는 훨씬 깊이 씁니다.
void *realloc(void *ptr, size_t size);
“ptr 이 가리키는 블록의 크기를 size 바이트로 바꿔 달라”는 함수입니다. 동작을 표로 정리하면 이렇습니다.
| 상황 | realloc 이 하는 일 | 돌려주는 값 |
|---|---|---|
ptr 이 NULL |
malloc(size) 와 똑같이 새로 할당 |
새 블록 주소 |
| 뒤에 빈 공간이 있어 제자리에서 늘릴 수 있음 | 블록 크기만 늘림 | 원래와 같은 주소 |
| 제자리에서 못 늘림 | 새 곳에 할당 → 원래 내용 복사 → 원래 블록 해제 | 새 주소 |
| 메모리가 부족해 실패 | 아무것도 안 함. 원래 블록은 그대로 살아 있음 | NULL |
세 번째 줄이 중요합니다. realloc 은 필요하면 데이터를 다른 곳으로 이사시키고, 이사 전 자리는 해제합니다. 정말 그런지 주소를 찍어 봅시다. vec_move.c 는 벡터를 키우면서, 매번 realloc 전후의 주소를 비교합니다. 일부러 realloc 할 때마다 바로 뒤에 다른 작은 할당을 하나씩 끼워 둡니다. 뒤가 막히면 제자리에서 늘릴 수 없기 때문입니다.
#include <stdio.h>
#include <stdlib.h>
#include <stdint.h>

int main(void) {
    int *data = NULL;
    size_t size = 0, cap = 0;
    void *blockers[16];
    int nb = 0;

    for (int i = 0; i < 200; i++) {
        if (size == cap) {
            size_t old = cap;
            cap = (cap == 0) ? 4 : cap * 2;
            uintptr_t before = (uintptr_t)data;     /* 옛 주소를 숫자로 기억 */
            int *tmp = realloc(data, cap * sizeof(int));
            if (tmp == NULL) { free(data); return 1; }
            data = tmp;
            printf("capacity %3zu -> %3zu : %#14lx -> %p  %s\n", old, cap,
                   (unsigned long)before, (void *)data,
                   before == 0 ? "(새로 할당)" :
                   before == (uintptr_t)data ? "(제자리에서 늘림)" : "(이사함!)");
            blockers[nb++] = malloc(16);            /* 바로 뒤에 다른 할당을 끼워 둔다 */
        }
        data[size++] = i;
    }
    free(data);
    for (int i = 0; i < nb; i++) free(blockers[i]);
    return 0;
}
옛 주소를 uintptr_t (주소를 담을 수 있는 크기의 정수, <stdint.h>)로 바꿔서 기억한 이유가 있습니다. 처음에는 void *before = data; 로 포인터 그대로 기억했는데, GCC가 이렇게 경고했습니다.
warning: pointer ‘before’ may be used after ‘realloc’ [-Wuse-after-free]
realloc 이 이사하면 before 는 해제된 블록을 가리키는 포인터가 됩니다. 해제된 포인터는 역참조뿐 아니라 값을 비교하는 것조차 표준상 정의되지 않은 동작입니다. 그래서 realloc 을 부르기 전에 주소를 숫자로 바꿔 둔 것입니다. 컴파일러가 이런 것까지 알려 준다는 것을 기억해 두세요.
$ gcc -Wall -Wextra -std=c11 -g vec_move.c -o vec_move && ./vec_move
capacity   0 ->   4 :              0 -> 0x5fc0db65c2a0  (새로 할당)
capacity   4 ->   8 : 0x5fc0db65c2a0 -> 0x5fc0db65d2f0  (이사함!)
capacity   8 ->  16 : 0x5fc0db65d2f0 -> 0x5fc0db65d2f0  (제자리에서 늘림)
capacity  16 ->  32 : 0x5fc0db65d2f0 -> 0x5fc0db65d360  (이사함!)
capacity  32 ->  64 : 0x5fc0db65d360 -> 0x5fc0db65d410  (이사함!)
capacity  64 -> 128 : 0x5fc0db65d410 -> 0x5fc0db65d540  (이사함!)
capacity 128 -> 256 : 0x5fc0db65d540 -> 0x5fc0db65d770  (이사함!)
첫 줄은 data 가 NULL 이라 새로 할당했고(표의 첫 줄), 대부분은 이사했고, 한 번은 운 좋게 뒤가 비어 있어 제자리에서 늘렸습니다. 어느 쪽이 될지는 그때그때 힙 상태에 달려 있어서 미리 알 수 없습니다. 뒤에 끼워 둔 할당을 빼고 돌려 보면 한 번 이사한 뒤로는 계속 제자리에서 늘어나는 것도 볼 수 있습니다. 벡터가 힙의 맨 끝에 있어 뒤가 텅 비어 있기 때문입니다.
이 사실에서 두 가지 규칙이 나옵니다.
규칙 1: realloc 전에 챙겨 둔 포인터는 믿지 마라
세 번째 질문이 이것입니다. stale_ptr.c:
#include <stdio.h>
#include <stdlib.h>

int main(void) {
    int *data = malloc(4 * sizeof(int));
    if (data == NULL) return 1;
    for (int i = 0; i < 4; i++) data[i] = (i + 1) * 10;

    int *first = &data[0];           /* 첫 원소의 주소를 챙겨 둔다 */
    void *other = malloc(16);        /* 바로 뒤에 다른 할당 */

    int *tmp = realloc(data, 1000 * sizeof(int));   /* 크게 늘린다 */
    if (tmp == NULL) { free(data); free(other); return 1; }
    data = tmp;

    printf("data[0] = %d\n", data[0]);
    printf("*first  = %d\n", *first);   /* 옛 주소로 읽기 */

    free(data);
    free(other);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g stale_ptr.c -o stale_ptr
stale_ptr.c: In function ‘main’:
stale_ptr.c:17:5: warning: pointer ‘first’ may be used after ‘realloc’ [-Wuse-after-free]
   17 |     printf("*first  = %d\n", *first);   /* 옛 주소로 읽기 */
      |     ^~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~
stale_ptr.c:12:16: note: call to ‘realloc’ here
$ ./stale_ptr
data[0] = 10
*first  = -1524884578
GCC가 컴파일할 때 이미 경고했고, 실행하면 data[0] 은 10 인데 *first 는 쓰레기 값입니다. data 는 이사 간 새 집을 가리키지만, first 는 철거된 옛 집을 가리키고 있기 때문입니다. valgrind 로 돌리면 정확히 짚어 줍니다(보고서 읽는 법은 6절에서 자세히 봅니다).
$ valgrind ./stale_ptr
==2481389== Invalid read of size 4
==2481389==    at 0x109285: main (stale_ptr.c:17)
==2481389==  Address 0x4aac040 is 0 bytes inside a block of size 16 free'd
==2481389==    at 0x484DB80: realloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==2481389==    by 0x109232: main (stale_ptr.c:12)
“17번째 줄에서 4바이트를 잘못 읽었다. 그 주소는 12번째 줄의 realloc 이 해제한 16바이트 블록 안이다.” 벡터 안의 원소를 가리키는 포인터를 따로 들고 있다가, 벡터에 원소를 추가(그래서 realloc)한 뒤 그 포인터를 쓰는 것은 실무에서도 아주 흔한 버그입니다. 원소를 가리킬 때는 포인터 대신 인덱스(몇 번째)를 기억하세요. 인덱스는 이사해도 변하지 않습니다.
규칙 2: realloc 결과는 반드시 임시 변수에 받아라
realloc 이 실패하면 NULL 을 돌려주지만 원래 블록은 그대로 살아 있습니다(표의 마지막 줄). 그런데 결과를 원래 변수에 바로 받으면 어떻게 될까요? 실패를 일부러 일으켜 봅시다. realloc_fail.c 는 말도 안 되게 큰 크기(약 9,223,372TB)를 요청해서 확실히 실패하게 만듭니다.
#include <stdio.h>
#include <stdlib.h>
#include <stdint.h>

int main(void) {
    int *data = malloc(100 * sizeof(int));
    if (data == NULL) return 1;
    data[0] = 42;

    /* 일부러 말도 안 되게 큰 크기를 요청해서 실패시킨다 */
    size_t huge = SIZE_MAX / 2;

    data = realloc(data, huge);      /* 위험한 방식: 결과를 바로 원래 변수에 */
    if (data == NULL) {
        printf("realloc 실패! data는 이제 NULL\n");
        printf("원래 있던 400바이트는 어디로?\n");
        return 1;
    }
    free(data);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g realloc_fail.c -o realloc_fail && ./realloc_fail
realloc 실패! data는 이제 NULL
원래 있던 400바이트는 어디로?
$ valgrind --leak-check=full ./realloc_fail
...
==2482379== 400 bytes in 1 blocks are definitely lost in loss record 1 of 1
==2482379==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==2482379==    by 0x1091BE: main (realloc_fail.c:6)
...
==2482379==    definitely lost: 400 bytes in 1 blocks
컴파일러는 아무 경고도 하지 않았습니다. 하지만 valgrind 는 6번째 줄에서 할당한 400바이트를 “확실히 잃어버렸다(definitely lost)” 고 보고합니다. realloc 이 실패했을 때 원래 400바이트는 멀쩡히 살아 있었는데, 그 주소를 들고 있던 유일한 변수 data 에 NULL 을 덮어써 버렸기 때문입니다. 데이터는 힙에 그대로 있는데 찾아갈 방법이 없어졌습니다. 이것이 메모리 누수입니다.
그래서 항상 이렇게 씁니다.
int *tmp = realloc(data, new_size);   /* ① 임시 변수에 받는다 */
if (tmp == NULL) {
    /* ② 실패: data 는 아직 원래 블록을 가리킨다. 정리하거나 그대로 쓸 수 있다 */
    ...
}
data = tmp;                            /* ③ 성공했을 때만 바꿔 넣는다 */
3.3 2배 확장 전략 — vector_push_back 한 줄씩
이제 examples/vector_int.c 의 핵심인 vector_push_back 을 봅시다.
int vector_push_back(IntVector *vec, int value) {
    if (vec->size == vec->capacity) {
        /* 공간 부족 -> 2배로 확장 (처음엔 4칸으로 시작) */
        size_t old_capacity = vec->capacity;
        size_t new_capacity = (old_capacity == 0) ? 4 : old_capacity * 2;

        /* realloc 결과를 임시 변수에 받는다.
         * 바로 vec->data에 넣으면 실패 시 원본 주소를 잃는다! */
        int *new_data = realloc(vec->data, new_capacity * sizeof(int));
        if (new_data == NULL) {
            return 0;                    /* 실패해도 기존 데이터는 살아있음 */
        }

        vec->data = new_data;
        vec->capacity = new_capacity;
        printf("  [확장] capacity: %zu -> %zu\n", old_capacity, new_capacity);
    }

    vec->data[vec->size] = value;
    vec->size++;
    return 1;
}
| 줄 | 하는 일 |
|---|---|
IntVector *vec |
벡터를 포인터로 받습니다. 값으로 받으면 복사본의 size 만 늘어나고 호출한 쪽의 벡터는 그대로입니다(4.2절에서 이 실수를 직접 해 봅니다) |
if (vec->size == vec->capacity) |
빈 자리가 없을 때만 확장합니다. 대부분의 push 는 이 if 를 건너뜁니다 |
(old_capacity == 0) ? 4 : old_capacity * 2 |
처음에는 4칸, 그 뒤로는 2배씩. ? : 는 3주차의 조건 연산자입니다 |
realloc(vec->data, new_capacity * sizeof(int)) |
크기는 바이트 단위입니다. 칸 수에 sizeof(int) 를 곱하는 것을 잊지 마세요. 처음에는 vec->data 가 NULL 이라 malloc 처럼 동작합니다 |
return 0 |
실패를 알립니다. 벡터는 망가지지 않았으니 호출한 쪽이 판단해서 처리합니다 |
vec->data[vec->size] = value; |
비어 있는 첫 칸(인덱스 = 현재 개수)에 넣습니다 |
vec->size++ |
개수를 하나 늘립니다 |
vector_int 를 실행하면 확장 과정이 보입니다.
$ ./build/vector_int
=== push_back: 자동 확장 관찰 ===
  [확장] capacity: 0 -> 4
  [확장] capacity: 4 -> 8
  [확장] capacity: 8 -> 16
[10, 20, 30, 40, 50, 60, 70, 80, 90, 100]  (size=10, capacity=16)

=== 인덱스 접근 ===
vec[3] = 40
vec[99] = 범위 초과! (안전하게 거부됨)

=== pop_back ===
꺼낸 값: 100 (남은 개수: 9)
꺼낸 값: 90 (남은 개수: 8)
꺼낸 값: 80 (남은 개수: 7)
꺼낸 값: 70 (남은 개수: 6)
[10, 20, 30, 40, 50, 60]  (size=6, capacity=16)

pop 후에도 capacity는 16로 유지 (재사용 대비)

메모리 해제 완료 (valgrind로 누수 0 확인 가능)
원소 10개를 넣는 동안 확장은 세 번뿐입니다.
왜 하필 2배일까?
1칸씩 늘린다면 어떨까요? 원소를 넣을 때마다 realloc 을 부르고, 이사할 때마다 기존 원소를 전부 복사해야 합니다. N개를 넣으면 복사가 1 + 2 + 3 + … + (N-1) ≈ N²/2 번 일어납니다. 100만 개면 약 5천억 번입니다.
2배씩 늘리면 확장은 4, 8, 16, … 칸이 될 때만 일어납니다. 확장할 때 복사하는 원소 수를 다 더해도 4 + 8 + 16 + … + N/2 < N 입니다. 원소 N개를 넣는 데 복사가 N번도 안 되니, 원소 하나당 평균 복사 1번 미만입니다. 가끔 비싼 확장이 있지만 평균을 내면 push 한 번이 일정한 시간에 끝납니다. 이것을 분할 상환(amortized) O(1) 이라고 부릅니다. 100만 개를 넣어도 realloc 은 19번뿐입니다(5절에서 실제로 셉니다).
대가는 메모리입니다. 확장 직후에는 절반이 비어 있습니다. 1,025개를 넣으면 capacity 는 2,048 입니다. 그래서 실무 라이브러리 중에는 2배 대신 1.5배를 쓰는 것도 있습니다. 공간과 시간 사이의 선택입니다.
pop_back 과 get
int vector_pop_back(IntVector *vec, int *out) {
    if (vec->size == 0) {
        return 0;                        /* 비어있으면 실패 */
    }
    vec->size--;
    if (out != NULL) {
        *out = vec->data[vec->size];
    }
    return 1;
}
pop 은 size-- 만 하면 됩니다. 값을 지우지도, 메모리를 돌려주지도 않습니다. 다음 push 가 그 자리를 덮어쓸 것이기 때문입니다. capacity 도 줄이지 않습니다. 곧 다시 push 될 수 있는데, 줄였다 늘렸다를 반복하면 realloc 비용만 듭니다(필요하면 7절 프로젝트의 vec_shrink 처럼 명시적으로 줄입니다).
꺼낸 값은 int *out 으로 돌려주고, 함수의 반환값은 성공 여부(1/0)로 씁니다. 반환값 하나로 “값”과 “실패”를 동시에 알릴 수 없기 때문입니다. 벡터가 비었을 때 -1 을 돌려주는 식으로 만들면, -1 이 들어 있는 벡터와 구분이 안 됩니다. out 이 NULL 이면 값은 버립니다.
vector_get 도 같은 방식이고, 인덱스가 size 이상이면 거부합니다. 일반 배열의 arr[99] 는 범위를 검사하지 않고 아무 메모리나 읽지만(6절의 invalid 실험), 벡터는 함수 안에서 검사할 수 있습니다. 출력의 vec[99] = 범위 초과! 가 그 결과입니다.
3.4 제네릭 벡터로 확장
1절의 void * 를 적용하면 int 전용 벡터가 “모든 타입” 벡터가 됩니다. 추가로 기억할 것은 원소 하나의 크기(elem_size) 하나뿐입니다. examples/vector_generic.c:
typedef struct {
    void  *data;         /* 타입 무관 저장 공간 */
    size_t elem_size;    /* 원소 하나의 크기 (바이트) */
    size_t size;         /* 원소 개수 */
    size_t capacity;     /* 확보된 칸 수 */
} Vector;

/* i번째 원소의 주소 계산: 시작주소 + i * 원소크기 */
static void *vector_at(const Vector *vec, size_t index) {
    return (char *)vec->data + index * vec->elem_size;
}

int vector_push_back(Vector *vec, const void *elem) {
    if (vec->size == vec->capacity) {
        size_t new_cap = (vec->capacity == 0) ? 4 : vec->capacity * 2;
        void *new_data = realloc(vec->data, new_cap * vec->elem_size);
        if (new_data == NULL) return 0;
        vec->data = new_data;
        vec->capacity = new_cap;
    }
    /* 원소를 바이트 단위로 복사해 넣는다 */
    memcpy(vector_at(vec, vec->size), elem, vec->elem_size);
    vec->size++;
    return 1;
}
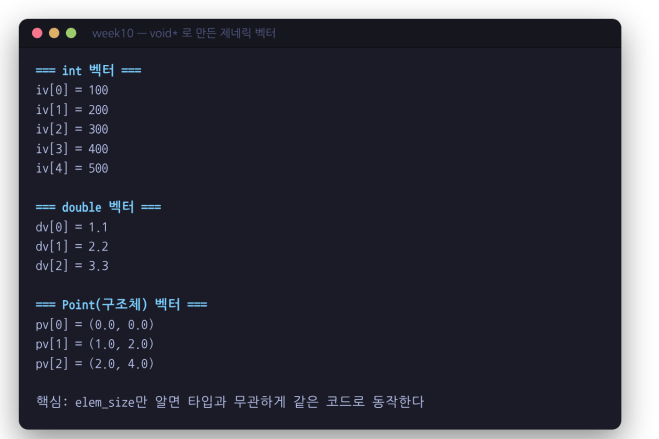
void 로 만든 제네릭 벡터*
바뀐 곳은 세 군데입니다.
vector_at: 1.3절의 정렬 함수에서 본 “시작 주소 + i × 원소 크기”를 함수로 만든 것입니다.(char *)로 바꿔서 바이트 단위로 계산합니다(1.1절).static은 “이 파일 안에서만 쓰는 함수”라는 표시입니다(5주차).realloc크기:sizeof(int)대신vec->elem_size를 곱합니다.- 값 넣기:
vec->data[i] = value처럼 대입할 수 없습니다. 타입을 모르니까요. 대신 원소가 있는 곳의 주소(const void *elem)를 받아서memcpy로 바이트를 복사합니다.
그래서 사용하는 쪽은 값이 아니라 주소를 넘깁니다.
Vector iv;
vector_init(&iv, sizeof(int));           /* "이 벡터의 원소는 4바이트" */

int value = 100;
vector_push_back(&iv, &value);           /* value 의 주소를 넘기면 4바이트가 복사되어 들어간다 */
value 는 복사되어 들어가므로, push 한 뒤에 value 를 바꿔도 벡터 안의 값은 그대로입니다. 구조체도 똑같습니다.
typedef struct { double x, y; } Point;

Vector pv;
vector_init(&pv, sizeof(Point));         /* 원소 16바이트 */

Point p = {1.0, 2.0};
vector_push_back(&pv, &p);               /* 16바이트가 통째로 복사된다 */
int, double, Point 세 벡터가 한 벌의 코드로 동작합니다. 값을 꺼낼 때도 주소를 넘겨서 받습니다.
Point got;
vector_get(&pv, 1, &got);                /* 1번 원소 16바이트를 got 으로 복사 */
printf("(%.1f, %.1f)\n", got.x, got.y);
생각해 보기:
vector_get이 값을 복사해 주는 대신vector_at이 돌려주는 주소를 그대로 쓰면 복사가 없어 더 빠릅니다. 그런데 그 주소를 들고 있는 동안 push 를 하면 어떻게 될까요? 3.2절의 규칙 1이 답입니다. 7절 프로젝트의vec_foreach가 주소를 콜백에 넘기는데, 콜백 안에서 push 를 하면 안 되는 이유이기도 합니다.
4. 연결 리스트 완전 정복
4.1 단일 연결 리스트의 모양
연결 리스트는 배열과 정반대의 철학입니다. 배열이 “한 덩어리의 연속 공간”이라면, 리스트는 “흩어진 노드들을 포인터로 꿴 목걸이” 입니다. 각 노드는 값 하나와, 다음 노드의 주소를 들고 있습니다.
typedef struct Node {
    int data;
    struct Node *next;   /* 다음 노드의 주소. 마지막 노드는 NULL */
} Node;
구조체가 자기 자신과 같은 타입을 가리키는 포인터를 멤버로 갖습니다(자기 참조 구조체, 8주차). typedef 이름 Node 는 선언이 끝나야 생기므로, 안에서는 struct Node * 로 써야 합니다.
리스트 전체는 첫 노드의 주소 하나로 표현합니다. 이 포인터를 흔히 head 라고 부릅니다. head 가 NULL 이면 빈 리스트입니다.
head
 │
 ▼
┌────┬──────┐   ┌────┬──────┐   ┌────┬──────┐
│ 10 │ next─┼──▶│ 20 │ next─┼──▶│ 30 │ NULL │
└────┴──────┘   └────┴──────┘   └────┴──────┘
말로는 쉽지만, 연결 리스트 버그의 대부분은 머릿속 그림과 실제 메모리가 어긋날 때 생깁니다. 그래서 이번에는 그림을 상상으로 그리지 않고, 실제 주소를 찍어서 그려 보겠습니다.
실험: 진짜 주소로 리스트 그리기
sll_trace.c 는 리스트를 만들고 고칠 때마다 모든 노드의 주소, 값, next 를 출력합니다. 주소는 길어서 끝 세 자리만 보이게 했습니다(& 0xfff 는 3주차의 비트 AND 로, 아래 12비트 = 16진수 세 자리만 남깁니다).
#include <stdio.h>
#include <stdlib.h>

typedef struct Node {
    int data;
    struct Node *next;
} Node;

/* 주소의 끝 세 자리만 보여 준다 (그림을 간단히 하려고) */
static unsigned tail3(const void *p) {
    return (unsigned)((unsigned long)p & 0xfff);
}

void dump(const char *title, Node *head) {
    printf("%s\n", title);
    printf("  head = %s", head ? "" : "NULL");
    if (head) printf("...%03x", tail3(head));
    printf("\n");
    for (Node *cur = head; cur != NULL; cur = cur->next) {
        printf("  [...%03x] data=%2d  next=", tail3(cur), cur->data);
        if (cur->next) printf("...%03x\n", tail3(cur->next));
        else           printf("NULL\n");
    }
    printf("\n");
}

Node *node_create(int data) {
    Node *node = malloc(sizeof(Node));
    if (node == NULL) exit(1);
    node->data = data;
    node->next = NULL;
    return node;
}

int main(void) {
    Node *head = NULL;
    dump("① 빈 리스트", head);

    head = node_create(10);
    dump("② 10 하나", head);

    head->next = node_create(20);
    head->next->next = node_create(30);
    dump("③ 10 -> 20 -> 30", head);

    Node *n5 = node_create(5);       /* push_front(5) */
    n5->next = head;
    head = n5;
    dump("④ 맨 앞에 5 삽입", head);

    Node *prev = head->next;         /* insert_at(2, 15): 10 뒤에 */
    Node *n15 = node_create(15);
    n15->next = prev->next;
    prev->next = n15;
    dump("⑤ 10 뒤에 15 삽입", head);

    Node *p = head;                  /* remove_value(20) */
    while (p->next->data != 20) p = p->next;
    Node *victim = p->next;
    p->next = victim->next;
    free(victim);
    dump("⑥ 20 삭제", head);

    while (head) { Node *n = head->next; free(head); head = n; }
    return 0;
}
for (Node *cur = head; cur != NULL; cur = cur->next) 가 리스트를 처음부터 끝까지 걷는 순회의 기본형입니다. 배열의 for (i = 0; i < n; i++) 에 해당합니다. “시작은 head, NULL 에 닿으면 끝, 한 걸음은 cur = cur->next.”
$ gcc -Wall -Wextra -std=c11 -g sll_trace.c -o sll_trace && ./sll_trace
출력을 단계별로 그림과 함께 봅시다.
② 노드 하나
② 10 하나
  head = ...2b0
  [...2b0] data=10  next=NULL
head(...2b0)
 │
 ▼
┌─ ...2b0 ──────┐
│ 10 │ NULL     │
└───────────────┘
node_create 는 malloc 으로 16바이트를 받아 값을 채우고 next 를 NULL 로 둔 뒤 그 주소를 돌려줍니다. head 에 그 주소가 들어갔습니다.
③ 10 → 20 → 30
③ 10 -> 20 -> 30
  head = ...2b0
  [...2b0] data=10  next=...2d0
  [...2d0] data=20  next=...2f0
  [...2f0] data=30  next=NULL
head(...2b0)
 │
 ▼
┌─ ...2b0 ──┐    ┌─ ...2d0 ──┐    ┌─ ...2f0 ──┐
│ 10 │ 2d0 ─┼───▶│ 20 │ 2f0 ─┼───▶│ 30 │ NULL │
└───────────┘    └───────────┘    └───────────┘
화살표의 정체는 숫자입니다. 10 노드의 next 칸에는 ...2d0 이라는 주소 값이 들어 있고, 그 주소에 20 노드가 있습니다. 2.3절에서 본 대로 노드가 32바이트(0x20) 간격으로 놓였습니다.
④ 맨 앞에 5 삽입
④ 맨 앞에 5 삽입
  head = ...310
  [...310] data= 5  next=...2b0
  [...2b0] data=10  next=...2d0
  ...
          새 노드
        ┌─ ...310 ──┐
head ──▶│  5 │ 2b0 ─┼───┐
        └───────────┘   │
                        ▼
                  ┌─ ...2b0 ──┐    ┌─ ...2d0 ──┐    ┌─ ...2f0 ──┐
                  │ 10 │ 2d0 ─┼───▶│ 20 │ 2f0 ─┼───▶│ 30 │ NULL │
                  └───────────┘    └───────────┘    └───────────┘
두 줄이면 끝납니다. 순서가 중요합니다.
n5->next = head;   /* ① 새 노드가 기존 첫 노드(...2b0)를 가리키게 하고 */
head = n5;         /* ② head 를 새 노드(...310)로 바꾼다 */
순서를 바꿔 head = n5; 를 먼저 하면, head 가 들고 있던 ...2b0 을 잃어버린 뒤에 n5->next = head; 가 되어 새 노드가 자기 자신을 가리키게 됩니다. 나머지 세 노드는 아무도 가리키지 않는 누수가 됩니다. 연결을 바꿀 때는 “잃어버리면 안 되는 주소를 먼저 옮겨 두고, 그다음에 덮어쓴다” 가 원칙입니다.
⑤ 10 뒤에 15 삽입
⑤ 10 뒤에 15 삽입
  head = ...310
  [...310] data= 5  next=...2b0
  [...2b0] data=10  next=...330
  [...330] data=15  next=...2d0
  [...2d0] data=20  next=...2f0
  [...2f0] data=30  next=NULL
        ┌─ ...2b0 ──┐                     ┌─ ...2d0 ──┐
        │ 10 │ 330 ─┼──┐             ┌───▶│ 20 │ 2f0 ─┼──▶ ...
        └───────────┘  │             │    └───────────┘
                       ▼             │
                     ┌─ ...330 ──┐   │
                     │ 15 │ 2d0 ─┼───┘
                     └───────────┘
역시 두 줄이고, 순서도 같은 원칙입니다.
n15->next = prev->next;   /* ① 새 노드가 20(...2d0)을 먼저 가리키고 */
prev->next = n15;         /* ② 10 의 next 를 새 노드(...330)로 바꾼다 */
⑥ 20 삭제
⑥ 20 삭제
  head = ...310
  [...310] data= 5  next=...2b0
  [...2b0] data=10  next=...330
  [...330] data=15  next=...2f0
  [...2f0] data=30  next=NULL
┌─ ...330 ──┐     ┌─ ...2d0 ──┐     ┌─ ...2f0 ──┐
│ 15 │ 2f0 ─┼──┐  │ 20 │ 2f0  │  ┌─▶│ 30 │ NULL │
└───────────┘  │  └───────────┘  │  └───────────┘
               │    free() 됨    │
               └─────────────────┘
삭제는 “앞 노드가 지울 노드를 건너뛰게” 만드는 것입니다. 15 의 next 가 20(…2d0) 대신 30(…2f0)을 가리키도록 바꾸고, 그다음에 20 을 free 합니다.
Node *victim = p->next;      /* 지울 노드(...2d0)를 붙잡아 두고 */
p->next = victim->next;      /* 15 의 next 를 30 으로 바꾸고 */
free(victim);                /* 그다음에 해제 */
마지막으로, 메모리 순서를 보세요. 리스트의 순서는 5 → 10 → 15 → 30 인데, 주소 순서는 10(2b0), 30(2f0), 5(310), 15(330) 입니다. 리스트의 논리적 순서와 메모리의 물리적 위치는 아무 상관이 없습니다. 순서를 정하는 것은 오직 next 에 적힌 주소뿐입니다. 이 성질 덕분에 중간 삽입과 삭제가 두 줄로 끝나고, 이 성질 때문에 5절에서 보게 될 성능 문제가 생깁니다.
4.2 push_front 와 이중 포인터
이제 examples/sll_basic.c 의 함수들을 봅시다. 실험에서는 main 안에서 직접 연결을 바꿨지만, 실제로는 함수로 만들어 씁니다. 머리 삽입입니다.
/* 새 노드를 힙에 만들어 반환 */
Node *node_create(int data) {
    Node *node = malloc(sizeof(Node));
    if (node == NULL) {
        return NULL;
    }
    node->data = data;
    node->next = NULL;
    return node;
}

/* 머리에 삽입: O(1)
 * head 자체를 바꿔야 하므로 이중 포인터(Node **)를 받는다 */
int push_front(Node **head, int data) {
    Node *node = node_create(data);
    if (node == NULL) return 0;
    node->next = *head;      /* 새 노드가 기존 첫 노드를 가리키고 */
    *head = node;            /* head는 새 노드를 가리킨다 */
    return 1;
}
왜 Node **head(이중 포인터)일까요? 함수 안에서 호출한 쪽의 head 변수 자체를 바꿔야 하기 때문입니다. 호출은 이렇게 합니다.
Node *list = NULL;
push_front(&list, 5);      /* list 변수의 "주소"를 넘긴다 */
&list 는 “list 라는 포인터 변수가 있는 곳의 주소”입니다. 함수 안의 *head 는 곧 main 의 list 그 자체이므로, *head = node; 는 main 의 list 를 바꿉니다. 6주차의 swap 이 int 를 바꾸려고 int * 를 받았듯이, Node * 를 바꾸려면 Node ** 를 받아야 합니다. 7주차에서 배운 “포인터를 수정하려면 포인터의 포인터” 규칙이 실전에 등장한 것입니다.
실험: head 를 값으로 넘기면?
규칙을 어기면 어떻게 되는지 직접 봅시다. byval.c:
#include <stdio.h>
#include <stdlib.h>

typedef struct Node {
    int data;
    struct Node *next;
} Node;

/* 잘못된 버전: head를 "값으로" 받는다 */
void push_front_wrong(Node *head, int data) {
    Node *node = malloc(sizeof(Node));
    if (node == NULL) return;
    node->data = data;
    node->next = head;
    head = node;                     /* 복사본만 바뀐다! */
    printf("  함수 안: head = %p\n", (void *)head);
}

int main(void) {
    Node *list = NULL;
    push_front_wrong(list, 10);
    push_front_wrong(list, 20);
    printf("함수 밖: list = %p\n", (void *)list);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g byval.c -o byval && ./byval
  함수 안: head = 0x55ec1b58c2a0
  함수 안: head = 0x55ec1b58d2d0
함수 밖: list = (nil)
컴파일러는 경고 하나 없었습니다. 함수 안에서는 head 가 새 노드를 가리켰지만, 함수 밖의 list 는 여전히 (nil)(NULL 을 %p 로 찍은 모양)입니다. head 는 list 의 값을 복사해 받은 지역 변수라서, 아무리 바꿔도 list 에는 닿지 않습니다. 5주차의 “값에 의한 전달” 그대로입니다.
더 나쁜 일도 생겼습니다. 두 노드는 할당됐는데, 그 주소를 들고 있던 head 는 함수가 끝나면서 사라졌습니다. valgrind 가 이것을 잡습니다.
$ valgrind --leak-check=full ./byval
...
==2484992== 16 bytes in 1 blocks are definitely lost in loss record 1 of 2
==2484992==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==2484992==    by 0x109185: push_front_wrong (byval.c:11)
==2484992==    by 0x1091F2: main (byval.c:21)
...
==2484992==    definitely lost: 32 bytes in 2 blocks
“push_front_wrong 의 11번째 줄(malloc)에서 할당한 16바이트를 잃어버렸다. 그 함수는 main 의 21번째 줄에서 불렸다.” 두 번 불렀으니 2블록 32바이트입니다. 증상은 “리스트가 계속 비어 있다”인데, 원인은 매개변수 타입 하나입니다.
다른 해결책: 이중 포인터가 헷갈리면, 새 머리를 반환값으로 돌려주는 방법도 있습니다.
Node *push_front(Node *head, int data)로 만들고list = push_front(list, 5);로 부르는 것입니다.examples/sll_reverse.c가 이 방식을 씁니다. 대신 호출할 때마다list =를 잊지 말아야 합니다. 4.7절의 이중 연결 리스트는 세 번째 방법, “리스트 관리 구조체의 주소를 넘기는” 방식을 씁니다.
4.3 꼬리 삽입, 중간 삽입, 삭제
꼬리 삽입은 끝까지 걸어가야 합니다.
/* 꼬리에 삽입: O(n) - 끝까지 걸어가야 한다 */
int push_back(Node **head, int data) {
    Node *node = node_create(data);
    if (node == NULL) return 0;

    if (*head == NULL) {     /* 빈 리스트면 새 노드가 곧 머리 */
        *head = node;
        return 1;
    }

    Node *cur = *head;
    while (cur->next != NULL) {
        cur = cur->next;     /* 마지막 노드까지 이동 */
    }
    cur->next = node;
    return 1;
}
- 빈 리스트는 따로 처리합니다. 이때는 “마지막 노드”가 없으니
head자체를 바꿔야 합니다. 그래서push_back도Node **를 받습니다. - 순회 조건이
cur != NULL이 아니라cur->next != NULL입니다. 마지막 노드 위에서 멈춰야 그next를 바꿀 수 있기 때문입니다.cur != NULL로 쓰면 마지막 노드를 지나NULL에서 멈추고, 그러면 붙일 곳이 없습니다. - 노드가 N개면 N번 걸어야 하니 O(n) 입니다. 꼬리 삽입이 잦다면 4.7절처럼
tail포인터를 따로 들고 다닙니다.
중간 삽입은 “pos 번째 자리”에 넣습니다.
/* pos번째 위치에 삽입 (0이면 머리) */
int insert_at(Node **head, size_t pos, int data) {
    if (pos == 0) {
        return push_front(head, data);
    }

    Node *cur = *head;
    /* pos-1번째 노드까지 이동 */
    for (size_t i = 0; i + 1 < pos && cur != NULL; i++) {
        cur = cur->next;
    }
    if (cur == NULL) return 0;           /* 범위 초과 */

    Node *node = node_create(data);
    if (node == NULL) return 0;
    node->next = cur->next;
    cur->next = node;
    return 1;
}
2번 자리에 넣으려면 1번 노드(바로 앞 노드) 에서 멈춰야 합니다. 단일 연결 리스트는 뒤로만 갈 수 있어서, “앞 노드”를 알아야 그 next 를 바꿀 수 있기 때문입니다. i + 1 < pos 조건이 pos-1 번 이동하게 합니다. 마지막 두 줄은 실험 ⑤ 와 똑같습니다. 리스트가 pos 보다 짧으면 cur 가 NULL 이 되어 실패를 돌려줍니다.
값으로 삭제는 지울 노드와 그 앞 노드를 함께 찾습니다.
/* 값으로 첫 노드 삭제. 찾아서 지우면 1, 없으면 0 */
int remove_value(Node **head, int data) {
    Node *cur = *head;
    Node *prev = NULL;

    while (cur != NULL && cur->data != data) {
        prev = cur;
        cur = cur->next;
    }
    if (cur == NULL) return 0;           /* 못 찾음 */

    if (prev == NULL) {
        *head = cur->next;               /* 첫 노드 삭제 */
    } else {
        prev->next = cur->next;          /* 이전 노드가 다음을 건너뛰게 */
    }
    free(cur);
    return 1;
}
prev 와 cur 두 포인터가 한 칸 간격으로 함께 걷습니다. cur 가 지울 노드를 찾았을 때 prev 는 그 바로 앞에 있습니다. 경우는 셋입니다.
| 상황 | prev |
cur |
처리 |
|---|---|---|---|
| 못 찾음 | 마지막 노드 | NULL |
0 을 돌려줌 |
| 첫 노드를 지움 | NULL (앞 노드가 없음) |
첫 노드 | head 를 바꿈 |
| 중간·끝 노드를 지움 | 앞 노드 | 지울 노드 | prev->next 를 바꿈 |
while 조건의 순서 cur != NULL && cur->data != data 도 중요합니다. && 는 왼쪽이 거짓이면 오른쪽을 보지 않습니다(3주차의 단락 평가). 그래서 cur 가 NULL 일 때 cur->data 를 읽는 사고가 나지 않습니다. 순서를 바꾸면 끝까지 못 찾았을 때 NULL->data 를 읽어 프로그램이 죽습니다.
탐색과 길이는 순회 기본형 그대로입니다.
Node *find(Node *head, int data) {
    for (Node *cur = head; cur != NULL; cur = cur->next) {
        if (cur->data == data) return cur;
    }
    return NULL;
}
이 함수들은 head 를 바꾸지 않으므로 Node * 로 받습니다. 바꾸는 함수는 Node **, 읽기만 하는 함수는 Node *. 매개변수 타입만 봐도 함수가 리스트를 바꾸는지 알 수 있습니다.
4.4 전체 해제 — 순서 하나로 프로그램이 죽는다
이번 주에서 가장 중요한 코드일지도 모릅니다.
/* 전체 해제: next를 먼저 백업하고 free 해야 한다! */
void list_free(Node **head) {
    Node *cur = *head;
    while (cur != NULL) {
        Node *next = cur->next;          /* free 전에 다음 주소 백업 */
        free(cur);
        cur = next;
    }
    *head = NULL;
}
free(cur) 를 하면 그 노드의 메모리는 더 이상 우리 것이 아닙니다. 그러니 다음 노드의 주소를 먼저 꺼내 두고 해제해야 합니다. 마지막의 *head = NULL; 은 호출한 쪽의 list 를 빈 리스트로 만들어, 해제된 노드를 가리키는 댕글링 포인터가 남지 않게 합니다.
실험: 순서를 바꾸면?
free 하고 나서 next 를 읽으면 어떻게 될까요? free_wrong.c:
#include <stdio.h>
#include <stdlib.h>

typedef struct Node {
    int data;
    struct Node *next;
} Node;

void list_free_wrong(Node *head) {
    Node *cur = head;
    while (cur != NULL) {
        free(cur);
        cur = cur->next;             /* 방금 해제한 노드를 읽는다! */
    }
}

int main(void) {
    Node *head = NULL;
    for (int i = 3; i >= 1; i--) {
        Node *n = malloc(sizeof(Node));
        if (n == NULL) return 1;
        n->data = i * 10;
        n->next = head;
        head = n;
    }
    list_free_wrong(head);
    printf("해제 끝\n");
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g free_wrong.c -o free_wrong
free_wrong.c: In function ‘list_free_wrong’:
free_wrong.c:13:13: warning: pointer ‘cur’ used after ‘free’ [-Wuse-after-free]
   13 |         cur = cur->next;             /* 방금 해제한 노드를 읽는다! */
      |         ~~~~^~~~~~~~~~~
free_wrong.c:12:9: note: call to ‘free’ here
   12 |         free(cur);
      |         ^~~~~~~~~
$ ./free_wrong
세그멘테이션 오류 (코어 덤프됨)
$ echo $?
139
먼저 GCC가 컴파일할 때 경고했습니다. “cur 를 free 한 뒤에 썼다.” 최신 GCC는 이런 실수를 코드만 보고도 잡아냅니다. 경고를 무시하고 실행하면 세그멘테이션 오류로 죽습니다. 종료 코드 139 는 128 + 11, “11번 신호(SIGSEGV, 잘못된 메모리 접근)로 죽었다”는 뜻입니다(신호는 18주차).
그런데 이상하지 않나요? free 는 “이 메모리를 돌려준다”는 약속일 뿐, 내용을 지우지는 않는다고 배웠습니다. 방금 해제한 노드의 next 에는 아직 다음 주소가 남아 있어야 하지 않을까요? valgrind 가 힌트를 줍니다.
$ valgrind ./free_wrong
==2485983== Invalid read of size 8
==2485983==    at 0x1091B3: list_free_wrong (free_wrong.c:13)
==2485983==    by 0x10923C: main (free_wrong.c:26)
==2485983==  Address 0x4aac0e8 is 8 bytes inside a block of size 16 free'd
==2485983==    at 0x484988F: free (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==2485983==    by 0x1091AE: list_free_wrong (free_wrong.c:12)
==2485983==    by 0x10923C: main (free_wrong.c:26)
==2485983==  Block was alloc'd at
==2485983==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==2485983==    by 0x1091EC: main (free_wrong.c:20)
한 줄씩 읽어 봅시다.
Invalid read of size 8: 8바이트를 잘못 읽었다. 포인터 하나의 크기입니다.at ... list_free_wrong (free_wrong.c:13): 13번째 줄cur = cur->next;에서.Address ... is 8 bytes inside a block of size 16 free'd: 읽은 곳은 16바이트 블록의 8바이트 지점이고, 그 블록은 이미 해제됐다. 16바이트 블록은Node, 오프셋 8은 2.3절 그림에서 본next의 자리입니다.- 그 아래 두 덩어리는 그 블록을 누가 해제했고(12번째 줄
free) 누가 할당했는지(20번째 줄malloc) 입니다.
valgrind 아래에서는 죽지 않았는데, 그냥 실행하면 죽는 이유는 이렇습니다. glibc 의 free 는 돌려받은 블록 안에 자기 관리 정보(다음에 재사용할 빈 블록 목록 등)를 써 넣습니다. 우리 노드의 next 자리가 그 정보로 덮여 버려서, cur = cur->next 가 엉뚱한 주소를 얻고 거기서 죽은 것입니다. valgrind 는 자기만의 할당기를 쓰기 때문에 겉으로는 멀쩡해 보였을 뿐입니다. 해제된 메모리는 무엇이 들어 있을지 아무도 약속하지 않습니다. “지금은 돌아간다”는 사실이 “맞는 코드”라는 뜻이 아닙니다.
4.5 sll_basic 실행과 valgrind 확인
$ ./build/sll_basic
=== 삽입 ===
HEAD -> [10] -> [20] -> [30] -> NULL
HEAD -> [5] -> [10] -> [20] -> [30] -> NULL
HEAD -> [5] -> [10] -> [15] -> [20] -> [30] -> NULL
길이: 5

=== 탐색 ===
20 탐색: 발견
99 탐색: 없음

=== 삭제 ===
HEAD -> [10] -> [15] -> [20] -> [30] -> NULL
HEAD -> [10] -> [15] -> [30] -> NULL
HEAD -> [10] -> [15] -> [30] -> NULL

=== 전체 해제 ===
HEAD -> NULL
삭제의 세 줄은 각각 머리(5) 삭제, 중간(20) 삭제, 없는 값(99) 삭제입니다. 없는 값을 지우려 할 때 리스트가 그대로인 것까지 확인했습니다. 이제 valgrind 로 누수가 없는지 봅시다.
$ valgrind --leak-check=full ./build/sll_basic
...
==2498232== HEAP SUMMARY:
==2498232==     in use at exit: 0 bytes in 0 blocks
==2498232==   total heap usage: 6 allocs, 6 frees, 4,176 bytes allocated
==2498232==
==2498232== All heap blocks were freed -- no leaks are possible
...
==2498232== ERROR SUMMARY: 0 errors from 0 contexts (suppressed: 0 from 0)
All heap blocks were freed -- no leaks are possible, “모든 힙 블록이 해제됐다. 누수 가능성 없음.” 이번 주 내내 보고 싶은 문장입니다.
숫자도 맞춰 봅시다. 노드는 10, 20, 30, 5, 15 다섯 개를 만들었는데 할당은 6번입니다. 나머지 하나는 무엇일까요? total heap usage 가 4,176 바이트입니다. 노드 5개 × 16 = 80, 4,176 − 80 = 4,096. printf 가 처음 불릴 때 출력을 모아 둘 버퍼 4KB 를 할당하기 때문입니다(9주차의 버퍼링). 이 버퍼는 프로그램이 끝날 때 C 라이브러리가 알아서 해제합니다. 이렇게 숫자를 하나하나 맞춰 보면 valgrind 보고서가 더 이상 암호로 보이지 않습니다.
4.6 뒤집기와 러너 테크닉
examples/sll_reverse.c 는 면접 단골 문제이자 포인터 조작 연습의 정수입니다. 이 파일은 4.2절 끝에서 말한 대로 새 머리를 반환값으로 돌려주는 방식을 씁니다.
리스트 뒤집기
Node *list_reverse(Node *head) {
    Node *prev = NULL;
    Node *cur = head;

    while (cur != NULL) {
        Node *next = cur->next;          /* 1. 다음 노드 백업 */
        cur->next = prev;                /* 2. 화살표 방향 반전 */
        prev = cur;                      /* 3. prev 전진 */
        cur = next;                      /* 4. cur 전진 */
    }
    return prev;                         /* prev가 새 머리 */
}
새 노드를 만들지 않고, 화살표(next) 방향만 하나씩 거꾸로 돌립니다. 세 포인터가 하는 일은 이렇습니다.
| 포인터 | 역할 |
|---|---|
prev |
이미 뒤집은 부분의 머리. 처음에는 NULL |
cur |
지금 뒤집을 노드 |
next |
아직 안 뒤집은 부분의 머리. cur->next 를 바꾸면 잃어버리므로 먼저 백업 |
4.4절의 해제와 같은 원칙입니다. cur->next 를 덮어쓰기 전에 그 값을 next 에 옮겨 둡니다. 말로는 헷갈리니 추적 프로그램(reverse_trace.c)으로 1 → 2 → 3 을 뒤집으며 매 단계를 찍어 봤습니다.
$ ./reverse_trace
시작      : prev=NULL cur=[1]
단계 1    : next=[2]   [1]->next 를 NULL 로 돌림
  전진 후 : prev=[1]  cur=[2]
단계 2    : next=[3]   [2]->next 를 [1] 로 돌림
  전진 후 : prev=[2]  cur=[3]
단계 3    : next=NULL  [3]->next 를 [2] 로 돌림
  전진 후 : prev=[3]  cur=NULL
결과      : 3 -> 2 -> 1 -> NULL
그림으로 그리면 이렇습니다.
시작:     prev=NULL   cur
                       ▼
                      [1] ──▶ [2] ──▶ [3] ──▶ NULL

단계 1:   NULL ◀── [1]      [2] ──▶ [3] ──▶ NULL
                    ▲        ▲
                   prev     cur          (1 의 화살표를 NULL 쪽으로)

단계 2:   NULL ◀── [1] ◀── [2]      [3] ──▶ NULL
                            ▲        ▲
                           prev     cur  (2 의 화살표를 1 쪽으로)

단계 3:   NULL ◀── [1] ◀── [2] ◀── [3]      NULL
                                    ▲        ▲
                                   prev     cur (끝)

→ prev 가 가리키는 [3] 이 새 머리
반복이 끝나면 cur 는 NULL, prev 는 원래의 마지막 노드이자 새 머리입니다. 노드를 한 번씩만 방문하니 O(n) 시간, 추가 메모리는 포인터 세 개뿐이니 O(1) 공간입니다. 종이에 노드 세 개를 그려 놓고 직접 따라가 보세요. 머리로만 이해하려 하면 헷갈리지만, 그림으로 따라가면 명쾌합니다.
중간 노드 찾기: 빠른 포인터와 느린 포인터
길이를 모르는 리스트의 가운데를 찾고 싶습니다. 한 번 세고, 다시 절반만큼 걸으면 두 번 순회해야 합니다. 한 번의 순회로 할 수 있을까요?
Node *find_middle(Node *head) {
    Node *slow = head;
    Node *fast = head;

    while (fast != NULL && fast->next != NULL) {
        slow = slow->next;               /* 1칸 */
        fast = fast->next->next;         /* 2칸 */
    }
    return slow;
}
두 사람이 같은 곳에서 출발해 한 명은 한 칸씩, 한 명은 두 칸씩 걷는다고 생각해 보세요. 빠른 사람이 끝에 닿는 순간, 느린 사람은 정확히 절반만큼 와 있습니다. 이것을 러너(runner) 기법 또는 토끼와 거북이 기법이라고 부릅니다.
노드 5개:  [1] [2] [3] [4] [5]
시작       s,f
1회            s   f
2회                s       f          f->next 가 NULL → 멈춤. slow = [3]

노드 6개:  [1] [2] [3] [4] [5] [6]
시작       s,f
1회            s   f
2회                s       f
3회                    s           f  (f = NULL) → 멈춤. slow = [4]
반복 조건 fast != NULL && fast->next != NULL 은 두 칸을 안전하게 뛸 수 있는지 확인합니다. fast->next->next 를 하려면 fast 와 fast->next 가 둘 다 NULL 이 아니어야 하니까요. 노드가 짝수 개면 가운데가 둘인데, 이 코드는 뒤쪽 가운데를 돌려줍니다.
뒤에서 n번째 노드
같은 발상의 응용입니다. 두 포인터를 n칸 벌려 놓고 함께 걸으면, 앞의 포인터가 끝에 닿을 때 뒤의 포인터는 끝에서 n번째에 있습니다.
Node *find_nth_from_end(Node *head, int n) {
    Node *lead = head;
    Node *trail = head;

    for (int i = 0; i < n; i++) {
        if (lead == NULL) return NULL;   /* 리스트가 n보다 짧음 */
        lead = lead->next;
    }
    while (lead != NULL) {
        lead = lead->next;
        trail = trail->next;
    }
    return trail;
}
실행 결과
$ ./build/sll_reverse
원본    : 1 -> 2 -> 3 -> 4 -> 5 -> NULL

=== 뒤집기 ===
뒤집기 1: 5 -> 4 -> 3 -> 2 -> 1 -> NULL
뒤집기 2: 1 -> 2 -> 3 -> 4 -> 5 -> NULL

=== 중간 노드 (runner technique) ===
5개 중 중간: 3
6개 중 중간: 3

=== 뒤에서 n번째 ===
뒤에서 1번째: 5
뒤에서 2번째: 4
뒤에서 3번째: 3
“6개 중 중간: 3” 이 위의 그림([4])과 다른 이유가 궁금하다면 코드를 다시 보세요. 6개짜리 리스트는 0 1 2 3 4 5 입니다(맨 앞에 0을 끼워 넣었습니다). 뒤쪽 가운데는 네 번째 노드, 값은 3입니다. 그림의 값과 리스트의 값을 헷갈리지 않는 것도 연습입니다.
4.7 이중 연결 리스트
노드가 앞(prev)과 뒤(next)를 모두 가리키면 이중 연결 리스트입니다.
typedef struct DNode {
    int data;
    struct DNode *prev;  /* 이전 노드 */
    struct DNode *next;  /* 다음 노드 */
} DNode;

/* 리스트 전체를 관리하는 구조체: 머리/꼬리를 함께 유지 */
typedef struct {
    DNode *head;
    DNode *tail;
    size_t size;
} DList;
list.head                                                list.tail
   │                                                        │
   ▼                                                        ▼
┌──────┬────┬──────┐     ┌──────┬────┬──────┐     ┌──────┬────┬──────┐
│ NULL │  5 │ next─┼────▶│      │ 10 │ next─┼────▶│      │ 20 │ NULL │
│      │    │      │◀────┼─prev │    │      │◀────┼─prev │    │      │
└──────┴────┴──────┘     └──────┴────┴──────┘     └──────┴────┴──────┘
DList 는 3절 벡터의 IntVector 와 같은 발상, “작은 관리 구조체”입니다. head, tail, size 를 한데 묶어 두면 함수에는 DList * 하나만 넘기면 됩니다. head 를 바꿔야 할 때도 list->head = ... 로 바꾸면 되니 이중 포인터가 필요 없습니다. 4.2절에서 말한 세 번째 방법입니다.
무엇이 좋아질까요?
- 양방향 순회:
tail에서prev를 따라 거꾸로 걸을 수 있습니다. - O(1) 꼬리 삽입:
tail을 들고 있으니 끝까지 걸어갈 필요가 없습니다. - O(1) 삭제: 노드 주소만 알면 앞 노드를 찾지 않고도 지울 수 있습니다. 앞 노드가
node->prev에 있으니까요. 단일 리스트는 앞 노드를 찾으러 처음부터 걸어야 했습니다.
대가도 분명합니다. 노드가 24바이트로 커지고(int 4 + 패딩 4 + 포인터 8 × 2), 삽입과 삭제 때 갱신할 포인터가 두 배로 늘어납니다.
꼬리 삽입
/* 꼬리 삽입: tail 포인터 덕분에 O(1)! */
int dlist_push_back(DList *list, int data) {
    DNode *node = dnode_create(data);
    if (node == NULL) return 0;

    if (list->tail == NULL) {            /* 빈 리스트 */
        list->head = list->tail = node;
    } else {
        node->prev = list->tail;         /* 새 노드의 앞 = 기존 꼬리 */
        list->tail->next = node;         /* 기존 꼬리의 뒤 = 새 노드 */
        list->tail = node;               /* 꼬리 갱신 */
    }
    list->size++;
    return 1;
}
빈 리스트일 때는 새 노드가 머리이자 꼬리입니다. list->head = list->tail = node; 는 오른쪽부터 대입되어 둘 다 node 가 됩니다. 그 외에는 세 연결을 바꿉니다.
전:  ... ◀──▶ [20]        tail ─▶ [20]
                          [30] (새 노드, prev=NULL next=NULL)

① node->prev = list->tail;       [20] ◀── [30]
② list->tail->next = node;       [20] ──▶ [30]
③ list->tail = node;             tail ─▶ [30]

후:  ... ◀──▶ [20] ◀──▶ [30]      tail ─▶ [30]
①과 ②는 순서를 바꿔도 되지만, ③은 반드시 마지막이어야 합니다. ③을 먼저 하면 ②의 list->tail->next 가 새 노드 자신의 next 가 되어 버립니다. 역시 “잃어버리면 안 되는 주소를 먼저 쓰고, 그다음에 덮어쓴다”입니다.
삭제: 경계 조건 네 가지
void dlist_remove(DList *list, DNode *node) {
    if (node->prev != NULL) {
        node->prev->next = node->next;
    } else {
        list->head = node->next;         /* 첫 노드였다면 head 갱신 */
    }

    if (node->next != NULL) {
        node->next->prev = node->prev;
    } else {
        list->tail = node->prev;         /* 마지막 노드였다면 tail 갱신 */
    }

    free(node);
    list->size--;
}
if/else 두 쌍이 네 가지 상황을 전부 처리합니다. 하나씩 대입해 보면 이렇습니다.
| 지우는 노드 | node->prev |
node->next |
앞쪽 처리 | 뒤쪽 처리 |
|---|---|---|---|---|
| 중간 노드 | 있음 | 있음 | 앞 노드의 next = 뒤 노드 |
뒤 노드의 prev = 앞 노드 |
| 첫 노드 | NULL |
있음 | head = 뒤 노드 |
뒤 노드의 prev = NULL |
| 끝 노드 | 있음 | NULL |
앞 노드의 next = NULL |
tail = 앞 노드 |
| 유일한 노드 | NULL |
NULL |
head = NULL |
tail = NULL |
마지막 줄을 보세요. 노드가 하나뿐일 때 지우면 head 와 tail 이 둘 다 NULL 이 되어 빈 리스트로 정확히 돌아갑니다. 리스트 버그의 대부분은 이 경계에서 나옵니다. 리스트 함수를 만들면 빈 리스트, 노드 1개, 첫 노드, 끝 노드를 반드시 따로 시험해 보세요.
$ ./build/dll_basic
=== 삽입 (push_back은 tail 덕분에 O(1)) ===
정방향: NULL <-> [5] <-> [10] <-> [20] <-> [30] <-> [40] <-> [50] <-> NULL  (size=6)
역방향: NULL <-> [50] <-> [40] <-> [30] <-> [20] <-> [10] <-> [5] <-> NULL

=== O(1) 삭제 ===
30 삭제 완료
정방향: NULL <-> [5] <-> [10] <-> [20] <-> [40] <-> [50] <-> NULL  (size=5)
머리/꼬리 삭제 후:
정방향: NULL <-> [10] <-> [20] <-> [40] <-> NULL  (size=3)
역방향: NULL <-> [40] <-> [20] <-> [10] <-> NULL

전체 해제 완료
정방향과 역방향이 정확히 거꾸로 나오는지가 이중 리스트 검사의 핵심입니다. next 연결만 맞고 prev 연결이 하나라도 틀리면 역방향 출력에서 드러납니다. 중간 삭제(30), 첫 노드 삭제(5), 끝 노드 삭제(50)까지 확인했습니다.
직접 해 보기:
dll_basic.c의main끝에 남은 세 노드를dlist_remove(&list, list.head);로 하나씩 지우고 매번dlist_print_forward와dlist_print_backward를 불러 보세요. 마지막 하나를 지울 때 표의 “유일한 노드” 줄이 실행됩니다. 둘 다NULL <-> NULL (size=0)처럼 나오면 성공입니다.
4.8 원형 연결 리스트
마지막 노드의 next 가 NULL 대신 첫 노드를 가리키면 원형 리스트입니다. “차례가 계속 돌아가는” 상황에 잘 맞습니다. 라운드 로빈 스케줄링(운영체제가 프로그램들에 CPU 시간을 돌아가며 나눠 주는 방식), 멀티플레이어 게임의 턴, 음악 반복 재생 같은 것들입니다.
examples/cll_basic.c 에는 재미있는 요령이 하나 있습니다. head 대신 tail 만 기억합니다. 원형이니 tail->next 가 곧 head 이기 때문입니다.
        tail
         │
         ▼
[1] ──▶ [2] ──▶ [3]
 ▲               │
 └───────────────┘   tail->next == head == [1]
tail 하나로 머리와 꼬리를 모두 O(1) 로 얻을 수 있어서, 포인터 하나로 이중 리스트의 장점 일부를 누리는 셈입니다.
/* 원형 리스트에 노드 추가 (tail 뒤에 삽입, tail 반환) */
CNode *cll_append(CNode *tail, int data) {
    CNode *node = malloc(sizeof(CNode));
    if (node == NULL) exit(1);
    node->data = data;

    if (tail == NULL) {
        node->next = node;               /* 혼자서 자신을 가리키는 원 */
        return node;
    }
    node->next = tail->next;             /* 새 노드 -> head */
    tail->next = node;                   /* 기존 tail -> 새 노드 */
    return node;                         /* 새 노드가 새 tail */
}
노드가 하나뿐일 때는 자기 자신을 가리킵니다. 원형 리스트에는 NULL 이 없다는 규칙을 지키기 위해서입니다.
원형 리스트에서 주의할 두 가지
- 순회 종료 조건이 다릅니다.
NULL이 없으니cur != NULL로 순회하면 영원히 돕니다. “시작점으로 돌아왔는가”로 판단해야 합니다. 이때while (cur != head)로 쓰면 첫 노드에서 바로 멈춰 버리므로, 일단 한 번 실행하고 조건을 보는do-while(3주차)이 자연스럽습니다.
CNode *head = tail->next;
CNode *cur = head;
do {
    printf("[%d] -> ", cur->data);
    cur = cur->next;
} while (cur != head);
- 해제 전에 고리를 끊으세요.
tail->next = NULL;로 원을 끊으면 평범한 단일 리스트가 되어, 4.4절의 해제 코드를 그대로 쓸 수 있습니다.
void cll_free(CNode *tail) {
    if (tail == NULL) return;
    CNode *head = tail->next;
    CNode *cur = head;

    /* 원형 고리를 먼저 끊고 지우면 실수할 일이 없다 */
    tail->next = NULL;
    while (cur != NULL) {
        CNode *next = cur->next;
        free(cur);
        cur = next;
    }
}
요세푸스 문제
cll_basic.c 는 고전 문제인 요세푸스 문제를 풉니다. n명이 원으로 앉아 있고, k번째 사람이 계속 빠져나갈 때 마지막에 남는 사람은 누구일까요? 원형 리스트로 “원으로 앉은 사람들”을 그대로 만들고, k-1 칸 걸은 뒤 노드를 하나 빼기를 반복합니다.
CNode *prev = tail;
CNode *cur = tail->next;             /* head */

while (cur->next != cur) {           /* 한 명 남을 때까지 */
    for (int i = 1; i < k; i++) {    /* k-1번 전진하면 cur가 k번째 사람 */
        prev = cur;
        cur = cur->next;
    }
    printf("제외: %d\n", cur->data);
    prev->next = cur->next;          /* 원에서 빼기 */
    free(cur);
    cur = prev->next;                /* 다음 사람부터 다시 세기 */
}
while (cur->next != cur) 는 “내 다음이 나 자신이 아닌 동안”, 즉 두 명 이상 남아 있는 동안입니다. 한 명 남으면 그 노드는 자기 자신을 가리키니까요.
$ ./build/cll_basic
=== 라운드 로빈: 3명이 턴을 주고받기 ===
턴 1: 플레이어 1
턴 2: 플레이어 2
턴 3: 플레이어 3
턴 4: 플레이어 1
턴 5: 플레이어 2
턴 6: 플레이어 3
턴 7: 플레이어 1

=== 요세푸스 문제 (n=7, k=3) ===
시작: [1] -> [2] -> [3] -> [4] -> [5] -> [6] -> [7] -> (다시 [1]로...)
제외: 3
제외: 6
제외: 2
제외: 7
제외: 5
제외: 1
생존자: 4
라운드 로빈에서 턴 4가 다시 플레이어 1인 것을 보세요. cur = cur->next 만 반복했을 뿐인데, NULL 걱정 없이 계속 돕니다.
요세푸스를 손으로 따라가 보면 이렇습니다. 1부터 세어 3번째인 3이 빠지고, 4부터 세어 6이 빠지고, 7부터 세어 원을 한 바퀴 돌아 2가 빠지고… 출력과 맞춰 보세요. 원형 리스트가 “원을 한 바퀴 돌아 다시 세기”를 코드 없이 자연스럽게 처리해 줍니다.
5. 배열 vs 리스트: 성능의 진실
교과서는 이렇게 말합니다. “삽입과 삭제는 리스트가 O(1)로 빠르고, 임의 접근은 배열이 O(1)로 빠르다.” 맞는 말입니다. 하지만 현대 CPU에서는 절반의 진실입니다. 네 번째 질문에 답하려면 직접 재 봐야 합니다.
5.1 측정하기
examples/perf_compare.c 는 원소 100만 개로 세 가지 작업을 해서 시간을 잽니다.
| 측정 | 동적 배열 | 연결 리스트 |
|---|---|---|
| 생성 | 뒤에 100만 번 추가 (2배 확장) | 머리에 100만 번 삽입 (malloc 100만 번) |
| 순회 | 전체 합 구하기 | 전체 합 구하기 |
| 임의 접근 | 1,000곳의 값 읽기 (arr[idx]) |
1,000곳의 값 읽기 (매번 머리부터 걷기) |
시간은 <time.h> 의 clock() 으로 잽니다. clock() 은 프로그램이 지금까지 쓴 CPU 시간을 “틱” 단위로 돌려주고, 두 시점의 차이를 CLOCKS_PER_SEC 으로 나누면 초가 됩니다.
static double elapsed_ms(clock_t start, clock_t end) {
    return (double)(end - start) * 1000.0 / CLOCKS_PER_SEC;
}
성능을 잴 때는 최적화를 켜야 실제 프로그램과 비슷한 결과가 나옵니다(1주차 5절의 -O2). Makefile 에 perf_compare 만 따로 -O2 로 만드는 규칙이 있습니다.
$ make perf_compare
gcc -Wall -Wextra -std=c11 -g -O2 examples/perf_compare.c -o build/perf_compare
$ ./build/perf_compare
원소 1000000개로 비교합니다...

=== 생성 (1000000개 추가) ===
동적 배열  :     1.93 ms  (realloc 19번)
연결 리스트:    26.38 ms  (malloc 1000000번)

=== 순회 (전체 합계) ===
동적 배열  :     0.30 ms  (합=499999500000)
연결 리스트:     1.91 ms  (합=499999500000)

=== 임의 접근 (1000회) ===
동적 배열  :     0.01 ms  (O(1) 인덱싱, 합=498001500)
연결 리스트:   626.94 ms  (매번 O(n) 순회, 합=501997500)
...

캐시가 만드는 성능 차이
그림은
make perf_compare로-O2빌드를 다시 돌린 결과입니다. 벤치마크라서 본문 표와 수치가 조금 다릅니다. 배속과 순서가 같은지를 보세요 — 절대값이 아니라 그게 이 측정이 말하려는 것입니다.그냥
make로 빌드한build/perf_compare는-O2없이 컴파일됩니다.make perf_compare를 따로 해야 최적화 버전이 됩니다. 두 버전의 숫자를 비교해 보는 것도 좋은 실험입니다.
같은 명령을 세 번 돌린 결과입니다. 매번 조금씩 다르지만 경향은 같습니다.
| 측정 | 동적 배열 | 연결 리스트 | 배율 |
|---|---|---|---|
| 생성 | 1.93 ~ 2.20 ms | 22.99 ~ 26.38 ms | 약 12배 |
| 순회 | 0.27 ~ 0.30 ms | 1.72 ~ 1.93 ms | 약 6배 |
| 임의 접근 | 0.01 ms | 587 ~ 628 ms | 약 6만 배 |
한 줄씩 해석해 봅시다.
생성: 배열은 realloc 19번이면 끝납니다(4칸에서 2배씩 늘려 1,048,576칸이 될 때까지: 4, 8, …, 2²⁰ 로 19번). 리스트는 malloc 을 100만 번 부릅니다. malloc 은 빈 공간을 찾고 관리 정보를 적는 일을 하므로 한 번 한 번이 공짜가 아닙니다. 3.3절의 분할 상환 O(1) 이 실제로 이득이라는 것이 보입니다.
임의 접근: 배열은 arr[idx] 가 “시작 주소 + idx × 4” 계산 한 번이라 1,000번 해도 0.01ms 입니다. 리스트는 idx 번째에 가려면 머리부터 idx 번 걸어야 해서, 평균 50만 걸음 × 1,000번 = 약 5억 걸음입니다. 여기서 두 합계(498001500 과 501997500)가 다른 것이 눈에 띌 텐데, 리스트를 머리 삽입으로 만들어서 순서가 거꾸로이기 때문입니다. 배열의 idx 번째는 값 idx 이고, 리스트의 idx 번째는 값 999999−idx 입니다.
순회: 둘 다 O(n) 인데 리스트가 6배 느립니다. 이론으로는 설명이 안 되는 부분입니다. 이것이 이 절의 주제입니다.
여담: 이 측정은 한때 0.00 ms 가 나왔다
이 예제를 처음 만들었을 때, 임의 접근을 이렇게 쟀습니다.
long long pick1 = 0;
for (int i = 0; i < 1000; i++) {
    size_t idx = (size_t)(i * 997) % size;
    pick1 += arr[idx];
}
/* ... 리스트도 같은 방식으로 pick2 에 더함 ... */
(void)pick1; (void)pick2;            /* 최적화로 계산이 사라지지 않게 사용 */
그리고 -O2 로 돌렸더니 이런 결과가 나왔습니다.
=== 임의 접근 (1000회) ===
동적 배열  :     0.00 ms  (O(1) 인덱싱)
연결 리스트:     0.00 ms  (매번 O(n) 순회)
5억 걸음이 0.00ms 에 끝날 리가 없습니다. 원인은 최적화였습니다. 컴파일러는 pick1 과 pick2 가 계산만 되고 어디에도 쓰이지 않는다는 것을 알아채고, 반복문을 통째로 지워 버렸습니다. 결과에 영향이 없는 계산은 할 필요가 없으니까요. 주석은 (void)pick1; 이 그걸 막는다고 믿었지만, (void) 는 “안 쓰는 변수라는 경고를 끄는” 표시일 뿐 컴파일러에게 계산을 강제하지 못합니다.
해결책은 결과를 정말로 쓰는 것입니다. 지금 코드는 합계를 출력합니다. 출력해야 하니 컴파일러가 계산을 지울 수 없습니다. 성능 측정 코드를 쓸 때 가장 흔한 함정이고, 23주차 “성능 최적화와 프로파일링”에서 다시 만납니다. 측정 결과가 믿기 어려울 만큼 좋으면, 먼저 측정을 의심하세요.
5.2 순회가 느린 진짜 이유: 캐시
둘 다 원소 100만 개를 한 번씩 읽는데, 왜 리스트가 느릴까요? 흔한 설명은 “리스트의 노드는 힙 여기저기 흩어져 있어서”입니다. 그런데 2.3절의 실험을 떠올려 보세요. 연달아 malloc 한 노드들은 32바이트 간격으로 붙어 있었습니다. 이 측정의 노드들도 흩어져 있지 않습니다. 그런데도 6배 느립니다. 그리고 정말 흩어져 있다면 어떻게 될까요?
실험: 같은 노드를 섞어서 이으면?
perf_shuffle.c 는 노드 100만 개를 차례로 할당한 다음, 연결 순서만 두 가지로 바꿔 순회 시간을 잽니다. 노드도, 값도, 합계도 똑같고, next 가 가리키는 순서만 다릅니다.
#include <stdio.h>
#include <stdlib.h>
#include <time.h>

#define N 1000000

typedef struct Node {
    int data;
    struct Node *next;
} Node;

static double ms(clock_t a, clock_t b) {
    return (double)(b - a) * 1000.0 / CLOCKS_PER_SEC;
}

/* order[] 순서대로 노드를 이어 붙여 리스트를 만든다 */
static Node *link_in_order(Node **nodes, const size_t *order) {
    for (size_t i = 0; i + 1 < N; i++) {
        nodes[order[i]]->next = nodes[order[i + 1]];
    }
    nodes[order[N - 1]]->next = NULL;
    return nodes[order[0]];
}

static long long walk(Node *head, double *elapsed) {
    long long sum = 0;
    clock_t t0 = clock();
    for (Node *cur = head; cur != NULL; cur = cur->next) {
        sum += cur->data;
    }
    *elapsed = ms(t0, clock());
    return sum;
}

int main(void) {
    Node **nodes = malloc(N * sizeof(Node *));
    size_t *order = malloc(N * sizeof(size_t));
    if (nodes == NULL || order == NULL) return 1;

    for (size_t i = 0; i < N; i++) {          /* 노드 100만 개를 차례로 할당 */
        nodes[i] = malloc(sizeof(Node));
        if (nodes[i] == NULL) return 1;
        nodes[i]->data = (int)i;
        order[i] = i;
    }

    double t;
    Node *head = link_in_order(nodes, order); /* 1. 할당한 순서대로 잇기 */
    long long s1 = walk(head, &t);
    printf("메모리 순서대로 이은 리스트: %7.2f ms  (합=%lld)\n", t, s1);

    srand(12345);                              /* 2. 순서를 무작위로 섞어 잇기 */
    for (size_t i = N - 1; i > 0; i--) {
        size_t j = (size_t)rand() % (i + 1);
        size_t tmp = order[i]; order[i] = order[j]; order[j] = tmp;
    }
    head = link_in_order(nodes, order);
    long long s2 = walk(head, &t);
    printf("무작위로 섞어 이은 리스트  : %7.2f ms  (합=%lld)\n", t, s2);

    for (size_t i = 0; i < N; i++) free(nodes[i]);
    free(nodes);
    free(order);
    return 0;
}
섞는 부분은 피셔-예이츠 셔플이라는 방법입니다. 맨 뒤 칸부터 앞으로 오면서, 자기 자신을 포함한 앞쪽 칸 중 하나를 무작위로 골라 자리를 바꿉니다. 모든 순서가 같은 확률로 나오는 섞기 방법입니다. srand(12345) 로 난수의 시작값을 고정해서 매번 같은 순서로 섞이게 했습니다.
$ gcc -O2 -Wall -Wextra -std=c11 perf_shuffle.c -o perf_shuffle
$ ./perf_shuffle
메모리 순서대로 이은 리스트:    2.18 ms  (합=499999500000)
무작위로 섞어 이은 리스트  :   71.83 ms  (합=499999500000)
$ ./perf_shuffle
메모리 순서대로 이은 리스트:    1.66 ms  (합=499999500000)
무작위로 섞어 이은 리스트  :   91.42 ms  (합=499999500000)
$ ./perf_shuffle
메모리 순서대로 이은 리스트:    1.79 ms  (합=499999500000)
무작위로 섞어 이은 리스트  :   61.56 ms  (합=499999500000)
같은 노드, 같은 개수, 같은 합계인데 40배 넘게 차이가 납니다. 코드도 똑같은 walk 함수입니다. 달라진 것은 오직 “다음 노드가 메모리의 어디에 있느냐”뿐입니다.
캐시란 무엇인가
CPU는 1초에 수십억 번 계산하지만, 메모리(RAM)에서 값을 가져오는 데는 한 번에 수십~수백 나노초가 걸립니다. CPU 입장에서 메모리는 아주 먼 창고입니다. 매번 창고까지 다녀오면 대부분의 시간을 기다리며 보내게 됩니다.
그래서 CPU 안에는 작고 빠른 저장소, 캐시(cache) 가 여러 층 있습니다. 이 글을 쓴 컴퓨터의 캐시는 이렇습니다.
$ lscpu | grep -E "L1d|L2|L3"
L1d 캐시:                         192 KiB (인스턴스 6건)
L2 캐시:                          3 MiB (인스턴스 6건)
L3 캐시:                          32 MiB (인스턴스 1건)
코어 6개가 각자 32KB 의 L1 과 512KB 의 L2 를 갖고, 32MB 의 L3 를 함께 씁니다. 가까울수록 작고 빠릅니다. CPU가 값을 찾을 때 L1 → L2 → L3 → 메모리 순서로 보고, 캐시에 있으면(캐시 적중) 빠르고, 없으면(캐시 미스) 메모리까지 가야 합니다.
캐시가 효과를 내는 비결은 두 가지입니다.
- 한 번에 64바이트씩 가져옵니다. 메모리에서 값 하나를 가져올 때, 그 주변 64바이트(캐시 라인)를 통째로 가져옵니다. int 배열이라면 한 번 가져올 때 int 16개가 딸려 옵니다. 다음 15개는 이미 캐시에 있는 셈입니다.
- 다음을 예측해서 미리 가져옵니다. CPU에는 프리페처(prefetcher) 가 있어서, 주소가 일정한 간격으로 증가하는 패턴을 보면 “다음은 저기겠구나” 하고 요청하기도 전에 미리 가져다 놓습니다.
이제 세 경우를 설명할 수 있습니다.
| 경우 | 메모리 모양 | 캐시 입장 |
|---|---|---|
| 배열 순회 (0.3ms) | int 가 4바이트씩 빈틈없이 붙어 있음. 100만 개 = 4MB | 캐시 라인 하나에 16개. 프리페처가 완벽히 예측 |
| 메모리 순서 리스트 (1.7ms) | 노드가 32바이트 간격으로 붙어 있음. 100만 개 = 32MB | 캐시 라인 하나에 노드 2개. 간격이 일정해 프리페처가 예측은 함. 하지만 읽을 양이 8배 |
| 무작위 순서 리스트 (60~90ms) | 다음 노드가 32MB 안의 아무 곳 | 다음 주소를 next 를 읽기 전에는 알 수 없음. 매번 캐시 미스, 매번 창고까지 |
세 번째 줄이 핵심입니다. 배열은 i 번째 다음이 i+1 번째라는 걸 CPU가 미리 압니다. 리스트는 지금 노드의 next 를 읽어야 비로소 다음 주소를 압니다. 그래서 노드들이 흩어져 있으면 “읽고 → 기다리고 → 다음 주소 알아내고 → 또 기다리고”를 100만 번 반복합니다. 이 현상을 포인터 추적(pointer chasing) 이라고 부릅니다.
그리고 두 번째 줄도 중요합니다. 연결 리스트가 “운 좋게” 메모리 순서대로 놓여 있어도, int 하나에 32바이트(2.3절)를 쓰기 때문에 같은 데이터를 담는 데 배열보다 8배 많은 메모리를 읽어야 합니다. 메모리를 많이 쓰는 자료구조는 그만큼 느립니다.
실제 프로그램에서 리스트는 대개 세 번째 줄에 가깝습니다. 노드를 넣고 빼기를 반복하다 보면, 해제된 자리에 새 노드가 들어가면서 순서가 뒤섞이기 때문입니다. 7절의 풀 할당자에서 반환한 블록이 재사용되는 모습을 보면 그 과정이 보입니다.
그래서 실무 감각은
- 기본값은 동적 배열. 순회와 접근이 압도적으로 빠르고 메모리도 적게 씁니다.
- 리스트가 이기는 조건은 분명할 때만. “지울 노드나 끼워 넣을 자리의 주소를 이미 들고 있고, 중간 삽입과 삭제가 매우 잦다”가 그 조건입니다. 이때 배열은 뒤 원소를 전부 밀거나 당겨야 하지만(7절
vec_insert의memmove), 리스트는 포인터 몇 개만 바꾸면 됩니다. 7절의 줄 에디터가 좋은 예입니다.
네 번째 질문의 답은 “둘 다 맞다”입니다. 교과서의 O 표기는 연산 횟수를 세고, 실무의 감각은 메모리를 읽는 방식까지 셉니다. 빅오 표기는 12~17주차의 알고리즘 주차에서도 계속 쓰지만, 마지막 판단은 항상 측정으로 합니다.
5.3 gdb 로 리스트 들여다보기
리스트 버그를 잡을 때 gdb 가 큰 힘이 됩니다. gdb 는 6주차에서 처음 만났습니다. 여기서는 멈춰 선 프로그램 안에서 포인터 사슬을 따라가 보는 방법을 익힙니다.
$ gdb ./build/sll_basic
(gdb) break list_free        # list_free 함수가 불리면 멈춰라
(gdb) run                    # 실행
...
Breakpoint 1, list_free (head=0x7fffffffd1f8) at sll_basic.c:121
121     Node *cur = *head;
sll_basic 이 삽입과 삭제를 마치고 전체 해제를 하려는 순간에 멈췄습니다. 이때 리스트는 10 -> 15 -> 30 입니다(4.5절 출력). head 는 Node ** 라는 것을 기억하며 따라가 봅시다.
(gdb) print *head
$1 = (Node *) 0x55555555a2b0
(gdb) print **head
$2 = {data = 10, next = 0x55555555a330}
(gdb) print *(*head)->next
$3 = {data = 15, next = 0x55555555a2f0}
(gdb) print (*head)->next->next->data
$4 = 30
| 명령 | 뜻 | 결과 |
|---|---|---|
print *head |
head 가 가리키는 것, 즉 main 의 list 변수의 값 |
첫 노드의 주소 |
print **head |
그 주소에 있는 노드 전체 | {data = 10, next = ...} |
print *(*head)->next |
첫 노드의 next 가 가리키는 노드 |
{data = 15, ...} |
print (*head)->next->next->data |
세 번째 노드의 값만 | 30 |
C 코드에 쓰는 것과 똑같은 식을 그대로 쓸 수 있습니다. -> 를 이어 붙이면서 사슬을 따라가는 것이죠. 리스트 끝을 넘어가 보면 어떻게 될까요?
(gdb) print *(*head)->next->next->next
Cannot access memory at address 0x0
(gdb) print (*head)->next->next->next->next
Cannot access memory at address 0x8
첫 번째는 세 번째 노드의 next, 즉 NULL(0번지)을 역참조하려다 거절당했습니다. 두 번째가 재미있습니다. 0x8 번지라고 합니다. NULL 인 노드의 next 를 읽으려면 “0번지 + next 의 오프셋 8″을 읽어야 하기 때문입니다(2.3절의 그림). 실제 프로그램에서 NULL 포인터의 멤버를 읽다가 죽으면, 이렇게 작은 숫자 주소에서 죽었다는 메시지가 나옵니다. 그 숫자가 곧 멤버의 오프셋이라는 것을 알면 어느 멤버를 읽다 죽었는지 짐작할 수 있습니다.
next 를 따라가다 보면 식이 길어집니다. 그럴 때는 중간 결과에 붙은 번호($2, $3)를 다시 쓸 수 있습니다. 예를 들어 print *$3.next 는 “3번 결과의 next 가 가리키는 노드”입니다.
6. valgrind 실습: 메모리 버그 4종 세트
7주차에서 valgrind 를 소개했습니다. 이번에는 일부러 버그를 만들어 놓고 보고서를 한 줄씩 읽는 연습을 합니다. 이미 3절과 4절에서 몇 번 봤는데, 여기서 체계적으로 정리합니다.
examples/valgrind_lab.c 는 인자에 따라 서로 다른 문제를 일으킵니다.
$ ./build/valgrind_lab           # 문제 없는 정상 실행
$ ./build/valgrind_lab leak      # 메모리 누수
$ ./build/valgrind_lab invalid   # 할당 범위 밖 접근
$ ./build/valgrind_lab uaf       # 해제 후 사용
$ ./build/valgrind_lab double    # 이중 해제
main(int argc, char *argv[]) 로 명령줄 인자를 받아서, strcmp 로 어떤 모드인지 고릅니다. 1주차 12절의 쉘 스크립트에서 $1 로 받던 것과 같은 것을 C에서 받는 방법입니다.
컴파일할 때부터 이미 경고가 나옵니다.
$ gcc -Wall -Wextra -std=c11 -g examples/valgrind_lab.c -o build/valgrind_lab
examples/valgrind_lab.c: In function ‘demo_uaf’:
examples/valgrind_lab.c:72:5: warning: pointer ‘value’ used after ‘free’ [-Wuse-after-free]
   72 |     printf("[UAF] 해제된 값: %d (쓰레기일 수 있음)\n", *value);
      |     ^~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~
examples/valgrind_lab.c:70:5: note: call to ‘free’ here
examples/valgrind_lab.c: In function ‘demo_double_free’:
examples/valgrind_lab.c:82:5: warning: pointer ‘p’ used after ‘free’ [-Wuse-after-free]
   82 |     free(p);                             /* 두 번째 free는 미정의 동작! */
      |     ^~~~~~~
examples/valgrind_lab.c:81:5: note: call to ‘free’ here
GCC 12 부터 들어온 -Wuse-after-free 경고입니다. 해제 후 사용과 이중 해제 두 가지를 컴파일 단계에서 이미 잡았습니다. -Wall 에 포함되어 있으니 1주차부터 써 온 옵션만으로 나온 것입니다. 하지만 이 경고가 모든 경우를 잡지는 못합니다. 누수와 범위 밖 접근은 조용히 통과했습니다. 그래서 valgrind 가 필요합니다.
6.1 보고서의 구조
정상 모드부터 봅시다.
$ valgrind --leak-check=full ./build/valgrind_lab
==2471884== Memcheck, a memory error detector
==2471884== Copyright (C) 2002-2022, and GNU GPL'd, by Julian Seward et al.
==2471884== Using Valgrind-3.22.0 and LibVEX; rerun with -h for copyright info
==2471884== Command: ./valgrind_lab
==2471884==
=== valgrind 실습장 ===
valgrind --leak-check=full ./valgrind_lab [모드] 로 확인하세요

[정상] 100개 int 할당 -> 사용 -> 해제
[정상] 합계: 99
[정상] valgrind 결과: 'no leaks are possible'이 떠야 정상
==2471884==
==2471884== HEAP SUMMARY:
==2471884==     in use at exit: 0 bytes in 0 blocks
==2471884==   total heap usage: 2 allocs, 2 frees, 4,496 bytes allocated
==2471884==
==2471884== All heap blocks were freed -- no leaks are possible
==2471884==
==2471884== For lists of detected and suppressed errors, rerun with: -s
==2471884== ERROR SUMMARY: 0 errors from 0 contexts (suppressed: 0 from 0)
| 부분 | 뜻 |
|---|---|
==2471884== |
valgrind 가 쓴 줄이라는 표시. 숫자는 프로세스 번호(PID)로, 실행할 때마다 다릅니다. 이 표시가 없는 줄은 우리 프로그램의 출력입니다 |
Memcheck |
valgrind 의 여러 도구 중 메모리 검사 도구가 돌고 있음 |
in use at exit: 0 bytes in 0 blocks |
프로그램이 끝날 때 아직 해제되지 않은 메모리. 0이어야 합니다 |
total heap usage: 2 allocs, 2 frees, 4,496 bytes |
할당 2번, 해제 2번. 400바이트(int 100개) + 4,096바이트(printf 버퍼, 4.5절) |
All heap blocks were freed -- no leaks are possible |
목표 문장 |
ERROR SUMMARY: 0 errors |
잘못된 읽기·쓰기·해제가 한 번도 없었음. 두 번째 목표 |
누수가 0 이어도 ERROR SUMMARY 가 0 이 아니면 문제가 있는 것입니다. 두 줄을 모두 확인하는 습관을 들이세요.
6.2 누수: definitely lost
$ valgrind --leak-check=full ./build/valgrind_lab leak
...
[누수] 1000바이트를 할당하고 해제하지 않습니다
[누수] 이 메모리는 영영 반환되지 않는다...
==2471924==
==2471924== HEAP SUMMARY:
==2471924==     in use at exit: 1,000 bytes in 1 blocks
==2471924==   total heap usage: 2 allocs, 1 frees, 5,096 bytes allocated
==2471924==
==2471924== 1,000 bytes in 1 blocks are definitely lost in loss record 1 of 1
==2471924==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==2471924==    by 0x10929B: demo_leak (valgrind_lab.c:43)
==2471924==    by 0x1094AB: main (valgrind_lab.c:93)
==2471924==
==2471924== LEAK SUMMARY:
==2471924==    definitely lost: 1,000 bytes in 1 blocks
==2471924==    indirectly lost: 0 bytes in 0 blocks
==2471924==      possibly lost: 0 bytes in 0 blocks
==2471924==    still reachable: 0 bytes in 0 blocks
==2471924==         suppressed: 0 bytes in 0 blocks
...
==2471924== ERROR SUMMARY: 1 errors from 1 contexts (suppressed: 0 from 0)
in use at exit 이 1,000바이트이고, 할당은 2번인데 해제는 1번입니다. 그 아래 덩어리가 어디서 할당한 메모리를 잃었는지 알려 줍니다. 아래에서 위로 읽으면 호출 순서입니다.
main (valgrind_lab.c:93)          ← main 의 93번째 줄이
  demo_leak (valgrind_lab.c:43)   ← demo_leak 을 불렀고, 그 43번째 줄이
    malloc                         ← malloc 을 불렀다. 그 메모리가 누수
이 호출 순서의 목록을 스택 추적(stack trace) 이라고 부릅니다. -g 로 컴파일해야 파일 이름과 줄 번호가 나옵니다(1주차 5절). -g 없이 컴파일하면 demo_leak (in ./valgrind_lab) 처럼 함수 이름만 나옵니다.
LEAK SUMMARY 의 네 가지 분류
LEAK SUMMARY 에는 줄이 다섯 개 있습니다(suppressed 는 “일부러 무시하기로 한 것”이라 신경 쓰지 않아도 됩니다). 나머지 넷의 차이를 실험으로 봅시다. 노드 3개짜리 리스트를 만들고 해제하지 않은 채 끝내는 두 가지 방법을 비교합니다. 첫째는 lost_head.c, 머리 포인터를 NULL 로 덮어써서 잃어버리는 경우입니다.
    /* 10 -> 20 -> 30 리스트를 만든 뒤 */
    head = NULL;                     /* 해제하지 않고 머리만 잊어버린다 */
    return 0;
$ valgrind --leak-check=full ./lost_head
==2501093==     in use at exit: 48 bytes in 3 blocks
...
==2501093== 48 (16 direct, 32 indirect) bytes in 1 blocks are definitely lost in loss record 2 of 2
==2501093==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==2501093==    by 0x10918F: main (lost_head.c:12)
...
==2501093==    definitely lost: 16 bytes in 1 blocks
==2501093==    indirectly lost: 32 bytes in 2 blocks
노드는 세 개(48바이트)인데, 확실히 잃은 것(definitely lost)은 16바이트 하나, 간접적으로 잃은 것(indirectly lost)이 32바이트 둘입니다.
  (아무도 안 가리킴)
         ✗
         ▼
      ┌──────┐      ┌──────┐      ┌──────┐
      │  10  │ ───▶ │  20  │ ───▶ │  30  │
      └──────┘      └──────┘      └──────┘
   definitely lost   indirectly lost (두 개)
첫 노드는 가리키는 포인터가 하나도 없으니 확실히 잃었습니다. 두 번째와 세 번째 노드는 가리키는 포인터(10 의 next, 20 의 next)가 있긴 한데, 그 포인터가 들어 있는 노드 자체가 잃어버린 메모리 안에 있습니다. 그래서 간접적으로 잃은 것입니다. valgrind 는 48 (16 direct, 32 indirect) 로 묶어서 보여 주며, “이 16바이트 하나만 제대로 해제했다면(리스트 전체 해제 함수를 불렀다면) 48바이트가 다 해결된다”고 알려 주는 셈입니다. indirectly lost 가 보이면, 먼저 definitely lost 를 고치세요. 대개 함께 사라집니다.
둘째는 reachable.c, 전역 변수가 아직 머리를 가리키는 채로 끝나는 경우입니다.
Node *keep;                          /* 전역 변수 */
...
    keep = head;                     /* 전역 변수가 아직 가리키는 채로 끝낸다 */
    return 0;
$ valgrind --leak-check=full ./reachable
==2502107==     in use at exit: 48 bytes in 3 blocks
...
==2502107==    definitely lost: 0 bytes in 0 blocks
==2502107==    indirectly lost: 0 bytes in 0 blocks
==2502107==    still reachable: 48 bytes in 3 blocks
==2502107== Reachable blocks (those to which a pointer was found) are not shown.
이번에는 still reachable(아직 닿을 수 있음)입니다. 프로그램이 끝나는 순간에도 전역 변수를 통해 세 노드에 닿을 수 있으니, “잃어버린” 것은 아닙니다. 해제만 안 했을 뿐입니다. 프로그램이 끝나면 운영체제가 모든 메모리를 회수하므로 당장 해는 없습니다. 하지만 이 코드가 함수가 되어 반복해서 불리면 그때는 진짜 누수가 됩니다. 이 강좌의 기준은 네 줄이 모두 0 입니다.
| 분류 | 뜻 | 심각도 |
|---|---|---|
| definitely lost | 가리키는 포인터가 하나도 없음 | 반드시 고친다 |
| indirectly lost | 잃어버린 블록을 통해서만 닿을 수 있었음 | definitely 를 고치면 대개 해결 |
| possibly lost | 블록의 중간을 가리키는 포인터만 있음. 진짜 누수일 수도, 아닐 수도 | 확인이 필요 |
| still reachable | 끝날 때도 닿을 수 있었지만 해제 안 함 | 정리 습관 차원에서 고친다 |
6.3 범위 밖 쓰기: Invalid write
void demo_invalid(void) {
    int *arr = malloc(10 * sizeof(int));
    if (arr == NULL) return;

    for (int i = 0; i <= 10; i++) {      /* <= 가 문제! i=10은 범위 밖 */
        arr[i] = i;
    }
    free(arr);
}
< 를 <= 로 쓰는 실수, 흔히 off-by-one(하나 차이) 오류라고 부릅니다. 먼저 valgrind 없이 실행해 봅시다.
$ ./build/valgrind_lab invalid
=== valgrind 실습장 ===
valgrind --leak-check=full ./valgrind_lab [모드] 로 확인하세요

[범위밖] 10칸을 할당하고 11번째 칸에 씁니다
$ echo $?
0
아무 일도 없었습니다. 종료 코드도 0 입니다. 2.3절에서 본 대로 malloc 은 요청보다 조금 넉넉하게 블록을 잡아 두기 때문에, 한 칸 넘어 쓴 값이 운 좋게 그 여유 공간에 들어간 것입니다. 이것이 가장 위험한 버그입니다. 지금은 조용히 돌아가다가, 코드가 조금 바뀌어 블록 배치가 달라지는 날 엉뚱한 곳에서 터집니다.
$ valgrind --leak-check=full ./build/valgrind_lab invalid
==2472814== Invalid write of size 4
==2472814==    at 0x109374: demo_invalid (valgrind_lab.c:58)
==2472814==    by 0x1094D6: main (valgrind_lab.c:95)
==2472814==  Address 0x4aad0a8 is 0 bytes after a block of size 40 alloc'd
==2472814==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==2472814==    by 0x109348: demo_invalid (valgrind_lab.c:54)
==2472814==    by 0x1094D6: main (valgrind_lab.c:95)
Invalid write of size 4: 4바이트(int 하나)를 잘못된 곳에 썼다.at ... demo_invalid (valgrind_lab.c:58): 58번째 줄arr[i] = i;에서.Address ... is 0 bytes after a block of size 40 alloc'd: 쓴 곳은 40바이트 블록이 끝난 바로 다음(0 bytes after). 40바이트는 int 10개, 그 바로 뒤는arr[10]입니다.- 그 아래: 그 40바이트 블록은 54번째 줄에서 할당됐다.
“몇 바이트 after” 의 숫자가 몇 칸 넘었는지 알려 줍니다. arr[11] 에 썼다면 4 bytes after 가 됩니다.
6.4 해제 후 사용: Invalid read … free’d
void demo_uaf(void) {
    int *value = malloc(sizeof(int));
    if (value == NULL) return;
    *value = 42;
    free(value);

    printf("[UAF] 해제된 값: %d (쓰레기일 수 있음)\n", *value);
}
use-after-free, 줄여서 UAF 입니다. valgrind 없이 실행하면 이렇습니다.
$ ./build/valgrind_lab uaf
...
[UAF] 해제한 메모리를 다시 읽습니다
[UAF] 해제된 값: 867377628 (쓰레기일 수 있음)
42 가 아니라 867377628 입니다. 4.4절에서 설명한 대로, free 가 돌려받은 블록 안에 자기 관리 정보를 써 넣었기 때문입니다. 실행할 때마다 다른 값이 나올 수 있습니다. valgrind 로 돌리면 이렇게 됩니다.
$ valgrind --leak-check=full ./build/valgrind_lab uaf
==2472869== Invalid read of size 4
==2472869==    at 0x1093DB: demo_uaf (valgrind_lab.c:72)
==2472869==    by 0x1094FE: main (valgrind_lab.c:97)
==2472869==  Address 0x4aad080 is 0 bytes inside a block of size 4 free'd
==2472869==    at 0x484988F: free (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==2472869==    by 0x1093D6: demo_uaf (valgrind_lab.c:70)
==2472869==    by 0x1094FE: main (valgrind_lab.c:97)
==2472869==  Block was alloc'd at
==2472869==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==2472869==    by 0x1093B5: demo_uaf (valgrind_lab.c:67)
==2472869==    by 0x1094FE: main (valgrind_lab.c:97)
...
[UAF] 해제된 값: 42 (쓰레기일 수 있음)
UAF 보고서는 스택 추적이 세 개입니다. ① 잘못 읽은 곳(72번째 줄), ② 그 블록을 해제한 곳(70번째 줄 free), ③ 그 블록을 할당한 곳(67번째 줄 malloc). 세 곳이 멀리 떨어진 실제 프로그램에서 이 정보는 금보다 귀합니다. “누가 이걸 먼저 지워 버렸지?”를 바로 알려 주니까요.
valgrind 아래에서는 42 가 그대로 찍힌 것도 보세요. valgrind 는 해제된 블록을 바로 재사용하지 않고 한동안 격리해 두기 때문입니다. 실행 환경에 따라 결과가 달라지는 것이 미정의 동작의 특징입니다.
출력 순서가 이상하다? 위의 valgrind 보고서에서는 오류 메시지가 먼저 나오고 프로그램의
printf출력이 뒤에 나옵니다. 출력을 다른 명령으로 넘기거나(|) 파일로 저장하면printf의 출력은 버퍼에 모였다가 나중에 한꺼번에 나가고, valgrind 의 보고서는 곧바로 나가기 때문입니다(9주차의 버퍼링). 터미널에서 직접 실행하면 줄 단위로 바로 나가서 순서가 자연스럽게 섞입니다.
6.5 이중 해제: Invalid free()
void demo_double_free(void) {
    char *p = malloc(50);
    if (p == NULL) return;
    free(p);
    free(p);                             /* 두 번째 free는 미정의 동작! */
}
이번에는 valgrind 없이 실행한 결과가 가장 극적입니다.
$ ./build/valgrind_lab double
...
[이중해제] 같은 메모리를 두 번 free 합니다
free(): double free detected in tcache 2
중지됨 (코어 덤프됨)
$ echo $?
134
glibc 가 스스로 잡아냈습니다. free(): double free detected in tcache 2 는 C 라이브러리가 “같은 블록을 두 번 돌려받았다”는 것을 알아채고 프로그램을 강제로 중지시킨 메시지입니다. tcache 는 glibc 가 최근에 해제된 블록을 모아 두는 목록의 이름입니다. 종료 코드 134 는 128 + 6, 6번 신호(SIGABRT, “스스로 중단”)입니다. 이중 해제를 그냥 두면 같은 블록이 두 번 재사용되어 서로 다른 두 변수가 같은 메모리를 쓰게 되고, 이는 보안 공격에 악용되기도 합니다(24주차). 그래서 glibc 가 방어하는 것입니다. 하지만 모든 경우를 잡지는 못합니다.
$ valgrind --leak-check=full ./build/valgrind_lab double
==2472872== Invalid free() / delete / delete[] / realloc()
==2472872==    at 0x484988F: free (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==2472872==    by 0x10943F: demo_double_free (valgrind_lab.c:82)
==2472872==    by 0x109526: main (valgrind_lab.c:99)
==2472872==  Address 0x4aad080 is 0 bytes inside a block of size 50 free'd
==2472872==    at 0x484988F: free (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==2472872==    by 0x109433: demo_double_free (valgrind_lab.c:81)
...
==2472872==   total heap usage: 2 allocs, 3 frees, 4,146 bytes allocated
“82번째 줄의 free 가 잘못됐다. 그 블록은 이미 81번째 줄에서 해제됐다.” 그리고 2 allocs, 3 frees 를 보세요. 할당보다 해제가 많습니다. 숫자만 봐도 이중 해제가 있다는 것을 알 수 있습니다.
free(p); 다음에 p = NULL; 을 쓰는 습관(valgrind_lab.c 의 정상 모드가 그렇게 합니다)이 이중 해제를 막아 줍니다. free(NULL) 은 아무 일도 하지 않는다고 표준이 정해 두었기 때문입니다.
6.6 한눈에 보기
| 모드 | valgrind 없이 | valgrind 보고의 첫 줄 | 읽는 법 |
|---|---|---|---|
| (정상) | 정상 | All heap blocks were freed -- no leaks are possible |
목표 |
| leak | 정상처럼 보임 | 1,000 bytes in 1 blocks are definitely lost |
할당한 곳의 스택 추적을 보고 free 를 추가 |
| invalid | 정상처럼 보임 (종료 코드 0) | Invalid write of size 4 … 0 bytes after a block of size 40 |
블록 크기와 “몇 bytes after”로 몇 칸 넘었는지 계산 |
| uaf | 쓰레기 값 (867377628) |
Invalid read of size 4 … inside a block of size 4 free'd |
세 스택 추적: 읽은 곳, 해제한 곳, 할당한 곳 |
| double | glibc 가 중지 (종료 코드 134) | Invalid free() |
allocs 보다 frees 가 많음 |
네 가지 중 세 가지가 valgrind 없이는 정상처럼 보인다는 것이 이 표의 교훈입니다. 이번 주의 규칙은 이것입니다. 동적 할당이 있는 프로그램은 전부 valgrind 로 누수 0, 오류 0 을 확인하고 넘어갑니다. Makefile 에 검사 타겟을 준비해 두었습니다.
$ make memcheck
generic_vector, vector_int, sll_basic 세 프로그램을 valgrind 로 검사합니다. --error-exitcode=1 옵션을 줘서, 오류가 하나라도 있으면 make 가 실패로 끝나게 해 두었습니다(1주차의 종료 코드 약속). 이 글의 모든 예제와 프로젝트를 이 방식으로 검사했고, 전부 누수 0, 오류 0 이었습니다(물론 valgrind_lab 의 버그 모드는 빼고요).
7. 실습 프로젝트
이번 주 프로젝트 세 개는 모두 “실무 축소판”입니다. 전체 코드는 projects/ 폴더에 있습니다. 여기서는 설계 아이디어와 핵심 코드를 설명합니다. 먼저 빌드하고 실행해 본 다음, 코드를 열어 이 설명과 맞춰 읽어 보세요.
프로젝트 1: 범용 동적 배열 라이브러리 (generic_vector.c)
3.4절의 제네릭 벡터를 라이브러리 수준으로 완성합니다. “라이브러리”란 다른 프로그램이 가져다 쓰는 코드입니다. 그래서 어떤 함수를 어떤 모양으로 제공할지(API 설계) 가 핵심입니다.
Vec *vec_create(size_t elem_size);       /* 생성 */
void vec_destroy(Vec *v);                /* 파괴 */
int  vec_push(Vec *v, const void *elem); /* 뒤에 추가 */
int  vec_pop(Vec *v, void *out);         /* 뒤에서 꺼내기 */
int  vec_get(const Vec *v, size_t i, void *out);
int  vec_set(Vec *v, size_t i, const void *elem);
int  vec_insert(Vec *v, size_t i, const void *elem);  /* 중간 삽입 */
int  vec_remove(Vec *v, size_t i);                    /* 중간 삭제 */
int  vec_reserve(Vec *v, size_t want);   /* 공간 미리 확보 */
int  vec_shrink(Vec *v);                 /* 남는 공간 반납 */
void vec_foreach(Vec *v, void (*fn)(void *, void *), void *ctx);
API 에서 읽을 수 있는 설계 원칙이 몇 가지 있습니다.
- 벡터를 힙에 만들어 포인터로 돌려준다 (
vec_create). 3절의IntVector는 스택에 만들고vector_init으로 초기화했지만, 여기서는 생성과 파괴를 짝으로 제공합니다. 쓰는 쪽은Vec의 내부를 몰라도 됩니다. - 값을 넣고 빼는 함수는 모두 주소를 받는다 (
const void *elem,void *out). 타입을 모르니까요(3.4절). - 읽기만 하는 함수는
const Vec *를 받는다 (vec_get). 이 함수가 벡터를 바꾸지 않는다는 약속을 타입으로 표현합니다. - 실패할 수 있는 함수는
int로 성공 여부를 돌려준다. 3.3절의pop에서 본 방식입니다.
vec_reserve: 확장을 한곳에서
int vec_reserve(Vec *v, size_t want) {
    if (want <= v->capacity) return 1;   /* 이미 충분 */

    size_t new_cap = (v->capacity == 0) ? 4 : v->capacity;
    while (new_cap < want) {
        new_cap *= 2;                    /* 2배 성장 전략 */
    }

    void *new_data = realloc(v->data, new_cap * v->elem_size);
    if (new_data == NULL) return 0;

    v->data = new_data;
    v->capacity = new_cap;
    return 1;
}
3절에서는 push_back 안에 확장 코드가 있었습니다. 여기서는 확장을 vec_reserve 한 곳으로 모으고, vec_push 와 vec_insert 가 모두 vec_reserve(v, v->size + 1) 을 부릅니다. 같은 코드를 두 번 쓰지 않으면 고칠 곳도 한 곳입니다. while 루프 덕분에 vec_reserve(v, 500) 처럼 큰 수를 요청해도 4 → 8 → … → 512 로 한 번에 맞춰 줍니다. 원소를 몇 개 넣을지 미리 안다면 vec_reserve 를 먼저 불러 두면 중간 확장이 한 번도 일어나지 않습니다.
vec_insert 와 memmove
중간에 넣으려면 뒤 원소들을 한 칸씩 밀어야 합니다.
int vec_insert(Vec *v, size_t i, const void *elem) {
    if (i > v->size) return 0;           /* i == size면 push와 동일 */
    if (!vec_reserve(v, v->size + 1)) return 0;

    /* memmove: 겹치는 영역도 안전하게 이동 */
    memmove(vec_slot(v, i + 1), vec_slot(v, i),
            (v->size - i) * v->elem_size);
    memcpy(vec_slot(v, i), elem, v->elem_size);
    v->size++;
    return 1;
}
삽입 전 (i = 1 에 X 넣기):   [ A ][ B ][ C ][ D ][   ]
                                  └──────────┘ 이 세 칸을
memmove 후:                  [ A ][ B ][ B ][ C ][ D ]
                                       └──────────┘ 한 칸 뒤로 (원본과 대상이 겹친다!)
memcpy 후:                   [ A ][ X ][ B ][ C ][ D ]
여기서 memcpy 가 아니라 memmove 를 씁니다. 둘 다 바이트를 복사하지만, 원본과 대상이 겹칠 때 차이가 납니다. memcpy 는 겹치지 않는다고 가정하고 가장 빠른 방법으로 복사하므로, 겹치면 결과가 정의되지 않습니다. 위 그림에서 B 를 C 자리에 쓰는 순간 C 가 덮여 버릴 수 있습니다. memmove 는 겹침을 확인하고 안전한 방향(이 경우 뒤에서부터)으로 복사합니다. 겹칠 가능성이 조금이라도 있으면 memmove 입니다.
삽입과 삭제가 뒤 원소 수에 비례하는 복사를 한다는 것도 보세요. 맨 앞에 넣으면 전부 밀어야 하니 O(n) 입니다. 5절에서 “중간 삽입이 잦으면 리스트가 이긴다”고 한 이유가 이것입니다.
vec_foreach 와 ctx
void vec_foreach(Vec *v, void (*fn)(void *elem, void *ctx), void *ctx) {
    for (size_t i = 0; i < v->size; i++) {
        fn(vec_slot(v, i), ctx);
    }
}
모든 원소에 같은 함수를 적용합니다. 1.3절의 콜백과 같은 발상인데, 인자가 하나 더 있습니다. void *ctx(context, 맥락)입니다. 콜백이 원소 말고도 필요한 정보를 받는 통로입니다. 예를 들어 “모든 학생에게 보너스 점수를 더한다”에서 보너스가 몇 점인지를 ctx 로 넘깁니다.
void add_bonus(void *elem, void *ctx) {
    Student *s = elem;
    int bonus = *(int *)ctx;
    s->score += bonus;
}

int bonus = 5;
vec_foreach(sv, add_bonus, &bonus);  /* 전원 +5점 */
전역 변수 없이도 콜백에 정보를 전달할 수 있습니다. C 라이브러리들이 콜백을 받을 때 거의 항상 이런 void * 인자를 함께 받는 이유입니다.
자체 테스트
main() 은 라이브러리를 검증하는 자체 테스트로 이루어져 있습니다.
#define TEST(name, cond) do {                                  \
    tests_run++;                                               \
    if (cond) { tests_passed++; printf("  [통과] %s\n", name); } \
    else      { printf("  [실패] %s (줄 %d)\n", name, __LINE__); } \
} while (0)
조건이 참이면 통과, 거짓이면 실패와 줄 번호(__LINE__) 를 출력하는 매크로입니다. __LINE__ 은 1주차 6절에서 본 __FILE__ 과 같은 미리 정의된 이름입니다. 여러 줄 매크로를 do { ... } while (0) 으로 감싸는 것은 C의 오래된 관용구입니다. 이렇게 하면 if (x) TEST(...); else ... 처럼 써도 세미콜론 때문에 else 가 엉뚱하게 붙는 일 없이 문장 하나처럼 동작합니다.
$ ./build/generic_vector
=== 범용 동적 배열 라이브러리 자체 테스트 ===

[1] int 벡터: push/pop/get
  [통과] 생성
  [통과] 100개 push 후 size
  [통과] get(50)
  [통과] 범위 밖 get 거부
  [통과] pop

[2] int 벡터: insert/remove
  [통과] insert(0)
  [통과] 삽입 확인
  [통과] 기존 원소 밀림
  [통과] remove(0)
  [통과] 삭제 후 복원

[3] 용량 관리: reserve/shrink
    현재 size=99, capacity=128
  [통과] reserve(500)
  [통과] shrink
    shrink 후 size=99, capacity=99

[4] 구조체 벡터 + foreach 콜백
  보너스 전:
    김철수  85점
    이영희  92점
    박민수  78점
  보너스 후:
    김철수  90점
    이영희  97점
    박민수  83점
  [통과] foreach로 값 변경

=====================================
테스트 결과: 13 / 13 통과
=====================================
valgrind --leak-check=full 로 누수 0을 확인해 보세요!
[3] 에서 100개를 넣고 하나를 뺀 뒤 size=99, capacity=128 인 것을 보세요. 4 → 8 → … → 128 로 확장됐습니다. vec_shrink 뒤에는 capacity 가 99로 딱 맞춰졌습니다. 프로그램의 종료 코드도 모든 테스트가 통과하면 0, 하나라도 실패하면 1 입니다(return (tests_passed == tests_run) ? 0 : 1;). 그래서 ./build/generic_vector && echo 좋아 처럼 스크립트에서 쓸 수 있습니다. 테스트 코드를 쓰는 습관은 15주차 이후 알고리즘을 만들 때 큰 힘이 됩니다.
확장 아이디어: vec_find(비교 콜백으로 탐색), vec_sort(qsort 연동, 1.3절), 헤더와 소스 분리(5주차 모듈화 적용). 11주차의 스택은 이 벡터 위에 그대로 올릴 수 있습니다. push 와 pop 이 이미 있으니까요.
프로젝트 2: 메모리 풀 관리자 (pool_allocator.c)
malloc 을 매번 부르는 대신, 큰 메모리를 한 번에 확보해 두고 고정 크기 블록으로 잘라 나눠 주는 할당기입니다. 게임 엔진이나 네트워크 서버처럼 같은 크기의 객체(총알, 패킷, 리스트 노드…)를 초당 수십만 개씩 만들고 버리는 프로그램이 실제로 쓰는 기법입니다.
핵심 아이디어: free list
빈 블록들을 연결 리스트로 관리합니다. 그런데 노드를 따로 할당하지 않습니다. 기발하게도, 빈 블록 자신의 공간에 “다음 빈 블록”의 주소를 적어 둡니다. 어차피 비어 있는 블록이니, 그 앞 8바이트를 관리용으로 빌려 쓰는 것입니다.
풀 생성 직후 (블록 4개):

free_list
   │
   ▼
┌─ 블록0 ─────┐   ┌─ 블록1 ─────┐   ┌─ 블록2 ─────┐   ┌─ 블록3 ─────┐
│ 다음=블록1 ─┼──▶│ 다음=블록2 ─┼──▶│ 다음=블록3 ─┼──▶│ 다음=NULL   │
│ (나머지 빔) │   │             │   │             │   │             │
└─────────────┘   └─────────────┘   └─────────────┘   └─────────────┘
 ◀────────────────── 한 번의 malloc 으로 받은 연속 공간 ──────────────────▶
void *pool_alloc(Pool *pool) {
    if (pool->free_list == NULL) {
        return NULL;                     /* 풀이 가득 참 */
    }
    void *block = pool->free_list;
    pool->free_list = *(void **)block;   /* 머리를 다음 빈 블록으로 */
    pool->used++;
    return block;
}

void pool_free(Pool *pool, void *block) {
    if (block == NULL) return;
    *(void **)block = pool->free_list;   /* 반환 블록이 기존 머리를 가리키고 */
    pool->free_list = block;             /* 머리가 반환 블록이 된다 */
    pool->used--;
}
*(void **)block 이 핵심입니다. block 은 void *, 타입 없는 주소입니다. 이것을 (void **) 로 캐스팅하면 “이 주소에는 주소(void *)가 들어 있다“고 보는 것이고, 앞의 * 로 그 주소를 읽거나 씁니다. 빈 블록의 첫 8바이트를 next 칸처럼 쓰는 것이죠.
가만히 보면 pool_alloc 은 4.3절의 머리 삭제, pool_free 는 4.2절의 머리 삽입 과 똑같습니다. 할당과 반환이 모두 포인터 두 번 움직이면 끝나는 O(1) 입니다. malloc 처럼 알맞은 크기의 빈 공간을 찾을 필요가 없습니다. 모든 블록의 크기가 같으니까요.
발견된 버그: 정렬
이 프로젝트를 처음 만들었을 때 풀은 sizeof(Item) 크기의 블록을 그대로 썼습니다.
typedef struct {
    int id;
    char name[24];
} Item;                  /* 4 + 24 = 28바이트 */
28바이트 블록이니 블록들은 0, 28, 56, 84, … 번지에서 시작합니다. 그리고 각 빈 블록의 첫머리에 8바이트 포인터를 씁니다. 2절에서 배운 대로 포인터는 8의 배수 주소에 있어야 하는데, 28과 84는 8의 배수가 아닙니다. 정렬 규칙 위반입니다. 인텔·AMD CPU는 이런 접근도 느릴 뿐 허용하기 때문에 프로그램은 멀쩡히 돌아갔고, 아무도 몰랐습니다. GCC의 정렬 검사기(-fsanitize=alignment)로 돌려서야 드러났습니다.
$ gcc -std=c11 -g -fsanitize=alignment -fno-sanitize-recover=alignment pool_allocator.c -o pool_ub
$ ./pool_ub
pool_allocator.c:59:23: runtime error: store to misaligned address 0x62e9f194330c for type 'void *', which requires 8 byte alignment
0x62e9f194330c: note: pointer points here
  00 00 00 00 00 00 00 00  00 00 00 00 00 00 00 00  ...
              ^
“void * 는 8바이트 정렬이 필요한데, 정렬되지 않은 주소(끝자리 ...30c)에 저장했다.” 0x30c 는 12로 끝나는 주소라 8의 배수가 아닙니다. ARM 처럼 정렬을 엄격하게 요구하는 CPU에서는 이 줄에서 프로그램이 죽었을 겁니다.
고친 코드는 블록 크기를 정렬 단위의 배수로 올립니다.
Pool *pool_create(size_t block_size, size_t block_count) {
    if (block_count == 0) return NULL;

    /* 블록 안에 포인터를 저장해야 하므로 최소 크기는 포인터 크기 */
    if (block_size < sizeof(void *)) {
        block_size = sizeof(void *);
    }

    /* 블록 크기를 정렬 단위(max_align_t, 보통 16)의 배수로 올린다. */
    size_t align = _Alignof(max_align_t);
    block_size = (block_size + align - 1) / align * align;
    ...
max_align_t 는 <stddef.h> 에 있는 “이 시스템에서 가장 엄격한 정렬을 요구하는 타입”입니다. x86-64 에서 16입니다. malloc 이 돌려주는 주소가 항상 16의 배수인 이유도 이것입니다(2.3절에서 본 주소들의 끝자리가 전부 0 이었습니다). 모든 블록이 16의 배수 주소에서 시작하면, 블록에 무엇을 담든 정렬이 맞습니다.
(block_size + align - 1) / align * align 은 올림 계산입니다. 정수 나눗셈은 버림이니, 나누기 전에 align - 1 을 더해 두면 올림이 됩니다. 28이라면 (28 + 15) / 16 × 16 = 43 / 16 × 16 = 2 × 16 = 32 입니다. 이 공식은 앞으로도 자주 쓰니 기억해 두세요.
맨 처음의 block_count == 0 검사도 이때 추가했습니다. 블록이 0개면 뒤의 (block_count - 1) * block_size 가 size_t 에서 0 − 1, 즉 아주 큰 수가 되어 엉뚱한 곳에 쓰기 때문입니다(size_t 는 부호가 없어서 0 − 1 이 음수가 아니라 최댓값이 됩니다).
실행 결과
$ ./build/pool_allocator
메모리 풀 관리자
================

=== 기본 사용법 ===
풀 생성: 블록 32바이트 x 32개

  [................................]  사용: 0/32

10개 할당 후:
  [##########......................]  사용: 10/32

3개(2,5,7번) 반환 후:
  [##.##.#.##......................]  사용: 7/32

재할당된 블록: 방금 반환한 7번 블록 재사용!
  [##.##.####......................]  사용: 8/32

전부 반환 후:
  [................................]  사용: 0/32

=== 속도 비교: malloc/free vs 풀 (10만 회) ===
malloc/free:     1.01 ms
메모리 풀  :     0.69 ms
풀이 약 1.5배 빠름

=== 풀 고갈 처리 ===
할당 1: 성공
할당 2: 성공
할당 3: 성공
할당 4: 성공
할당 5: 실패 (풀 고갈 - NULL 반환)
...
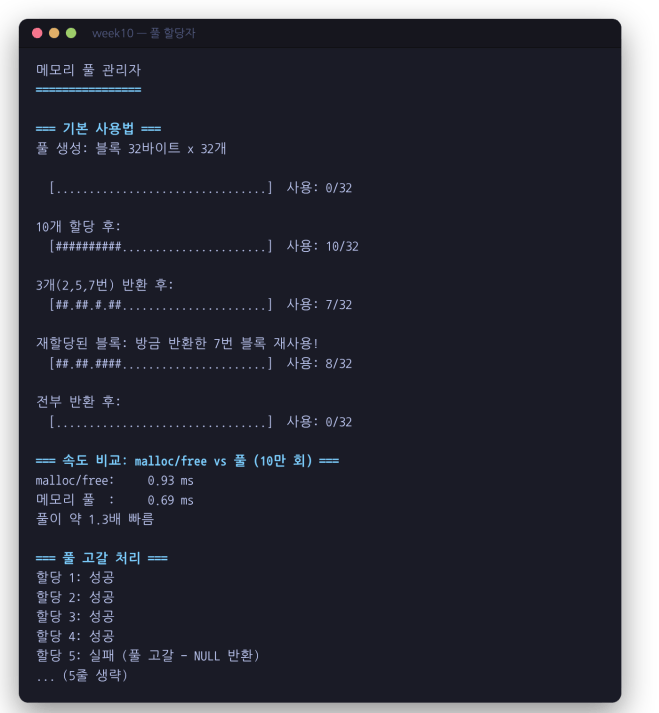
풀 할당자
- 블록 크기:
Item28바이트가 32바이트로 올림됐습니다. - 시각화:
pool_visualize는 free list 를 따라가며 빈 블록을.로 표시합니다. 블록의 번호는(주소 - 시작 주소) / 블록 크기로 계산합니다. 1.3절의 “i번째 원소의 주소”를 거꾸로 푼 것입니다. - 재사용 순서: 2, 5, 7 순서로 반환했더니 다음 할당은 7번입니다. 반환은 free list 의 머리에 넣고 할당은 머리에서 꺼내니, 가장 최근에 반환한 블록이 가장 먼저 재사용됩니다(LIFO, 11주차의 스택과 같은 순서). 방금 쓴 메모리는 캐시에 남아 있을 가능성이 높아서, 이 순서가 속도에도 유리합니다(5.2절). 그리고 이런 재사용이 반복되면 리스트 노드들의 메모리 순서가 뒤섞이는 이유도 여기서 보입니다.
- 속도: 이 측정은
-O2없이 컴파일한 것이고, 한 블록을 할당하자마자 반환하는 단순한 패턴이라malloc도 아주 빠릅니다(glibc 의malloc도 내부에 이와 비슷한 목록을 갖고 있습니다). 실제 프로그램에서 풀의 이점은 할당 순서가 복잡하고 스레드가 여럿일 때 더 커집니다. 숫자는 실행할 때마다 다르니 경향만 보세요. - 고갈: 블록 4개짜리 풀에서 5번째 할당은
NULL을 돌려줍니다.malloc과 같은 약속이라 쓰는 쪽은 똑같이NULL검사를 하면 됩니다.
확장 아이디어: 풀이 고갈되면 자동으로 새 풀을 하나 더 만들어 잇기(풀의 리스트), 여러 블록 크기를 지원하는 멀티 풀, 이중 반환 감지(반환하려는 블록이 이미 free list 에 있는지 확인).
프로젝트 3: 연결 리스트 기반 줄 에디터 (list_editor.c)
9주차의 simple_editor 를 기억하나요? 그때는 char *lines[MAX_LINES], 포인터 배열로 줄을 관리했습니다. 이번에는 이중 연결 리스트로 다시 만듭니다. 같은 프로그램을 다른 자료구조로 만들어 보면 차이가 몸으로 느껴집니다.
| 포인터 배열 (9주차) | 이중 연결 리스트 (이번 주) | |
|---|---|---|
| 줄 수 한계 | MAX_LINES 고정 |
메모리가 허락하는 만큼 |
| n번째 줄 찾기 | lines[n-1] 한 번 |
앞이나 뒤에서 걸어가기 |
| 중간에 줄 삽입 | 뒤 줄들을 전부 한 칸씩 이동 | 위치를 찾으면 포인터 4개 조작 |
실제 텍스트 에디터들도 줄이나 글자 덩어리를 리스트나 그 변형으로 관리합니다. 수만 줄짜리 파일의 중간에 한 줄을 넣을 때마다 뒤를 전부 밀 수는 없으니까요.
구조
/* 한 줄 = 노드 하나. 줄 내용은 필요한 만큼만 동적 할당 */
typedef struct Line {
    char *text;
    struct Line *prev;
    struct Line *next;
} Line;

typedef struct {
    Line  *head;
    Line  *tail;
    size_t count;        /* 줄 수 */
    int    modified;     /* 저장 안 된 변경이 있는가 */
} Buffer;
Line 이 4.7절의 DNode, Buffer 가 DList 입니다. 다른 점은 데이터가 int 가 아니라 char *text 라는 것입니다. 줄 내용은 노드 안에 고정 크기 배열로 두지 않고, 딱 필요한 만큼 따로 할당합니다.
Line *line_create(const char *text) {
    Line *line = malloc(sizeof(Line));
    if (line == NULL) return NULL;

    line->text = malloc(strlen(text) + 1);       /* 딱 필요한 만큼만 */
    if (line->text == NULL) {
        free(line);
        return NULL;
    }
    strcpy(line->text, text);
    line->prev = line->next = NULL;
    return line;
}
strlen(text) + 1: 문자열 길이에 끝의\0(1주차 6절, 4주차) 한 바이트를 더합니다.+ 1을 빼먹으면 6.3절의 범위 밖 쓰기가 됩니다.- 두 번째
malloc이 실패하면 첫 번째로 할당한line을 해제하고 돌아갑니다. 여러 번 할당하는 함수는 중간에 실패했을 때 앞서 할당한 것을 되돌려야 누수가 없습니다. - 그래서 해제할 때도 두 번 해야 합니다.
free(line->text);다음에free(line);. 순서를 바꾸면 해제된line에서text를 읽는 4.4절의 실수가 됩니다.
n번째 줄 찾기: 가까운 쪽에서 걷기
이중 리스트의 장점을 살린 디테일입니다. 앞쪽 줄이면 head 부터 전진, 뒤쪽 줄이면 tail 부터 후진합니다.
Line *buffer_find(Buffer *buf, size_t n) {
    if (n < 1 || n > buf->count) return NULL;

    Line *cur;
    if (n <= buf->count / 2) {
        cur = buf->head;                 /* 앞쪽: head부터 전진 */
        for (size_t i = 1; i < n; i++) cur = cur->next;
    } else {
        cur = buf->tail;                 /* 뒤쪽: tail부터 후진 */
        for (size_t i = buf->count; i > n; i--) cur = cur->prev;
    }
    return cur;
}
1,000줄짜리 파일에서 999번째 줄을 찾을 때, 앞에서 걸으면 998걸음, 뒤에서 걸으면 1걸음입니다. 최악의 경우가 절반으로 줄어듭니다.
발견된 버그: 빈 버퍼에 삽입
i <n> <내용> 명령은 n번 줄 앞에 삽입합니다. 원래 코드는 이랬습니다.
int buffer_insert(Buffer *buf, size_t n, const char *text) {
    if (n == buf->count + 1 || buf->count == 0) {
        return buffer_append(buf, text);
    }
    ...
“빈 버퍼면 그냥 추가”라는 조건 때문에, 빈 버퍼에 i 5 유령 줄 을 입력하면 이렇게 됐습니다.
> 5번 줄 앞에 삽입됨
>    1 | 유령 줄
5번 줄이 없는데 “5번 줄 앞에 삽입됨”이라고 알리고 1번 줄에 넣었습니다. 사용자는 거짓 메시지를 믿게 됩니다. 빈 버퍼에서 말이 되는 위치는 1번(= count + 1)뿐이므로, || buf->count == 0 을 지웠습니다. 이제는 이렇게 동작합니다.
> 삽입 실패 (사용법: i 3 내용)
> 1번 줄 앞에 삽입됨
>    1 | 첫 줄
4.7절에서 말한 “빈 리스트를 따로 시험하라” 가 이런 버그를 잡는 방법입니다.
실행해 보기
키보드로 직접 명령을 쳐도 되고, 2주차에서 배운 대로 파이프로 명령을 한꺼번에 넣을 수도 있습니다. printf 의 \n 이 Enter 역할을 합니다.
$ printf 'a 첫 번째 줄\na 두 번째 줄\ni 2 끼어든 줄\np\nd 1\np\nw memo.txt\nq\n' | ./build/list_editor
연결 리스트 기반 줄 에디터 (h: 도움말)
=====================================
> 추가됨 (1줄)
> 추가됨 (2줄)
> 2번 줄 앞에 삽입됨
>    1 | 첫 번째 줄
   2 | 끼어든 줄
   3 | 두 번째 줄
> 1번 줄 삭제됨
>    1 | 끼어든 줄
   2 | 두 번째 줄
> 'memo.txt'에 2줄 저장 완료
> 에디터 종료
$ cat -n memo.txt
     1  끼어든 줄
     2  두 번째 줄
파이프로 넣으면 우리가 친 명령은 화면에 보이지 않고 프로그램의 응답만 > 뒤에 나옵니다. 직접 칠 때는 > a 첫 번째 줄 처럼 입력이 보입니다. 저장한 파일을 다시 불러오려면 실행할 때 파일 이름을 주면 됩니다.
$ printf 'p\nq\n' | ./build/list_editor memo.txt
연결 리스트 기반 줄 에디터 (h: 도움말)
=====================================
'memo.txt'에서 2줄 불러옴
>    1 | 끼어든 줄
   2 | 두 번째 줄
> 에디터 종료
q 를 한 번 쳤는데 저장하지 않은 변경이 있으면 “정말 종료하려면 다시 q”라고 경고합니다. 위의 첫 실행에서는 w 로 저장한 뒤라 바로 끝났습니다. 파이프 입력이 끝나면(EOF) 반복문이 끝나고, 프로그램은 buffer_clear 로 모든 줄을 해제한 뒤 종료합니다. valgrind 로 확인하면 누수 0, 오류 0 입니다.
9주차의 파일 입출력(fgets, fprintf)과 이번 주의 리스트가 하나로 합쳐진, Part 1 과 Part 2 의 만남입니다. 한 가지 한계도 알아 두세요. 한 줄을 fgets 로 최대 511글자까지 읽으므로, 그보다 긴 줄이 있는 파일을 불러오면 여러 줄로 쪼개집니다.
확장 아이디어: 줄 수정 명령(e), 문자열 검색(/), 실행 취소(undo). 실행 취소는 “방금 한 명령”들을 스택에 쌓아 두었다가 거꾸로 되돌리면 됩니다. 다음 주 11주차의 예고편입니다.
8. 자주 하는 실수와 함정
이번 주에 직접 내 본 실수들을 한곳에 모았습니다. 각 항목 끝의 절 번호로 돌아가 실험을 다시 확인할 수 있습니다.
| 실수 | 증상 | 누가 잡아 주나 | 절 |
|---|---|---|---|
realloc 결과를 바로 원래 변수에 대입 |
실패 시 원본 주소를 잃음 → 누수 | valgrind (definitely lost). 컴파일러는 침묵 | 3.2 |
realloc 전에 챙긴 원소 포인터를 계속 사용 |
쓰레기 값 | GCC -Wuse-after-free, valgrind (free’d) |
3.2 |
free(cur) 후에 cur->next 읽기 |
세그멘테이션 오류 | GCC -Wuse-after-free, valgrind |
4.4 |
head 를 바꾸는 함수가 Node * 로 받음 |
리스트가 계속 비어 있음 + 누수 | valgrind 만. 컴파일러는 침묵 | 4.2 |
| 연결을 바꾸는 순서가 틀림 | 노드가 자기 자신을 가리키거나 나머지를 잃음 | valgrind (lost), 출력으로 확인 | 4.1 |
| 빈 리스트·노드 1개·첫·끝 노드를 안 시험 | 특정 경우에만 죽거나 거짓 결과 | 시험하는 사람만 | 4.7, 7 |
원형 리스트를 cur != NULL 로 순회 |
영원히 돎 | Ctrl + C |
4.8 |
| 구조체 크기를 손으로 계산 | 파일 저장·메모리 계산이 틀림 | sizeof 만 믿기 |
2 |
| 블록 크기를 정렬 단위로 맞추지 않음 | x86 에서는 멀쩡, 다른 CPU 에서 죽음 | -fsanitize=alignment |
7 |
비교 함수에서 return x - y; |
큰 값이 섞이면 정렬이 틀림 | -fsanitize=undefined |
1.3 |
| 문자열 배열 비교에서 캐스팅 한 단계 빼먹음 | 정렬이 안 됨. 경고도 없음 | 출력으로 확인 | 1.3 |
크기 제한이 있는 함수가 조용히 return |
아무 일도 안 일어남. 오류도 없음 | 시험하는 사람만 | 1.2 |
| 성능 측정 결과를 아무 데도 안 씀 | 최적화가 측정 대상을 지워 0.00ms | 결과를 출력해서 막기 | 5.1 |
“누가 잡아 주나” 칸을 보세요. 컴파일러가 잡아 주는 것은 일부이고, valgrind 와 검사기(-fsanitize)가 나머지 상당 부분을 잡고, 몇 가지는 직접 경계 조건을 시험하는 것 말고는 방법이 없습니다. 그래서 이번 주의 습관은 세 가지입니다.
-Wall -Wextra로 컴파일하고 경고 0 (1주차부터의 습관)- valgrind 로 누수 0, 오류 0
- 빈 경우, 하나인 경우, 처음과 끝을 따로 시험
마치며
이번 주는 Part 2 의 문을 여는 큰 걸음이었습니다. 처음에 던진 네 질문에 답해 봅시다.
void *는 무엇인가? “없음을 가리키는” 포인터가 아니라 “무엇을 가리키는지 말하지 않는” 주소입니다. 크기와 함께 쓰면 타입과 무관한 코드를, 함수 포인터와 함께 쓰면qsort같은 범용 함수를 만들 수 있습니다. 대신 타입 검사를 포기합니다.- int 와 포인터를 담은 구조체는 몇 바이트인가? 12가 아니라 16바이트(패딩), 그리고
malloc으로 만들면 32바이트를 차지합니다(헤더와 16바이트 단위 정렬). realloc전에 챙긴 포인터는 왜 쓰레기를 읽나?realloc은 데이터를 이사시키고 옛 자리를 해제할 수 있기 때문입니다. 원소는 포인터 대신 인덱스로 기억합니다.- 리스트 삽입은 O(1)인데 왜 배열을 쓰라고 하나? 연산 횟수만이 아니라 메모리를 읽는 방식이 속도를 정하기 때문입니다. 같은 노드도 흩어져 있으면 40배 느렸습니다. 기본값은 배열, 리스트는 조건이 맞을 때입니다.
정리하면 이렇습니다.
- 제네릭 프로그래밍:
void *+ 원소 크기 + 함수 포인터 = 타입에 얽매이지 않는 코드 - 정렬과 패딩: 구조체 크기는
sizeof로만, 큰 멤버부터 배치 - 동적 배열: size 와 capacity 분리, 2배 확장으로 분할 상환 O(1),
realloc은 임시 변수로 - 연결 리스트 3종: 단일(기본), 이중(O(1) 삭제, 양방향), 원형(순환 구조)
- 성능의 진실: 빅오만큼 캐시가 중요하다. 측정을 믿되, 측정도 의심한다
- valgrind: 누수 0, 오류 0 은 습관이다
특히 오늘 만든 generic_vector 와 연결 리스트는 앞으로 계속 재사용됩니다. 다음 주의 스택과 큐는 이 벡터와 리스트 위에 그대로 올라갑니다. 자료구조는 벽돌 쌓기입니다. 오늘 구운 벽돌이 단단해야 다음 층이 튼튼합니다.
그리고 이번 주에는 저장소의 예제 코드에서도 버그를 여러 개 찾아 고쳤습니다. 정렬을 어긴 풀 할당자, 최적화에 측정을 통째로 빼앗긴 벤치마크, 거짓 메시지를 내던 에디터, 조용히 아무것도 안 하던 swap. 전부 컴파일되고, 실행되고, 대충 보면 맞는 결과를 내던 코드였습니다. 검사기와 valgrind 와 경계 조건 시험이 없었다면 계속 숨어 있었을 겁니다. 여러분의 코드도 마찬가지입니다.
포인터 그림을 그리며 따라오셨다면, 이제 여러분은 C의 가장 어려운 고비를 넘은 것입니다. 다음 주에 만나요!
체크리스트
각 항목을 설명할 수 있으면 체크합니다.
- [ ]
void *를 캐스팅해서 역참조할 수 있고, 캐스팅이 “컴파일러에게 하는 약속”인 이유를 안다 - [ ]
void *산술이 표준 C에서 안 되는 이유와, GCC가 그것을 받아 주는 방식을 안다 - [ ] 바이트 단위 제네릭 swap 을 직접 작성할 수 있다
- [ ]
qsort의 네 매개변수와 비교 함수의 약속(음수/0/양수)을 설명할 수 있다 - [ ] 비교 함수에서
x - y가 위험한 이유를 오버플로우로 설명할 수 있다 - [ ] 문자열 배열을 정렬할 때 비교 함수가
char **를 받는 이유를 안다 - [ ] 구조체 패딩이 생기는 이유, 끝에도 패딩이 붙는 이유, 줄이는 방법(큰 멤버 먼저)을 안다
- [ ] 16바이트 노드가
malloc에서 32바이트를 차지하는 이유를 안다 - [ ]
realloc의 네 가지 동작(NULL, 제자리, 이사, 실패)을 설명할 수 있다 - [ ]
realloc결과를 임시 변수로 받는 패턴이 손에 붙었다 - [ ] size 와 capacity 의 차이, 2배 확장이 분할 상환 O(1)인 이유를 설명할 수 있다
- [ ] 단일 연결 리스트의 삽입·삭제를 “잃어버리면 안 되는 주소를 먼저” 원칙으로 설명할 수 있다
- [ ]
head를 바꾸는 함수가Node **를 받아야 하는 이유를 안다 - [ ] 리스트 전체 해제에서
next를 먼저 백업해야 하는 이유를 안다 - [ ] 리스트 뒤집기를 포인터 3개로 구현하고, 단계별 그림을 그릴 수 있다
- [ ] 이중 연결 리스트 삭제의 경계 조건 4가지를 표로 설명할 수 있다
- [ ] 원형 리스트의 순회 종료 조건이 왜 다른지 안다
- [ ] 같은 노드를 섞어 이으면 순회가 느려지는 이유를 캐시와 포인터 추적으로 설명할 수 있다
- [ ] valgrind 보고서에서 definitely/indirectly/still reachable 을 구분할 수 있다
- [ ] valgrind 보고서에서 Invalid write, Invalid read(free’d), Invalid free 를 구분하고 스택 추적을 읽을 수 있다
- [ ] 세 프로젝트를 빌드하고 valgrind 로 누수 0, 오류 0 을 확인했다
- [ ] (도전)
generic_vector에vec_find와vec_sort를 추가해 봤다 - [ ] (도전)
pool_allocator에 이중 반환 감지를 추가해 봤다
참고 자료
- The C Programming Language (K&R) — Chapter 5 (Pointers and Arrays), 6.5 (Self-referential Structures)
man 3 qsort,man 3 malloc,man 3 realloc,man 3 memmove—realloc의 반환값 규칙이 정확히 적혀 있습니다- cppreference — qsort
- cppreference — Objects and alignment
- Valgrind Quick Start Guide
- Valgrind 사용자 설명서 — Memcheck — 누수 분류(definitely/indirectly/possibly/still reachable)의 정확한 정의
- Ulrich Drepper, “What Every Programmer Should Know About Memory” — 캐시가 궁금하다면
- 다음 주차: 11주차 스택, 큐, 덱 구현