들어가며
1주차에 만든 프로그램들은 모두 정해진 글자를 그대로 찍기만 했습니다. 자기소개 프로그램도, 배너도, 몇 번을 실행하든 똑같은 화면이 나옵니다. 계산기라고 이름 붙인 프로그램조차 “계산 기능은 다음 주차에 구현됩니다”라는 안내문만 보여 줬습니다.
진짜 프로그램은 다릅니다. 계산기는 사용자가 넣은 숫자를 기억해 두었다가 더하고, 게임은 플레이어의 체력과 점수를 기억하면서 계속 바꾸고, 메모장은 우리가 친 글자를 기억해서 파일로 저장합니다. 프로그램이 “기억”을 하려면 무엇이 필요할까요? 그 답이 이번 주의 주제인 변수와 자료형입니다.
이번 주를 마치면 이런 질문에 답할 수 있게 됩니다.
- 변수는 컴퓨터 안의 어디에, 어떤 모양으로 저장될까?
int는 왜 21억까지밖에 못 셀까? 21억을 넘기면 어떻게 될까?0.1 + 0.2가0.3이 아니라는데, 정말일까? 왜 그럴까?7 / 2는 왜 3.5가 아니라 3일까?scanf에 숫자 대신abc를 넣으면 무슨 일이 생길까?scanf("%d", &age)의&를 빼먹으면 왜 프로그램이 죽을까?
1주차처럼 이번에도 모든 출력은 실제로 컴파일하고 실행한 결과입니다. 여러분의 터미널에서도 똑같이 나와야 합니다(메모리 주소처럼 실행할 때마다 바뀌는 값은 따로 표시합니다). 예제를 직접 치고, 실험을 직접 해 보세요.
이번 주차의 작업 폴더
$ mkdir -p ~/c_programming/week02
$ cd ~/c_programming/week02
$ code .
컴파일은 1주차에 정한 기본 명령을 그대로 씁니다.
$ gcc -Wall -Wextra -std=c11 -g 파일이름.c -o 파일이름
이번 주차에서 배울 내용
| 절 | 주제 | 한 줄 요약 |
|---|---|---|
| 1 | 변수 | 메모리의 한 칸에 이름을 붙인 것 |
| 2 | 자료형 | 그 칸이 몇 바이트이고, 안의 비트를 어떻게 읽을지 |
| 3 | 정수형 | char, short, int, long, unsigned 와 오버플로우 |
| 4 | 부동소수점형 | float, double 과 근사값의 함정 |
| 5 | 이름 짓기 | 쓸 수 있는 이름, 쓸 수 없는 이름, 좋은 이름 |
| 6 | printf |
서식 지정자 한 글자 한 글자의 뜻 |
| 7 | scanf |
키보드 입력과 입력 버퍼, 그리고 & |
| 8 | 상수 | #define 과 const |
| 9 | 형 변환 | 자동 변환과 강제 변환, 정수 나눗셈 |
| 10 | sizeof |
크기를 컴파일러에게 묻기 |
| 11 | 실습 | 계산기, 온도 변환기, BMI 계산기 |
1. 변수란 무엇인가?
메모리 — 번호가 붙은 칸들의 긴 줄
변수를 이해하려면 먼저 메모리(RAM) 를 떠올려야 합니다. 메모리는 아주 긴 한 줄짜리 사물함이라고 생각하면 됩니다.
주소:   ... 1000  1001  1002  1003  1004  1005  1006  1007 ...
       ┌─────┬─────┬─────┬─────┬─────┬─────┬─────┬─────┐
내용:   │  ?  │  ?  │  ?  │  ?  │  ?  │  ?  │  ?  │  ?  │
       └─────┴─────┴─────┴─────┴─────┴─────┴─────┴─────┘
- 칸 하나의 크기는 1바이트(byte) 입니다. 1바이트는 0과 1이 8개 모인 것(8비트)이라서, 0부터 255까지 256가지 값 중 하나를 담을 수 있습니다.
- 칸마다 번호가 붙어 있습니다. 이 번호를 주소(address) 라고 합니다. 8GB 메모리라면 칸이 약 80억 개 있는 셈입니다.
- 칸은 절대 비어 있지 않습니다. 항상 무언가 들어 있습니다. 그 전에 누가 쓰던 값일 수도 있고요. 이 사실이 뒤에서 “쓰레기 값”으로 돌아옵니다.
그런데 사람이 “1004번 칸부터 4칸에 나이를 넣고, 나중에 1004번 칸부터 4칸을 읽어라”라고 코드를 쓸 수는 없습니다. 번호는 외우기도 어렵고, 프로그램을 실행할 때마다 바뀌기도 합니다(곧 직접 확인합니다). 그래서 칸 몇 개에 이름을 붙여서 그 이름으로 부릅니다. 이것이 변수(variable) 입니다.
변수 = 메모리의 몇 칸 + 그 칸들에 붙인 이름 + 그 칸들을 어떻게 읽을지에 대한 약속(자료형)
세 번째 줄의 “약속”이 2절의 주제인 자료형입니다. 일단 첫 프로그램부터 봅시다.
첫 번째 변수 프로그램
variable_basic.c:
#include <stdio.h>

int main(void) {
    // 정수를 저장하는 변수 age 선언
    int age;

    // age 변수에 25라는 값을 저장 (할당)
    age = 25;

    // age 변수의 값을 출력
    printf("나이: %d세\n", age);

    // age 변수의 값을 변경
    age = 26;
    printf("내년 나이: %d세\n", age);

    return 0;
}
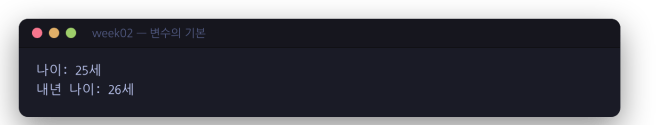
변수의 기본
$ gcc -Wall -Wextra -std=c11 -g variable_basic.c -o variable_basic
$ ./variable_basic
나이: 25세
내년 나이: 26세
1주차에는 없던 것이 세 가지 나왔습니다. 하나씩 뜯어봅시다.
int age; — 선언 (declaration)
int age;
“정수를 담을 칸을 마련하고, 거기에 age 라는 이름을 붙여라” 는 뜻입니다. 이것을 변수 선언이라고 합니다.
int: integer(정수)의 줄임말로, 이 변수에 담을 값의 종류, 즉 자료형(type) 입니다. 이 컴퓨터에서int는 4바이트, 칸 4개를 차지합니다.age: 변수 이름입니다. 규칙만 지키면 마음대로 지을 수 있습니다(5절).;: 1주차에 본 대로 문장의 끝입니다.
선언만 하고 값은 넣지 않았습니다. 그럼 지금 age 의 4칸에는 무엇이 들어 있을까요? 앞에서 “칸은 절대 비어 있지 않다”고 했습니다. 그 칸을 전에 쓰던 누군가가 남긴 값이 그대로 있습니다. 조금 뒤에 직접 들여다봅니다.
age = 25; — 대입 (assignment)
age = 25;
“25를 age 칸에 넣어라” 는 뜻입니다. 여기서 가장 중요한 것 하나.
C의
=는 “같다”가 아니라 “오른쪽 값을 왼쪽 칸에 넣어라”입니다.
수학에서 x = x + 1 은 말이 안 되는 식이지만, C에서는 “지금 x 의 값에 1을 더해서 다시 x 에 넣어라”라는 아주 흔한 문장입니다. 그래서 = 를 대입 연산자라고 부르고, 오른쪽에서 왼쪽으로 읽습니다. “같다”를 비교하는 기호는 따로 있습니다(==, 3주차).
대입의 왼쪽에는 반드시 값을 넣을 수 있는 칸이 와야 합니다. 25 = age; 는 오류입니다. 25는 칸이 아니라 그냥 숫자이기 때문입니다. 이 “칸”이라는 개념은 8절에서 #define 상수에 값을 넣으려 할 때 나오는 오류 메시지(lvalue required)로 다시 만납니다.
printf("나이: %d세\n", age); — 값을 끼워 넣어 출력
printf("나이: %d세\n", age);
1주차에 잠깐 본 서식 지정자가 드디어 제 역할을 합니다.
printf의 괄호 안에 쉼표로 구분된 값이 두 개 있습니다. 첫째는 서식 문자열"나이: %d세\n", 둘째는age입니다.printf는 서식 문자열을 앞에서부터 그대로 출력하다가%d를 만나면, 그 자리에 뒤에 준 값을 끼워 넣습니다.%d는 “정수를 10진수(decimal)로 적어라”는 뜻입니다.- 그래서
나이:+25+세+ 줄바꿈이 출력됩니다.
%d 가 두 개면 뒤에 값을 두 개 줘야 하고, 앞에서부터 순서대로 짝이 맞춰집니다. 6절에서 서식 지정자를 하나씩 다 봅니다.
age = 26; — 값 바꾸기
같은 칸에 새 값을 넣으면 이전 값은 사라집니다. 칸 하나에는 값 하나만 들어가니까요. 그래서 두 번째 printf 는 26을 출력합니다. 변수(variable)라는 이름은 이렇게 “값이 변할 수 있다”는 데서 왔습니다.
선언과 초기화를 한 번에
int age = 25; // 선언과 동시에 값을 넣는다
선언하면서 곧바로 첫 값을 넣는 것을 초기화(initialization) 라고 합니다. 이 강좌에서는 변수를 만들 때 항상 초기화하는 쪽을 권합니다. 왜 그런지 실험으로 보겠습니다.
실험: 초기화하지 않은 변수에는 무엇이 들어 있을까?
uninit.c:
#include <stdio.h>

int main(void) {
    int x;
    printf("x = %d\n", x);
    return 0;
}
1주차 5절에서 -Wall 을 설명할 때 본 코드입니다. 경고를 무시하고 실행해 보겠습니다.
$ gcc -std=c11 uninit.c -o uninit
$ ./uninit
x = 32767
$ ./uninit
x = 32766
$ gcc -std=c11 -O2 uninit.c -o uninit
$ ./uninit
x = 0
실행할 때마다 값이 다르고, 최적화 옵션을 바꾸니 또 달라졌습니다. x 의 칸에 전에 쓰던 누군가가 남긴 값이 그대로 찍힌 것입니다. 이것을 쓰레기 값(garbage value) 이라고 부릅니다. 여러분의 컴퓨터에서는 또 다른 값이 나올 수 있습니다.
제일 위험한 것은 마지막 줄입니다. -O2 로 컴파일했더니 0이 나왔습니다. 그럼 “초기화 안 해도 0이네” 하고 넘어가기 쉽지만, 그건 우연입니다. C 표준은 초기화하지 않은 지역 변수의 값을 정해 두지 않았고, 컴파일러는 이 경우 아무 값이나 써도 됩니다. 테스트할 때는 우연히 0이라 멀쩡하다가, 다른 컴퓨터나 다른 옵션에서 갑자기 엉뚱한 값이 되는 버그가 됩니다. 그래서 1주차의 -Wall 경고(‘x’ is used uninitialized)가 중요한 것입니다.
실험: 변수는 정말 메모리 어딘가에 있을까?
& 기호를 변수 이름 앞에 붙이면 그 변수의 주소를 얻을 수 있습니다. printf 의 %p 는 주소(pointer)를 출력하는 서식입니다.
address.c:
#include <stdio.h>

int main(void) {
    int age = 25;
    printf("age 의 값   : %d\n", age);
    printf("age 의 크기 : %zu 바이트\n", sizeof(age));
    printf("age 의 주소 : %p\n", (void *)&age);
    return 0;
}
$ ./address
age 의 값   : 25
age 의 크기 : 4 바이트
age 의 주소 : 0x7fffa3a5aca4
$ ./address
age 의 값   : 25
age 의 크기 : 4 바이트
age 의 주소 : 0x7ffc5a5441e4
age 는 메모리의 0x7fffa3a5aca4 번지부터 4바이트를 차지하고 있었습니다(0x 로 시작하는 것은 16진수 표기이고 6절에서 다룹니다). 그런데 두 번째 실행에서는 주소가 바뀌었습니다. 리눅스는 보안을 위해 프로그램을 실행할 때마다 메모리 배치를 무작위로 바꿉니다(1주차 7절의 pie executable 이 이것과 관련 있고, 24주차 보안 편에서 자세히 봅니다). 이게 우리가 주소 대신 이름으로 변수를 부르는 이유입니다.
sizeof 와 (void *) 는 각각 10절과 6주차에서 다룹니다. 지금은 “변수는 정말 메모리의 어느 번지에 몇 바이트로 존재한다”는 것만 눈으로 확인하면 됩니다. 이 & 기호는 7절 scanf 에서 아주 중요하게 다시 나옵니다.
2. 자료형의 세계
왜 자료형이 필요한가? — 같은 비트, 다른 뜻
메모리 칸에 들어 있는 것은 결국 0과 1뿐입니다. 예를 들어 4바이트짜리 칸에 이런 비트가 들어 있다고 합시다.
01000000 10100000 00000000 00000000
이것은 무엇일까요? 읽는 방법에 따라 다릅니다. 정수로 읽으면 1084227584이고, 실수(float)로 읽으면 5.0입니다. 같은 32개의 비트가 전혀 다른 두 값이 됩니다. 믿기 어렵다면 7절에서 scanf 로 실수를 정수 변수에 잘못 읽는 실험을 할 때 이 1084227584가 실제로 튀어나오는 것을 보게 됩니다.
그래서 C는 변수를 만들 때 반드시 자료형을 적게 합니다. 자료형은 컴파일러에게 두 가지를 알려 줍니다.
- 몇 칸(바이트)을 쓸 것인가:
char는 1칸,int는 4칸,double은 8칸. - 그 칸의 비트를 어떻게 읽을 것인가: 정수로? 음수가 있는 정수로? 실수로?
C는 이렇게 변수마다 자료형을 코드를 쓸 때 미리 정해야 하는 정적 타입(static typing) 언어입니다. Python이나 JavaScript처럼 실행 중에 알아서 정해 주지 않습니다. 대신 컴파일러가 타입을 미리 알기 때문에, 1주차에서 본 것처럼 “%d 자리에 문자열을 줬다” 같은 실수를 실행하기 전에 경고로 잡아 줄 수 있습니다.
기본 자료형 한눈에 보기
C 자료형
├── 정수형 (Integer Types)
│   ├── char          (1바이트)
│   ├── short         (2바이트)
│   ├── int           (4바이트)
│   ├── long          (64비트 리눅스에서 8바이트, 64비트 윈도우에서 4바이트)
│   └── long long     (8바이트)
│   (각각 앞에 unsigned 를 붙이면 음수 없는 버전)
│
├── 부동소수점형 (Floating-Point Types)
│   ├── float         (4바이트)
│   ├── double        (8바이트)
│   └── long double   (이 환경에서 16바이트)
│
└── 기타
    ├── _Bool         (참/거짓. C99)
    └── void          ("값 없음". 1주차 main(void) 의 그것)
주의: 괄호 안의 크기는 이 강좌의 환경(x86-64 리눅스, GCC 13) 에서의 값입니다. C 표준은 “
char는 1바이트”, “short≤int≤long≤long long“, “int는 최소 16비트” 같은 최소한의 규칙만 정하고, 정확한 크기는 컴파일러와 플랫폼이 정합니다. 그래서 크기를 외우지 말고 10절의sizeof로 확인하는 습관을 들이세요.
_Bool은 이름이 어색하지만,#include <stdbool.h>를 하면bool,true,false라는 자연스러운 이름으로 쓸 수 있습니다.
3. 정수형 자료형
먼저, 비트로 수를 세는 법
정수형을 이해하려면 “비트 몇 개로 수를 몇 개까지 셀 수 있나”를 알아야 합니다. 어렵지 않습니다.
| 비트 수 | 만들 수 있는 조합 | 계산 |
|---|---|---|
| 1 | 0, 1 |
2가지 |
| 2 | 00, 01, 10, 11 |
2 × 2 = 4가지 |
| 3 | 000 ~ 111 |
2 × 2 × 2 = 8가지 |
| 8 (1바이트) | 00000000 ~ 11111111 |
2⁸ = 256가지 |
| 16 (2바이트) | 2¹⁶ = 65,536가지 | |
| 32 (4바이트) | 2³² = 4,294,967,296가지 (약 43억) |
비트가 하나 늘 때마다 가짓수가 두 배가 됩니다. 이제 이 가짓수를 어떻게 나눠 쓰느냐가 문제입니다.
- 음수를 안 쓰면(
unsigned): 0부터 시작해서 전부 양수에 씁니다. 8비트면 0 ~ 255. - 음수도 쓰면(
signed): 절반은 음수, 절반은 0과 양수에 씁니다. 8비트면 -128 ~ 127. 양수 쪽이 하나 적은 이유는 0이 양수 쪽 자리를 하나 차지하기 때문입니다.
음수를 비트로 나타내는 방법을 2의 보수(two’s complement) 라고 합니다. 3주차에 비트 연산자를 배우면 변수 안의 비트를 직접 들여다볼 수 있습니다. 지금은 “같은 8비트라도 signed면 -128~127, unsigned면 0~255″만 기억하세요.
char — 가장 작은 정수형, 그리고 문자
char 는 이름이 character(문자)에서 왔지만, 정체는 1바이트짜리 정수입니다. 컴퓨터는 글자를 저장할 수 없으니, 글자마다 번호를 매겨서 번호를 저장합니다. 이 번호표가 ASCII 코드입니다. 'A' 는 65, 'a' 는 97, 숫자 글자 '0' 은 48번입니다.
char_example.c:
#include <stdio.h>
#include <limits.h>   // CHAR_MIN, CHAR_MAX, UCHAR_MAX

int main(void) {
    char letter = 'A';        // 문자로 사용
    char number = 65;         // 숫자로 사용 (ASCII 코드 65 = 'A')

    printf("letter: %c\n", letter);    // %c: 문자로 출력
    printf("letter (as number): %d\n", letter);  // %d: 숫자로 출력

    printf("number: %d\n", number);
    printf("number (as char): %c\n", number);

    // char의 범위 - 숫자를 외워 적지 않고 <limits.h> 에게 묻는다.
    // char 가 signed 인지 unsigned 인지는 플랫폼마다 다르기 때문이다.
    printf("\nchar 범위 (이 컴퓨터에서):\n");
    printf("최소값: %d\n", CHAR_MIN);
    printf("최대값: %d\n", CHAR_MAX);

    // unsigned char (0~255)
    unsigned char positive = 200;
    printf("\nunsigned char: %u (최대 %d)\n", positive, UCHAR_MAX);

    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g char_example.c -o char_example && ./char_example
letter: A
letter (as number): 65
number: 65
number (as char): A

char 범위 (이 컴퓨터에서):
최소값: -128
최대값: 127

unsigned char: 200 (최대 255)
코드 읽기
'A'와"A"는 다릅니다. 작은따옴표'A'는 글자 하나, 즉 숫자 65입니다. 큰따옴표"A"는 1주차에 본 문자열로,'A'와 끝 표시'\0'두 바이트짜리 덩어리입니다.char변수에는 작은따옴표를 씁니다.letter와number는 메모리 안에서 완전히 똑같습니다. 둘 다 칸 하나에 65가 들어 있습니다. 차이는printf에게 어떻게 보여 달라고 했는지뿐입니다.%c는 “번호에 해당하는 글자를 그려라”,%d는 “숫자로 적어라”. 2절에서 말한 “같은 비트, 다른 해석”의 가장 간단한 예입니다.#include <limits.h>: 1주차에stdio.h가printf의 사전이었듯,limits.h는 “이 컴퓨터에서 각 정수형의 최솟값·최댓값”을 적어 둔 사전입니다.CHAR_MIN,CHAR_MAX는 그 안에 정의된 이름입니다. 범위를-128,127처럼 숫자로 직접 적지 않고 이 이름을 쓰면, 다른 컴퓨터에서 컴파일해도 그 컴퓨터의 진짜 범위가 나옵니다.%u: unsigned 정수를 출력하는 서식입니다.
char 의 부호는 정해져 있지 않습니다. 그냥 char 가 signed (−128~127)인지 unsigned (0~255)인지는 C 표준이 정하지 않고 플랫폼이 정합니다. 우리 환경(x86-64 리눅스)에서는 signed 라서 위처럼 −128~127이 나왔지만, 라즈베리파이 같은 ARM 리눅스에서는 unsigned 라서 0~255가 나옵니다. 그래서 1바이트 숫자를 다룰 때는 signed char 나 unsigned char 로 부호를 분명히 적는 것이 안전합니다.
실험: 문자로 산수를 할 수 있을까?
char 가 숫자라면 더하고 뺄 수도 있지 않을까요?
#include <stdio.h>

int main(void) {
    char c = 'A';
    printf("%c + 1 = %c (%d)\n", c, c + 1, c + 1);
    printf("'a' - 'A' = %d\n", 'a' - 'A');
    printf("'7' - '0' = %d\n", '7' - '0');
    return 0;
}
$ ./charmath
A + 1 = B (66)
'a' - 'A' = 32
'7' - '0' = 7
'A' + 1은 66, 즉'B'입니다. ASCII 표에서 알파벳이 순서대로 붙어 있기 때문입니다.- 소문자와 대문자는 항상 32 차이입니다. 그래서
c - 32로 소문자를 대문자로 바꿀 수 있습니다(실제로는toupper함수를 씁니다. 4주차). '7' - '0'은 7입니다. 글자'7'(55번)을 숫자 7로 바꾸는 가장 흔한 방법입니다. 사용자가 입력한 글자를 숫자로 바꿀 때 4주차에 계속 씁니다.
터미널에서 man ascii 를 치면 ASCII 표 전체를 볼 수 있습니다.
실험: char 에 200을 넣으면?
sc.c:
#include <stdio.h>
int main(void) {
    char c = 200;
    signed char s = -1;
    unsigned char u = 300;
    printf("char c = 200   -> %d\n", c);
    printf("unsigned 300   -> %d\n", u);
    printf("signed char -1 -> %d\n", s);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 sc.c -o sc
sc.c: In function ‘main’:
sc.c:5:23: warning: unsigned conversion from ‘int’ to ‘unsigned char’ changes value from ‘300’ to ‘44’ [-Woverflow]
    5 |     unsigned char u = 300;
      |                       ^~~
$ ./sc
char c = 200   -> -56
unsigned 300   -> 44
signed char -1 -> -1
char c = 200이 −56이 됐습니다. 200은 비트로11001000인데, signedchar는 맨 앞 비트가 1이면 음수로 읽습니다. 그렇게 읽은 값이 −56입니다(200 − 256 = −56). 칸에 들어간 비트는 같은데 읽는 방법 때문에 값이 바뀐 것입니다. 경고도 나지 않았다는 점에 주의하세요.unsigned char u = 300은 44가 됐습니다. 1바이트에는 255까지밖에 안 들어가니, 넘치는 부분이 잘려서 300 − 256 = 44만 남았습니다. 이번에는 GCC가 “300이 44로 바뀐다”고 정확히 경고해 줬습니다.
int — 가장 많이 사용하는 정수형
int 는 기본 정수형입니다. 특별한 이유가 없으면 정수는 int 로 씁니다. CPU가 가장 빠르게 다루는 크기로 정해지는 것이 관례라서, 대부분의 계산에서 가장 자연스러운 선택입니다.
int_example.c:
#include <stdio.h>
#include <limits.h>   // INT_MIN, INT_MAX

int main(void) {
    int score = 95;
    int temperature = -15;
    int population = 1000000;

    printf("점수: %d\n", score);
    printf("온도: %d도\n", temperature);
    printf("인구: %d명\n", population);

    // int의 크기와 범위
    printf("\nint 정보:\n");
    printf("크기: %zu 바이트\n", sizeof(int));
    printf("비트: %zu 비트\n", sizeof(int) * 8);

    // 범위도 외워 적지 않고 <limits.h> 에게 묻는다
    printf("최소값: %d\n", INT_MIN);
    printf("최대값: %d\n", INT_MAX);

    return 0;
}
$ ./int_example
점수: 95
온도: -15도
인구: 1000000명

int 정보:
크기: 4 바이트
비트: 32 비트
최소값: -2147483648
최대값: 2147483647
코드 읽기
int population = 1000000;: 코드에 숫자를 쓸 때 쉼표(1,000,000)는 쓸 수 없습니다. C에서 쉼표는 다른 뜻이 있기 때문입니다.sizeof(int): “int가 몇 바이트인지”를 컴파일러에게 묻는 연산자입니다(10절). 4가 나왔고, 1바이트는 8비트이니* 8해서 32비트입니다.- 범위 −2,147,483,648 ~ 2,147,483,647: 앞의 표에서 32비트는 약 43억 가지였습니다. 그것을 절반씩 음수와 0·양수에 나눠 쓰니 약 ±21억입니다.
21억이면 충분히 커 보이지만, 세계 인구(약 80억)나 1초에 1씩 세는 시계의 68년 치를 담기에도 부족합니다. 실제로 1970년부터 초를 세는 32비트 시간은 2038년 1월에 넘칩니다. 이것을 “2038년 문제”라고 부릅니다.
short, long, long long — 크기가 다른 정수형
integer_sizes.c:
#include <stdio.h>

int main(void) {
    short small_number = 32000;
    int normal_number = 2000000000;
    long big_number = 3000000000L;        // L suffix
    long long huge_number = 9000000000000000000LL;  // LL suffix

    printf("short: %hd (크기: %zu bytes)\n",
           small_number, sizeof(short));
    printf("int: %d (크기: %zu bytes)\n",
           normal_number, sizeof(int));
    printf("long: %ld (크기: %zu bytes)\n",
           big_number, sizeof(long));
    printf("long long: %lld (크기: %zu bytes)\n",
           huge_number, sizeof(long long));

    return 0;
}
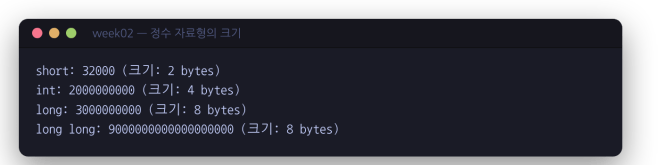
정수 자료형의 크기
$ ./integer_sizes
short: 32000 (크기: 2 bytes)
int: 2000000000 (크기: 4 bytes)
long: 3000000000 (크기: 8 bytes)
long long: 9000000000000000000 (크기: 8 bytes)
코드 읽기
- 숫자 뒤의
L,LL: 코드에 직접 쓴 숫자(리터럴, literal)에도 자료형이 있습니다. 그냥3000000000이라고 쓰면 컴파일러가 알아서 들어갈 수 있는 타입을 고르지만,L을 붙이면 “이 숫자는long이다”,LL은 “long long이다”라고 분명히 밝힙니다. 음수 없는 수에는U(unsigned)를 붙입니다. 소문자l도 되지만 숫자1과 헷갈리니 대문자를 씁니다. - 서식의
h,l,ll:%d는int용입니다. 다른 크기의 정수를 찍을 때는 앞에 크기 표시를 붙입니다.%hd는 half, 즉short,%ld는 long,%lld는 long long 입니다. 크기가 맞지 않으면-Wall이 경고합니다. - printf 괄호가 두 줄에 걸쳐 있습니다. 1주차에서 “문자열은 한 줄 안에서 열고 닫아야 한다”고 했지만, 쉼표로 구분된 값들 사이에서는 얼마든지 줄을 바꿔도 됩니다. 한 줄이 너무 길 때 이렇게 씁니다.
long 과 long long 이 둘 다 8바이트로 나왔습니다. 그럼 둘은 같은 걸까요? 우리 환경에서만 같습니다.
long의 크기에 주의: 64비트 리눅스(LP64 모델)에서는long이 8바이트라 위 출력처럼long과long long이 같습니다. 하지만 64비트 윈도우(LLP64 모델)에서는long이 4바이트입니다. 같은 코드가 윈도우에서는long big_number = 3000000000L;에서 값이 넘칩니다. 8바이트가 반드시 필요하면long long이나,<stdint.h>의int64_t(이름에 크기가 박혀 있는 타입으로, 뒤쪽 주차에서 파일 크기나 시간을 다룰 때 자주 씁니다)를 쓰세요.
%zu 는 무엇일까요? sizeof 가 돌려주는 값은 int 도 long 도 아닌 size_t 라는 전용 타입입니다(“크기를 담는 타입”). 그 전용 서식이 %zu 입니다. z 가 size_t 크기를, u 가 unsigned 를 뜻합니다. sizeof 의 결과를 찍을 때는 항상 %zu 를 쓰세요.
이 컴퓨터의 정수 범위 전체
limits.h 에 있는 값을 한꺼번에 찍어 봅시다. float.h 는 4절에서 쓸 실수형 정보가 든 사전입니다. limits.c:
#include <stdio.h>
#include <limits.h>
#include <float.h>

int main(void) {
    printf("CHAR_BIT=%d CHAR_MIN=%d CHAR_MAX=%d\n", CHAR_BIT, CHAR_MIN, CHAR_MAX);
    printf("SHRT_MIN=%d SHRT_MAX=%d USHRT_MAX=%d\n", SHRT_MIN, SHRT_MAX, USHRT_MAX);
    printf("INT_MIN=%d INT_MAX=%d UINT_MAX=%u\n", INT_MIN, INT_MAX, UINT_MAX);
    printf("LONG_MAX=%ld LLONG_MAX=%lld ULLONG_MAX=%llu\n", LONG_MAX, LLONG_MAX, ULLONG_MAX);
    printf("FLT_DIG=%d DBL_DIG=%d LDBL_DIG=%d\n", FLT_DIG, DBL_DIG, LDBL_DIG);
    printf("FLT_MAX=%e DBL_MAX=%e FLT_EPSILON=%e DBL_EPSILON=%e\n", FLT_MAX, DBL_MAX, FLT_EPSILON, DBL_EPSILON);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 limits.c -o limits && ./limits
CHAR_BIT=8 CHAR_MIN=-128 CHAR_MAX=127
SHRT_MIN=-32768 SHRT_MAX=32767 USHRT_MAX=65535
INT_MIN=-2147483648 INT_MAX=2147483647 UINT_MAX=4294967295
LONG_MAX=9223372036854775807 LLONG_MAX=9223372036854775807 ULLONG_MAX=18446744073709551615
FLT_DIG=6 DBL_DIG=15 LDBL_DIG=18
FLT_MAX=3.402823e+38 DBL_MAX=1.797693e+308 FLT_EPSILON=1.192093e-07 DBL_EPSILON=2.220446e-16
아래 두 줄은 4절에서 봅니다. %llu 는 unsigned long long 용 서식입니다.
| 자료형 | 크기 | 범위 |
|---|---|---|
signed char |
1 | −128 ~ 127 |
unsigned char |
1 | 0 ~ 255 |
short |
2 | −32,768 ~ 32,767 |
unsigned short |
2 | 0 ~ 65,535 |
int |
4 | 약 −21억 ~ 21억 |
unsigned int |
4 | 0 ~ 약 43억 |
long, long long |
8 | 약 ±922경 |
unsigned long long |
8 | 0 ~ 약 1845경 |
CHAR_BIT=8 은 “1바이트가 8비트”라는 뜻입니다. 너무 당연해 보이지만, 옛날에는 1바이트가 9비트인 컴퓨터도 있어서 표준이 이것까지 이름으로 정해 두었습니다.
자료형 선택 가이드
- 특별한 이유가 없으면:
int - 21억을 넘을 수 있으면(파일 크기, 밀리초 시간, 큰 합계):
long long - 메모리를 아껴야 하는 큰 배열:
short나char(4주차 이후) - 음수가 절대 없고 비트 자체를 다룰 때:
unsigned(아래에서 설명하는 함정에 주의)
unsigned — 음수 없는 정수
unsigned_example.c:
#include <stdio.h>

int main(void) {
    // signed vs unsigned
    int signed_num = -100;
    unsigned int unsigned_num = 100;

    printf("signed int: %d\n", signed_num);
    printf("unsigned int: %u\n", unsigned_num);

    // unsigned는 범위가 2배
    unsigned int max_unsigned = 4294967295U;  // 약 43억
    printf("unsigned int 최대값: %u\n", max_unsigned);

    // 주의: unsigned에 음수를 넣으면?
    unsigned int wrong = -1;
    printf("unsigned에 -1을 넣으면: %u\n", wrong);  // 매우 큰 수가 됨!

    return 0;
}
$ ./unsigned_example
signed int: -100
unsigned int: 100
unsigned int 최대값: 4294967295
unsigned에 -1을 넣으면: 4294967295
unsigned는 음수를 쓰지 않는 대신 최댓값이 약 두 배가 됩니다(주석의 “범위가 2배”는 정확히는 “최댓값이 2배”입니다. 담을 수 있는 값의 개수는 똑같이 2³²개입니다).-1을 넣었더니 4294967295가 됐습니다. −1을 비트로 나타내면11111111 11111111 11111111 11111111(32개 모두 1)입니다. 이것을 unsigned 로 읽으면 가장 큰 수, 2³² − 1 = 4,294,967,295입니다. 또 “같은 비트, 다른 해석”입니다.
실험: unsigned 가 위험한 이유
unsigned 는 음수가 없으니 안전해 보이지만, 초보자에게는 오히려 함정이 많습니다.
#include <stdio.h>

int main(void) {
    int a = -1;
    unsigned int b = 1;
    if (a < b)
        printf("-1 < 1 : 참\n");
    else
        printf("-1 < 1 : 거짓 (?!)\n");
    return 0;
}
if 는 3주차에 배우지만, 뜻은 “괄호 안이 참이면 위, 아니면 else 아래를 실행”입니다.
$ gcc -Wall -Wextra -std=c11 sgn.c -o sgn
sgn.c: In function ‘main’:
sgn.c:5:11: warning: comparison of integer expressions of different signedness: ‘int’ and ‘unsigned int’ [-Wsign-compare]
    5 |     if (a < b)
      |           ^
$ ./sgn
-1 < 1 : 거짓 (?!)
−1이 1보다 작지 않다고 합니다. signed 와 unsigned 를 비교하면 C는 둘을 unsigned 로 맞춘 다음 비교하는데(9절의 자동 형 변환), 그러면 −1이 4294967295로 바뀌어 버립니다. -Wextra 가 “부호가 다른 정수를 비교한다”고 경고해 준 것이 바로 이 함정입니다. 이 경고는 절대 무시하지 마세요.
오버플로우 — 정수가 넘치면 어떻게 될까?
int 의 최댓값에 1을 더하면 어떻게 될까요?
overflow.c:
#include <stdio.h>
#include <limits.h>

int main(void) {
    int big = INT_MAX;
    printf("INT_MAX     = %d\n", big);
    big = big + 1;
    printf("INT_MAX + 1 = %d\n", big);
    unsigned int u = 0;
    u = u - 1;
    printf("0u - 1      = %u\n", u);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 overflow.c -o overflow && ./overflow
INT_MAX     = 2147483647
INT_MAX + 1 = -2147483648
0u - 1      = 4294967295
21억에 1을 더했더니 −21억이 됐습니다. 자동차 주행거리계가 999999에서 000000으로 돌아가는 것과 비슷합니다. 이것을 오버플로우(overflow, 넘침) 라고 합니다. 경고도 없었습니다.
그런데 두 줄은 성격이 다릅니다.
- unsigned 의 넘침(
0u - 1) 은 C 표준이 “끝에서 반대쪽 끝으로 돌아간다(wrap around)”고 정해 둔 동작입니다. 항상 4294967295가 나옵니다. - signed 의 넘침(
INT_MAX + 1) 은 C 표준이 정하지 않은 동작(undefined behavior, UB) 입니다. 지금은 −2147483648이 나왔지만, 컴파일러는 “signed 는 절대 넘치지 않는다”고 가정하고 최적화해도 되기 때문에, 옵션에 따라 전혀 다른 결과가 나오거나 조건문이 이상하게 동작할 수 있습니다.
“정의되지 않은 동작”은 C에서 가장 무서운 말입니다. 실행해 보니 괜찮았다고 해서 괜찮은 게 아니라는 뜻이기 때문입니다. 다행히 GCC에는 실행 중에 이런 동작을 잡아 주는 기능이 있습니다. -fsanitize=undefined 옵션을 붙여 보세요.
$ gcc -std=c11 -fsanitize=undefined overflow.c -o overflow && ./overflow
INT_MAX     = 2147483647
overflow.c:7:9: runtime error: signed integer overflow: 2147483647 + 1 cannot be represented in type 'int'
INT_MAX + 1 = -2147483648
“7번째 줄에서 signed 정수 오버플로우: 2147483647 + 1 은 int 로 나타낼 수 없다”고 실행하는 순간 알려 줍니다. 이런 옵션을 새니타이저(sanitizer) 라고 부르고, 24주차 보안 프로그래밍에서 본격적으로 다시 만납니다. 숫자가 이상하게 나오는 프로그램을 만나면 한 번 붙여서 돌려 보는 습관을 들이세요.
컴파일할 때 이미 넘치는 것이 보이는 경우에는 GCC가 경고도 해 줍니다.
int x = 2147483647 + 1;
$ gcc -Wall -Wextra -std=c11 cof.c -o cof
cof.c:3:24: warning: integer overflow in expression of type ‘int’ results in ‘-2147483648’ [-Woverflow]
변수를 거쳐 계산하면 컴파일러가 값을 미리 알 수 없어서 경고하지 못합니다. 앞의 overflow.c 가 그랬습니다. 그러니 큰 값이 나올 수 있는 계산은 처음부터 long long 으로 하는 것이 가장 확실한 예방법입니다. 9절에서 그 방법을 봅니다.
4. 부동소수점형 자료형
float 와 double
소수점이 있는 수(실수)를 저장하는 타입입니다. 부동소수점(floating point) 이라는 이름은 “소수점이 떠다닌다”는 뜻인데, 3.14도 314000000도 0.000314도 “유효숫자 314 + 소수점 위치”로 저장하기 때문입니다. 과학에서 쓰는 3.14 × 10⁸ 같은 표기와 같은 원리입니다.
float_example.c:
#include <stdio.h>

int main(void) {
    float pi_f = 3.14159f;              // f suffix (float)
    double pi_d = 3.141592653589793;    // 기본값 (double)
    long double pi_ld = 3.141592653589793238L;  // L suffix

    printf("float PI: %.5f (크기: %zu bytes)\n",
           pi_f, sizeof(float));
    printf("double PI: %.15f (크기: %zu bytes)\n",
           pi_d, sizeof(double));
    printf("long double PI: %.18Lf (크기: %zu bytes)\n",
           pi_ld, sizeof(long double));

    // 정밀도 차이
    printf("\n정밀도 비교:\n");
    printf("float:       %.20f\n", pi_f);
    printf("double:      %.20f\n", pi_d);
    printf("long double: %.20Lf\n", pi_ld);

    // 과학적 표기법
    double speed_of_light = 2.998e8;  // 2.998 × 10^8
    printf("\n빛의 속도: %e m/s\n", speed_of_light);
    printf("빛의 속도: %.0f m/s\n", speed_of_light);

    return 0;
}
$ ./float_example
float PI: 3.14159 (크기: 4 bytes)
double PI: 3.141592653589793 (크기: 8 bytes)
long double PI: 3.141592653589793238 (크기: 16 bytes)

정밀도 비교:
float:       3.14159011840820312500
double:      3.14159265358979311600
long double: 3.14159265358979323808

빛의 속도: 2.998000e+08 m/s
빛의 속도: 299800000 m/s
코드 읽기
- 리터럴 뒤의
f,L: 소수점이 있는 숫자를 그냥 쓰면(3.14) C는double로 봅니다.float로 쓰려면3.14159f처럼f를 붙이고,long double은L을 붙입니다. %.5f:%f는 실수를 소수점 표기로 찍는 서식이고, 가운데.5는 “소수점 아래 5자리까지” 라는 뜻입니다(정밀도). 아무것도 안 쓰면 6자리입니다.long double은%Lf로 찍습니다.2.998e8:e8은 “× 10⁸”입니다. 과학적 표기법이고,%e로 찍으면 다시 이 모양(2.998000e+08)으로 나옵니다.%.0f로 찍으면 소수점 없이 보통 숫자로 나옵니다.
정밀도 비교 줄을 자세히 보세요
소스에는 분명 3.14159f 라고 적었는데, 20자리까지 뽑아 보면 3.14159011840820312500 입니다. 3.14159 가 아니라 3.1415901184... 가 저장되어 있습니다. double 도 16번째 자리쯤부터 진짜 원주율(3.14159265358979323846…)과 달라집니다.
왜 우리가 적은 숫자가 그대로 저장되지 않을까요? 컴퓨터는 2진수로 소수를 저장하기 때문입니다. 10진수에서 1/3 = 0.3333… 이 끝나지 않듯이, 2진수에서는 0.1 같은 평범한 수가 끝나지 않습니다. 그래서 정해진 비트 수에서 잘라 가장 가까운 값을 저장합니다.
fl.c:
#include <stdio.h>

int main(void) {
    printf("0.1 = %.20f\n", 0.1);
    printf("0.5 = %.20f\n", 0.5);
    float f = 16777217;
    printf("float 16777217 -> %.1f\n", f);
    double d = 16777217;
    printf("double 16777217 -> %.1f\n", d);
    return 0;
}
%.20f 로 소수점 아래 20자리까지 찍어서 실제로 저장된 값을 드러냅니다.
$ ./fl
0.1 = 0.10000000000000000555
0.5 = 0.50000000000000000000
float 16777217 -> 16777216.0
double 16777217 -> 16777217.0
0.5는 2진수로 딱 떨어지는 수(1/2)라서 정확하게 저장됩니다.0.1은 2진수로 끝나지 않아서, 저장된 값이0.10000000000000000555...입니다. 아주 조금 큽니다.float에 16,777,217을 넣었더니 16,777,216이 됐습니다. 정수인데도요!float는 유효숫자를 24비트(약 7자리)밖에 담지 못해서, 2²⁴ = 16,777,216을 넘는 정수부터는 홀수를 표현할 수 없습니다.double은 유효숫자가 53비트라 괜찮습니다.
“유효숫자 몇 자리”도 <float.h> 에 이름으로 정해져 있습니다. 3절의 limits 프로그램이 찍은 마지막 두 줄이 그것입니다.
FLT_DIG=6 DBL_DIG=15 LDBL_DIG=18
FLT_MAX=3.402823e+38 DBL_MAX=1.797693e+308 FLT_EPSILON=1.192093e-07 DBL_EPSILON=2.220446e-16
| 자료형 | 크기 | 믿을 수 있는 10진 유효숫자 (_DIG) |
가장 큰 값 (_MAX) |
|---|---|---|---|
float |
4바이트 | 6자리 | 약 3.4 × 10³⁸ |
double |
8바이트 | 15자리 | 약 1.8 × 10³⁰⁸ |
long double |
16바이트 (실제 사용 10바이트) | 18자리 |
long double 은 16바이트를 차지하지만, x86-64 에서는 그중 10바이트(80비트)만 실제 값에 씁니다. 나머지는 메모리 정렬을 위한 빈 공간입니다. 그래서 크기는 double 의 두 배인데 정밀도는 3자리 정도만 늡니다.
실수형 선택 가이드
- 특별한 이유가 없으면:
double.float의 6자리는 생각보다 금방 부족합니다. - 메모리를 아껴야 하는 아주 큰 데이터(그래픽, 머신러닝 가중치 등):
float long double은 플랫폼마다 크기와 정밀도가 달라서 이 강좌에서는 거의 쓰지 않습니다.
부동소수점의 함정
저장부터 근사값이니, 근사값끼리 계산하면 오차가 쌓입니다. 이것이 가장 크게 문제가 되는 곳이 == 로 두 실수가 같은지 비교할 때입니다. “왜 내 조건문이 참이 안 되지?”로 초보자가 가장 자주 데는 함정입니다.
float_precision.c:
#include <stdio.h>
#include <math.h>

int main(void) {
    // 부동소수점은 정확하지 않다!
    // double로 0.1 + 0.2 를 계산하면 0.3과 정확히 같지 않다.
    double a = 0.1;
    double b = 0.2;
    double c = a + b;

    printf("0.1 + 0.2 = %.20f\n", c);
    printf("0.3과 == 로 같은가? %s\n", (c == 0.3) ? "예" : "아니오");

    // float는 정밀도가 더 낮아 오차 자체는 더 크지만,
    // 반올림 방향에 따라 == 비교가 "우연히" 참이 되어 버그를 숨기기도 한다.
    // 즉, 겉보기에 같아 보여 오히려 더 위험하다.
    float fa = 0.1f;
    float fb = 0.2f;
    float fc = fa + fb;

    printf("\n(float) 0.1 + 0.2 = %.20f\n", fc);
    printf("(float) 0.3과 == 로 같은가? %s\n", (fc == 0.3f) ? "예" : "아니오");

    // 큰 수와 작은 수의 연산 - 작은 값이 흡수되어 사라진다
    float big = 1000000.0f;
    float small = 0.000001f;
    float result = big + small;

    printf("\n1000000 + 0.000001 = %.10f\n", result);
    printf("정확한 값은 1000000.000001이어야 함\n");

    // 해결책: == 대신 epsilon(허용 오차) 이내인지 비교
    double epsilon = 0.0000001;

    printf("\nepsilon 비교: |(0.1+0.2) - 0.3| < epsilon ? %s\n",
           (fabs(c - 0.3) < epsilon) ? "예" : "아니오");

    return 0;
}
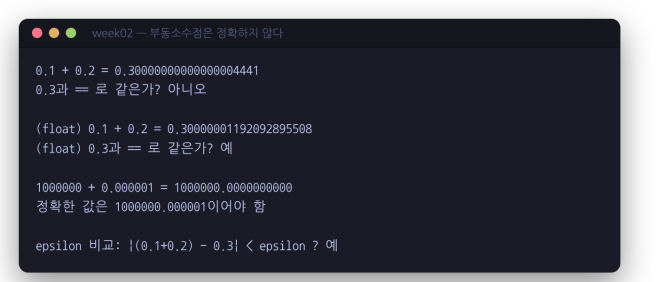
부동소수점은 정확하지 않다
$ ./float_precision
0.1 + 0.2 = 0.30000000000000004441
0.3과 == 로 같은가? 아니오

(float) 0.1 + 0.2 = 0.30000001192092895508
(float) 0.3과 == 로 같은가? 예

1000000 + 0.000001 = 1000000.0000000000
정확한 값은 1000000.000001이어야 함

epsilon 비교: |(0.1+0.2) - 0.3| < epsilon ? 예
처음 보는 문법 두 가지
(c == 0.3) ? "예" : "아니오":조건 ? 참일_때 : 거짓일_때모양의 조건 연산자입니다. 조건이 참이면"예", 거짓이면"아니오"가 되어%s자리에 들어갑니다. 3주차에 자세히 배웁니다.==는 “같은가?”를 묻는 비교 연산자입니다(1절의=와 다릅니다).fabs(...): 절댓값(absolute value)을 구하는 함수로, 앞의 f 는 실수(floating) 버전이라는 뜻입니다.#include <math.h>가 그 사전입니다.man 3 fabs로 확인해 보세요.
출력을 한 줄씩
double의0.1 + 0.2는0.3과 같지 않습니다. 0.1도 0.2도 0.3도 모두 근사값이고, 근사값 두 개를 더한 결과가 0.3의 근사값과 마지막 자리에서 어긋났습니다.==는 비트 하나까지 정확히 같은지 보기 때문에 “아니오”입니다. 이것은 C의 문제가 아니라 2진 부동소수점을 쓰는 모든 언어(Python, JavaScript, Java…)에서 똑같이 일어납니다.float에서는 같은 계산이 “예”로 나옵니다. 오차가 없어서가 아니라(출력 첫 줄을 보면0.30000001...입니다),float의 낮은 정밀도로 반올림한 결과가0.3f의 근사값과 우연히 딱 맞아떨어졌을 뿐입니다. 이런 어쩌다 맞는 경우가 오히려 더 위험합니다. 테스트할 때는 멀쩡하다가, 값이 조금만 달라지면 갑자기 거짓이 되는 버그가 됩니다.- 큰 수 + 작은 수:
1000000.0f에0.000001f를 더해도 그대로입니다.float의 유효숫자는 6~7자리인데, 1000000.000001은 13자리가 필요합니다. 작은 값이 유효숫자 밖으로 밀려나 흡수(absorption) 되었습니다. - 해결책(epsilon 비교): 정확히 같은지 묻지 말고, 차이의 절댓값이 아주 작은 허용 오차(epsilon)보다 작은지를 물으면 “예”가 나옵니다.
epsilon 은 얼마로 할까? 이 예제의 0.0000001 은 설명을 위해 고른 값입니다. 사실 적당한 허용 오차는 다루는 값의 크기에 따라 다릅니다. 값이 100만 단위라면 0.0000001은 너무 작고(float 로는 그 차이를 표현할 수도 없습니다), 값이 0.000001 단위라면 너무 큽니다. 실무에서는 두 값의 크기에 비례하는 오차를 쓰는데, 지금은 “실수는 == 로 비교하지 않는다“는 원칙만 확실히 기억하세요.
교훈
- 부동소수점은 근사값입니다. 적은 그대로 저장되지 않습니다.
==로 직접 비교하지 마세요.float에서 우연히 참이 나오더라도 믿으면 안 됩니다.fabs(a - b) < epsilon처럼 차이가 충분히 작은지 확인합니다.- 정확해야 하는 계산은 정수로 합니다. 예를 들어 돈은 “12.50달러”를
double로 두지 말고 “1250센트”를long long으로 둡니다. 은행 프로그램이 원 단위를 정수로 다루는 이유입니다.
-lm은 언제 필요할까?math.h의 함수들은libm이라는 수학 라이브러리에 들어 있습니다. 1주차 7절에서printf가libc.so.6에 있었던 것처럼요. 그런데libm은 기본으로 링크되지 않아서,sqrt(제곱근) 같은 함수를 쓰면 링크 단계에서 이렇게 실패합니다.#include <stdio.h> #include <math.h> int main(void) { double x = 2.0; printf("%f\n", sqrt(x)); return 0; }$ gcc -Wall -std=c11 sq.c -o sq /usr/bin/ld: /tmp/cc8MSClV.o: in function `main': sq.c:(.text+0x23): undefined reference to `sqrt' collect2: error: ld returned 1 exit status $ gcc -Wall -std=c11 sq.c -o sq -lm $ ./sq 1.4142141주차 10절에서 배운 링크 단계의
undefined reference입니다. 끝에-lm(library m,libm을 링크하라)을 붙이면 해결됩니다. 위의float_precision.c는-lm없이도 컴파일됩니다.fabs처럼 아주 간단한 함수는 GCC가 직접 기계어 몇 줄로 바꿔 넣어서(내장 함수, builtin) 라이브러리를 부르지 않기 때문입니다. 어떤 함수가 그런지 외울 필요는 없으니,math.h를 쓰면-lm을 붙인다고 기억하세요. 이번 주 예제의Makefile도 모든 프로그램에-lm을 붙입니다.
5. 변수 명명 규칙
변수 이름은 마음대로 지을 수 있다고 했지만, 컴파일러가 이름으로 받아들이는 규칙이 있습니다. 그리고 규칙 안에서도 좋은 이름과 나쁜 이름이 있습니다.
올바른 변수 이름
naming_rules.c:
#include <stdio.h>

int main(void) {
    // ✅ 올바른 변수 이름 (모두 아래에서 사용됨)
    int age = 25;
    int student_count = 30;
    int maxScore = 100;
    int _internal_value = 42;
    int value2 = 50;

    printf("=== 올바른 변수 이름 ===\n");
    printf("age = %d\n", age);
    printf("student_count = %d\n", student_count);
    printf("maxScore = %d\n", maxScore);
    printf("_internal_value = %d\n", _internal_value);
    printf("value2 = %d\n", value2);

    // ❌ 잘못된 변수 이름 (컴파일 에러)
    // int 2value = 50;        // 숫자로 시작 불가
    // int student-count = 30; // 하이픈(-) 사용 불가
    // int int = 10;           // 예약어 사용 불가
    // int my value = 20;      // 공백 사용 불가

    // 변수 이름은 대소문자 구분
    int Value = 10;
    int value = 20;
    printf("\nValue = %d, value = %d (서로 다른 변수)\n", Value, value);

    // 의미 있는 이름 사용 권장
    int score = 100;        // ✅ 명확한 의미
    int student_age = 20;   // ✅ 명확

    printf("\n명확한 변수 이름의 중요성:\n");
    printf("점수: %d\n", score);
    printf("학생 나이: %d\n", student_age);

    return 0;
}
$ ./naming_rules
=== 올바른 변수 이름 ===
age = 25
student_count = 30
maxScore = 100
_internal_value = 42
value2 = 50

Value = 10, value = 20 (서로 다른 변수)

명확한 변수 이름의 중요성:
점수: 100
학생 나이: 20
Value 와 value 가 서로 다른 변수로 공존합니다. 1주차에 배운 대로 C는 대소문자를 구분하기 때문입니다. 가능하다는 것이지 권하는 것은 아닙니다. 읽는 사람이 반드시 헷갈립니다.
이 예제는 선언한 변수를 모두 출력에 씁니다. 선언만 하고 쓰지 않는 변수가 있으면
-Wall이unused variable경고를 내기 때문입니다(1주차 10절 에러 5). 예제라도 경고 0개를 지키는 습관입니다.
규칙을 어기면 컴파일러는 뭐라고 할까?
주석 처리된 네 줄을 하나씩 살려서 컴파일해 봅시다. 오류 메시지가 생각보다 엉뚱해서, 한 번 봐 두지 않으면 나중에 원인을 못 찾습니다.
숫자로 시작하는 이름
names.c:3:9: error: invalid suffix "value" on integer constant
    3 |     int 2value = 50;
      |         ^~~~~~
“정수 상수 뒤에 value 라는 잘못된 접미사가 붙었다”고 합니다. 컴파일러는 2value 를 이름이 아니라 숫자 2 에 무언가가 붙은 것으로 읽었습니다. 3절에서 본 3000000000L 처럼 숫자 뒤에는 L, U 같은 접미사가 올 수 있으니까요. 이름이 숫자로 시작하면 안 되는 이유가 바로 이것입니다. 숫자와 구분할 수 없기 때문입니다.
하이픈이 들어간 이름
names2.c:3:16: error: expected ‘=’, ‘,’, ‘;’, ‘asm’ or ‘__attribute__’ before ‘-’ token
    3 |     int student-count = 30;
      |                ^
names2.c:3:17: error: ‘count’ undeclared (first use in this function)
- 는 빼기입니다. 컴파일러는 student - count 로 읽고, “count 라는 변수는 선언된 적이 없다”고 합니다. 여러 단어를 이을 때는 _ 를 씁니다.
예약어를 이름으로
names3.c:3:9: error: two or more data types in declaration specifiers
    3 |     int int = 10;
      |         ^~~
“자료형이 두 개 이상 적혔다.” int 는 C가 이미 정해 둔 단어라서 이름으로 쓸 수 없습니다. 이런 단어를 예약어(keyword) 라고 합니다. C11의 예약어는 44개입니다.
auto      break     case      char      const     continue  default   do
double    else      enum      extern    float     for       goto      if
inline    int       long      register  restrict  return    short     signed
sizeof    static    struct    switch    typedef   union     unsigned  void
volatile  while     _Alignas  _Alignof  _Atomic   _Bool     _Complex  _Generic
_Imaginary _Noreturn _Static_assert _Thread_local
외울 필요는 없습니다. VS Code 에서 예약어는 다른 색으로 칠해지니, 이름을 쳤는데 색이 바뀌면 예약어입니다.
명명 규칙 정리
쓸 수 있는 글자
- 영어 알파벳 (
a–z,A–Z) - 숫자 (
0–9). 단 첫 글자는 안 됩니다 - 밑줄 (
_)
쓸 수 없는 것
- 숫자로 시작하는 이름
- 공백,
-,+,*,/,@,#같은 기호 - 예약어
호기심: 한글 이름은 될까? 해 보면 됩니다.
    int 나이 = 25;
    printf("%d\n", 나이);
놀랍게도 GCC 13은
-Wpedantic을 줘도 경고 없이 컴파일하고 25를 출력합니다. C99부터 표준이 유니코드 글자를 이름에 쓰는 길을 열어 두었고, GCC 10부터 UTF-8로 쓴 이름을 그대로 받아 주기 때문입니다.price$처럼$가 들어간 이름도 GCC 확장으로 됩니다. 하지만 쓰지 마세요. 다른 컴파일러나 도구, 다른 나라 개발자와 함께 쓰는 코드에서 문제가 생깁니다. 이름은 영어로, 설명은 한글 주석으로 하는 것이 관례입니다.밑줄로 시작하는 이름에 대해: 예제의
_internal_value는 문법적으로 괜찮습니다. 다만_다음에 대문자가 오거나(_Value) 밑줄이 두 개(__value)로 시작하는 이름은 컴파일러와 표준 라이브러리가 쓰려고 예약해 둔 이름입니다. 1주차에 본__FILE__,__GNUC__가 그런 이름이죠. 겹치면 이상한 오류가 날 수 있으니, 우리가 만드는 이름은 밑줄로 시작하지 않는 편이 안전합니다.
좋은 이름 짓기
컴파일러는 a 도 student_age 도 똑같이 받아들입니다. 이름은 사람을 위한 것입니다.
| 나쁜 이름 | 좋은 이름 | 이유 |
|---|---|---|
a, x, tmp2 |
age, total_price |
무엇이 들어 있는지 이름이 말해 준다 |
h |
height_cm |
단위까지 넣으면 cm 와 m 를 헷갈리는 버그가 줄어든다 |
flag |
is_valid |
참/거짓 변수는 is_, has_ 로 시작하면 읽기 쉽다 |
여러 단어를 잇는 방법은 두 가지가 많이 쓰입니다.
    int student_count;    // snake_case: C 와 리눅스 커널의 전통
    int studentCount;     // camelCase: Java, JavaScript 에서 흔함
이 강좌는 C 전통을 따라 snake_case 를 씁니다. 무엇을 고르든 한 프로그램 안에서는 한 가지만 쓰는 것이 가장 중요합니다.
6. printf의 서식 지정자
1절부터 %d, %c, %f, %zu 가 계속 나왔습니다. 이제 한자리에 모아서 제대로 봅시다.
printf 는 값을 그냥 찍는 게 아니라, 서식 지정자가 말하는 타입대로 값을 해석해서 글자로 바꿉니다. 그래서 값의 실제 타입과 서식이 어긋나면 엉뚱한 글자가 찍힙니다. 1주차 10절에서 %d 자리에 문자열을 준 경고를 봤죠.
서식 지정자의 생김새
서식 지정자는 % 로 시작해서 변환 문자 하나로 끝나고, 그 사이에 선택적인 부분들이 들어갑니다.
%  [플래그]  [폭]  [.정밀도]  [크기]  변환문자
%     -       10      .2                 f
%     0        5                         d
%                                 ll     d
| 부분 | 예 | 뜻 |
|---|---|---|
| 플래그 | - 0 + # |
- 왼쪽 정렬, 0 빈자리를 0으로, + 양수에도 + 표시, # 진법 표시(0x) |
| 폭 | 10 |
최소 몇 칸을 차지할지. 모자라면 공백으로 채운다 |
| .정밀도 | .2 |
실수는 소수점 아래 자릿수, 문자열은 최대 글자 수 |
| 크기 | h l ll L z |
값의 크기. short, long, long long, long double, size_t |
| 변환 문자 | d f s … |
어떤 타입을 어떤 모양으로 |
%-10.2f 를 읽어 보면 “실수(f)를, 소수점 아래 2자리(.2)로, 최소 10칸(10)에, 왼쪽 정렬(-)”입니다. 조합만 알면 처음 보는 서식도 읽을 수 있습니다.
다양한 출력 형식
printf_formats.c:
#include <stdio.h>

int main(void) {
    int integer = 42;
    unsigned int uint = 42;
    float floating = 3.14159f;
    double dbl = 2.718281828;
    char character = 'A';
    char *string = "Hello";

    printf("=== 정수 출력 ===\n");
    printf("%%d: %d\n", integer);          // 10진수
    printf("%%i: %i\n", integer);          // 10진수 (d와 동일)
    printf("%%u: %u\n", uint);             // unsigned 10진수
    printf("%%o: %o\n", integer);          // 8진수
    printf("%%x: %x\n", integer);          // 16진수 (소문자)
    printf("%%X: %X\n", integer);          // 16진수 (대문자)

    printf("\n=== 실수 출력 ===\n");
    printf("%%f: %f\n", floating);         // 기본 (소수점 6자리)
    printf("%%.2f: %.2f\n", floating);     // 소수점 2자리
    printf("%%.10f: %.10f\n", floating);   // 소수점 10자리
    printf("%%e: %e\n", dbl);              // 과학적 표기법 (소문자)
    printf("%%E: %E\n", dbl);              // 과학적 표기법 (대문자)
    printf("%%g: %g\n", floating);         // 자동 선택 (f 또는 e)

    printf("\n=== 문자 출력 ===\n");
    printf("%%c: %c\n", character);        // 문자
    printf("%%s: %s\n", string);           // 문자열

    printf("\n=== 특수 기능 ===\n");
    printf("%%p: %p\n", (void*)&integer);  // 포인터 주소
    printf("%%%%: %%\n");                  // % 기호 자체

    printf("\n=== 폭과 정렬 ===\n");
    printf("%%5d: %5d\n", integer);        // 최소 5자리 (오른쪽 정렬)
    printf("%%-5d: %-5d끝\n", integer);    // 최소 5자리 (왼쪽 정렬)
    printf("%%05d: %05d\n", integer);      // 0으로 채움
    printf("%%10.2f: %10.2f\n", floating); // 전체 10자리, 소수점 2자리

    return 0;
}
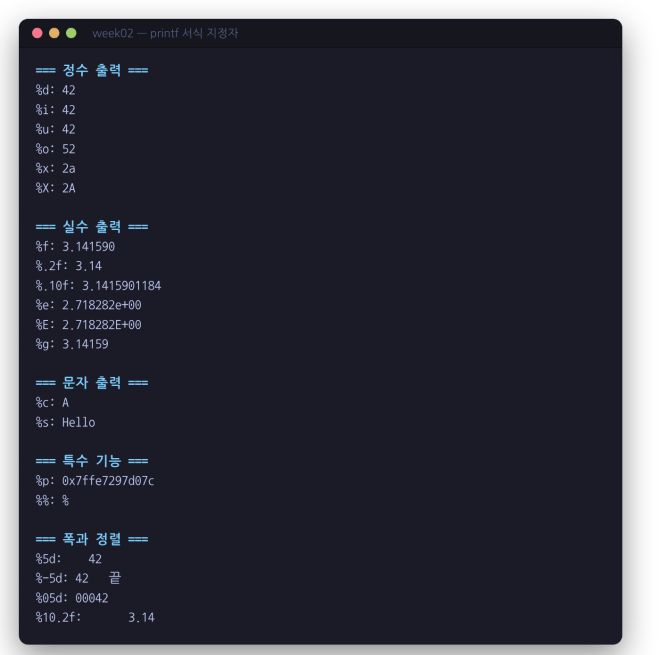
printf 서식 지정자
$ ./printf_formats
=== 정수 출력 ===
%d: 42
%i: 42
%u: 42
%o: 52
%x: 2a
%X: 2A

=== 실수 출력 ===
%f: 3.141590
%.2f: 3.14
%.10f: 3.1415901184
%e: 2.718282e+00
%E: 2.718282E+00
%g: 3.14159

=== 문자 출력 ===
%c: A
%s: Hello

=== 특수 기능 ===
%p: 0x7ffca4e27eac
%%: %

=== 폭과 정렬 ===
%5d:    42
%-5d: 42   끝
%05d: 00042
%10.2f:       3.14
%p 줄의 주소는 1절에서 본 것처럼 실행할 때마다 다릅니다. 나머지는 여러분의 결과와 똑같아야 합니다.
코드 읽기
printf("%%d: %d\n", integer);: 1주차 6절에서 본 대로%%는%글자 하나를 찍습니다. 그래서 앞의%%d는 글자%d로 찍히고, 뒤의%d만 서식 지정자로 동작합니다. 출력 줄마다 “어떤 서식을 썼는지”를 보여 주려는 장치입니다.char *string = "Hello";: 문자열을 담는 변수입니다.*가 붙은 이유는 4주차(문자열)와 6주차(포인터)에서 배웁니다. 지금은 “%s로 찍는 문자열”로만 보세요.
출력 읽기 — 같은 42, 다른 모습
%o: 52: 8진수(octal)입니다. 42 = 5 × 8 + 2 이므로52. 1주차 2절의chmod 755가 8진수였습니다. 권한 세 자리가 각각 0~7인 이유가 이것입니다.%x: 2a: 16진수(hexadecimal)입니다. 16진수는 0~9 다음에 a(10)~f(15)를 씁니다. 42 = 2 × 16 + 10 이므로2a. 16진수는 4비트가 정확히 한 자리라서, 1주차 7절의 기계어(48 89 e5)나 1절의 메모리 주소처럼 비트를 다루는 곳에서 늘 씁니다.%X: 2A: 대문자 16진수입니다.
출력 읽기 — 실수
%f: 3.141590: 정밀도를 안 주면 소수점 아래 6자리입니다. 저장된 값은3.14159011...이니(4절) 6자리에서 반올림하면3.141590입니다.%.10f: 3.1415901184: 10자리까지 찍으니 4절의 근사값이 드러납니다.%e: 2.718282e+00: 과학적 표기법(exponent)입니다.e+00은 × 10⁰.%g: 3.14159: general.%f와%e중 더 짧은 쪽을 고르고, 끝의 쓸모없는 0을 지웁니다.
출력 읽기 — 폭과 정렬
%5d: 42: 최소 5칸. 42는 2칸이니 앞에 공백 3칸을 채워 오른쪽 정렬합니다.%-5d: 42 끝:-플래그로 왼쪽 정렬. 공백이 뒤에 붙은 게 보이도록끝을 찍었습니다.%05d: 00042:0플래그로 공백 대신 0을 채웁니다. 날짜(09)나 번호(00042)에 씁니다.%10.2f: 3.14: 소수점 아래 2자리로 만든3.14(4칸)를 10칸에 오른쪽 정렬했습니다.
폭 지정은 1주차 6절에서 탭(\t)으로 표를 맞추려다 실패한 문제를 푸는 도구입니다. %-10s 로 이름을, %5d 로 숫자를 찍으면 줄이 반듯하게 맞습니다(단, 한글은 두 칸이라 1주차 8절에서 본 문제가 여기서도 생깁니다).
실험: 서식 지정자 더 알아보기
gfmt.c:
#include <stdio.h>

int main(void) {
    printf("%%g: %g | %g | %g | %g\n", 3.14159, 100000.0, 1000000.0, 0.0001234);
    printf("%%f: %f | %f\n", 1000000.0, 0.0001234);
    printf("%%.3g: %.3g\n", 3.14159);
    printf("[%%8.3f] [%8.3f]\n", 3.14159);
    printf("[%%-8d] [%-8d]\n", 42);
    printf("[%%+d] [%+d] [%+d]\n", 42, -42);
    printf("[%%x] [%x] [%%#x] [%#x] [%%#o] [%#o]\n", 255, 255, 8);
    printf("[%%s] [%s] [%%10s] [%10s] [%%.3s] [%.3s]\n", "Hello", "Hello", "Hello");
    int n = printf("abc\n");
    printf("printf 가 돌려준 값: %d\n", n);
    return 0;
}
$ ./gfmt
%g: 3.14159 | 100000 | 1e+06 | 0.0001234
%f: 1000000.000000 | 0.000123
%.3g: 3.14
[%8.3f] [   3.142]
[%-8d] [42      ]
[%+d] [+42] [-42]
[%x] [ff] [%#x] [0xff] [%#o] [010]
[%s] [Hello] [%10s] [     Hello] [%.3s] [Hel]
abc
printf 가 돌려준 값: 4
%g의 선택: 100000은 그대로, 1000000은1e+06으로 바뀌었습니다. 기본 정밀도(6자리)로 나타낼 수 없을 만큼 커지면 과학적 표기로 넘어갑니다. 반대로%f는 0.0001234를0.000123으로 잘라 버렸는데,%g는0.0001234를 온전히 보여 줍니다.%.3g:g에서 정밀도는 소수점 아래가 아니라 유효숫자입니다. 3자리3.14.%8.3f:3.142는 반올림된 값입니다.printf는 자를 때 반올림합니다.%+d: 양수에도+를 붙입니다. 온도 변화처럼 부호가 중요한 값에 씁니다.%#x,%#o:#은 진법 표시를 붙입니다. 16진수는0x, 8진수는0. C 코드에 숫자를 쓸 때도 똑같이0xff,010으로 씁니다. 그래서 C에서010은 10이 아니라 8입니다. 숫자 앞에 0을 함부로 붙이면 안 되는 이유입니다.%.3s: 문자열에서 정밀도는 최대 글자 수입니다.Hel까지만.printf도 값을 돌려줍니다. 출력한 바이트 수입니다."abc\n"은 4바이트라 4. 1주차의main처럼 함수는 일을 하고 값을 돌려줄 수 있고, 우리는 그 값을 변수에 받을 수 있습니다.printf의 반환값은 잘 쓰지 않지만, 7절scanf의 반환값은 아주 중요합니다.
실험: 서식과 타입이 어긋나면?
#include <stdio.h>

int main(void) {
    int num = 42;
    printf("%f\n", num);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 pfi.c -o pfi
pfi.c: In function ‘main’:
pfi.c:5:14: warning: format ‘%f’ expects argument of type ‘double’, but argument 2 has type ‘int’ [-Wformat=]
    5 |     printf("%f\n", num);
      |             ~^     ~~~
      |              |     |
      |              |     int
      |              double
      |             %d
$ ./pfi
0.000000
42를 넘겼는데 0.000000 이 찍힙니다. printf 는 %f 를 보고 “실수가 넘어왔겠지” 하고 실수를 받는 자리에서 값을 꺼냈는데, 우리는 정수를 정수 자리에 넣었습니다(1주차 7절의 호출 규약에서 정수와 실수는 전달되는 자리가 다릅니다). 그래서 42와 전혀 상관없는 값이 나왔습니다. 경고가 이미 %d 로 고치라고 알려 줬습니다. “int 를 %f 로 찍으면 자동으로 42.0이 되겠지”는 통하지 않습니다. 그렇게 하려면 9절의 형 변환을 써야 합니다.
서식 지정자 치트시트
| 서식 | 넘겨주는 값의 타입 | 출력 모양 |
|---|---|---|
%d, %i |
int (그리고 char, short — 아래 참고) |
10진 정수 |
%u |
unsigned int |
부호 없는 10진 정수 |
%o |
unsigned int |
8진수 |
%x, %X |
unsigned int |
16진수 |
%hd / %ld / %lld |
short / long / long long |
10진 정수 |
%zu |
size_t (sizeof 의 결과) |
부호 없는 10진 정수 |
%f (= %lf) |
double (그리고 float — 아래 참고) |
소수점 표기 |
%e, %E |
double |
과학적 표기 |
%g, %G |
double |
짧은 쪽 자동 |
%Lf |
long double |
소수점 표기 |
%c |
int (문자 번호) |
문자 한 개 |
%s |
문자열 (char *) |
문자열 |
%p |
주소 (void *) |
16진 주소 |
%% |
없음 | % 글자 |
char 와 float 는 왜 표에 따로 없을까? printf 처럼 넘기는 값의 개수가 정해지지 않은 함수(가변 인자 함수)에 값을 넘기면, C는 작은 타입을 자동으로 키워서 넘깁니다. char 와 short 는 int 로, float 는 double 로 바뀌어 넘어갑니다. 이것을 기본 인자 승격(default argument promotion) 이라고 합니다. 그래서 printf 입장에서는 float 를 받을 일이 없고, %f 하나로 float 와 double 을 모두 찍습니다. C99부터는 %lf 도 printf 에서 %f 와 똑같이 동작합니다.
%f와%lf에 대한 흔한 오해: “%lf는scanf에서만 쓴다”는 말이 돌아다니는데, 정확하지 않습니다.printf에서는%f와%lf가 같고, 둘 다 써도 됩니다. 구분이 강제되는 쪽은scanf입니다.scanf는 값이 아니라 주소를 받기 때문에 승격이 일어나지 않고,float칸에는%f,double칸에는 반드시%lf를 써야 합니다. 틀리면 무슨 일이 생기는지 다음 절에서 직접 봅니다.
7. scanf – 사용자 입력 받기
드디어 프로그램이 사용자에게 값을 받습니다. scanf 는 scan formatted, printf 의 반대 방향입니다. printf 가 “값을 서식대로 글자로 만들어 화면에 쓰기”라면, scanf 는 “키보드로 들어온 글자를 서식대로 읽어서 값으로 바꾸기”입니다.
키보드 입력은 어떻게 프로그램에 도착할까?
scanf 를 쓰기 전에, 우리가 키를 누를 때 무슨 일이 일어나는지 알아야 합니다. 이걸 모르면 뒤에 나올 “버퍼 문제”가 마법처럼 보입니다.
- 키를 누르면 글자가 곧바로 프로그램으로 가지 않습니다. 터미널이 한 줄을 모아 둡니다. 그래서
Backspace로 고칠 수 있습니다. Enter를 누르는 순간, 그 줄 전체가 줄바꿈 문자\n까지 포함해서 프로그램의 입력 버퍼(buffer) 라는 대기열로 들어갑니다.scanf는 이 대기열에서 필요한 만큼만 글자를 꺼내 갑니다. 꺼내 가지 않은 글자는 그대로 대기열에 남아서 다음 입력 함수를 기다립니다.
25 를 치고 Enter 를 누르면 대기열에는 이렇게 들어갑니다.
[ '2' ][ '5' ][ '\n' ]
3번이 핵심입니다. 남은 글자는 사라지지 않습니다. 이 한 문장이 이 절의 거의 모든 문제를 설명합니다.
입력하는 글자가 화면에 보이는 이유: 우리가 치는 글자는 터미널이 보여 주는 것(echo)이지 프로그램이 출력하는 게 아닙니다. 아래 실행 예시에서
25,175.5같은 입력값이 보이는 것은 그 때문입니다. 1주차 6절의\r실험처럼, 화면에 보이는 것과 프로그램이 주고받는 것은 다를 수 있습니다.
기본 사용법
scanf_basic.c:
#include <stdio.h>

int main(void) {
    int age;
    float height;
    char grade;

    printf("나이를 입력하세요: ");
    scanf("%d", &age);

    printf("키를 입력하세요 (cm): ");
    scanf("%f", &height);

    printf("학점을 입력하세요 (A-F): ");
    scanf(" %c", &grade);  // 주의: 앞에 공백!

    printf("\n=== 입력한 정보 ===\n");
    printf("나이: %d세\n", age);
    printf("키: %.1fcm\n", height);
    printf("학점: %c\n", grade);

    return 0;
}
$ ./scanf_basic
나이를 입력하세요: 25
키를 입력하세요 (cm): 175.5
학점을 입력하세요 (A-F): A

=== 입력한 정보 ===
나이: 25세
키: 175.5cm
학점: A
코드 읽기
printf("나이를 입력하세요: ");: 끝에\n이 없습니다. 그래서 커서가 같은 줄에 남고, 사용자는 안내문 바로 옆에 입력합니다. 1주차 5절의\n실험을 기억하나요? 여기서는 일부러 뺀 것입니다.scanf("%d", &age);: “입력 버퍼에서 10진 정수(%d)를 읽어서,age의 주소(&age)에 넣어라.” 서식 지정자는printf와 거의 같습니다.scanf("%f", &height);:height가float라서%f.double이었다면 반드시%lf입니다(6절 마지막 상자).scanf(" %c", &grade);:%c앞에 공백이 있습니다. 이 공백이 왜 필요한지는 조금 뒤 “버퍼 문제”에서 직접 봅니다.%.1fcm:%.1f(소수점 1자리) 바로 뒤에 글자cm가 붙은 것입니다.%.1fc라는 서식이 아닙니다. 서식 지정자는 변환 문자(f)에서 끝납니다.
& 는 왜 붙일까?
printf("%d", age) 에는 & 가 없는데, scanf("%d", &age) 에는 왜 붙을까요?
printf 는 age 의 값(25)만 알면 됩니다. 찍기만 하니까요. 하지만 scanf 는 age 칸에 값을 넣어야 합니다. 그런데 C에서 함수에 변수를 넘기면 값이 복사되어 넘어갑니다. scanf(age) 라고 쓰면 scanf 는 “지금 age 에 들어 있는 쓰레기 값의 사본”을 받을 뿐, 원래 age 칸이 어디 있는지 모릅니다. 그래서 1절에서 본 & 로 age 칸의 주소를 넘겨서 “여기에 넣어 줘”라고 알려 주는 것입니다. 택배를 받으려면 물건이 아니라 주소를 알려 줘야 하는 것과 같습니다.
“함수에 값의 사본이 넘어간다”와 “주소를 넘기면 함수가 원래 칸을 바꿀 수 있다”는 5주차 함수와 6주차 포인터의 핵심 주제입니다. 지금은 scanf 로 숫자나 문자를 읽을 때는 변수 앞에 & 만 확실히 기억하세요.
실험: & 를 빼면?
#include <stdio.h>

int main(void) {
    int num = 0;
    scanf("%d", num);
    printf("%d\n", num);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 noamp.c -o noamp
noamp.c: In function ‘main’:
noamp.c:5:13: warning: format ‘%d’ expects argument of type ‘int *’, but argument 2 has type ‘int’ [-Wformat=]
    5 |     scanf("%d", num);
      |            ~^   ~~~
      |             |   |
      |             |   int
      |             int *
$ ./noamp
5
세그멘테이션 오류 (코어 덤프됨)
경고가 먼저 알려 줍니다. “%d 는 int *(정수의 주소)를 원하는데 int(정수 값)가 왔다.” 무시하고 실행해서 5를 넣으면 프로그램이 죽습니다. scanf 는 num 의 값 0을 주소로 믿고 “0번지”에 5를 쓰려고 했습니다. 0번지는 어떤 프로그램도 쓸 수 없는 곳이라, 운영체제가 프로그램을 강제로 끝냈습니다. 이것이 C 프로그래머가 가장 많이 보는 오류, 세그멘테이션 오류(segmentation fault) 입니다. 영어 환경에서는 Segmentation fault (core dumped) 로 나옵니다. echo $? 로 보면 종료 코드는 139입니다. 6주차 포인터에서 이 오류를 수없이 만나게 됩니다.
실험: 서식 지정자를 틀리면?
int 칸에 %f 로 읽어 보겠습니다.
    int num = 0;
    scanf("%f", &num);
    printf("%d\n", num);
$ gcc -Wall -Wextra -std=c11 fint.c -o fint
fint.c:4:13: warning: format ‘%f’ expects argument of type ‘float *’, but argument 2 has type ‘int *’ [-Wformat=]
$ ./fint
5
1084227584
5를 넣었는데 1084227584 가 나왔습니다. 2절에서 예고한 바로 그 숫자입니다. scanf 는 %f 를 보고 5를 실수 5.0의 비트(01000000 10100000 00000000 00000000)로 만들어 num 칸에 넣었고, printf 는 그 비트를 정수로 읽었습니다. “같은 비트, 다른 해석”을 우리 손으로 만들어 낸 셈입니다.
double 을 %f 로 읽으면(흔한 실수입니다) 이렇게 됩니다.
    double d = 0;
    scanf("%f", &d);
    printf("d = %f\n", d);
$ ./dlf
3.5
d = 0.000000
3.5가 0이 됐습니다. scanf 는 %f 를 보고 4바이트짜리 float 비트를 8바이트 double 칸의 앞 4바이트에만 썼습니다. 나머지 4바이트는 0 그대로라, double 로 읽으면 0에 아주 가까운 값이 됩니다. 경고는 %lf 로 고치라고 알려 줬습니다(%lf 라고 제안하는 줄이 메시지 끝에 나옵니다).
교훈: scanf 의 경고는 거의 전부 “실행하면 틀린 값이 들어가거나 죽는다”는 뜻입니다. 절대 무시하지 마세요.
scanf의 반환값 — 읽기에 성공했나?
printf 가 값을 돌려주듯, scanf 도 값을 돌려줍니다. 이번에는 아주 중요한 값입니다. 성공적으로 읽어서 변수에 넣은 항목의 개수입니다.
scanf_return.c:
#include <stdio.h>

int main(void) {
    int num;
    int result;

    printf("정수를 입력하세요: ");
    result = scanf("%d", &num);

    if (result == 1) {
        printf("성공! 입력한 숫자: %d\n", num);
    } else {
        printf("오류! 정수가 아닌 값을 입력했습니다.\n");
        printf("반환값: %d\n", result);
    }

    return 0;
}
if 와 else 는 3주차에 배우지만, 뜻은 “괄호 안이 참이면 첫 번째 { }, 아니면 두 번째 { } 를 실행”입니다. == 는 “같은가?”입니다. 여러 가지를 넣어 봅시다.
| 입력 | 출력 | 반환값의 뜻 |
|---|---|---|
42 |
성공! 입력한 숫자: 42 |
1개 읽음 |
abc |
오류! ... / 반환값: 0 |
0개 읽음. abc 는 정수가 아니다 |
(아무것도 없이 Ctrl + D) |
오류! ... / 반환값: -1 |
입력이 끝났다(EOF) |
42abc |
성공! 입력한 숫자: 42 |
숫자가 끝나는 곳까지만 읽음 |
7 |
성공! 입력한 숫자: 7 |
앞의 공백은 건너뜀 |
3.9 |
성공! 입력한 숫자: 3 |
. 에서 멈춤. 반올림이 아니다 |
몇 가지를 짚어 봅시다.
abc는 실패(0)입니다. 그리고 이때num에는 아무것도 들어가지 않습니다.num을 초기화하지 않았으니 쓰레기 값 그대로입니다. 반환값을 확인하지 않고num을 쓰면 1절의 쓰레기 값을 쓰게 됩니다.Ctrl + D는 1주차 2절에서 “입력 끝 알리기”라고 했던 키입니다. 입력이 끝나면scanf는EOF(End Of File)를 돌려줍니다.EOF는stdio.h에 정의된 음수이고, 이 환경에서는 −1입니다. 파일에서 읽거나 파이프로 입력을 줄 때(echo 42 | ./scanf_return) 입력의 끝이 바로 이것입니다.42abc와3.9는 “성공”입니다.%d는 숫자가 이어지는 데까지만 읽고 멈춥니다. 그리고 멈춘 곳 뒤의abc나.9는 입력 버퍼에 그대로 남습니다. 다음scanf가 그걸 먼저 읽게 됩니다. 앞에서 말한 “남은 글자는 사라지지 않는다”입니다.
그래서 규칙은 하나입니다. scanf 의 반환값을 항상 확인하세요. 11절의 실습 프로젝트들도 이 규칙을 지키도록 고쳐 두었습니다.
scanf의 버퍼 문제
scanf 에서 초보자를 가장 많이 당황시키는 문제입니다. %d 로 숫자를 읽은 직후에 %c 로 문자를 읽으면, 사용자가 문자를 입력할 기회도 없이 프로그램이 넘어가 버립니다.
scanf_buffer_problem.c:
/*
 * scanf_buffer_problem.c - scanf의 입력 버퍼 문제
 * 2주차: 변수와 자료형
 *
 * %d로 숫자를 읽은 뒤 곧바로 %c로 문자를 읽으면,
 * 앞서 Enter로 남은 개행문자('\n')를 %c가 먼저 읽어 버린다.
 */

#include <stdio.h>

int main(void) {
    printf("╔════════════════════════════════════════╗\n");
    printf("║      scanf 입력 버퍼 문제 시연         ║\n");
    printf("╚════════════════════════════════════════╝\n\n");

    int age;
    char initial;

    printf("나이를 입력하세요: ");
    scanf("%d", &age);

    printf("이름의 첫 글자를 입력하세요: ");
    scanf("%c", &initial);  // 문제 발생! 남아 있던 '\n'을 읽는다

    printf("\n나이: %d\n", age);
    printf("첫 글자: %c\n", initial);
    printf("첫 글자의 ASCII 코드: %d\n", initial);

    if (initial == '\n') {
        printf("→ 개행문자('\\n', 코드 10)를 읽었습니다. 버퍼 문제 발생!\n");
    }

    return 0;
}
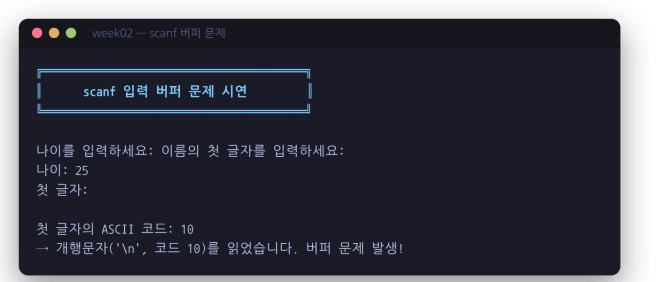
scanf 버퍼 문제
25 를 입력하고 Enter 를 누릅니다.
$ ./scanf_buffer_problem
╔════════════════════════════════════════╗
║      scanf 입력 버퍼 문제 시연         ║
╚════════════════════════════════════════╝

나이를 입력하세요: 25
이름의 첫 글자를 입력하세요:
나이: 25
첫 글자:

첫 글자의 ASCII 코드: 10
→ 개행문자('\n', 코드 10)를 읽었습니다. 버퍼 문제 발생!
“이름의 첫 글자를 입력하세요”가 나오자마자, 우리가 아무것도 치기 전에 결과가 쏟아집니다. 앞에서 그린 입력 버퍼로 따라가 봅시다.
25 Enter 를 친 직후   :  [ '2' ][ '5' ][ '\n' ]
scanf("%d") 가 25를 꺼냄:                   [ '\n' ]   ← 남았다!
scanf("%c") 가 꺼냄     :  '\n' → initial     (비었음. 사용자를 기다릴 필요가 없었다)
%d 는 숫자가 끝나는 곳까지만 읽고, Enter 로 들어온 '\n' 은 버퍼에 남겨 둡니다. 그다음 %c 는 “다음 글자 하나” 를 읽는데, 버퍼에 이미 '\n' 이 있으니 기다리지 않고 그걸 가져갑니다. 그래서 initial 은 줄바꿈 문자(ASCII 10)가 되고, “첫 글자: ” 뒤에 줄바꿈이 찍혀서 빈 줄처럼 보입니다.
입력 버퍼에 무엇이 들어가는지 직접 확인할 수도 있습니다. 1주차 6절의 od -c 를 씁니다.
$ printf '25\nK\n' | od -c
0000000   2   5  \n   K  \n
25 와 K 사이에 \n 이 있습니다. 이 \n 을 %c 가 먼저 가져가는 것입니다.
그런데 %d 는 왜 이런 문제가 없을까요? %d, %f, %s 같은 대부분의 서식은 읽기 전에 앞쪽의 공백류 문자(공백, 탭, 줄바꿈)를 알아서 건너뜁니다. 앞의 반환값 표에서 7 이 7로 읽힌 것도 그래서입니다. %c 만 예외입니다. 공백이나 줄바꿈도 엄연한 “글자”이기 때문에, %c 는 무엇이든 다음 글자를 그대로 가져옵니다.
해결책 1: %c 앞에 공백 넣기
scanf(" %c", &initial); // 앞에 공백 추가
scanf 의 서식 문자열에서 공백은 “공백류 문자를 0개 이상 건너뛰어라” 라는 뜻입니다. 그래서 " %c" 는 “줄바꿈이든 공백이든 다 건너뛰고, 처음 나오는 진짜 글자를 읽어라”가 됩니다. scanf_basic.c 에서 " %c" 를 쓴 이유가 이것입니다.
직접 확인해 봅시다. scanf_basic.c 에서 공백을 빼고("%c") 다시 실행하면 이렇게 됩니다.
$ ./scanf_basic_nospace
나이를 입력하세요: 25
키를 입력하세요 (cm): 175.5
학점을 입력하세요 (A-F):
=== 입력한 정보 ===
나이: 25세
키: 175.5cm
학점:
학점을 물어보자마자 결과가 나오고, 학점 자리에는 줄바꿈이 들어갔습니다. 공백 한 칸의 차이입니다.
해결책 2: 버퍼 비우기
int c;
while ((c = getchar()) != '\n' && c != EOF)
    ;                        // 버퍼의 모든 문자 제거
scanf("%c", &initial);
getchar() 는 입력 버퍼에서 글자 하나를 꺼내 돌려주는 함수입니다. while 은 3주차에 배울 반복문으로, “괄호 안이 참인 동안 계속 반복하라”는 뜻입니다. 그래서 이 코드는 “꺼낸 글자가 줄바꿈이 아니고 입력의 끝도 아닌 동안 계속 꺼내서 버려라”, 즉 그 줄의 남은 글자를 줄바꿈까지 전부 버린다는 뜻입니다. 42abc 처럼 숫자 뒤에 쓰레기가 남은 경우까지 치워 줍니다. 3주차 이후 예제의 flush_line() 함수가 바로 이 코드입니다.
c 가 char 가 아니라 int 인 것도 이유가 있습니다. getchar() 는 글자(0~255)뿐 아니라 EOF(−1)도 돌려줄 수 있어서, 둘을 구분하려면 char 보다 큰 int 가 필요합니다.
&& c != EOF 를 빼면 안 됩니다. 인터넷에서 이렇게 쓰는 코드를 아주 많이 봅니다.
while (getchar() != '\n'); /* 입력이 끝나면 영원히 돕니다 */
입력이 끝나면 getchar() 는 '\n' 대신 EOF 를 계속 돌려줍니다. 그래서 이 루프는 빠져나올 수 없습니다. 정말 그런지 실험해 봅시다. 숫자 하나를 읽고 위의 루프로 버퍼를 비운 뒤 ok 를 찍는 inf.c 를 만들고, 줄바꿈이 없는 입력을 줘 봅니다.
#include <stdio.h>
int main(void) {
    int n;
    scanf("%d", &n);
    while (getchar() != '\n')
        ;
    printf("ok\n");
    return 0;
}
$ printf '5\n' | timeout 2 ./inf
ok
$ printf '5' | timeout 2 ./inf
$ echo $?
124
timeout 2 는 “2초 안에 안 끝나면 강제로 끝내라”는 명령이고, 강제로 끝냈을 때 종료 코드 124를 돌려줍니다. 줄바꿈이 있으면 ok 가 나오지만, 줄바꿈 없이 입력이 끝나면 2초 동안 멈춰 있다가 강제 종료됐습니다. timeout 이 없었다면 영원히 돌았을 겁니다. 터미널에서 직접 타이핑할 때는 항상 Enter 를 치니까 잘 돌아가고, 파이프로 입력을 주거나 파일에서 읽을 때만 멈춥니다.
터미널에서만 시험한 입력 코드는 시험하지 않은 것과 같습니다. printf '...' | ./프로그램 처럼 입력을 흘려 넣어 보는 습관을 들이세요.
해결책 3: fgets 로 한 줄씩 읽기 (권장)
가장 튼튼한 방법은 scanf 로 직접 읽지 않고, fgets 로 한 줄을 통째로 읽은 다음 그 안에서 숫자를 꺼내는 것입니다. 한 줄을 통째로 가져가니 버퍼에 찌꺼기가 남지 않습니다. 문자열을 배우는 4주차에 다룹니다.
실험: 숫자 대신 abc 를 넣으면?
같은 scanf_buffer_problem 에 나이 대신 abc 를 넣어 봅시다.
$ printf 'abc\n' | ./scanf_buffer_problem
...
나이를 입력하세요: 이름의 첫 글자를 입력하세요:
나이: 32766
첫 글자: a
첫 글자의 ASCII 코드: 97
(입력을 파이프로 흘려 넣어서 abc 가 화면에 보이지 않습니다. 앞의 “입력하는 글자가 화면에 보이는 이유” 상자를 참고하세요.)
두 가지가 동시에 일어났습니다.
- 나이가 쓰레기 값입니다.
%d는a를 보고 “정수가 아니다” 하고 아무것도 읽지 않은 채 실패(반환값 0)했습니다.age는 초기화하지 않았으니 쓰레기 값이 찍혔습니다. 실행할 때마다 다른 값이 나옵니다. - 첫 글자가
a입니다.%d가 실패하면서abc를 버퍼에 그대로 남겼고, 다음%c가 그중 첫 글자a를 가져갔습니다.
반환값을 확인하지 않은 코드가 잘못된 입력을 만나면 이렇게 됩니다. 쓰레기 값으로 계산을 계속하고, 남은 입력이 엉뚱한 곳으로 흘러갑니다.
안전한 입력 처리
지금까지 배운 것을 모아서, 잘못된 입력을 걸러 내는 프로그램을 봅시다.
safe_input.c:
#include <stdio.h>

int main(void) {
    int num;
    int result;

    printf("1부터 100 사이의 숫자를 입력하세요: ");
    result = scanf("%d", &num);

    // 입력 검증
    if (result != 1) {
        printf("오류: 숫자를 입력해야 합니다!\n");
        return 1;
    }

    if (num < 1 || num > 100) {
        printf("오류: 1부터 100 사이의 숫자를 입력해야 합니다!\n");
        return 1;
    }

    printf("올바른 입력: %d\n", num);

    return 0;
}
result != 1:!=는 “같지 않은가?”입니다. 1개를 읽지 못했으면 오류입니다.return 1;:main을 곧바로 끝내면서 1(실패)을 돌려줍니다. 1주차 5절의 종료 코드 약속입니다.num < 1 || num > 100:||는 “또는”입니다. 1보다 작거나 100보다 크면 범위 밖입니다(3주차).
$ ./safe_input
1부터 100 사이의 숫자를 입력하세요: 50
올바른 입력: 50
$ echo $?
0
$ ./safe_input
1부터 100 사이의 숫자를 입력하세요: abc
오류: 숫자를 입력해야 합니다!
$ echo $?
1
$ ./safe_input
1부터 100 사이의 숫자를 입력하세요: 101
오류: 1부터 100 사이의 숫자를 입력해야 합니다!
오류일 때 종료 코드가 1이니, 1주차 12절의 컴파일 스크립트처럼 다른 프로그램이 이 프로그램의 성공과 실패를 알 수 있습니다.
입력 검증 체크리스트
- [ ]
scanf의 반환값이 기대한 개수인지 확인했다 - [ ] 값이 말이 되는 범위인지 확인했다
- [ ] 오류 메시지를 출력하고 0이 아닌 종료 코드로 끝냈다
- [ ] 파이프로도 입력을 넣어 시험했다(
printf 'abc\n' | ./프로그램)
8. 상수
프로그램에는 바뀌지 않는 값도 있습니다. 원주율, 최대 학생 수, 인사말 같은 것들이죠. 이런 값을 코드 곳곳에 숫자로 직접 쓰면, 나중에 바꿀 때 전부 찾아 고쳐야 하고, 30 이 학생 수인지 날짜인지 읽는 사람이 알 수 없습니다. 그래서 값에 이름을 붙입니다. 방법이 두 가지 있습니다.
#define 매크로 상수
define_constant.c:
#include <stdio.h>

#define PI 3.141592653589793
#define MAX_STUDENTS 30
#define GREETING "안녕하세요!"

int main(void) {
    double radius = 5.0;
    double area = PI * radius * radius;

    printf("반지름이 %.1f인 원의 넓이: %.2f\n", radius, area);
    printf("최대 학생 수: %d\n", MAX_STUDENTS);
    printf("%s\n", GREETING);

    return 0;
}
$ ./define_constant
반지름이 5.0인 원의 넓이: 78.54
최대 학생 수: 30
안녕하세요!
#define 이름 값 은 “이 파일에서 이름 이 나오면 전부 값 으로 바꿔 쳐라” 는 뜻입니다. # 으로 시작하니 1주차 7절의 전처리기 지시입니다. 전처리기는 C 문법을 모르는 텍스트 편집 도구라고 했죠. 정말 글자를 바꿔 치는지 gcc -E 로 확인해 봅시다.
$ gcc -E define_constant.c | tail -11
int main(void) {
    double radius = 5.0;
    double area = 3.141592653589793 * radius * radius;

    printf("반지름이 %.1f인 원의 넓이: %.2f\n", radius, area);
    printf("최대 학생 수: %d\n", 30);
    printf("%s\n", "안녕하세요!");

    return 0;
}
PI, MAX_STUDENTS, GREETING 이 전부 사라지고 그 자리에 값이 들어갔습니다. 컴파일러는 PI 라는 이름을 본 적도 없습니다. 이 사실에서 #define 의 장점과 함정이 모두 나옵니다.
관례: 매크로 이름은 전부 대문자로 씁니다. 코드를 읽을 때 “이건 변수가 아니라 바꿔 치기되는 매크로”라는 것을 한눈에 알 수 있게 하려는 약속입니다.
실험: #define 의 함정 세 가지
함정 1: 세미콜론을 붙이면
#define MAX_STUDENTS 30;
...
    printf("%d\n", MAX_STUDENTS);
$ gcc -Wall -Wextra -std=c11 dsemi.c -o dsemi
dsemi.c: In function ‘main’:
dsemi.c:2:24: error: expected ‘)’ before ‘;’ token
    2 | #define MAX_STUDENTS 30;
      |                        ^
dsemi.c:4:20: note: in expansion of macro ‘MAX_STUDENTS’
    4 |     printf("%d\n", MAX_STUDENTS);
      |                    ^~~~~~~~~~~~
#define 은 C 문장이 아니니 세미콜론이 필요 없는데, 습관적으로 붙이면 세미콜론까지 값에 포함되어 바꿔 쳐집니다. printf("%d\n", 30;); 이 되어 버린 것입니다. 오류 메시지가 #define 줄을 가리키고, note: in expansion of macro 가 “이 매크로를 펼친 자리에서 문제가 났다”고 알려 줍니다. 매크로가 관련된 오류는 이렇게 두 곳을 함께 보여 줍니다.
함정 2: 계산식을 넣으면
#define SUM 2 + 3
...
    printf("SUM * 10 = %d\n", SUM * 10);
$ ./dexpr
SUM * 10 = 32
50이 나와야 할 것 같은데 32입니다. gcc -E 로 보면 이유가 보입니다.
$ gcc -E -P dexpr.c | tail -4
int main(void) {
    printf("SUM * 10 = %d\n", 2 + 3 * 10);
    return 0;
}
SUM 이 2 + 3 이라는 글자로 바뀌어서 2 + 3 * 10 이 됐고, 곱셈이 먼저라 2 + 30 = 32입니다. 해결책은 매크로 값을 괄호로 감싸는 것입니다. #define SUM (2 + 3) 으로 고치면 (2 + 3) * 10 = 50이 나옵니다. 매크로에 계산식을 넣을 때는 항상 괄호로 감싸세요.
함정 3: 값을 바꾸려 하면
#define PI 3.14159
...
    PI = 3.14;
$ gcc -Wall -Wextra -std=c11 dassign.c -o dassign
dassign.c:4:8: error: lvalue required as left operand of assignment
    4 |     PI = 3.14;
      |        ^
“대입의 왼쪽에는 lvalue 가 와야 한다.” lvalue 는 1절에서 말한 값을 넣을 수 있는 칸입니다(대입의 left 에 올 수 있는 값). 바꿔 치기하고 나면 3.14159 = 3.14; 가 되니, 숫자에 숫자를 넣으려 한 셈입니다. 오류 메시지만 보고는 PI 가 매크로라는 사실을 짐작하기 어렵습니다. 매크로는 컴파일러에게 보이지 않는다는 것의 부작용입니다.
const 키워드
두 번째 방법은 변수 앞에 const (constant, 상수)를 붙여서 “이 변수는 값을 바꿀 수 없다”고 선언하는 것입니다.
const_example.c:
#include <stdio.h>

int main(void) {
    const double PI = 3.141592653589793;
    const int MAX_SCORE = 100;

    double radius = 10.0;
    double area = PI * radius * radius;

    printf("PI: %.15f\n", PI);
    printf("원의 넓이: %.2f\n", area);

    // const 변수는 반드시 초기화해야 함
    const int value = 42;

    printf("최대 점수: %d\n", MAX_SCORE);
    printf("값: %d\n", value);

    return 0;
}
$ ./const_example
PI: 3.141592653589793
원의 넓이: 314.16
최대 점수: 100
값: 42
const 변수는 진짜 변수입니다. 타입이 있고, 메모리에 칸이 있고, 이름이 컴파일러에게 보입니다. 다만 값을 바꾸려 하면 컴파일러가 막습니다.
    const double PI = 3.14159;
    PI = 3.14;
$ gcc -Wall -Wextra -std=c11 cassign.c -o cassign
cassign.c:4:8: error: assignment of read-only variable ‘PI’
    4 |     PI = 3.14;
      |        ^
#define 때의 lvalue required 와 비교해 보세요. 이번에는 “읽기 전용 변수 PI 에 대입했다”고 이름까지 정확히 짚어 줍니다. 컴파일러가 PI 를 알고 있기 때문입니다.
실험: const 변수를 초기화하지 않으면?
예제의 주석에는 “반드시 초기화해야 함”이라고 적혀 있습니다. 정말 오류일까요?
    const int value;
    printf("%d\n", value);
$ gcc -Wall -Wextra -std=c11 cnoinit.c -o cnoinit
cnoinit.c: In function ‘main’:
cnoinit.c:4:5: warning: ‘value’ is used uninitialized [-Wuninitialized]
    4 |     printf("%d\n", value);
      |     ^~~~~~~~~~~~~~~~~~~~~
cnoinit.c:3:15: note: ‘value’ was declared here
$ ./cnoinit
32766
오류가 아닙니다. C에서는 초기화하지 않은 const 변수도 문법상 허용되고, 쓸 때 1절과 같은 “초기화 안 된 변수” 경고만 나옵니다(C++ 에서는 오류입니다). 결과는 쓰레기 값이고, const 라서 나중에 값을 넣을 방법도 없습니다. 그러니 문법이 허용하든 말든, const 변수는 만들 때 반드시 값을 넣어야 쓸모가 있습니다. 예제 주석의 “반드시”는 문법 규칙이 아니라 이런 뜻입니다.
#define vs const
| 특징 | #define |
const |
|---|---|---|
| 정체 | 전처리기의 글자 바꿔 치기 | 값을 바꿀 수 없는 변수 |
| 타입 | 없음 (바꿔 친 글자에 따라 정해짐) | 있음 |
| 컴파일러가 이름을 아는가 | 모름 (오류 메시지가 엉뚱해짐) | 앎 (read-only variable ‘PI’) |
| 디버거로 이름을 볼 수 있나 | 없음 | 있음 |
| 적용 범위 | 정의한 줄부터 파일 끝까지. { } 를 무시함 |
선언한 { } 블록 안 (5주차) |
| 흔한 실수 | 세미콜론, 괄호 누락 | 거의 없음 |
“적용 범위” 줄이 궁금하면 실험해 보세요.
int main(void) {
    {
        #define LIMIT 10
        const int limit = 10;
        printf("블록 안: %d %d\n", LIMIT, limit);
    }
    printf("블록 밖: %d\n", LIMIT);
    return 0;
}
$ ./dscope
블록 안: 10 10
블록 밖: 10
{ } 안에서 정의한 LIMIT 이 블록 밖에서도 쓰입니다. 전처리기는 { } 를 모르기 때문입니다. 반대로 블록 밖에서 limit 을 쓰면 “선언되지 않았다”는 오류가 납니다.
예전 글에서는 “
#define은 메모리를 쓰지 않고const는 쓴다”고 설명했는데, 반만 맞는 말입니다.#define으로 바꿔 친 문자열"안녕하세요!"는 당연히 메모리에 들어가고, 반대로const int는 컴파일러가 값을 코드에 직접 박아 넣어 칸을 만들지 않기도 합니다(1주차 7절에서 본 것처럼 컴파일러는 뜻대로 번역합니다). 메모리는 선택 기준이 되지 못합니다.
권장사항
- 일반적인 상수(원주율, 최댓값, 세율 등):
const. 타입이 있고 컴파일러가 도와줍니다. - 배열 크기처럼 “컴파일할 때 확정된 정수”가 꼭 필요한 곳:
#define도 여전히 많이 씁니다(4주차). - 1주차 6절의
#ifdef처럼 조건부 컴파일:#define만 가능합니다.
9. 형 변환 (Type Casting)
C는 서로 다른 자료형을 섞어 계산할 때 규칙에 따라 한쪽을 다른 타입으로 바꿉니다. 이 규칙을 모르면 가장 많이 당하는 사고가 정수 나눗셈입니다. 7 / 2 가 3.5가 아니라 3 이 되어 버리는, 평균·비율·계산기 코드에서 끝없이 반복되는 버그죠. 자동으로 무엇이 바뀌는지, 언제 우리가 직접 바꿔야 하는지를 이 절에서 정리합니다.
자동 형 변환 (Implicit Conversion)
implicit_casting.c:
#include <stdio.h>

int main(void) {
    // 정수 → 실수 (자동 변환)
    int integer = 5;
    double result = integer;  // int가 double로 변환

    printf("int → double: %d → %f\n", integer, result);

    // 작은 타입 → 큰 타입
    char c = 'A';
    int i = c;  // char가 int로 변환
    printf("char → int: %c → %d\n", c, i);

    // 실수 → 정수 (자동 변환, 소수점 버림)
    double pi = 3.14159;
    int truncated = pi;  // 캐스팅 없이 대입하면 소수점 이하가 버려진다
    printf("double → int: %f → %d (소수점 버림!)\n", pi, truncated);

    // 연산 시 자동 변환
    int a = 7;
    int b = 2;
    double div1 = a / b;          // int / int = int (3), 그 후 double로 변환
    double div2 = (double)a / b;  // double / int = double (3.5)

    printf("\n정수 나눗셈 문제:\n");
    printf("7 / 2 = %f (잘못된 결과!)\n", div1);
    printf("(double)7 / 2 = %f (올바른 결과)\n", div2);

    return 0;
}
$ ./implicit_casting
int → double: 5 → 5.000000
char → int: A → 65
double → int: 3.141590 → 3 (소수점 버림!)

정수 나눗셈 문제:
7 / 2 = 3.000000 (잘못된 결과!)
(double)7 / 2 = 3.500000 (올바른 결과)
자동 변환이 일어나는 곳은 크게 두 군데입니다.
1) 대입할 때: 오른쪽 값이 왼쪽 변수의 타입으로 바뀝니다.
double result = integer;에서 5는 5.0이 됩니다. 정보 손실이 없습니다.int truncated = pi;에서 3.14159는 3 이 됩니다. 소수점 아래는 반올림이 아니라 버려집니다. 정보가 사라졌는데도 경고가 나지 않았습니다.
정말 경고가 없을까요? -Wall -Wextra 는 이 변환을 경고하지 않습니다. 이런 변환을 잡아내는 옵션은 따로 있습니다.
$ gcc -Wall -Wextra -Wconversion -std=c11 implicit_casting.c -o implicit_casting
implicit_casting.c:17:21: warning: conversion from ‘double’ to ‘int’ may change value [-Wfloat-conversion]
   17 |     int truncated = pi;  // 캐스팅 없이 대입하면 소수점 이하가 버려진다
-Wconversion 을 주면 “double 을 int 로 바꾸면 값이 바뀔 수 있다”고 알려 줍니다. 경고가 너무 많이 나와서 기본 묶음에 들어가 있지 않을 뿐, 숫자를 많이 다루는 코드를 쓸 때는 켜 볼 가치가 있습니다.
2) 계산할 때: 연산자 양쪽의 타입이 다르면, 더 “큰” 쪽으로 맞춘 다음 계산합니다. 대략 이런 순서입니다.
int  →  unsigned int  →  long  →  long long  →  float  →  double  →  long double
                                         (오른쪽으로 갈수록 "큰" 타입)
그리고 char 와 short 는 계산에 들어가는 순간 일단 int 로 바뀝니다(3절의 'A' + 1 이 66으로 계산된 이유입니다). 3절 끝에서 본 -1 < 1u 가 거짓이 된 것도 이 규칙 때문입니다. int 와 unsigned int 가 만나서 unsigned int 쪽으로 맞춰졌죠. 이 규칙을 일반 산술 변환(usual arithmetic conversions) 이라고 부릅니다.
정수 나눗셈 — 왜 7 / 2 는 3일까?
double div1 = a / b; // a = 7, b = 2
이 줄이 3.5가 아닌 이유를 순서대로 따라가 봅시다.
=오른쪽의a / b가 먼저 계산됩니다. 둘 다int이니 정수 나눗셈을 합니다. 정수 나눗셈은 몫만 남기고 나머지는 버립니다. 결과는int3.- 그다음 3을
double변수에 대입하면서 3.0이 됩니다. - 이미 1단계에서 .5를 잃었습니다. 대입할 때
double로 바뀌는 것은 너무 늦었습니다.
“결과를 double 에 넣으니 알아서 실수 나눗셈을 하겠지”라는 기대가 틀린 것입니다. C는 계산할 때 결과를 담을 변수를 보지 않고, 계산에 참여하는 값들의 타입만 봅니다.
해결 방법은 계산 전에 한쪽을 실수로 만드는 것입니다.
double result = (double)a / b;  // ✅ 3.5
double result = a / 2.0;        // ✅ 2.0 은 double 리터럴이라 3.5
(double)a 가 다음에 볼 명시적 형 변환입니다. 한쪽이 double 이 되면 위의 규칙대로 다른 쪽도 double 로 맞춰져서 실수 나눗셈을 합니다.
정수 나눗셈을 조금 더 실험해 봅시다.
$ ./div
7 / 2   = 3
-7 / 2  = -3
7 % 2   = 1
-7 % 2  = -1
(int)3.7  = 3
(int)-3.7 = -3
7 / 2.0 = 3.500000
-7 / 2는 −4가 아니라 −3입니다. C의 정수 나눗셈은 0 쪽으로 자릅니다(C99부터 표준으로 정해졌습니다). −3.5에서 소수점을 버려 −3.%는 나머지 연산자입니다.7 % 2는 1,-7 % 2는 −1. 나머지의 부호는 나눠지는 수를 따릅니다.%는 3주차에 짝수·홀수 판별 같은 데 많이 씁니다.(int)-3.7도 −3입니다. 실수를 정수로 바꿀 때도 0 쪽으로 자릅니다. 반올림을 원하면math.h의round나lround를 씁니다.
명시적 형 변환 (Explicit Casting)
(타입)값 모양으로, “이 값을 이 타입으로 바꿔라” 고 직접 지시하는 것을 캐스트(cast) 라고 합니다. 금속을 틀(cast)에 부어 모양을 바꾸는 데서 온 말입니다.
explicit_casting.c:
#include <stdio.h>
#include <math.h>

int main(void) {
    // 형 변환 연산자: (타입)값

    double pi = 3.14159;
    int truncated = (int)pi;  // 명시적 변환

    printf("원래 값: %f\n", pi);
    printf("int로 변환: %d\n", truncated);

    // 정수 나눗셈을 실수로
    int numerator = 22;
    int denominator = 7;

    double result1 = numerator / denominator;  // 잘못된 방법
    double result2 = (double)numerator / denominator;  // 올바른 방법
    double result3 = numerator / (double)denominator;  // 올바른 방법
    double result4 = (double)numerator / (double)denominator;  // 가장 명확

    printf("\n정수 나눗셈 22 / 7:\n");
    printf("방법1 (캐스팅 없음): %f\n", result1);
    printf("방법2 (분자 캐스팅): %f\n", result2);
    printf("방법3 (분모 캐스팅): %f\n", result3);
    printf("방법4 (둘 다 캐스팅): %f\n", result4);

    // 오버플로우 방지
    int big_num = 1000000;
    long result_overflow = big_num * big_num;  // 오버플로우!
    long result_safe = (long)big_num * big_num;  // 안전

    printf("\n오버플로우 예제:\n");
    printf("int * int: %ld (오버플로우!)\n", result_overflow);
    printf("(long)int * int: %ld (안전)\n", result_safe);

    return 0;
}
$ ./explicit_casting
원래 값: 3.141590
int로 변환: 3

정수 나눗셈 22 / 7:
방법1 (캐스팅 없음): 3.000000
방법2 (분자 캐스팅): 3.142857
방법3 (분모 캐스팅): 3.142857
방법4 (둘 다 캐스팅): 3.142857

오버플로우 예제:
int * int: -727379968 (오버플로우!)
(long)int * int: 1000000000000 (안전)
코드 읽기
(int)pi: 앞의int truncated = pi;와 결과는 같습니다. 차이는 의도를 드러낸다는 것입니다. 읽는 사람도-Wconversion도 “일부러 버렸구나”를 알 수 있습니다. 정보가 사라지는 변환에는 캐스트를 써서 의도를 밝히는 것이 좋은 습관입니다.- 방법 2, 3, 4: 결과가 모두 같습니다. 한쪽만
double이 되면 다른 쪽도 따라 바뀌기 때문입니다. 22/7 = 3.142857은 원주율의 오래된 근삿값입니다. (double)numerator / denominator를 읽는 순서: 캐스트는 나눗셈보다 먼저 적용됩니다.(double)(numerator / denominator)로 쓰면 정수 나눗셈을 먼저 해서 3을 만든 다음 3.0으로 바꾸니 소용없습니다. 괄호의 위치가 중요합니다.
오버플로우 줄을 자세히 봅시다. 100만 × 100만 = 1조이고, 1조는 int 범위(약 21억)를 훨씬 넘습니다. big_num * big_num 은 int 끼리의 곱셈이라, 결과를 long 변수에 넣든 말든 곱셈 자체가 int 로 계산되어 넘칩니다. 정수 나눗셈과 똑같은 함정입니다. 계산에 참여하는 값의 타입이 결과의 타입을 정합니다.
그리고 3절에서 배운 대로, signed 정수의 넘침은 정의되지 않은 동작입니다. 예제의 -727379968 은 “넘치면 이 값이 나온다”는 게 아니라, 이번에는 이 값이 나왔다는 것뿐입니다. 새니타이저로 확인해 봅시다.
$ gcc -std=c11 -fsanitize=undefined explicit_casting.c -o explicit_casting && ./explicit_casting 2>&1 | grep runtime
explicit_casting.c:30:36: runtime error: signed integer overflow: 1000000 * 1000000 cannot be represented in type 'int'
30번째 줄의 곱셈이 넘쳤다고 정확히 짚어 줍니다. (long)big_num * big_num 처럼 한쪽을 먼저 long 으로 바꾸면 곱셈이 long 으로 계산되어 안전합니다(long 이 8바이트인 이 환경 기준입니다. 3절의 윈도우 이야기를 떠올리면 long long 이 더 확실합니다).
형 변환 정리
| 상황 | 자동으로 되나? | 무슨 일이 생기나 |
|---|---|---|
작은 정수 → 큰 정수 (char → int) |
된다 | 값 그대로. 안전 |
정수 → 실수 (int → double) |
된다 | 거의 안전. 아주 큰 정수는 4절처럼 근사값이 될 수 있음 |
실수 → 정수 (double → int) |
된다 | 소수점 아래를 버림. -Wconversion 만 경고 |
큰 정수 → 작은 정수 (int → char) |
된다 | 넘치는 비트가 잘림(3절의 300 → 44) |
| signed ↔ unsigned | 된다 | 비트는 그대로, 해석만 바뀜(−1 → 4294967295) |
예전 글에는 “큰 타입에서 작은 타입으로는 명시적 변환이 필요하다”고 적었는데, 틀린 설명입니다. 위 표처럼 C는 정보가 사라지는 변환도 아무 말 없이 자동으로 해 버립니다. 바로 그래서 위험하고, 그래서 캐스트로 의도를 밝히고
-Wconversion으로 점검하는 것입니다. 캐스트는 “필요해서” 쓰는 게 아니라 “실수가 아니라 일부러라는 것을 보여 주려고” 씁니다.
10. sizeof 연산자
자료형 크기 확인
3절에서 “크기를 외우지 말고 sizeof 로 확인하라”고 했습니다. sizeof 는 컴파일러에게 “이것이 몇 바이트냐”고 묻는 연산자입니다.
sizeof_example.c:
#include <stdio.h>

int main(void) {
    printf("=== 기본 자료형 크기 ===\n");
    printf("char: %zu byte(s)\n", sizeof(char));
    printf("short: %zu byte(s)\n", sizeof(short));
    printf("int: %zu byte(s)\n", sizeof(int));
    printf("long: %zu byte(s)\n", sizeof(long));
    printf("long long: %zu byte(s)\n", sizeof(long long));
    printf("float: %zu byte(s)\n", sizeof(float));
    printf("double: %zu byte(s)\n", sizeof(double));
    printf("long double: %zu byte(s)\n", sizeof(long double));

    // 변수의 크기
    int number = 42;
    double pi = 3.14;

    printf("\n=== 변수 크기 ===\n");
    printf("sizeof(number): %zu\n", sizeof(number));
    printf("sizeof(pi): %zu\n", sizeof(pi));

    // 표현식의 크기 (컴파일 시 결정)
    printf("\n=== 표현식 크기 ===\n");
    printf("sizeof(10): %zu\n", sizeof(10));
    printf("sizeof(3.14): %zu\n", sizeof(3.14));
    printf("sizeof(10 + 20): %zu\n", sizeof(10 + 20));

    // 비트 수 계산
    printf("\n=== 비트 수 ===\n");
    printf("int: %zu bits\n", sizeof(int) * 8);
    printf("double: %zu bits\n", sizeof(double) * 8);

    return 0;
}
$ ./sizeof_example
=== 기본 자료형 크기 ===
char: 1 byte(s)
short: 2 byte(s)
int: 4 byte(s)
long: 8 byte(s)
long long: 8 byte(s)
float: 4 byte(s)
double: 8 byte(s)
long double: 16 byte(s)

=== 변수 크기 ===
sizeof(number): 4
sizeof(pi): 8

=== 표현식 크기 ===
sizeof(10): 4
sizeof(3.14): 8
sizeof(10 + 20): 4

=== 비트 수 ===
int: 32 bits
double: 64 bits
읽기
sizeof(타입)과sizeof(변수)둘 다 됩니다. 변수를 주면 그 변수의 타입 크기입니다.sizeof(10)은 4,sizeof(3.14)는 8: 3절과 4절에서 “리터럴에도 타입이 있다”고 했죠. 그냥 쓴 정수는int, 그냥 쓴 실수는double입니다.sizeof(10 + 20): 계산 결과의 타입(int)의 크기입니다.sizeof는 컴파일할 때 타입만 보고 답을 정하기 때문에,10 + 20을 실제로 계산하지도 않습니다.sizeof의 결과는size_t타입이고, 서식은%zu입니다(3절).
실험: ‘A’ 는 몇 바이트일까?
char 는 1바이트입니다. 그럼 문자 'A' 도 1바이트겠죠?
    char c = 'A';
    printf("sizeof(c)   = %zu\n", sizeof(c));
    printf("sizeof('A') = %zu\n", sizeof('A'));
    printf("sizeof c    = %zu\n", sizeof c);
$ ./szA
sizeof(c)   = 1
sizeof('A') = 4
sizeof c    = 1
'A' 는 4바이트입니다! C에서 작은따옴표로 쓴 문자 리터럴은 char 가 아니라 int 입니다. 역사적인 이유로 그렇게 정해졌습니다(C++ 에서는 1이 나옵니다. 같은 코드가 두 언어에서 다른 답을 내는 드문 예입니다). char c = 'A'; 는 int 65를 char 칸에 넣으면서 1바이트로 줄이는 것입니다.
세 번째 줄 sizeof c 처럼 변수에는 괄호 없이 써도 됩니다. sizeof 는 함수가 아니라 + 같은 연산자이기 때문입니다. 하지만 타입에는 괄호가 꼭 필요합니다.
$ gcc -Wall -Wextra -std=c11 sznp.c -o sznp
sznp.c:3:28: error: expected expression before ‘int’
    3 |     printf("%zu\n", sizeof int);
      |                            ^~~
헷갈릴 바에는 항상 괄호를 쓰는 것이 간단합니다.
sizeof 는 앞으로 계속 씁니다. 4주차에는 배열 전체의 크기를, 7주차에는 동적 메모리를 얼마나 할당할지 계산할 때 핵심 도구가 됩니다.
11. 실습 프로젝트
이제 배운 것을 모아서 입력을 받고, 계산하고, 결과를 보여 주는 진짜 프로그램을 만들어 봅시다. 1주차의 “계산기 안내 프로그램”이 드디어 계산을 합니다.
세 프로젝트 모두 ~/c_programming/week02/projects 에서 작업합니다. 3주차에 배울 if 와 switch 가 조금 먼저 나오는데, 뜻은 코드 옆에 설명해 두었습니다. 모양이 영어 문장과 거의 같아서 읽는 데는 문제가 없을 겁니다.
이 프로젝트들은 예전 판에서 고쳤습니다. 세 프로그램 모두
scanf의 반환값을 확인하지 않아서, 숫자 대신 글자를 넣으면 7절에서 본 것처럼 초기화되지 않은 변수로 계산을 계속했습니다. 예전 판의 계산기에abc를 넣으면 “잘못된 연산자입니다”가 나왔는데, 그건 연산자 변수에 우연히 들어 있던 쓰레기 값이+ - * /중 어느 것과도 같지 않았기 때문이었습니다. 운이 나빴다면 엉뚱한 계산 결과가 나왔을 겁니다. 지금 판은 7절의 규칙대로 반환값을 확인합니다.
프로젝트 1: 사칙연산 계산기
calculator.c:
#include <stdio.h>

int main(void) {
    double num1, num2;
    char operator;
    double result;

    printf("=== 간단한 계산기 ===\n");
    printf("계산식을 입력하세요 (예: 10 + 5): ");
    // scanf 는 읽는 데 성공한 항목 수를 돌려준다. 세 개를 다 못 읽었으면
    // num1, operator, num2 중 일부는 값이 없는(쓰레기) 상태이므로 멈춘다.
    if (scanf("%lf %c %lf", &num1, &operator, &num2) != 3) {
        printf("오류: 입력 형식이 잘못되었습니다! (예: 10 + 5)\n");
        return 1;
    }

    // 연산자에 따라 계산
    switch (operator) {
        case '+':
            result = num1 + num2;
            printf("%.2f + %.2f = %.2f\n", num1, num2, result);
            break;
        case '-':
            result = num1 - num2;
            printf("%.2f - %.2f = %.2f\n", num1, num2, result);
            break;
        case '*':
            result = num1 * num2;
            printf("%.2f × %.2f = %.2f\n", num1, num2, result);
            break;
        case '/':
            if (num2 == 0) {
                printf("오류: 0으로 나눌 수 없습니다!\n");
            } else {
                result = num1 / num2;
                printf("%.2f ÷ %.2f = %.2f\n", num1, num2, result);
            }
            break;
        default:
            printf("오류: 잘못된 연산자입니다!\n");
            printf("사용 가능한 연산자: +, -, *, /\n");
    }

    return 0;
}

계산기
$ gcc -Wall -Wextra -std=c11 -g calculator.c -o calculator
$ ./calculator
=== 간단한 계산기 ===
계산식을 입력하세요 (예: 10 + 5): 15.5 * 2
15.50 × 2.00 = 31.00
(스크린샷은 10 + 5 를 파이프로 흘려 넣어 찍어서, 입력한 글자가 화면에 보이지 않습니다.)
코드 읽기
double num1, num2;: 쉼표로 같은 타입의 변수 여러 개를 한 줄에 선언할 수 있습니다. 소수도 계산하려고double을 썼습니다.char operator;:+,-같은 기호 한 글자를 담습니다. 3절에서 본 대로 글자는 번호로 저장됩니다.scanf("%lf %c %lf", &num1, &operator, &num2): 한 번에 세 개를 읽습니다.double이니%lf(6절 마지막 상자)입니다. 서식 사이의 공백은 7절에서 배운 대로 “공백류를 건너뛰어라”입니다. 특히%c앞의 공백 덕분에10 + 5의+앞 공백을 건너뛰고+를 읽습니다.!= 3: 세 개를 모두 읽었는지 확인합니다. 하나라도 못 읽었으면return 1;로 끝냅니다.switch (operator) { case '+': ... }: “operator의 값이'+'면 여기,'-'면 저기…”로 갈라지는 구문입니다.break;는 “여기서switch를 빠져나가라”,default:는 “어느case에도 해당하지 않으면”입니다. 3주차 10절에서 자세히 배웁니다.case에'+'처럼 작은따옴표를 쓴 것에 주목하세요.operator는char이고'+'는 문자(번호 43)입니다.if (num2 == 0): 0으로 나누기를 막습니다. 참고로double을 0으로 나누면 C는 오류 대신inf(무한대)를 만들어 냅니다. 정수를 0으로 나누면 프로그램이 죽습니다. 어느 쪽이든 원하는 결과가 아니니 미리 막는 것입니다.×,÷: 출력용 기호는 UTF-8 문자라 그대로 쓸 수 있습니다. 입력할 때는 키보드에 있는*,/를 씁니다.
실험해 보기
| 입력 | 결과 | 이유 |
|---|---|---|
10 + 5 |
10.00 + 5.00 = 15.00 |
|
10+5 |
10.00 + 5.00 = 15.00 |
%lf 는 숫자가 아닌 + 에서 멈추고, %c 가 + 를 읽는다 |
10 -5 |
10.00 - 5.00 = 5.00 |
공백을 건너뛴 뒤 %c 가 - 를, %lf 가 5를 읽는다 |
1e3 / 8 |
1000.00 ÷ 8.00 = 125.00 |
%lf 는 과학적 표기(4절)도 읽는다 |
7 / 0 |
오류: 0으로 나눌 수 없습니다! |
|
7 % 2 |
오류: 잘못된 연산자입니다! |
% 는 case 에 없다 |
abc |
오류: 입력 형식이 잘못되었습니다! (종료 코드 1) |
첫 %lf 부터 실패. 반환값 0 |
10 -5 가 10 - 5 로 읽히는 것은 편리하지만, 반대로 10 - -5 는 어떻게 읽힐지 예상해 보고 직접 확인해 보세요.
터미널에서 3 + 까지만 치고 Enter 를 누르면 오류가 나지 않고 다음 숫자를 기다립니다. %lf 는 줄바꿈도 공백류로 보고 건너뛰기 때문입니다(7절). 한 줄에 다 써야 한다는 규칙은 scanf 에게 없습니다. 이런 동작이 불편하다면 4주차의 fgets 로 한 줄씩 읽어야 합니다.
직접 해 보기: case '%': 를 추가해서 나머지 연산을 지원해 보세요. 그런데 % 연산자는 정수에만 쓸 수 있어서 num1 % num2 는 컴파일 오류가 납니다. 9절의 캐스트로 (int)num1 % (int)num2 처럼 바꿔야 합니다. 출력할 때 % 글자는 %% 로 쓴다는 것도 잊지 마세요.
프로젝트 2: 온도 변환기
temperature_converter.c:
#include <stdio.h>

int main(void) {
    int choice;
    double temperature, converted;

    printf("=== 온도 변환기 ===\n");
    printf("1. 섭씨 → 화씨\n");
    printf("2. 화씨 → 섭씨\n");
    printf("선택: ");
    if (scanf("%d", &choice) != 1) {
        printf("오류: 숫자를 입력해야 합니다!\n");
        return 1;
    }

    if (choice == 1) {
        printf("섭씨 온도를 입력하세요: ");
        if (scanf("%lf", &temperature) != 1) {
            printf("오류: 숫자를 입력해야 합니다!\n");
            return 1;
        }

        // 섭씨 → 화씨: F = C × 9/5 + 32
        converted = temperature * 9.0 / 5.0 + 32.0;

        printf("%.1f°C = %.1f°F\n", temperature, converted);

        // 추가 정보
        if (temperature <= 0) {
            printf("물이 얼 수 있는 온도입니다.\n");
        } else if (temperature >= 100) {
            printf("물이 끓는 온도입니다.\n");
        } else if (temperature >= 20 && temperature <= 25) {
            printf("쾌적한 실내 온도입니다.\n");
        }

    } else if (choice == 2) {
        printf("화씨 온도를 입력하세요: ");
        if (scanf("%lf", &temperature) != 1) {
            printf("오류: 숫자를 입력해야 합니다!\n");
            return 1;
        }

        // 화씨 → 섭씨: C = (F - 32) × 5/9
        converted = (temperature - 32.0) * 5.0 / 9.0;

        printf("%.1f°F = %.1f°C\n", temperature, converted);

        // 추가 정보
        if (converted <= 0) {
            printf("물이 얼 수 있는 온도입니다.\n");
        } else if (converted >= 100) {
            printf("물이 끓는 온도입니다.\n");
        }

    } else {
        printf("잘못된 선택입니다!\n");
    }

    return 0;
}
$ ./temperature_converter
=== 온도 변환기 ===
1. 섭씨 → 화씨
2. 화씨 → 섭씨
선택: 1
섭씨 온도를 입력하세요: 25
25.0°C = 77.0°F
쾌적한 실내 온도입니다.
코드 읽기
9.0 / 5.0: 9절의 정수 나눗셈 함정을 피하려고 일부러.0을 붙였습니다. 만약temperature * 9 / 5 + 32라고 써도temperature가double이라 괜찮지만, 공식만 따로 떼어9 / 5라고 쓰는 순간 1 이 되어 버립니다. 실수 계산에 쓰는 상수에는.0을 붙이는 습관이 안전합니다.if ... else if ... else: “만약 ~면, 아니고 ~면, 그것도 아니면”입니다. 위에서부터 차례로 검사해서 처음 참인 곳 하나만 실행합니다(3주차 9절).temperature >= 20 && temperature <= 25:&&는 “그리고”입니다. 20 이상이고 25 이하.°: 도 기호도 UTF-8 문자입니다.
실험해 보기
| 선택 / 입력 | 결과 |
|---|---|
1 / 25 |
25.0°C = 77.0°F / 쾌적한 실내 온도입니다. |
2 / 212 |
212.0°F = 100.0°C / 물이 끓는 온도입니다. |
1 / -40 |
-40.0°C = -40.0°F / 물이 얼 수 있는 온도입니다. |
3 |
잘못된 선택입니다! |
x |
오류: 숫자를 입력해야 합니다! (종료 코드 1) |
1 / abc |
오류: 숫자를 입력해야 합니다! (종료 코드 1) |
−40도는 섭씨와 화씨가 같아지는 온도입니다. 공식 F = C × 9/5 + 32 에서 F = C 로 놓고 풀면 C = −40이 나옵니다. 프로그램이 공식대로 계산하고 있다는 좋은 확인 방법입니다. 이렇게 답을 미리 아는 값으로 프로그램을 시험하는 것을 기억해 두세요.
직접 해 보기: 3번 메뉴 “섭씨 → 켈빈”(K = C + 273.15)을 추가해 보세요.
프로젝트 3: BMI 계산기
bmi_calculator.c:
#include <stdio.h>

int main(void) {
    double height, weight, bmi;

    printf("=== BMI (체질량지수) 계산기 ===\n\n");

    printf("키를 입력하세요 (cm): ");
    if (scanf("%lf", &height) != 1) {
        printf("오류: 키는 숫자로 입력해야 합니다!\n");
        return 1;
    }

    printf("몸무게를 입력하세요 (kg): ");
    if (scanf("%lf", &weight) != 1) {
        printf("오류: 몸무게는 숫자로 입력해야 합니다!\n");
        return 1;
    }

    // 입력 검증: 숫자이긴 해도 0 이하면 계산할 수 없다
    if (height <= 0 || weight <= 0) {
        printf("오류: 키와 몸무게는 0보다 커야 합니다!\n");
        return 1;
    }

    // BMI = 체중(kg) / (신장(m) × 신장(m))
    // cm를 m로 변환: cm / 100
    double height_m = height / 100.0;
    bmi = weight / (height_m * height_m);

    printf("\n=== 결과 ===\n");
    printf("키: %.1fcm\n", height);
    printf("몸무게: %.1fkg\n", weight);
    printf("BMI: %.2f\n", bmi);

    // BMI 판정 (대한비만학회 기준, 아시아·태평양 기준을 따른다)
    printf("판정: ");
    if (bmi < 18.5) {
        printf("저체중\n");
    } else if (bmi < 23.0) {
        printf("정상\n");
    } else if (bmi < 25.0) {
        printf("비만 전단계 (과체중)\n");
    } else if (bmi < 30.0) {
        printf("1단계 비만\n");
    } else if (bmi < 35.0) {
        printf("2단계 비만\n");
    } else {
        printf("3단계 비만 (고도비만)\n");
    }

    // BMI 기준 설명
    printf("\n[BMI 기준 - 대한비만학회]\n");
    printf("18.5 미만: 저체중\n");
    printf("18.5 ~ 22.9: 정상\n");
    printf("23.0 ~ 24.9: 비만 전단계 (과체중)\n");
    printf("25.0 ~ 29.9: 1단계 비만\n");
    printf("30.0 ~ 34.9: 2단계 비만\n");
    printf("35.0 이상: 3단계 비만 (고도비만)\n");

    return 0;
}
$ ./bmi_calculator
=== BMI (체질량지수) 계산기 ===

키를 입력하세요 (cm): 175
몸무게를 입력하세요 (kg): 70

=== 결과 ===
키: 175.0cm
몸무게: 70.0kg
BMI: 22.86
판정: 정상

[BMI 기준 - 대한비만학회]
18.5 미만: 저체중
18.5 ~ 22.9: 정상
23.0 ~ 24.9: 비만 전단계 (과체중)
25.0 ~ 29.9: 1단계 비만
30.0 ~ 34.9: 2단계 비만
35.0 이상: 3단계 비만 (고도비만)
코드 읽기
- 검증이 두 단계입니다. 먼저
scanf의 반환값으로 “숫자인가?”를, 그다음height <= 0 || weight <= 0으로 “말이 되는 숫자인가?”를 봅니다. 7절 끝의 입력 검증 체크리스트 그대로입니다. 키 0으로 BMI를 계산하면 0으로 나누게 되니 꼭 필요한 검사입니다. double height_m = height / 100.0;: 변수는main의 맨 위가 아니라 필요한 곳에서 선언해도 됩니다(C99부터). 쓰는 곳 가까이에서 선언하면 읽기 쉽습니다.- 판정의
else if사슬: 위에서부터 검사하므로,bmi < 23.0줄에 도착했다면 이미 18.5 이상이라는 뜻입니다. 그래서 범위의 아래쪽 끝을 다시 적지 않아도 됩니다.
판정 기준을 고쳤습니다. 예전 판은 BMI 30 이상을 전부 “고도비만”으로 판정했는데, 대한비만학회 기준(비만 진료지침)과 다릅니다. 학회 기준은 25 이상을 비만으로 보고 25~29.9를 1단계, 30~34.9를 2단계, 35 이상을 3단계(고도비만) 로 나눕니다. 그래서 예전 판에 키 180cm, 몸무게 100kg 을 넣으면 BMI 30.86이 “고도비만”으로 나왔지만, 지금 판은 “2단계 비만”으로 판정합니다. 프로그램의 계산이 맞아도 기준이 틀리면 결과가 틀립니다. 숫자로 사람을 판정하는 프로그램이라면 기준의 출처를 코드 주석에 남겨 두세요.
실험해 보기
| 키 / 몸무게 | BMI | 판정 |
|---|---|---|
| 175 / 70 | 22.86 | 정상 |
| 160 / 45 | 17.58 | 저체중 |
| 180 / 100 | 30.86 | 2단계 비만 |
abc |
오류: 키는 숫자로 입력해야 합니다! |
직접 해 보기: “정상 체중 범위”를 알려 주도록 고쳐 보세요. BMI 18.5와 22.9에 해당하는 몸무게는 18.5 * height_m * height_m 과 22.9 * height_m * height_m 입니다. 키 175cm 라면 약 56.7kg ~ 70.1kg 이 나와야 합니다.
12. 자주 하는 실수와 해결법
이번 주에 본 실수를 모아 둡니다. 모두 앞에서 실제 메시지를 보며 다룬 것들입니다. 해당 절을 다시 찾아볼 수 있게 표시해 두었습니다.
실수 1: 초기화하지 않은 변수 사용 (1절)
int x;
printf("%d\n", x);  // ❌ 쓰레기 값. 실행할 때마다 다르거나, 우연히 0
int x = 0;          // ✅ 만들 때 값을 넣는다
printf("%d\n", x);
-Wall 이 ‘x’ is used uninitialized 로 알려 줍니다.
실수 2: 정수 나눗셈 (9절)
int a = 7, b = 2;
double result = a / b;          // ❌ 3.0. 나눗셈이 int 로 먼저 계산된다
double result = (double)a / b; // ✅ 3.5
결과를 담는 변수의 타입이 아니라, 계산에 참여하는 값들의 타입이 계산 방식을 정합니다. 경고가 나지 않으니 스스로 조심해야 합니다.
실수 3: scanf 에서 & 빼먹기 (7절)
int num;
scanf("%d", num);   // ❌ 경고 후, 실행하면 세그멘테이션 오류
scanf("%d", &num); // ✅ 값을 넣을 칸의 주소를 준다
실수 4: scanf 의 반환값을 안 보기 (7절)
scanf("%d", &age); // ❌ abc 를 넣으면 age 는 쓰레기 값 그대로
if (scanf("%d", &age) != 1) { // ✅ 몇 개를 읽었는지 확인한다
    printf("오류: 숫자를 입력하세요!\n");
    return 1;
}
실수 5: %c 앞의 공백 빼먹기 (7절)
scanf("%d", &age);
scanf("%c", &initial);   // ❌ 앞에서 남은 '\n' 을 읽는다
scanf(" %c", &initial); // ✅ 공백류를 건너뛰고 읽는다
실수 6: 부동소수점을 == 로 비교 (4절)
if (a + b == 0.3) // ❌ double 에서는 거짓, float 에서는 우연히 참
#include <math.h>
if (fabs((a + b) - 0.3) < 1e-9)   // ✅ 차이가 충분히 작은지 본다
math.h 의 함수를 쓰면 컴파일할 때 -lm 을 붙입니다(fabs 는 없어도 되지만, 습관으로).
실수 7: 서식 지정자와 타입 불일치 (6절, 7절)
int num = 42;
printf("%f\n", num);   // ❌ 0.000000 이 찍힌다 (42.0 이 아니다)
double d;
scanf("%f", &d);       // ❌ double 에는 %lf. 값이 망가진다
printf("%d\n", num);            // ✅
printf("%f\n", (double)num);    // ✅ 실수로 보여 주고 싶다면 캐스트
scanf("%lf", &d);               // ✅
전부 -Wall 이 [-Wformat=] 경고로 잡아 주고, 무엇으로 고치라는지까지 제안합니다.
실수 8: 계산 결과가 int 범위를 넘음 (3절, 9절)
int big = 1000000;
long long r = big * big;              // ❌ 곱셈이 int 로 계산되어 넘친다 (정의되지 않은 동작)
long long r = (long long)big * big; // ✅ 계산 전에 큰 타입으로
의심스러우면 -fsanitize=undefined 로 컴파일해서 실행해 보세요.
실수 9: #define 에 세미콜론, 괄호 누락 (8절)
#define MAX 30;        // ❌ 세미콜론까지 바꿔 쳐진다
#define SUM 2 + 3      // ❌ SUM * 10 이 32가 된다
#define MAX 30         // ✅
#define SUM (2 + 3)    // ✅ 계산식은 괄호로 감싼다
13. 좋은 코딩 습관
1. 의미 있는 변수 이름 (5절)
// ❌ 나쁜 예
int a = 20;
double x = 175.5;

// ✅ 좋은 예
int student_age = 20;
double height_cm = 175.5;
이름에 단위를 넣으면(height_cm, weight_kg, timeout_ms) 단위를 헷갈려서 생기는 버그가 크게 줄어듭니다. BMI 계산기에서 cm 를 m 로 바꾸는 것을 잊으면 결과가 1만 배 틀어집니다.
2. 매직 넘버 피하기 (8절)
// ❌ 나쁜 예: 3.14159 가 무엇인지, 왜 이 정밀도인지 알 수 없다
double area = 3.14159 * radius * radius;

// ✅ 좋은 예
const double PI = 3.14159265358979323846;
double area = PI * radius * radius;
코드 한가운데 설명 없이 등장하는 숫자를 매직 넘버(magic number) 라고 부릅니다. 이름을 붙이면 뜻이 드러나고, 값을 바꿀 때 한 곳만 고치면 됩니다. 단, 0, 1, 공식의 9.0 / 5.0 처럼 뜻이 뻔한 숫자까지 이름을 붙일 필요는 없습니다.
3. 입력 검증 (7절)
printf("나이 입력: ");
if (scanf("%d", &age) != 1) {
    printf("오류: 숫자를 입력하세요!\n");
    return 1;
}

if (age < 0 || age > 150) {
    printf("오류: 올바른 나이를 입력하세요!\n");
    return 1;
}
사용자는 반드시 예상하지 못한 값을 넣습니다. 형식(숫자인가?)과 범위(말이 되는가?) 두 가지를 모두 확인하세요. 그리고 printf 'abc\n' | ./프로그램 처럼 파이프로도 시험하세요.
4. 주석은 “왜”를 적는다 (1주차 11절)
// 원의 넓이 계산: A = πr²
double area = PI * radius * radius;

// 섭씨를 화씨로 변환: F = C × 9/5 + 32
// (9 / 5 는 정수 나눗셈으로 1이 되므로 반드시 9.0 / 5.0)
double fahrenheit = celsius * 9.0 / 5.0 + 32.0;
두 번째 주석처럼 이 코드가 왜 이런 모양인지를 적어 두면, 나중에 누군가(미래의 나 포함) 9.0 을 9 로 “정리”해서 버그를 만드는 일을 막을 수 있습니다.
5. 경고를 더 켜 보기
1주차에 정한 -Wall -Wextra 에 더해, 이번 주에 새로 만난 옵션들입니다.
| 옵션 | 잡아 주는 것 | 이번 주에 본 곳 |
|---|---|---|
-Wconversion |
값이 바뀔 수 있는 자동 형 변환 | 9절 int truncated = pi; |
-fsanitize=undefined |
실행 중 정의되지 않은 동작 (정수 오버플로우 등) | 3절, 9절 |
평소에는 기본 명령으로 컴파일하고, 숫자가 이상하게 나오는 프로그램을 만나면 이 옵션들을 붙여서 다시 돌려 보세요.
마치며
이번 주에 여러분의 프로그램은 처음으로 기억하고, 입력받고, 계산했습니다. 돌아보면 이번 주의 핵심은 한 문장으로 모입니다.
메모리에는 비트만 있고, 그 비트의 뜻은 자료형이 정한다.
char에 200을 넣으니 −56이 됐고(3절),- −1을
unsigned로 읽으니 4294967295가 됐고(3절), - 실수 5.0의 비트를 정수로 읽으니 1084227584가 됐고(7절),
float는 16777217을 담지 못했고(4절),7 / 2는 두 값이int라서 3이 됐습니다(9절).
모두 같은 이야기입니다. 이 감각이 있으면 6주차 포인터에서 “메모리 주소에 있는 비트를 어떤 타입으로 읽을 것인가”라는 이야기가 자연스럽게 이어집니다.
그리고 scanf 를 쓰면서 프로그램 바깥에서 들어오는 값은 믿을 수 없다는 것을 배웠습니다. 반환값을 확인하고, 범위를 확인하고, 파이프로 이상한 입력을 흘려 넣어 시험하는 습관은 24주차 보안 프로그래밍까지 이어지는 가장 중요한 습관입니다.
다음 주차 예고
3주차에서는 연산자와 제어문을 배웁니다. 이번 주에 미리 맛본 것들이 본격적으로 나옵니다.
- 이번 주 11절에서 설명 없이 쓴
if,else if,switch는 정확히 어떻게 동작할까? - 7절의
while (getchar() ...)같은 반복문은 어떻게 만들까? %나머지 연산으로 짝수·홀수를 가르고, 1주차 12절의 별 삼각형을 반복문으로 그려 보기&&,||는 왜 “단락 평가”를 할까?- 비트 연산자로 2절에서 말한 “변수 안의 비트”를 직접 들여다보기
추가 연습 과제
모든 과제는 scanf 반환값 확인과 경고 0개를 지키세요.
초급
- 두 정수를 입력받아 합, 차, 곱, 몫, 나머지를 출력하세요. 몫은 정수 나눗셈과 실수 나눗셈 두 가지로 출력해서 차이를 확인하세요.
- 원의 반지름을 입력받아 둘레(2πr)와 넓이(πr²)를 소수점 둘째 자리까지 출력하세요. π 는
const double로 정의하세요. - 초를 입력받아 “시:분:초”로 바꾸세요. 예:
3725→1:02:05. 힌트:/와%, 그리고%02d.
중급
- 세 과목 점수를 입력받아 평균을 출력하세요.
int합계를 3으로 나눌 때 9절의 함정에 빠지지 않도록. - 문자 하나를 입력받아 ASCII 코드, 대문자면 소문자, 소문자면 대문자를 출력하세요(3절의 32 차이).
if는 3주차지만 11절의 모양을 흉내 내면 됩니다. int두 개를 입력받아 곱하되, 결과가int범위를 넘을 수 있으니long long으로 계산해 출력하세요.2000000000 2를 넣어 확인하세요.
고급
- 장바구니 계산기: 상품 가격(원)과 수량을 입력받아 총액을 출력하세요. 돈은 4절의 교훈대로 정수로 다루세요.
- 대출 이자 계산기: 원금, 연이율(%), 기간(년)을 입력받아 단리 이자와 총 상환액을 출력하세요. 퍼센트 입력을 소수로 바꿀 때의 나눗셈에 주의하세요.
sizeof와limits.h,float.h를 써서 이 컴퓨터의 모든 기본 자료형의 크기와 범위를 3절의 표처럼 정렬해서 출력하세요. 6절의 폭 지정(%-20s,%25lld)을 쓰세요.
체크리스트
각 항목을 설명할 수 있으면 체크합니다.
- [ ] 변수가 “메모리의 몇 칸 + 이름 + 자료형”이라는 것을 설명할 수 있다
- [ ]
=가 “같다”가 아니라 “대입”이라는 것을 안다 - [ ] 초기화하지 않은 변수가 왜 위험한지,
-O2에서 0이 나와도 왜 믿으면 안 되는지 안다 - [ ] 8비트로 셀 수 있는 가짓수와 signed / unsigned 범위를 설명할 수 있다
- [ ]
char가 1바이트 정수이고'A'가 65라는 것을 안다 - [ ] 크기와 범위를 외우지 않고
sizeof,limits.h,float.h로 확인할 수 있다 - [ ] signed 정수 오버플로우가 “정의되지 않은 동작”이라는 뜻을 안다
- [ ]
0.1 + 0.2 != 0.3인 이유를 설명하고, 실수를 epsilon 으로 비교할 수 있다 - [ ]
printf서식 지정자의 구조(%[플래그][폭][.정밀도][크기]변환)를 읽을 수 있다 - [ ]
scanf에&가 필요한 이유를 설명할 수 있다 - [ ] 입력 버퍼와
%c앞 공백의 관계를 설명할 수 있다 - [ ]
scanf의 반환값(1, 0, EOF)을 확인하는 코드를 쓸 수 있다 - [ ]
#define과const의 차이를 알고,#define의 함정 세 가지를 안다 - [ ]
7 / 2가 3인 이유와 해결법을 안다 - [ ] 자동 형 변환에서 정보가 사라지는 경우를 알고
-Wconversion으로 찾을 수 있다 - [ ] 계산기, 온도 변환기, BMI 계산기를 직접 만들고 잘못된 입력으로 시험해 봤다
모든 항목을 체크했다면, 3주차로 넘어갈 준비가 되었습니다!