들어가며
4주차에 배열을 정렬하는 버블 정렬을 만들었습니다. 그런데 한 프로그램 안에서 점수 배열도 정렬하고, 나이 배열도 정렬하고, 키 배열도 정렬해야 한다면 어떻게 할까요? 지금까지 배운 것만으로는 정렬 코드를 세 번 복사해서 붙여 넣는 수밖에 없습니다. 그러다 정렬 코드에서 버그를 하나 발견하면? 세 군데를 똑같이 고쳐야 하고, 한 군데라도 빼먹으면 어떤 배열은 제대로 정렬되고 어떤 배열은 안 되는, 찾기 아주 어려운 버그가 생깁니다.
사실 우리는 1주차부터 이 문제의 답을 쓰고 있었습니다. printf 는 우리가 만들지 않았는데도, 이름만 부르면 화면에 글자를 찍어 줍니다. 수천 줄짜리 출력 코드가 printf 라는 이름 하나 뒤에 숨어 있기 때문입니다. 이렇게 “작업 하나를 이름으로 묶어 둔 것”이 함수(function) 입니다. 이번 주에는 printf 를 쓰기만 하던 쪽에서, 함수를 직접 만드는 쪽으로 넘어갑니다.
그리고 함수가 많아지면 한 파일에 다 넣기 어려워집니다. 1주차 7절에서 “파일이 여러 개면 따로 컴파일해서 링크한다”는 이야기를 잠깐 했고, 2절에서는 touch 로 파일의 수정 시각을 바꾸면서 “5주차에 make 를 속여 보는 실험을 한다”고 약속했습니다. 이번 주 후반부는 그 약속을 지키는 시간입니다. 프로그램을 여러 파일로 나누고(모듈화), 그 파일들을 make 로 똑똑하게 빌드합니다.
이번 주차를 마치면 다음을 할 수 있게 됩니다.
- 함수를 정의하고, 선언하고, 호출할 수 있다. 세 단어의 차이를 설명할 수 있다
- 매개변수와 인자, 반환값이 정확히 무엇이고 어떻게 오가는지 안다
- C의 인자 전달이 복사(call by value) 라는 것을 주소를 찍어 눈으로 확인한다
- 변수가 어디서 보이고(범위) 언제까지 살아 있는지(수명) 구분한다
- 재귀 함수를 만들고, 재귀가 스택을 얼마나 쓰는지, 언제 위험한지 안다
- 프로그램을
.h와.c로 나누고, 링크 오류를 읽고 고칠 수 있다 - Makefile 을 한 줄씩 읽고 쓸 수 있고,
make가 무엇을 다시 컴파일할지 예측할 수 있다
이번 주 예제를 준비하기
이번 주 예제는 저장소의 week05/ 폴더에 있습니다.
week05/
├── examples/     ← 개념 예제 10개 (.c)
├── projects/     ← 실습 프로젝트 4개 (.c)
├── modular/      ← 여러 파일로 나눈 예제 (.h, .c, Makefile)
├── Makefile      ← 이 주차 전체를 빌드하는 Makefile
└── build/        ← make 가 만든 실행 파일이 들어가는 곳
week05 폴더에서 make 를 치면 예제와 프로젝트가 전부 컴파일되고, 실행 파일은 build/examples/ 와 build/projects/ 에 생깁니다.
$ cd week05
$ make
mkdir -p build/examples
gcc -Wall -Wextra -std=c11 -g -O0 -o build/examples/call_by_value examples/call_by_value.c
gcc -Wall -Wextra -std=c11 -g -O0 -o build/examples/function_array examples/function_array.c
...
=== 예제 컴파일 완료 ===
...
=== 프로젝트 컴파일 완료 ===
$ ./build/examples/function_basic
make 가 무엇이고 이 명령이 어떻게 동작하는지는 7절에서 한 줄씩 뜯어봅니다. 그 전까지는 “make 를 치면 예제가 컴파일된다”는 것만 알면 됩니다. 1주차처럼 gcc -Wall -Wextra -std=c11 파일.c -o 파일 로 하나씩 컴파일해도 결과는 같습니다.
예제를 직접 타이핑해 보고 싶다면 1주차처럼 ~/c_programming/week05 폴더를 만들어 거기서 작업하세요. 이 글의 짧은 실험 코드들은 저장소에 없고 글에만 있으니, 직접 만들어서 컴파일해 봐야 합니다.
1. 함수란 무엇인가?
1.1 함수의 필요성
두 수 중 큰 값을 구하는 코드를 세 번 써야 한다고 해 봅시다. 3주차에 배운 조건문으로 이렇게 쓸 수 있습니다.
int a = 3, b = 5;
int max1;
if (a > b) max1 = a; else max1 = b;

int c = 10, d = 7;
int max2;
if (c > d) max2 = c; else max2 = d;

int e = 1, f = 9;
int max3;
if (e > f) max3 = e; else max3 = f;
같은 모양이 세 번 반복됩니다. 이름만 바뀌었을 뿐 하는 일은 “두 수 중 큰 것 고르기” 하나입니다. 이 일을 함수로 묶으면 이렇게 됩니다.
int max(int x, int y) {
    if (x > y) {
        return x;
    }
    return y;
}

int max1 = max(3, 5);
int max2 = max(10, 7);
int max3 = max(1, 9);
“큰 값 고르기”라는 로직은 한 곳에만 있고, 쓰는 쪽은 이름만 부릅니다. 이것만으로도 얻는 것이 네 가지입니다.
| 이점 | 뜻 | 예 |
|---|---|---|
| 재사용 | 한 번 만들어서 몇 번이든 부른다 | max 를 100번 불러도 코드는 한 벌 |
| 가독성 | 이름만 봐도 무엇을 하는지 안다 | if (a > b) ... else ... 보다 max(a, b) 가 한눈에 읽힌다 |
| 유지보수 | 고칠 곳이 한 군데 | max 에 버그가 있으면 함수 하나만 고친다 |
| 분업 | 큰 문제를 작은 함수 여러 개로 나눈다 | “입력받기”, “계산하기”, “출력하기”를 각각 함수로 |
마지막 분업이 사실 가장 중요합니다. 프로그램이 커질수록 “한 번에 전부 생각하기”가 불가능해집니다. 함수로 나누면 한 번에 작은 문제 하나만 생각하면 됩니다. max 를 만드는 동안에는 max 만 생각하고, 다 만든 뒤에는 max 가 어떻게 동작하는지 잊고 무엇을 하는지만 기억하면 됩니다. 우리가 printf 의 내부를 몰라도 잘 쓰고 있는 것처럼요.
1.2 함수의 구조 — 한 줄씩 해부하기
두 정수를 더하는 함수를 봅시다.
int add(int a, int b) {
    int sum = a + b;
    return sum;
}
1주차에 main 을 한 줄씩 뜯어봤던 것처럼, 첫 줄을 조각내 봅시다.
int      add      (int a, int b)      {
 │        │              │            │
 │        │              │            └─ 본문 시작
 │        │              └────────────── 매개변수 목록: 이 함수가 받는 값
 │        └───────────────────────────── 함수 이름: 부를 때 쓰는 이름
 └────────────────────────────────────── 반환형: 돌려주는 값의 자료형
| 부분 | 이름 | 뜻 |
|---|---|---|
int |
반환형(return type) | 이 함수가 일을 마치고 돌려주는 값의 자료형. 2주차에 배운 int, double, char 등 무엇이든 됩니다 |
add |
함수 이름 | 변수 이름과 같은 규칙: 영문자, 숫자, _ 만 쓰고 숫자로 시작할 수 없습니다. 대소문자를 구분합니다 |
(int a, int b) |
매개변수(parameter) | 함수가 받는 값. “자료형 이름” 쌍을 쉼표로 나열합니다 |
{ ... } |
본문(body) | 실제로 할 일 |
return sum; |
반환문 | sum 의 값을 부른 쪽에 돌려주고, 함수를 그 자리에서 끝냅니다 |
이제 이 함수를 불러 봅시다.
int result = add(3, 5);
이것을 함수 호출(call) 이라고 합니다. 이 한 줄이 실행될 때 무슨 일이 일어나는지 순서대로 보면 이렇습니다.
① main 이 add(3, 5) 를 만난다
② 3 이 a 에, 5 가 b 에 들어간다            ← 값이 "복사"되어 넘어감 (2절)
③ main 은 그 자리에서 멈추고, add 의 본문이 실행된다
④ sum = 3 + 5 = 8
⑤ return sum; → 8 을 들고 main 으로 돌아간다
⑥ main 은 멈췄던 자리에서 이어서, add(3, 5) 자리를 8 로 바꿔 끼운다
⑦ result = 8
핵심은 ⑥입니다. 함수 호출은 그 자리가 반환값으로 바뀌는 식(expression) 입니다. 그래서 add(3, 5) 는 숫자 8 이 올 수 있는 곳이면 어디든 쓸 수 있습니다. 변수에 넣어도 되고, printf 에 바로 넘겨도 되고, 다른 함수의 인자로 줘도 됩니다.
매개변수와 인자 — 비슷하지만 다른 두 단어
- 매개변수(parameter): 함수를 만들 때 괄호 안에 적는 변수.
int add(int a, int b)의a,b. “빈 그릇”입니다. - 인자(argument): 함수를 부를 때 괄호 안에 넣는 실제 값.
add(3, 5)의3,5. 그릇에 담기는 “내용물”입니다.
영어 문서와 오류 메시지에서 두 단어가 구분되어 쓰이니 기억해 두세요. 3절에서 보게 될 too many arguments to function 은 “부를 때 넣은 값(인자)이 너무 많다”는 뜻입니다.
예제: function_basic.c
examples/function_basic.c:
#include <stdio.h>

/* 두 정수를 더해서 반환하는 함수 */
int add(int a, int b)
{
    return a + b;  /* return 문으로 결과값을 호출한 쪽에 돌려준다 */
}

/* 두 정수를 곱해서 반환하는 함수 */
int multiply(int a, int b)
{
    return a * b;
}

/* 두 정수 중 더 큰 값을 반환하는 함수 */
int max(int a, int b)
{
    if (a > b) {
        return a;   /* 조건에 따라 여러 개의 return 을 둘 수 있다 */
    }
    return b;
}

/* 정수의 제곱을 반환하는 함수 (함수 안에서 다른 함수를 호출) */
int square(int n)
{
    return multiply(n, n);  /* 함수는 다른 함수를 호출할 수 있다 */
}

int main(void)
{
    printf("╔════════════════════════════════════════╗\n");
    printf("║          함수 기초 예제                ║\n");
    printf("╚════════════════════════════════════════╝\n\n");

    int x = 7;
    int y = 3;

    int sum = add(x, y);          /* 반환값을 변수에 저장 */
    int product = multiply(x, y);

    printf("x = %d, y = %d\n\n", x, y);
    printf("add(x, y)      = %d\n", sum);
    printf("multiply(x, y) = %d\n", product);
    printf("max(x, y)      = %d\n", max(x, y));   /* 반환값을 바로 출력에 사용 */
    printf("square(x)      = %d\n", square(x));

    /* 함수 호출을 식 안에서 조합할 수도 있다 */
    printf("\nadd(square(y), multiply(x, y)) = %d\n",
           add(square(y), multiply(x, y)));

    return 0;
}
(파일 맨 위의 설명 주석은 줄였습니다. 저장소 파일에는 더 자세한 주석이 있습니다.)
$ ./build/examples/function_basic
╔════════════════════════════════════════╗
║          함수 기초 예제                ║
╚════════════════════════════════════════╝

x = 7, y = 3

add(x, y)      = 10
multiply(x, y) = 21
max(x, y)      = 7
square(x)      = 49

add(square(y), multiply(x, y)) = 30
코드 읽기 포인트
return a + b;:add는 1.2절의 예와 달리sum변수를 만들지 않고 계산식을 바로 돌려줍니다.return뒤에는 변수뿐 아니라 값이 되는 식이면 무엇이든 올 수 있습니다.max의return두 개:a > b면 첫 번째return a;에서 함수가 즉시 끝납니다. 아래의return b;는 실행되지 않습니다. 그래서else를 쓰지 않아도 됩니다.return은 “값을 돌려준다”와 “함수를 끝낸다”를 동시에 합니다.square가multiply를 부름: 함수 안에서 다른 함수를 부를 수 있습니다.square(7)→multiply(7, 7)→49가square로 돌아오고, 그것이 다시main으로 돌아옵니다.- 마지막 줄의 중첩 호출:
add(square(y), multiply(x, y))는 안쪽부터 계산됩니다.square(3)은 9,multiply(7, 3)은 21, 그다음add(9, 21)이 30입니다. 수학의f(g(x))와 같습니다.
알아 두면 좋은 사실: 인자는 어떤 순서로 계산될까?
add(square(y), multiply(x, y))에서square(y)와multiply(x, y)중 무엇이 먼저 계산될까요? C 표준은 정하지 않았습니다. 컴파일러 마음대로입니다. 이 예제처럼 두 함수가 서로 영향을 주지 않으면 상관없지만, 둘 다 화면에 무언가를 찍는 함수라면 출력 순서가 컴파일러마다 달라질 수 있습니다. 순서가 중요하면 따로 변수에 받아 두고 넘기세요.
실험: 자료형이 다른 값을 넘기면?
square 는 int 를 받습니다. 여기에 2.9 를 넘기면 어떻게 될까요? convert.c 를 만들어 봅시다.
#include <stdio.h>

int square(int n) {
    return n * n;
}

int main(void) {
    printf("%d\n", square(2.9));
    return 0;
}
$ gcc -Wall -Wextra -std=c11 convert.c -o convert
$ ./convert
4
경고 하나 없이 4 가 나왔습니다. 2.9 × 2.9 = 8.41 이 아니라, 2.9 가 int 로 바뀌면서 소수점 아래를 잘라 2 가 되었고, 2 × 2 = 4 입니다. 2주차에 배운 “실수를 정수에 넣으면 소수점 아래가 버려진다”는 규칙이 함수 인자에도 그대로 적용된 것입니다. 컴파일러는 매개변수의 자료형을 보고 알아서 바꿔 넣습니다(암묵적 형 변환).
-Wall -Wextra 로도 아무 말이 없다는 게 무섭습니다. 이런 변환을 잡아 주는 옵션이 따로 있습니다.
$ gcc -Wall -Wextra -Wconversion -std=c11 convert.c -o convert
convert.c: In function ‘main’:
convert.c:8:27: warning: conversion from ‘double’ to ‘int’ changes value from ‘2.8999999999999999e+0’ to ‘2’ [-Wfloat-conversion]
    8 |     printf("%d\n", square(2.9));
      |                           ^~~
“double 을 int 로 바꾸면서 값이 2.8999… 에서 2 로 바뀐다”고 정확히 알려 줍니다. 메시지에 2.9 가 아니라 2.8999999999999999 로 나오는 것도 흥미롭습니다. 2주차에 본 대로, 2.9 는 컴퓨터 안에서 정확히 표현되지 않는 수이기 때문입니다. -Wconversion 은 경고가 너무 많이 나와서 -Wall 에 포함되지 않았지만, 계산이 중요한 프로그램에서는 켜 보는 것이 좋습니다.
1.3 반환값이 없는 함수 — void
모든 함수가 값을 돌려줄 필요는 없습니다. 구분선을 찍거나 인사말을 출력하는 함수처럼, 값보다 동작 자체가 목적인 함수도 있습니다. 이런 함수는 반환형 자리에 void(비어 있음)를 씁니다. 1주차에 int main(void) 의 괄호 안에서 본 그 void 입니다. 괄호 안에서는 “받는 게 없다”, 반환형 자리에서는 “돌려주는 게 없다”는 뜻입니다.
examples/function_void.c:
#include <stdio.h>

/* 구분선을 출력하는 void 함수 (반환값 없음) */
void print_line(void)
{
    printf("----------------------------------------\n");
}

/* 이름을 받아 인사말을 출력하는 void 함수 */
void greet(const char *name)
{
    printf("안녕하세요, %s 님!\n", name);
    /* 값을 돌려줄 필요가 없으므로 return 문이 없다 */
}

/* 값을 반환하는 함수와 비교 */
int double_value(int n)
{
    return n * 2;
}

int main(void)
{
    printf("╔════════════════════════════════════════╗\n");
    printf("║          void 함수 예제                ║\n");
    printf("╚════════════════════════════════════════╝\n\n");

    /* void 함수 호출: 반환값이 없으므로 변수에 담지 않고 그냥 호출만 한다 */
    print_line();
    greet("철수");
    greet("영희");
    print_line();

    /* 반환값이 있는 함수: 결과를 변수에 저장해 재사용 */
    int result = double_value(21);
    printf("\ndouble_value(21) = %d\n", result);
    printf("그 값에 1을 더하면 = %d\n", result + 1);

    print_line();
    printf("void 함수는 '동작', 반환 함수는 '값'에 집중한다.\n");
    print_line();

    return 0;
}
$ ./build/examples/function_void
╔════════════════════════════════════════╗
║          void 함수 예제                ║
╚════════════════════════════════════════╝

----------------------------------------
안녕하세요, 철수 님!
안녕하세요, 영희 님!
----------------------------------------

double_value(21) = 42
그 값에 1을 더하면 = 43
----------------------------------------
void 함수는 '동작', 반환 함수는 '값'에 집중한다.
----------------------------------------
코드 읽기 포인트
print_line(void): 받는 것도 없고(괄호 안void) 돌려주는 것도 없는(앞의void) 함수입니다. 부를 때는print_line();처럼 빈 괄호를 반드시 붙입니다. 괄호가 있어야 “부른다”는 뜻이 됩니다.greet(const char *name): 문자열을 받는 매개변수입니다.char *는 6주차에 배울 포인터이고, 지금은 “문자열을 받는 자리” 라고 읽으면 됩니다. 4주차의 문자열이 이 모양으로 함수에 넘어갑니다.const는 “이 함수는 받은 문자열을 고치지 않겠다”는 약속입니다(2.3절).print_line을 세 번 재사용: 구분선 모양을=로 바꾸고 싶다면?print_line안의 한 줄만 고치면 세 곳이 한꺼번에 바뀝니다. 1.1절의 “유지보수” 이점입니다.
실험: void 함수의 값을 받으려고 하면?
돌려주는 값이 없는 함수의 “값”을 변수에 넣으려고 하면 어떻게 될까요?
int r = print_line();
$ gcc -Wall -Wextra -std=c11 voiduse.c -o voiduse
voiduse.c: In function ‘main’:
voiduse.c:8:13: error: void value not ignored as it ought to be
    8 |     int r = print_line();
      |             ^~~~~~~~~~
“void 값은 무시되어야 하는데 무시되지 않았다”는 오류입니다. 없는 값을 쓸 수는 없으니 당연합니다. 반대로, 값을 돌려주는 함수의 반환값을 무시하는 것은 괜찮습니다. double_value(21); 이라고만 쓰면 계산된 42 는 그냥 버려집니다. 사실 printf 도 출력한 글자 수를 int 로 돌려주는 함수인데, 우리는 1주차부터 그 값을 한 번도 받지 않고 버려 왔습니다. man 3 printf 의 RETURN VALUE 부분을 확인해 보세요.
void 함수에서 return 쓰기
void 함수에서도 return 을 쓸 수 있습니다. 값 없이 return; 이라고만 쓰면 함수를 그 자리에서 끝내라는 뜻이 됩니다. 이상한 입력을 만났을 때 일찍 빠져나오는 데 씁니다.
void greet(const char *name) {
    if (name[0] == '\0') {
        printf("이름이 비어 있습니다.\n");
        return;                          /* 여기서 끝. 아래 줄은 실행되지 않는다 */
    }
    printf("안녕하세요, %s 님!\n", name);
}
$ ./voidret
이름이 비어 있습니다.
안녕하세요, 철수 님!
greet("") 를 부르면 빈 문자열이라 첫 if 에서 return; 으로 끝나고, greet("철수") 는 끝까지 실행됩니다. 4주차에 배운 대로 빈 문자열 "" 는 첫 글자가 바로 \0 인 문자열입니다.
반대로,
int함수에서return을 빼먹으면? 1주차 10절의 “에러 5″에서 봤습니다.control reaches end of non-void function경고가 나오고, 함수는 쓰레기 값을 돌려줍니다. 1주차 7절에서 본 대로 반환값은eax라는 저장 칸으로 전달되는데, 아무것도 넣지 않았으니 거기 우연히 남아 있던 값이 나오는 것입니다.main만은 예외라서return이 없으면 0을 돌려줍니다.
2. 매개변수와 call by value
2.1 값에 의한 전달
이번 절의 질문은 이것입니다. 함수 안에서 매개변수를 바꾸면, 부른 쪽의 변수도 바뀔까?
examples/call_by_value.c:
#include <stdio.h>

/* 매개변수 n 을 100으로 바꾸지만, 이는 복사본일 뿐이다 */
void modify(int n)
{
    printf("  [modify] 시작 시 n = %d\n", n);
    n = 100;  /* 복사본만 바뀐다. 원본에는 영향이 없다 */
    printf("  [modify] 변경 후 n = %d\n", n);
}

/*
 * 두 값을 '교환하려고' 시도하지만 실패하는 함수.
 * a, b 는 복사본이므로 여기서 아무리 바꿔도 원본은 그대로다.
 */
void try_swap(int a, int b)
{
    int temp = a;
    a = b;
    b = temp;
    printf("  [try_swap] 함수 안: a = %d, b = %d (복사본만 교환됨)\n", a, b);
}

int main(void)
{
    printf("╔════════════════════════════════════════╗\n");
    printf("║        값에 의한 전달 예제             ║\n");
    printf("╚════════════════════════════════════════╝\n\n");

    int num = 5;
    printf("[호출 전]  num = %d\n", num);
    modify(num);   /* num 의 값 5가 복사되어 전달된다 */
    printf("[호출 후]  num = %d  <- 원본은 그대로!\n\n", num);

    int x = 1;
    int y = 2;
    printf("[교환 전]  x = %d, y = %d\n", x, y);
    try_swap(x, y);
    printf("[교환 후]  x = %d, y = %d  <- 교환 안 됨!\n\n", x, y);

    printf("정리: 인자는 '값(복사본)'으로 전달되므로\n");
    printf("      함수 안에서의 변경은 원본에 반영되지 않는다.\n");

    return 0;
}
실행하기 전에 예상해 보세요. [호출 후] 줄의 num 은 5일까요, 100일까요?
$ ./build/examples/call_by_value
╔════════════════════════════════════════╗
║        값에 의한 전달 예제             ║
╚════════════════════════════════════════╝

[호출 전]  num = 5
  [modify] 시작 시 n = 5
  [modify] 변경 후 n = 100
[호출 후]  num = 5  <- 원본은 그대로!

[교환 전]  x = 1, y = 2
  [try_swap] 함수 안: a = 2, b = 1 (복사본만 교환됨)
[교환 후]  x = 1, y = 2  <- 교환 안 됨!

정리: 인자는 '값(복사본)'으로 전달되므로
      함수 안에서의 변경은 원본에 반영되지 않는다.
modify 안에서는 분명히 n = 100 이 되었는데, main 으로 돌아오니 num 은 그대로 5입니다. try_swap 도 함수 안에서는 교환에 성공했지만, 밖에서 보면 아무 일도 없었습니다.
이유는 함수를 부를 때 변수 자체가 아니라 변수의 값이 복사되어 넘어가기 때문입니다. modify(num) 을 부르는 순간 num 의 값 5가 새 변수 n 에 복사됩니다. n 과 num 은 이름도 다르지만, 무엇보다 메모리에서 서로 다른 칸입니다. 이 방식을 값에 의한 전달(call by value) 이라고 하고, C의 함수 인자는 전부 이 방식입니다.
비유하자면 친구에게 내 공책을 빌려주는 게 아니라 복사본을 떠서 주는 것입니다. 친구가 복사본에 낙서를 해도 내 공책은 멀쩡합니다.
실험: 정말 다른 칸일까? 주소를 찍어 보자
“메모리에서 서로 다른 칸”이라는 말이 정말인지 눈으로 확인할 수 있습니다. 변수 이름 앞에 & 를 붙이면 그 변수가 메모리의 어디에 있는지(주소) 를 얻을 수 있고, printf 의 %p 는 주소를 출력하는 서식 지정자입니다. 6주차의 주인공인 포인터를 살짝 미리 보는 셈입니다. 지금은 “&변수 는 그 변수의 위치 번호”라고만 알면 됩니다.
addr.c:
#include <stdio.h>

void modify(int x) {
    printf("modify 안의 x: 값 %d, 주소 %p\n", x, (void *)&x);
    x = 100;
}

int main(void) {
    int a = 10;
    printf("main 안의 a  : 값 %d, 주소 %p\n", a, (void *)&a);
    modify(a);
    printf("호출 후 a    : 값 %d\n", a);
    return 0;
}
(void *) 는 %p 에 맞는 모양으로 바꿔 주는 표기인데, 6주차에 설명합니다. 지금은 그대로 따라 쓰세요.
$ gcc -Wall -Wextra -std=c11 addr.c -o addr
$ ./addr
main 안의 a  : 값 10, 주소 0x7ffe2dc282c4
modify 안의 x: 값 10, 주소 0x7ffe2dc282ac
호출 후 a    : 값 10
a 와 x 는 값은 10으로 같지만 주소가 다릅니다. ...2c4 와 ...2ac, 메모리의 서로 다른 칸입니다. x = 100 은 ...2ac 칸에 100을 쓴 것이니, ...2c4 칸의 a 는 영향을 받을 수가 없습니다.
한 번 더 실행해 보세요.
$ ./addr
main 안의 a  : 값 10, 주소 0x7ffe471dedf4
modify 안의 x: 값 10, 주소 0x7ffe471deddc
호출 후 a    : 값 10
주소가 실행할 때마다 바뀝니다. 1주차 7절에서 본 pie executable 과 관련된 보안 기능 때문인데, 24주차에 다룹니다. 그래도 두 주소가 서로 다르다는 사실은 매번 같습니다. 두 주소의 차이도 매번 0x18(= 24바이트)로 똑같습니다. 함수가 호출될 때 메모리의 어디에 자리를 잡는지에 규칙이 있다는 뜻입니다. 이 규칙은 5.1절에서 재귀를 보며 다시 만납니다.
2.2 그럼 swap 은 어떻게 만들까?
두 변수의 값을 맞바꾸는 swap 은 정렬 같은 곳에서 꼭 필요합니다. 4주차 버블 정렬에서도 temp 를 써서 교환했죠. 그런데 교환을 함수로 만들면 위의 try_swap 처럼 실패합니다. 함수는 복사본만 받으니까요.
해결책은 값 대신 주소를 넘기는 것입니다. 친구에게 공책 복사본 대신 “내 공책은 3번 사물함에 있어”라고 위치를 알려 주면, 친구가 그 사물함에 가서 진짜 공책에 쓸 수 있습니다. 주소를 넘겨서 원본을 바꾸는 방식을 흔히 call by reference(참조에 의한 전달) 라고 부르고, 이것을 하려면 주소를 저장하는 변수인 포인터가 필요합니다. 그래서 swap 은 다음 주 6주차의 첫 번째 목표입니다.
지금 기억할 것은 두 가지입니다.
- C의 기본은 복사다. 함수 안에서 매개변수를 아무리 바꿔도 부른 쪽의 변수는 안전하다.
- 그래서 함수가 결과를 알려 주는 정식 통로는
return값이다.
8.1절의 계산기 프로젝트에는
divide(a, b, &ok)처럼&를 붙여 부르는 곳이 있습니다. “나눗셈 결과”와 “0으로 나눴는지 여부”, 두 가지를 알려 주고 싶은데return은 하나만 돌려줄 수 있어서 주소를 넘긴 것입니다. 6주차에 이 방식을 제대로 배웁니다.
2.3 배열은 예외처럼 보인다
그런데 배열을 함수에 넘기면 이야기가 조금 달라집니다. 먼저 정상적인 사용부터 봅시다.
examples/function_array.c:
#include <stdio.h>

/* 배열의 모든 원소를 더해 합계를 반환한다. */
int array_sum(const int arr[], int size)
{
    int sum = 0;
    for (int i = 0; i < size; i++) {
        sum += arr[i];
    }
    return sum;
}

/* 평균을 반환한다. (정수 나눗셈 오차를 피하려고 double로 계산) */
double array_average(const int arr[], int size)
{
    if (size == 0) {
        return 0.0;   /* 0으로 나누는 것을 방지 */
    }
    int sum = array_sum(arr, size);   /* 위에서 만든 함수를 재사용 */
    return (double)sum / size;
}

/* 배열에서 가장 큰 값을 반환한다. */
int array_max(const int arr[], int size)
{
    int max = arr[0];                 /* 첫 원소를 후보로 시작 */
    for (int i = 1; i < size; i++) {
        if (arr[i] > max) {
            max = arr[i];
        }
    }
    return max;
}

int main(void)
{
    printf("╔════════════════════════════════════════╗\n");
    printf("║        배열을 함수에 전달하기 예제     ║\n");
    printf("╚════════════════════════════════════════╝\n\n");

    int scores[] = {85, 92, 78, 90, 66, 100, 73};

    /* 원소 개수는 main 안에서만 sizeof 로 구할 수 있다. */
    int size = (int)(sizeof(scores) / sizeof(scores[0]));

    printf("배열 원소 (%d개): ", size);
    for (int i = 0; i < size; i++) {
        printf("%d ", scores[i]);
    }
    printf("\n");
    printf("----------------------------------------\n");

    /* 배열과 크기를 함께 넘겨 각 함수를 호출한다. */
    printf("합계   : %d\n", array_sum(scores, size));
    printf("평균   : %.2f\n", array_average(scores, size));
    printf("최댓값 : %d\n", array_max(scores, size));

    printf("\n[정리]\n");
    printf(" - 배열은 함수에 넘길 수 있지만, 크기(개수)는 함께 넘겨야 한다.\n");
    printf(" - 함수 안에서는 배열의 길이를 스스로 알 수 없기 때문이다.\n");
    printf(" - 값을 바꾸지 않는 함수는 const를 붙여 '읽기 전용'임을 표시하면 좋다.\n");

    return 0;
}
$ ./build/examples/function_array
╔════════════════════════════════════════╗
║        배열을 함수에 전달하기 예제     ║
╚════════════════════════════════════════╝

배열 원소 (7개): 85 92 78 90 66 100 73
----------------------------------------
합계   : 584
평균   : 83.43
최댓값 : 100
...
코드 읽기 포인트
const int arr[]: 배열 매개변수는 크기 없이[]로 씁니다. 어떤 크기의 배열이든 받을 수 있다는 뜻입니다.int size: 배열과 항상 짝으로 원소 개수를 따로 받습니다. 이유는 바로 아래 실험에서 봅니다.array_average가array_sum을 부름: 이미 만든 함수를 재사용했습니다. 합계 구하는 코드를 두 번 쓰지 않았습니다.(double)sum / size: 2주차에 본 형 변환입니다.int / int는 소수점을 버리므로(584 / 7 = 83), 한쪽을double로 바꿔서 83.43 을 얻습니다.if (size == 0) return 0.0;: 0으로 나누는 것을 막는 방어 코드입니다. 함수는 어떤 값이 들어올지 모르는 채로 만들어지므로, 이상한 입력을 먼저 걸러 두는 습관이 중요합니다.
실험: 함수 안에서 sizeof 를 쓰면?
4주차에 배열의 원소 개수를 sizeof(배열) / sizeof(배열[0]) 로 구했습니다. 그럼 함수 안에서도 그렇게 하면 size 를 따로 안 받아도 되지 않을까요? arrsize.c:
#include <stdio.h>

void show_size(int arr[]) {
    printf("함수 안 sizeof(arr) = %zu\n", sizeof(arr));
}

void set_zero(int arr[], int size) {
    for (int i = 0; i < size; i++) {
        arr[i] = 0;
    }
}

int main(void) {
    int nums[5] = {1, 2, 3, 4, 5};
    printf("main 안 sizeof(nums) = %zu\n", sizeof(nums));
    show_size(nums);
    set_zero(nums, 5);
    printf("set_zero 후 nums[0] = %d, nums[4] = %d\n", nums[0], nums[4]);
    return 0;
}
%zu 는 sizeof 의 결과(size_t 라는 자료형)를 출력하는 서식 지정자입니다.
$ gcc -Wall -Wextra -std=c11 arrsize.c -o arrsize
arrsize.c: In function ‘show_size’:
arrsize.c:4:49: warning: ‘sizeof’ on array function parameter ‘arr’ will return size of ‘int *’ [-Wsizeof-array-argument]
    4 |     printf("함수 안 sizeof(arr) = %zu\n", sizeof(arr));
      |                                                 ^
arrsize.c:3:20: note: declared here
    3 | void show_size(int arr[]) {
      |                ~~~~^~~~~
$ ./arrsize
main 안 sizeof(nums) = 20
함수 안 sizeof(arr) = 8
set_zero 후 nums[0] = 0, nums[4] = 0
두 가지 놀라운 결과가 나왔습니다.
첫째, 함수 안의 sizeof(arr) 는 20이 아니라 8입니다. int 5개면 4 × 5 = 20바이트여야 하는데 8이 나왔습니다. GCC 경고가 이유를 말해 줍니다. “배열 매개변수에 sizeof 를 쓰면 int * 의 크기가 나온다.” int * 는 6주차에 배울 “int 를 가리키는 주소”이고, 64비트 컴퓨터에서 주소는 8바이트입니다. 즉 함수에 넘어온 것은 배열 전체가 아니라 배열이 시작하는 주소라는 뜻입니다. 그래서 함수 안에서는 배열의 길이를 알 방법이 없고, size 를 따로 받아야 합니다.
둘째, set_zero 가 원본을 바꿨습니다. 2.1절에서는 함수 안의 변경이 원본에 영향을 주지 않았는데, 이번에는 main 의 nums 가 전부 0이 되었습니다. 첫째 결과와 같은 이유입니다. 함수가 받은 것이 배열이 있는 주소이므로, arr[i] = 0 은 주소를 따라가서 원본 배열의 칸에 0을 씁니다. 사물함 번호를 받은 친구가 진짜 공책에 쓴 것과 같습니다.
그럼 call by value 가 깨진 걸까요? 아닙니다. 정확히 말하면 주소라는 값이 복사되어 넘어갔고, 그 주소가 가리키는 곳은 원본이라서 원본이 바뀌는 것입니다. C의 인자 전달은 여전히 전부 복사입니다. 이 미묘한 이야기는 6주차 “포인터와 배열의 관계”에서 완전히 풀립니다. 지금은 두 가지만 기억하세요.
- 배열을 넘길 때는 크기를 따로 넘긴다.
- 배열을 받은 함수는 원본을 바꿀 수 있다.
const — “나는 안 바꾼다”는 약속
2번 때문에 생기는 걱정이 있습니다. array_sum 을 부를 때, 이 함수가 실수로 내 배열을 망가뜨리면 어떡하죠? 그래서 function_array.c 의 함수들은 매개변수에 const 를 붙였습니다.
int array_sum(const int arr[], int size)
const 는 “이 배열을 읽기만 하고 고치지 않겠다”는 약속이고, 컴파일러가 이 약속을 검사합니다. array_sum 안에 실수로 arr[0] = 0; 이라고 쓰면 컴파일 오류가 납니다(직접 해 보세요. assignment of read-only location 이라는 오류가 나옵니다). 부르는 쪽은 const 를 보고 “이 함수는 내 배열을 안 건드린다”고 안심할 수 있습니다. 값을 바꿀 필요가 없는 배열 매개변수에는 항상 const 를 붙이는 습관을 들이세요.
3. 함수 프로토타입과 선언
3.1 컴파일러는 위에서 아래로 읽는다
지금까지의 예제는 모두 함수를 main 위에 만들었습니다. 순서를 바꿔서 main 을 먼저 쓰고 함수를 아래에 두면 어떻게 될까요? noproto.c:
#include <stdio.h>

int main(void) {
    printf("%d\n", add(3, 5));
    return 0;
}

int add(int a, int b) {
    return a + b;
}
$ gcc -Wall -Wextra -std=c11 noproto.c -o noproto
noproto.c: In function ‘main’:
noproto.c:4:20: warning: implicit declaration of function ‘add’ [-Wimplicit-function-declaration]
    4 |     printf("%d\n", add(3, 5));
      |                    ^~~
$ ./noproto
8
1주차 10절의 “에러 2″(헤더 파일 누락)에서 본 것과 같은 경고입니다. “add 가 선언 없이(implicit) 쓰였다.” 그때 설명한 대로 C 컴파일러는 파일을 위에서 아래로 한 번 읽습니다. 4번째 줄에서 add 를 만났을 때는 아직 8번째 줄의 add 를 읽기 전이라, 컴파일러는 add 가 무엇인지 모릅니다.
그런데 경고만 나고 실행하면 8이 잘 나왔습니다. 그럼 괜찮은 걸까요? 이번에는 double 을 다루는 함수로 똑같이 해 봅시다. noproto2.c:
#include <stdio.h>

int main(void) {
    printf("%f\n", half(3.0));
    return 0;
}

double half(double x) {
    return x / 2;
}
$ gcc -Wall -Wextra -std=c11 noproto2.c -o noproto2
noproto2.c: In function ‘main’:
noproto2.c:4:20: warning: implicit declaration of function ‘half’ [-Wimplicit-function-declaration]
    4 |     printf("%f\n", half(3.0));
      |                    ^~~~
noproto2.c:4:14: warning: format ‘%f’ expects argument of type ‘double’, but argument 2 has type ‘int’ [-Wformat=]
...
noproto2.c: At top level:
noproto2.c:8:8: error: conflicting types for ‘half’; have ‘double(double)’
    8 | double half(double x) {
      |        ^~~~
noproto2.c:4:20: note: previous implicit declaration of ‘half’ with type ‘int()’
    4 |     printf("%f\n", half(3.0));
      |                    ^~~~
이번에는 오류입니다. 메시지를 차례로 읽으면 무슨 일이 있었는지 보입니다.
- 4번째 줄에서 처음 보는
half를 만난 컴파일러는, 옛날 C의 규칙대로 “아마int를 돌려주는 함수겠지” 하고 멋대로 짐작했습니다. 마지막note의previous implicit declaration of ‘half’ with type ‘int()’가 그 짐작입니다. - 그래서
printf의%f에int가 들어온다고 경고했습니다. - 그런데 8번째 줄에 와 보니
half는double을 돌려주는 함수였습니다. “아까 짐작한 것과 다르다(conflicting types)” 는 오류가 납니다.
add 가 우연히 잘 돌아간 것은 컴파일러의 짐작(int 를 돌려준다)이 우연히 맞았기 때문일 뿐입니다. 짐작이 틀리면 오류가 나거나, 더 나쁘게는 오류 없이 엉뚱한 값이 나옵니다. 이 “짐작” 규칙은 1989년 C 표준 시절의 유물로, C99 부터 표준에서 빠졌습니다. GCC 13은 옛 코드를 위해 경고만 내 주지만, GCC 14부터는 이것을 오류로 처리합니다. 그러니 경고가 났을 때 “돌아가니까 괜찮다”고 넘기면 안 됩니다.
3.2 해결책: 프로토타입
해결 방법은 두 가지입니다.
- 함수 정의를 부르는 곳보다 위에 둔다. 지금까지 예제들이 한 방법입니다.
- 부르는 곳보다 위에 “이런 함수가 있다”는 안내문만 먼저 적어 둔다.
2번의 안내문을 함수 프로토타입(prototype) 또는 함수 선언(declaration) 이라고 합니다. 1주차 5절에서 stdio.h 안에 있다고 본 printf 의 “선언”이 바로 이것입니다.
examples/function_prototype.c:
#include <stdio.h>

/* --- 함수 프로토타입 (선언만, 본문 없음) --- */
int  subtract(int a, int b);
int  factorial(int n);
void print_result(const char *label, int value);

int main(void)
{
    printf("╔════════════════════════════════════════╗\n");
    printf("║        함수 프로토타입 예제            ║\n");
    printf("╚════════════════════════════════════════╝\n\n");

    /*
     * 아래 함수들의 실제 정의는 main 보다 아래에 있지만,
     * 위에서 프로토타입을 선언했으므로 여기서 호출해도 된다.
     */
    print_result("10 - 4", subtract(10, 4));
    print_result("5! (팩토리얼)", factorial(5));

    /* factorial 은 자기 자신을 호출(재귀)하는데, 이때도 프로토타입이 유용하다 */
    print_result("0! (팩토리얼)", factorial(0));

    return 0;
}

/* --- 함수 정의 (본문 포함) : main 아래에 위치 --- */

/* 뺄셈 함수 */
int subtract(int a, int b)
{
    return a - b;
}

/* 팩토리얼 함수 (재귀 호출) */
int factorial(int n)
{
    if (n <= 1) {
        return 1;
    }
    return n * factorial(n - 1);  /* 자기 자신을 호출 */
}

/* 라벨과 값을 보기 좋게 출력하는 함수 */
void print_result(const char *label, int value)
{
    printf("%-16s = %d\n", label, value);
}
$ ./build/examples/function_prototype
╔════════════════════════════════════════╗
║        함수 프로토타입 예제            ║
╚════════════════════════════════════════╝

10 - 4           = 6
5! (팩토리얼) = 120
0! (팩토리얼) = 1
경고 없이 컴파일되고 잘 동작합니다. 프로토타입의 생김새를 정의와 비교해 봅시다.
int subtract(int a, int b);      /* 선언(프로토타입): 끝이 ; */
int subtract(int a, int b)       /* 정의: 끝에 { 본문 } */
{
    return a - b;
}
프로토타입은 정의의 첫 줄을 복사하고 끝에 ; 를 붙인 것입니다. 본문이 없으니 “무엇을 하는지”는 알려 주지 않고, “이름이 무엇이고, 무엇을 받고, 무엇을 돌려주는지” 만 알려 줍니다. 컴파일러가 호출을 번역하는 데는 이것으로 충분합니다. 3.0 을 넘기면 double 로 넣어야 하는지, 돌아온 값을 int 로 읽어야 하는지만 알면 되니까요.
프로토타입에서는 매개변수 이름을 생략할 수 있습니다. int subtract(int, int); 도 됩니다. 컴파일러에게 필요한 건 자료형뿐이기 때문입니다. 하지만 이름이 있으면 subtract(int a, int b) 에서 무엇을 빼는지 읽는 사람이 알기 쉬우니, 이 강좌에서는 이름을 적습니다.
선언과 정의, 그리고 호출
세 단어를 정리해 둡시다. 앞으로 오류 메시지에서 계속 나옵니다.
| 용어 | 영어 | 모양 | 하는 일 | 몇 번? |
|---|---|---|---|---|
| 선언 | declaration | int add(int a, int b); |
“이런 함수가 있다”고 알린다 | 여러 번 해도 된다 (내용만 같다면) |
| 정의 | definition | int add(int a, int b) { ... } |
함수를 실제로 만든다. 기계어가 생긴다 | 프로그램 전체에서 딱 한 번 |
| 호출 | call | add(3, 5) |
함수를 실행한다 | 원하는 만큼 |
정의는 선언을 겸합니다. 그래서 정의가 위에 있으면 따로 선언하지 않아도 됩니다. “정의는 딱 한 번”이라는 규칙은 6.6절에서 여러 파일을 다룰 때 multiple definition 이라는 링크 오류로 다시 만납니다.
수수께끼: 출력의 = 는 왜 줄이 안 맞을까?
위 출력을 다시 보세요.
10 - 4           = 6
5! (팩토리얼) = 120
0! (팩토리얼) = 1
print_result 는 %-16s 로 라벨을 16칸에 맞춰 왼쪽 정렬해서 = 의 위치를 맞추려고 했습니다(- 는 왼쪽 정렬, 16 은 폭). 첫 줄은 잘 맞았는데 한글이 들어간 줄은 = 가 앞으로 당겨졌습니다. 왜일까요?
1주차 6절에서 본 한글은 3바이트라는 사실이 답입니다. printf 의 폭 16은 화면 칸 수가 아니라 바이트 수입니다. "5! (팩토리얼)" 은 5! ( 4바이트 + 한글 4자 × 3바이트 + ) 1바이트 = 17바이트라서, 이미 16을 넘었으니 공백을 하나도 붙이지 않습니다. 그런데 화면에서는 한글이 한 글자당 2칸이라 4 + 8 + 1 = 13칸만 차지합니다. 그래서 = 가 3칸 앞에 찍힌 것입니다.
한글이 섞인 표를 printf 의 폭 지정으로 맞추기 어려운 이유가 이것입니다. 라벨을 영어로 바꾸면("5! (factorial)") 줄이 맞는지 직접 확인해 보세요.
3.3 인자 개수나 자료형이 틀리면
프로토타입의 진짜 가치는 컴파일러가 호출을 검사할 수 있게 된다는 것입니다. argcount.c:
#include <stdio.h>

int add(int a, int b);

int main(void) {
    printf("%d\n", add(1, 2, 3));
    printf("%d\n", add(1));
    return 0;
}

int add(int a, int b) {
    return a + b;
}
$ gcc -Wall -Wextra -std=c11 argcount.c -o argcount
argcount.c: In function ‘main’:
argcount.c:6:20: error: too many arguments to function ‘add’
    6 |     printf("%d\n", add(1, 2, 3));
      |                    ^~~
argcount.c:3:5: note: declared here
    3 | int add(int a, int b);
      |     ^~~
argcount.c:7:20: error: too few arguments to function ‘add’
    7 |     printf("%d\n", add(1));
      |                    ^~~
argcount.c:3:5: note: declared here
    3 | int add(int a, int b);
      |     ^~~
“인자가 너무 많다(too many arguments)”, “너무 적다(too few arguments)”. 그리고 note: declared here 가 프로토타입이 있는 3번째 줄을 가리킵니다. 컴파일러가 이 선언과 호출을 비교해서 틀린 곳을 찾은 것입니다. 1.2절에서 배운 대로 “arguments”는 부를 때 넣은 값(인자)입니다.
3.4 () 와 (void) 의 차이
1주차에 int main(void) 를 설명하면서 “int main() 처럼 빈 괄호를 쓴 코드도 많지만 void 를 명시하는 쪽이 정확하다”고 했습니다. 이제 그 차이를 직접 볼 수 있습니다. emptyparen.c:
#include <stdio.h>

int hello();
int hello_void(void);

int main(void) {
    hello(1, 2, 3);
    hello_void(1, 2, 3);
    return 0;
}

int hello() { printf("hello\n"); return 0; }
int hello_void(void) { printf("hello_void\n"); return 0; }
두 함수 모두 매개변수가 없는데, 일부러 인자를 3개씩 넣어 불렀습니다.
$ gcc -Wall -Wextra -std=c11 emptyparen.c -o emptyparen
emptyparen.c: In function ‘main’:
emptyparen.c:8:5: error: too many arguments to function ‘hello_void’
    8 |     hello_void(1, 2, 3);
      |     ^~~~~~~~~~
emptyparen.c:4:5: note: declared here
    4 | int hello_void(void);
      |     ^~~~~~~~~~
hello_void 만 오류가 나고, hello(1, 2, 3) 에는 아무 말이 없습니다. C11 에서 빈 괄호 () 는 “매개변수가 없다”가 아니라 “매개변수 정보를 알려 주지 않겠다” 는 뜻이기 때문입니다. 정보가 없으니 컴파일러는 인자 개수를 검사할 수 없습니다. 반면 (void) 는 “매개변수가 없다“고 분명히 말하므로, 인자를 넣으면 잡아냅니다.
이 애매한 규칙은 최신 표준인 C23 에서 드디어 바뀌었습니다. C23 모드로 컴파일하면 () 도 (void) 와 같은 뜻이 됩니다.
$ gcc -std=c2x -Wall emptyparen.c -o e23
emptyparen.c: In function ‘main’:
emptyparen.c:7:5: error: too many arguments to function ‘hello’
...
(c2x 는 GCC 13이 C23 을 부르는 이름입니다.) 이번에는 hello 도 오류를 냅니다. 하지만 이 강좌는 C11 을 기준으로 하므로, 매개변수가 없는 함수에는 항상 (void) 를 씁니다.
4. 변수의 유효 범위와 수명
변수에 대해 두 가지를 물을 수 있습니다.
- 범위(scope): 이 변수의 이름을 어디서 쓸 수 있나?
- 수명(lifetime): 이 변수가 메모리에 언제부터 언제까지 존재하나?
둘은 비슷해 보이지만 다른 질문이고, 4.4절의 static 지역 변수에서 둘이 갈라지는 것을 보게 됩니다.
4.1 지역 변수 — 함수 안에서만 산다
함수(또는 { } 블록) 안에서 만든 변수를 지역 변수(local variable) 라고 합니다. 지금까지 main 안에서 만든 변수들이 전부 지역 변수였습니다.
다른 함수의 지역 변수를 쓰려고 하면 어떻게 될까요? scope_err.c:
#include <stdio.h>

void make_local(void) {
    int secret = 42;
}

int main(void) {
    make_local();
    printf("%d\n", secret);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 scope_err.c -o scope_err
scope_err.c: In function ‘make_local’:
scope_err.c:4:9: warning: unused variable ‘secret’ [-Wunused-variable]
    4 |     int secret = 42;
      |         ^~~~~~
scope_err.c: In function ‘main’:
scope_err.c:9:20: error: ‘secret’ undeclared (first use in this function)
    9 |     printf("%d\n", secret);
      |                    ^~~~~~
scope_err.c:9:20: note: each undeclared identifier is reported only once for each function it appears in
main 에서는 secret 이 “선언되지 않았다(undeclared)”고 합니다. secret 이라는 이름은 make_local 의 { } 안에서만 통합니다. 함께 나온 경고도 재미있습니다. “secret 을 만들어 놓고 쓰지 않았다.” 컴파일러 입장에서 make_local 은 변수를 만들었다가 아무도 쓰지 않은 채 버리는 함수입니다.
그리고 수명의 관점에서도, make_local 이 끝나는 순간 secret 은 메모리에서 사라집니다. 설령 이름이 통했더라도 main 에서 쓸 때는 이미 없는 변수입니다. 2.1절에서 modify 의 x 가 다른 주소에 있었던 것처럼, 지역 변수는 함수가 불릴 때 만들어지고 함수가 끝나면 사라집니다. 같은 함수를 두 번 부르면 지역 변수도 두 번 새로 만들어집니다.
블록 범위
지역 변수의 범위는 정확히 말하면 자신이 선언된 { } 블록입니다. 함수 전체가 아니라 for 나 if 의 블록일 수도 있습니다. blockscope.c:
#include <stdio.h>

int main(void) {
    for (int i = 0; i < 3; i++) {
        int square = i * i;
        printf("%d ", square);
    }
    printf("\n%d\n", i);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 blockscope.c -o blockscope
blockscope.c: In function ‘main’:
blockscope.c:8:22: error: ‘i’ undeclared (first use in this function)
    8 |     printf("\n%d\n", i);
      |                      ^
for (int i = 0; ...) 처럼 for 괄호 안에서 만든 i 는 for 문 안에서만 삽니다. square 도 마찬가지입니다. 3주차에서 for 문 안에 변수를 선언하던 방식이 이런 뜻이었습니다. 변수는 필요한 곳에서 가장 좁은 범위로 만드는 것이 좋습니다. 범위가 좁을수록 “이 변수를 누가 바꿨지?”를 찾을 곳이 줄어듭니다.
4.2 전역 변수 — 어디서든 보인다
모든 함수 밖에서 만든 변수는 전역 변수(global variable) 입니다. 파일 안의 모든 함수가 같은 변수를 봅니다.
examples/function_scope.c:
#include <stdio.h>

/*
 * [전역 변수 (Global Variable)]
 * 함수 바깥에 선언된 변수. 프로그램 어디서나 접근할 수 있고,
 * 프로그램이 끝날 때까지 살아 있다(수명 = 프로그램 전체).
 * 초기화하지 않으면 0으로 자동 초기화된다.
 */
int global_count = 0;

/* 전역 변수를 읽고 수정하는 함수 */
void increase_count(void)
{
    global_count++;  /* 어느 함수에서든 같은 전역 변수를 공유한다 */
    printf("  [increase_count] global_count = %d\n", global_count);
}

/* 지역 변수: 이 함수 블록 안에서만 유효하며 함수가 끝나면 사라진다 */
void local_demo(void)
{
    int local_value = 42;  /* 이 변수는 local_demo 안에서만 존재 */
    printf("  [local_demo] local_value = %d\n", local_value);
}

/* 변수 가리기: 지역 변수가 전역 변수와 이름이 같으면 지역 변수가 우선한다 */
void shadow_demo(void)
{
    int global_count = 999;  /* 전역과 같은 이름의 지역 변수 */
    printf("  [shadow_demo] 지역 global_count = %d (전역을 가림)\n",
           global_count);
}

int main(void)
{
    printf("╔════════════════════════════════════════╗\n");
    printf("║      변수의 유효 범위 예제             ║\n");
    printf("╚════════════════════════════════════════╝\n\n");

    /* 지역 변수: main 안에서만 유효 */
    int main_local = 10;
    printf("[main] 지역 변수 main_local = %d\n\n", main_local);

    /* 전역 변수는 여러 함수 호출에 걸쳐 값이 유지된다 */
    printf("전역 변수 공유 확인:\n");
    increase_count();
    increase_count();
    increase_count();
    printf("[main] 세 번 호출 후 global_count = %d\n\n", global_count);

    /* 지역 변수는 함수마다 독립적 */
    printf("지역 변수 확인:\n");
    local_demo();
    printf("[main] local_demo 의 local_value 는 여기서 접근 불가\n\n");

    /* 변수 가리기(shadowing) 확인 */
    printf("변수 가리기(shadowing) 확인:\n");
    shadow_demo();
    printf("[main] shadow_demo 후에도 전역 global_count = %d (영향 없음)\n",
           global_count);

    return 0;
}
$ ./build/examples/function_scope
╔════════════════════════════════════════╗
║      변수의 유효 범위 예제             ║
╚════════════════════════════════════════╝

[main] 지역 변수 main_local = 10

전역 변수 공유 확인:
  [increase_count] global_count = 1
  [increase_count] global_count = 2
  [increase_count] global_count = 3
[main] 세 번 호출 후 global_count = 3

지역 변수 확인:
  [local_demo] local_value = 42
[main] local_demo 의 local_value 는 여기서 접근 불가

변수 가리기(shadowing) 확인:
  [shadow_demo] 지역 global_count = 999 (전역을 가림)
[main] shadow_demo 후에도 전역 global_count = 3 (영향 없음)
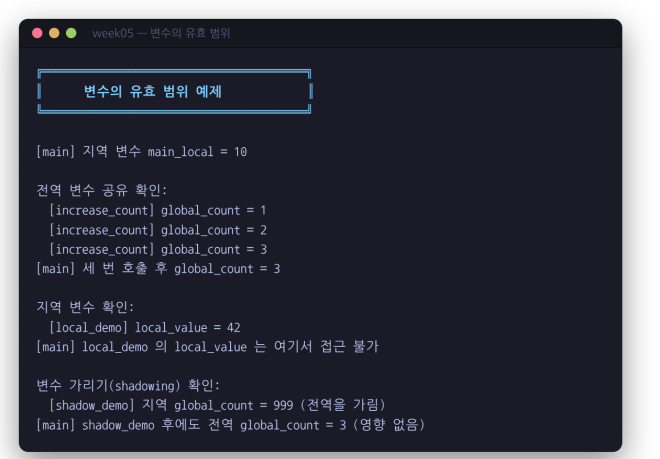
변수의 유효 범위
코드 읽기 포인트
increase_count를 세 번 부르면 1, 2, 3: 전역 변수는 함수 호출이 끝나도 사라지지 않고 값을 유지합니다. 그리고main에서 읽어도 같은 3이 나옵니다. 모든 함수가 한 변수를 공유합니다.- 전역 변수의 자동 초기화: 주석에 적힌 대로, 전역 변수는 값을 주지 않아도 0으로 시작합니다. 1주차 10절에서 초기화하지 않은 지역 변수가 쓰레기 값을 가진다고 했던 것과 대조적입니다. 전역 변수는 프로그램이 시작될 때 한꺼번에 0으로 채워지는 메모리 영역(1주차 7절
size명령의bss칸)에 들어가기 때문입니다.
전역 변수는 편리해 보입니다. 매개변수로 넘기지 않아도 어디서든 쓸 수 있으니까요. 하지만 바로 그게 문제입니다. 프로그램이 커져서 전역 변수의 값이 이상해졌을 때, 어느 함수가 바꿨는지 찾으려면 모든 함수를 뒤져야 합니다. 반면 함수가 매개변수로 받고 return 으로 돌려주기만 하면, 그 함수가 무엇을 읽고 무엇을 바꾸는지가 첫 줄에 다 드러납니다. 그래서 전역 변수는 꼭 필요할 때만 씁니다. 이 예제처럼 “프로그램 전체에서 한 벌만 있어야 하는 카운터” 정도가 적당한 쓰임입니다.
4.3 변수 가리기(shadowing)
shadow_demo 는 전역 변수와 같은 이름 global_count 로 지역 변수를 만들었습니다. 그러자 그 함수 안에서는 global_count 라고 쓰면 가까이 있는 지역 변수(999) 를 가리키게 되고, 전역 변수는 가려져서 보이지 않습니다. 이것을 가리기(shadowing) 라고 합니다. 전역 변수는 main 의 마지막 줄에서 보듯 3 그대로입니다.
가리기는 문법적으로는 합법이지만, 거의 항상 실수입니다. 전역 변수를 바꾸려고 global_count = 999; 라고 쓰려다가 습관처럼 int 를 붙였다면? 전역 변수는 그대로이고 버그가 생깁니다. -Wall -Wextra 는 이것을 잡지 않지만, 전용 옵션이 있습니다.
$ gcc -Wall -Wextra -Wshadow -std=c11 examples/function_scope.c -o function_scope
examples/function_scope.c: In function ‘shadow_demo’:
examples/function_scope.c:44:9: warning: declaration of ‘global_count’ shadows a global declaration [-Wshadow]
   44 |     int global_count = 999;  /* 전역과 같은 이름의 지역 변수 */
      |         ^~~~~~~~~~~~
examples/function_scope.c:14:5: note: shadowed declaration is here
   14 | int global_count = 0;
      |     ^~~~~~~~~~~~
“global_count 선언이 전역 선언을 가린다”고 알려 주고, note 가 가려진 쪽(14번째 줄)을 가리킵니다. 일부러 가린 게 아니라면 지역 변수의 이름을 바꾸세요.
4.4 static 지역 변수 — 범위는 좁게, 수명은 길게
여기까지 보면 선택지가 두 개인 것 같습니다.
- 지역 변수: 범위가 좁아서 안전하지만, 함수가 끝나면 값을 잊어버린다.
- 전역 변수: 값을 기억하지만, 범위가 넓어서 아무나 바꿀 수 있다.
“함수가 불린 횟수를 세는” 기능을 만든다고 해 봅시다. 값을 기억해야 하니 지역 변수로는 안 되고, 그렇다고 전역 변수로 만들면 다른 함수가 망가뜨릴 수 있습니다. 범위는 지역 변수처럼 좁고, 수명은 전역 변수처럼 긴 변수가 있다면 좋겠죠. 그것이 static 지역 변수입니다.
examples/static_function.c:
#include <stdio.h>

/*
 * 키워드 static은 위치에 따라 두 가지 다른 의미를 가진다.
 *
 * 1) 파일 범위의 함수/변수 앞에 붙는 static  ->  '내부 연결(internal linkage)'
 *    - 그 함수/변수는 오직 이 파일(.c) 안에서만 보이고 사용할 수 있다.
 *
 * 2) 함수 안 지역 변수 앞에 붙는 static  ->  '정적 저장 수명(static storage)'
 *    - 함수가 끝나도 변수가 사라지지 않고 값이 유지된다.
 *    - 초기화는 딱 한 번만 일어난다.
 */

/* (1) static 함수: 이 파일 내부에서만 호출 가능한 도우미 함수 */
static void print_line(void)
{
    printf("----------------------------------------\n");
}

/* (2) static 지역 변수: 호출될 때마다 값이 1씩 늘며 유지된다. */
int counter(void)
{
    static int count = 0;
    count++;
    return count;
}

/* 비교용: static이 없는 일반 지역 변수는 매 호출마다 새로 초기화된다. */
int counter_normal(void)
{
    int count = 0;   /* 매번 0으로 다시 시작 */
    count++;
    return count;
}

int main(void)
{
    printf("╔════════════════════════════════════════╗\n");
    printf("║        static 함수와 지역 변수 예제    ║\n");
    printf("╚════════════════════════════════════════╝\n\n");

    printf("[static 지역 변수 counter()] 호출할 때마다 값이 유지되며 증가\n");
    print_line();   /* 파일 내부 static 함수 호출 */
    for (int i = 0; i < 5; i++) {
        printf("  %d번째 호출 -> counter() = %d\n", i + 1, counter());
    }
    print_line();

    printf("\n[일반 지역 변수 counter_normal()] 매 호출마다 값이 초기화됨\n");
    print_line();
    for (int i = 0; i < 5; i++) {
        printf("  %d번째 호출 -> counter_normal() = %d\n", i + 1, counter_normal());
    }
    print_line();

    printf("\n[정리]\n");
    printf(" - static 지역 변수는 호출 사이에 값을 '기억'한다.\n");
    printf(" - 일반 지역 변수는 호출이 끝나면 사라져 매번 처음부터 시작한다.\n");
    printf(" - 함수/변수 앞의 static은 다른 파일에서 못 보게 하여 구현을 숨긴다.\n");

    return 0;
}
$ ./build/examples/static_function
╔════════════════════════════════════════╗
║        static 함수와 지역 변수 예제    ║
╚════════════════════════════════════════╝

[static 지역 변수 counter()] 호출할 때마다 값이 유지되며 증가
----------------------------------------
  1번째 호출 -> counter() = 1
  2번째 호출 -> counter() = 2
  3번째 호출 -> counter() = 3
  4번째 호출 -> counter() = 4
  5번째 호출 -> counter() = 5
----------------------------------------

[일반 지역 변수 counter_normal()] 매 호출마다 값이 초기화됨
----------------------------------------
  1번째 호출 -> counter_normal() = 1
  2번째 호출 -> counter_normal() = 1
  3번째 호출 -> counter_normal() = 1
  4번째 호출 -> counter_normal() = 1
  5번째 호출 -> counter_normal() = 1
----------------------------------------
...
두 함수는 static 한 단어만 다른데 결과가 완전히 다릅니다.
counter_normal: 부를 때마다int count = 0;이 새로 실행되어 0부터 시작합니다. 그래서 항상 1입니다.counter:static int count = 0;의= 0은 프로그램이 시작될 때 딱 한 번만 적용됩니다. 함수를 다시 불러도 이 줄은 초기화를 다시 하지 않고,count는 지난번 값을 그대로 갖고 있습니다. 그래서 1, 2, 3, 4, 5 로 늘어납니다.
count 는 여전히 counter 함수 안에서만 이름이 통합니다(범위는 지역). 하지만 메모리에는 프로그램이 끝날 때까지 남아 있습니다(수명은 전역). main 이 count = 100; 으로 망가뜨릴 수 없으니 전역 변수보다 안전합니다.
4.5 static 함수 — 이 파일 밖에서는 안 보이게
같은 static 이 함수 앞에 붙으면 전혀 다른 뜻이 됩니다. static void print_line(void) 는 “이 함수는 이 .c 파일 안에서만 부를 수 있다”는 뜻입니다. 이것을 내부 연결(internal linkage) 이라고 합니다.
한 파일짜리 프로그램에서는 차이가 보이지 않습니다. 하지만 1주차 7절에서 배운 nm 으로 오브젝트 파일의 이름표를 보면 차이가 드러납니다.
$ gcc -c -std=c11 examples/static_function.c -o static_function.o
$ nm static_function.o
0000000000000000 b count.0
000000000000001a T counter
0000000000000039 T counter_normal
0000000000000051 T main
0000000000000000 t print_line
                 U printf
                 U puts
1주차에 T 는 “이 파일 안에 있는 코드”라고 했습니다. 자세히 보면 counter, main 은 대문자 T 인데 print_line 은 소문자 t 입니다. nm 에서 대문자는 다른 파일에도 보이는 이름, 소문자는 이 파일 안에서만 쓰는 이름입니다. static 을 붙였더니 링커가 다른 파일과 연결할 때 print_line 이라는 이름을 아예 쓰지 않는다는 뜻입니다.
맨 위의 b count.0 도 보세요. counter 안의 static int count 가 함수의 지역 변수인데도 오브젝트 파일에 이름표가 있습니다. b 는 4.2절에서 말한 “0으로 채워지는 영역(bss)”이고, 소문자이니 이 파일 안에서만 쓰입니다. .0 은 다른 함수에 같은 이름의 static 변수가 있어도 겹치지 않게 컴파일러가 붙인 번호입니다. 일반 지역 변수 counter_normal 의 count 는 여기에 없습니다. 일반 지역 변수는 함수가 불릴 때마다 잠깐 생겼다 사라지는 임시 공간에 있고, static 지역 변수는 전역 변수처럼 고정된 자리를 갖는다는 것이 이렇게 확인됩니다.
static 함수가 왜 필요한지는 6.6절에서 여러 파일을 합칠 때 이름이 충돌하는 상황을 보면 분명해집니다.
4.6 정리: 변수의 종류
| 종류 | 선언 위치 | 범위 (어디서 보이나) | 수명 (언제까지 사나) | 초기화 안 하면 |
|---|---|---|---|---|
| 지역 변수 | 함수·블록 안 | 그 { } 안 |
블록이 끝날 때까지 | 쓰레기 값 |
static 지역 변수 |
함수 안, static |
그 { } 안 |
프로그램 끝까지 | 0 |
| 전역 변수 | 함수 밖 | 파일 전체 (다른 파일에서도 가능) | 프로그램 끝까지 | 0 |
static 전역 변수 |
함수 밖, static |
이 파일 안만 | 프로그램 끝까지 | 0 |
static 의 두 가지 뜻을 한 문장으로 기억하세요. 함수 안에서는 “오래 살아라”, 함수 밖에서는 “밖에 보이지 마라”.
5. 재귀 함수
1.2절에서 “함수는 다른 함수를 부를 수 있다”고 했습니다. 그럼 함수가 자기 자신을 부르면 어떻게 될까요? 이상하게 들리지만 완전히 합법이고, 어떤 문제는 이 방법으로 놀랍도록 짧게 풀립니다. 함수가 자기 자신을 부르는 것을 재귀(recursion) 라고 합니다.
5.1 재귀란? 그리고 호출 스택
러시아 인형 마트료시카를 떠올려 보세요. 인형을 열면 조금 작은 인형이 나오고, 그걸 열면 또 작은 인형이 나오고, 마지막에는 더 열리지 않는 가장 작은 인형이 나옵니다. 재귀도 똑같습니다.
- 큰 문제를 “조금 작은 같은 문제”로 바꾼다 → 인형을 열면 작은 인형
- 더 이상 쪼갤 수 없을 만큼 작아지면 바로 답한다 → 더 열리지 않는 인형
그래서 모든 재귀 함수에는 두 부분이 반드시 있어야 합니다.
| 부분 | 이름 | 하는 일 |
|---|---|---|
| ① | 종료 조건 (base case) | 문제가 충분히 작으면 자신을 부르지 않고 바로 답을 돌려준다 |
| ② | 재귀 단계 (recursive case) | 문제를 조금 작게 만들어 자기 자신을 부른다 |
①이 없으면 인형을 영원히 열게 됩니다. 5.5절에서 실제로 해 보고 프로그램이 어떻게 죽는지 봅니다.
함수를 부를 때마다 무슨 일이 생길까?
재귀를 이해하려면 먼저 함수 호출이 메모리에서 어떻게 이뤄지는지 알아야 합니다. 2.1절에서 main 의 a 와 modify 의 x 가 서로 다른 주소에 있었습니다. 함수가 불릴 때마다 그 함수의 지역 변수와 매개변수를 위한 작업 공간이 새로 만들어지기 때문입니다. 이 작업 공간을 스택 프레임(stack frame) 이라고 하고, 프레임들이 쌓이는 메모리 영역을 스택(stack) 이라고 합니다.
스택은 접시를 쌓는 것과 같습니다. 함수를 부르면 접시(프레임)를 하나 위에 올리고, 함수가 끝나면 맨 위 접시를 치웁니다. 가장 나중에 부른 함수가 가장 먼저 끝납니다.
재귀 함수도 예외가 아닙니다. 같은 함수를 다시 부르면 또 새로운 프레임이 쌓이고, 그 안에 새로운 지역 변수가 생깁니다. 정말 그런지 주소를 찍어 확인해 봅시다. depth.c:
#include <stdio.h>

void dive(int depth) {
    int local = depth;
    printf("깊이 %d: local 의 주소 %p\n", depth, (void *)&local);
    if (depth < 4) {
        dive(depth + 1);
    }
}

int main(void) {
    dive(1);
    return 0;
}
dive 는 깊이가 4가 될 때까지 자기 자신을 부릅니다. depth < 4 가 거짓이 되면 더 부르지 않으니, 그것이 종료 조건입니다.
$ gcc -Wall -Wextra -std=c11 depth.c -o depth
$ ./depth
깊이 1: local 의 주소 0x7ffc3186cb04
깊이 2: local 의 주소 0x7ffc3186cad4
깊이 3: local 의 주소 0x7ffc3186caa4
깊이 4: local 의 주소 0x7ffc3186ca74
같은 함수 안의 같은 이름 local 인데, 깊이마다 주소가 다릅니다. 네 개의 local 이 동시에 메모리에 존재한다는 뜻입니다. 그리고 주소를 보면 규칙이 있습니다.
| 깊이 | 주소 끝자리 | 앞 깊이와의 차이 |
|---|---|---|
| 1 | ...cb04 |
|
| 2 | ...cad4 |
−0x30 (48바이트) |
| 3 | ...caa4 |
−0x30 (48바이트) |
| 4 | ...ca74 |
−0x30 (48바이트) |
한 번 깊어질 때마다 정확히 48바이트씩 작아지는 쪽으로 이동합니다. dive 한 번의 프레임이 48바이트이고, x86-64 리눅스에서 스택은 큰 주소에서 작은 주소 쪽으로 자란다는 것이 이렇게 드러납니다. 접시를 쌓는데 위가 아니라 아래로 쌓이는 셈입니다. 이 스택 구조는 7주차 메모리 구조와 24주차 보안 단원에서 다시 자세히 봅니다.
5.2 팩토리얼
재귀의 첫 예제로 가장 많이 쓰이는 것이 팩토리얼입니다. n! 은 1부터 n까지 곱한 것입니다(5! = 5 × 4 × 3 × 2 × 1 = 120). 이것을 이렇게 바꿔 쓸 수 있습니다.
n! = n × (n-1)!        (재귀 단계: n! 을 조금 작은 (n-1)! 로)
1! = 1                 (종료 조건: 1! 은 바로 안다)
5! 을 구하려면 4! 을 알면 되고, 4! 을 구하려면 3! 을 알면 되고… 1! 은 1 이라고 바로 압니다. 수학의 정의를 그대로 옮기면 재귀 함수가 됩니다.
long factorial(int n) {
    if (n <= 1) return 1;          /* 종료 조건 */
    return n * factorial(n - 1);   /* 재귀 단계 */
}
n <= 1 로 쓴 이유는 0! 도 1이기 때문입니다(수학의 약속입니다). 실제로 어떤 순서로 호출되고 돌아오는지 보여 주는 예제가 있습니다.
examples/recursion_factorial.c:
#include <stdio.h>

/*
 * depth 매개변수는 현재 재귀 호출의 깊이로, 들여쓰기 출력에만 사용한다.
 * 이를 통해 호출이 얼마나 깊게 들어가고 다시 빠져나오는지 시각화한다.
 */
long factorial_recursive(int n, int depth)
{
    /* 호출 깊이만큼 들여쓰기 출력 (호출이 들어가는 과정) */
    for (int i = 0; i < depth; i++) {
        printf("    ");
    }
    printf("-> factorial(%d) 호출\n", n);

    /* 종료 조건: n이 1 이하이면 1을 반환한다. */
    if (n <= 1) {
        for (int i = 0; i < depth; i++) {
            printf("    ");
        }
        printf("<- factorial(%d) = 1 (종료 조건)\n", n);
        return 1;
    }

    /* 재귀 조건: n * factorial(n-1) */
    long result = n * factorial_recursive(n - 1, depth + 1);

    /* 계산 결과를 반환하며 빠져나오는 과정 출력 */
    for (int i = 0; i < depth; i++) {
        printf("    ");
    }
    printf("<- factorial(%d) = %ld\n", n, result);
    return result;
}

/* 비교용: 반복문(loop)으로 구현한 팩토리얼 */
long factorial_iterative(int n)
{
    long result = 1;
    for (int i = 2; i <= n; i++) {
        result *= i;
    }
    return result;
}

int main(void)
{
    printf("╔════════════════════════════════════════╗\n");
    printf("║        재귀 팩토리얼 예제              ║\n");
    printf("╚════════════════════════════════════════╝\n\n");

    int n = 5;

    printf("[재귀 버전] %d! 계산 과정\n", n);
    printf("----------------------------------------\n");
    long r = factorial_recursive(n, 0);
    printf("----------------------------------------\n");
    printf("재귀 결과: %d! = %ld\n\n", n, r);

    printf("[반복문 버전] %d! 계산\n", n);
    printf("----------------------------------------\n");
    long i = factorial_iterative(n);
    printf("반복문 결과: %d! = %ld\n\n", n, i);

    printf("두 방식의 결과 일치 여부: %s\n", (r == i) ? "일치" : "불일치");
    ...
    return 0;
}
$ ./build/examples/recursion_factorial
╔════════════════════════════════════════╗
║        재귀 팩토리얼 예제              ║
╚════════════════════════════════════════╝

[재귀 버전] 5! 계산 과정
----------------------------------------
-> factorial(5) 호출
    -> factorial(4) 호출
        -> factorial(3) 호출
            -> factorial(2) 호출
                -> factorial(1) 호출
                <- factorial(1) = 1 (종료 조건)
            <- factorial(2) = 2
        <- factorial(3) = 6
    <- factorial(4) = 24
<- factorial(5) = 120
----------------------------------------
재귀 결과: 5! = 120

[반복문 버전] 5! 계산
----------------------------------------
반복문 결과: 5! = 120

두 방식의 결과 일치 여부: 일치
...
이 출력은 5.1절의 접시 쌓기를 그대로 그린 그림입니다. 들여쓰기가 깊어지는 부분(→) 은 접시가 쌓이는 과정이고, 얕아지는 부분(←) 은 접시를 치우는 과정입니다.
한 가지 꼭 짚을 점이 있습니다. factorial(5) 를 부르면 곧바로 곱셈을 할 수 없습니다. 5 × factorial(4) 를 계산하려면 factorial(4) 의 답이 필요하니까요. 그래서 factorial(5) 는 곱셈을 미뤄 둔 채 기다리고, factorial(4) 도 기다리고… factorial(1) 이 1을 돌려준 다음에야 쌓여 있던 곱셈이 거꾸로 하나씩 처리됩니다. 2 × 1 = 2, 3 × 2 = 6, 4 × 6 = 24, 5 × 24 = 120. 기다리는 동안 각 호출의 n 은 자기 프레임에 안전하게 보관되어 있습니다. 5.1절에서 깊이마다 local 이 따로 있었던 것처럼요.
depth 매개변수는 계산과 상관없고 들여쓰기 칸 수를 알려 주려고 넘기는 값입니다. 재귀 함수에 이렇게 “지금 몇 번째 깊이인지”를 넘겨 출력해 보는 것은 재귀를 디버깅하는 좋은 방법입니다.
실험: 팩토리얼은 어디까지 계산될까?
팩토리얼은 아주 빨리 커집니다. long long(2주차에 본 8바이트 정수)으로 몇까지 계산될까요? fact_over.c:
#include <stdio.h>

long long factorial(int n) {
    if (n <= 1) {
        return 1;
    }
    return (long long)n * factorial(n - 1);
}

int main(void) {
    for (int n = 19; n <= 22; n++) {
        printf("%d! = %lld\n", n, factorial(n));
    }
    return 0;
}
$ ./fact_over
19! = 121645100408832000
20! = 2432902008176640000
21! = -4249290049419214848
22! = -1250660718674968576
20! 까지는 맞지만, 21! 에서 갑자기 음수가 나옵니다. 21! 은 약 5.1 × 10¹⁹ 로, long long 이 담을 수 있는 최댓값(약 9.2 × 10¹⁸)을 넘었습니다. 2주차에 본 정수 오버플로입니다. C 표준에서 부호 있는 정수의 오버플로는 “정의되지 않은 동작”이라서 어떤 값이 나올지 보장되지 않습니다. 이 컴퓨터에서는 음수가 나왔을 뿐입니다. 재귀든 반복이든 상관없이, 함수가 돌려주는 자료형의 범위는 항상 생각해야 합니다.
5.3 재귀의 함정 — 피보나치
피보나치 수열은 앞의 두 수를 더해 다음 수를 만듭니다. 0, 1, 1, 2, 3, 5, 8, 13, … 정의도 재귀적입니다.
F(n) = F(n-1) + F(n-2)     (재귀 단계)
F(0) = 0, F(1) = 1          (종료 조건)
팩토리얼처럼 그대로 옮기면 됩니다.
long fib(int n) {
    if (n < 2) return n;             /* F(0)=0, F(1)=1 */
    return fib(n - 1) + fib(n - 2);
}
아주 깔끔합니다. 그런데 이 함수에는 숨은 문제가 있습니다. 팩토리얼과 달리 자기 자신을 두 번 부른다는 것입니다. fib(5) 가 무엇을 부르는지 나무 모양으로 그려 봅시다.
                    fib(5)
               ┌──────┴──────┐
            fib(4)         fib(3)
          ┌───┴───┐       ┌───┴───┐
       fib(3)  fib(2)  fib(2)  fib(1)
       ┌─┴─┐   ┌─┴─┐   ┌─┴─┐
   fib(2) fib(1) fib(1) fib(0) fib(1) fib(0)
   ┌─┴─┐
fib(1) fib(0)
fib(3) 이 두 번, fib(2) 가 세 번 계산됩니다. 똑같은 문제를 몇 번이고 처음부터 다시 풀고 있습니다. 얼마나 심각한지 세어 보는 예제가 있습니다.
examples/recursion_fibonacci.c 의 핵심 부분:
/* 재귀 호출이 몇 번 일어나는지 세기 위한 카운터 */
static long call_count = 0;

/* 재귀 버전: 정의를 그대로 옮긴 형태 */
long fib_recursive(int n)
{
    call_count++;               /* 함수가 호출될 때마다 1 증가 */

    if (n < 2) {                /* 종료 조건: F(0)=0, F(1)=1 */
        return n;
    }
    /* 재귀 조건: 같은 함수를 두 번 호출 -> 여기서 중복 계산 발생 */
    return fib_recursive(n - 1) + fib_recursive(n - 2);
}

/* 반복문 버전: 앞의 두 값만 기억하며 앞으로 나아간다. */
long fib_iterative(int n)
{
    if (n < 2) {
        return n;
    }

    long prev = 0;   /* F(0) */
    long curr = 1;   /* F(1) */
    for (int i = 2; i <= n; i++) {
        long next = prev + curr;   /* 다음 값 = 앞의 두 값의 합 */
        prev = curr;
        curr = next;
    }
    return curr;
}
call_count 는 4.5절에서 본 static 전역 변수입니다. 이 파일 안에서만 쓰는 카운터이고, 함수가 불릴 때마다 1씩 늘어납니다.
$ ./build/examples/recursion_fibonacci
...
[재귀 버전] 각 n에 대한 결과와 호출 횟수
----------------------------------------
 n | F(n) | 재귀 호출 횟수
---+------+----------------
 0 |    0 | 1
 1 |    1 | 1
 2 |    1 | 3
 3 |    2 | 5
 4 |    3 | 9
 5 |    5 | 15
 6 |    8 | 25
 7 |   13 | 41
 8 |   21 | 67
 9 |   34 | 109
10 |   55 | 177
11 |   89 | 287
12 |  144 | 465
13 |  233 | 753
14 |  377 | 1219
15 |  610 | 1973
...
F(15) = 610 을 구하려고 함수를 1,973번 불렀습니다. 호출 횟수 열을 보면 n이 1 늘 때마다 약 1.6배씩 커집니다. 사실 이 숫자들에는 재미있는 규칙이 있습니다. 호출 횟수 = 2 × F(n+1) − 1 입니다. n = 15 면 F(16) = 987 이니 2 × 987 − 1 = 1,973. 피보나치 수를 구하는 비용이 피보나치 수만큼 커지는 셈입니다.
실험: 실제로 얼마나 느릴까?
재귀 버전과 반복 버전의 시간을 재 봅시다. 명령줄에서 r(재귀) 또는 i(반복)와 n 을 받도록 만든 fibtime.c 를 준비했습니다. main 의 argv 로 명령줄 값을 받는 방법은 7주차에 배우니, 지금은 시간 측정 결과만 보세요. /usr/bin/time -f "%e초" 는 프로그램이 걸린 시간을 초 단위로 알려 주는 명령입니다.
$ /usr/bin/time -f "  %e초" ./fibtime r 35
재귀 F(35) = 9227465
  0.04초
$ /usr/bin/time -f "  %e초" ./fibtime r 40
재귀 F(40) = 102334155
  0.45초
$ /usr/bin/time -f "  %e초" ./fibtime r 45
재귀 F(45) = 1134903170
  5.34초
$ /usr/bin/time -f "  %e초" ./fibtime i 45
반복 F(45) = 1134903170
  0.00초
(이 글을 쓴 컴퓨터에서 잰 시간입니다. 컴퓨터마다 다르지만 늘어나는 비율은 비슷합니다.)
n이 5 늘 때마다 시간이 약 11배씩 늘어납니다. F(45) 는 5초가 넘게 걸리는데, 반복 버전은 측정도 안 될 만큼 빠릅니다. F(50) 을 재귀로 구하면 n이 5 늘 때 11배라는 비율대로라면 1분 가까이 걸린다는 계산이 나옵니다. 반복 버전이 빠른 이유는 간단합니다. 앞의 두 값만 기억하면서 한 번 앞으로 나아가기 때문에, 같은 값을 두 번 계산하지 않습니다.
그렇다고 재귀가 나쁜 것은 아닙니다. 문제는 재귀가 아니라 같은 계산을 반복하는 구조입니다. 한 번 계산한 F(k) 를 배열에 적어 두고 다시 쓰는 메모이제이션(memoization) 을 쓰면 재귀로도 빨라집니다. 배열을 배운 여러분이라면 지금 도전해 볼 수 있습니다(연습 문제 8).
5.4 재귀가 빛나는 곳 – 하노이의 탑
반대로 재귀가 아니면 풀기 어려운 문제도 있습니다. 대표적인 것이 하노이의 탑입니다.
기둥 세 개(A, B, C)가 있고, A 기둥에 크기가 다른 원반 n개가 큰 것부터 쌓여 있습니다. 규칙은 두 가지입니다.
- 한 번에 원반 하나만 옮길 수 있다.
- 큰 원반을 작은 원반 위에 놓을 수 없다.
원반을 전부 C 기둥으로 옮기려면 어떻게 해야 할까요? 원반이 3개만 되어도 머리로 풀기 꽤 까다롭습니다. 그런데 재귀로 생각하면 놀랍도록 간단해집니다.
“원반 n개를 A에서 C로 옮기려면” 1. 위쪽 n−1개를 A에서 B로 옮겨 둔다. (← 조금 작은 같은 문제!) 2. 남은 가장 큰 원반 하나를 A에서 C로 옮긴다. 3. B에 옮겨 둔 n−1개를 B에서 C로 옮긴다. (← 또 조금 작은 같은 문제!)
“n−1개를 어떻게 옮기지?”는 걱정하지 않아도 됩니다. 같은 방법으로 옮기면 되니까요. 그것이 재귀입니다.
examples/recursion_hanoi.c:
#include <stdio.h>

/* 지금까지의 이동 횟수를 기록하는 파일 내부 전역 변수 */
static int move_count = 0;

/*
 * n     : 옮길 원반의 개수
 * from  : 출발 기둥 이름
 * aux   : 보조(경유) 기둥 이름
 * to    : 도착 기둥 이름
 */
void hanoi(int n, char from, char aux, char to)
{
    /* 종료 조건: 옮길 원반이 없으면 아무것도 하지 않는다. */
    if (n == 0) {
        return;
    }

    /* 1) 위쪽 n-1개를 도착 기둥을 경유지로 삼아 보조 기둥으로 옮긴다. */
    hanoi(n - 1, from, to, aux);

    /* 2) 가장 큰(맨 아래) 원반을 도착 기둥으로 직접 옮긴다. */
    move_count++;
    printf("  %2d단계: 원반 %d 이동  %c -> %c\n", move_count, n, from, to);

    /* 3) 보조 기둥의 n-1개를 출발 기둥을 경유지로 삼아 도착 기둥으로 옮긴다. */
    hanoi(n - 1, aux, from, to);
}

int main(void)
{
    printf("╔════════════════════════════════════════╗\n");
    printf("║        하노이의 탑 예제                ║\n");
    printf("╚════════════════════════════════════════╝\n\n");

    int n = 3;

    printf("원반 %d개를 A(출발) -> C(도착)로 옮깁니다. (B는 보조)\n", n);
    printf("----------------------------------------\n");

    move_count = 0;
    hanoi(n, 'A', 'B', 'C');

    printf("----------------------------------------\n");
    printf("총 이동 횟수: %d회\n", move_count);
    printf("이론적 최소 이동 횟수(2^%d - 1): %d회\n", n, (1 << n) - 1);
    ...
    return 0;
}

하노이 탑
$ ./build/examples/recursion_hanoi
...
원반 3개를 A(출발) -> C(도착)로 옮깁니다. (B는 보조)
----------------------------------------
   1단계: 원반 1 이동  A -> C
   2단계: 원반 2 이동  A -> B
   3단계: 원반 1 이동  C -> B
   4단계: 원반 3 이동  A -> C
   5단계: 원반 1 이동  B -> A
   6단계: 원반 2 이동  B -> C
   7단계: 원반 1 이동  A -> C
----------------------------------------
총 이동 횟수: 7회
이론적 최소 이동 횟수(2^3 - 1): 7회
코드 읽기 포인트
- 매개변수 순서가 호출마다 바뀝니다.
hanoi(n - 1, from, to, aux)에서aux와to의 자리가 바뀌어 들어갑니다. “n−1개를 B로 옮길 때는 C가 보조 기둥 역할을 한다”는 뜻입니다. 매개변수는 복사본이라(2.1절) 이렇게 역할을 바꿔 넘겨도 부른 쪽의from,to는 그대로입니다. - 종료 조건이
n == 0: 옮길 원반이 0개면 아무것도 안 하고 돌아갑니다.n == 1을 종료 조건으로 해도 되지만, 0으로 하면 “원반 하나 옮기기”도 같은 세 단계로 처리되어 코드가 더 단순합니다. (1 << n) - 1: 3주차에 배운 비트 이동 연산입니다.1 << n은 2ⁿ 이니, 이 식은 2ⁿ − 1 입니다.- 출력 4단계: 가장 큰 원반 3이 A → C 로 가는 순간이 정확히 한가운데입니다. 앞의 3단계는 “원반 2개를 B로”, 뒤의 3단계는 “원반 2개를 C로”입니다. 재귀의 세 단계 구조가 출력에 그대로 드러납니다.
실험: 원반을 늘리면?
int n = 3; 을 10, 20으로 바꿔 보세요(20은 100만 줄이 출력되니 | tail -3 을 붙여 끝만 보세요).
총 이동 횟수: 1023회
이론적 최소 이동 횟수(2^10 - 1): 1023회
총 이동 횟수: 1048575회
이론적 최소 이동 횟수(2^20 - 1): 1048575회
원반이 하나 늘 때마다 이동 횟수가 두 배가 됩니다. 옛날이야기에 따르면 어느 사원의 승려들이 원반 64개짜리 탑을 옮기고 있고, 다 옮기면 세상이 끝난다고 합니다. 2⁶⁴ − 1 = 18,446,744,073,709,551,615 번이니, 1초에 한 번 옮긴다면 약 5,845억 년이 걸립니다. 우주의 나이가 약 138억 년이니 걱정하지 않아도 됩니다.
이 코드의 move_count 는 int 입니다. 원반 64개로 바꾸면 5.2절에서 본 오버플로가 일어나겠죠(물론 그 전에 5,845억 년을 기다려야 합니다).
5.5 종료 조건을 빼먹으면 — 스택 오버플로
5.1절에서 “종료 조건이 없으면 인형을 영원히 연다”고 했습니다. 컴퓨터에서는 정말 영원히 갈까요? 직접 해 봅시다. forever.c:
#include <stdio.h>

long depth = 0;

void forever(void) {
    depth++;
    if (depth % 100000 == 0) {
        fprintf(stderr, "깊이 %ld\n", depth);
    }
    forever();
}

int main(void) {
    forever();
    return 0;
}
fprintf(stderr, ...) 는 printf 와 같지만 표준 오류(stderr) 로 출력합니다. 프로그램이 갑자기 죽으면 printf 로 찍은 내용이 화면에 나가기 전에 사라질 수 있는데, 표준 오류는 즉시 출력되므로 죽기 직전의 기록을 볼 수 있습니다. 표준 출력과 표준 오류의 차이는 9주차 파일 입출력에서 자세히 다룹니다.
$ gcc -Wall -Wextra -std=c11 forever.c -o forever
forever.c: In function ‘forever’:
forever.c:5:6: warning: infinite recursion detected [-Winfinite-recursion]
    5 | void forever(void) {
      |      ^~~~~~~
forever.c:10:5: note: recursive call
   10 |     forever();
      |     ^~~~~~~~~
컴파일러가 먼저 알아챘습니다. “무한 재귀가 발견됐다(infinite recursion detected).” 경고를 무시하고 실행해 봅시다.
$ ./forever
깊이 100000
깊이 200000
깊이 300000
깊이 400000
깊이 500000
세그멘테이션 오류 (코어 덤프됨)
$ echo $?
139
50만 번을 넘기고 60만 번에 닿기 전에 프로그램이 죽었습니다. 세그멘테이션 오류(Segmentation fault) 는 프로그램이 쓰면 안 되는 메모리에 손을 댔을 때 운영체제가 강제로 끝내는 것입니다. 앞으로 포인터를 배우면 자주 보게 될 메시지입니다. 종료 코드 139는 128 + 11 인데, 11은 “메모리 접근 위반” 신호의 번호입니다. 1주차에서 배운 대로 종료 코드에는 이렇게 실패의 종류가 담겨 있습니다(신호는 18주차 POSIX 시스템 프로그래밍에서 배웁니다).
왜 50만 번쯤에서 죽었을까요? 5.1절에서 함수를 부를 때마다 스택에 프레임이 쌓인다고 했습니다. 스택의 크기는 무한하지 않습니다. 리눅스에서는 기본으로 8MB 가 한도이고, ulimit -s 로 확인할 수 있습니다.
$ ulimit -s
8192
8,192KB, 즉 8MB 입니다. forever 의 프레임이 16바이트라면 8 × 1024 × 1024 ÷ 16 = 524,288번에서 스택이 넘칩니다. 실제로 50만과 60만 사이에서 죽었으니 계산과 맞습니다. 쌓아 둔 접시가 천장에 닿은 것입니다. 이것을 스택 오버플로(stack overflow) 라고 합니다. 개발자들이 질문하는 유명한 웹사이트의 이름이 바로 이것입니다.
재귀를 쓸 때는 항상 두 가지를 확인하세요.
- 종료 조건이 있는가?
- 매번 종료 조건에 가까워지는가?
factorial(n)이factorial(n - 1)을 부르는 것처럼. 실수로factorial(n + 1)이라고 쓰면 종료 조건이 있어도 영원히 닿지 못합니다.
그리고 종료 조건이 맞더라도 너무 깊이 들어가면 같은 일이 생깁니다. 재귀로 100만 단계를 들어가야 하는 문제는 반복문으로 바꾸는 것이 안전합니다.
5.6 재귀 vs 반복문
| 재귀 | 반복문 | |
|---|---|---|
| 코드 | 문제의 정의를 그대로 옮겨 짧고 읽기 쉽다 | 상태를 직접 관리해야 해서 길어질 수 있다 |
| 속도 | 호출마다 프레임을 만드는 비용이 든다 | 일반적으로 빠르다 |
| 메모리 | 깊이만큼 스택을 쓴다 | 추가 스택을 거의 안 쓴다 |
| 실수하면 | 스택 오버플로(5.5절) | 무한 루프(3주차) |
| 잘 맞는 문제 | 하노이 탑, 미로 찾기(8.3절), 트리(12주차)처럼 구조 자체가 재귀인 문제 | 팩토리얼, 피보나치처럼 한 방향으로 쌓아 가는 계산 |
모든 재귀는 반복문으로 바꿀 수 있고, 그 반대도 가능합니다. 어느 쪽이 “옳은” 게 아니라, 문제의 모양에 맞는 쪽을 고르면 됩니다. 하노이의 탑을 반복문으로 짜 보면(가능합니다) 재귀 버전이 얼마나 명료한지 실감하게 됩니다.
6. 모듈화와 분할 컴파일
6.1 왜 파일을 나누는가
지금까지 모든 예제는 파일 하나였습니다. 하지만 1주차 7절에서 말한 대로 리눅스 커널은 .c 파일이 3만 개가 넘습니다. 만약 그 코드가 한 파일에 들어 있다면?
- 한 줄만 고쳐도 전체를 다시 컴파일해야 합니다.
- 여러 사람이 한 파일을 동시에 고쳐야 합니다.
- 원하는 함수를 찾기도 어렵습니다.
그래서 관련 있는 함수끼리 묶어 따로 파일로 나눕니다. 이렇게 나눈 한 덩어리를 모듈(module) 이라고 하고, 프로그램을 모듈로 나누는 것을 모듈화라고 합니다. C에서 모듈 하나는 보통 파일 두 개로 이루어집니다.
| 파일 | 담는 것 | 비유 |
|---|---|---|
헤더 파일 .h |
함수 선언(프로토타입), 상수, 자료형 정의 | 식당 메뉴판: 무엇을 주문할 수 있는지 |
구현 파일 .c |
함수 정의(실제 코드) | 주방: 실제로 어떻게 만드는지 |
손님(다른 파일)은 메뉴판(.h)만 보고 주문하면 되고, 주방(.c)이 어떻게 돌아가는지 알 필요가 없습니다. 1주차에서 우리가 stdio.h 라는 메뉴판만 보고 printf 를 주문했고, 주방은 libc.so.6 에 있었던 것과 똑같은 구조입니다.
6.2 헤더와 구현: modular 예제 둘러보기
week05/modular/ 폴더에 모듈 두 개로 나눈 프로그램이 있습니다.
modular/
├── mymath.h     ← 수학 모듈의 메뉴판
├── mymath.c     ← 수학 모듈의 주방
├── strutil.h    ← 문자열 모듈의 메뉴판
├── strutil.c    ← 문자열 모듈의 주방
├── main.c       ← 두 모듈을 쓰는 손님
└── Makefile     ← 빌드 방법 (7절)
헤더: mymath.h
/*
 * mymath.h - 수학 라이브러리 헤더
 * 5주차: 함수와 모듈화 (분할 컴파일 데모)
 */

#ifndef MYMATH_H
#define MYMATH_H

/* 두 정수의 합을 반환한다. */
int add(int a, int b);

/* 두 정수의 최대공약수(GCD)를 반환한다. */
int gcd(int a, int b);

/* n의 팩토리얼(n!)을 반환한다. n은 0 이상이어야 한다. */
long factorial(int n);

/* n이 소수이면 1, 아니면 0을 반환한다. */
int is_prime(int n);

/* base의 exp 제곱을 반환한다. exp는 0 이상이어야 한다. */
int power(int base, int exp);

#endif /* MYMATH_H */
3.2절에서 배운 프로토타입만 모여 있습니다. 본문은 하나도 없습니다. 각 선언 위의 주석을 보세요. “무엇을 받아서 무엇을 돌려주는지”, 그리고 “어떤 조건을 지켜야 하는지”(n은 0 이상이어야 한다) 가 적혀 있습니다. 헤더는 이 모듈을 쓰는 사람이 읽는 설명서이기도 하니, 주석은 여기에 정성껏 씁니다. man 3 printf 의 SYNOPSIS 와 같은 역할입니다.
맨 위와 맨 아래의 #ifndef, #define, #endif 는 6.4절에서 설명합니다.
구현: mymath.c
#include "mymath.h"

int add(int a, int b)
{
    return a + b;
}

int gcd(int a, int b)
{
    if (a < 0) {
        a = -a;
    }
    if (b < 0) {
        b = -b;
    }
    while (b != 0) {
        int tmp = a % b;
        a = b;
        b = tmp;
    }
    return a;
}

long factorial(int n)
{
    long result = 1;
    int i;
    for (i = 2; i <= n; i++) {
        result *= i;
    }
    return result;
}

int is_prime(int n)
{
    int i;
    if (n < 2) {
        return 0;
    }
    for (i = 2; i * i <= n; i++) {
        if (n % i == 0) {
            return 0;
        }
    }
    return 1;
}

int power(int base, int exp)
{
    int result = 1;
    int i;
    for (i = 0; i < exp; i++) {
        result *= base;
    }
    return result;
}
헤더에 선언한 다섯 함수의 정의가 있습니다. 첫 줄에서 자기 자신의 헤더 mymath.h 를 포함하는 것을 눈여겨보세요. 이 파일은 printf 를 쓰지 않으니 stdio.h 는 필요 없는데, 자기 헤더는 포함합니다. 왜 그럴까요? 6.3절에서 실험으로 답합니다.
gcd 는 3주차에서 배운 유클리드 호제법으로 최대공약수를 구합니다. gcd(48, 36) 이면 48 % 36 = 12, 36 % 12 = 0 이니 답은 12입니다. is_prime 의 i * i <= n 은 “√n 까지만 나눠 보면 된다”는 뜻입니다. 36 이 6 보다 큰 수로 나누어떨어진다면 짝이 되는 6 보다 작은 수로도 나누어떨어지기 때문입니다.
손님: main.c
#include <stdio.h>
#include "mymath.h"
#include "strutil.h"

int main(void)
{
    char text[] = "hello, modular world";

    printf("╔════════════════════════════════════════╗\n");
    printf("║   5주차: 함수와 모듈화 (분할 컴파일)   ║\n");
    printf("╚════════════════════════════════════════╝\n\n");

    printf("[ mymath 라이브러리 데모 ]\n");
    printf("  add(3, 4)      = %d\n", add(3, 4));
    printf("  gcd(48, 36)    = %d\n", gcd(48, 36));
    printf("  factorial(5)   = %ld\n", factorial(5));
    printf("  is_prime(17)   = %d\n", is_prime(17));
    printf("  is_prime(18)   = %d\n", is_prime(18));
    printf("  power(2, 10)   = %d\n", power(2, 10));
    printf("\n");

    printf("[ strutil 라이브러리 데모 ]\n");
    printf("  원본 문자열      : \"%s\"\n", text);
    printf("  str_length       : %d\n", str_length(text));
    printf("  'o' 개수         : %d\n", str_count_char(text, 'o'));
    str_upper(text);
    printf("  str_upper 적용   : \"%s\"\n", text);
    printf("\n");

    printf("각 함수는 별도의 .c 파일에서 구현되고,\n");
    printf(".h 헤더로 선언을 공유하여 분할 컴파일됩니다.\n");

    return 0;
}
main.c 에는 add, gcd 같은 함수의 정의가 하나도 없습니다. 헤더 두 개를 포함해서 선언만 받아 왔을 뿐입니다. 컴파일러는 선언만 있으면 호출을 번역할 수 있다는 것을 3.2절에서 봤습니다. strutil.h 와 strutil.c 도 같은 구조로 str_length, str_upper, str_count_char 를 제공합니다(4주차에 배운 문자열 처리를 함수로 묶은 것입니다).
#include <…> 와 #include “…” 의 차이
main.c 의 첫 세 줄은 괄호 모양이 다릅니다.
#include <stdio.h>      /* 꺾쇠: 시스템 헤더 */
#include "mymath.h"     /* 큰따옴표: 내가 만든 헤더 */
| 모양 | 찾는 곳 |
|---|---|
<stdio.h> |
시스템 헤더 폴더 (/usr/include 등, 1주차 7절) |
"mymath.h" |
① 이 #include 가 적힌 파일이 있는 폴더를 먼저, 없으면 ② 시스템 헤더 폴더 |
①을 흔히 “현재 폴더”라고 설명하는데, 정확히는 터미널의 현재 위치가 아니라 #include 를 쓴 소스 파일의 위치입니다. 확인해 봅시다. 소스와 헤더를 src 폴더에 넣고, 그 바깥에서 컴파일합니다.
$ ls
src
$ ls src
main.c  mymath.h  strutil.h
$ gcc -Wall -std=c11 -c src/main.c -o main.o
$
터미널의 현재 위치에는 헤더가 없는데도 오류 없이 컴파일됩니다. main.c 옆(src/)에서 헤더를 찾았기 때문입니다.
반대로 헤더를 다른 폴더(inc/)로 옮기면 못 찾습니다.
$ gcc -Wall -std=c11 -c main.c
main.c:7:10: fatal error: mymath.h: 그런 파일이나 디렉터리가 없습니다
    7 | #include "mymath.h"
      |          ^~~~~~~~~~
compilation terminated.
$ gcc -Wall -std=c11 -Iinc -c main.c
$
이럴 때는 -I (Include) 옵션으로 “헤더는 이 폴더에서도 찾아라”라고 알려 주면 됩니다. -Iinc 는 inc 폴더를 찾을 곳에 추가합니다. 큰 프로젝트는 보통 헤더를 include/ 폴더에 모아 두고 -Iinclude 로 컴파일합니다.
6.3 구현 파일이 자기 헤더를 포함하는 이유
mymath.c 는 왜 mymath.h 를 포함할까요? 실험해 봅시다. 누군가 mymath.c 를 고치다가 add 의 반환형을 실수로 long 으로 바꿨다고 해 봅시다. 헤더는 여전히 int add(int a, int b); 입니다.
long add(int a, int b)     /* 헤더와 다르게 바뀜! */
{
    return a + b;
}
mymath.c 가 자기 헤더를 포함하고 있으면, 컴파일할 때 이렇게 됩니다.
$ gcc -Wall -std=c11 -c mymath.c
mymath.c:8:6: error: conflicting types for ‘add’; have ‘long int(int,  int)’
    8 | long add(int a, int b)
      |      ^~~
In file included from mymath.c:6:
mymath.h:10:5: note: previous declaration of ‘add’ with type ‘int(int,  int)’
   10 | int add(int a, int b);
      |     ^~~
3.1절에서 본 conflicting types 오류입니다. 헤더의 선언(int)과 여기의 정의(long)가 다르다고 바로 잡아 줍니다.
그런데 #include "mymath.h" 줄을 지우고 같은 실수를 하면?
$ gcc -Wall -std=c11 -c mymath.c
$
아무 말 없이 컴파일됩니다. 이 파일만 보면 long add(...) 는 아무 문제 없는 함수니까요. 하지만 main.c 는 헤더를 보고 add 가 int 를 돌려준다고 믿고 번역됩니다. 한쪽은 long 을 돌려주고 다른 쪽은 int 를 받는, 서로 약속이 어긋난 프로그램이 조용히 만들어집니다. 이런 버그는 7.5절에서 보듯 엉뚱한 값으로 나타나서 원인을 찾기가 아주 어렵습니다.
그래서 구현 파일은 항상 자기 헤더를 첫 줄에 포함합니다. 그러면 메뉴판(.h)과 주방(.c)이 어긋나는 순간 컴파일러가 알려 줍니다.
6.4 include 가드
mymath.h 의 맨 위와 맨 아래를 다시 봅시다.
#ifndef MYMATH_H
#define MYMATH_H

... 선언들 ...

#endif /* MYMATH_H */
1주차 6절 예제 5에서 본 조건부 컴파일입니다. 한 줄씩 읽으면 이렇습니다.
#ifndef MYMATH_H: “MYMATH_H라는 이름이 아직 정의되지 않았다면(if not defined)” 아래를 남긴다.#define MYMATH_H:MYMATH_H라는 이름을 정의한다. (값은 없어도 됩니다. 이름이 있다는 것 자체가 표시입니다.)- 선언들
#endif: 조건 블록의 끝.
처음 포함될 때는 MYMATH_H 가 없으니 내용이 들어가고, 동시에 MYMATH_H 가 정의됩니다. 같은 헤더가 두 번째로 포함되면 이미 MYMATH_H 가 있으니 #ifndef 가 거짓이 되어 내용 전체가 통째로 건너뛰어집니다. 이것을 include 가드(include guard) 라고 합니다.
같은 헤더가 두 번 포함되는 일이 정말 있을까요? 직접 두 번 쓰는 일은 드물지만, a.h 가 b.h 를 포함하고 main.c 가 a.h 와 b.h 를 둘 다 포함하면 b.h 는 두 번 들어옵니다. 1주차 7절에서 stdio.h 하나가 헤더 26개를 끌고 온 것을 기억하나요? 헤더가 헤더를 포함하는 일은 아주 흔합니다.
실험: 가드가 없으면 무엇이 문제일까?
그런데 여기서 재미있는 사실이 있습니다. 함수 선언은 여러 번 해도 오류가 아닙니다. 3.2절의 표에서 “선언은 여러 번 해도 된다(내용만 같다면)”고 했죠.
int add(int a, int b);
int add(int a, int b);
int add(int, int);
$ gcc -Wall -Wextra -std=c11 dup.c -o dup
$
아무 문제 없습니다. 그러니 지금의 mymath.h 처럼 함수 선언만 있는 헤더는 가드가 없어도 두 번 포함해서 오류가 나지는 않습니다. 그럼 가드는 왜 필요할까요?
헤더에는 함수 선언 말고도 자료형 정의가 들어갑니다. 8주차에 배울 구조체가 대표적입니다. point.h 에 가드 없이 구조체를 정의해 봅시다.
struct point {
    int x;
    int y;
};
그리고 이 헤더를 두 번 포함합니다.
#include "point.h"
#include "point.h"
$ gcc -Wall -std=c11 guard.c -o guard
In file included from guard.c:2:
point.h:1:8: error: redefinition of ‘struct point’
    1 | struct point {
      |        ^~~~~
In file included from guard.c:1:
point.h:1:8: note: originally defined here
    1 | struct point {
      |        ^~~~~
“struct point 를 다시 정의했다(redefinition).” 선언은 여러 번 해도 되지만 정의는 한 번만 해야 한다는 규칙에 걸렸습니다. point.h 에 #ifndef POINT_H / #define POINT_H / #endif 를 두르면 같은 코드가 오류 없이 컴파일됩니다.
그러니 include 가드가 막는 것은 정확히 말하면 “중복 선언”이 아니라 “중복 정의” 입니다. 지금은 선언만 있는 헤더라도, 나중에 누군가 자료형을 추가할 수 있으니 모든 헤더에 처음부터 가드를 씁니다. 이름은 보통 파일 이름을 대문자로 바꾸고 . 을 _ 로 바꿔서(mymath.h → MYMATH_H) 다른 헤더와 겹치지 않게 합니다.
6.5 분할 컴파일 — 따로 번역하고 함께 링크하기
이제 여러 파일로 나눈 프로그램을 컴파일해 봅시다. 1주차처럼 main.c 만 컴파일하면 어떻게 될까요?
$ cd week05/modular
$ gcc -Wall -Wextra -std=c11 main.c -o demo
/usr/bin/ld: /tmp/cc4BUAfR.o: in function `main':
main.c:(.text+0x8c): undefined reference to `add'
/usr/bin/ld: main.c:(.text+0xb1): undefined reference to `gcd'
/usr/bin/ld: main.c:(.text+0xd1): undefined reference to `factorial'
/usr/bin/ld: main.c:(.text+0xf2): undefined reference to `is_prime'
/usr/bin/ld: main.c:(.text+0x112): undefined reference to `is_prime'
/usr/bin/ld: main.c:(.text+0x137): undefined reference to `power'
/usr/bin/ld: main.c:(.text+0x18d): undefined reference to `str_length'
/usr/bin/ld: main.c:(.text+0x1b4): undefined reference to `str_count_char'
/usr/bin/ld: main.c:(.text+0x1d6): undefined reference to `str_upper'
collect2: error: ld returned 1 exit status
1주차 10절의 “에러 3″(mian 오타)에서 본 바로 그 링크 오류 undefined reference 입니다. 메시지를 읽어 봅시다.
/usr/bin/ld:로 시작합니다. 컴파일러가 아니라 링커의 메시지입니다. 즉 컴파일은 성공했습니다. 헤더가 있으니 컴파일러는add가 어떤 함수인지 알았고, 호출을 번역할 수 있었습니다.- 문제는 링크 단계입니다.
main이add를 부르는데, 링커가 합칠 파일 중에add의 정의(기계어) 를 가진 파일이 없습니다. 메뉴판만 있고 주방이 없는 것입니다. /tmp/cc4BUAfR.o는 GCC가main.c를 번역해서 임시 폴더에 잠깐 만든 오브젝트 파일입니다(1주차 7절).
mymath.c 를 함께 넣으면 오류가 줄어듭니다.
$ gcc -Wall -Wextra -std=c11 main.c mymath.c -o demo
/usr/bin/ld: /tmp/cc7szVwI.o: in function `main':
main.c:(.text+0x18d): undefined reference to `str_length'
/usr/bin/ld: main.c:(.text+0x1b4): undefined reference to `str_count_char'
/usr/bin/ld: main.c:(.text+0x1d6): undefined reference to `str_upper'
collect2: error: ld returned 1 exit status
수학 함수들은 해결됐고 문자열 함수 세 개가 남았습니다. strutil.c 까지 넣으면 드디어 성공합니다.
$ gcc -Wall -Wextra -std=c11 main.c mymath.c strutil.c -o demo
$ ./demo
╔════════════════════════════════════════╗
║   5주차: 함수와 모듈화 (분할 컴파일)   ║
╚════════════════════════════════════════╝

[ mymath 라이브러리 데모 ]
  add(3, 4)      = 7
  gcd(48, 36)    = 12
  factorial(5)   = 120
  is_prime(17)   = 1
  is_prime(18)   = 0
  power(2, 10)   = 1024

[ strutil 라이브러리 데모 ]
  원본 문자열      : "hello, modular world"
  str_length       : 20
  'o' 개수         : 3
  str_upper 적용   : "HELLO, MODULAR WORLD"

각 함수는 별도의 .c 파일에서 구현되고,
.h 헤더로 선언을 공유하여 분할 컴파일됩니다.
교훈: 헤더를 포함하는 것(#include)과 구현 파일을 링크하는 것은 별개입니다. #include 는 컴파일러에게 선언을 알려 줄 뿐이고, 정의가 든 .c 파일은 따로 컴파일해서 링크에 넣어야 합니다. undefined reference 가 나오면 “이 함수의 정의가 든 .c 를 빼먹지 않았나?”부터 확인하세요.
한 단계씩: -c 로 따로 번역하고 링크하기
위의 한 줄 명령은 내부적으로 세 파일을 각각 번역한 뒤 합칩니다. 1주차 7절에서 배운 -c 로 이 과정을 나눠 봅시다.
$ gcc -Wall -Wextra -std=c11 -c main.c
$ gcc -Wall -Wextra -std=c11 -c mymath.c
$ gcc -Wall -Wextra -std=c11 -c strutil.c
$ ls -l *.o
-rw-rw-r-- 1 user user 4216  9월 24 10:35 main.o
-rw-rw-r-- 1 user user 1848  9월 24 10:35 mymath.o
-rw-rw-r-- 1 user user 1664  9월 24 10:35 strutil.o
각 .c 가 다른 파일을 전혀 보지 않고 혼자서 .o 로 번역되었습니다. 이렇게 파일마다 따로 컴파일하는 것을 분할 컴파일(separate compilation) 이라고 합니다. 각 .o 에 무엇이 있고 무엇이 필요한지 nm 으로 봅시다.
$ nm main.o
                 U __stack_chk_fail
                 U add
                 U factorial
                 U gcd
                 U is_prime
0000000000000000 T main
                 U power
                 U printf
                 U putchar
                 U puts
                 U str_count_char
                 U str_length
                 U str_upper
$ nm mymath.o
0000000000000000 T add
000000000000005b T factorial
0000000000000018 T gcd
000000000000009a T is_prime
00000000000000e5 T power
$ nm strutil.o
00000000000000af T str_count_char
0000000000000000 T str_length
0000000000000032 T str_upper
그림이 딱 맞아떨어집니다.
main.o는main만 가지고 있고(T),add,gcd,str_length등은 필요하다(U, Undefined) 고 표시합니다.mymath.o는add,gcd,factorial,is_prime,power를 가지고 있습니다(T).strutil.o는 문자열 함수 세 개를 가지고 있습니다(T).
링커가 하는 일은 U 와 T 를 짝지어 주는 것입니다. main.o 의 U add 를 mymath.o 의 T add 와 연결합니다. printf 와 puts 는 1주차에 본 대로 libc.so.6 에서 찾습니다. __stack_chk_fail 은 배열이 넘치는 것을 감지하는 보안 장치인데(main 에 char text[] 배열이 있어서 들어갔습니다), 24주차에 다룹니다.
이제 링크만 따로 합니다.
$ gcc main.o mymath.o strutil.o -o demo
$ ./demo | head -3
╔════════════════════════════════════════╗
║   5주차: 함수와 모듈화 (분할 컴파일)   ║
╚════════════════════════════════════════╝
그림으로 정리하면 이렇습니다.
main.c    ──(gcc -c)──▶  main.o     T main,  U add, U gcd, U str_length ...  ┐
mymath.c  ──(gcc -c)──▶  mymath.o   T add, T gcd, T factorial ...           ├─(링크)─▶ demo
strutil.c ──(gcc -c)──▶  strutil.o  T str_length, T str_upper ...           ┘
            ↑ 각자 따로 번역                         ↑ U 와 T 를 짝지음
이렇게 나누면 좋은 점이 바로 1주차 7절 끝에서 말한 것입니다. mymath.c 만 고쳤다면 mymath.o 만 다시 만들고 링크만 다시 하면 됩니다. main.c 와 strutil.c 는 다시 번역할 필요가 없습니다. 그런데 무엇을 다시 만들어야 하는지 사람이 매번 판단하는 것은 번거롭고 실수하기 쉽습니다. 그 판단을 대신해 주는 것이 7절의 make 입니다.
6.6 같은 이름이 두 번 정의되면 — multiple definition
3.2절에서 “정의는 프로그램 전체에서 딱 한 번”이라고 했습니다. 파일이 하나일 때는 같은 함수를 두 번 쓰면 컴파일러가 바로 잡아 줍니다. 그런데 두 파일에 나뉘어 있으면 어떨까요? 컴파일러는 파일을 하나씩 따로 보니까 알 수가 없습니다.
extra.c 라는 파일을 만들고, 우연히 mymath.c 와 같은 이름의 add 를 정의했다고 해 봅시다.
int add(int a, int b)
{
    return a - b;   /* 이름만 같은 다른 add */
}
$ gcc -Wall -Wextra -std=c11 main.c mymath.c strutil.c extra.c -o demo
/usr/bin/ld: /tmp/ccdfELAr.o: in function `add':
extra.c:(.text+0x0): multiple definition of `add'; /tmp/cc4DwwU3.o:mymath.c:(.text+0x0): first defined here
collect2: error: ld returned 1 exit status
이번에도 링커가 잡았습니다. “extra.c 의 add 가 여러 번 정의되었다(multiple definition). 처음 정의된 곳은 mymath.c.” 컴파일은 각자 잘 됐지만, 링커가 T add 를 두 개 발견하고 어느 것을 main 과 연결할지 정할 수 없게 된 것입니다.
undefined reference 와 multiple definition 은 링크 오류의 두 얼굴입니다.
| 오류 | 뜻 | 흔한 원인 |
|---|---|---|
undefined reference to 'X' |
X 를 쓰는데 정의가 하나도 없다 |
.c 파일을 링크에 빼먹음, 이름 오타 |
multiple definition of 'X' |
X 의 정의가 둘 이상 있다 |
같은 이름의 함수를 두 파일에 정의, 헤더에 함수 정의(본문)를 넣음 |
표의 마지막 원인은 특히 조심하세요. 헤더에 함수 선언이 아니라 본문까지 적어 두면, 그 헤더를 포함한 .c 파일마다 정의가 하나씩 생겨서 multiple definition 이 납니다. 헤더에는 선언만, 정의는 .c 에.
static 이 해결해 주는 것
extra.c 의 add 가 사실은 그 파일 안에서만 쓰는 도우미 함수였다면 어떨까요? 4.5절에서 배운 static 을 붙이면 됩니다.
static int add(int a, int b)
{
    return a - b;
}
$ gcc -Wall -Wextra -std=c11 main.c mymath.c strutil.c extra.c -o demo
extra.c:1:12: warning: ‘add’ defined but not used [-Wunused-function]
    1 | static int add(int a, int b)
      |            ^~~
$
multiple definition 오류가 사라졌습니다. static 을 붙인 add 는 nm 에서 소문자 t 로, 즉 이 파일 안에서만 쓰는 이름으로 표시되어 링커가 다른 파일과 연결하지 않기 때문입니다. mymath.c 의 add 와 extra.c 의 add 가 서로 부딪히지 않고 공존합니다. (남은 경고는 “extra.c 안에서 이 add 를 아무도 안 쓴다”는 뜻인데, 실험용 파일이라서 그렇습니다.)
이것이 static 함수의 진짜 쓸모입니다. 모듈 안에서만 쓰는 도우미 함수에 static 을 붙여 두면, 다른 모듈이 우연히 같은 이름을 써도 충돌하지 않습니다. 헤더에 선언한 함수(모듈의 메뉴)는 static 없이, 모듈 내부의 도우미 함수는 static 으로 만드는 습관을 들이세요.
7. Makefile 기초
6.5절 끝에서 문제가 하나 남았습니다. 파일을 고칠 때마다 “무엇을 다시 컴파일해야 하지?”를 사람이 판단해야 한다는 것입니다. mymath.c 를 고치면 mymath.o 를, strutil.h 를 고치면… 그 헤더를 포함하는 파일들을 전부 다시 컴파일해야 합니다. 파일이 수십 개면 사람이 추적할 수 없습니다.
make 는 이 판단을 대신해 주는 프로그램입니다. 1976년에 만들어진 오래된 도구지만, 지금도 리눅스 커널을 포함한 수많은 C 프로젝트가 make 로 빌드됩니다. make 에게 “무엇이 무엇으로 만들어지고, 어떻게 만드는지” 를 적어 주는 파일이 Makefile 입니다.
7.1 규칙의 구조
Makefile 은 규칙(rule) 들의 모음입니다. 규칙 하나는 이렇게 생겼습니다.
타깃: 재료1 재료2 ...
    명령
| 부분 | 영어 | 뜻 | 예 |
|---|---|---|---|
| 타깃 | target | 만들려는 파일 | mymath.o |
| 재료 | prerequisites (의존 파일) | 타깃을 만드는 데 필요한 파일들 | mymath.c mymath.h |
| 명령 | recipe (레시피) | 타깃을 만드는 쉘 명령 | gcc -c mymath.c |
그리고 make 의 판단 규칙은 딱 하나입니다.
타깃이 없거나, 재료 중 하나라도 타깃보다 새것이면(수정 시각이 나중이면), 명령을 실행한다.
“새것”을 판단하는 기준이 1주차 2절에서 ls -l 로 본 파일의 수정 시각입니다. mymath.c 를 고쳐서 저장하면 mymath.c 의 시각이 mymath.o 보다 나중이 되고, make 는 “재료가 결과물보다 새롭다, 결과물이 낡았다”고 판단해서 다시 만듭니다.
명령 줄은 반드시 탭(Tab) 문자로 시작해야 합니다. 공백 4칸이 아니라 키보드의
Tab키입니다. 50년 된 규칙이라 지금 보면 이상하지만 바뀌지 않았습니다. 7.8절에서 공백으로 쓰면 어떻게 되는지 봅니다. VS Code 는 파일 이름이Makefile이면 알아서 탭을 넣어 줍니다.
7.2 modular/Makefile 한 줄씩 읽기
week05/modular/Makefile:
# Makefile - 분할 컴파일 데모
# 5주차: 함수와 모듈화

CC      = gcc
CFLAGS  = -Wall -Wextra -std=c11
TARGET  = demo
OBJS    = main.o mymath.o strutil.o

# 최종 링크: 각 .o 파일을 묶어 실행파일 생성
$(TARGET): $(OBJS)
    $(CC) $(CFLAGS) -o $(TARGET) $(OBJS)

# 개별 컴파일 규칙 (헤더 의존성 명시)
main.o: main.c mymath.h strutil.h
    $(CC) $(CFLAGS) -c main.c

mymath.o: mymath.c mymath.h
    $(CC) $(CFLAGS) -c mymath.c

strutil.o: strutil.c strutil.h
    $(CC) $(CFLAGS) -c strutil.c

clean:
    rm -f $(TARGET) $(OBJS)

.PHONY: clean
위에서부터 읽어 봅시다.
# 로 시작하는 줄: 주석입니다. 1주차 12절의 쉘 스크립트와 같습니다.
변수 정의 (4~7번째 줄):
CC      = gcc
CFLAGS  = -Wall -Wextra -std=c11
TARGET  = demo
OBJS    = main.o mymath.o strutil.o
이름 = 값 으로 변수를 만듭니다. 쓸 때는 $(이름) 으로 씁니다. $(CC) 는 gcc 로, $(CFLAGS) 는 -Wall -Wextra -std=c11 로 바뀝니다. 쉘의 $HOME 과 비슷하지만 괄호가 필요합니다.
변수를 쓰는 이유는 1.1절의 함수를 쓰는 이유와 같습니다. 컴파일 옵션에 -g 를 더하고 싶으면 CFLAGS 한 줄만 고치면 모든 규칙에 적용됩니다. CC 와 CFLAGS 라는 이름은 관례라서, 다른 사람의 Makefile 에서도 거의 항상 같은 뜻으로 쓰입니다(C Compiler, C 컴파일 FLAGS).
첫 번째 규칙 (10~11번째 줄):
$(TARGET): $(OBJS)
    $(CC) $(CFLAGS) -o $(TARGET) $(OBJS)
변수를 풀어 쓰면 이렇습니다.
demo: main.o mymath.o strutil.o
    gcc -Wall -Wextra -std=c11 -o demo main.o mymath.o strutil.o
“demo 는 .o 세 개로 만든다. 만드는 방법은 셋을 링크하는 것.” 6.5절에서 손으로 친 링크 명령과 같습니다. Makefile 의 첫 번째 규칙은 특별합니다. 그냥 make 라고만 치면 첫 번째 규칙의 타깃을 만듭니다. 그래서 최종 결과물(demo)을 맨 위에 둡니다.
.o 규칙들 (14~21번째 줄):
main.o: main.c mymath.h strutil.h
    $(CC) $(CFLAGS) -c main.c
“main.o 는 main.c, mymath.h, strutil.h 로 만든다.” 재료에 헤더까지 적은 것이 중요합니다. main.c 는 두 헤더를 #include 하니까, 헤더가 바뀌면 main.o 도 다시 만들어야 합니다. 반면 mymath.o 의 재료는 mymath.c mymath.h 뿐입니다. mymath.c 는 strutil.h 를 포함하지 않으니까요. 재료 목록은 각 .c 파일의 #include 줄과 정확히 맞아야 합니다. 이것을 틀리면 어떤 일이 생기는지 7.5절에서 봅니다.
clean 규칙과 .PHONY (23~26번째 줄):
clean:
    rm -f $(TARGET) $(OBJS)

.PHONY: clean
clean 은 재료가 없고, 명령은 만들어진 파일들을 지웁니다. clean 이라는 파일을 만드는 게 아니라 작업의 이름일 뿐입니다. .PHONY: clean 은 “clean 은 파일이 아니라 작업 이름이다”라고 make 에게 알려 주는 선언입니다(phony = 가짜). 왜 필요한지는 7.7절에서 봅니다. rm -f 의 -f 는 1주차 2절에서 본 “없는 파일이어도 불평하지 마라”입니다.
make 가 이 Makefile 을 읽으면 머릿속에 이런 의존성 그래프를 그립니다.
                     demo
          ┌───────────┼───────────┐
       main.o      mymath.o    strutil.o
     ┌───┼────┐     ┌──┴──┐     ┌──┴───┐
 main.c mymath.h strutil.h  mymath.c mymath.h  strutil.c strutil.h
(mymath.h 와 strutil.h 는 두 곳에서 쓰입니다.) make 는 아래에서 위로 따라 올라가며 “재료가 타깃보다 새것인가?”를 확인하고, 필요한 것만 다시 만듭니다.
7.3 make 실행해 보기
$ cd week05/modular
$ make
gcc -Wall -Wextra -std=c11 -c main.c
gcc -Wall -Wextra -std=c11 -c mymath.c
gcc -Wall -Wextra -std=c11 -c strutil.c
gcc -Wall -Wextra -std=c11 -o demo main.o mymath.o strutil.o
$ ./demo | head -3
╔════════════════════════════════════════╗
║   5주차: 함수와 모듈화 (분할 컴파일)   ║
╚════════════════════════════════════════╝
make 는 실행하는 명령을 화면에 먼저 보여 준 뒤 실행합니다. 6.5절에서 우리가 손으로 친 네 줄과 똑같습니다. 순서를 보세요. demo 를 만들려면 .o 들이 먼저 있어야 하니, make 가 알아서 .o 부터 만들었습니다.
바로 한 번 더 make 를 쳐 봅시다.
$ make
make: 'demo'은(는) 이미 업데이트되었습니다.
영어 환경에서는 make: 'demo' is up to date. 입니다. 아무것도 바뀌지 않았으니 아무것도 하지 않았습니다. 모든 재료보다 타깃이 새것이기 때문입니다. 이것이 make 의 핵심입니다. 필요한 일만 합니다.
7.4 touch 로 make 속이기 — 1주차의 약속
1주차 2절에서 touch 는 파일 내용은 그대로 두고 수정 시각만 지금으로 바꾼다고 배웠습니다. 그때 “5주차에 touch 로 make 를 속여 보는 실험을 한다”고 했죠. 드디어 그 실험입니다. 내용은 한 글자도 안 바꾸고, make 가 파일이 바뀌었다고 믿게 만들어 봅시다.
먼저 mymath.c 를 건드려 봅니다.
$ touch mymath.c
$ stat -c '%y %n' mymath.c mymath.o
2026-09-24 10:36:38.199... mymath.c
2026-09-24 10:36:37.169... mymath.o
stat -c '%y %n' 은 파일의 수정 시각(%y)과 이름(%n)을 보여 줍니다. ls -l 은 분 단위까지만 보여 줘서 1초 차이가 안 보이기 때문에 이 명령을 썼습니다. 이제 mymath.c 가 mymath.o 보다 1초 새것입니다. make 를 치기 전에, 무엇이 다시 컴파일될지 7.2절의 그래프를 보고 예상해 보세요.
$ make
gcc -Wall -Wextra -std=c11 -c mymath.c
gcc -Wall -Wextra -std=c11 -o demo main.o mymath.o strutil.o
mymath.c 만 다시 컴파일하고, mymath.o 가 새것이 되었으니 demo 를 다시 링크했습니다. main.c 와 strutil.c 는 건드리지 않았습니다. 그래프에서 mymath.c 로부터 위로 올라가는 길만 다시 만들어진 것입니다.
이번에는 헤더를 건드려 봅시다. strutil.h 를 touch 하면 무엇이 다시 컴파일될까요? 그래프에서 strutil.h 는 main.o 와 strutil.o 두 곳의 재료입니다.
$ touch strutil.h
$ make
gcc -Wall -Wextra -std=c11 -c main.c
gcc -Wall -Wextra -std=c11 -c strutil.c
gcc -Wall -Wextra -std=c11 -o demo main.o mymath.o strutil.o
예상대로 main.c 와 strutil.c 가 다시 컴파일되고 mymath.c 는 그대로입니다. mymath.h 도 해 보세요.
$ touch mymath.h
$ make
gcc -Wall -Wextra -std=c11 -c main.c
gcc -Wall -Wextra -std=c11 -c mymath.c
gcc -Wall -Wextra -std=c11 -o demo main.o mymath.o strutil.o
이번에는 main.c 와 mymath.c 입니다. make 는 파일 내용은 전혀 보지 않고, 오직 시각과 우리가 적어 준 의존 관계만 보고 판단한다는 것이 확인됐습니다. 그래서 touch 에 속은 것이고, 그래서 의존 관계를 정확히 적어 주는 것이 중요합니다.
이 실험이 왜 중요할까? 지금은 파일이 3개라 전부 다시 컴파일해도 1초면 끝납니다. 하지만 파일이 1만 개인 프로젝트에서 헤더 하나를 고쳤다면?
make는 그 헤더를 포함하는 파일만 골라 다시 컴파일합니다. 나머지 9,900개는 그대로 둡니다. 몇 시간짜리 빌드가 몇 초로 줄어드는 비결이 이 단순한 시각 비교입니다.
7.5 의존성을 빠뜨리면 — 조용한 버그
7.2절에서 “재료 목록은 #include 와 정확히 맞아야 한다”고 했습니다. 헤더를 재료에서 빼먹으면 어떻게 될까요? 헤더를 뺀 Makefile.bad 를 만들어 봅시다.
CC = gcc
CFLAGS = -Wall -Wextra -std=c11

demo: main.o mymath.o strutil.o
    $(CC) main.o mymath.o strutil.o -o demo

main.o: main.c
    $(CC) $(CFLAGS) -c main.c

mymath.o: mymath.c
    $(CC) $(CFLAGS) -c mymath.c

strutil.o: strutil.c
    $(CC) $(CFLAGS) -c strutil.c
make -f 파일이름 은 Makefile 대신 지정한 파일을 읽으라는 뜻입니다. 이것으로 빌드하고 실행하면 처음에는 잘 됩니다.
$ make -f Makefile.bad -s
$ ./demo | grep factorial
  factorial(5)   = 120
(-s 는 명령을 화면에 보여 주지 말고 조용히(silent) 하라는 옵션입니다.)
헤더를 touch 해 봅시다.
$ touch mymath.h
$ make -f Makefile.bad
make: 'demo'은(는) 이미 업데이트되었습니다.
헤더가 바뀌었는데 make 는 아무것도 안 합니다. 재료 목록에 헤더가 없으니 헤더의 시각은 보지도 않습니다. touch 만 했으니 지금은 괜찮지만, 진짜로 헤더를 고쳤다면 어떻게 될까요?
factorial 이 소수점 있는 값도 받도록 매개변수를 int 에서 double 로 바꾼다고 해 봅시다. 헤더와 구현을 둘 다 바르게 고칩니다.
/* mymath.h */
long factorial(double n);

/* mymath.c */
long factorial(double n)
{
    ...
}
main.c 는 그대로 factorial(5) 를 부릅니다. 헤더가 바뀌었으니 main.c 는 다시 컴파일되어야 합니다. 이제 5 를 double 로 바꿔서 넘겨야 하니까요. 하지만 Makefile.bad 는 모릅니다.
$ make -f Makefile.bad
gcc -Wall -Wextra -std=c11 -c mymath.c
gcc main.o mymath.o strutil.o -o demo
$ ./demo | grep factorial
  factorial(5)   = 1
factorial(5) 가 1 이 되었습니다. 경고도, 오류도 없이요.
무슨 일이 일어났는지 보면 이렇습니다. mymath.c 는 다시 컴파일되어 “factorial 은 double 을 받는다”로 바뀌었습니다. 그런데 main.o 는 옛날 헤더를 보고 번역된 그대로라서, 여전히 5를 int 로 넘깁니다. 1주차 7절에서 “첫 번째 값은 rdi 에 넣는다”는 호출 규약을 봤는데, 사실 int 는 정수용 저장 칸으로, double 은 실수용 저장 칸(xmm0)으로 넘어갑니다. main.o 는 5를 정수 칸에 넣었고, 새 factorial 은 실수 칸을 읽었습니다. 거기엔 5가 아니라 엉뚱한 값이 있었고, 그 값으로 계산한 결과가 1이었습니다. 6.3절에서 말한 “약속이 어긋난 프로그램”이 이렇게 만들어집니다.
의존성을 제대로 적은 Makefile 로 빌드하면 main.c 가 다시 컴파일되어 바로 고쳐집니다(이 Makefile 은 7.6절에서 만듭니다).
$ make -f Makefile.auto
gcc -Wall -Wextra -std=c11 -g -c main.c -o main.o
gcc -Wall -Wextra -std=c11 -g main.o mymath.o strutil.o -o demo
$ ./demo | grep factorial
  factorial(5)   = 120
교훈: Makefile 의 의존성이 틀리면 컴파일러의 모든 검사를 우회하는 버그가 생깁니다. 이상한 버그가 나오면 make clean 으로 전부 지우고 처음부터 다시 빌드해 보는 것이 좋은 첫 번째 점검입니다. 그래도 같은 문제가 나오면 코드의 문제이고, 사라지면 의존성의 문제입니다.
이 실험은 원래대로 돌려 두세요.
mymath.h와mymath.c의double을int로 되돌리고make clean && make를 하면 됩니다.
7.6 변수와 자동 변수로 줄이기
modular/Makefile 의 .o 규칙 세 개는 모양이 거의 같습니다. 파일이 100개면 규칙도 100개를 써야 할까요? make 에는 반복을 줄이는 도구가 있습니다. 이 도구들로 다시 쓴 Makefile.auto 를 봅시다.
CC      = gcc
CFLAGS  = -Wall -Wextra -std=c11 -g
TARGET  = demo
OBJS    = main.o mymath.o strutil.o

$(TARGET): $(OBJS)
    $(CC) $(CFLAGS) $^ -o $@

%.o: %.c
    $(CC) $(CFLAGS) -c $< -o $@

main.o: mymath.h strutil.h
mymath.o: mymath.h
strutil.o: strutil.h

.PHONY: clean
clean:
    rm -f $(TARGET) $(OBJS)
새로 나온 기호들을 하나씩 봅시다.
자동 변수: $@, $<, $^
명령 안에서 규칙의 타깃과 재료를 가리키는 특별한 변수입니다. make 가 규칙마다 알아서 값을 채워 줍니다.
| 자동 변수 | 뜻 | 외우는 법 | demo: main.o mymath.o strutil.o 에서 |
|---|---|---|---|
$@ |
타깃 | 과녁(@)을 겨눈다 | demo |
$< |
첫 번째 재료 | 왼쪽(<) 맨 앞 | main.o |
$^ |
모든 재료 | 위로 쭉(^) 전부 | main.o mymath.o strutil.o |
그래서 첫 규칙의 명령 $(CC) $(CFLAGS) $^ -o $@ 는 gcc ... main.o mymath.o strutil.o -o demo 가 됩니다. 파일 이름을 두 번 쓰지 않아도 됩니다.
패턴 규칙: %.o: %.c
%.o: %.c
    $(CC) $(CFLAGS) -c $< -o $@
% 는 “아무 이름”을 뜻하는 자리표시입니다. 이 규칙은 “무엇.o 는 같은 이름의 무엇.c 로 만든다” 는 뜻입니다. mymath.o 가 필요하면 % 가 mymath 가 되어 mymath.c 를 재료로 삼고, 명령은 gcc ... -c mymath.c -o mymath.o 가 됩니다. 이 한 규칙이 .o 규칙 세 개를 대신합니다. 파일이 100개여도 이 규칙 하나면 됩니다.
명령 없는 규칙으로 헤더 의존성 더하기
main.o: mymath.h strutil.h
mymath.o: mymath.h
strutil.o: strutil.h
명령이 없는 규칙은 “재료를 추가하기만 하라” 는 뜻입니다. 패턴 규칙이 준 재료(main.c)에 헤더들이 더해집니다. 7.5절의 버그를 막는 부분이 바로 이 세 줄입니다.
실행해 봅시다.
$ make -f Makefile.auto clean
rm -f demo main.o mymath.o strutil.o
$ make -f Makefile.auto
gcc -Wall -Wextra -std=c11 -g -c main.c -o main.o
gcc -Wall -Wextra -std=c11 -g -c mymath.c -o mymath.o
gcc -Wall -Wextra -std=c11 -g -c strutil.c -o strutil.o
gcc -Wall -Wextra -std=c11 -g main.o mymath.o strutil.o -o demo
$ touch strutil.h
$ make -f Makefile.auto
gcc -Wall -Wextra -std=c11 -g -c main.c -o main.o
gcc -Wall -Wextra -std=c11 -g -c strutil.c -o strutil.o
gcc -Wall -Wextra -std=c11 -g main.o mymath.o strutil.o -o demo
자동 변수들이 실제 파일 이름으로 바뀐 것과, strutil.h 를 건드렸을 때 7.4절과 똑같이 필요한 파일만 다시 컴파일되는 것이 보입니다. 규칙은 짧아졌지만 똑똑함은 그대로입니다.
명령줄에서 변수 바꾸기
make 를 부를 때 변수를 덮어쓸 수 있습니다.
$ make -f Makefile.auto clean
$ make -f Makefile.auto CFLAGS="-Wall -O2"
gcc -Wall -O2 -c main.c -o main.o
gcc -Wall -O2 -c mymath.c -o mymath.o
...
Makefile 을 고치지 않고도 이번 빌드만 최적화 옵션(1주차 5절의 -O2)으로 할 수 있습니다. CFLAGS 라는 관례적인 이름을 쓰는 이유가 이것입니다. 다른 사람도 CFLAGS 를 바꾸면 컴파일 옵션이 바뀔 거라고 기대합니다.
사실 make 는 이미 알고 있다:
make에는%.o: %.c같은 규칙이 처음부터 내장되어 있습니다.make -p -f /dev/null로 내장 규칙을 보면%.o: %.c와 그 명령$(COMPILE.c) $(OUTPUT_OPTION) $<이 들어 있습니다. 그래서.o규칙을 아예 안 써도 동작합니다. 하지만 이 강좌에서는 무슨 일이 일어나는지 보이도록 직접 씁니다.
7.7 .PHONY 는 왜 필요할까
clean 은 파일이 아니라 작업 이름이라고 했습니다. 그런데 정말로 clean 이라는 이름의 파일이 폴더에 있으면 어떻게 될까요? .PHONY 없이 clean 규칙만 있는 Makefile 로 실험해 봅시다.
clean:
    rm -f *.o demo
$ touch clean
$ make -f Makefile.nophony
make: 'clean'은(는) 이미 업데이트되었습니다.
$ ls *.o
main.o  mymath.o  ...
.o 파일이 그대로 있습니다! make 는 규칙대로 판단했습니다. “타깃 clean 이라는 파일이 있다. 재료는 없다. 그러니 이미 최신이다.” 7.1절의 판단 규칙에 따르면 당연한 결과입니다.
.PHONY: clean 을 넣으면 “clean 은 파일 이름이 아니다”라고 알려 주는 것이라, 같은 이름의 파일이 있어도 항상 명령을 실행합니다.
$ touch clean
$ make -f Makefile.phony
rm -f *.o demo
clean, all, run, help 처럼 파일을 만들지 않는 작업 이름은 모두 .PHONY 에 적어 두세요. 이 주차의 최상위 Makefile 도 .PHONY: all clean examples projects help run-examples modular 로 시작합니다.
7.8 탭 대신 공백을 쓰면
7.1절에서 명령 줄은 탭으로 시작해야 한다고 했습니다. 공백 4칸으로 쓰면 이렇게 됩니다.
demo: main.o
    gcc main.o -o demo
$ make -f Makefile.spaces
Makefile.spaces:2: *** 분리 기호가 빠졌음.  멈춤.
영어로는 *** missing separator. Stop. 입니다. 메시지만 보면 무슨 말인지 알기 어렵지만, Makefile 에서 이 메시지가 나오면 99% 탭 문제입니다. 2번째 줄이라고 알려 주니 그 줄의 들여쓰기를 지우고 Tab 키로 다시 넣으세요. 에디터에서 탭과 공백을 구분해서 보고 싶으면, 1주차 2절의 cat 에 -A 옵션을 주세요. 탭이 ^I 로 보입니다.
$ cat -A Makefile | head -3
7.9 알아 두면 편한 make 사용법
| 명령 | 뜻 |
|---|---|
make |
첫 번째 규칙의 타깃을 만든다 |
make 타깃 |
그 타깃만 만든다. 예: make mymath.o |
make clean |
clean 규칙을 실행한다 |
make -n |
실제로 실행하지 않고 무엇을 실행할지만 보여 준다 (dry run) |
make -s |
명령을 화면에 보여 주지 않고 조용히 실행한다 |
make -f 파일 |
Makefile 대신 다른 파일을 읽는다 |
make -C 폴더 |
그 폴더로 가서 make 한다 |
make 변수=값 |
Makefile 의 변수를 이번만 덮어쓴다 |
make -n 은 특히 유용합니다. main.c 를 touch 한 뒤 -n 으로 물어보면, 실행하지 않고 계획만 보여 줍니다.
$ touch main.c
$ make -n
gcc -Wall -Wextra -std=c11 -c main.c
gcc -Wall -Wextra -std=c11 -o demo main.o mymath.o strutil.o
“이렇게 할 예정”이라는 목록입니다. Makefile 을 새로 썼을 때 의존성이 맞는지 확인하는 데 좋습니다. 특정 타깃만 만들 수도 있습니다.
$ make clean
rm -f demo main.o mymath.o strutil.o
$ make mymath.o
gcc -Wall -Wextra -std=c11 -c mymath.c
mymath.o 하나만 만들어졌습니다.
7.10 의존성을 컴파일러에게 맡기기: -MMD
7.5절의 버그를 막으려면 #include 를 바꿀 때마다 Makefile 의 헤더 목록도 고쳐야 합니다. 이것도 사람이 하면 실수합니다. 그래서 실무에서는 컴파일러에게 의존성 목록을 만들게 합니다. 어떤 헤더를 포함하는지는 전처리기가 제일 잘 아니까요.
$ gcc -MMD -c main.c
$ cat main.d
main.o: main.c mymath.h strutil.h
-MMD 를 주면 컴파일하면서 main.d 라는 파일에 Makefile 규칙 형식으로 의존성을 적어 줍니다. 7.2절에서 우리가 손으로 쓴 main.o: main.c mymath.h strutil.h 와 똑같습니다(시스템 헤더 stdio.h 는 바뀔 일이 없으니 빼 줍니다). Makefile 끝에 -include $(OBJS:.o=.d) 한 줄을 넣으면 이 .d 파일들을 읽어 들여 의존성을 자동으로 관리할 수 있습니다. 지금은 “이런 방법이 있다” 정도로 알아 두세요. 파일이 많아지는 뒤 주차의 프로젝트에서 요긴하게 쓰입니다.
7.11 이 주차의 최상위 Makefile
이번 주 처음에 week05 폴더에서 친 make 도 Makefile 로 동작합니다. week05/Makefile 은 조금 길지만, 이제 대부분 읽을 수 있습니다. 핵심 부분만 봅시다.
EXAMPLE_SRCS = $(wildcard $(EXAMPLE_DIR)/*.c)
EXAMPLE_BINS = $(patsubst $(EXAMPLE_DIR)/%.c,$(BUILD_DIR)/examples/%,$(EXAMPLE_SRCS))

$(BUILD_DIR)/examples/%: $(EXAMPLE_DIR)/%.c | $(BUILD_DIR)/examples
    $(CC) $(CFLAGS) $(DEBUG_FLAGS) -o $@ $<
$(wildcard examples/*.c):examples폴더의.c파일 목록을 자동으로 만듭니다. 새 예제 파일을 추가해도 Makefile 을 고칠 필요가 없습니다.$(patsubst 패턴,바꿀모양,목록): 목록의 이름을 패턴에 맞춰 바꿉니다.examples/function_basic.c를build/examples/function_basic으로 바꿔서 “만들어야 할 실행 파일 목록”을 얻습니다.build/examples/%: examples/%.c: 7.6절의 패턴 규칙입니다. 실행 파일 하나를 같은 이름의.c하나로 만듭니다.| $(BUILD_DIR)/examples:|뒤의 재료는 “있기만 하면 되고, 시각은 비교하지 마라”는 뜻입니다. 폴더는 안에 파일이 생길 때마다 시각이 바뀌어서, 일반 재료로 쓰면 쓸데없이 다시 빌드하게 되기 때문입니다.
그 밖에 이런 편의 규칙들이 있습니다.
$ make help
╔════════════════════════════════════════════════════════════╗
║     5주차: 함수와 모듈화 - Makefile 사용법                 ║
╚════════════════════════════════════════════════════════════╝

사용 가능한 명령어:
  make              - 모든 예제와 프로젝트 컴파일
  make examples     - 예제만 컴파일
  make projects     - 프로젝트만 컴파일
  ...
$ make run-example-function_basic
실행: build/examples/function_basic
╔════════════════════════════════════════╗
║          함수 기초 예제                ║
...
run-example-% 는 % 자리에 예제 이름을 넣으면 그 예제를 빌드하고 실행하는 패턴 규칙입니다. 명령 앞의 @ 는 “이 명령은 화면에 보여 주지 말고 실행만 하라”는 뜻이라, echo 로 찍는 안내문이 두 번 나오지 않습니다.
8. 실습 프로젝트
projects/ 폴더에는 함수로 잘게 나눈 프로그램 네 개가 있습니다. 네 프로젝트 모두 한 파일짜리지만, main 은 짧고 일은 함수들이 나눠서 하는 구조를 눈여겨보세요. 각 프로젝트를 읽을 때는 먼저 main 만 읽고 “무슨 프로그램인지” 파악한 다음, 궁금한 함수로 내려가 보세요. 함수 이름이 잘 지어져 있으면 main 만 읽어도 프로그램의 흐름이 보입니다.
8.1 calculator.c – 모듈화된 계산기
덧셈, 뺄셈, 곱셈, 나눗셈을 각각 함수로 분리한 메뉴형 계산기입니다. main 의 뼈대만 보면 이렇습니다.
    print_banner();

    while (1) {
        print_menu();

        /* 메뉴 입력 검증: 정수가 아니거나 EOF면 안전하게 종료 */
        if (scanf("%d", &choice) != 1) {
            printf("\n입력이 올바르지 않거나 종료되었습니다. 프로그램을 종료합니다.\n");
            break;
        }
        ...
        /* 피연산자 입력 및 검증 */
        if (!read_two_numbers(&a, &b)) {
            ...
            break;
        }

        /* 선택한 연산을 해당 함수로 위임 */
        switch (choice) {
            case 1:
                result = add(a, b);
                printf("결과: %.4f + %.4f = %.4f\n", a, b, result);
                break;
            ...
            case 4:
                result = divide(a, b, &ok);
                if (!ok) {
                    printf("오류: 0으로 나눌 수 없습니다.\n");
                } else {
                    printf("결과: %.4f / %.4f = %.4f\n", a, b, result);
                }
                break;
        }
    }
실행해서 3 + 4 를 하고, 4 ÷ 0 을 시도하고, 없는 메뉴 9를 누르고, 0으로 끝내 봅시다.
$ ./build/projects/calculator
╔════════════════════════════════════════╗
║        모듈화된 계산기                 ║
╚════════════════════════════════════════╝


===== 메뉴 =====
1. 덧셈 (+)
2. 뺄셈 (-)
3. 곱셈 (*)
4. 나눗셈 (/)
0. 종료
선택: 1
첫 번째 숫자 입력: 3
두 번째 숫자 입력: 4
결과: 3.0000 + 4.0000 = 7.0000

===== 메뉴 =====
...
선택: 4
첫 번째 숫자 입력: 10
두 번째 숫자 입력: 0
오류: 0으로 나눌 수 없습니다.

===== 메뉴 =====
...
선택: 9
잘못된 메뉴 선택입니다. 다시 입력해 주세요.

===== 메뉴 =====
...
선택: 0

계산기를 종료합니다. 감사합니다.
숫자 대신 글자를 넣으면 어떻게 될까요?
선택: abc

입력이 올바르지 않거나 종료되었습니다. 프로그램을 종료합니다.
코드 읽기 포인트
print_banner,print_menu: 출력만 하는void함수(1.3절)로 화면 그리는 코드를main밖으로 뺐습니다. 그래서main의 반복문이 한눈에 들어옵니다.scanf(...) != 1: 2주차에서 배운 대로scanf는 읽는 데 성공한 값의 개수를 돌려줍니다. 1이 아니면 숫자가 아닌 입력이거나 입력이 끝난 것(EOF,Ctrl + D)입니다. 이때 멈추지 않고 계속 반복하면, 읽지 못한abc가 입력에 그대로 남아서 무한 반복에 빠집니다. 그래서break로 빠져나옵니다. 함수의 반환값을 확인하는 습관이 프로그램을 지킨다는 좋은 예입니다.read_two_numbers(&a, &b)와divide(a, b, &ok): 2.2절 끝에서 말한&입니다.read_two_numbers는 “숫자 두 개”와 “성공했는지”를 세 가지 알려 줘야 하는데return은 하나뿐이라, 숫자는a,b의 주소를 받아 직접 써 넣고 성공 여부만return합니다.divide도 같은 방식입니다. 6주차에 포인터를 배우면 이 코드를 완전히 이해할 수 있습니다.switch로 함수에 일을 맡김: 각case는 계산을 직접 하지 않고add,sub같은 함수를 부릅니다. 나중에 “거듭제곱” 메뉴를 추가하려면 함수 하나와case하나만 추가하면 됩니다.
직접 해 보기: 5번 메뉴 “나머지(%)”를 추가해 보세요. 실수의 나머지는 % 연산자로 구할 수 없으니, 두 수를 int 로 바꿔서 계산하는 int mod(int a, int b) 함수를 만들고, 0으로 나누는 경우도 막아 보세요. printf 로 % 를 출력하려면 %% 로 써야 한다는 것(1주차 6절)도 잊지 마세요.
8.2 math_utils.c – 수학 라이브러리
거듭제곱, 최대공약수, 최소공배수, 소수 판별, 팩토리얼, 절댓값을 각각 함수로 만들어 모은 “라이브러리 스타일” 프로그램입니다.
$ ./build/projects/math_utils
╔════════════════════════════════════════╗
║        수학 유틸리티 라이브러리        ║
╚════════════════════════════════════════╝

[ 거듭제곱 ]
  2^10 = 1024
  3^4  = 81
  1.5^3 = 3.3750

[ 최대공약수 / 최소공배수 ]
  gcd(48, 36) = 12
  lcm(48, 36) = 144
  gcd(17, 5)  = 1
  lcm(4, 6)   = 12

[ 소수 판별 (1 ~ 20) ]
  소수: 2 3 5 7 11 13 17 19
  97은 소수인가? 예
  100은 소수인가? 아니오

[ 팩토리얼 ]
   1! = 1
   ...
  10! = 3628800

[ 절댓값 ]
  abs(-42)   = 42
  abs(-3.14) = 3.14
이 프로젝트에서 눈여겨볼 함수 세 개를 봅시다.
재귀 최대공약수:
long long gcd(long long a, long long b)
{
    a = abs_ll(a);
    b = abs_ll(b);

    if (b == 0) {
        return a;
    }
    return gcd(b, a % b);
}
6.2절 mymath.c 의 gcd 는 while 반복문이었는데, 이쪽은 재귀입니다. 유클리드 호제법의 정의(“a와 b의 최대공약수는 b와 a%b의 최대공약수와 같다, b가 0이면 a”)를 그대로 옮겼습니다. 같은 일을 하는 두 버전을 비교해 보세요. 5.6절에서 말한 대로 어느 쪽이 옳은 게 아니라, 이 경우는 재귀 버전이 수학 정의와 더 닮았을 뿐입니다. 재귀 깊이도 매번 수가 빠르게 작아져서 걱정할 필요가 없습니다.
함수가 함수를 부르는 최소공배수:
long long lcm(long long a, long long b)
{
    if (a == 0 || b == 0) {
        return 0;
    }
    return abs_ll(a / gcd(a, b) * b);
}
최소공배수 = a × b ÷ 최대공약수 라는 공식을 쓰는데, 이미 만든 gcd 를 재사용했습니다. a * b / gcd 가 아니라 a / gcd * b 순서로 계산한 것은 오버플로를 피하려는 것입니다. a × b 를 먼저 하면 큰 수끼리 곱해서 5.2절처럼 넘칠 수 있지만, 먼저 나누면 수가 작아진 뒤에 곱합니다. 수학적으로는 같은 식이지만, 컴퓨터에서는 계산 순서가 결과를 바꿀 수 있습니다.
6k±1 소수 판별:
int is_prime(long long n)
{
    long long i;

    if (n < 2) {
        return 0;
    }
    if (n < 4) {
        return 1;   /* 2, 3 */
    }
    if (n % 2 == 0 || n % 3 == 0) {
        return 0;
    }
    for (i = 5; i * i <= n; i += 6) {
        if (n % i == 0 || n % (i + 2) == 0) {
            return 0;
        }
    }
    return 1;
}
mymath.c 의 is_prime 은 2, 3, 4, 5, … 를 전부 나눠 봤는데, 이쪽은 5, 7, 11, 13, 17, 19, … 처럼 6의 배수 ±1 만 나눠 봅니다. 2와 3의 배수를 먼저 걸러 내고 나면, 남은 소수 후보는 반드시 6k−1 이나 6k+1 모양이기 때문입니다(6k, 6k+2, 6k+4 는 짝수이고 6k+3 은 3의 배수). 나눠 보는 횟수가 약 3분의 1로 줄어듭니다. 함수의 겉모양(이름, 매개변수, 반환값)이 같으면 안의 구현은 얼마든지 더 좋게 바꿀 수 있다는 것이 함수의 또 다른 장점입니다. 부르는 쪽은 아무것도 고칠 필요가 없습니다.
직접 해 보기: 이 파일을 6절처럼 mathutils.h, mathutils.c, main.c 세 파일로 나누고, 7.6절 같은 Makefile 을 써서 빌드해 보세요. print_banner 는 main.c 에만 필요하니 어디에 둘지도 생각해 보세요.
8.3 maze_solver.c – 재귀 미로 탐색
8×8 미로에서 왼쪽 위 (0, 0) 에서 오른쪽 아래 (7, 7) 까지 가는 길을 재귀로 찾는 프로그램입니다. 미로는 4주차에 배운 2차원 배열로 표현합니다.
#define SIZE 8

/* 0 = 통로, 1 = 벽 */
int maze[SIZE][SIZE] = {
    {0, 1, 0, 0, 0, 1, 0, 0},
    {0, 1, 0, 1, 0, 1, 0, 1},
    {0, 0, 0, 1, 0, 0, 0, 0},
    {1, 1, 1, 1, 1, 1, 0, 1},
    {0, 0, 0, 0, 0, 0, 0, 0},
    {0, 1, 1, 1, 1, 1, 1, 0},
    {0, 0, 0, 0, 0, 0, 1, 0},
    {1, 1, 1, 1, 1, 0, 0, 0}
};

/* 경로 표시용 배열: 1이면 해답 경로에 포함된 칸 */
int path[SIZE][SIZE];

재귀로 미로 풀기
maze 와 path 는 전역 변수입니다. 4.2절에서 전역 변수는 조심하라고 했지만, 여기서는 재귀 함수가 몇 단계 깊이에 있든 같은 미로와 같은 경로 기록을 봐야 하기 때문에 전역으로 두었습니다. 배열을 매개변수로 넘기는 방법(2.3절)도 있지만, 2차원 배열을 넘기는 문법은 7주차에 배웁니다. path 는 초기화하지 않았지만 전역 변수라서 전부 0으로 시작합니다(4.2절).
핵심은 solve 함수입니다.
int solve(int row, int col)
{
    /* 도착점 도달 */
    if (row == SIZE - 1 && col == SIZE - 1 && maze[row][col] == 0) {
        path[row][col] = 1;
        return 1;
    }

    /* 이동 가능하고 아직 방문하지 않은 칸인지 확인 */
    if (is_safe(row, col) && path[row][col] == 0) {
        /* 현재 칸을 경로에 포함 */
        path[row][col] = 1;

        /* 아래 -> 오른쪽 -> 위 -> 왼쪽 순으로 탐색 */
        if (solve(row + 1, col)) {
            return 1;
        }
        if (solve(row, col + 1)) {
            return 1;
        }
        if (solve(row - 1, col)) {
            return 1;
        }
        if (solve(row, col - 1)) {
            return 1;
        }

        /* 어느 방향으로도 갈 수 없으면 되돌리기(백트래킹) */
        path[row][col] = 0;
        return 0;
    }

    return 0;
}
5.1절의 재귀 두 부분으로 읽어 봅시다.
- 종료 조건: 도착점에 왔으면 1(성공). 벽이거나 미로 밖이거나 이미 지나온 칸이면 0(실패). 이 칸에서는 더 볼 것이 없습니다.
- 재귀 단계: “이 칸에서 도착점까지 가는 길이 있나?”라는 문제를 “이웃 칸에서 도착점까지 가는 길이 있나?”라는 같은 모양의 작은 문제로 바꿉니다. 아래, 오른쪽, 위, 왼쪽 순서로 물어보고, 하나라도 “있다(1)”고 하면 나도 “있다”고 답합니다.
마지막 두 줄이 이 알고리즘의 이름이 된 부분입니다. 네 방향 모두 막혔으면 이 칸을 경로에서 지우고(path = 0) 실패를 돌려줍니다. 그러면 이 칸으로 들어왔던 한 단계 앞의 호출이 다음 방향을 시도합니다. 막다른 길에서 한 걸음 되돌아가서(back) 다른 길을 찾는(track) 이 방법을 백트래킹(backtracking) 이라고 합니다. 실제 미로에서 벽에 손을 짚고 가다 막히면 돌아 나오는 것과 같습니다. 되돌아가는 과정을 따로 코드로 쓰지 않아도 재귀 호출이 끝나고 돌아오는 것 자체가 되돌아가기라는 점이 재귀의 우아한 부분입니다.
path[row][col] == 0 확인도 중요합니다. 이미 지나온 칸을 다시 가지 않게 하는 조건인데, 이것이 없으면 두 칸 사이를 영원히 왔다 갔다 하다가 5.5절의 스택 오버플로로 죽습니다.
$ ./build/projects/maze_solver
╔════════════════════════════════════════╗
║        재귀 미로 탐색기                ║
╚════════════════════════════════════════╝

범례: # 벽, . 통로, * 경로
시작: (0, 0)  도착: (7, 7)

경로를 찾았습니다!

* # * * * # . .
* # * # * # . #
* * * # * * * .
# # # # # # * #
. . . . . . * *
. # # # # # # *
. . . . . . # *
# # # # # . . *
* 를 따라가 보세요. (0, 0) 에서 아래로 내려가다가 오른쪽, 위, 오른쪽… 구불구불하게 도착점에 닿습니다. 이것이 가장 짧은 길은 아닙니다. 탐색 순서(아래 → 오른쪽 → 위 → 왼쪽)대로 가다가 처음 찾은 길일 뿐입니다. 가장 짧은 길을 찾는 방법은 14주차 그래프 탐색에서 배웁니다.
실험: 길을 막으면?
3번째 줄(행 3) {1, 1, 1, 1, 1, 1, 0, 1} 을 보면, 위쪽 절반과 아래쪽 절반을 잇는 통로가 (3, 6) 한 칸뿐입니다. 여기를 벽으로 막아 봅시다. {1, 1, 1, 1, 1, 1, 1, 1} 로 바꾸고 다시 컴파일합니다.
$ ./maze_solver
...
경로 없음: 시작점에서 도착점까지 갈 수 없습니다.
solve 는 위쪽 절반의 모든 칸을 다 돌아본 뒤 전부 실패를 돌려받고, 결국 solve(0, 0) 이 0을 돌려줍니다. 탐색 순서를 바꿔 보는 실험도 해 보세요. solve 안의 네 if 의 순서를 오른쪽 → 아래 → 왼쪽 → 위로 바꾸면 다른 길을 찾습니다.
8.4 temperature_stats.c – 온도 통계
한 주 동안의 기온 7개로 평균, 최고, 최저, 표준편차를 구하고 섭씨·화씨를 바꾸는 리포트입니다. main 은 이렇게 짧습니다.
int main(void)
{
    /* 한 주간의 온도 데이터(섭씨) */
    double temperatures[] = {
        21.5, 23.0, 19.8, 25.2, 22.1, 18.5, 24.7
    };
    int n = (int)(sizeof(temperatures) / sizeof(temperatures[0]));

    print_banner();
    print_report(temperatures, n);

    return 0;
}

기온 통계
$ ./build/projects/temperature_stats
╔════════════════════════════════════════╗
║        온도 통계 리포트                ║
╚════════════════════════════════════════╝

[ 측정 데이터 (섭씨) ]
  21.5 23.0 19.8 25.2 22.1 18.5 24.7

[ 통계 요약 ]
  데이터 개수 : 7
  평균       : 22.11 도
  최고 기온   : 25.20 도
  최저 기온   : 18.50 도
  표준편차    : 2.26

[ 평균 온도 단위 변환 ]
  섭씨 22.11 도 = 화씨 71.81 도
  (참고) 화씨 100.0 도 = 섭씨 37.78 도
main 은 데이터를 준비하고 두 함수를 부를 뿐입니다. 실제 일은 작은 함수들이 층을 이루어 나눠 합니다.
main
 ├── print_banner
 └── print_report
      ├── mean
      ├── max_value
      ├── min_value
      ├── std_dev
      │    ├── mean          ← 표준편차는 평균이 필요하다
      │    └── my_sqrt       ← 그리고 제곱근이 필요하다
      ├── celsius_to_fahrenheit
      └── fahrenheit_to_celsius
함수가 함수를 부르는 구조가 한눈에 보입니다. std_dev 는 이미 만든 mean 을 다시 씁니다. 1.1절의 “재사용”과 “분업”이 이런 모습입니다.
코드 읽기 포인트
- 배열 + 개수를 짝으로 넘기기:
mean(const double data[], int n)처럼 모든 통계 함수가 2.3절의 규칙을 따릅니다. 배열과 개수를 같이 받고, 읽기만 하니const를 붙였습니다. sizeof로 개수 구하기는main에서만:n을main에서 구해 넘깁니다. 2.3절의 실험대로 함수 안에서는 구할 수 없기 때문입니다. 기온 데이터를 하나 추가해도n은 저절로 8이 됩니다.
직접 만든 제곱근 my_sqrt:
/*
 * 제곱근을 뉴턴법(뉴턴-랩슨)으로 직접 구현한다.
 * math.h / -lm 의존을 피하기 위함.
 */
double my_sqrt(double x)
{
    double guess;
    int i;

    if (x <= 0.0) {
        return 0.0;
    }

    guess = x;   /* 초기 추정값 */
    for (i = 0; i < 50; i++) {
        guess = 0.5 * (guess + x / guess);
    }
    return guess;
}
C에는 제곱근 함수 sqrt 가 표준 라이브러리 math.h 에 있습니다. 그런데 수학 함수들은 libc.so.6 이 아니라 libm(수학 라이브러리)이라는 별도 파일에 있어서, 링크할 때 -lm 옵션을 붙여야 합니다. 붙이지 않으면 6.5절에서 본 링크 오류가 납니다. sqrt 를 쓰는 작은 파일 sq.c 로 확인해 봅시다.
#include <stdio.h>
#include <math.h>

double root(double x) {
    return sqrt(x);
}

int main(void) {
    printf("%f %f\n", sqrt(2.0), root(5.0));
    return 0;
}
$ gcc -Wall -std=c11 sq.c -o sq
/usr/bin/ld: /tmp/ccVnoRzf.o: in function `root':
sq.c:(.text+0x1b): undefined reference to `sqrt'
collect2: error: ld returned 1 exit status
$ gcc -Wall -std=c11 sq.c -o sq -lm
$
math.h 를 포함했으니 컴파일은 됐지만(선언은 있으니까), sqrt 의 정의가 든 libm 을 링크에 넣지 않아서 실패한 것입니다. -lm 은 “libm 이라는 라이브러리를 링크에 넣어라”는 뜻입니다(-l 뒤에 lib 를 뺀 이름). 이 프로젝트는 그 번거로움을 피하려고 제곱근을 직접 만들었습니다.
방법은 뉴턴법입니다. √x 를 모를 때, 아무 추측값 guess 에서 시작해서 “추측값과 x/추측값의 평균”으로 계속 고쳐 나가면 답에 빠르게 다가갑니다. √2 를 예로 들면 2 → 1.5 → 1.4167 → 1.41422 → … 로, 몇 번 만에 소수점 아래 여러 자리가 맞습니다. 50번은 충분하고도 남는 횟수입니다. my_sqrt 가 내부에서 어떤 방법을 쓰는지 std_dev 는 모릅니다. 나중에 math.h 의 sqrt 로 바꾸더라도 my_sqrt 안만 고치면 됩니다. 8.2절의 소수 판별처럼, 겉모양이 같으면 속은 자유롭게 바꿀 수 있습니다.
표준편차 계산:
double std_dev(const double data[], int n)
{
    double m = mean(data, n);
    double sum_sq = 0.0;
    double diff;
    int i;

    for (i = 0; i < n; i++) {
        diff = data[i] - m;
        sum_sq += diff * diff;
    }
    return my_sqrt(sum_sq / n);
}
표준편차는 “데이터가 평균에서 평균적으로 얼마나 떨어져 있는지”입니다. 각 값에서 평균을 뺀 차이를 제곱해서 더하고, 개수로 나눈 뒤(분산), 제곱근을 씌웁니다. 이 기온들은 평균 22.11도에서 대략 ±2.26도 안쪽에 흩어져 있다는 뜻입니다. 주석의 “모표준편차”는 개수 n 으로 나눈다는 뜻입니다(통계에서 표본으로 전체를 추정할 때는 n - 1 로 나누기도 합니다).
직접 해 보기
#include <math.h>를 추가하고my_sqrt를sqrt로 바꿔 보세요.-lm없이 컴파일하면 어떻게 되는지,-lm을 붙이면 어떻게 되는지 확인해 보세요. 재미있는 점이 하나 있습니다.sqrt(2.0)처럼 상수를 넣으면 GCC가 컴파일할 때 답을 미리 계산해 버려서-lm없이도 링크가 되는 경우가 있습니다. 변수를 넣었을 때와 비교해 보세요.- 기온이 평균보다 높은 날이 며칠인지 세는
int count_above(const double data[], int n, double threshold)함수를 만들고 리포트에 추가해 보세요. - 이 프로그램을
stats.h/stats.c(통계 함수),temp.h/temp.c(단위 변환),main.c로 나누고 Makefile 을 써 보세요.my_sqrt는stats.c안에서만 쓰이니static으로 숨기는 게 좋을까요?
9. 정리
이번 주에 배운 것을 돌아봅시다.
함수
- 함수는 작업 하나를 이름으로 묶은 것이다. 재사용, 가독성, 유지보수, 분업을 위해 쓴다.
- 함수의 첫 줄은 반환형, 이름, 매개변수로 이루어진다. 매개변수는 만들 때의 빈 그릇, 인자는 부를 때의 내용물이다.
- 함수 호출은 그 자리가 반환값으로 바뀌는 식이다.
return은 값을 돌려주면서 함수를 끝낸다. - 값을 돌려주지 않는 함수는 반환형이
void이고, 받는 것이 없는 함수는 괄호 안에void를 쓴다.()는 C11 에서 “정보 없음”이라 인자 검사를 못 한다.
인자 전달
- C의 인자 전달은 전부 복사(call by value) 다.
a와x의 주소가 다른 것으로 확인했다. - 그래서 함수로 원본을 바꾸는
swap은 지금 방법으로는 불가능하다 → 6주차 포인터. - 배열은 시작 주소가 넘어간다. 그래서 크기를 따로 넘겨야 하고, 함수가 원본을 바꿀 수 있다. 바꾸지 않을 거라면
const.
선언과 정의
- 컴파일러는 위에서 아래로 한 번 읽는다. 부르기 전에 선언(프로토타입) 이 있어야 한다.
- 선언은 여러 번 해도 되지만, 정의는 프로그램 전체에서 한 번이다.
- 선언 없이 부르면 컴파일러가
int를 돌려준다고 멋대로 짐작한다. GCC 14부터는 오류다.
범위와 수명
- 지역 변수는
{ }안에서만 보이고, 블록이 끝나면 사라지고, 초기화하지 않으면 쓰레기 값이다. - 전역 변수는 어디서나 보이고, 프로그램 끝까지 살고, 0으로 시작한다. 꼭 필요할 때만 쓴다.
static은 함수 안에서는 “오래 살아라”, 함수 밖에서는 “밖에 보이지 마라”.
재귀
- 재귀 함수에는 종료 조건과 작아지는 재귀 단계가 반드시 있어야 한다.
- 호출마다 스택에 프레임이 쌓인다(48바이트씩 내려가는 주소로 확인). 너무 깊으면 스택 오버플로로 죽는다(8MB 한도, 약 52만 번).
- 같은 계산을 반복하는 재귀(피보나치)는 느리다. 구조 자체가 재귀인 문제(하노이, 미로)에서 빛난다.
모듈화와 빌드
- 모듈 = 헤더(
.h, 메뉴판: 선언) + 구현(.c, 주방: 정의). 구현 파일은 자기 헤더를 포함해서 어긋남을 잡는다. - 헤더에는 include 가드. 막는 것은 중복 선언이 아니라 중복 정의다.
#include는 선언을 줄 뿐이다. 정의가 든.c를 빼먹으면undefined reference, 같은 정의가 둘이면multiple definition.make는 수정 시각과 적어 준 의존 관계만 보고 필요한 것만 다시 만든다. 의존 관계가 틀리면 조용한 버그가 생긴다.- Makefile 의 명령 줄은 탭으로 시작한다.
$@는 타깃,$<는 첫 재료,$^는 모든 재료.
오류 메시지 모음
이번 주에 만난 오류와 경고를 1주차 10절의 표에 이어 정리합니다.
| 메시지 | 단계 | 뜻과 해결 |
|---|---|---|
implicit declaration of function ‘X’ |
컴파일 (경고) | X 를 선언 전에 불렀다. 프로토타입을 위에 두거나 헤더를 포함 |
conflicting types for ‘X’ |
컴파일 | X 의 선언과 정의가 다르다 |
too many / too few arguments to function ‘X’ |
컴파일 | 인자 개수가 선언과 다르다 |
void value not ignored as it ought to be |
컴파일 | void 함수의 값을 쓰려고 했다 |
‘X’ undeclared |
컴파일 | X 의 범위 밖에서 썼다 (다른 함수의 지역 변수 등) |
‘sizeof’ on array function parameter |
컴파일 (경고) | 함수 안에서 배열 매개변수의 sizeof 는 주소 크기(8) |
redefinition of ‘struct X’ |
컴파일 | 같은 정의가 두 번. 헤더에 include 가드 |
infinite recursion detected |
컴파일 (경고) | 종료 조건 없는 재귀 |
undefined reference to ‘X’ |
링크 | X 의 정의가 든 .c/.o 를 빼먹음 |
multiple definition of ‘X’ |
링크 | 같은 이름의 정의가 둘. 한쪽을 static 으로 하거나 이름을 바꿈 |
세그멘테이션 오류 (종료 코드 139) |
실행 | 이번 주에는 스택 오버플로. 재귀의 종료 조건 확인 |
*** 분리 기호가 빠졌음. 멈춤. |
make | Makefile 명령 줄을 탭 대신 공백으로 들여씀 |
'X'은(는) 이미 업데이트되었습니다. |
make | 할 일이 없다. 파일을 고쳤는데 이게 나오면 의존 관계를 의심 |
이번 주에 쓴 도구와 옵션
| 도구·옵션 | 하는 일 |
|---|---|
-Wconversion |
값이 바뀌는 자료형 변환을 경고 (1.2절) |
-Wshadow |
변수 가리기를 경고 (4.3절) |
-std=c2x |
C23 규칙으로 컴파일 (3.4절) |
-I폴더 |
헤더를 찾을 폴더 추가 (6.2절) |
-MMD |
의존성 목록 .d 파일 생성 (7.10절) |
nm |
오브젝트 파일의 이름표. T/t, U, b (4.5절, 6.5절) |
ulimit -s |
스택 크기 한도 확인 (5.5절) |
/usr/bin/time -f "%e초" |
실행 시간 측정 (5.3절) |
stat -c '%y %n' |
파일의 정확한 수정 시각 (7.4절) |
make -n, -s, -f, -C |
계획만 보기, 조용히, 다른 Makefile, 다른 폴더 (7.9절) |
10. 연습 문제
각 문제는 gcc -Wall -Wextra -std=c11 로 경고 0개가 되도록 작성하세요.
기본 문제
- 최소공배수: 두 정수의 최소공배수를 구하는
int lcm(int a, int b)를 작성하세요. 6.2절의gcd를 재사용하고, 8.2절에서 본 대로 오버플로가 덜 나는 계산 순서를 쓰세요. - swap 이 실패하는 이유:
main의x와try_swap의a의 주소를%p로 찍어서(2.1절의 실험처럼) 교환이 왜 원본에 반영되지 않는지 출력으로 보여 주세요. - 합 구하기 두 가지: 1부터 n까지의 합을 재귀 함수와 반복문 함수로 각각 작성하세요. n = 100000 으로 재귀 버전을 실행하면 어떻게 되나요? n = 1000000 이면요? 5.5절의 계산으로 결과를 설명해 보세요.
- 자릿수의 합: 자연수 n의 각 자리 숫자의 합을 재귀로 구하세요. (예: 1234 → 10) 힌트:
n % 10은 마지막 자리,n / 10은 마지막 자리를 뗀 나머지입니다. - 호출 횟수 기억하기:
static지역 변수로 자신이 몇 번 불렸는지 세어, 부를 때마다 “3번째 호출입니다”처럼 출력하는 함수를 만드세요. 같은 일을 전역 변수로도 해 보고, 어느 쪽이 더 안전한지 설명해 보세요.
모듈화 문제
- strutil 에 기능 추가:
modular/strutil.h,strutil.c에 문자열을 뒤집는void str_reverse(char *s)를 추가하고main.c에서 호출하세요. 헤더에 선언을,.c에 정의를 넣는 것을 잊지 마세요. - Makefile 검증: 6번을 한 뒤
touch strutil.h를 하고,make -n으로 무엇이 다시 컴파일될지 먼저 예상한 다음make로 확인하세요. 예상과 다르다면 Makefile 의 의존 관계를 고치세요. - 메모이제이션: 5.3절의 재귀 피보나치에
long memo[100]전역 배열을 더해서, 한 번 계산한 F(n) 을 기록해 두고 다시 쓰도록 고치세요. F(45) 의 실행 시간이 어떻게 바뀌는지/usr/bin/time으로 재 보세요. 이 배열은 다른 파일에서 건드리면 안 되니 어떻게 선언하는 게 좋을까요?
도전 문제
- 4주차 코드 모듈화: 4주차에 만든 버블 정렬을
void bubble_sort(int arr[], int size)함수로 만들고, 배열을 출력하는print_array함수와 함께sort.h/sort.c모듈로 분리하세요.main.c에서 점수 배열과 나이 배열을 각각 정렬해 보세요. 이번 주 “들어가며”의 질문에 대한 답입니다. - 하노이 탑 반복문 버전: 5.4절의 하노이 탑을 재귀 없이 반복문만으로 풀어 보세요. (힌트: 원반 n개일 때, 가장 작은 원반은 항상 같은 방향으로 한 칸씩 돈다는 규칙이 있습니다.) 재귀 버전과 코드 길이를 비교해 보세요.
다음 주 예고
6주차: 포인터 기초
이번 주 내내 “6주차에 배웁니다”라고 미뤄 둔 것들이 한꺼번에 풀립니다.
- 2.1절에서
&로 찍어 본 주소는 정확히 무엇이고, 그 주소를 담는 변수 포인터는 어떻게 쓰나? - 2.2절의
swap을 드디어 동작하게 만드는 방법, call by reference - 2.3절에서 배열 매개변수의
sizeof가 8이었던 이유. 배열 이름과 포인터는 무슨 관계인가? - 8.1절 계산기의
&a,int *ok는 무엇이었나? - 포인터를 잘못 쓰면 이번 주에 본 세그멘테이션 오류가 어떻게 생기는가?
체크리스트
각 항목을 설명할 수 있으면 체크하세요.
- [ ] 함수를 쓰는 이유 네 가지(재사용, 가독성, 유지보수, 분업)를 예로 설명할 수 있다
- [ ] 함수의 반환형, 이름, 매개변수, 본문,
return을 구분할 수 있다 - [ ] 매개변수와 인자의 차이를 안다
- [ ] 함수 호출이 반환값으로 바뀌는 식이라는 것을 알고, 호출을 중첩해 쓸 수 있다
- [ ]
void함수를 만들고,return;으로 일찍 끝낼 수 있다 - [ ] call by value 를 주소 출력으로 확인했고,
swap이 왜 실패하는지 설명할 수 있다 - [ ] 배열을 함수에 넘길 때 크기를 따로 넘기는 이유와
const의 역할을 안다 - [ ] 선언(프로토타입)과 정의의 차이를 알고, 프로토타입을 쓸 수 있다
- [ ]
()와(void)의 차이를 실험으로 확인했다 - [ ] 지역 변수, 전역 변수,
static지역 변수의 범위와 수명을 표로 정리할 수 있다 - [ ]
static함수가nm에서 소문자t로 나오는 이유를 안다 - [ ] 재귀 함수의 종료 조건과 재귀 단계를 찾을 수 있다
- [ ] 재귀가 스택을 쓴다는 것과 스택 오버플로가 왜 생기는지 설명할 수 있다
- [ ] 재귀 피보나치가 느린 이유와 해결 방법을 안다
- [ ] 프로그램을
.h와.c로 나누고, 구현 파일이 자기 헤더를 포함하는 이유를 안다 - [ ] include 가드가 무엇을 막는지 정확히 안다
- [ ]
undefined reference와multiple definition을 보고 원인을 찾을 수 있다 - [ ]
gcc -c로 분할 컴파일하고.o를 링크할 수 있다 - [ ] Makefile 의 타깃, 재료, 명령, 변수를 읽고 쓸 수 있다
- [ ]
touch로 파일을 건드렸을 때make가 무엇을 다시 컴파일할지 예측할 수 있다 - [ ] 헤더 의존성을 빠뜨리면 어떤 버그가 생기는지 안다
- [ ]
$@,$<,$^와 패턴 규칙%.o: %.c를 쓸 수 있다 - [ ]
.PHONY가 왜 필요한지, “분리 기호가 빠졌음”이 무슨 뜻인지 안다
모든 항목을 체크했다면 6주차 포인터로 넘어갈 준비가 되었습니다!