학습 목표
이번 주차를 마치면 다음을 할 수 있습니다:
- 버블·선택·삽입 정렬이 배열을 어떻게 바꾸는지 한 바퀴씩 손으로 따라갈 수 있다
- 비교 횟수와 이동 횟수를 세어 세 정렬의 성격 차이를 설명할 수 있다
- 병합 정렬(하향식·상향식)과 퀵 정렬(파티션, 피벗 전략, 3-way)을 구현하고, 각 줄이 왜 그렇게 생겼는지 안다
- “정렬된 입력에 끝 피벗”이 왜 O(n²)와 스택 오버플로로 이어지는지 직접 재현할 수 있다
- 비교 없는 정렬(카운팅·기수·버킷)이 O(n log n) 벽을 넘는 원리와 그 대가를 안다
- 안정 정렬이 무엇이고, 부등호 하나가 어떻게 그것을 결정하는지 설명할 수 있다
- 이진 탐색을 함정 없이 구현하고, lower/upper bound 로 개수 세기·삽입 위치·범위 검색을 할 수 있다
- 인트로 정렬(퀵+힙+삽입)과 외부 정렬의 구조를 이해하고, 벤치마크 표를 읽고 해석할 수 있다
들어가며
컴퓨터가 하는 일의 상당 부분은 사실 두 가지입니다. 줄 세우기(정렬)와 찾기(검색). 데이터베이스의 ORDER BY, 검색 엔진의 순위, 엑셀의 정렬 버튼, 게임의 랭킹, 파일 탐색기의 이름순 보기가 전부 오늘의 주제입니다.
그런데 궁금하지 않으신가요? 표준 라이브러리에 qsort 가 있고 bsearch 도 있습니다. 부르면 끝입니다. 그런데 왜 정렬 알고리즘을 열 가지나 배울까요?
이유는 세 가지입니다.
첫째, “어떤 정렬이 제일 빨라요?”의 정답이 “데이터에 따라 다릅니다”이기 때문입니다. 이번 주 마지막 프로젝트에서 같은 5만 개를 정렬하는 데 어떤 알고리즘은 1초 넘게 걸리고 어떤 알고리즘은 1밀리초도 안 걸리는 것을 보게 됩니다. 그리고 같은 알고리즘이 데이터 모양에 따라 수천 배 차이가 나는 것도요. 그 “따라”를 모르면 qsort 를 언제 믿고 언제 믿으면 안 되는지도 모릅니다.
둘째, 정렬은 알고리즘 설계의 모든 기법이 압축된 교재이기 때문입니다. 분할 정복, 하이브리드 전략, 캐시 지역성, 안정성, 오버플로 방어. 앞으로 만날 거의 모든 개념이 정렬 알고리즘 안에 작은 예제로 들어 있습니다.
셋째, 이진 탐색처럼 “쉬워 보이는” 코드에 함정이 얼마나 많은지 몸으로 익히기 위해서입니다. 자바 표준 라이브러리에 9년 동안 숨어 있던 버그를 이번 주에 직접 만들어 보고, 무한 루프에도 빠져 보고, 의도한 것과 정반대로 정렬되는 비교 함수도 써 봅니다.
이 글은 1~10주차와 같은 방식으로 씁니다. 모든 알고리즘을 작은 배열로 한 걸음씩 추적하고, 모든 출력은 실제로 돌려서 얻고, 예제마다 “이걸 바꾸면 어떻게 될까” 실험을 붙였습니다. 코드를 읽기만 하지 말고 꼭 따라 치면서 실험까지 해 보세요.
예제 코드는 week15/examples/ 와 week15/projects/ 에 있습니다. 실행 시간을 재는 곳이 많은 주라서, 빌드 방법을 먼저 짚고 갑니다.
0. 준비: 빌드와 측정에 대하여
빌드
이번 주부터 예제가 많아서 Makefile 로 한 번에 빌드합니다. 5주차에서 배운 그 make 입니다.
$ cd week15
$ make
컴파일: examples/basic_sorts.c
...
컴파일: projects/benchmark.c
✓ 프로젝트 파일 빌드 완료
✓ 모든 파일 빌드 완료!
$ ls build
basic_sorts  benchmark  binary_search  bucket_sort  counting_radix  external_sort
merge_sort  quick_3way  quick_sort  search_variants  sort_library  sort_stability
Makefile 을 열어 보면 규칙이 두 가지입니다.
# 예제 컴파일 규칙
$(BUILD_DIR)/%: $(EXAMPLES_DIR)/%.c
	@$(CC) $(CFLAGS) $< -o $@ $(LDFLAGS)

# 프로젝트 컴파일 규칙 (성능 측정용은 -O2)
$(BUILD_DIR)/%: $(PROJECTS_DIR)/%.c
	@$(CC) $(CFLAGS) -O2 $< -o $@ $(LDFLAGS)
예제는 -O2 없이, 프로젝트는 -O2 로 빌드됩니다. 1주차 5절에서 “배우는 동안에는 최적화를 켜지 않는다”고 했죠. 예제는 코드와 실행이 1:1 로 대응하도록 최적화를 끄고, 실행 시간을 재는 프로젝트는 실제 프로그램과 같은 조건이 되도록 켭니다. 10주차 성능 비교에서 -O2 가 측정 루프를 통째로 지워 버렸던 일을 기억하신다면, 이번 주 프로젝트가 왜 결과를 “검증”까지 하는지도 곧 이해가 될 겁니다.
한 파일만 직접 컴파일하고 싶으면 1주차의 명령 그대로입니다.
$ gcc -Wall -Wextra -std=c11 -g examples/basic_sorts.c -o build/basic_sorts
측정에 대하여
이번 주에는 두 종류의 숫자가 나옵니다.
| 숫자 | 얻는 법 | 성질 |
|---|---|---|
| 비교 횟수, 이동 횟수 | 코드에 카운터를 넣어 셈 | 어느 컴퓨터에서 돌려도 똑같습니다. 알고리즘의 성질 그 자체 |
| 실행 시간(ms) | clock() 으로 잼 |
컴퓨터마다, 실행마다 다릅니다. 이 글의 수치는 AMD Ryzen 5 5600X 에서 잰 것입니다 |
그래서 이 글은 가능하면 횟수로 설명하고, 시간은 “몇 배” 차이를 보는 용도로만 씁니다. 여러분의 컴퓨터에서 시간이 두 배쯤 다르게 나와도 정상입니다. 순서와 배율이 같은지를 보세요.
시간을 잴 때 쓰는 함수는 이것입니다.
#include <time.h>

clock_t t0 = clock();
sorts[s].fn(work, n);           /* 잴 대상 */
clock_t t1 = clock();
double ms = (double)(t1 - t0) * 1000.0 / CLOCKS_PER_SEC;
clock() 은 이 프로그램이 CPU 를 쓴 시간을 돌려줍니다. 단위는 CLOCKS_PER_SEC 로 나눠야 초가 되는데, 리눅스에서는 이 값이 100만이라 마이크로초 단위입니다. 벽시계 시간이 아니라 CPU 시간이라서, 프로그램이 잠들어 기다린 시간은 빠집니다. 정렬처럼 계산만 하는 코드에는 이쪽이 알맞습니다.
측정에서 제일 흔한 실수 하나를 미리 말해 두겠습니다. 같은 배열을 두 번 정렬하면 두 번째 측정은 “이미 정렬된 데이터”를 잰 것이 됩니다. 이번 주 모든 벤치마크 코드가 정렬 전에
memcpy로 원본을 다시 복사하는 이유입니다. 1절에서 코드로 봅니다.
1. O(n²) 삼형제: 무시하면 안 되는 기본기
1.1 느리다고 쓸모없는 건 아니다
버블·선택·삽입 정렬은 전부 평균 O(n²)입니다. 데이터가 10배 늘면 시간은 100배 늡니다. 큰 데이터에는 확실히 부적합합니다.
그런데 셋은 성격이 뚜렷하게 다르고, 그 성격이 실전에서 쓰입니다. 삽입 정렬은 이번 주 프로젝트 1의 인트로 정렬 안에 부품으로 들어가고, 선택 정렬은 쓰기가 비싼 저장 장치에서 이유 있는 선택이 됩니다. 셋을 같은 데이터로 돌리면서 비교와 이동 횟수를 세어 성격을 확인해 봅시다.
examples/basic_sorts.c:
/*
 * basic_sorts.c - O(n^2) 3형제: 버블, 선택, 삽입 정렬
 * 15주차: 정렬과 검색 알고리즘
 *
 * "느린 정렬"이라고 무시하면 안 됩니다. 각자 개성이 있습니다:
 * - 버블: 교환을 반복. 교육용. (조기 종료 최적화 포함)
 * - 선택: 최솟값을 찾아 앞으로. 교환 횟수 최소 (쓰기 비용이 클 때!)
 * - 삽입: 카드 정리하듯 제자리에 끼우기.
 *         "거의 정렬된" 데이터에선 O(n)에 가깝다! (실전 최다 활용)
 *
 * 비교/교환 횟수를 세어 성격 차이를 확인합니다.
 */
#include <stdio.h>
#include <string.h>

#define N 10

static long compares, swaps;

void reset_stats(void)  { compares = swaps = 0; }
void print_stats(void)  { printf("(비교 %ld회, 이동 %ld회)\n", compares, swaps); }

void swap(int *a, int *b) {
    int t = *a; *a = *b; *b = t;
    swaps++;
}

void print_array(const char *label, const int arr[], int n) {
    printf("%-10s [", label);
    for (int i = 0; i < n; i++) printf("%d%s", arr[i], i + 1 < n ? " " : "");
    printf("] ");
}

/* ---------- 버블 정렬: 이웃끼리 비교해 큰 것을 뒤로 ---------- */
void bubble_sort(int arr[], int n) {
    for (int i = 0; i < n - 1; i++) {
        int swapped = 0;
        for (int j = 0; j + 1 < n - i; j++) {
            compares++;
            if (arr[j] > arr[j + 1]) {
                swap(&arr[j], &arr[j + 1]);
                swapped = 1;
            }
        }
        if (!swapped) break;     /* 한 바퀴 동안 교환 없음 = 이미 정렬! */
    }
}

/* ---------- 선택 정렬: i번째 자리의 주인(최솟값)을 찾아온다 ---------- */
void selection_sort(int arr[], int n) {
    for (int i = 0; i < n - 1; i++) {
        int min = i;
        for (int j = i + 1; j < n; j++) {
            compares++;
            if (arr[j] < arr[min]) min = j;
        }
        if (min != i) swap(&arr[i], &arr[min]);   /* 한 바퀴에 교환 최대 1번! */
    }
}

/* ---------- 삽입 정렬: 왼쪽(정렬 구간)의 제자리에 끼워 넣기 ---------- */
void insertion_sort(int arr[], int n) {
    for (int i = 1; i < n; i++) {
        int key = arr[i];
        int j = i - 1;
        while (j >= 0) {
            compares++;
            if (arr[j] <= key) break;    /* 제자리 발견 */
            arr[j + 1] = arr[j];         /* 한 칸씩 밀기 */
            swaps++;
            j--;
        }
        arr[j + 1] = key;
    }
}

void test(const char *name, void (*sort)(int[], int),
          const int src[], int n) {
    int arr[N];
    memcpy(arr, src, n * sizeof(int));
    reset_stats();
    sort(arr, n);
    print_array(name, arr, n);
    print_stats();
}

int main(void) {
    int random_data[N]  = {5, 2, 9, 1, 7, 3, 8, 6, 4, 0};
    int sorted_data[N]  = {0, 1, 2, 3, 4, 5, 6, 7, 8, 9};
    int reverse_data[N] = {9, 8, 7, 6, 5, 4, 3, 2, 1, 0};
    int nearly_data[N]  = {0, 1, 2, 4, 3, 5, 6, 7, 9, 8};  /* 두 쌍만 뒤집힘 */

    printf("=== 무작위 데이터 ===\n");
    print_array("원본", random_data, N);
    printf("\n");
    test("버블", bubble_sort, random_data, N);
    test("선택", selection_sort, random_data, N);
    test("삽입", insertion_sort, random_data, N);

    printf("\n=== 이미 정렬된 데이터 (최선의 경우) ===\n");
    test("버블", bubble_sort, sorted_data, N);
    test("선택", selection_sort, sorted_data, N);
    test("삽입", insertion_sort, sorted_data, N);
    printf("-> 버블(조기 종료)과 삽입은 O(n)! 선택은 그래도 다 비교한다\n");

    printf("\n=== 역순 데이터 (최악의 경우) ===\n");
    test("버블", bubble_sort, reverse_data, N);
    test("선택", selection_sort, reverse_data, N);
    test("삽입", insertion_sort, reverse_data, N);
    printf("-> 선택 정렬의 '이동' 횟수에 주목: 항상 최소!\n");

    printf("\n=== 거의 정렬된 데이터 (실전에서 흔함!) ===\n");
    test("버블", bubble_sort, nearly_data, N);
    test("선택", selection_sort, nearly_data, N);
    test("삽입", insertion_sort, nearly_data, N);

    printf("\n정리:\n");
    printf("1. 셋 다 평균 O(n^2) - 큰 데이터엔 부적합\n");
    printf("2. 삽입: 거의 정렬된 데이터에 강하다\n");
    printf("   -> 그래서 퀵/인트로 정렬이 '작은 구간'을 삽입에 맡긴다!\n");
    printf("3. 선택: 이동(쓰기)이 최소 -> 쓰기 비용이 비싼 저장장치에 유리\n");
    return 0;
}
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=c11 -g examples/basic_sorts.c -o build/basic_sorts
$ ./build/basic_sorts
=== 무작위 데이터 ===
원본     [5 2 9 1 7 3 8 6 4 0]
버블     [0 1 2 3 4 5 6 7 8 9] (비교 45회, 이동 26회)
선택     [0 1 2 3 4 5 6 7 8 9] (비교 45회, 이동 8회)
삽입     [0 1 2 3 4 5 6 7 8 9] (비교 32회, 이동 26회)

=== 이미 정렬된 데이터 (최선의 경우) ===
버블     [0 1 2 3 4 5 6 7 8 9] (비교 9회, 이동 0회)
선택     [0 1 2 3 4 5 6 7 8 9] (비교 45회, 이동 0회)
삽입     [0 1 2 3 4 5 6 7 8 9] (비교 9회, 이동 0회)
-> 버블(조기 종료)과 삽입은 O(n)! 선택은 그래도 다 비교한다

=== 역순 데이터 (최악의 경우) ===
버블     [0 1 2 3 4 5 6 7 8 9] (비교 45회, 이동 45회)
선택     [0 1 2 3 4 5 6 7 8 9] (비교 45회, 이동 5회)
삽입     [0 1 2 3 4 5 6 7 8 9] (비교 45회, 이동 45회)
-> 선택 정렬의 '이동' 횟수에 주목: 항상 최소!

=== 거의 정렬된 데이터 (실전에서 흔함!) ===
버블     [0 1 2 3 4 5 6 7 8 9] (비교 17회, 이동 2회)
선택     [0 1 2 3 4 5 6 7 8 9] (비교 45회, 이동 2회)
삽입     [0 1 2 3 4 5 6 7 8 9] (비교 11회, 이동 2회)
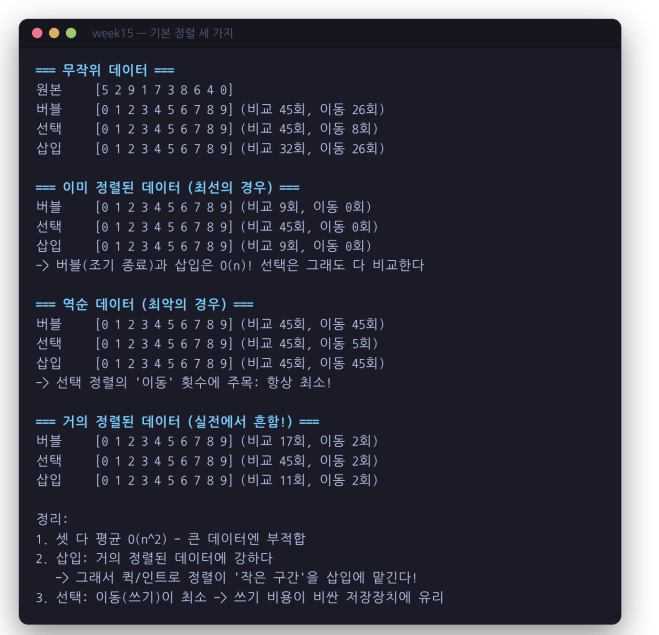
기본 정렬 세 가지
그림은 글을 쓴 뒤 다시 돌린 결과입니다. 벤치마크라서 본문 표와 수치가 몇 % 다릅니다. 배속과 순서가 같은지를 보세요 — 절대값이 아니라 그게 이 측정이 말하려는 것입니다.
숫자를 읽기 전에, 세 정렬이 실제로 배열을 어떻게 바꾸는지 작은 배열로 한 바퀴씩 따라가 봅시다. 알고리즘 공부에서 이 “손으로 따라가기”를 건너뛰면 나중에 코드의 부등호 하나가 왜 그런지 절대 이해할 수 없습니다.
1.2 버블 정렬 한 바퀴씩 따라가기
버블(bubble) 은 거품입니다. 큰 값이 거품처럼 오른쪽 끝으로 떠오른다고 해서 붙은 이름입니다. 규칙은 하나뿐입니다. 이웃한 두 칸을 비교해서, 왼쪽이 크면 바꾼다. 이것을 배열 끝까지 하면 “한 바퀴”입니다.
[5 2 9 1 7] 로 해 봅시다. 원소 5개이므로 바깥 for 는 최대 4바퀴(i = 0, 1, 2, 3) 돕니다.
1바퀴 (i = 0, j 는 0부터 3까지):
| j | 비교 | 결과 | 배열 |
|---|---|---|---|
| 0 | 5 > 2 ? 예 | 교환 | [2 5 9 1 7] |
| 1 | 5 > 9 ? 아니오 | 그대로 | [2 5 9 1 7] |
| 2 | 9 > 1 ? 예 | 교환 | [2 5 1 9 7] |
| 3 | 9 > 7 ? 예 | 교환 | [2 5 1 7 9] |
한 바퀴가 끝나자 가장 큰 9가 맨 뒤에 확정됐습니다. 9는 만나는 모든 값보다 커서 계속 오른쪽으로 밀려간 것입니다. 그래서 다음 바퀴부터는 마지막 칸을 볼 필요가 없고, 코드의 j + 1 < n - i 가 그 일을 합니다. i 가 커질수록 안쪽 반복이 한 칸씩 짧아집니다.
나머지 바퀴를 프로그램으로 추적한 결과입니다.
  바퀴 1: [2 5 1 7 9]  (누적 비교 4, 이동 3)
  바퀴 2: [2 1 5 7 9]  (누적 비교 7, 이동 4)
  바퀴 3: [1 2 5 7 9]  (누적 비교 9, 이동 5)
  바퀴 4: [1 2 5 7 9]  (누적 비교 10, 이동 5)
  -> 교환 없음, 조기 종료
3바퀴에서 이미 정렬이 끝났지만, 프로그램은 그것을 4바퀴를 돌아 보고 나서야 압니다. 4바퀴 동안 교환이 한 번도 없었다는 것(swapped == 0)이 “이미 정렬됐다”는 증거이기 때문입니다. 이것이 코드의 if (!swapped) break; 입니다.
비교 횟수 4 + 3 + 2 + 1 = 10 을 일반화하면, 원소가 n개일 때 최대 (n−1) + (n−2) + … + 1 = n(n−1)/2 번입니다. 10개면 45, 1,000개면 499,500, 100만 개면 약 5,000억 번입니다. n이 10배가 되면 비교는 100배가 되는 이 성질을 O(n²) 라고 부릅니다.
실험: 조기 종료를 빼면?
if (!swapped) break; 한 줄이 얼마나 중요한지 확인해 봅시다. 이미 정렬된 10개에 대해, 이 줄이 있는 원래 코드는 비교 9회로 끝났습니다(출력의 “이미 정렬된 데이터” 부분). 이 줄을 지운 버블 정렬을 따로 만들어 같은 입력을 넣으면 이렇습니다.
플래그 없는 버블, 정렬된 10개: 비교 45회
9회 대 45회. 조기 종료가 없으면 버블 정렬은 이미 정렬된 입력에서도 n(n−1)/2 번을 전부 비교합니다. 그러면 어떤 입력에서도 삽입 정렬보다 나은 점이 하나도 없는 알고리즘이 됩니다. 교과서에서 버블 정렬을 “가장 느린 정렬”이라고 부르는 것은 대개 이 줄이 없는 버전을 두고 하는 말입니다.
1.3 선택 정렬 한 바퀴씩 따라가기
선택(selection) 은 “i번째 자리의 주인을 선택해서 데려온다”입니다. 첫 번째 자리의 주인은 전체 최솟값, 두 번째 자리의 주인은 남은 것 중 최솟값, 이런 식입니다. 바퀴마다 최솟값의 위치(min)만 기억해 두고, 바퀴 끝에 딱 한 번 교환합니다.
  바퀴 1: [1 2 9 5 7]  (누적 비교 4, 이동 1)   ← 최솟값 1을 찾아 5와 교환
  바퀴 2: [1 2 9 5 7]  (누적 비교 7, 이동 1)   ← 남은 [2 9 5 7]의 최솟값 2는 이미 제자리, 교환 없음
  바퀴 3: [1 2 5 9 7]  (누적 비교 9, 이동 2)   ← 남은 [9 5 7]의 최솟값 5를 9와 교환
  바퀴 4: [1 2 5 7 9]  (누적 비교 10, 이동 3)  ← 남은 [9 7]의 최솟값 7을 9와 교환
비교 횟수는 버블과 똑같이 4 + 3 + 2 + 1 = 10 입니다. 그런데 선택 정렬에는 조기 종료가 없습니다. 최솟값을 찾으려면 남은 것을 전부 봐야 하니까요. 그래서 출력에서 “이미 정렬된 데이터”에도 45회를 비교합니다. 입력이 어떻든 항상 n(n−1)/2 번입니다.
대신 이동은 바퀴당 최대 1번, 전체로는 최대 n−1 번입니다. 역순 10개에서 버블과 삽입이 45번 움직일 때 선택은 5번만 움직인 것이 출력에 보입니다. 이것이 선택 정렬의 유일하지만 분명한 장점입니다.
이 장점이 쓸모 있는 곳이 있습니다. 플래시 메모리(SSD, EEPROM)는 쓰기 횟수에 수명이 있고, 쓰기가 읽기보다 훨씬 느립니다. 27주차 임베디드 편에서 만날 마이크로컨트롤러의 EEPROM 은 보통 10만 번 정도 쓰면 수명이 다합니다. 그런 곳에서 작은 표를 정렬해야 한다면, 비교는 많이 해도 쓰기는 적은 선택 정렬이 합리적인 선택입니다.
1.4 삽입 정렬 한 바퀴씩 따라가기
삽입(insertion) 은 카드 게임에서 손에 든 카드를 정리하는 방식입니다. 왼쪽은 이미 정리된 카드, 오른쪽에서 카드를 한 장 꺼내(key) 왼쪽의 알맞은 자리에 끼워 넣습니다.
  2 를 꺼내  끼움 1: [2 5 9 1 7]  (누적 비교 1, 이동 1)
  9 를 꺼내  끼움 2: [2 5 9 1 7]  (누적 비교 2, 이동 1)
  1 을 꺼내  끼움 3: [1 2 5 9 7]  (누적 비교 5, 이동 4)
  7 을 꺼내  끼움 4: [1 2 5 7 9]  (누적 비교 7, 이동 5)
두 번째 줄을 보세요. 9를 꺼냈는데 왼쪽 끝의 5가 9보다 작으니(arr[j] <= key) 한 번 비교하고 바로 멈춥니다. 이미 제자리이기 때문입니다. 반면 1을 꺼냈을 때는 9, 5, 2 를 차례로 한 칸씩 오른쪽으로 밀고(arr[j + 1] = arr[j]) 맨 앞에 내려놓습니다. 세 번 비교, 세 번 이동입니다.
여기서 삽입 정렬의 핵심 성질이 나옵니다. 각 원소는 “자기보다 큰 왼쪽 원소의 개수”만큼만 비교하고 이동합니다. 이미 정렬된 배열에서는 그런 원소가 하나도 없으니 원소당 비교 1번, 전체 n−1 번으로 끝납니다. 출력의 “이미 정렬된 데이터”에서 9회가 나온 이유이고, “거의 정렬된 데이터”(두 쌍만 뒤집힘)에서 11회로 끝난 이유입니다. 버블은 17회, 선택은 45회였습니다.
실전 데이터는 거의 정렬된 경우가 정말 많습니다. 로그는 시간순으로 쌓이고, 데이터베이스에서 가져온 목록은 대개 인덱스 순서이며, 사용자가 몇 개만 고친 목록은 대부분 원래 순서를 유지합니다. 그래서 퀵 정렬과 인트로 정렬이 작은 구간을 삽입 정렬에 맡깁니다. 프로젝트 1에서 직접 그렇게 만듭니다.
1.5 숫자에서 읽어내는 성격
10개짜리 네 가지 입력의 결과를 표로 모으면 세 정렬의 성격이 선명해집니다.
| 데이터 | 버블 (비교/이동) | 선택 (비교/이동) | 삽입 (비교/이동) |
|---|---|---|---|
| 무작위 | 45 / 26 | 45 / 8 | 32 / 26 |
| 정렬됨 | 9 / 0 | 45 / 0 | 9 / 0 |
| 역순 | 45 / 45 | 45 / 5 | 45 / 45 |
| 거의 정렬 | 17 / 2 | 45 / 2 | 11 / 2 |
- 선택은 어떤 입력에도 비교 45회입니다. 입력을 “보지 않는” 알고리즘입니다. 대신 이동은 항상 최소입니다.
- 버블과 삽입은 정렬된 입력에서 9회, 즉 O(n)입니다. 입력이 좋으면 빨라지는 알고리즘입니다.
- 무작위 입력에서 삽입(32)이 버블(45)보다 적게 비교합니다. 삽입은 제자리를 찾으면 바로 멈추지만, 버블은 한 바퀴를 끝까지 돌아야 하기 때문입니다.
1.6 코드에서 볼 것
교환이 아니라 밀기. 삽입 정렬의 안쪽 반복을 다시 보세요.
        int key = arr[i];            /* 끼워 넣을 카드를 손에 든다 */
        int j = i - 1;
        while (j >= 0) {
            compares++;
            if (arr[j] <= key) break;    /* 제자리 발견 */
            arr[j + 1] = arr[j];         /* 한 칸씩 밀기 */
            swaps++;
            j--;
        }
        arr[j + 1] = key;            /* 빈 자리에 내려놓는다 */
교환(swap)은 대입 세 번(t = a; a = b; b = t;)이지만 밀기는 대입 한 번입니다. 카드를 손(key)에 들고 있으니 그 자리를 계속 비워 둘 수 있기 때문입니다. 같은 O(n²)여도 상수가 3분의 1입니다. 이런 상수 차이가 프로젝트 1의 “작은 구간은 삽입 정렬” 결정을 만듭니다.
<= 인가 < 인가. if (arr[j] <= key) break; 는 같으면 멈춥니다. 그래서 key 는 자기와 같은 값의 뒤에 놓입니다. 원래 순서가 유지되는 것이죠. 이것을 < 로 바꾸면 같은 값도 밀어내고 그 앞에 끼어들어, 같은 값끼리의 순서가 뒤집힙니다. 지금은 정수라서 뒤집혀도 티가 안 나지만, 7절에서 학생 명단으로 이 부등호 하나가 만드는 차이를 눈으로 봅니다.
함수 포인터로 테스트 통일하기. 7주차에 배운 함수 포인터가 여기서 바로 쓰입니다.
void test(const char *name, void (*sort)(int[], int),
          const int src[], int n) {
    int arr[N];
    memcpy(arr, src, n * sizeof(int));   /* 원본에서 매번 새로 복사! */
    reset_stats();
    sort(arr, n);
    ...
}
sort 는 “int 배열과 길이를 받고 아무것도 돌려주지 않는 함수”를 가리키는 포인터입니다. 정렬 함수 세 개의 모양이 같으니 하나의 test 로 전부 돌릴 수 있습니다. 그리고 memcpy 로 매번 원본에서 복사합니다. 이걸 빼먹고 같은 배열을 계속 쓰면, 첫 번째 정렬이 배열을 정렬해 버려서 두 번째 정렬은 “이미 정렬된 데이터” 케이스가 됩니다. 결과가 그럴싸해 보여서 알아채기 어려운, 벤치마크에서 가장 흔한 실수입니다.
1.7 시간으로 확인하기
횟수가 아니라 시간으로도 O(n²)를 확인해 봅시다. 프로젝트 3의 벤치마크 도구에 크기를 주면 됩니다(10절에서 자세히 봅니다). 무작위 입력에서 삽입 정렬이 걸린 시간입니다.
| n | 삽입 정렬 (무작위) | 앞 칸 대비 |
|---|---|---|
| 10,000 | 6.0 ms | |
| 100,000 | 624.9 ms | 약 104배 |
n이 10배가 됐는데 시간은 약 100배가 됐습니다. 이론대로입니다. 그러니 100만 개면 다시 100배, 약 1분입니다. 선택 정렬은 같은 10만 개에 9초가 걸려서 100만 개면 15분입니다. 벤치마크 도구가 10만 개를 넘으면 삽입·선택 정렬을 자동으로 건너뛰는 이유입니다. 같은 100만 개를 다음 절의 병합 정렬은 0.06초에 끝냅니다.
2. 병합 정렬: 최악이 없는 모범생
2.1 분할 정복의 교과서
1절의 세 정렬은 n²에 갇혀 있습니다. 여기서 빠져나오는 첫 번째 아이디어가 분할 정복(divide and conquer) 입니다. 문제를 반으로 나누고, 각각을 풀고, 결과를 합칩니다.
병합 정렬은 세 단계입니다.
- 분할: 배열을 반으로 나눈다
- 정복: 각 반쪽을 재귀적으로 정렬한다
- 병합: 정렬된 두 배열을 하나로 합친다 ← 진짜 일은 여기서
왜 이게 빠를까요? 정렬된 두 줄을 합치는 것은 쉽기 때문입니다. 두 줄의 맨 앞 카드만 비교해서 작은 쪽을 가져오면 됩니다. 두 줄이 각각 정렬돼 있으니 맨 앞이 그 줄의 최솟값이고, 둘 중 작은 쪽이 전체의 최솟값입니다. 원소 n개를 합치는 데 비교가 최대 n번입니다.
examples/merge_sort.c:
/*
 * merge_sort.c - 병합 정렬: 하향식(재귀)과 상향식(반복)
 * 15주차: 정렬과 검색 알고리즘
 *
 * 분할 정복의 교과서:
 *   1. 반으로 나눈다 (분할)
 *   2. 각각 정렬한다 (재귀)
 *   3. 정렬된 두 배열을 합친다 (병합 - 핵심!)
 *
 * 성질:
 * - 항상 O(n log n). 최악이 없다!
 * - 안정 정렬 (같은 값의 순서 유지)
 * - 대신 O(n) 임시 공간 필요
 */
#include <stdio.h>
#include <string.h>

#define N 8

/* 병합: 정렬된 두 구간 [left..mid], [mid+1..right]를 하나로
 * 두 줄의 맨 앞 카드 중 작은 쪽을 가져오는 것의 반복 */
void merge(int arr[], int temp[], int left, int mid, int right) {
    int i = left;        /* 왼쪽 구간 커서 */
    int j = mid + 1;     /* 오른쪽 구간 커서 */
    int k = left;        /* 결과 커서 */

    while (i <= mid && j <= right) {
        if (arr[i] <= arr[j]) {          /* <= 라서 안정 정렬! (< 면 불안정) */
            temp[k++] = arr[i++];
        } else {
            temp[k++] = arr[j++];
        }
    }
    while (i <= mid)   temp[k++] = arr[i++];     /* 남은 것 쓸어 담기 */
    while (j <= right) temp[k++] = arr[j++];

    memcpy(arr + left, temp + left, (right - left + 1) * sizeof(int));
}

/* ---------- 하향식: 재귀로 쪼갠다 ---------- */
static int depth = 0;

void merge_sort_topdown(int arr[], int temp[], int left, int right) {
    if (left >= right) return;           /* 원소 1개 = 이미 정렬 */

    int mid = left + (right - left) / 2;

    for (int i = 0; i < depth; i++) printf("  ");
    printf("분할 [%d..%d] -> [%d..%d] + [%d..%d]\n",
           left, right, left, mid, mid + 1, right);

    depth++;
    merge_sort_topdown(arr, temp, left, mid);
    merge_sort_topdown(arr, temp, mid + 1, right);
    depth--;

    merge(arr, temp, left, mid, right);

    for (int i = 0; i < depth; i++) printf("  ");
    printf("병합 [%d..%d]: ", left, right);
    for (int i = left; i <= right; i++) printf("%d ", arr[i]);
    printf("\n");
}

/* ---------- 상향식: 재귀 없이 크기 1, 2, 4, ... 구간을 병합 ---------- */
void merge_sort_bottomup(int arr[], int temp[], int n) {
    for (int width = 1; width < n; width *= 2) {
        printf("  구간 크기 %d끼리 병합: ", width);
        for (int left = 0; left + width < n; left += 2 * width) {
            int mid = left + width - 1;
            int right = (left + 2 * width - 1 < n) ? left + 2 * width - 1
                                                   : n - 1;
            merge(arr, temp, left, mid, right);
        }
        for (int i = 0; i < n; i++) printf("%d ", arr[i]);
        printf("\n");
    }
}

int main(void) {
    int data[N] = {5, 2, 8, 1, 9, 3, 7, 4};
    int temp[N];

    printf("원본: ");
    for (int i = 0; i < N; i++) printf("%d ", data[i]);
    printf("\n");

    printf("\n=== 하향식 병합 정렬 (재귀 과정 추적) ===\n");
    int a[N];
    memcpy(a, data, sizeof(data));
    merge_sort_topdown(a, temp, 0, N - 1);

    printf("\n=== 상향식 병합 정렬 (반복문, 재귀 없음) ===\n");
    int b[N];
    memcpy(b, data, sizeof(data));
    merge_sort_bottomup(b, temp, N);

    printf("\n두 방식 결과 동일: %s\n",
           memcmp(a, b, sizeof(a)) == 0 ? "확인" : "버그!");

    printf("\n병합 정렬의 특징:\n");
    printf("1. 언제나 O(n log n) - 입력이 어떻든 성능 보장\n");
    printf("2. 안정 정렬 - merge에서 같으면 왼쪽 우선 (<=)\n");
    printf("3. O(n) 추가 메모리 - 제자리가 아닌 것이 대가\n");
    printf("4. 순차 접근 위주 - 연결 리스트, 외부 정렬(대용량 파일)에 최적\n");
    printf("5. 상향식은 재귀가 없어 스택 오버플로우 걱정 제로\n");
    return 0;
}
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=c11 -g examples/merge_sort.c -o build/merge_sort
$ ./build/merge_sort
원본: 5 2 8 1 9 3 7 4

=== 하향식 병합 정렬 (재귀 과정 추적) ===
분할 [0..7] -> [0..3] + [4..7]
  분할 [0..3] -> [0..1] + [2..3]
    분할 [0..1] -> [0..0] + [1..1]
    병합 [0..1]: 2 5
    분할 [2..3] -> [2..2] + [3..3]
    병합 [2..3]: 1 8
  병합 [0..3]: 1 2 5 8
  분할 [4..7] -> [4..5] + [6..7]
    분할 [4..5] -> [4..4] + [5..5]
    병합 [4..5]: 3 9
    분할 [6..7] -> [6..6] + [7..7]
    병합 [6..7]: 4 7
  병합 [4..7]: 3 4 7 9
병합 [0..7]: 1 2 3 4 5 7 8 9

=== 상향식 병합 정렬 (반복문, 재귀 없음) ===
  구간 크기 1끼리 병합: 2 5 1 8 3 9 4 7
  구간 크기 2끼리 병합: 1 2 5 8 3 4 7 9
  구간 크기 4끼리 병합: 1 2 3 4 5 7 8 9

두 방식 결과 동일: 확인
2.2 재귀의 모양 읽기
들여쓰기가 재귀의 깊이입니다. 5주차에서 재귀 함수가 스택에 쌓이는 것을 봤죠. 이 출력은 그 스택의 모양을 그대로 그린 것입니다. 나무 그림으로 다시 그리면 이렇습니다.
                    [5 2 8 1 9 3 7 4]              ← 분할 (깊이 0)
                   /                  \
          [5 2 8 1]                    [9 3 7 4]    ← 분할 (깊이 1)
          /        \                   /        \
      [5 2]        [8 1]           [9 3]        [7 4]   ← 분할 (깊이 2)
      /   \        /   \           /   \        /   \
    [5]   [2]    [8]   [1]       [9]   [3]    [7]   [4]  ← 원소 1개 = 정렬됨
      \   /        \   /           \   /        \   /
      [2 5]        [1 8]           [3 9]        [4 7]    ← 병합
          \        /                   \        /
          [1 2 5 8]                    [3 4 7 9]        ← 병합
                   \                  /
                    [1 2 3 4 5 7 8 9]                    ← 병합
두 가지가 보입니다.
내려가는 길에는 아무 일도 안 합니다. “분할”은 그저 mid 를 계산하고 재귀 호출을 두 번 하는 것뿐입니다. 원소 1개짜리(left >= right)에 닿으면 “이미 정렬됐다”며 그냥 돌아옵니다. 모든 정렬 작업은 올라오는 길의 “병합”에서 일어납니다.
깊이는 log₂ n 입니다. 8개를 반씩 나누면 3번 만에 1개가 됩니다(8 → 4 → 2 → 1). 100만 개면 20번입니다. 그리고 각 깊이에서 병합에 드는 비교는 다 합쳐 최대 n번입니다(같은 깊이의 구간들을 합치면 배열 전체니까요). 그래서 전체는 n × log n. 100만 개면 약 2,000만 번으로, 1절의 5,000억 번과는 비교가 안 됩니다.
2.3 병합 함수 해부
void merge(int arr[], int temp[], int left, int mid, int right) {
    int i = left;        /* 왼쪽 구간 커서 */
    int j = mid + 1;     /* 오른쪽 구간 커서 */
    int k = left;        /* 결과 커서 */

    while (i <= mid && j <= right) {
        if (arr[i] <= arr[j]) {          /* <= 라서 안정 정렬! (< 면 불안정) */
            temp[k++] = arr[i++];
        } else {
            temp[k++] = arr[j++];
        }
    }
    while (i <= mid)   temp[k++] = arr[i++];     /* 남은 것 쓸어 담기 */
    while (j <= right) temp[k++] = arr[j++];

    memcpy(arr + left, temp + left, (right - left + 1) * sizeof(int));
}
커서 세 개가 전부입니다. i 는 왼쪽 줄의 맨 앞, j 는 오른쪽 줄의 맨 앞, k 는 결과를 쓸 자리입니다. temp[k++] = arr[i++] 는 “왼쪽 맨 앞 카드를 결과에 놓고, 두 커서를 한 칸씩 전진”을 한 줄에 쓴 것입니다(3주차의 후위 ++).
마지막 병합 [1 2 5 8] + [3 4 7 9] 를 한 걸음씩 따라가면 이렇습니다.
| 단계 | arr[i] | arr[j] | 가져온 것 | temp |
|---|---|---|---|---|
| 1 | 1 | 3 | 1 (왼쪽) | 1 |
| 2 | 2 | 3 | 2 (왼쪽) | 1 2 |
| 3 | 5 | 3 | 3 (오른쪽) | 1 2 3 |
| 4 | 5 | 4 | 4 (오른쪽) | 1 2 3 4 |
| 5 | 5 | 7 | 5 (왼쪽) | 1 2 3 4 5 |
| 6 | 8 | 7 | 7 (오른쪽) | 1 2 3 4 5 7 |
| 7 | 8 | 9 | 8 (왼쪽) | 1 2 3 4 5 7 8 |
7단계에서 왼쪽 줄이 바닥났습니다(i 가 mid 를 넘음). 첫 번째 while 은 여기서 끝납니다. 그런데 오른쪽 줄에 9가 남아 있습니다. 뒤의 while 두 줄이 이것을 쓸어 담습니다. 남은 것들은 이미 정렬돼 있고 지금까지 담은 것보다 전부 크니, 비교 없이 순서대로 붙이면 됩니다.
실험: 쓸어 담기 두 줄을 빼면?
“남은 것은 어차피 정렬돼 있으니 그냥 두면 되지 않나?” 싶습니다. 두 줄을 지운 merge 로 [2 5 8 9] 와 [1 3 4 7] 을 합쳐 보면 이렇습니다.
왼쪽 [2 5 8 9] + 오른쪽 [1 3 4 7] 병합
결과: 1 2 3 4 5 7 0 0
8과 9가 사라지고 0이 들어왔습니다. 첫 번째 while 은 오른쪽 줄이 바닥나는 순간 끝나고, 왼쪽에 남은 8과 9는 temp 에 옮겨지지 않았습니다. 그 자리에는 temp 에 원래 있던 값(여기서는 0)이 남아 있다가 memcpy 로 배열에 덮어써졌습니다. 데이터가 조용히 사라지는 종류의 버그입니다. 오류 메시지도 없고, 결과는 오름차순처럼 보이기까지 합니다. 정렬 결과를 반드시 검증해야 하는 이유를 10절에서 다시 말하겠습니다.
memcpy 로 되돌리는 이유
병합 결과는 temp 에 만들어집니다. 원래 배열 arr 에 바로 쓸 수는 없습니다. arr[left..right] 를 읽는 중에 같은 자리에 쓰면, 아직 읽지 않은 값을 덮어쓰기 때문입니다. 그래서 temp 에 다 만든 뒤 memcpy 로 통째로 돌려놓습니다. 다음 단계(상위 병합)가 arr 을 읽어야 하니까요.
temp 를 함수 안에서 매번 malloc 하지 않고 바깥에서 한 번 만들어 넘겨받는 것도 눈여겨보세요. 재귀 호출마다 할당하면 병합 횟수만큼(n−1 번) malloc 과 free 가 일어납니다. 7주차에서 봤듯 malloc 은 싼 함수가 아닙니다.
그 유명한 부등호
if (arr[i] <= arr[j]) {
값이 같을 때 왼쪽을 먼저 가져옵니다. 왼쪽 구간은 원래 배열에서 앞쪽이었으니, 같은 값들의 원래 순서가 그대로 유지됩니다. 이것이 병합 정렬이 안정 정렬인 이유입니다. < 로 바꾸면 값이 같을 때 오른쪽을 먼저 가져와 순서가 뒤집힙니다. 정수만 정렬할 때는 아무 차이가 없어 보이지만, 7절에서 이 한 글자가 실무에서 어떤 결과를 만드는지 봅니다.
2.4 상향식: 재귀 없는 병합 정렬
void merge_sort_bottomup(int arr[], int temp[], int n) {
    for (int width = 1; width < n; width *= 2) {
        for (int left = 0; left + width < n; left += 2 * width) {
            int mid = left + width - 1;
            int right = (left + 2 * width - 1 < n) ? left + 2 * width - 1
                                                   : n - 1;
            merge(arr, temp, left, mid, right);
        }
    }
}
하향식이 “끝까지 쪼갠 뒤 올라오며 병합”이었다면, 상향식은 쪼개는 단계를 아예 건너뜁니다. 원소 1개짜리는 이미 정렬돼 있다는 사실을 이용해 처음부터 병합만 합니다. 크기 1끼리 → 크기 2끼리 → 크기 4끼리. 출력의 세 줄이 정확히 그 순서입니다.
  구간 크기 1끼리 병합: 2 5 1 8 3 9 4 7     ← [5 2]→[2 5], [8 1]→[1 8], ...
  구간 크기 2끼리 병합: 1 2 5 8 3 4 7 9     ← [2 5]+[1 8]→[1 2 5 8], ...
  구간 크기 4끼리 병합: 1 2 3 4 5 7 8 9
재귀 나무의 아래쪽부터 한 층씩 올라가는 것과 같습니다. 결과는 하향식과 똑같고(두 방식 결과 동일: 확인), 재귀가 없으니 스택 오버플로 걱정이 없습니다. 재귀를 꺼리는 임베디드 환경에서 쓰는 형태이고, 프로젝트 3의 벤치마크도 이 상향식을 씁니다.
left + width < n 조건과 right 의 삼항 연산자는 배열 크기가 2의 거듭제곱이 아닐 때를 위한 것입니다. 원소가 10개이고 width 가 4일 때, left = 8 에서 8 + 4 < 10 이 거짓이라 마지막 구간 [8..9]는 짝이 없어 그냥 넘어갑니다. 다음 라운드(width 8)에서 right 가 15가 아니라 n - 1 = 9 로 잘려 [0..7]과 [8..9]가 병합됩니다. 경계 처리는 지루하지만 여기서 실수하면 위의 실험처럼 데이터가 조용히 사라집니다.
2.5 병합 정렬의 프로필
| 항목 | 병합 정렬 |
|---|---|
| 시간 (최선/평균/최악) | O(n log n) / O(n log n) / O(n log n) |
| 공간 | O(n) 추가 (제자리 아님) |
| 안정성 | 안정 |
| 접근 패턴 | 순차 |
최악이 없습니다. 입력이 어떻게 생겼든 항상 n log n 입니다. 다음 절의 퀵 정렬이 특정 입력에서 O(n²)로 무너지는 것과 대조됩니다. 벤치마크 표(10절)에서 병합 정렬의 네 칸이 서로 비슷한 것이 이 성질입니다.
순차 접근이라는 점도 중요합니다. 병합은 두 구간을 앞에서 뒤로 한 번씩 훑을 뿐 여기저기 건너뛰지 않습니다. 그래서 두 곳에서 병합 정렬이 독보적입니다.
- 연결 리스트 정렬: 10주차의 연결 리스트는 “5번째 원소”로 바로 갈 수 없어 퀵 정렬이 불리한데, 병합은 앞에서부터 순서대로만 읽으므로 잘 맞습니다. 게다가 포인터만 이어 붙이면 되니
temp배열도 필요 없습니다. - 외부 정렬: 메모리보다 큰 파일을 정렬할 때. 프로젝트 2에서 직접 만듭니다.
대가는 O(n) 임시 공간입니다. 100만 개 int 를 정렬하려면 4MB 짜리 temp 가 더 필요합니다. 대부분은 감당할 만하지만, 메모리가 빠듯한 환경에서는 결정적 단점입니다. 다음 절의 퀵 정렬은 이 대가를 치르지 않습니다.
3. 퀵 정렬: 평균의 왕, 최악의 함정
3.1 파티션이 심장이다
퀵 정렬도 분할 정복이지만 순서가 반대입니다. 병합 정렬이 “대충 나누고 정성껏 합친다”면, 퀵 정렬은 “정성껏 나누고, 합치는 단계가 없다” 입니다.
- 피벗(pivot) 하나를 고른다. 기준값입니다.
- 피벗보다 작은 것은 왼쪽, 큰 것은 오른쪽으로 옮긴다. 이것을 파티션(partition) 이라고 합니다.
- 왼쪽과 오른쪽을 각각 재귀적으로 정렬한다. 합칠 필요가 없습니다. 왼쪽은 전부 피벗보다 작고 오른쪽은 전부 크니, 각각 정렬되면 전체가 정렬된 것입니다.
파티션이 끝나면 피벗은 최종 위치에 확정됩니다. 다시는 이사하지 않습니다. 이 성질 때문에 병합 정렬의 temp 배열이 필요 없고, 배열 안에서 자리만 바꿔 가며 정렬합니다. 이것을 제자리(in-place) 정렬이라고 합니다.
examples/quick_sort.c:
/*
 * quick_sort.c - 퀵 정렬: 평균의 왕, 최악의 함정
 * 15주차: 정렬과 검색 알고리즘
 *
 * 아이디어:
 *   1. 피벗(기준값)을 하나 고른다
 *   2. 피벗보다 작은 것은 왼쪽, 큰 것은 오른쪽으로 (파티션)
 *   3. 양쪽을 재귀적으로 정렬
 *
 * 평균 O(n log n)에 상수가 작고 제자리 정렬이라 실전에서 가장 빠른
 * 축에 듭니다. 하지만 피벗을 잘못 고르면 O(n^2)로 추락합니다!
 *
 * 피벗 전략 비교: 맨 끝 vs 셋의 중앙값(median-of-three)
 */
#include <stdio.h>
#include <string.h>

static long compares;

void swap(int *a, int *b) { int t = *a; *a = *b; *b = t; }

/* 로무토 파티션: arr[high]를 피벗으로, 작은 것들을 앞으로 모은다 */
int partition(int arr[], int low, int high) {
    int pivot = arr[high];
    int i = low - 1;                     /* "작은 구역"의 끝 */

    for (int j = low; j < high; j++) {
        compares++;
        if (arr[j] < pivot) {
            i++;
            swap(&arr[i], &arr[j]);      /* 작은 것을 작은 구역으로 */
        }
    }
    swap(&arr[i + 1], &arr[high]);       /* 피벗을 경계에 안착 */
    return i + 1;                        /* 피벗의 최종 위치 */
}

/* 기본 퀵 정렬: 맨 끝 피벗 */
void quick_sort_basic(int arr[], int low, int high) {
    if (low >= high) return;
    int p = partition(arr, low, high);
    quick_sort_basic(arr, low, p - 1);   /* 피벗 왼쪽 */
    quick_sort_basic(arr, p + 1, high);  /* 피벗 오른쪽 */
}

/* median-of-three: 처음/가운데/끝 중 중앙값을 피벗으로
 * -> 정렬된 입력에서도 좋은 피벗을 고른다! */
void median_of_three(int arr[], int low, int high) {
    int mid = low + (high - low) / 2;
    /* 세 값을 정렬해서 중앙값이 mid에 오게 한 뒤 high 자리로 */
    if (arr[mid] < arr[low])  swap(&arr[mid], &arr[low]);
    if (arr[high] < arr[low]) swap(&arr[high], &arr[low]);
    if (arr[high] < arr[mid]) swap(&arr[high], &arr[mid]);
    swap(&arr[mid], &arr[high]);         /* 중앙값을 피벗 자리로 */
}

void quick_sort_median3(int arr[], int low, int high) {
    if (low >= high) return;
    median_of_three(arr, low, high);
    int p = partition(arr, low, high);
    quick_sort_median3(arr, low, p - 1);
    quick_sort_median3(arr, p + 1, high);
}

/* 파티션 한 번을 시각적으로 */
void demo_partition(void) {
    int arr[] = {7, 2, 9, 4, 3, 8, 5};
    int n = 7;

    printf("파티션 데모 (피벗 = 맨 끝 %d):\n  전: ", arr[n-1]);
    for (int i = 0; i < n; i++) printf("%d ", arr[i]);

    int p = partition(arr, 0, n - 1);

    printf("\n  후: ");
    for (int i = 0; i < n; i++) {
        if (i == p) printf("[%d] ", arr[i]);
        else        printf("%d ", arr[i]);
    }
    printf("\n  피벗 %d는 최종 위치 %d에 안착. 왼쪽은 다 작고 오른쪽은 다 크다!\n",
           arr[p], p);
}

int main(void) {
    demo_partition();

    /* 피벗 전략의 승부처: 이미 정렬된 입력 */
    #define M 1000
    static int sorted_arr[M], work[M];
    for (int i = 0; i < M; i++) sorted_arr[i] = i;

    printf("\n=== 이미 정렬된 %d개 입력: 피벗 전략 대결 ===\n", M);

    memcpy(work, sorted_arr, sizeof(work));
    compares = 0;
    quick_sort_basic(work, 0, M - 1);
    printf("맨 끝 피벗       : 비교 %8ld회  <- O(n^2)로 추락!\n", compares);

    memcpy(work, sorted_arr, sizeof(work));
    compares = 0;
    quick_sort_median3(work, 0, M - 1);
    printf("median-of-three  : 비교 %8ld회  <- O(n log n) 유지\n", compares);

    printf("(이론값: n^2/2 = %d, n log n ≈ %d)\n",
           M * M / 2, M * 10);

    printf("\n=== 무작위 입력에선? ===\n");
    static int rnd[M];
    unsigned seed = 7;
    for (int i = 0; i < M; i++) {
        seed = seed * 1103515245 + 12345;
        rnd[i] = (int)((seed >> 16) % 10000);
    }

    memcpy(work, rnd, sizeof(work));
    compares = 0;
    quick_sort_basic(work, 0, M - 1);
    printf("맨 끝 피벗       : 비교 %8ld회\n", compares);

    memcpy(work, rnd, sizeof(work));
    compares = 0;
    quick_sort_median3(work, 0, M - 1);
    printf("median-of-three  : 비교 %8ld회 (무작위에선 큰 차이 없다)\n",
           compares);

    printf("\n핵심 정리:\n");
    printf("1. 퀵의 힘 = 제자리 + 작은 상수 + 캐시 친화\n");
    printf("2. 퀵의 약점 = 나쁜 피벗이 연속되면 O(n^2)\n");
    printf("   (정렬된 입력 + 끝 피벗이 대표적 저격 사례)\n");
    printf("3. median-of-three로 실전 입력 대부분 방어\n");
    printf("4. '악의적 입력'까지 방어하려면? -> 프로젝트의 인트로 정렬!\n");
    return 0;
}
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=c11 -g examples/quick_sort.c -o build/quick_sort
$ ./build/quick_sort
파티션 데모 (피벗 = 맨 끝 5):
  전: 7 2 9 4 3 8 5
  후: 2 4 3 [5] 9 8 7
  피벗 5는 최종 위치 3에 안착. 왼쪽은 다 작고 오른쪽은 다 크다!

=== 이미 정렬된 1000개 입력: 피벗 전략 대결 ===
맨 끝 피벗       : 비교   499500회  <- O(n^2)로 추락!
median-of-three  : 비교     7987회  <- O(n log n) 유지
(이론값: n^2/2 = 500000, n log n ≈ 10000)

=== 무작위 입력에선? ===
맨 끝 피벗       : 비교    10086회
median-of-three  : 비교     9019회 (무작위에선 큰 차이 없다)
3.2 로무토 파티션 한 걸음씩
int partition(int arr[], int low, int high) {
    int pivot = arr[high];
    int i = low - 1;                     /* "작은 구역"의 끝 */

    for (int j = low; j < high; j++) {
        compares++;
        if (arr[j] < pivot) {
            i++;
            swap(&arr[i], &arr[j]);      /* 작은 것을 작은 구역으로 */
        }
    }
    swap(&arr[i + 1], &arr[high]);       /* 피벗을 경계에 안착 */
    return i + 1;                        /* 피벗의 최종 위치 */
}
로무토(Lomuto) 파티션이라는 방식입니다. 배열을 네 구역으로 보면 이해가 쉽습니다.
[ 피벗보다 작다 ][ 피벗보다 크거나 같다 ][ 아직 안 본 것 ][ 피벗 ]
 low..i           i+1..j-1                j..high-1        high
j 가 앞에서부터 한 칸씩 훑습니다. i 는 “작은 구역”의 마지막 칸을 가리키는데, 처음에는 작은 구역이 비어 있으니 low - 1 입니다. arr[j] 가 피벗보다 작으면 i 를 한 칸 늘리고 그 자리와 교환합니다. 작은 구역이 한 칸 자라는 것입니다.
데모의 [7 2 9 4 3 8 5] 를 j 한 걸음마다 따라가 봅시다. 피벗은 맨 끝의 5입니다.
| j | arr[j] | 5보다 작나? | 동작 | i | 배열 |
|---|---|---|---|---|---|
| 시작 | -1 | 7 2 9 4 3 8 5 |
|||
| 0 | 7 | 아니오 | 그대로 | -1 | 7 2 9 4 3 8 5 |
| 1 | 2 | 예 | i=0, arr[0]↔arr[1] | 0 | 2 7 9 4 3 8 5 |
| 2 | 9 | 아니오 | 그대로 | 0 | 2 7 9 4 3 8 5 |
| 3 | 4 | 예 | i=1, arr[1]↔arr[3] | 1 | 2 4 9 7 3 8 5 |
| 4 | 3 | 예 | i=2, arr[2]↔arr[4] | 2 | 2 4 3 7 9 8 5 |
| 5 | 8 | 아니오 | 그대로 | 2 | 2 4 3 7 9 8 5 |
| 끝 | arr[3]↔arr[6] (피벗) | 2 4 3 5 9 8 7 |
j = 1 에서 2를 발견하고 i 를 0으로 올린 뒤 arr[0](7)과 교환했습니다. 7은 “크거나 같다” 구역의 첫 칸으로 밀려나고 2가 작은 구역에 들어왔습니다. 순회가 끝났을 때 i = 2 이므로 작은 구역은 [0..2], 그 다음 칸 i + 1 = 3 이 “큰 구역”의 시작입니다. 거기에 피벗을 넣으면 2 4 3 [5] 9 8 7 입니다.
왼쪽 구역 2 4 3 이 정렬되지 않았다는 점을 꼭 보세요. 파티션은 “작은 것들을 왼쪽에 모으는” 것이지 “정렬하는” 것이 아닙니다. 정렬은 재귀가 이어서 합니다. [2 4 3] 을 피벗 3으로 파티션하면 [2] 3 [4], 원소 1개짜리는 low >= high 로 바로 돌아옵니다.
3.3 피벗이 전부다
퀵 정렬의 성능은 파티션이 얼마나 균등하게 나누는가가 결정합니다.
- 피벗이 중앙값 근처 → 반씩 쪼개짐 → 재귀 깊이 log n → 각 깊이에서 n번 비교 → O(n log n)
- 피벗이 최솟값이나 최댓값 → 한쪽이 텅 빔 → 재귀 깊이 n → 각 깊이에서 n, n−1, n−2, … 번 비교 → O(n²)
그리고 악명 높은 함정이 여기 있습니다. 이미 정렬된 배열에 “맨 끝 피벗”을 쓰면 매번 최악입니다. 정렬된 배열의 맨 끝은 항상 최댓값이니까요. 파티션할 때마다 “왼쪽에 n−1개, 오른쪽에 0개”로 쪼개지고, 피벗 하나만 확정된 채 n−1개짜리 문제가 다시 남습니다.
실행 결과가 정확히 그것입니다. 정렬된 1,000개에서 맨 끝 피벗은 499,500회 비교했습니다. 1,000 × 999 / 2, 1절 버블 정렬과 같은 n(n−1)/2 입니다. median-of-three 는 7,987회로 60배 이상 적습니다.
아이러니하죠. 이미 정렬된 데이터가 “빠른 정렬”의 최악 입력이라니. 그런데 1절에서 말했듯 실전 데이터는 정렬돼 있는 경우가 정말 많습니다. 이 함정은 실무에서 실제로 밟히는 함정입니다.
실험: 정렬된 입력을 키워 보면 어디까지 버틸까?
1,000개는 50만 번 비교라 순식간입니다. 끝 피벗 퀵 정렬(quick_sort_basic)에 정렬된 입력을 크게 넣어 봅시다. 재귀 깊이를 함께 재는 작은 프로그램을 만들어 돌린 결과입니다.
$ ./qworst 10000
n=10000 정렬 완료, 최대 재귀 깊이 9999
0.17s 걸림
$ ./qworst 50000
n=50000 정렬 완료, 최대 재귀 깊이 49999
6.00s 걸림
$ ./qworst 300000
Command terminated by signal 11
129.77s 걸림
$ echo $?
139
두 가지가 보입니다.
시간이 n² 으로 늘어납니다. 1만 개 0.17초, 5만 개 6초. n이 5배가 되니 시간은 약 35배입니다. 30만 개는 이 속도라면 4분 가까이 걸릴 참이었습니다.
재귀 깊이가 n−1 입니다. 매번 한쪽이 비니까 재귀가 n번 중첩됩니다. 5주차에서 무한 재귀가 세그멘테이션 오류로 죽는 것을 봤죠. 스택은 기본 8MB 이고 재귀 한 단계마다 수십 바이트를 쓰니, 30만 단계를 다 쌓기 전에 스택이 넘쳐 세그멘테이션 오류(종료 코드 139) 로 죽었습니다. 2분 넘게 돌다가요. 병합 정렬은 30만 개를 깊이 19에서 끝냅니다(2¹⁹ ≈ 52만).
같은 코드가 무작위 입력 30만 개는 문제없이 정렬합니다. 입력의 모양 하나가 “잘 돌던 프로그램”을 죽입니다. 이것이 피벗 선택이 단순한 성능 문제가 아니라 안정성 문제인 이유입니다.
3.4 median-of-three
void median_of_three(int arr[], int low, int high) {
    int mid = low + (high - low) / 2;
    if (arr[mid] < arr[low])  swap(&arr[mid], &arr[low]);
    if (arr[high] < arr[low]) swap(&arr[high], &arr[low]);
    if (arr[high] < arr[mid]) swap(&arr[high], &arr[mid]);
    swap(&arr[mid], &arr[high]);         /* 중앙값을 피벗 자리로 */
}
처음·가운데·끝 세 값을 보고 그 셋의 중앙값을 피벗으로 씁니다. 세 번의 비교·교환으로 arr[low] ≤ arr[mid] ≤ arr[high] 가 되고, 가운데(arr[mid])를 피벗 자리(high)로 옮긴 뒤 평소처럼 파티션합니다. 세 줄의 if 를 하나씩 보면 이렇습니다.
arr[mid] < arr[low]면 교환 → 이제arr[low] ≤ arr[mid]arr[high] < arr[low]면 교환 → 이제arr[low]가 셋 중 최솟값arr[high] < arr[mid]면 교환 → 이제arr[mid] ≤ arr[high], 즉arr[mid]가 중앙값
정렬된 배열에서는 가운데 값이 진짜 중앙값이므로 정확히 반씩 쪼개집니다. 역순 배열도 마찬가지입니다. 실전에서 흔한 “정렬됨 / 역순 / 거의 정렬됨” 입력을 파티션당 비교 세 번의 비용으로 막습니다. 무작위 입력에서는 큰 이득이 없지만(10,086 → 9,019), 최악을 막아 주는 보험으로 값이 충분합니다.
다만 만능은 아닙니다. 두 가지를 기억해 두세요.
- 세 위치의 값을 알고 있는 공격자는 여전히 O(n²)를 유도하는 입력을 만들 수 있습니다. 웹 서버가 이런 입력으로 서비스 거부 공격을 당한 사례가 실제로 있습니다. 완전한 방어는 프로젝트 1의 인트로 정렬입니다.
- 공격자가 아니어도, 파티션 방식에 따라 median-of-three 가 스스로 만든 모양에 속는 경우가 있습니다. 10절 벤치마크에서 실제로 그런 일이 벌어지고, 왜 그런지 파헤칩니다.
3.5 퀵 정렬의 프로필
| 항목 | 퀵 정렬 |
|---|---|
| 시간 (최선/평균/최악) | O(n log n) / O(n log n) / O(n²) |
| 공간 | O(log n) (재귀 스택만, 제자리 정렬) |
| 안정성 | 불안정 |
| 접근 패턴 | 순차 스캔 (캐시 친화적) |
최악이 O(n²)인데도 퀵 정렬이 “실전 최강”으로 불리는 이유는 세 가지입니다.
- 제자리 정렬: 병합 정렬의 O(n) 임시 배열이 없습니다.
- 작은 상수: 파티션은 비교와 교환뿐이라 한 번의 연산이 가볍습니다.
- 캐시 친화적: 배열을 앞에서 뒤로 순차적으로 훑으므로 캐시 적중률이 높습니다.
3번이 특히 중요합니다. 10주차에서 배운 “빅오가 같아도 메모리 접근 패턴이 다르면 성능이 다르다”는 원리가 여기서 다시 작동합니다. 힙 정렬도 O(n log n)이지만 배열을 멀리 건너뛰며 접근해 캐시를 계속 놓칩니다. 10절의 벤치마크 표에서 그 차이가 숫자로 나옵니다.
4. 3-way 파티션: 중복 값의 구원자
4.1 퀵 정렬의 숨은 약점
퀵 정렬에는 피벗 말고 약점이 하나 더 있습니다. 중복 값입니다.
배열 전체가 같은 값이라고 해 봅시다. 로무토 파티션의 조건은 arr[j] < pivot 인데, 모든 값이 피벗과 같으니 이 조건이 한 번도 참이 되지 않습니다. i 는 low - 1 에서 한 번도 움직이지 않고, 피벗은 low 자리에 놓이며, “왼쪽 0개, 오른쪽 n−1개”로 쪼개집니다. 정렬된 입력 + 끝 피벗과 똑같은 O(n²) 입니다. 값이 세 종류뿐인 배열도 크게 다르지 않습니다.
해법이 3-way 파티션입니다. 다익스트라가 “네덜란드 국기 문제”(빨강·하양·파랑 공을 국기 순서로 정렬하기)의 해법으로 고안한 것으로, 배열을 두 구역이 아니라 세 구역으로 나눕니다.
[ 피벗보다 작다 | 피벗과 같다 | 피벗보다 크다 ]
그리고 “같다” 구역은 재귀에서 통째로 제외합니다. 피벗과 같은 값들은 이미 제자리이기 때문입니다. 값이 세 종류뿐이라면 재귀가 세 번이면 끝납니다.
examples/quick_3way.c:
/*
 * quick_3way.c - 3-way 파티션 퀵 정렬 (중복 값의 구원자)
 * 15주차: 정렬과 검색 알고리즘
 *
 * 일반 퀵 정렬의 숨은 약점: 중복 값이 많으면 느려집니다.
 * 값이 전부 같아도 파티션이 계속 쪼개려 들거든요.
 *
 * 3-way 파티션(네덜란드 국기 문제, 다익스트라 고안):
 * 배열을 세 구역으로 나눈다:
 *   [ 피벗보다 작다 | 피벗과 같다 | 피벗보다 크다 ]
 * "같다" 구역은 재귀에서 통째로 제외! 중복이 많을수록 이득.
 */
#include <stdio.h>
#include <string.h>

static long compares;

void swap(int *a, int *b) { int t = *a; *a = *b; *b = t; }

/* ---------- 일반 퀵 (비교용) ---------- */
int partition(int arr[], int low, int high) {
    int pivot = arr[high];
    int i = low - 1;
    for (int j = low; j < high; j++) {
        compares++;
        if (arr[j] < pivot) swap(&arr[++i], &arr[j]);
    }
    swap(&arr[i + 1], &arr[high]);
    return i + 1;
}

void quick_sort(int arr[], int low, int high) {
    if (low >= high) return;
    int p = partition(arr, low, high);
    quick_sort(arr, low, p - 1);
    quick_sort(arr, p + 1, high);
}

/* ---------- 3-way 파티션 퀵 ----------
 * lt: "작다" 구역의 끝 다음  /  gt: "크다" 구역의 시작 전
 * i : 현재 검사 위치
 *
 *   [ < pivot ][ == pivot ][ 미확인 ][ > pivot ]
 *    low..lt-1  lt..i-1     i..gt     gt+1..high
 */
void quick_sort_3way(int arr[], int low, int high) {
    if (low >= high) return;

    int pivot = arr[low];
    int lt = low, i = low + 1, gt = high;

    while (i <= gt) {
        compares++;
        if (arr[i] < pivot) {
            swap(&arr[lt++], &arr[i++]);     /* "작다" 구역으로 */
        } else if (arr[i] > pivot) {
            swap(&arr[i], &arr[gt--]);       /* "크다" 구역으로 (i는 그대로!) */
        } else {
            i++;                             /* 같으면 그냥 통과 */
        }
    }
    /* 이제 arr[lt..gt]는 전부 피벗과 같다 - 재귀에서 제외! */
    quick_sort_3way(arr, low, lt - 1);
    quick_sort_3way(arr, gt + 1, high);
}

int main(void) {
    /* 데모: 작은 배열로 세 구역 확인 */
    int demo[] = {3, 5, 3, 1, 3, 8, 3, 2, 3};
    int dn = 9;
    printf("3-way 데모 (피벗=3): ");
    for (int i = 0; i < dn; i++) printf("%d ", demo[i]);
    quick_sort_3way(demo, 0, dn - 1);
    printf("\n정렬 결과          : ");
    for (int i = 0; i < dn; i++) printf("%d ", demo[i]);
    printf("\n(3이 다섯 개나 되지만 '같다' 구역으로 한 번에 처리)\n");

    /* 승부: 값 종류가 3가지뿐인 10만 개 배열 */
    #define M 100000
    static int dup_data[M], work[M];
    unsigned seed = 11;
    for (int i = 0; i < M; i++) {
        seed = seed * 1103515245 + 12345;
        dup_data[i] = (int)((seed >> 16) % 3);   /* 0, 1, 2만! */
    }

    printf("\n=== 값 종류 3가지 x %d개: 중복 대량 데이터 대결 ===\n", M);

    memcpy(work, dup_data, sizeof(work));
    compares = 0;
    quick_sort(work, 0, M - 1);
    printf("일반 퀵   : 비교 %10ld회\n", compares);

    memcpy(work, dup_data, sizeof(work));
    compares = 0;
    quick_sort_3way(work, 0, M - 1);
    printf("3-way 퀵  : 비교 %10ld회  <- 압도적!\n", compares);

    /* 중복이 없으면? */
    static int uniq[M];
    for (int i = 0; i < M; i++) uniq[i] = i;
    /* 셔플 */
    seed = 22;
    for (int i = M - 1; i > 0; i--) {
        seed = seed * 1103515245 + 12345;
        int j = (int)((seed >> 16) % (unsigned)(i + 1));
        int t = uniq[i]; uniq[i] = uniq[j]; uniq[j] = t;
    }

    printf("\n=== 전부 다른 값 %d개 (중복 없음) ===\n", M);

    memcpy(work, uniq, sizeof(work));
    compares = 0;
    quick_sort(work, 0, M - 1);
    printf("일반 퀵   : 비교 %10ld회\n", compares);

    memcpy(work, uniq, sizeof(work));
    compares = 0;
    quick_sort_3way(work, 0, M - 1);
    printf("3-way 퀵  : 비교 %10ld회 (비슷하거나 살짝 손해)\n", compares);

    printf("\n결론:\n");
    printf("1. 중복 많은 데이터(성별, 등급, 카테고리...)에선 3-way가 압승\n");
    printf("2. '같다' 구역을 재귀에서 빼는 것이 비결\n");
    printf("3. 실전 라이브러리 정렬들이 이 기법을 내장하고 있다\n");
    return 0;
}
컴파일하고 실행합니다. 10만 개짜리 일반 퀵 정렬이 O(n²)라 몇 초 걸립니다.
$ gcc -Wall -Wextra -std=c11 -g examples/quick_3way.c -o build/quick_3way
$ ./build/quick_3way
3-way 데모 (피벗=3): 3 5 3 1 3 8 3 2 3
정렬 결과          : 1 2 3 3 3 3 3 5 8
(3이 다섯 개나 되지만 '같다' 구역으로 한 번에 처리)

=== 값 종류 3가지 x 100000개: 중복 대량 데이터 대결 ===
일반 퀵   : 비교 1666797824회
3-way 퀵  : 비교     199993회  <- 압도적!

=== 전부 다른 값 100000개 (중복 없음) ===
일반 퀵   : 비교    1997013회
3-way 퀵  : 비교    1992459회 (비슷하거나 살짝 손해)
16억 6천만 회 대 20만 회. 8,300배 차이입니다. 값 종류가 셋뿐인 10만 개에서 일반 퀵 정렬은 사실상 O(n²)로 무너졌습니다(n²/2 = 50억이니 그 3분의 1 수준입니다). 3-way 는 약 2n 번, 즉 O(n)으로 끝났습니다. 값이 세 종류면 파티션 세 번이면 되니까요.
반면 중복이 없으면 둘이 거의 같습니다. 3-way 는 중복이 있을 때만 이득이고, 없을 때 손해도 거의 없습니다. 그래서 실전 라이브러리들이 기본으로 채택합니다.
4.2 세 포인터의 춤
void quick_sort_3way(int arr[], int low, int high) {
    if (low >= high) return;

    int pivot = arr[low];
    int lt = low, i = low + 1, gt = high;

    while (i <= gt) {
        compares++;
        if (arr[i] < pivot) {
            swap(&arr[lt++], &arr[i++]);     /* "작다" 구역으로 */
        } else if (arr[i] > pivot) {
            swap(&arr[i], &arr[gt--]);       /* "크다" 구역으로 (i는 그대로!) */
        } else {
            i++;                             /* 같으면 그냥 통과 */
        }
    }
    /* 이제 arr[lt..gt]는 전부 피벗과 같다 - 재귀에서 제외! */
    quick_sort_3way(arr, low, lt - 1);
    quick_sort_3way(arr, gt + 1, high);
}
주석의 배열 그림이 이해의 열쇠입니다. 포인터가 셋입니다.
[ < pivot ][ == pivot ][ 미확인 ][ > pivot ]
 low..lt-1  lt..i-1     i..gt     gt+1..high
lt(less than): “작다” 구역의 끝 다음 칸. 곧 “같다” 구역의 첫 칸입니다.i: 지금 검사할 칸.i왼쪽은 전부 판정이 끝났습니다.gt(greater than): “크다” 구역의 시작 전 칸. 미확인 구역의 마지막 칸입니다.
데모 배열 [3 5 3 1 3 8 3 2 3] (피벗 3)을 한 걸음씩 따라가 봅시다.
| 검사 | arr[i] | 판정 | 동작 | lt | i | gt | 배열 |
|---|---|---|---|---|---|---|---|
| 시작 | 0 | 1 | 8 | 3 5 3 1 3 8 3 2 3 |
|||
| 1 | 5 | > 3 | gt와 교환, gt−− | 0 | 1 | 7 | 3 3 3 1 3 8 3 2 5 |
| 2 | 3 | == 3 | i++ | 0 | 2 | 7 | 3 3 3 1 3 8 3 2 5 |
| 3 | 3 | == 3 | i++ | 0 | 3 | 7 | 3 3 3 1 3 8 3 2 5 |
| 4 | 1 | < 3 | lt와 교환, lt++, i++ | 1 | 4 | 7 | 1 3 3 3 3 8 3 2 5 |
| 5 | 3 | == 3 | i++ | 1 | 5 | 7 | 1 3 3 3 3 8 3 2 5 |
| 6 | 8 | > 3 | gt와 교환, gt−− | 1 | 5 | 6 | 1 3 3 3 3 2 3 8 5 |
| 7 | 2 | < 3 | lt와 교환, lt++, i++ | 2 | 6 | 6 | 1 2 3 3 3 3 3 8 5 |
| 8 | 3 | == 3 | i++ | 2 | 7 | 6 | 1 2 3 3 3 3 3 8 5 |
| 끝 | i > gt | 작다 [0..1], 같다 [2..6], 크다 [7..8] |
세 가지 경우를 하나씩 봅시다.
작을 때 (4번, 7번 검사): lt 자리(같은 값 구역의 첫 칸)와 교환하고 둘 다 전진합니다. 4번 검사에서 arr[3]=1 과 arr[0]=3 이 바뀌어 1이 맨 앞으로 가고, 3은 “같다” 구역의 끝으로 밀렸습니다. “같다” 구역 전체가 한 칸 오른쪽으로 밀리는 효과입니다.
클 때 (1번, 6번 검사): gt 자리와 교환하고 gt 만 줄입니다. 1번 검사에서 arr[1]=5 와 arr[8]=3 이 바뀌었는데, 이제 arr[1] 에는 맨 뒤에서 온 3이 있습니다. 이 3은 아직 검사한 적이 없습니다. 그래서 i 를 그대로 두고, 다음 검사(2번)에서 이 3을 봅니다. 여기서 i++ 를 넣으면 값 하나를 검사 없이 건너뛰게 됩니다.
같을 때 (2, 3, 5, 8번): i++ 만. 이미 “같다” 구역 안에 있는 셈입니다.
반복은 i > gt, 즉 미확인 구역이 사라질 때까지입니다. 끝나면 arr[lt..gt] 가 전부 피벗과 같고, 재귀는 그 양옆 [0..1] 과 [7..8] 만 처리합니다.
실험: 클 때 i++ 를 넣으면?
“교환했으니 다음으로 넘어가야지”라는 생각에 swap(&arr[i], &arr[gt--]); i++; 로 고쳐서 같은 데모를 돌리면 이렇습니다.
결과: 1 3 3 3 3 2 3 5 8
2가 3들 사이에 끼어 있습니다. 정렬이 틀렸는데 프로그램은 아무 불평도 하지 않습니다. 맨 뒤에서 끌려온 값을 검사하지 않고 지나쳐서, 그 값이 “같다” 구역으로 취급된 것입니다. 3-way 파티션을 직접 짤 때 가장 흔한 버그이고, 이 실험처럼 작은 배열로 손 추적을 해 봐야 잡히는 종류의 버그입니다.
4.3 언제 쓰나
중복이 많은 데이터는 생각보다 흔합니다.
- 성별, 등급, 카테고리, 상태 코드로 정렬할 때
- 날짜만 남긴 타임스탬프(같은 날 데이터가 수천 건)
- 점수, 나이처럼 범위가 좁은 값
- 로그의 로그 레벨(INFO / WARN / ERROR)
이런 경우 3-way 가 극적인 이득을 줍니다. 중복이 없을 때 손해가 거의 없으니, 범용 정렬을 만든다면 3-way 를 기본으로 쓰는 것이 합리적입니다. 10절의 벤치마크가 그렇게 만들어져 있습니다.
5. 비교 없는 정렬: O(n log n) 벽 넘기
5.1 넘을 수 없는 벽, 그리고 우회로
지금까지 본 정렬은 전부 “두 값을 비교해서 순서를 정하는” 방식이었습니다. 이런 비교 기반 정렬에는 유명한 정리가 있습니다.
비교 기반 정렬은 아무리 잘 만들어도 최악의 경우 O(n log n)보다 빠를 수 없다.
증명의 아이디어는 이렇습니다. n개를 늘어놓는 방법(순열)은 n! 가지입니다. 정렬이란 그중 “오름차순인 하나”를 찾아내는 일이고, 비교 한 번은 “예/아니오” 두 갈래이므로 k번 비교하면 최대 2^k 가지 경우를 구분할 수 있습니다. n! 가지를 모두 구분하려면 2^k ≥ n! 이어야 하고, 양변에 로그를 씌우면 k ≥ log₂(n!) ≈ n log n 입니다. 10개만 해도 10! = 3,628,800 가지라서 최소 22번은 비교해야 한다는 뜻입니다.
즉 퀵·병합·힙 정렬은 이미 이론적 한계에 도달했습니다. 더 나은 비교 정렬은 존재하지 않습니다.
그런데 벽을 넘는 방법이 있습니다. 비교를 하지 않으면 됩니다. 값 자체를 배열의 인덱스로 쓰거나, 자릿수별로 나누거나, 구간에 뿌리는 방식입니다. 물론 공짜는 아니고, 각자 데이터에 대한 조건을 요구합니다.
examples/counting_radix.c:
/*
 * counting_radix.c - 비교 없는 정렬: 카운팅 & 기수 정렬
 * 15주차: 정렬과 검색 알고리즘
 *
 * 놀라운 사실: 비교 기반 정렬은 아무리 잘해도 O(n log n)이 한계입니다
 * (수학적으로 증명됨). 그런데 "비교하지 않으면" 그 벽을 넘을 수 있습니다!
 *
 * 카운팅 정렬: 값의 범위가 작을 때. "몇 개 있는지 세서" 자리를 계산
 *   O(n + k), k = 값의 범위
 *
 * 기수 정렬: 자릿수별로 카운팅 정렬을 반복 (1의 자리 -> 10의 자리 -> ...)
 *   O(d x (n + 10)), d = 자릿수
 *   비결: 카운팅이 "안정 정렬"이라서 앞 자릿수 순서가 보존된다!
 */
#include <stdio.h>
#include <string.h>

/* ---------- 카운팅 정렬 ---------- */
void counting_sort(int arr[], int n, int max_value) {
    int count[100] = {0};        /* max_value < 100 가정 (데모용) */

    /* 1. 개수 세기 */
    for (int i = 0; i < n; i++) count[arr[i]]++;

    printf("  개수: ");
    for (int v = 0; v <= max_value; v++) {
        if (count[v] > 0) printf("%d이 %d개, ", v, count[v]);
    }
    printf("\n");

    /* 2. 누적합 = "이 값이 끝나는 위치" */
    for (int v = 1; v <= max_value; v++) count[v] += count[v - 1];

    /* 3. 뒤에서부터 제자리에 배치 (뒤에서 = 안정성의 비결!) */
    int output[64];
    for (int i = n - 1; i >= 0; i--) {
        output[--count[arr[i]]] = arr[i];
    }
    memcpy(arr, output, n * sizeof(int));
}

/* ---------- 기수 정렬 (LSD: 낮은 자리부터) ---------- */
void counting_by_digit(int arr[], int n, int divisor) {
    int count[10] = {0};
    int output[64];

    for (int i = 0; i < n; i++) count[(arr[i] / divisor) % 10]++;
    for (int d = 1; d < 10; d++) count[d] += count[d - 1];
    for (int i = n - 1; i >= 0; i--) {           /* 뒤에서부터 = 안정! */
        int digit = (arr[i] / divisor) % 10;
        output[--count[digit]] = arr[i];
    }
    memcpy(arr, output, n * sizeof(int));
}

void radix_sort(int arr[], int n, int max_value) {
    for (int divisor = 1; max_value / divisor > 0; divisor *= 10) {
        counting_by_digit(arr, n, divisor);

        printf("  %6d의 자리 정렬 후: ", divisor);
        for (int i = 0; i < n; i++) printf("%3d ", arr[i]);
        printf("\n");
    }
}

int main(void) {
    printf("=== 카운팅 정렬: 시험 점수(0~10) 정렬 ===\n");
    int scores[] = {7, 2, 9, 2, 5, 7, 0, 9, 7, 3};
    int sn = 10;

    printf("원본: ");
    for (int i = 0; i < sn; i++) printf("%d ", scores[i]);
    printf("\n");

    counting_sort(scores, sn, 10);

    printf("결과: ");
    for (int i = 0; i < sn; i++) printf("%d ", scores[i]);
    printf("\n비교를 한 번도 안 했다! O(n + k)\n");

    printf("\n=== 기수 정렬: 세 자리 수 정렬 ===\n");
    int nums[] = {329, 457, 657, 839, 436, 720, 355, 57};
    int nn = 8;

    printf("원본: ");
    for (int i = 0; i < nn; i++) printf("%3d ", nums[i]);
    printf("\n");

    radix_sort(nums, nn, 999);

    printf("\n1의 자리 순서가 10의 자리 정렬에서도 (같은 값끼리) 유지되는\n");
    printf("것이 보이나요? 카운팅의 '안정성'이 기수 정렬을 가능하게 합니다.\n");

    printf("\n=== 왜 항상 안 쓰나? ===\n");
    printf("카운팅의 함정: 값 범위 k가 크면 재앙\n");
    printf("  예: int 전체 범위 -> count 배열 42억 칸 = 16GB!\n");
    printf("기수의 함정: 자릿수 d가 크면(긴 문자열 등) 이득 감소\n");
    printf("\n적재적소:\n");
    printf("- 점수, 나이, 등급처럼 좁은 범위 정수 -> 카운팅\n");
    printf("- 고정 길이 숫자/문자열 대량         -> 기수\n");
    printf("- 일반적인 경우                       -> 비교 정렬 (퀵/병합)\n");
    return 0;
}
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=c11 -g examples/counting_radix.c -o build/counting_radix
$ ./build/counting_radix
=== 카운팅 정렬: 시험 점수(0~10) 정렬 ===
원본: 7 2 9 2 5 7 0 9 7 3
  개수: 0이 1개, 2이 2개, 3이 1개, 5이 1개, 7이 3개, 9이 2개,
결과: 0 2 2 3 5 7 7 7 9 9
비교를 한 번도 안 했다! O(n + k)

=== 기수 정렬: 세 자리 수 정렬 ===
원본: 329 457 657 839 436 720 355  57
       1의 자리 정렬 후: 720 355 436 457 657  57 329 839
      10의 자리 정렬 후: 720 329 436 839 355 457 657  57
     100의 자리 정렬 후:  57 329 355 436 457 657 720 839

1의 자리 순서가 10의 자리 정렬에서도 (같은 값끼리) 유지되는
것이 보이나요? 카운팅의 '안정성'이 기수 정렬을 가능하게 합니다.

=== 왜 항상 안 쓰나? ===
카운팅의 함정: 값 범위 k가 크면 재앙
  예: int 전체 범위 -> count 배열 42억 칸 = 16GB!
기수의 함정: 자릿수 d가 크면(긴 문자열 등) 이득 감소
5.2 카운팅 정렬: 세어서 자리를 계산한다
카운팅 정렬은 세 단계입니다. 코드에는 < 도 > 도 없습니다. 정말 한 번도 비교하지 않습니다.
    /* 1. 개수 세기 */
    for (int i = 0; i < n; i++) count[arr[i]]++;

    /* 2. 누적합 = "이 값이 끝나는 위치" */
    for (int v = 1; v <= max_value; v++) count[v] += count[v - 1];

    /* 3. 뒤에서부터 제자리에 배치 (뒤에서 = 안정성의 비결!) */
    for (int i = n - 1; i >= 0; i--) {
        output[--count[arr[i]]] = arr[i];
    }
1단계는 직관적입니다. count[arr[i]]++ 는 “값 arr[i] 를 하나 봤다”고 표시하는 것입니다. 값을 그대로 인덱스로 씁니다. 그래서 값이 0 이상의 작은 정수여야 합니다.
2단계 누적합이 이 알고리즘의 핵심 아이디어입니다. 예제 데이터로 표를 만들어 봅시다.
값      :   0  1  2  3  4  5  6  7  8  9
개수    :   1  0  2  1  0  1  0  3  0  2
누적합  :   1  1  3  4  4  5  5  8  8 10
누적합의 뜻은 “이 값보다 작거나 같은 원소가 몇 개인가” 입니다. 7의 누적합이 8이라는 것은 “7 이하가 8개”라는 뜻이고, 그러면 7들은 정렬 결과에서 인덱스 7까지 차지하고 끝납니다(0번부터 세니까). 즉 누적합은 “이 값이 놓일 구역의 끝 다음 위치”입니다. 값 자체가 자기 위치를 알려 주니 비교가 필요 없습니다.
3단계는 배열을 뒤에서부터 돌면서 --count[값] 으로 자리를 하나씩 앞으로 당겨 채웁니다. 이것도 한 걸음씩 봅시다.
  arr[9]=3 -> count[3]를 3으로 줄이고 output[3]에 놓음 : [ . . . 3 . . . . . . ]
  arr[8]=7 -> count[7]를 7로 줄이고 output[7]에 놓음 : [ . . . 3 . . . 7 . . ]
  arr[7]=9 -> count[9]를 9로 줄이고 output[9]에 놓음 : [ . . . 3 . . . 7 . 9 ]
  arr[6]=0 -> count[0]를 0으로 줄이고 output[0]에 놓음 : [ 0 . . 3 . . . 7 . 9 ]
  arr[5]=7 -> count[7]를 6으로 줄이고 output[6]에 놓음 : [ 0 . . 3 . . 7 7 . 9 ]
  arr[4]=5 -> count[5]를 4로 줄이고 output[4]에 놓음 : [ 0 . . 3 5 . 7 7 . 9 ]
  arr[3]=2 -> count[2]를 2로 줄이고 output[2]에 놓음 : [ 0 . 2 3 5 . 7 7 . 9 ]
  arr[2]=9 -> count[9]를 8로 줄이고 output[8]에 놓음 : [ 0 . 2 3 5 . 7 7 9 9 ]
  arr[1]=2 -> count[2]를 1로 줄이고 output[1]에 놓음 : [ 0 2 2 3 5 . 7 7 9 9 ]
  arr[0]=7 -> count[7]를 5로 줄이고 output[5]에 놓음 : [ 0 2 2 3 5 7 7 7 9 9 ]
7이 세 개인데, 원본에서 가장 뒤에 있던 7(arr[8])이 output[7], 그다음 7(arr[5])이 output[6], 맨 앞의 7(arr[0])이 output[5]에 놓였습니다. 뒤에서부터 돌았기 때문에 원본에서 뒤에 있던 것이 결과에서도 뒤에 갑니다. 원래 순서가 유지되는 것, 즉 안정 정렬입니다. 앞에서부터 돌면 같은 값들의 순서가 뒤집힙니다. 지금은 숫자라 티가 안 나지만, 이 성질이 바로 다음 기수 정렬의 전제 조건이 됩니다.
시간은 O(n + k)입니다. n은 원소 수, k는 값의 범위(여기서는 10)입니다. 비교가 0회이므로 O(n log n) 벽을 넘었습니다.
5.3 기수 정렬: 자릿수별로 반복
카운팅 정렬은 값의 범위가 좁아야 합니다. 세 자리 수(0~999)를 정렬하려면 count 가 1,000칸이어야 하고, 아홉 자리 수라면 10억 칸입니다. 기수(radix) 정렬은 이 문제를 “자릿수 하나씩”으로 쪼개서 풉니다. 한 자릿수는 0~9, 열 가지뿐이니 count[10] 이면 됩니다.
void radix_sort(int arr[], int n, int max_value) {
    for (int divisor = 1; max_value / divisor > 0; divisor *= 10) {
        counting_by_digit(arr, n, divisor);
        ...
    }
}
(arr[i] / divisor) % 10 이 원하는 자릿수를 뽑습니다. divisor 가 1이면 457 / 1 % 10 = 7(1의 자리), 10이면 457 / 10 % 10 = 5(10의 자리), 100이면 4(100의 자리)입니다. 3주차의 정수 나눗셈과 나머지가 여기서 이렇게 쓰입니다.
낮은 자리부터 정렬합니다(LSD, least significant digit). 왜 낮은 자리부터일까요? 실행 결과를 자세히 보세요.
원본:              329 457 657 839 436 720 355  57
  1의 자리 후:     720 355 436 457 657  57 329 839
 10의 자리 후:     720 329 436 839 355 457 657  57
100의 자리 후:      57 329 355 436 457 657 720 839
10의 자리 정렬 후를 보면, 10의 자리가 5로 같은 355, 457, 657, 57 이 나란히 있습니다. 그런데 이들의 1의 자리는 5, 7, 7, 7 순서입니다. 1의 자리 정렬의 결과가 그대로 보존됐습니다. 10의 자리가 같으면 1의 자리 순서로 결정돼야 하는데, 정확히 그렇게 돼 있습니다.
이것이 성립하는 이유가 안정성입니다. 카운팅 정렬이 안정적이라서, 10의 자리가 같은 것들의 상대 순서(= 1의 자리 순서)를 흐트러뜨리지 않습니다. 낮은 자리부터 차례로 정렬하면 마지막에 가장 높은 자리가 순서를 결정하고, 그것이 같을 때는 그 아래 자리, 또 그 아래 자리 순서가 자동으로 지켜집니다.
실험: 불안정한 카운팅으로 기수 정렬을 하면?
3단계의 “뒤에서부터”를 “앞에서부터”로 바꾼 카운팅(for (int i = 0; i < n; i++))으로 같은 기수 정렬을 돌리면 이렇게 됩니다.
   1의 자리 후: 720 355 436  57 657 457 839 329
  10의 자리 후: 329 720 839 436 457 657  57 355
 100의 자리 후:  57 355 329 457 436 657 720 839
결과가 정렬되지 않았습니다. 355 329, 457 436 처럼 100의 자리가 같은 것들의 순서가 틀렸습니다. 각 단계에서 같은 자릿수끼리의 순서가 뒤집혀서, 앞 단계의 결과가 무너진 것입니다. “안정성이 왜 중요한가”의 가장 극적인 사례입니다. 안정성은 있으면 좋은 성질이 아니라, 기수 정렬에서는 없으면 알고리즘 자체가 성립하지 않는 조건입니다.
기수 정렬의 시간은 O(d × (n + 10))입니다. d는 자릿수입니다. 세 자리 수 100만 개면 카운팅 정렬 세 번, 약 300만 번의 작업입니다.
5.4 조건과의 거래
비교 없는 정렬은 조건을 요구합니다.
| 알고리즘 | 시간 | 조건 | 조건이 깨지면 |
|---|---|---|---|
| 카운팅 | O(n + k) | 값 범위 k가 작다 | k가 크면 메모리 폭발 |
| 기수 | O(d(n + 10)) | 자릿수 d가 작다 | 긴 키는 이득 감소 |
| 버킷 | 평균 O(n) | 값이 고르게 분포 | 몰리면 O(n²) |
카운팅의 함정이 가장 치명적입니다. int 전체 범위를 지원하려면 count 배열이 2³² = 4,294,967,296, 약 42.9억 칸입니다(예제 출력의 “42억 칸”). 칸 하나가 int 4바이트니 16GB 입니다. 시험 점수(0~100)라면 count[101] 로 완벽하지만, 값이 0~10억인 사용자 ID라면 절대 쓰면 안 됩니다. 값의 범위를 먼저 확인하는 것이 이 알고리즘의 전제입니다.
정리하면 이렇습니다.
- 점수·나이·등급처럼 좁은 범위 정수 → 카운팅
- 고정 길이 숫자나 문자열을 대량으로 (전화번호, 우편번호, 날짜) → 기수
- 그 외 일반적인 경우 → 비교 정렬(퀵/병합)
6. 버킷 정렬: 분포가 생명
카운팅 정렬은 값이 정수여야 합니다. 0.0 이상 1.0 미만의 실수 15개를 정렬하려면 어떻게 할까요? 실수를 인덱스로 쓸 수는 없습니다. 버킷(bucket, 양동이) 정렬은 값의 범위를 구간으로 나눠서 그 문제를 풉니다. 아이디어는 13주차 해시 테이블과 똑같습니다.
- 값의 범위를 몇 개의 “양동이”로 나눈다
- 각 원소를 자기 양동이에 던져 넣는다
- 양동이 안을 각각 정렬한다 (작으니 삽입 정렬로 충분)
- 양동이를 순서대로 쏟아 담는다
데이터가 고르게 퍼져 있으면 양동이당 평균 몇 개씩만 들어가서 각 양동이 정렬이 사실상 상수 시간이고, 전체가 평균 O(n) 입니다.
examples/bucket_sort.c:
/*
 * bucket_sort.c - 버킷 정렬: 균등 분포의 스페셜리스트
 * 15주차: 정렬과 검색 알고리즘
 *
 * 아이디어:
 *   1. 값의 범위를 n개의 "양동이"로 나눈다
 *   2. 각 원소를 자기 양동이에 던져 넣는다 (해시 테이블 체이닝과 닮음!)
 *   3. 양동이 안을 각각 정렬한다 (작으니까 삽입 정렬)
 *   4. 양동이를 순서대로 쏟는다
 *
 * 데이터가 고르게 퍼져 있으면 양동이당 평균 1개 -> 평균 O(n)!
 * 한쪽에 몰리면 한 양동이가 다 받아서 O(n^2)... 분포가 생명입니다.
 */
#include <stdio.h>
#include <stdlib.h>

#define N 15
#define BUCKETS 5

typedef struct BNode {
    double value;
    struct BNode *next;
} BNode;

/* 버킷(연결 리스트)에 정렬 상태를 유지하며 삽입 = 삽입 정렬과 동일 */
BNode *insert_sorted(BNode *head, double value) {
    BNode *node = malloc(sizeof(BNode));
    if (node == NULL) exit(1);
    node->value = value;

    if (head == NULL || value < head->value) {
        node->next = head;
        return node;
    }
    BNode *cur = head;
    while (cur->next != NULL && cur->next->value <= value) {
        cur = cur->next;
    }
    node->next = cur->next;
    cur->next = node;
    return head;
}

void bucket_sort(double arr[], int n) {
    BNode *bucket[BUCKETS] = {NULL};

    /* 1~2. 값 [0,1)을 버킷 인덱스로 변환해 던져 넣기 */
    for (int i = 0; i < n; i++) {
        int idx = (int)(arr[i] * BUCKETS);       /* 0.0~0.2 -> 0, ... */
        if (idx >= BUCKETS) idx = BUCKETS - 1;
        bucket[idx] = insert_sorted(bucket[idx], arr[i]);
    }

    /* 버킷 상태 출력 */
    for (int b = 0; b < BUCKETS; b++) {
        printf("  버킷 %d [%.1f~%.1f): ", b,
               (double)b / BUCKETS, (double)(b + 1) / BUCKETS);
        for (BNode *cur = bucket[b]; cur != NULL; cur = cur->next) {
            printf("%.2f ", cur->value);
        }
        printf("\n");
    }

    /* 4. 순서대로 쏟아 담기 + 해제 */
    int k = 0;
    for (int b = 0; b < BUCKETS; b++) {
        BNode *cur = bucket[b];
        while (cur != NULL) {
            arr[k++] = cur->value;
            BNode *next = cur->next;
            free(cur);
            cur = next;
        }
    }
}

int main(void) {
    printf("=== 버킷 정렬: [0,1) 실수 %d개, 버킷 %d개 ===\n\n", N, BUCKETS);

    /* 고르게 퍼진 데이터 */
    double uniform[N] = {
        0.78, 0.17, 0.39, 0.26, 0.72, 0.94, 0.21, 0.12,
        0.23, 0.68, 0.55, 0.90, 0.05, 0.43, 0.61,
    };

    printf("원본: ");
    for (int i = 0; i < N; i++) printf("%.2f ", uniform[i]);
    printf("\n\n[고른 분포] 버킷별 분배:\n");
    bucket_sort(uniform, N);

    printf("\n결과: ");
    for (int i = 0; i < N; i++) printf("%.2f ", uniform[i]);
    printf("\n버킷당 평균 %d개씩 -> 각 버킷 정렬이 순식간 = 평균 O(n)\n",
           N / BUCKETS);

    /* 몰린 데이터 */
    double skewed[N] = {
        0.11, 0.12, 0.13, 0.10, 0.15, 0.14, 0.16, 0.11,
        0.13, 0.12, 0.17, 0.18, 0.10, 0.19, 0.95,
    };

    printf("\n[몰린 분포] 버킷별 분배:\n");
    bucket_sort(skewed, N);
    printf("\n결과: ");
    for (int i = 0; i < N; i++) printf("%.2f ", skewed[i]);
    printf("\n0번 버킷에 14개가 몰림 -> 그 버킷 정렬이 O(m^2) = 버킷의 의미 상실\n");

    printf("\n정리:\n");
    printf("1. 버킷 정렬 = 균등 분포일 때 평균 O(n)\n");
    printf("2. 분포를 모르면 도박 - 몰리면 O(n^2)\n");
    printf("3. 카운팅과의 차이: 실수/넓은 범위도 OK (구간으로 나누니까)\n");
    printf("4. 13주차 해시 체이닝과 구조가 똑같다는 것을 눈치챘나요?\n");
    return 0;
}
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=c11 -g examples/bucket_sort.c -o build/bucket_sort
$ ./build/bucket_sort
=== 버킷 정렬: [0,1) 실수 15개, 버킷 5개 ===

원본: 0.78 0.17 0.39 0.26 0.72 0.94 0.21 0.12 0.23 0.68 0.55 0.90 0.05 0.43 0.61

[고른 분포] 버킷별 분배:
  버킷 0 [0.0~0.2): 0.05 0.12 0.17
  버킷 1 [0.2~0.4): 0.21 0.23 0.26 0.39
  버킷 2 [0.4~0.6): 0.43 0.55
  버킷 3 [0.6~0.8): 0.61 0.68 0.72 0.78
  버킷 4 [0.8~1.0): 0.90 0.94

결과: 0.05 0.12 0.17 0.21 0.23 0.26 0.39 0.43 0.55 0.61 0.68 0.72 0.78 0.90 0.94
버킷당 평균 3개씩 -> 각 버킷 정렬이 순식간 = 평균 O(n)

[몰린 분포] 버킷별 분배:
  버킷 0 [0.0~0.2): 0.10 0.10 0.11 0.11 0.12 0.12 0.13 0.13 0.14 0.15 0.16 0.17 0.18 0.19
  버킷 1 [0.2~0.4):
  버킷 2 [0.4~0.6):
  버킷 3 [0.6~0.8):
  버킷 4 [0.8~1.0): 0.95

결과: 0.10 0.10 0.11 0.11 0.12 0.12 0.13 0.13 0.14 0.15 0.16 0.17 0.18 0.19 0.95
0번 버킷에 14개가 몰림 -> 그 버킷 정렬이 O(m^2) = 버킷의 의미 상실
두 결과의 대비가 전부입니다. 고르게 퍼지면 양동이마다 2~4개씩 나뉘어 각각 순식간에 정렬되지만, 몰리면 한 양동이가 14개를 다 받아 그냥 삽입 정렬이 됩니다. 버킷으로 나눈 의미가 사라집니다.
6.1 구현에서 볼 것
        int idx = (int)(arr[i] * BUCKETS);       /* 0.0~0.2 -> 0, ... */
        if (idx >= BUCKETS) idx = BUCKETS - 1;
값을 버킷 번호로 바꾸는 계산입니다. 0.78 × 5 = 3.9 → (int) 로 소수점을 버리면 3. 0.17 × 5 = 0.85 → 0. 이 계산이 곧 해시 함수의 역할입니다. 다만 13주차 해시와 결정적으로 다른 점이 있습니다. 해시 함수는 값을 섞어서 분포를 고르게 만드는 것이 목적이지만, 버킷 정렬의 인덱스 계산은 순서를 보존해야 합니다. 0번 버킷의 모든 값이 1번 버킷의 모든 값보다 작아야 마지막에 순서대로 쏟아 담을 수 있으니까요. 그래서 섞을 수가 없고, 분포가 나쁘면 그대로 당할 수밖에 없습니다.
if (idx >= BUCKETS) 는 값이 정확히 1.0일 때를 위한 방어입니다. 1.0 × 5 = 5인데 버킷은 0~4번까지밖에 없으니, 이 줄이 없으면 bucket[5] 라는 배열 밖에 쓰게 됩니다. 4주차에서 본 그 범위 초과입니다. 부동소수점 경계값은 이렇게 한 줄로 막아 둬야 합니다.
BNode *insert_sorted(BNode *head, double value) {
    ...
    while (cur->next != NULL && cur->next->value <= value) {
버킷은 10주차의 연결 리스트이고, 넣을 때부터 정렬 상태를 유지하며 삽입합니다. 연결 리스트에 삽입 정렬을 하는 셈입니다. <= 덕분에 같은 값은 뒤에 붙어 안정성도 유지됩니다.
정리하면 버킷 정렬은 분포를 확신할 수 있을 때만 쓰는 특수 도구입니다. 균등 난수, 0~1로 정규화된 좌표, 고르게 퍼진 측정값이라면 강력하지만, 분포를 모른다면 도박입니다.
13주차에서 해시 테이블을 만들 때 “충돌이 한 곳에 몰리면 O(n)으로 퇴화한다”고 했던 것을 기억하시나요? 버킷 정렬의 약점과 정확히 같은 구조입니다. 데이터를 여러 통에 나눠 담는 모든 기법은 “고르게 나뉜다”는 가정 위에 서 있고, 그 가정이 깨지면 무너집니다.
7. 안정 정렬: 부등호 하나의 무게
7.1 안정성이란
이번 주 내내 “안정”이라는 말이 나왔습니다. 이제 정확히 정의하고, 왜 중요한지 눈으로 봅시다.
안정 정렬(stable sort) = 키가 같은 원소들의 원래 순서가 유지되는 정렬입니다.
정의만 보면 “그게 뭐 대수인가” 싶습니다. 정수 배열에서 3과 3의 순서가 바뀐들 결과는 똑같으니까요. 차이는 원소가 여러 필드를 가진 레코드일 때 나타납니다. 학생 명단을 학년으로 정렬하면, 같은 1학년끼리는 어떤 순서가 될까요? 안정 정렬은 원래 순서를 지키고, 불안정 정렬은 아무 보장도 하지 않습니다.
examples/sort_stability.c:
/*
 * sort_stability.c - 안정 정렬 vs 불안정 정렬
 * 15주차: 정렬과 검색 알고리즘
 *
 * 안정(stable) 정렬: 키가 같은 원소들의 "원래 순서"가 유지된다.
 *
 * 왜 중요한가? 다단계 정렬 때문입니다.
 * "이름순으로 정렬된 명단을 학년순으로 다시 정렬"하면
 * - 안정 정렬: 같은 학년 안에서 이름순이 유지된다! (엑셀처럼)
 * - 불안정 정렬: 같은 학년 안의 순서가 뒤죽박죽
 *
 * 안정: 버블, 삽입, 병합, 카운팅
 * 불안정: 선택, 퀵, 힙
 */
#include <stdio.h>
#include <string.h>

typedef struct {
    char name[12];
    int  grade;
} Student;

#define N 7

void print_students(const char *label, const Student s[], int n) {
    printf("%s\n", label);
    for (int i = 0; i < n; i++) {
        printf("  %d학년 %s\n", s[i].grade, s[i].name);
    }
}

/* 안정 정렬: 삽입 정렬 (학년 기준) */
void insertion_by_grade(Student arr[], int n) {
    for (int i = 1; i < n; i++) {
        Student key = arr[i];
        int j = i - 1;
        /* 주의: > 만 밀어낸다. >= 로 쓰면 같은 학년의 순서가 뒤집혀
         * 불안정해진다! 부등호 하나가 안정성을 좌우한다. */
        while (j >= 0 && arr[j].grade > key.grade) {
            arr[j + 1] = arr[j];
            j--;
        }
        arr[j + 1] = key;
    }
}

/* 불안정 정렬: 선택 정렬 (학년 기준) */
void selection_by_grade(Student arr[], int n) {
    for (int i = 0; i < n - 1; i++) {
        int min = i;
        for (int j = i + 1; j < n; j++) {
            if (arr[j].grade < arr[min].grade) min = j;
        }
        if (min != i) {
            /* 멀리 있는 원소와 "점프 교환" - 이 과정에서
             * 같은 키 원소들의 상대 순서가 깨진다 */
            Student t = arr[i]; arr[i] = arr[min]; arr[min] = t;
        }
    }
}

/* 이름 기준 삽입 정렬 (1차 정렬용, 안정) */
void insertion_by_name(Student arr[], int n) {
    for (int i = 1; i < n; i++) {
        Student key = arr[i];
        int j = i - 1;
        while (j >= 0 && strcmp(arr[j].name, key.name) > 0) {
            arr[j + 1] = arr[j];
            j--;
        }
        arr[j + 1] = key;
    }
}

int main(void) {
    Student roster[N] = {
        {"다은", 2}, {"가람", 1}, {"나비", 3}, {"라온", 1},
        {"마루", 2}, {"바다", 1}, {"사랑", 3},
    };

    printf("=== 목표: 학년순, 같은 학년은 이름순 ===\n\n");

    /* 1차: 이름순 정렬 */
    insertion_by_name(roster, N);
    print_students("[1단계] 이름순 정렬:", roster, N);

    /* 2차: 학년순 - 안정 정렬로 */
    Student stable[N];
    memcpy(stable, roster, sizeof(roster));
    insertion_by_grade(stable, N);
    printf("\n");
    print_students("[2단계-안정(삽입)] 학년순 재정렬:", stable, N);
    printf("  -> 같은 학년 안에서 이름순 유지! (가람<라온<바다)\n");

    /* 2차: 학년순 - 불안정 정렬로 */
    Student unstable[N];
    memcpy(unstable, roster, sizeof(roster));
    selection_by_grade(unstable, N);
    printf("\n");
    print_students("[2단계-불안정(선택)] 학년순 재정렬:", unstable, N);
    printf("  -> 같은 학년 안의 이름순이 깨졌다!\n");

    printf("\n=== 분류표 ===\n");
    printf("  안정   : 버블, 삽입, 병합, 카운팅/기수\n");
    printf("  불안정 : 선택, 퀵, 힙\n");
    printf("\n실전 팁:\n");
    printf("1. C의 qsort는 안정성을 보장하지 않는다!\n");
    printf("   다단계 정렬이 필요하면 비교 함수에 2차 키를 넣어라:\n");
    printf("   if (학년 같으면) return strcmp(이름);\n");
    printf("2. 불안정 정렬도 (원래 인덱스)를 키에 붙이면 안정화 가능\n");
    return 0;
}
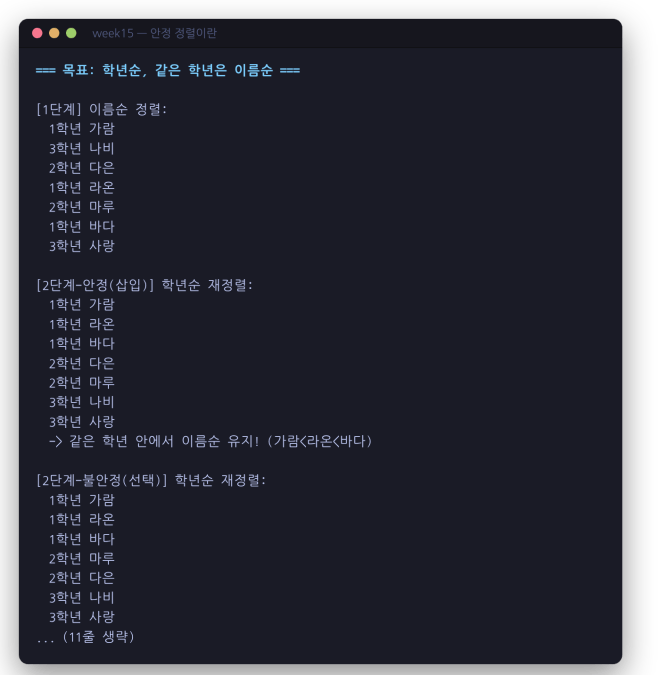
안정 정렬이란
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=c11 -g examples/sort_stability.c -o build/sort_stability
$ ./build/sort_stability
=== 목표: 학년순, 같은 학년은 이름순 ===

[1단계] 이름순 정렬:
  1학년 가람
  3학년 나비
  2학년 다은
  1학년 라온
  2학년 마루
  1학년 바다
  3학년 사랑

[2단계-안정(삽입)] 학년순 재정렬:
  1학년 가람
  1학년 라온
  1학년 바다
  2학년 다은
  2학년 마루
  3학년 나비
  3학년 사랑
  -> 같은 학년 안에서 이름순 유지! (가람<라온<바다)

[2단계-불안정(선택)] 학년순 재정렬:
  1학년 가람
  1학년 라온
  1학년 바다
  2학년 마루
  2학년 다은
  3학년 나비
  3학년 사랑
  -> 같은 학년 안의 이름순이 깨졌다!
2학년을 보세요. 안정 정렬은 다은 → 마루(이름순 유지), 불안정 정렬은 마루 → 다은(뒤집힘)입니다. 1학년과 3학년은 둘 다 이름순인데, 이것은 우연입니다. 불안정 정렬은 “때로는 유지되고 때로는 깨진다”이고, 보장이 없다는 것이 문제입니다.
7.2 다단계 정렬의 원리
이 예제가 보여 주는 기법이 실무에서 정말 유용합니다.
“학년순, 같은 학년은 이름순”을 원한다면 → 이름순으로 먼저 정렬하고, 그다음 학년순으로 안정 정렬한다.
순서가 거꾸로라는 점이 핵심입니다. 가장 중요한 기준(1차 키)으로 마지막에 정렬합니다. 앞 단계의 결과가 안정성 덕분에 보존되니까요. 5절의 기수 정렬이 낮은 자리부터 정렬한 것과 완전히 같은 원리입니다. 1의 자리가 “이름”, 10의 자리가 “학년”인 셈입니다.
엑셀에서 정렬 기준을 여러 개 지정할 수 있는 것, 파일 탐색기에서 “종류로 정렬한 뒤 이름으로 정렬”이 자연스럽게 동작하는 것이 전부 안정 정렬 덕분입니다.
7.3 왜 어떤 정렬은 불안정한가
코드에 답이 주석으로 달려 있습니다.
/* 안정: 삽입 정렬 */
        while (j >= 0 && arr[j].grade > key.grade) {
> 만 밀어냅니다. 학년이 같으면(==) 멈추므로 key 는 같은 학년의 뒤에 놓입니다. 원래 순서 유지입니다. 1절의 arr[j] <= key 와 같은 뜻을 반대편에서 쓴 것입니다.
실험: > 를 >= 로 바꾸면?
같은 학년도 밀어내도록 >= 로 바꾸고 이름순 명단을 학년순으로 정렬하면 이렇습니다.
이름순 명단을 학년순으로 (>= 사용):
  1학년 바다
  1학년 라온
  1학년 가람
  2학년 마루
  2학년 다은
  3학년 사랑
  3학년 나비
세 학년 모두 이름순이 정확히 거꾸로입니다. 같은 학년을 만날 때마다 밀어내고 그 앞에 끼어들었으니, 나중에 온 것이 항상 앞에 서게 됐습니다. 글자 하나(=)가 정렬을 “안정”에서 “확실히 뒤집음”으로 바꿨습니다. 코드를 읽을 때 부등호의 = 유무를 그냥 지나치면 안 되는 이유입니다.
/* 불안정: 선택 정렬 */
        if (min != i) {
            Student t = arr[i]; arr[i] = arr[min]; arr[min] = t;
        }
선택 정렬이 불안정한 이유는 멀리 있는 원소와 점프 교환을 하기 때문입니다. 실행 결과를 따라가 봅시다. 이름순 명단 [1-가람, 3-나비, 2-다은, 1-라온, 2-마루, 1-바다, 3-사랑] 에서 두 번째 바퀴(i=1)의 주인은 1학년 라온입니다. 라온이 1번 자리로 오면서 그 자리에 있던 3-나비가 라온의 자리(3번)로 날아갑니다. 나비는 2-다은을 뛰어넘었지만 학년이 다르니 상관없습니다. 그런데 세 번째 바퀴(i=2)에서 1학년 바다가 2번 자리로 오면서 2-다은이 바다의 자리(5번)로 날아가고, 그 사이에 있던 2-마루를 뛰어넘습니다. 이 순간 2학년의 순서가 마루, 다은 으로 뒤집혔습니다. 이후로는 이 순서를 되돌릴 기회가 없습니다.
퀵 정렬과 힙 정렬도 같은 이유로 불안정합니다. 파티션의 swap 과 힙의 sift_down 이 모두 멀리 떨어진 원소를 교환합니다.
7.4 분류표와 실전 대처
| 안정 | 불안정 |
|---|---|
| 버블, 삽입, 병합, 카운팅, 기수, 버킷 | 선택, 퀵, 힙 |
외우는 요령이 있습니다. 이웃끼리만 움직이면 안정, 멀리 점프하면 불안정입니다.
그리고 실전에서 가장 중요한 사실 하나.
C 표준 라이브러리의
qsort는 안정성을 보장하지 않습니다.
이름은 quick sort 에서 왔지만 실제 구현은 라이브러리마다 다르고, 표준 문서 어디에도 “같은 키의 순서를 유지한다”는 말이 없습니다. 그럼 우리 환경의 qsort 는 실제로 어떨까요? 키(0, 1, 2 중 하나)와 원래 위치를 기록한 레코드를 qsort 로 정렬한 뒤, 같은 키 안에서 원래 위치가 뒤집힌 곳이 있는지 세어 봤습니다.
n=       7: 같은 키 안에서 원래 순서가 뒤집힌 곳 0개 -> 안정으로 동작
n=    1000: 같은 키 안에서 원래 순서가 뒤집힌 곳 0개 -> 안정으로 동작
n=  100000: 같은 키 안에서 원래 순서가 뒤집힌 곳 0개 -> 안정으로 동작
n= 1000000: 같은 키 안에서 원래 순서가 뒤집힌 곳 0개 -> 안정으로 동작
이 컴퓨터의 glibc 2.39 에서는 100만 개까지 한 번도 뒤집히지 않았습니다. glibc 의 qsort 는 메모리를 확보할 수 있으면 병합 정렬을 쓰기 때문입니다. 그러나 이것에 의존하면 안 됩니다. 다른 라이브러리(musl, macOS, 윈도우)에서는 다르게 동작하고, glibc 도 메모리가 부족하면 다른 알고리즘으로 바꿉니다. “우리 컴퓨터에서 되더라”는 표준의 보장이 아닙니다.
다단계 정렬이 필요하면 두 가지 방법이 있습니다.
방법 1 — 비교 함수에 2차 키를 넣기 (권장):
int cmp_student(const void *a, const void *b) {
    const Student *x = a, *y = b;
    if (x->grade != y->grade) return (x->grade > y->grade) - (x->grade < y->grade);
    return strcmp(x->name, y->name);     /* 학년이 같으면 이름으로 */
}
“학년이 다르면 학년으로, 같으면 이름으로”를 비교 함수 하나에 넣습니다. 한 번의 qsort 로 끝나고 안정성에 의존하지 않으니 가장 깔끔합니다.
방법 2 — 원래 위치를 키에 추가하기: 레코드에 original_index 필드를 넣고 최종 비교 기준으로 씁니다. 모든 원소의 키가 서로 달라지므로 “같은 키”가 아예 없어지고, 어떤 불안정 정렬도 안정 정렬처럼 동작합니다.
비교 함수의 함정: a - b
방법 1의 비교 함수에서 (x > y) - (x < y) 라는 낯선 식이 나왔습니다. 그냥 return x - y; 라고 쓰면 안 될까요? 큰 값이면 양수, 작은 값이면 음수가 나오니 될 것 같습니다. 7주차에서 잠깐 언급한 이 함정을 이번에 직접 밟아 봅시다.
int cmp_sub(const void *a, const void *b) { return *(const int *)a - *(const int *)b; }
INT_MAX=2147483647, INT_MIN=-2147483648
a - b 로 정렬  : 2147483647 -2147483648 -100 -1 0 100
(a>b)-(a<b) 정렬: -2147483648 -100 -1 0 100 2147483647
INT_MAX - (-1) = -2147483648  <- 양수여야 하는데 음수
a - b 버전은 21억이 맨 앞에 왔습니다. 2147483647 - (-1) 은 2147483648 이어야 하는데 int 의 최댓값(2147483647)을 넘어서 오버플로가 일어나고, 결과가 음수 −2147483648 이 됩니다. 비교 함수가 “INT_MAX 가 −1보다 작다”고 답한 것입니다. 2주차에서 본 정의되지 않은 동작입니다. -fsanitize=undefined 로 컴파일하면 정확히 짚어 줍니다.
cmpbug.c:4:63: runtime error: signed integer overflow: 2147483647 - -2147483648 cannot be represented in type 'int'
(x > y) - (x < y) 는 두 비교의 결과(0 또는 1)를 빼는 것이라 값이 항상 −1, 0, 1 중 하나입니다. 절대 넘치지 않습니다. 작은 값만 다룰 때는 a - b 도 문제없지만, 습관은 안전한 쪽으로 들이세요. 이번 주 모든 예제가 이 식을 씁니다.
8. 이진 탐색: 쉬워 보이는 것의 함정
8.1 구현 실수 1위 알고리즘
정렬을 배웠으니 이제 “찾기”입니다. 정렬된 배열에서 값을 찾는 가장 좋은 방법이 이진 탐색(binary search) 입니다. 사전에서 단어를 찾을 때 우리가 하는 그것입니다. 가운데를 펴 보고, 찾는 단어가 그보다 앞이면 앞쪽 절반만, 뒤면 뒤쪽 절반만 다시 봅니다. 한 번 볼 때마다 후보가 절반으로 줄어드니, 10억 개 중에서도 30번이면 찾습니다.
개념은 초등학생도 이해합니다. 그런데 이진 탐색은 구현 실수 1위 알고리즘으로 악명 높습니다. 1946년에 처음 발표됐는데 버그 없는 구현이 논문에 실린 것은 1962년이었다는 이야기가 있을 정도입니다. 더 최근 이야기도 있습니다. 2006년 구글의 조슈아 블로크는 자기가 자바 표준 라이브러리에 넣은 Arrays.binarySearch 에 9년 동안 아무도 모르던 버그가 있었다고 공개했습니다. 그 코드의 원형인 존 벤틀리의 책 『Programming Pearls』(1986)까지 거슬러 올라가면 20년입니다. 그 버그가 바로 아래 함정 1번입니다. 세계 최고의 개발자들이 검토한 코드에서도 살아남은 버그라면, 우리가 조심해야 할 이유는 충분합니다.
examples/binary_search.c:
/*
 * binary_search.c - 이진 탐색과 그 함정들, lower/upper bound
 * 15주차: 정렬과 검색 알고리즘
 *
 * "정렬된 배열에서 절반씩 버리기" - 개념은 쉽지만
 * 이진 탐색은 '구현 실수 1위' 알고리즘으로 악명 높습니다.
 * (자바 표준 라이브러리의 이진 탐색에도 20년 묵은 버그가 있었다!)
 *
 * 3대 함정:
 *   1. mid = (low + high) / 2  -> 덧셈 오버플로우!
 *   2. 경계 조건 (<= vs <, mid-1 vs mid) 실수 -> 무한 루프
 *   3. 중복 값에서 "아무거나" 찾음 -> lower/upper bound가 정답
 */
#include <stdio.h>

/* ---------- 기본 이진 탐색 ---------- */
int binary_search(const int arr[], int n, int target, int *steps) {
    int low = 0, high = n - 1;
    *steps = 0;

    while (low <= high) {
        (*steps)++;
        int mid = low + (high - low) / 2;    /* 오버플로우 안전 공식! */

        if (arr[mid] == target) return mid;
        if (arr[mid] < target)  low = mid + 1;   /* 오른쪽 절반으로 */
        else                    high = mid - 1;  /* 왼쪽 절반으로 */
    }
    return -1;                   /* 없음 */
}

/* ---------- lower_bound: target "이상"이 처음 나오는 위치 ----------
 * 없으면 삽입 위치를 반환 - 그래서 탐색 실패도 유용하다! */
int lower_bound(const int arr[], int n, int target) {
    int low = 0, high = n;       /* high = n (배열 끝 다음까지) */

    while (low < high) {
        int mid = low + (high - low) / 2;
        if (arr[mid] < target) low = mid + 1;
        else                   high = mid;       /* mid가 답일 수도 - 버리지 않는다 */
    }
    return low;
}

/* ---------- upper_bound: target "초과"가 처음 나오는 위치 ---------- */
int upper_bound(const int arr[], int n, int target) {
    int low = 0, high = n;

    while (low < high) {
        int mid = low + (high - low) / 2;
        if (arr[mid] <= target) low = mid + 1;   /* <= 하나만 다르다! */
        else                    high = mid;
    }
    return low;
}

int main(void) {
    /*                 0   1   2   3   4   5   6   7   8   9  10  11 */
    int arr[] =      { 3,  7, 12, 12, 12, 19, 25, 25, 31, 40, 46, 52 };
    int n = 12;

    printf("정렬된 배열: ");
    for (int i = 0; i < n; i++) printf("%d ", arr[i]);
    printf("(12개)\n");

    printf("\n=== 기본 이진 탐색 ===\n");
    int targets[] = {19, 3, 52, 30};
    for (int t = 0; t < 4; t++) {
        int steps;
        int idx = binary_search(arr, n, targets[t], &steps);
        if (idx >= 0) printf("%2d 탐색: 인덱스 %2d (%d번 만에)\n",
                             targets[t], idx, steps);
        else          printf("%2d 탐색: 없음 (%d번 만에 확정)\n",
                             targets[t], steps);
    }
    printf("12개 -> 최대 4번. 10억 개라도 30번! 이것이 log의 힘.\n");

    printf("\n=== 함정 1: mid 계산 오버플로우 ===\n");
    printf("mid = (low + high) / 2       <- low+high가 INT_MAX를 넘으면 음수!\n");
    printf("mid = low + (high - low) / 2 <- 항상 안전. 무조건 이걸로.\n");

    printf("\n=== 함정 2: 중복 값 - 12를 찾으면 어디? ===\n");
    int steps;
    int idx = binary_search(arr, n, 12, &steps);
    printf("기본 탐색: 인덱스 %d (2,3,4 중 '우연히' 걸린 곳!)\n", idx);

    int lo = lower_bound(arr, n, 12);
    int hi = upper_bound(arr, n, 12);
    printf("lower_bound(12) = %d (첫 12의 위치)\n", lo);
    printf("upper_bound(12) = %d (12 다음 값의 위치)\n", hi);
    printf("-> 12의 개수 = %d - %d = %d개 (정렬 배열에서 O(log n) 카운트!)\n",
           hi, lo, hi - lo);

    printf("\n=== lower_bound의 또 다른 재주: 삽입 위치 ===\n");
    int pos = lower_bound(arr, n, 30);
    printf("30은 없지만 lower_bound(30) = %d\n", pos);
    printf("-> \"30을 넣으려면 인덱스 %d에\" (정렬 유지 삽입의 기본기)\n", pos);

    printf("\n=== 범위 검색: 12 이상 31 이하가 몇 개? ===\n");
    int from = lower_bound(arr, n, 12);
    int to = upper_bound(arr, n, 31);
    printf("upper_bound(31) - lower_bound(12) = %d - %d = %d개\n",
           to, from, to - from);
    printf("(13주차에서 '해시는 범위 검색 불가'라 했던 그 문제의 정답!)\n");

    printf("\n외울 것 딱 두 가지:\n");
    printf("1. mid = low + (high - low) / 2\n");
    printf("2. 중복/범위/삽입 위치는 lower/upper bound\n");
    return 0;
}
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=c11 -g examples/binary_search.c -o build/binary_search
$ ./build/binary_search
정렬된 배열: 3 7 12 12 12 19 25 25 31 40 46 52 (12개)

=== 기본 이진 탐색 ===
19 탐색: 인덱스  5 (1번 만에)
 3 탐색: 인덱스  0 (3번 만에)
52 탐색: 인덱스 11 (4번 만에)
30 탐색: 없음 (4번 만에 확정)
12개 -> 최대 4번. 10억 개라도 30번! 이것이 log의 힘.

=== 함정 1: mid 계산 오버플로우 ===
mid = (low + high) / 2       <- low+high가 INT_MAX를 넘으면 음수!
mid = low + (high - low) / 2 <- 항상 안전. 무조건 이걸로.

=== 함정 2: 중복 값 - 12를 찾으면 어디? ===
기본 탐색: 인덱스 2 (2,3,4 중 '우연히' 걸린 곳!)
lower_bound(12) = 2 (첫 12의 위치)
upper_bound(12) = 5 (12 다음 값의 위치)
-> 12의 개수 = 5 - 2 = 3개 (정렬 배열에서 O(log n) 카운트!)

=== lower_bound의 또 다른 재주: 삽입 위치 ===
30은 없지만 lower_bound(30) = 8
-> "30을 넣으려면 인덱스 8에" (정렬 유지 삽입의 기본기)

=== 범위 검색: 12 이상 31 이하가 몇 개? ===
upper_bound(31) - lower_bound(12) = 9 - 2 = 7개
(13주차에서 '해시는 범위 검색 불가'라 했던 그 문제의 정답!)

외울 것 딱 두 가지:
1. mid = low + (high - low) / 2
2. 중복/범위/삽입 위치는 lower/upper bound
8.2 한 걸음씩 따라가기
int binary_search(const int arr[], int n, int target, int *steps) {
    int low = 0, high = n - 1;
    ...
    while (low <= high) {
        int mid = low + (high - low) / 2;
        if (arr[mid] == target) return mid;
        if (arr[mid] < target)  low = mid + 1;
        else                    high = mid - 1;
    }
    return -1;
}
low 와 high 는 “답이 있을 수 있는 범위”의 양 끝입니다. 처음엔 배열 전체 [0, 11] 입니다. mid 는 그 가운데이고, arr[mid] 를 찾는 값과 비교해서 범위를 절반으로 줄입니다. 배열 3 7 12 12 12 19 25 25 31 40 46 52 에서 세 가지 경우를 추적하면 이렇습니다.
19를 찾을 때 (한 번에 찾는 운 좋은 경우):
| 단계 | low | high | mid | arr[mid] | 판단 |
|---|---|---|---|---|---|
| 1 | 0 | 11 | 5 | 19 | 찾음 → 인덱스 5 반환 |
3을 찾을 때 (맨 앞에 있는 값):
| 단계 | low | high | mid | arr[mid] | 판단 |
|---|---|---|---|---|---|
| 1 | 0 | 11 | 5 | 19 | 19 > 3, 왼쪽으로 (high = 4) |
| 2 | 0 | 4 | 2 | 12 | 12 > 3, 왼쪽으로 (high = 1) |
| 3 | 0 | 1 | 0 | 3 | 찾음 → 인덱스 0 반환 |
30을 찾을 때 (없는 값):
| 단계 | low | high | mid | arr[mid] | 판단 |
|---|---|---|---|---|---|
| 1 | 0 | 11 | 5 | 19 | 19 < 30, 오른쪽으로 (low = 6) |
| 2 | 6 | 11 | 8 | 31 | 31 > 30, 왼쪽으로 (high = 7) |
| 3 | 6 | 7 | 6 | 25 | 25 < 30, 오른쪽으로 (low = 7) |
| 4 | 7 | 7 | 7 | 25 | 25 < 30, 오른쪽으로 (low = 8) |
| 끝 | 8 | 7 | low > high → 없음, −1 반환 |
범위가 12 → 5 → 2 → 1 → 0 으로 줄어듭니다. 매번 절반이니 12개면 최대 4번(2⁴ = 16 ≥ 12), 10억 개면 30번(2³⁰ ≈ 10.7억)입니다. 이것이 O(log n)입니다.
마지막 표를 보세요. low = 8, high = 7 로 low 가 high 를 넘어서는 순간 “없다”가 확정됩니다. 범위가 비었다는 뜻입니다. 이 종료 조건이 다음 함정들과 직결됩니다.
8.3 함정 1: mid 오버플로
int mid = (low + high) / 2;          /* 위험! */
int mid = low + (high - low) / 2;    /* 안전. 항상 이 공식으로 */
두 식은 수학적으로 같은 값입니다. 그런데 C 에서는 다릅니다. low + high 가 int 의 최댓값(약 21억)을 넘으면 어떻게 될까요? 원소가 10억 개 넘는 배열은 흔치 않으니, 큰 인덱스만 넣어서 두 식을 비교해 봅시다.
low=2000000000 high=2100000000
(low + high) / 2       = -97483648
low + (high - low) / 2 = 2050000000
첫 번째 식은 음수가 나왔습니다. 20억 + 21억 = 41억이 int 에 들어가지 않아 오버플로가 일어난 것입니다. 이 음수로 arr[mid] 를 읽으면 배열 앞쪽 바깥, 엉뚱한 메모리를 읽습니다. 운이 좋으면 즉시 죽고, 나쁘면 이상한 값을 돌려주고 아무 일 없다는 듯 계속 돕니다. 7절의 비교 함수와 같은 종류의 정의되지 않은 동작이고, -fsanitize=undefined 가 역시 잡아 줍니다.
midovf.c:4:18: runtime error: signed integer overflow: 2000000000 + 2100000000 cannot be represented in type 'int'
두 번째 식은 왜 안전할까요? high - low 는 배열 크기를 넘지 않으니 오버플로가 없고, 그 절반을 low 에 더한 값은 high 를 넘지 않기 때문입니다.
이 버그의 무서운 점은 작은 배열에서는 절대 재현되지 않는다는 것입니다. 테스트를 전부 통과하고 배포된 뒤, 몇 년 후 데이터가 커졌을 때 터집니다. 자바 라이브러리에서 9년 동안 발견되지 않은 이유입니다. 그래서 조건 반사적으로 안전한 공식을 쓰는 습관을 들여야 합니다. 이번 주 모든 예제가 low + (high - low) / 2 를 씁니다. 2절 병합 정렬의 mid 도 같은 식이었습니다.
8.4 함정 2: 경계 조건
    while (low <= high) {            /* <= 인가 < 인가? */
        ...
        if (arr[mid] < target)  low = mid + 1;    /* mid+1 인가 mid 인가? */
        else                    high = mid - 1;
    }
기본 이진 탐색에서 low <= high 와 mid ± 1 은 한 세트입니다. high = n - 1 로 시작해서 [low, high] 양쪽 끝을 포함하는 범위를 쓰므로, low == high 일 때 남은 한 칸도 검사해야 하고(따라서 <=), mid 는 방금 검사했으니 다음 범위에서 빼야 합니다(따라서 ± 1).
실험: high = mid - 1 을 high = mid 로 쓰면?
“mid 도 혹시 답일지 모르니 남겨 두자”는 생각으로 high = mid 로 고치고 {1, 3, 5, 7, 9} 에서 없는 값 2를 찾아 보겠습니다. 2초 뒤에 강제 종료하는 timeout 명령으로 실행합니다.
$ timeout 2 ./bsloop
반복 1: low=0 high=4 mid=2
반복 2: low=0 high=2 mid=1
반복 3: low=0 high=1 mid=0
반복 4: low=1 high=1 mid=1
반복 5: low=1 high=1 mid=1
반복 6: low=1 high=1 mid=1
종료됨
종료 코드 124 (timeout 이 죽였으면 124)
무한 루프입니다. 4번째 반복부터 low = 1, high = 1, mid = 1 이 영원히 반복됩니다. arr[1] = 3 > 2 이니 high = mid = 1 로 바꾸는데, high 는 이미 1이라 범위가 줄지 않습니다. mid - 1 이었다면 high = 0 이 되어 low > high 로 끝났을 것입니다.
반대로 while (low < high) 로 쓰면 무한 루프는 없지만, low == high 인 마지막 한 칸을 검사하지 않고 끝나서 맨 끝에 있는 값을 못 찾습니다. 위 표에서 30을 찾을 때 4단계 low = 7, high = 7 이 바로 그 경우입니다.
이 조합을 헷갈리지 않는 요령은 하나입니다. “범위가 매 반복마다 반드시 줄어드는가?” 를 확인하세요. 줄지 않는 경로가 하나라도 있으면 무한 루프이고, 검사 안 하고 버리는 칸이 있으면 못 찾는 값이 생깁니다.
8.5 함정 3: 중복 값, 그리고 lower/upper bound
실행 결과에서 12를 찾았더니 인덱스 2가 나왔습니다. 그런데 12는 인덱스 2, 3, 4에 세 개 있습니다. 기본 이진 탐색은 그중 “우연히 걸린” 하나를 돌려줄 뿐 어느 것인지 보장하지 않습니다. 이 배열에서는 2가 걸렸지만, 배열이 조금만 달라도 3이나 4가 걸립니다.
실무에서는 보통 “첫 번째”나 “마지막”이 필요합니다. 그 답이 lower_bound 와 upper_bound 입니다.
- lower_bound(x): x 이상인 값이 처음 나오는 위치
- upper_bound(x): x 초과인 값이 처음 나오는 위치
int lower_bound(const int arr[], int n, int target) {
    int low = 0, high = n;       /* high = n (배열 끝 다음까지) */

    while (low < high) {
        int mid = low + (high - low) / 2;
        if (arr[mid] < target) low = mid + 1;
        else                   high = mid;       /* mid가 답일 수도 - 버리지 않는다 */
    }
    return low;
}
기본 탐색과 다른 점이 세 가지입니다.
| 기본 탐색 | lower_bound | |
|---|---|---|
| 범위 | [low, high] 양 끝 포함, high = n - 1 |
[low, high) 끝은 미포함, high = n |
| 반복 조건 | low <= high |
low < high |
| 왼쪽으로 갈 때 | high = mid - 1 (mid 는 답이 아님) |
high = mid (mid 가 답일 수 있음) |
high = n 으로 시작하는 이유는 “모든 원소가 target 보다 작다”면 답이 배열 끝 다음(n) 이어야 하기 때문입니다. 그리고 arr[mid] >= target 일 때 mid 를 버리지 않습니다. mid 가 “target 이상인 첫 위치”일 수 있으니까요. 그래도 무한 루프에 빠지지 않는 이유는 high = mid 가 항상 범위를 줄이기 때문입니다. [low, high) 에서 mid < high 이므로 high = mid 는 반드시 high 를 작게 만듭니다. 8.4절의 무한 루프와 달리, 이 형태에서는 high = mid 가 안전합니다. 범위의 정의가 다르면 안전한 갱신도 다릅니다.
12를 찾는 과정을 따라가 봅시다.
| 단계 | low | high | mid | arr[mid] | 판단 |
|---|---|---|---|---|---|
| 1 | 0 | 12 | 6 | 25 | 25 ≥ 12, high = 6 (mid 는 답 후보) |
| 2 | 0 | 6 | 3 | 12 | 12 ≥ 12, high = 3 (mid 는 답 후보) |
| 3 | 0 | 3 | 1 | 7 | 7 < 12, low = 2 |
| 4 | 2 | 3 | 2 | 12 | 12 ≥ 12, high = 2 (mid 는 답 후보) |
| 끝 | 2 | 2 | low == high → 2 반환 |
2단계에서 12를 만났지만 멈추지 않고 더 왼쪽에 12가 있는지 계속 확인합니다. 그래서 세 개의 12 중 첫 번째(인덱스 2)를 정확히 찾습니다.
upper_bound 는 부등호 하나만 다릅니다.
if (arr[mid] <= target) low = mid + 1; /* <= 하나만 다르다! */
< 가 <= 로 바뀌면 “target 과 같은 것도 왼쪽에 둔다”는 뜻이 되어, 결과가 “target 초과의 첫 위치”가 됩니다. 이번 주 세 번째로 등장한 “부등호 하나가 뜻을 바꾸는” 예입니다.
8.6 bound 함수의 세 가지 활용
이 둘만 있으면 실전 검색 문제의 대부분이 풀립니다.
개수 세기: upper_bound(x) - lower_bound(x)
lower_bound(12) = 2, upper_bound(12) = 5 → 12는 5 - 2 = 3개
정렬된 배열에서 특정 값이 몇 개인지를 O(log n) 에 셉니다. 처음부터 끝까지 세면 O(n)입니다.
삽입 위치 찾기: lower_bound(x)
30은 배열에 없지만 lower_bound(30) = 8
→ 인덱스 8에 넣으면 정렬이 유지된다
탐색에 실패해도 유용한 정보를 줍니다. 위의 lower_bound(30) 추적을 보면 4단계 low = 7, high = 8, mid = 7, arr[7] = 25 < 30 에서 low = 8 이 되어 끝납니다. 31이 있는 자리입니다. 정렬 상태를 유지하며 원소를 추가하는 모든 코드의 기본기입니다.
범위 검색: upper_bound(끝) - lower_bound(시작)
12 이상 31 이하 = upper_bound(31) - lower_bound(12) = 9 - 2 = 7개
13주차에서 “해시 테이블은 범위 검색을 못 한다”고 했던 것을 기억하시나요? 그 문제의 답이 정렬 배열 + bound 함수입니다. 데이터베이스가 인덱스를 정렬된 구조(B-트리)로 유지하는 이유도 결국 이것입니다. WHERE price BETWEEN 1000 AND 5000 같은 질의를 O(log n + k)에 처리할 수 있습니다. k는 결과 개수입니다.
9. 검색의 변형들
이진 탐색이 만능은 아닙니다. 상황별로 더 나은 선택이 있고, 각각 요구하는 조건이 다릅니다.
examples/search_variants.c:
/*
 * search_variants.c - 검색의 변형들: 보간, 지수, 삼분 검색
 * 15주차: 정렬과 검색 알고리즘
 *
 * 이진 탐색이 만능은 아닙니다. 상황별 특화 버전들:
 *
 * 보간 검색: "값이 고르게 퍼져 있다면 위치를 '추정'하자"
 *   전화번호부에서 '홍길동'을 찾을 때 중간을 펴지 않고
 *   뒤쪽을 펴는 것과 같다. 균등 분포면 O(log log n)!
 *
 * 지수 검색: "끝을 모르는" 배열에서. 범위를 2배씩 늘려 찾고
 *   그 안에서 이진 탐색. 무한 스트림/링크드 파일에 유용.
 *
 * 삼분 검색: 정렬 배열이 아니라 "산 모양(단봉) 함수"의
 *   꼭대기를 찾는다. 최적화 문제의 기본기.
 */
#include <stdio.h>

static int probes;

/* ---------- 1. 보간 검색 ---------- */
int interpolation_search(const int arr[], int n, int target) {
    int low = 0, high = n - 1;
    probes = 0;

    while (low <= high && target >= arr[low] && target <= arr[high]) {
        probes++;
        if (arr[high] == arr[low]) break;        /* 0 나눗셈 방지 */

        /* 위치 추정: 값의 비율만큼 안으로 들어간다 */
        int pos = low + (int)((long long)(target - arr[low])
                              * (high - low) / (arr[high] - arr[low]));

        if (arr[pos] == target) return pos;
        if (arr[pos] < target) low = pos + 1;
        else                   high = pos - 1;
    }
    if (low <= high && arr[low] == target) { probes++; return low; }
    return -1;
}

int binary_search_count(const int arr[], int n, int target) {
    int low = 0, high = n - 1;
    probes = 0;
    while (low <= high) {
        probes++;
        int mid = low + (high - low) / 2;
        if (arr[mid] == target) return mid;
        if (arr[mid] < target) low = mid + 1;
        else                   high = mid - 1;
    }
    return -1;
}

/* ---------- 2. 지수 검색 ---------- */
int exponential_search(const int arr[], int n, int target) {
    probes = 0;
    if (arr[0] == target) return 0;

    /* 1, 2, 4, 8, ... 범위를 두 배씩 넓히며 "울타리" 찾기 */
    int bound = 1;
    while (bound < n && arr[bound] < target) {
        probes++;
        printf("      범위 확장: [%d..%d]\n", bound, bound * 2);
        bound *= 2;
    }

    /* [bound/2, min(bound, n-1)] 구간에서 이진 탐색 */
    int low = bound / 2;
    int high = (bound < n) ? bound : n - 1;
    while (low <= high) {
        probes++;
        int mid = low + (high - low) / 2;
        if (arr[mid] == target) return mid;
        if (arr[mid] < target) low = mid + 1;
        else                   high = mid - 1;
    }
    return -1;
}

/* ---------- 3. 삼분 검색: 단봉 함수의 꼭대기 ---------- */
/* 예시 함수: x = 37에서 최대가 되는 산 모양 */
long long peak_function(int x) {
    long long d = x - 37;
    return 1000 - d * d;
}

int ternary_search(int low, int high) {
    probes = 0;
    while (high - low > 2) {
        probes++;
        int m1 = low + (high - low) / 3;
        int m2 = high - (high - low) / 3;

        if (peak_function(m1) < peak_function(m2)) {
            low = m1 + 1;        /* 꼭대기는 m1 오른쪽에 */
        } else {
            high = m2 - 1;       /* 꼭대기는 m2 왼쪽에 (또는 사이) */
        }
    }
    /* 남은 2~3개 중 최대 */
    int best = low;
    for (int x = low + 1; x <= high; x++) {
        if (peak_function(x) > peak_function(best)) best = x;
    }
    return best;
}

int main(void) {
    /* 균등하게 퍼진 데이터 (보간 검색의 홈그라운드) */
    #define N 1000
    static int uniform[N];
    for (int i = 0; i < N; i++) uniform[i] = i * 10;     /* 0,10,20,... */

    printf("=== 1. 보간 검색 vs 이진 탐색 (균등 데이터 %d개) ===\n", N);
    int targets[] = {50, 4500, 9990};
    for (int t = 0; t < 3; t++) {
        binary_search_count(uniform, N, targets[t]);
        int bin_probes = probes;
        interpolation_search(uniform, N, targets[t]);
        printf("  %4d 탐색: 이진 %2d번, 보간 %2d번\n",
               targets[t], bin_probes, probes);
    }
    printf("  균등 분포에선 보간이 거의 한 번에 맞힌다 (위치를 계산하니까)\n");

    /* 한쪽에 몰린 데이터 (보간의 약점) */
    static int skewed[N];
    for (int i = 0; i < N - 1; i++) skewed[i] = i;       /* 0~998 */
    skewed[N - 1] = 1000000;                             /* 마지막만 백만! */

    printf("\n[몰린 데이터: 0~998 + 1000000]\n");
    binary_search_count(skewed, N, 998);
    printf("  998 탐색: 이진 %2d번, ", probes);
    interpolation_search(skewed, N, 998);
    printf("보간 %2d번 <- 추정이 계속 빗나간다!\n", probes);

    printf("\n=== 2. 지수 검색: 앞쪽에 있는 값을 빨리 ===\n");
    printf("  30 탐색 과정:\n");
    int idx = exponential_search(uniform, N, 30);
    printf("  결과: 인덱스 %d (%d번 접근)\n", idx, probes);
    printf("  용도: 크기를 모르는/무한한 정렬 데이터, 앞쪽 편중 접근\n");

    printf("\n=== 3. 삼분 검색: 산의 꼭대기 찾기 ===\n");
    printf("  f(x) = 1000 - (x-37)^2, 구간 [0, 1000]\n");
    int peak = ternary_search(0, 1000);
    printf("  꼭대기: x = %d, f(x) = %lld (%d번 반복)\n",
           peak, peak_function(peak), probes);
    printf("  정렬 안 된 데이터라도 '단봉'이면 log 시간에 최댓값!\n");
    printf("  (이진 탐색: 정렬 필요 / 삼분 검색: 단봉 필요)\n");

    printf("\n선택 가이드:\n");
    printf("  일반 정렬 데이터        -> 이진 탐색 (기본값)\n");
    printf("  균등 분포 확신          -> 보간 검색\n");
    printf("  크기 미상/앞쪽 편중     -> 지수 검색\n");
    printf("  단봉 함수 최적화        -> 삼분 검색\n");
    return 0;
}
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=c11 -g examples/search_variants.c -o build/search_variants
$ ./build/search_variants
=== 1. 보간 검색 vs 이진 탐색 (균등 데이터 1000개) ===
    50 탐색: 이진 10번, 보간  1번
  4500 탐색: 이진 10번, 보간  1번
  9990 탐색: 이진 10번, 보간  1번
  균등 분포에선 보간이 거의 한 번에 맞힌다 (위치를 계산하니까)

[몰린 데이터: 0~998 + 1000000]
  998 탐색: 이진  9번, 보간 999번 <- 추정이 계속 빗나간다!

=== 2. 지수 검색: 앞쪽에 있는 값을 빨리 ===
  30 탐색 과정:
      범위 확장: [1..2]
      범위 확장: [2..4]
  결과: 인덱스 3 (3번 접근)
  용도: 크기를 모르는/무한한 정렬 데이터, 앞쪽 편중 접근

=== 3. 삼분 검색: 산의 꼭대기 찾기 ===
  f(x) = 1000 - (x-37)^2, 구간 [0, 1000]
  꼭대기: x = 37, f(x) = 1000 (14번 반복)
  정렬 안 된 데이터라도 '단봉'이면 log 시간에 최댓값!
  (이진 탐색: 정렬 필요 / 삼분 검색: 단봉 필요)

선택 가이드:
  일반 정렬 데이터        -> 이진 탐색 (기본값)
  균등 분포 확신          -> 보간 검색
  크기 미상/앞쪽 편중     -> 지수 검색
  단봉 함수 최적화        -> 삼분 검색
9.1 보간 검색: 위치를 추정한다
전화번호부에서 “홍길동”을 찾을 때 우리는 중간을 펴지 않습니다. ㅎ은 맨 뒤 글자니 뒤쪽을 폅니다. 값의 분포를 알고 있으니 위치를 추정하는 것입니다. 그 직관을 식으로 옮긴 것이 보간(interpolation) 검색입니다.
        int pos = low + (int)((long long)(target - arr[low])
                              * (high - low) / (arr[high] - arr[low]));
읽는 법: “target 이 arr[low] 와 arr[high] 사이에서 몇 퍼센트 지점인가”를 구해서, 인덱스 범위에서 같은 퍼센트 지점을 바로 찔러 봅니다. 균등 데이터 0, 10, 20, ..., 9990 에서 4500을 찾는 첫 시도를 숫자로 보면 이렇습니다.
low=0(값 0) high=999(값 9990) -> pos = 0 + (4500-0)*(999-0)/(9990-0) = 450, arr[pos]=4500
4500은 0~9990 의 45% 지점이니 인덱스 999의 45% 지점인 450을 찔렀고, 거기 정확히 4500이 있습니다. 한 번에 찾았습니다. 이진 탐색은 같은 값을 10번 만에 찾습니다. 값이 균등하게 퍼져 있으면 추정이 거의 맞으므로, 평균 O(log log n) 이라는 놀라운 복잡도가 나옵니다.
하지만 반대 경우를 보세요. 0~998 이 촘촘하고 마지막만 1,000,000 인 배열에서 998 을 찾으면 999번입니다. 처음 몇 번의 추정을 보면 왜 그런지 바로 보입니다.
1번째: low=0(값 0) high=999(값 1000000) -> pos = 0 + (998-0)*(999-0)/(1000000-0) = 0, arr[pos]=0
2번째: low=1(값 1) high=999(값 1000000) -> pos = 1 + (998-1)*(999-1)/(1000000-1) = 1, arr[pos]=1
3번째: low=2(값 2) high=999(값 1000000) -> pos = 2 + (998-2)*(999-2)/(1000000-2) = 2, arr[pos]=2
4번째: low=3(값 3) high=999(값 1000000) -> pos = 3 + (998-3)*(999-3)/(1000000-3) = 3, arr[pos]=3
“최댓값이 100만이니 998은 0.1% 지점, 즉 맨 앞이겠지”라고 추정해서 매번 한 칸씩밖에 못 나아갑니다. O(n)으로 완전히 무너졌습니다. 분포를 확신할 수 없으면 쓰지 마세요. 최악이 O(n)인 알고리즘을 최악이 O(log n)인 알고리즘 대신 쓰는 것은 이득이 확실할 때만 정당화됩니다.
(long long) 캐스팅도 짚고 갑시다. (target - arr[low]) * (high - low) 는 두 값이 각각 수천만이면 곱이 int 를 넘칩니다. 곱하기 전에 넓은 타입으로 올려 두는 것, 이번 주에 세 번째로 나오는 오버플로 방어 습관입니다(mid 계산, 비교 함수, 그리고 여기).
9.2 지수 검색: 울타리부터 친다
    int bound = 1;
    while (bound < n && arr[bound] < target) {
        bound *= 2;
    }
    /* [bound/2, min(bound, n-1)] 구간에서 이진 탐색 */
1, 2, 4, 8, 16, … 으로 범위를 두 배씩 넓히다가 target 을 넘어서면 멈추고, 마지막 두 배 사이 구간에서만 이진 탐색을 합니다. 실행 결과에서 30을 찾을 때 [1..2], [2..4] 로 두 번 넓힌 뒤 [2..4] 안에서 찾았습니다.
두 상황에서 유용합니다.
- 크기를 모르는 데이터: 끝을 알 수 없는 스트림이나 파일. 이진 탐색은
high를 알아야 시작할 수 있지만, 지수 검색은arr[bound]를 읽어 보며 나아가므로 크기가 필요 없습니다. - 앞쪽에 몰린 접근: 찾는 값이 대개 앞쪽에 있다면, 전체 크기와 무관하게 O(log i)입니다(i 는 찾는 위치). 배열이 10억 개여도 앞쪽 30번째쯤을 찾는 데 몇 번이면 됩니다.
9.3 삼분 검색: 정렬이 아닌 “산 모양”
이진 탐색은 정렬을 요구합니다. 그런데 정렬되지 않았어도 탐색할 수 있는 경우가 있습니다. 올라갔다가 내려오는 산 모양(단봉, unimodal) 이라면 꼭대기를 O(log n)에 찾을 수 있습니다.
        int m1 = low + (high - low) / 3;
        int m2 = high - (high - low) / 3;

        if (peak_function(m1) < peak_function(m2)) {
            low = m1 + 1;        /* 꼭대기는 m1 오른쪽에 */
        } else {
            high = m2 - 1;       /* 꼭대기는 m2 왼쪽에 (또는 사이) */
        }
구간을 삼등분해 두 지점 m1, m2 를 잡습니다. f(m1) < f(m2) 라면 꼭대기는 확실히 m1 오른쪽에 있습니다. 만약 꼭대기가 m1 왼쪽에 있다면 m1 에서 m2 로 갈수록 내리막이어야 하는데, 실제로는 올라갔으니 모순입니다. 이렇게 매번 구간의 3분의 1을 버리고, 실행 결과에서 [0, 1000] 구간을 14번 만에 x = 37 로 좁혔습니다.
이진 탐색은 “정렬”이 조건이고, 삼분 검색은 “단봉”이 조건입니다. 용도가 아예 다릅니다. 삼분 검색은 최적화 문제에 씁니다. 비용이 최소가 되는 지점, 수익이 최대가 되는 가격 같은 것들입니다.
9.4 선택 가이드
| 상황 | 알고리즘 |
|---|---|
| 일반 정렬 데이터 | 이진 탐색 (기본값) |
| 균등 분포 확신 | 보간 검색 |
| 크기 미상 / 앞쪽 편중 | 지수 검색 |
| 단봉 함수 최적화 | 삼분 검색 |
| 중복 / 범위 / 삽입 위치 | lower / upper bound |
특별한 이유가 없으면 이진 탐색이 정답입니다. 나머지는 조건이 확실할 때 꺼내는 특수 도구입니다.
10. 실습 프로젝트
projects/ 폴더에는 이번 주 내용을 실전 수준으로 묶은 세 프로그램이 있습니다. 0절에서 말했듯 이 셋은 -O2 로 빌드됩니다.
$ cd week15
$ make
$ ./build/sort_library      # 인트로 정렬 vs qsort
$ ./build/external_sort     # 메모리보다 큰 데이터 정렬
$ ./build/benchmark         # 정렬 7종 × 입력 4종 성능표
프로젝트 1: 인트로 정렬 라이브러리 (sort_library.c)
C++ 의 std::sort 가 실제로 쓰는 인트로 정렬(Introsort) 을 만듭니다. 이번 주에 배운 세 정렬을 조합해서 서로의 약점을 메꿉니다.
| 담당 | 알고리즘 | 이유 |
|---|---|---|
| 평소 | 퀵 (median-of-three) | 평균 최강, 제자리 정렬 |
| 재귀 깊이 > 2 log n | 힙으로 교대 | 최악 O(n²) → O(n log n) 방어 |
| 구간 ≤ 16 | 삽입 | 작은 구간은 이쪽이 빠름 (1절) |
typedef int (*cmp_fn)(const void *, const void *);

static void byte_swap(char *a, char *b, size_t size);
static void insertion_range(char *base, size_t lo, size_t hi, ...);
static void sift_down_range(char *base, size_t lo, size_t start, size_t end, ...);
static void heap_sort_range(char *base, size_t lo, size_t hi, ...);
static size_t partition_range(char *base, size_t lo, size_t hi, ...);
static void intro_rec(char *base, size_t lo, size_t hi, size_t depth_limit, ...);
void intro_sort(void *base, size_t count, size_t size, cmp_fn cmp);
인터페이스가 qsort 와 똑같습니다. void * 로 배열을 받고, 원소 개수와 원소 하나의 크기, 비교 함수를 받습니다. 10주차에서 배운 제네릭 프로그래밍입니다. 원소가 int 인지 구조체인지 모르니 교환도 바이트 단위로 합니다.
static void byte_swap(char *a, char *b, size_t size) {
    while (size--) {
        char t = *a; *a++ = *b; *b++ = t;
    }
}
size 가 4면 네 바이트를 한 바이트씩 바꿉니다. 느리지만 어떤 타입에도 통합니다.
깊이 제한이 인트로 정렬의 핵심 아이디어입니다.
void intro_sort(void *base, size_t count, size_t size, cmp_fn cmp) {
    if (count < 2) return;

    /* 깊이 한도 = 2 * log2(n): 이걸 넘으면 피벗 운이 나쁜 것 */
    int depth_limit = 0;
    for (size_t n = count; n > 1; n >>= 1) depth_limit += 2;

    intro_rec(base, 0, count - 1, size, cmp, depth_limit);
}
n >>= 1 은 n 을 2로 나누는 것이니(3주차 비트 연산), 이 반복문은 log₂ n 번 돌면서 depth_limit 을 2씩 올립니다. 100만 개면 약 40입니다. 그리고 재귀 본체에서 이 한도를 씁니다.
    /* intro_rec 안에서 */
        if (n <= SMALL_THRESHOLD) {
            insertion_range(base, lo, hi, size, cmp);    /* 작으면 삽입 */
            return;
        }
        if (depth_limit == 0) {
            heap_sort_range(base, lo, hi, size, cmp);    /* 너무 깊으면 힙 */
            return;
        }
        depth_limit--;
3절에서 봤듯이 균등하게 나뉘면 재귀 깊이는 log n 입니다. 깊이가 그 두 배를 넘었다면 “피벗 선택이 계속 실패하고 있다”는 신호입니다. 그때 퀵을 포기하고 힙 정렬로 갈아타면, 남은 구간이 확실히 O(n log n) 에 끝납니다. 퀵의 평균 성능을 누리면서 최악을 원천 봉쇄하는 것입니다. 3절의 30만 개 세그멘테이션 오류도, median-of-three 를 노린 악의적 입력도 이 한도에 걸려 힙으로 넘어갑니다. 그래서 입력을 통제할 수 없는 서버 코드에서 특히 중요합니다.
스택 깊이 보장도 들어 있습니다.
        /* 작은 쪽만 재귀, 큰 쪽은 루프로 (스택 깊이 O(log n) 보장) */
        if (p > lo && p - lo < hi - p) {
            intro_rec(base, lo, p - 1, size, cmp, depth_limit);
            lo = p + 1;
        } else {
            if (p < hi) intro_rec(base, p + 1, hi, size, cmp, depth_limit);
            if (p == lo) return;
            hi = p - 1;
        }
파티션 후 두 구간 중 작은 쪽만 재귀 호출하고, 큰 쪽은 lo 나 hi 를 바꿔서 같은 while 반복으로 처리합니다. 작은 쪽은 항상 절반 이하이므로 재귀 깊이가 최대 log n 으로 묶입니다. 3절의 30만 개 실험이 스택을 넘긴 것은 재귀 깊이가 n 이었기 때문인데, 이 기법은 그것을 구조적으로 막습니다.
실행 결과입니다.
$ ./build/sort_library
인트로 정렬 라이브러리 (퀵+힙+삽입 하이브리드)
==============================================

[1] 정확성 테스트
  무작위 5개  : 통과
  원소 1개    : 통과
  전부 같음   : 통과
  역순        : 통과
  구조체(점수 내림차순): 이영희(92.0) 정수진(92.0) 김철수(85.5) 박민수(78.3)

[2] 성능 대결: 1000000개 정렬 (표준 qsort vs 우리 intro_sort)
  무작위  qsort   136.5 ms | intro   210.3 ms | 검증 OK
  정렬됨  qsort    28.6 ms | intro   133.8 ms | 검증 OK
  역순     qsort    32.2 ms | intro   306.8 ms | 검증 OK
  중복 많음 qsort    72.4 ms | intro   150.8 ms | 검증 OK
정직하게 말씀드리면 우리 구현이 glibc 의 qsort 보다 느립니다. 1.5~10배 정도입니다. 실망할 필요는 없고, 오히려 여기서 배울 것이 많습니다.
- glibc 의
qsort는 이름과 달리 병합 정렬을 기본으로 씁니다(7절에서 안정성 실험으로 확인했죠). 그래서 정렬됨·역순 입력에서 특히 빠릅니다. 2절에서 병합 정렬은 입력의 모양을 타지 않는다고 했습니다. - 수십 년 다듬어진 구현이라 원소 크기가
int면 전용 코드를 쓰는 식의 최적화가 들어 있습니다. 우리의byte_swap은 바이트 단위 반복문이라 훨씬 느립니다. - 우리 구현은 교육용입니다. 구조를 명확히 보여 주는 것이 목적이라 그런 미세 최적화를 넣지 않았습니다.
“표준 라이브러리를 이기겠다”가 아니라 “표준 라이브러리가 무엇을 하고 있는지 이해한다” 가 이 프로젝트의 목표입니다. 그리고 검증이 전부 OK 라는 것, 우리가 만든 정렬이 100만 개를 네 가지 모양 모두 정확히 정렬한다는 것이 진짜 성과입니다.
확장 아이디어: int 크기 전용 교환 함수로 속도 개선, 안정 버전(병합 기반, 팀소트 방향), 내림차순·키 추출 인터페이스, 스레드 병렬화(20주차 예고)
프로젝트 2: 외부 정렬 (external_sort.c)
“RAM 은 4GB 인데 100GB 로그 파일을 정렬하라.” 실전 단골 문제입니다. 데모는 정수 10만 개를 “메모리에는 8천 개만 올릴 수 있다” 는 제약으로 정렬합니다. 9주차 파일 입출력과 12주차 힙이 여기서 만납니다.
#define TOTAL_COUNT  100000      /* 전체 데이터 개수 */
#define CHUNK_SIZE   8000        /* "메모리 한계": 한 번에 이만큼만! */

int  create_input(void);
int  create_runs(int *run_count);     /* 1단계: 청크별 정렬 → 런 파일 */
void heap_push(MinHeap *h, HeapItem it);
HeapItem heap_pop(MinHeap *h);
int  merge_runs(int run_count);       /* 2단계: k-way 병합 */
int  verify(void);
메모리보다 큰 데이터 정렬
그림은 글을 쓴 뒤 다시 돌린 결과입니다. 벤치마크라서 본문 표와 수치가 몇 % 다릅니다. 배속과 순서가 같은지를 보세요 — 절대값이 아니라 그게 이 측정이 말하려는 것입니다.
2단계 전략입니다.
1단계, 런(run) 생성: 파일을 8천 개씩 읽어 메모리 안에서 qsort 로 정렬한 뒤, 정렬된 임시 파일로 저장합니다. 이 정렬된 조각을 런이라고 부릅니다. 10만 개면 8천 개짜리 12개와 4천 개짜리 1개, 런이 13개 생깁니다.
    while ((got = fread(buffer, sizeof(int), CHUNK_SIZE, in)) > 0) {
        qsort(buffer, got, sizeof(int), cmp_int);    /* 메모리 안에서 정렬 */
        ...
        fwrite(buffer, sizeof(int), got, out);
9주차의 fread 가 “최대 CHUNK_SIZE 개”를 읽고 실제로 읽은 개수를 돌려주는 것을 이용합니다. 마지막 조각은 4천 개만 읽히므로 got 이 4000 입니다.
2단계, k-way 병합: 런 13개의 맨 앞 값을 12주차 최소 힙에 넣고, 최솟값을 꺼내 출력 파일에 쓰고, 그 값이 나온 런에서 다음 값을 보충합니다. 2절의 병합이 두 줄의 맨 앞을 비교했다면, 이것은 13개 줄의 맨 앞을 비교하는 것입니다.
    while (heap.size > 0) {
        HeapItem it = heap_pop(&heap);       /* 전체에서 가장 작은 값 */
        fwrite(&it.value, sizeof(int), 1, out);
        written++;

        /* 그 값이 나온 런에서 다음 값을 보충 */
        int next;
        if (fread(&next, sizeof(int), 1, run_fp[it.run_index]) == 1) {
            heap_push(&heap, (HeapItem){next, it.run_index});
        }
    }
HeapItem 에 값뿐 아니라 어느 런에서 왔는지(run_index)를 함께 넣어 두는 것이 요령입니다. 값을 꺼낸 뒤 같은 런에서 다음 값을 가져와야 하니까요.
$ ./build/external_sort
외부 정렬: 정수 100000개, 메모리 한계 8000개 가정
=============================================

입력 생성: bigdata.bin (정수 100000개, 390 KB)

[1단계] 청크 정렬 -> 런 생성 (8000개씩)
  런  0: 8000개 정렬 -> run_00.tmp
  런  1: 8000개 정렬 -> run_01.tmp
  ...
  런 12: 4000개 정렬 -> run_12.tmp
  총 13개의 정렬된 런

[2단계] 13-way 병합 (최소 힙으로 최솟값 선택)
  병합 완료: 100000개 -> sorted.bin

[검증]
  100000개 전부 오름차순 확인 (체크섬 3269094447)

결과: 성공!
(데모 파일 정리 완료)
힙이 왜 필요한지가 이 프로젝트의 핵심입니다. 런이 13개면 값을 하나 꺼낼 때마다 “13개 후보 중 최솟값”을 골라야 합니다. 후보를 하나씩 보면 O(k), 힙이면 O(log k)입니다. 13개면 차이가 작지만 런이 수백 개가 되면 결정적입니다. 전체는 O(N log k)입니다.
메모리 사용량을 계산해 보세요. 병합 단계에서 메모리에 올라와 있는 것은 런마다 값 하나씩, 총 13개뿐입니다. 전체 데이터가 아무리 커도 메모리 사용량은 런 개수에만 비례합니다. 이것이 “메모리보다 큰 데이터를 정렬한다”는 마법의 정체입니다.
이 기법은 실제로 쓰입니다. 데이터베이스의 ORDER BY 가 메모리를 넘어설 때, 유닉스 sort 명령이 큰 파일을 처리할 때, 맵리듀스가 셔플 단계에서 전부 이 방식입니다. 리눅스에서 sort 로 큰 파일을 정렬해 보면 /tmp 에 임시 파일이 생겼다 사라지는 것을 볼 수 있습니다. 바로 런 파일입니다.
확장 아이디어: 청크 크기와 성능의 관계 측정, 2단계 병합(런이 수백 개일 때는 나눠서 두 번 병합), 문자열 레코드 정렬, 버퍼링으로 입출력 횟수 줄이기
프로젝트 3: 벤치마킹 도구 (benchmark.c)
정렬 7종 × 입력 패턴 4종의 성능표를 자동으로 만듭니다. 모든 결과는 검증(오름차순 + 체크섬)을 통과해야 표에 실립니다.
typedef struct {
    const char *name;
    void (*fn)(int[], int);
    int max_n;                   /* O(n^2) 정렬은 큰 입력 제외 */
} SortEntry;

typedef struct {
    const char *name;
    void (*fill)(int[], int);
} PatternEntry;

void fill_random(int arr[], int n);    /* 무작위 */
void fill_sorted(int arr[], int n);    /* 이미 정렬됨 */
void fill_reverse(int arr[], int n);   /* 역순 */
void fill_fewuniq(int arr[], int n);   /* 중복 많음 (값 8종류) */

long long checksum(const int arr[], int n);
int is_sorted(const int arr[], int n);

정렬 벤치마크
그림은 글을 쓴 뒤 다시 돌린 결과입니다. 벤치마크라서 본문 표와 수치가 몇 % 다릅니다. 배속과 순서가 같은지를 보세요 — 절대값이 아니라 그게 이 측정이 말하려는 것입니다.
함수 포인터 배열로 이중 반복문을 도는 구조입니다. 정렬을 추가하고 싶으면 sorts[] 배열에 한 줄만 넣으면 됩니다. 확장 가능한 테스트 코드를 짜는 전형적인 방법이고, 실제로 이 글을 쓰면서 퀵(무작위) 한 줄을 추가했습니다.
    for (int s = 0; s < ns; s++) {
        for (int p = 0; p < np; p++) {
            rng_state = 42;                      /* 패턴마다 같은 데이터! */
            patterns[p].fill(data, n);
            long long want = checksum(data, n);

            memcpy(work, data, n * sizeof(int));
            clock_t t0 = clock();
            sorts[s].fn(work, n);
            clock_t t1 = clock();

            /* 검증: 정렬됨 + 원소 보존(체크섬) */
            if (!is_sorted(work, n) || checksum(work, n) != want) {
                printf("%12s", "검증실패!");
                continue;
            }
rng_state = 42 로 난수 씨앗을 매번 되돌리는 것도 보세요. 모든 정렬이 똑같은 무작위 데이터를 받아야 공정한 비교입니다.
결과표 읽기
원소 5만 개, 단위는 ms 입니다.
$ ./build/benchmark
정렬 벤치마크: 원소 50000개, 단위 ms

             무작위   정렬됨      역순  중복많음
----------------------------------------------------------
삽입           154.8         0.0       303.5       130.0
선택          2249.6      2241.3      2273.5      2262.3
병합             2.6         0.6         0.6         1.2
퀵(3way)          2.3         3.5         2.7         0.4
퀵(무작위)         2.4         1.3         1.2         0.3
힙                2.4         2.2         1.9         2.0
qsort              3.6         0.9         1.1         2.3
이 표 한 장이 이번 주 전체의 요약입니다. 한 칸씩 읽어 봅시다.
- 삽입의 “정렬됨” 0.0 ms: 무작위(155 ms)와는 비교도 안 됩니다. 1절에서 배운 “거의 정렬된 데이터의 왕”이 실제 시간으로 증명됐습니다. 이 칸 때문에 삽입 정렬이 인트로 정렬의 부품으로 쓰입니다.
- 삽입의 “역순” 304 ms: 같은 알고리즘이 최악의 입력에서는 무작위의 두 배입니다. 역순은 모든 원소가 왼쪽 원소 전부보다 작아서 매번 끝까지 밀어야 하니까요. 알고리즘의 성능은 입력과의 궁합이라는 말의 증거입니다.
- 선택 정렬의 네 칸이 전부 비슷: 2,240 ~ 2,270 ms 로 패턴을 타지 않습니다. 1절에서 봤듯 입력이 어떻든 항상 n(n−1)/2 번 비교하기 때문입니다. 그리고 삽입보다 15배 느립니다. 같은 O(n²)인데도요. 삽입은 제자리를 찾으면 멈추지만 선택은 끝까지 보고, 삽입의 밀기 한 번은 대입 한 번인데 교환은 세 번입니다.
- 병합의 네 칸이 비슷: 2절의 “최악이 없다”입니다. 정렬됨·역순에서 0.6 ms 로 더 빠른 것은 병합 시 한쪽 줄이 먼저 바닥나 “쓸어 담기”만 하기 때문입니다.
- 퀵(3way)의 “중복많음” 0.4 ms: 표에서 가장 빠른 칸에 속합니다. 4절의 3-way 파티션이 위력을 발휘했습니다. 값이 8종류뿐이라 “같다” 구역이 거대해집니다.
- 힙의 안정적인 2 ms: 패턴을 거의 타지 않습니다. 힙 정렬은 최악도 O(n log n)이니까요. 하지만 100만 개 표(아래)에서 보듯 무작위 입력에서 퀵보다 두 배 느립니다. 힙은 배열을 멀리 건너뛰며 접근해 캐시를 계속 놓치기 때문입니다. 10주차의 교훈이 여기서 다시 확인됩니다.
- glibc
qsort: 병합 정렬 기반이라 병합과 같은 모양입니다. 무작위에서 우리 병합보다 조금 느린 것은qsort가 원소 크기를 모르는 제네릭 함수라 비교 함수를 포인터로 부르기 때문입니다.
그리고 이상한 칸이 하나 있습니다. 퀵(3way)의 “정렬됨” 3.5 ms 와 “역순” 2.7 ms 입니다. 무작위(2.3 ms)보다 느립니다. 3절에서 median-of-three 는 정렬된 입력을 방어한다고 했고, 이 구현은 실제로 median-of-three 를 씁니다. 그런데 왜 느릴까요? 그 아래 줄 퀵(무작위)은 같은 입력을 1.3 ms 에 끝냈는데요.
수수께끼: median-of-three 가 있는데 왜 정렬된 입력에서 느릴까
숫자가 작아서 잘 안 보이니 100만 개로 키워 봅시다.
$ ./build/benchmark 1000000
             무작위   정렬됨      역순  중복많음
----------------------------------------------------------
병합            61.6        14.3        14.7        25.6
퀵(3way)         44.6       271.8       196.1         7.5
퀵(무작위)        43.2        28.7        29.2         7.9
힙               90.7        53.9        55.3        51.7
qsort             90.2        24.2        27.8        54.8
퀵(3way)의 정렬됨이 272 ms, 무작위 입력의 6배입니다. 퀵(무작위)은 29 ms 로 정상입니다. 두 구현의 차이는 딱 하나, 피벗을 고르는 방법입니다. median-of-three 가 어딘가에서 실패하고 있습니다.
원인을 찾으려면 파티션이 얼마나 균등하게 나누는지 세어 봐야 합니다. 벤치마크의 퀵 정렬에 카운터를 붙여 100만 개를 돌린 결과입니다.
무작위 비교   18262699  파티션   65535  평균(작은쪽/큰쪽) 129/135
정렬됨 비교  527911035  파티션  572066  평균(작은쪽/큰쪽)   9/913
무작위 입력은 파티션마다 평균 129 대 135 로 거의 반씩 나뉩니다. 그런데 정렬된 입력은 9 대 913 입니다. 한쪽에 거의 다 몰립니다. 파티션 횟수도 9배 많고 비교는 29배 많습니다. median-of-three 가 중앙값을 못 고르고 있다는 뜻입니다.
왜 그럴까요? 정렬된 12개를 딱 한 번 파티션해 보면 답이 보입니다.
피벗 5, 파티션 후: 0 1 2 3 4 5 7 8 9 10 11 6
왼쪽 [0..4]  같음 [5..5]  오른쪽 [6..11]
오른쪽 구간의 세 후보: arr[low]=7 arr[mid]=9 arr[high]=6 -> 중앙값 7 (구간의 최솟값 6 바로 다음!)
첫 파티션은 완벽합니다. 피벗 5가 정확히 가운데입니다. 문제는 오른쪽 구간의 모양입니다. 7 8 9 10 11 6. 정렬돼 있는데 최솟값 6이 맨 뒤에 가 있습니다. 4절의 3-way 파티션을 떠올려 보세요. 피벗보다 큰 값을 만나면 gt 자리와 교환합니다. 정렬된 입력에서는 피벗 오른쪽이 전부 크니까, 6이 맨 뒤(gt)로 밀려나고 나머지가 한 칸씩 당겨집니다.
이 구간에서 median-of-three 는 arr[low] = 7, arr[mid] = 9, arr[high] = 6 을 보고 중앙값 7 을 고릅니다. 7은 이 구간에서 두 번째로 작은 값입니다. 파티션은 “작은 것 1개, 나머지 전부”로 나뉘고, 나머지 구간은 또 같은 모양(정렬됨 + 최솟값이 맨 뒤)이 되어 다음에도 두 번째로 작은 값을 고릅니다. 이것이 평균 9 대 913 의 정체입니다.
median-of-three 가 정렬된 입력을 방어한다는 말은 로무토 파티션 기준이었습니다. 3-way 파티션은 큰 값을 뒤에서부터 끌어오면서 구간의 모양을 바꾸고, 그 바뀐 모양이 median-of-three 를 정확히 속이는 형태입니다. 공격자가 없어도 알고리즘이 스스로 만든 입력에 스스로 속는 것입니다.
해법은 입력의 모양에 좌우되지 않는 피벗, 즉 무작위 피벗입니다.
void quick_rand_impl(int arr[], int low, int high) {
    while (low < high) {
        int pivot = arr[low + (int)(xorshift() % (unsigned)(high - low + 1))];
        ...
구간 안에서 아무 위치나 골라 피벗으로 씁니다. 어떤 모양의 입력이든 나쁜 피벗이 연속될 확률은 극히 낮습니다. 표에서 퀵(무작위)은 정렬됨·역순에서 무작위 입력보다 오히려 빠르고, 100만 개에서 퀵(3way)보다 9배 빠릅니다. 대가는 파티션마다 난수를 하나 뽑는 비용뿐인데, 무작위 입력의 두 칸(44.6 대 43.2)을 보면 차이가 없습니다.
이 수수께끼에서 얻을 교훈은 셋입니다.
- “방어했다”고 믿는 것과 측정하는 것은 다릅니다. median-of-three 를 넣었으니 됐다고 생각했지만, 표가 아니라고 말했습니다. 벤치마크가 있어서 잡은 문제입니다.
- 최적화는 조합에 따라 상호작용합니다. median-of-three 도 좋은 기법이고 3-way 도 좋은 기법인데, 둘을 그냥 붙이면 서로를 방해했습니다.
- 그래서 실전 라이브러리는 한 가지 방어에 의존하지 않습니다. 인트로 정렬의 깊이 한도가 그 예입니다. 피벗이 어떻게 실패하든 깊이가 한도를 넘으면 힙으로 넘어갑니다.
크기별 성장 곡선
같은 도구로 크기를 바꿔 가며 재면 O 표기가 “실제로” 무슨 뜻인지 보입니다. 무작위 입력 기준입니다.
| n | 삽입 | 선택 | 병합 | 퀵(무작위) | 힙 | qsort |
|---|---|---|---|---|---|---|
| 10,000 | 6.0 | 90.6 | 0.5 | 0.5 | 0.4 | 0.6 |
| 100,000 | 624.9 | 8965.3 | 5.7 | 4.8 | 5.2 | 7.8 |
| 1,000,000 | (생략) | (생략) | 61.6 | 43.2 | 90.7 | 90.2 |
n 이 10배가 될 때 삽입과 선택은 약 100배, 나머지는 약 10배 늘었습니다. O(n²)와 O(n log n)의 차이가 이것입니다. 10만 개에서 선택 정렬은 9초, 병합 정렬은 0.006초입니다. 100만 개짜리 선택 정렬은 15분이 걸릴 것이라 도구가 건너뜁니다.
벤치마크를 만들 때 반드시 지켜야 할 것 두 가지가 코드에 들어 있습니다.
- 매번 원본에서 복사: 1절에서 말한 그 함정입니다. 첫 정렬이 배열을 정렬해 버리면 다음 측정이 무의미해집니다.
- 결과 검증: 정렬이 끝나면 오름차순인지 확인하고 체크섬을 비교합니다. 빠른데 틀린 정렬만큼 위험한 것은 없습니다. 2절의 “쓸어 담기 없는 병합”은 결과가 오름차순처럼 보이지만 원소가 사라졌으니 체크섬에서 걸립니다. 10주차에서
-O2가 측정 루프를 지워 0.00 ms 가 나왔던 일도, 검증이 있었다면 “정렬 안 됨”으로 즉시 드러났을 것입니다.
확장 아이디어: 비교/이동 횟수 칸 추가, CSV 출력(9주차 파일 입출력), 프로젝트 1의 인트로 정렬을 표에 추가, median-of-three 와 로무토 파티션 조합을 추가해서 3-way 조합과 비교
11. 자주 하는 실수와 함정
1. mid = (low + high) / 2. 오버플로입니다. low + (high - low) / 2 로 쓰세요. 자바 표준 라이브러리에 9년간 숨어 있던 버그입니다(8.3절).
2. 정렬된 입력에 끝-피벗 퀵. O(n²)로 저격당하고, 재귀 깊이가 n 이 되어 스택이 넘칩니다(3.3절). median-of-three 는 기본, 완전한 방어는 인트로 정렬.
3. 방어 기법을 조합하고 측정하지 않기. median-of-three + 3-way 파티션이 정렬된 입력에서 서로를 방해했습니다(10절). 넣었으면 재세요.
4. qsort 에 안정성 기대. 표준이 보장하지 않습니다. 우리 환경에서 안정으로 동작해도 다른 환경에서는 아닙니다. 2차 키를 비교 함수에 넣으세요(7.4절).
5. 병합에서 < 사용, 삽입에서 >= 사용. 동작은 하지만 안정성을 잃습니다. 7.3절에서 이름순이 정확히 거꾸로 뒤집히는 것을 봤습니다.
6. 병합의 “쓸어 담기” 생략. 데이터가 조용히 사라집니다(2.3절).
7. 비교 함수에서 return a - b. 오버플로로 INT_MAX 가 맨 앞에 옵니다(7.4절). (a > b) - (a < b) 로 쓰세요.
8. 카운팅 정렬을 넓은 범위에. count 배열이 16GB 가 됩니다. 값의 범위부터 확인하세요(5.4절).
9. 카운팅 정렬을 앞에서부터 배치. 안정성이 깨져서 기수 정렬이 틀린 답을 냅니다(5.3절).
10. 3-way 파티션에서 gt 교환 후 i++. 검사하지 않은 값을 건너뛰어 정렬이 틀립니다(4.2절).
11. 이진 탐색의 경계 조건. high = mid 와 low <= high 를 섞으면 무한 루프입니다(8.4절). 범위가 매 반복마다 반드시 줄어드는지 확인하세요.
12. 보간 검색을 분포 모르고 사용. 몰린 데이터에서 999번 찔렀습니다(9.1절).
13. 벤치마크에서 같은 배열 재사용. 두 번째 측정이 “정렬됨” 패턴이 됩니다. 매번 원본에서 복사하세요.
14. 정렬 결과 검증 생략. 빠른데 틀린 정렬이 가장 위험합니다. 측정에는 항상 검증을 붙이세요.
12. 연습 문제
기본 문제
- 버블 정렬 최적화 제거: 1.2절의 실험을 직접 해 보세요.
swapped플래그를 없애고 정렬된 입력으로 돌려 비교 횟수가 9에서 45로 바뀌는지 확인하세요. - K번째 작은 값: 배열에서 K번째로 작은 값을 찾으세요. 정렬 후 인덱싱하면 O(n log n)이지만, 퀵 정렬의 파티션만 쓰면(퀵 셀렉트) 평균 O(n)입니다. 파티션 후 피벗 위치가 K 보다 크면 왼쪽만, 작으면 오른쪽만 다시 파티션하면 됩니다.
- 두 정렬 배열 병합: 이미 정렬된 두 배열을 하나로 합치세요.
merge함수를 그대로 응용하면 됩니다. 2.3절의 실험을 떠올려 “쓸어 담기”를 빼먹지 마세요. - 중복 제거: 정렬된 배열에서 중복을 제거하고 남은 개수를 반환하세요(제자리에서, 추가 배열 없이).
- 회전된 배열 탐색:
[4, 5, 6, 7, 0, 1, 2]처럼 회전된 정렬 배열에서 이진 탐색으로 값을 찾으세요.mid를 기준으로 어느 쪽 절반이 정렬돼 있는지 먼저 판단하는 것이 요령입니다.
심화 문제
- 로무토 + median-of-three 를 벤치마크에 추가: 3절의
quick_sort_median3를 벤치마크의sorts[]에 넣고, 정렬됨 칸이 퀵(3way)와 퀵(무작위) 중 어느 쪽에 가까운지 측정하세요. 10절의 설명이 맞다면 어느 쪽이어야 할까요? - 팀소트 맛보기: 배열에서 이미 정렬된 구간(“런”)을 찾아 그 구간은 건너뛰고 나머지만 병합하세요. 파이썬과 자바의 표준 정렬이 이 방식입니다.
- 연결 리스트 병합 정렬: 10주차의 연결 리스트를 병합 정렬로 정렬하세요. 배열과 달리 추가 메모리 없이 가능합니다. 2.5절에서 왜 그런지 설명했습니다.
- 문자열 기수 정렬: 고정 길이 문자열 배열을 기수 정렬로 정렬하세요(뒤 글자부터). 16주차의 예고편입니다.
- 정렬 알고리즘 시각화: 정렬 과정의 각 단계를 터미널에 막대그래프로 출력하세요. 6절의
\r을 쓰면 같은 줄을 계속 고쳐 그릴 수 있습니다(1주차 이스케이프 시퀀스). 26주차 TUI 편에서 제대로 만들 것의 연습입니다.
마치며
이번 주에 배운 것을 정리합니다.
- O(n²) 삼형제: 느리지만 개성이 있다. 삽입은 거의 정렬된 데이터에 강해 고급 정렬의 부품이 되고, 선택은 쓰기가 최소다
- 병합 정렬: 최악이 없고 안정적. O(n) 메모리가 대가. 연결 리스트와 외부 정렬의 왕
- 퀵 정렬: 평균 최강. 피벗을 잘못 고르면 O(n²)와 스택 오버플로. median-of-three 와 3-way 로 방어하되, 조합은 측정으로 확인
- 비교 없는 정렬: 좁은 범위(카운팅), 자릿수(기수), 균등 분포(버킷)라는 조건과의 거래
- 안정성: 부등호 하나가 결정한다. 다단계 정렬과 기수 정렬의 전제
- 이진 탐색: 안전한 mid 공식 + lower/upper bound 가 실전의 90%
- 인트로 정렬: 퀵 + 힙 + 삽입 = 실제 표준 라이브러리의 답
이번 주에 반복해서 나온 주제가 몇 가지 있습니다.
첫째, 부등호 하나의 무게. 병합의 <=, 삽입의 <= 와 >, upper_bound 의 <=. 글자 하나가 알고리즘의 성질을 바꿨고, 7.3절에서는 정렬 결과를 정확히 뒤집었습니다. 코드를 읽을 때 이런 곳을 그냥 지나치지 않는 눈이 실력입니다.
둘째, 오버플로. mid 계산, 비교 함수의 뺄셈, 보간 검색의 곱셈. 세 번 모두 -fsanitize=undefined 가 잡아 줬습니다. C 를 쓰는 한 평생 따라다니는 주제이고, 작은 테스트로는 절대 안 잡힙니다.
셋째, 알고리즘과 입력의 궁합. “제일 빠른 정렬”은 없습니다. 벤치마크 표에서 같은 알고리즘이 0.0 ms 와 304 ms 를 오갔고, median-of-three 는 자기가 만든 입력에 속았습니다. 데이터를 알아야 알고리즘을 고를 수 있고, 골랐으면 재야 합니다.
넷째, 하이브리드가 실전의 답. 인트로 정렬은 세 알고리즘의 조합이고, 팀소트도, glibc qsort 도 그렇습니다. 교과서의 단일 알고리즘은 이해를 위한 것이고, 실전은 각자의 강점을 조합합니다.
다음 주는 문자열 알고리즘입니다. “찾기”의 대상이 숫자에서 텍스트로 바뀝니다. KMP, 보이어-무어, 라빈-카프, 그리고 에디터의 “찾아 바꾸기”와 grep 이 어떻게 그렇게 빠른지 알게 됩니다.
수고하셨습니다. 정렬은 지루해 보이지만, 알고리즘을 보는 눈을 길러 주는 최고의 교재입니다. 오늘 배운 개념들이 앞으로 계속 다른 옷을 입고 나타날 겁니다.
체크리스트
- [ ] 버블·선택·삽입 정렬을 5개짜리 배열로 한 바퀴씩 손으로 따라갈 수 있다
- [ ] n(n−1)/2 가 어디서 나오는지, 왜 선택 정렬은 항상 그만큼 비교하는지 안다
- [ ] 삽입 정렬이 거의 정렬된 데이터에서 O(n)인 이유와, 교환 대신 “밀기”를 쓰는 이유를 안다
- [ ] 병합 정렬의 재귀 나무를 그리고, 깊이가 log n 인 이유를 설명할 수 있다
- [ ] 병합의
<=가 안정성을 만드는 원리와, “쓸어 담기”를 빼면 생기는 일을 안다 - [ ] 로무토 파티션을 한 걸음씩 추적할 수 있고, 파티션 후 피벗 위치가 확정되는 이유를 안다
- [ ] 정렬된 입력 + 끝 피벗이 O(n²)와 스택 오버플로로 이어지는 과정을 그릴 수 있다
- [ ] median-of-three 가 무엇을 방어하고, 3-way 파티션과 조합했을 때 왜 실패했는지 안다
- [ ] 3-way 파티션의 세 구역과,
gt교환 후i를 안 늘리는 이유를 안다 - [ ] 비교 정렬의 O(n log n) 하한이 왜 존재하는지 설명할 수 있다
- [ ] 카운팅 정렬의 누적합이 “위치”가 되는 원리와, 뒤에서부터 배치하는 이유를 안다
- [ ] 기수 정렬에 안정성이 필수인 이유를 실험으로 보였다
- [ ] 버킷 정렬과 해시 체이닝의 구조가 같음을 안다
- [ ] 안정/불안정 정렬을 분류하고,
qsort가 안정성을 보장하지 않는다는 것과 대처법을 안다 - [ ]
a - b비교 함수가 왜 위험한지 실제 오버플로로 봤다 - [ ] mid 안전 공식을 반사적으로 쓰고,
high = mid가 무한 루프를 만드는 조건을 안다 - [ ] lower/upper bound 로 개수 세기·삽입 위치·범위 검색을 할 수 있다
- [ ] 보간 검색의 조건(균등 분포)과 몰린 데이터의 참사를 안다
- [ ] 인트로 정렬의 3단 구성(퀵/힙/삽입)과 깊이 한도의 역할을 안다
- [ ] 외부 정렬의 2단계(런 생성 + k-way 병합)와 메모리 사용량을 설명할 수 있다
- [ ] 벤치마크에서 원본 복사와 결과 검증이 필수인 이유를 안다
- [ ] 세 프로젝트를 빌드하고 검증 통과를 확인했다
- [ ] (도전) 연습 문제 6번으로 10절의 설명을 직접 검증해 봤다
참고 자료
- CLRS(Introduction to Algorithms) Chapter 2, 6-9 (정렬 전권)
- Donald Knuth, The Art of Computer Programming Vol. 3, 6.2.1 — 이진 탐색의 역사(1946년 발표, 1962년 첫 무결점 구현)
- Jon Bentley, Programming Pearls — 이진 탐색 함정의 고전
- 자바 이진 탐색 버그 사건 (구글 리서치 블로그, 2006)
- VisuAlgo — 정렬 시각화
- Timsort 설계 문서 (CPython)
- 다음 주차: 16주차 문자열 알고리즘