학습 목표
이번 주차를 마치면 다음을 할 수 있습니다:
pipe가 만드는 fd 두 개가 무엇이고, 왜 안 쓰는 끝을 반드시 닫아야 하는지 실험으로 설명할 수 있다pipe+fork+dup2세 가지로 셸의ls | wc -l을 직접 만들 수 있다- FIFO,
popen, 공유 메모리, 메시지 큐를 “언제 쓰나 / 인자는 무엇인가 / 실패하면 어떻게 되나”로 설명할 수 있다 - 경쟁 조건을 직접 재현하고, 세마포어로 고치고, 고친 것이 맞는지 확인할 수 있다
- 교착 상태를 직접 만들어 멈추는 것을 보고, 왜 생기는지 그림으로 설명하고, 락 순서 통일로 예방할 수 있다
- 프로그램이 죽은 뒤 남은 IPC 자원을 찾아서 지울 수 있다
- 생산자-소비자, 공유 캐시, 워커 풀 같은 동시성 패턴을 구현할 수 있다
들어가며
18주차에서 우리는 프로세스를 만들었습니다. fork로 복제하고, exec로 변신시키고, wait으로 수거했죠. 그런데 한 가지 답답한 점이 있었습니다. 만들고 나면 남남이었다는 것입니다.
int counter = 100;
if (fork() == 0) {
    counter++;          /* 자식이 101로 바꿔도 */
    exit(0);
}
wait(NULL);
printf("%d\n", counter);   /* 부모는 여전히 100 */
fork는 메모리를 통째로 복사합니다. 그래서 자식이 counter를 바꿔도 부모의 counter는 그대로입니다. 그러면 프로세스들은 어떻게 협력할까요? 1주차부터 매일 쓰는 ls | wc -l에서 ls의 출력은 어떤 길로 wc에 도착할까요? 웹 서버의 워커 프로세스 열 개는 어떻게 작업을 나눠 갖고, 서로 다른 프로그램 둘이 어떻게 같은 데이터를 볼까요?
답이 IPC(Inter-Process Communication, 프로세스 간 통신) 입니다. 이번 주의 전반부 주제죠.
그리고 대화가 시작되면 새로운 문제가 따라옵니다. 둘이 같은 데이터를 동시에 건드리면 어떻게 될까요? “한 번에 하나씩만 건드려라”를 누가 지켜 줄까요? 여기서 동기화가 필요해집니다. 후반부의 주제입니다.
이번 주의 구조는 이렇습니다.
| 전반부: 대화하는 법 | 후반부: 충돌하지 않는 법 |
|---|---|
| 파이프, FIFO, popen (1~4절) | 경쟁 조건과 임계 구역 (5절) |
| 공유 메모리 (7절) | 세마포어와 상호 배제 (6절) |
| 메시지 큐, System V (8~9절) | 교착 상태와 예방 (10절) |
그리고 프로젝트(11절)에서 이 둘을 합쳐 생산자-소비자 시스템, 공유 캐시, 워커 풀을 만듭니다. 웹 서버와 메시지 브로커의 뼈대를 직접 짜 보는 것이죠.
이번 주는 “프로그램이 멈추는 경험” 을 일부러 여러 번 하게 됩니다. IPC 프로그램의 버그는 대개 오류 메시지 없이 그냥 멈춥니다. 왜 멈췄는지 아는 사람과 모르는 사람의 차이가 이 주차의 목표입니다. 그래서 멈추는 실험은 전부 timeout 5 ./프로그램으로 돌립니다. 5초 안에 안 끝나면 timeout이 죽이고 종료 코드 124를 돌려줍니다. 1주차에서 배운 echo $?가 계속 쓰입니다.
컴파일 옵션 이야기 — 예전 글과 다른 점
인터넷의 오래된 글이나 책은 이번 주 예제를 이렇게 컴파일하라고 합니다.
gcc -Wall -Wextra -std=gnu11 -g 파일.c -o 실행파일 -pthread -lrt
-pthread: 세마포어(sem_*) 함수가libpthread에 있으니 링크하라-lrt: 메시지 큐(mq_*)와shm_open이librt(realtime 라이브러리)에 있으니 링크하라
그런데 우리 환경(Ubuntu 24.04, glibc 2.39)에서는 둘 다 없어도 링크됩니다. 직접 확인해 봤습니다.
$ gcc -Wall -Wextra -std=gnu11 examples/sem_posix.c -o /tmp/x_sem
$ echo $?
0
$ gcc -Wall -Wextra -std=gnu11 examples/mqueue_demo.c -o /tmp/x_mq
$ echo $?
0
glibc 2.34(2021년)부터 libpthread와 librt의 내용이 libc 본체로 합쳐졌기 때문입니다. 1주차 7절에서 본 ldd로 확인하면 libpthread.so가 아예 나타나지 않습니다. 그럼 왜 이 글과 Makefile은 여전히 -pthread -lrt를 붙일까요? 다른 환경 때문입니다. 오래된 리눅스, 다른 배포판, 임베디드 보드(27주차)에서는 아직 필요할 수 있고, 붙여서 손해 볼 것은 없습니다. 그래서 습관으로 붙이되, 이 옵션이 “없으면 무조건 링크 오류”라는 옛 설명은 틀렸다는 것을 알아 두세요.
이번 주의 -std=gnu11도 짚고 갑니다. 지금까지는 -std=c11이었는데, dup2, mkfifo, sem_timedwait 같은 POSIX 함수와 MAP_ANONYMOUS 같은 리눅스 상수는 C 표준 밖에 있습니다. gnu11은 “C11 + GNU/POSIX 확장”을 켜서 이런 이름들을 헤더가 내놓게 합니다. 18주차와 같은 이유입니다.
1. 파이프: 프로세스를 잇는 관
1.1 pipe() 한 번에 fd 두 개
파이프(pipe) 는 커널이 관리하는 버퍼에 한쪽에서 쓰고 다른 쪽에서 읽는 통로입니다. 먼저 함수부터 봅시다. 이번 주에 새로 나오는 함수는 모두 이 형식으로 정리합니다.
#include <unistd.h>
int pipe(int fd[2]);
| 항목 | 설명 |
|---|---|
fd |
출력 인자. 정수 2칸짜리 배열을 넘기면 커널이 채워 줍니다. fd[0]은 읽는 끝, fd[1]은 쓰는 끝 |
| 반환값 | 성공 0, 실패 -1 (그리고 errno) |
| 실패하는 경우 | EMFILE (이 프로세스가 열 수 있는 fd를 다 썼다), ENFILE (시스템 전체가 다 썼다) |
| 설명서 | man 7 pipe (개념), man 2 pipe (함수. manpages-dev 설치 필요) |
순서를 외우는 요령이 있습니다. 0번은 표준 입력(읽기), 1번은 표준 출력(쓰기). 18주차에서 본 그 번호와 같은 뜻입니다.
pipe(fd)를 호출하고 나면 프로세스의 fd 표는 이렇게 됩니다.
프로세스의 fd 표                     커널
┌────┬────────────────┐
│ 0  │ 표준 입력      │
│ 1  │ 표준 출력      │
│ 2  │ 표준 오류      │
│ 3  │ 파이프 읽는 끝 │◀──┐   ┌──────────────────┐
│ 4  │ 파이프 쓰는 끝 │───┼──▶│  버퍼 (64KB)      │
└────┴────────────────┘   └───│ ◀ 읽기   쓰기 ▶  │
                              └──────────────────┘
fd 3과 4가 같은 버퍼의 양 끝을 가리킵니다. 4번에 write하면 버퍼에 쌓이고, 3번에서 read하면 쌓인 순서대로 나옵니다.
이 그림은 비유가 아니라 실제로 볼 수 있습니다. 리눅스는 프로세스의 fd 표를 /proc/PID/fd 폴더에 바로가기 파일로 보여 줍니다. pipe를 부른 직후 자기 fd 표를 ls로 찍는 showfd.c입니다.
    int fd[2];
    pipe(fd);
    printf("pipe() -> %d, %d\n", fd[0], fd[1]);
    char cmd[64];
    snprintf(cmd, sizeof(cmd), "ls -l /proc/%d/fd", getpid());
    fflush(stdout);
    system(cmd);
$ ./showfd
pipe() -> 3, 4
...
lr-x------ 1 user user 64  9월 29 02:42 3 -> pipe:[13516655]
l-wx------ 1 user user 64  9월 29 02:42 4 -> pipe:[13516655]
0, 1, 2번은 터미널이라 생략했습니다. 3번은 r(읽기 전용), 4번은 w(쓰기 전용)이고, 둘 다 같은 번호 pipe:[13516655] 를 가리킵니다. 이 번호가 커널 안의 파이프 버퍼를 구분하는 이름표(inode 번호)입니다. 1.2절에서 프로그램이 멈췄을 때 이 폴더가 결정적인 단서가 됩니다. 그리고 여기서 18주차의 fork가 등장합니다. fork는 fd 표를 복사하므로, 자식도 3번과 4번을 갖게 됩니다. 부모가 4번에 쓰고 자식이 3번에서 읽으면 통신이 됩니다.
부모 ---write(fd[1])---> [커널 버퍼] ---read(fd[0])---> 자식
examples/pipe_basic.c:
/*
 * pipe_basic.c - 익명 파이프: 프로세스 사이의 관
 * 19주차: IPC와 동기화
 *
 * 18주차에서 fork로 프로세스를 만들었지만, 만들고 나면 남남이었습니다.
 * (메모리가 복사되므로 변수를 공유할 수 없었죠!)
 *
 * 파이프는 그 둘을 잇는 "관"입니다:
 *
 *   pipe(fd) -> fd[0] = 읽는 쪽, fd[1] = 쓰는 쪽
 *
 *   부모 ---write(fd[1])---> [커널 버퍼] ---read(fd[0])---> 자식
 *
 * 핵심 규칙: 쓰지 않는 쪽 끝은 반드시 닫는다!
 * (안 닫으면 read가 EOF를 영원히 못 받아 프로그램이 멈춘다)
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <sys/wait.h>
#include <errno.h>
#include <signal.h>

int main(void) {
    printf("=== 1. 파이프의 두 끝 ===\n");

    int fd[2];
    if (pipe(fd) < 0) {              /* fd[0]=읽기, fd[1]=쓰기 */
        perror("pipe");
        return 1;
    }
    printf("pipe() 성공: 읽기 fd=%d, 쓰기 fd=%d\n", fd[0], fd[1]);
    printf("(18주차에서 배운 대로 '빈 번호 중 최소'가 배정됐다)\n\n");

    /* ---------- 2. 부모 -> 자식 방향 통신 ---------- */
    printf("=== 2. 부모가 쓰고 자식이 읽는다 ===\n");
    fflush(stdout);                  /* fork 전 버퍼 비우기 (18주차 규칙!) */

    pid_t pid = fork();
    if (pid < 0) {
        perror("fork");
        return 1;
    }

    if (pid == 0) {
        /* ---------- 자식: 읽는 쪽 ---------- */
        close(fd[1]);                /* 쓰는 끝은 안 쓰니 닫는다 - 중요! */

        char buffer[128];
        ssize_t n;
        while ((n = read(fd[0], buffer, sizeof(buffer) - 1)) > 0) {
            buffer[n] = '\0';
            printf("[자식] 받음(%zd바이트): %s", n, buffer);
        }
        /* read가 0 = EOF = 쓰는 쪽이 전부 닫혔다는 뜻 */
        printf("[자식] EOF 도착. 파이프의 쓰는 끝이 모두 닫혔다.\n");

        close(fd[0]);
        exit(0);
    }

    /* ---------- 부모: 쓰는 쪽 ---------- */
    close(fd[0]);                    /* 읽는 끝은 안 쓰니 닫는다 */

    const char *messages[] = {
        "안녕, 자식아!\n",
        "파이프로 대화하는 중이야.\n",
        "이제 끊을게.\n",
    };
    for (int i = 0; i < 3; i++) {
        write(fd[1], messages[i], strlen(messages[i]));
        usleep(100000);              /* 관찰하기 좋게 잠깐 쉬기 */
    }

    close(fd[1]);                    /* 닫아야 자식의 read가 EOF를 받는다! */
    wait(NULL);

    /* ---------- 3. 양방향? 파이프 두 개! ---------- */
    printf("\n=== 3. 양방향 통신: 파이프 두 개 ===\n");
    printf("파이프는 단방향이다. 양쪽 대화를 하려면 두 개를 판다.\n");
    fflush(stdout);

    int to_child[2], to_parent[2];
    if (pipe(to_child) < 0 || pipe(to_parent) < 0) {
        perror("pipe");
        return 1;
    }

    pid = fork();
    if (pid == 0) {
        /* 자식: to_child로 받고, to_parent로 답한다 */
        close(to_child[1]);
        close(to_parent[0]);

        char question[128];
        ssize_t n = read(to_child[0], question, sizeof(question) - 1);
        if (n > 0) {
            question[n] = '\0';
            printf("[자식] 질문 받음: %s", question);

            const char *answer = "42입니다!\n";
            write(to_parent[1], answer, strlen(answer));
        }

        close(to_child[0]);
        close(to_parent[1]);
        exit(0);
    }

    /* 부모: to_child로 묻고, to_parent로 답을 받는다 */
    close(to_child[0]);
    close(to_parent[1]);

    const char *question = "삶, 우주, 그리고 모든 것의 답은?\n";
    printf("[부모] 질문 보냄: %s", question);
    fflush(stdout);                  /* 출력 순서를 맞추기 위해 */
    write(to_child[1], question, strlen(question));
    close(to_child[1]);              /* 질문 끝났다고 알림 */

    char answer[128];
    ssize_t n = read(to_parent[0], answer, sizeof(answer) - 1);
    if (n > 0) {
        answer[n] = '\0';
        printf("[부모] 답 받음: %s", answer);
    }
    close(to_parent[0]);
    wait(NULL);

    /* ---------- 4. 파이프의 성질 ---------- */
    printf("\n=== 4. 파이프의 성질 (외우세요) ===\n");
    printf("1. 단방향  : 양방향이 필요하면 두 개\n");
    printf("2. 혈연관계: fork로 fd를 물려받은 프로세스끼리만 (남남은 FIFO로!)\n");
    printf("3. 버퍼 유한: 리눅스 기본 64KB. 가득 차면 write가 '기다린다'\n");
    printf("4. EOF 규칙: 쓰는 끝이 '전부' 닫혀야 read가 0을 반환\n");
    printf("5. SIGPIPE : 읽는 끝이 모두 닫힌 파이프에 쓰면 프로세스가 죽는다!\n");

    /* ---------- 5. SIGPIPE 실험 ---------- */
    printf("\n=== 5. SIGPIPE: 아무도 안 듣는데 말하면? ===\n");
    fflush(stdout);

    int broken[2];
    if (pipe(broken) < 0) return 1;

    pid = fork();
    if (pid == 0) {
        close(broken[0]);            /* 자식이 읽는 끝을 닫아버린다 */
        close(broken[1]);
        exit(0);
    }
    wait(NULL);
    close(broken[0]);                /* 부모도 읽는 끝을 닫는다 -> 독자 0명 */

    signal(SIGPIPE, SIG_IGN);        /* 죽지 않고 에러로 받겠다고 선언 */
    ssize_t r = write(broken[1], "아무도 안 듣는다\n", 20);
    if (r < 0) {
        printf("write 실패: errno %d (%s)\n", errno, strerror(errno));
        printf("-> EPIPE! 기본 동작이었다면 SIGPIPE로 프로세스가 죽었을 것\n");
        printf("   (서버 프로그램이 SIGPIPE를 무시하는 이유: 클라이언트가\n");
        printf("    갑자기 끊었다고 서버가 죽으면 안 되니까!)\n");
    }
    close(broken[1]);

    return 0;
}
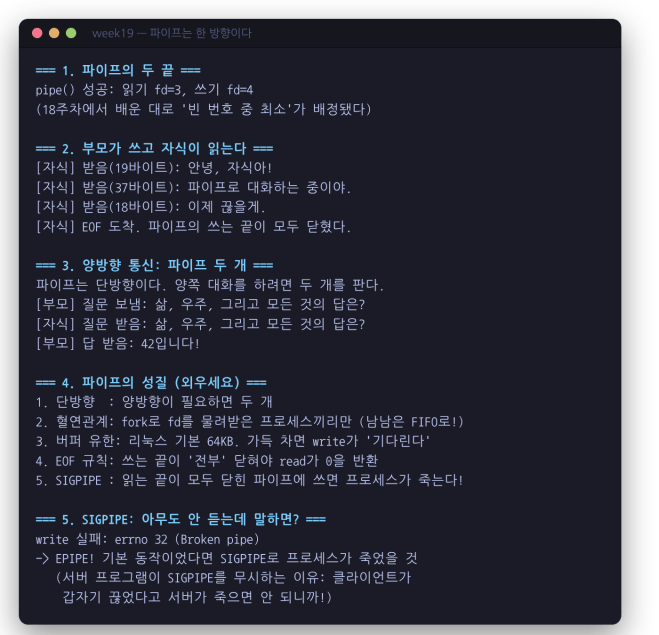
파이프는 한 방향이다
컴파일하고 실행합니다. 이번 주 예제는 week19 폴더에서 make를 한 번 돌리면 전부 build/에 만들어지지만, 처음 몇 개는 직접 컴파일해 보세요.
$ cd week19
$ mkdir -p build
$ gcc -Wall -Wextra -std=gnu11 -g examples/pipe_basic.c -o build/pipe_basic
$ ./build/pipe_basic
=== 1. 파이프의 두 끝 ===
pipe() 성공: 읽기 fd=3, 쓰기 fd=4
(18주차에서 배운 대로 '빈 번호 중 최소'가 배정됐다)

=== 2. 부모가 쓰고 자식이 읽는다 ===
[자식] 받음(19바이트): 안녕, 자식아!
[자식] 받음(37바이트): 파이프로 대화하는 중이야.
[자식] 받음(18바이트): 이제 끊을게.
[자식] EOF 도착. 파이프의 쓰는 끝이 모두 닫혔다.

=== 3. 양방향 통신: 파이프 두 개 ===
파이프는 단방향이다. 양쪽 대화를 하려면 두 개를 판다.
[부모] 질문 보냄: 삶, 우주, 그리고 모든 것의 답은?
[자식] 질문 받음: 삶, 우주, 그리고 모든 것의 답은?
[부모] 답 받음: 42입니다!

=== 4. 파이프의 성질 (외우세요) ===
...

=== 5. SIGPIPE: 아무도 안 듣는데 말하면? ===
write 실패: errno 32 (Broken pipe)
-> EPIPE! 기본 동작이었다면 SIGPIPE로 프로세스가 죽었을 것
코드 읽기 포인트
pipe(fd)는fork전에 부릅니다. 순서가 반대면(fork 뒤에 pipe) 부모와 자식이 각자 다른 파이프를 만들어서 서로 연결되지 않습니다. 파이프는 fd이고, fd는fork로 물려받는다는 것이 연결의 원리입니다.fflush(stdout)후fork: 18주차 규칙입니다.printf의 버퍼에 남은 내용이fork로 복사되면 같은 줄이 두 번 찍힙니다.- 읽음(19바이트): “안녕, 자식아!\n”은 한글 5자(15바이트) + 쉼표·공백·느낌표 3자 + 개행 1자 = 19바이트입니다. 1주차에서 확인한 “한글은 3바이트”가 여기서도 그대로입니다.
read는 글자가 아니라 바이트를 셉니다. read의 반환값 세 가지: 양수(받은 바이트 수), 0(EOF), -1(오류).while ((n = read(...)) > 0)은 “0이나 -1이 나올 때까지 계속 읽어라”입니다. 9주차fgets루프와 같은 모양이죠.write(fd[1], ..., 20)마지막 실험은 문자열 길이를 대충 20으로 줬습니다. “아무도 안 듣는다\n”은 실제로 24바이트인데, 어차피 실패시키려는 쓰기라 길이가 정확할 필요가 없어서 그렇습니다. 평소에는strlen을 쓰세요.
1.2 안 쓰는 끝은 반드시 닫는다 — 직접 멈춰 보기
이번 주에서 가장 중요한 규칙입니다. 코드에서 이 두 줄을 보세요.
    if (pid == 0) {
        close(fd[1]);                /* 쓰는 끝은 안 쓰니 닫는다 - 중요! */
        ...
    }
    close(fd[0]);                    /* 부모는 읽는 끝을 닫는다 */
왜 닫아야 할까요? EOF 규칙 때문입니다.
파이프의 쓰는 끝이 “전부” 닫혀야
read가 0(EOF)을 반환한다.
fork 직후의 상황을 그려 보면 이유가 보입니다.
              부모의 fd 표          자식의 fd 표
              3 ─▶ 읽는 끝          3 ─▶ 읽는 끝
              4 ─▶ 쓰는 끝          4 ─▶ 쓰는 끝
                        ╲            ╱
                    [ 커널 버퍼 ] ◀── 쓰는 끝을 가진 fd: 부모 4, 자식 4 → 2개
커널은 “쓰는 끝을 가리키는 fd가 몇 개 남았나”를 셉니다. 부모가 close(fd[1])을 해도 자식이 자기 몫의 4번을 안 닫았으면 1개가 남습니다. 그러면 커널 입장에서는 “아직 누군가 쓸 수 있는 상태”이고, 자식의 read는 “데이터가 더 올지도 모른다”며 영원히 기다립니다. 그 누군가가 바로 자기 자신인데도요.
말로만 들으면 와닿지 않으니 직접 멈춰 봅시다. 자식의 close(fd[1]) 한 줄만 뺀 프로그램입니다. noclose_child.c:
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <sys/wait.h>

int main(void) {
    int fd[2];
    pipe(fd);
    if (fork() == 0) {
        /* close(fd[1]);  <- 이 한 줄을 뺐다 */
        char buf[64];
        ssize_t n;
        while ((n = read(fd[0], buf, sizeof(buf) - 1)) > 0) {
            buf[n] = '\0';
            printf("[자식] 받음: %s", buf);
        }
        printf("[자식] EOF\n");
        exit(0);
    }
    close(fd[0]);
    write(fd[1], "hello\n", 6);
    close(fd[1]);
    wait(NULL);
    printf("[부모] 끝\n");
    return 0;
}
$ gcc -Wall -Wextra -std=gnu11 noclose_child.c -o noclose_child
$ timeout 5 ./noclose_child
$ echo $?
124
아무것도 출력되지 않고 5초 뒤에 124. timeout이 죽였다는 뜻입니다. 자식은 hello를 받았는데 왜 출력조차 안 됐을까요? 자식의 printf는 버퍼에 쌓여 있다가 exit할 때 나오는데, read에서 영원히 기다리느라 exit에 도달하지 못했기 때문입니다. timeout이 SIGTERM으로 죽이면 버퍼는 그냥 버려집니다. 그래서 멈춘 프로그램은 출력도 안 보이는 경우가 많습니다. 디버깅할 때 fflush(stdout)을 곳곳에 넣어야 하는 이유입니다.
이것이 파이프 프로그램이 멈추는 원인 1위입니다. 프로그램이 아무 이유 없이 멈췄다면 가장 먼저 의심하세요.
멈춘 상태에서 무엇이 잘못됐는지 증거를 잡는 방법이 있습니다. 1.1절의 /proc/PID/fd입니다. 멈춰 있는 동안 다른 터미널에서 부모와 자식의 fd 표를 봤습니다.
$ ./noclose_child &
$ ls -l /proc/부모PID/fd | awk '{print $9, $10, $11}'
...                      (0~2번은 터미널. 3, 4번이 없다)
$ ls -l /proc/자식PID/fd | awk '{print $9, $10, $11}'
...
3 -> pipe:[13524997]
4 -> pipe:[13524997]
$ cat /proc/자식PID/wchan
anon_pipe_read
부모는 3, 4번을 모두 닫아서 0~2번만 남았습니다. 그런데 자식에게는 4번(쓰는 끝)이 아직 열려 있습니다. 그리고 wchan(커널 안에서 무엇을 기다리는지)은 anon_pipe_read, 즉 파이프 읽기를 기다리는 중입니다. “쓰는 끝이 남아 있는데 그것을 가진 자가 읽기를 기다린다”는 상황이 파일 목록으로 그대로 보입니다. 이 방법은 10.2절에서 교착 상태를 볼 때 다시 씁니다. PID는 ps 나 pgrep noclose_child 로 찾습니다.
부모 쪽의 close(fd[1])도 똑같이 중요합니다. 이번에는 부모가 닫지 않고 바로 wait을 부르는 noclose_parent.c입니다(자식은 제대로 닫습니다).
    close(fd[0]);
    write(fd[1], "hello\n", 6);
    /* close(fd[1]);  <- 부모가 닫지 않고 바로 기다린다 */
    wait(NULL);
$ timeout 5 ./noclose_parent
$ echo $?
124
역시 멈춥니다. 이번에는 부모는 자식이 끝나기를 기다리고(wait), 자식은 부모가 닫기를 기다리는(read) 상황입니다. 서로가 서로를 기다리는 이 모양을 10절에서 교착 상태라는 이름으로 다시 만납니다.
실험 요약: 파이프 하나에
fork한 번이면 fd가 부모 2개 + 자식 2개 = 4개입니다. 각 프로세스가 자기가 안 쓰는 1개씩을 닫아서 읽는 끝 1개, 쓰는 끝 1개만 남기는 것이 정석입니다. 파이프가 두 개면 fd 8개 중 4개를 닫아야 합니다.pipe_basic.c의 3번 실험에서 부모와 자식이 각각 두 번씩close하는 것이 그것입니다.
1.3 파이프는 단방향이다
읽는 끝에 쓰거나 쓰는 끝에서 읽으면 어떻게 될까요? 시험해 보면 커널이 거절합니다. wrong_end.c의 앞부분입니다.
    int fd[2];
    pipe(fd);
    char buf[8];
    if (write(fd[0], "x", 1) < 0)
        printf("write(fd[0]) 실패: errno %d (%s)\n", errno, strerror(errno));
    if (read(fd[1], buf, 1) < 0)
        printf("read(fd[1]) 실패: errno %d (%s)\n", errno, strerror(errno));
write(fd[0]) 실패: errno 9 (Bad file descriptor)
read(fd[1]) 실패: errno 9 (Bad file descriptor)
EBADF입니다. fd[0]은 읽기 전용, fd[1]은 쓰기 전용으로 열려 있어서, 읽기 전용으로 연 파일에 쓰려 할 때와 같은 종류의 오류입니다. 그래서 양방향 대화를 하려면 파이프를 두 개 팝니다. 실행 결과의 3번이 그것입니다.
    int to_child[2], to_parent[2];
    pipe(to_child);                  /* 부모 → 자식 */
    pipe(to_parent);                 /* 자식 → 부모 */
파이프 하나로 양방향을 하려고 하면(부모와 자식이 둘 다 fd[1]에 쓰고 fd[0]에서 읽으면) 문법상 막히지는 않지만, 자기가 쓴 것을 자기가 읽어 버리는 사태가 납니다. 버퍼는 하나이고 누가 썼는지 구분하지 않으니까요. 방향마다 하나씩 파는 것이 정석입니다.
1.4 버퍼는 64KB — 가득 차면 write가 기다린다
파이프의 버퍼는 무한하지 않습니다. 크기를 직접 물어볼 수 있습니다. wrong_end.c의 뒷부분입니다.
    printf("파이프 버퍼 크기: %d 바이트\n", fcntl(fd[1], F_GETPIPE_SZ));

    /* 아무도 안 읽는 파이프를 논블로킹으로 채워 본다 */
    fcntl(fd[1], F_SETFL, O_NONBLOCK);
    char block[1024];
    memset(block, 'A', sizeof(block));
    long total = 0;
    for (;;) {
        ssize_t n = write(fd[1], block, sizeof(block));
        if (n < 0) {
            printf("%ld 바이트 쓴 뒤 write 실패: errno %d (%s)\n",
                   total, errno, strerror(errno));
            break;
        }
        total += n;
    }
파이프 버퍼 크기: 65536 바이트
65536 바이트 쓴 뒤 write 실패: errno 11 (Resource temporarily unavailable)
정확히 65,536바이트(64KB)를 쓴 뒤 EAGAIN이 났습니다. F_GETPIPE_SZ는 리눅스 전용 fcntl 명령이라 파일 맨 위에 #define _GNU_SOURCE가 필요합니다. 그리고 여기서는 O_NONBLOCK을 켰기 때문에 “지금은 못 쓴다”는 오류로 돌아왔습니다. O_NONBLOCK을 켜지 않으면 어떻게 될까요? fill_block.c는 아무도 읽지 않는 파이프에 1KB씩 70번 씁니다.
    for (int i = 0; i < 70; i++) {          /* 70KB: 64KB 를 넘긴다 */
        write(fd[1], block, sizeof(block));
        printf("%d KB 씀\n", i + 1);
        fflush(stdout);
    }
    printf("끝\n");
$ timeout 5 ./fill_block | tail -2
63 KB 씀
64 KB 씀
$ echo ${PIPESTATUS[0]}
124
64KB까지 쓰고 65번째 write에서 멈췄습니다. “끝”은 나오지 않았고 종료 코드는 124입니다. 이것이 파이프의 세 번째 성질, 가득 차면 write가 기다린다입니다.
이 성질이 얼핏 불편해 보이지만, 사실은 파이프의 가장 큰 장점입니다. 자동 흐름 제어가 되기 때문입니다. 쓰는 쪽이 아무리 빨라도 읽는 쪽이 비워 주는 속도에 맞춰집니다. cat 100GB짜리파일 | grep ERROR가 메모리를 100GB 쓰지 않는 이유가 바로 이것입니다. cat은 64KB를 채우면 잠들고, grep이 읽어 가면 깨어나 다음 64KB를 채웁니다.
echo ${PIPESTATUS[0]}:timeout 5 ./fill_block | tail -2처럼 파이프로 이은 명령에서$?는 마지막 명령(tail)의 종료 코드입니다. 앞 명령의 종료 코드는 Bash의PIPESTATUS배열에서 봅니다. 0번이 첫 명령입니다.
1.5 SIGPIPE: 아무도 안 듣는데 말하면
파이프의 반대편 함정입니다. 읽는 끝이 전부 닫힌 파이프에 쓰면 커널이 SIGPIPE 시그널을 보냅니다. 그리고 18주차에서 본 대로 이 시그널의 기본 동작은 프로세스 종료입니다.
pipe_basic.c의 5번 실험은 signal(SIGPIPE, SIG_IGN)으로 시그널을 무시했기 때문에 죽지 않고 write가 -1과 errno = EPIPE로 돌아왔습니다. 무시하지 않으면 어떻게 될까요? sigpipe_default.c:
    int fd[2];
    pipe(fd);
    close(fd[0]);                  /* 읽는 끝을 아무도 안 가진다 */
    printf("쓰기 직전\n");
    fflush(stdout);
    write(fd[1], "x", 1);          /* SIGPIPE 기본 동작 = 종료 */
    printf("이 줄은 나오지 않는다\n");
$ ./sigpipe_default
쓰기 직전
$ echo $?
141
“이 줄은 나오지 않는다”가 정말 나오지 않았고, 종료 코드가 141입니다. 18주차에서 배운 규칙대로 128 + 시그널 번호(SIGPIPE = 13)입니다. perror도 오류 메시지도 없이 그냥 죽습니다.
서버 프로그램은 거의 예외 없이 SIGPIPE를 무시합니다. 클라이언트가 갑자기 연결을 끊었다고 서버 전체가 죽으면 안 되니까요. 21주차 네트워크 프로그래밍에서 이 이야기가 다시 나옵니다.
그런데 이 성질에는 좋은 쓸모도 있습니다. 셸에서 yes | head -3을 실행하면 어떻게 끝날까요? yes는 y를 무한히 출력하는 프로그램입니다.
$ yes | head -3
y
y
y
$ echo "${PIPESTATUS[@]}"
141 0
head가 3줄을 읽고 끝나면서 읽는 끝이 닫히고, yes가 다음 write에서 SIGPIPE를 받아 죽었습니다. PIPESTATUS가 정확히 그것을 보여 줍니다. yes는 141(SIGPIPE로 죽음), head는 0(정상). 무한 출력 프로그램이 자동으로 멈추는 것이죠. 셸 파이프라인이 안전한 이유입니다.
1.6 파이프의 다섯 가지 성질
지금까지 실험으로 확인한 것을 정리하면 이렇습니다. 예제 4번 출력에 있는 목록입니다.
| # | 성질 | 확인한 실험 |
|---|---|---|
| 1 | 단방향: 양방향이 필요하면 두 개 | 1.3절 EBADF |
| 2 | 혈연관계 전용: fork로 fd를 물려받은 프로세스끼리만 |
1.1절 (남남은 3절 FIFO로) |
| 3 | 버퍼 유한: 리눅스 기본 64KB. 가득 차면 write가 기다린다 |
1.4절 65,536바이트, 종료 코드 124 |
| 4 | EOF 규칙: 쓰는 끝이 전부 닫혀야 read가 0을 반환 |
1.2절 종료 코드 124 두 번 |
| 5 | SIGPIPE: 읽는 끝이 모두 닫힌 파이프에 쓰면 프로세스가 죽는다 | 1.5절 종료 코드 141 |
2. 파이프라인: ls | wc -l의 정체
2.1 18주차 미니 쉘에 없던 기능
18주차에 미니 쉘을 만들면서 리다이렉션(>)은 구현했지만 파이프(|)는 “19주차에서 재료를 배웁니다”라고 미뤄 뒀습니다. 1주차 3절에서도 “파이프는 19주차에 C로 직접 만들어 봅니다”라고 약속했죠. 이제 그 재료가 준비됐습니다.
ls | wc -l을 칠 때 셸이 하는 일은 이렇습니다.
pipe(fd)로 관을 판다fork두 번 (ls용,wc용)ls쪽 자식:dup2(fd[1], 1)— 표준 출력을 파이프로wc쪽 자식:dup2(fd[0], 0)— 표준 입력을 파이프로- 부모는 양쪽 fd를 모두 닫고 둘 다
wait
18주차의 리다이렉션과 완전히 같은 기법입니다. dup2의 대상이 파일에서 파이프로 바뀌었을 뿐이죠. dup2를 다시 정리하고 갑니다.
#include <unistd.h>
int dup2(int oldfd, int newfd);
| 항목 | 설명 |
|---|---|
oldfd |
복제할 원본 fd. 여기서는 파이프의 한쪽 끝 |
newfd |
복제본이 들어갈 번호. newfd가 이미 열려 있으면 먼저 조용히 닫고 덮어씁니다 |
| 반환값 | 성공하면 newfd, 실패하면 -1 |
| 실패하는 경우 | EBADF (oldfd가 열려 있지 않다), EINTR |
| 뜻 | “newfd번이 이제 oldfd와 같은 곳을 가리키게 하라” |
ls 쪽 자식의 fd 표가 어떻게 바뀌는지 그려 보면 명확합니다.
dup2(fd[1], 1) 전              dup2(fd[1], 1) 후             close(fd[1]) 후
┌───┬──────────┐               ┌───┬──────────┐              ┌───┬──────────┐
│ 0 │ 터미널   │               │ 0 │ 터미널   │              │ 0 │ 터미널   │
│ 1 │ 터미널   │               │ 1 │ 파이프 W │◀─ 덮어씀     │ 1 │ 파이프 W │
│ 2 │ 터미널   │               │ 2 │ 터미널   │              │ 2 │ 터미널   │
│ 3 │ 파이프 R │               │ 3 │ 파이프 R │              │ 3 │ 파이프 R │
│ 4 │ 파이프 W │               │ 4 │ 파이프 W │              │ 4 │ (닫힘)   │
└───┴──────────┘               └───┴──────────┘              └───┴──────────┘
마지막 단계에서 4번을 닫는 이유가 있습니다. 1번과 4번이 같은 쓰는 끝을 가리키면 쓰는 끝 fd가 2개가 되어 1.2절의 EOF 규칙이 깨집니다. 복제했으면 원본은 닫습니다.
examples/pipe_shell.c:
/*
 * pipe_shell.c - 파이프라인의 정체: ls | wc -l 만들기
 * 19주차: IPC와 동기화
 *
 * 18주차 미니 쉘에 없던 기능, 드디어 파이프 `|`입니다.
 *
 * `ls | wc -l`을 칠 때 쉘이 하는 일:
 *   1. pipe(fd)로 관을 판다
 *   2. fork 두 번 (ls용, wc용)
 *   3. ls  쪽 자식: dup2(fd[1], 1)  -> 표준 출력을 파이프로!
 *      wc  쪽 자식: dup2(fd[0], 0)  -> 표준 입력을 파이프로!
 *   4. 부모는 양쪽 fd를 모두 닫고 둘 다 wait
 *
 * 18주차의 dup2 리다이렉션과 똑같은 기법입니다.
 * 대상이 '파일'에서 '파이프'로 바뀌었을 뿐!
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <sys/wait.h>

/* 명령 두 개를 파이프로 잇는다: left | right */
int run_pipeline(char *left[], char *right[]) {
    int fd[2];
    if (pipe(fd) < 0) {
        perror("pipe");
        return -1;
    }

    /* ---------- 왼쪽 명령: 출력을 파이프로 ---------- */
    pid_t pid_left = fork();
    if (pid_left < 0) { perror("fork"); return -1; }

    if (pid_left == 0) {
        close(fd[0]);                /* 읽는 끝 불필요 */
        dup2(fd[1], STDOUT_FILENO);  /* 표준 출력 -> 파이프 쓰는 끝 */
        close(fd[1]);                /* 복제했으니 원본은 닫는다 */

        execvp(left[0], left);
        perror(left[0]);
        _exit(127);
    }

    /* ---------- 오른쪽 명령: 입력을 파이프로 ---------- */
    pid_t pid_right = fork();
    if (pid_right < 0) { perror("fork"); return -1; }

    if (pid_right == 0) {
        close(fd[1]);                /* 쓰는 끝 불필요 */
        dup2(fd[0], STDIN_FILENO);   /* 표준 입력 <- 파이프 읽는 끝 */
        close(fd[0]);

        execvp(right[0], right);
        perror(right[0]);
        _exit(127);
    }

    /* ---------- 부모: 양쪽 끝 모두 닫기 (중요!) ---------- */
    close(fd[0]);
    close(fd[1]);
    /* 부모가 안 닫으면 wc는 EOF를 영원히 못 받아 멈춘다!
     * "쓰는 끝이 전부 닫혀야 EOF"라는 규칙을 기억하세요 */

    int status_left, status_right;
    waitpid(pid_left, &status_left, 0);
    waitpid(pid_right, &status_right, 0);

    return WIFEXITED(status_right) ? WEXITSTATUS(status_right) : -1;
}

/* 명령 N개를 이어 붙이는 일반화 버전 */
int run_chain(char **commands[], int n) {
    int prev_read = -1;              /* 이전 단계의 읽는 끝 */
    pid_t pids[8];

    for (int i = 0; i < n; i++) {
        int fd[2] = {-1, -1};

        if (i < n - 1) {             /* 마지막이 아니면 다음으로 갈 파이프 필요 */
            if (pipe(fd) < 0) { perror("pipe"); return -1; }
        }

        pid_t pid = fork();
        if (pid < 0) { perror("fork"); return -1; }

        if (pid == 0) {
            if (prev_read >= 0) {            /* 첫 명령이 아니면 입력 연결 */
                dup2(prev_read, STDIN_FILENO);
                close(prev_read);
            }
            if (i < n - 1) {                 /* 마지막이 아니면 출력 연결 */
                close(fd[0]);
                dup2(fd[1], STDOUT_FILENO);
                close(fd[1]);
            }
            execvp(commands[i][0], commands[i]);
            perror(commands[i][0]);
            _exit(127);
        }

        pids[i] = pid;
        if (prev_read >= 0) close(prev_read);   /* 부모는 쓴 뒤 바로 닫는다 */
        if (i < n - 1) {
            close(fd[1]);
            prev_read = fd[0];       /* 다음 명령의 입력으로 물려준다 */
        }
    }

    for (int i = 0; i < n; i++) waitpid(pids[i], NULL, 0);
    return 0;
}

int main(void) {
    printf("=== 1. ls | wc -l : 두 명령 잇기 ===\n");
    printf("(현재 디렉토리의 항목 수를 센다)\n");
    fflush(stdout);

    char *ls_cmd[]  = {"ls", NULL};
    char *wc_cmd[]  = {"wc", "-l", NULL};
    run_pipeline(ls_cmd, wc_cmd);

    printf("\n=== 2. 파이프라인의 정체 ===\n");
    printf("dup2(fd[1], 1): 왼쪽 명령의 표준 출력을 파이프로 바꿔치기\n");
    printf("dup2(fd[0], 0): 오른쪽 명령의 표준 입력을 파이프로 바꿔치기\n");
    printf("-> 두 프로그램은 자기가 파이프에 연결된 줄도 모른다!\n");
    printf("   그냥 평소대로 printf 하고 scanf 할 뿐.\n");
    printf("   이것이 유닉스 '작은 도구의 조합' 철학의 기술적 토대입니다.\n");

    printf("\n=== 3. 3단 파이프라인 ===\n");
    printf("cat /etc/passwd | grep -c bash  (bash를 쓰는 계정 수)\n");
    fflush(stdout);

    char *c1[] = {"cat", "/etc/passwd", NULL};
    char *c2[] = {"grep", "-c", "bash", NULL};
    char **chain2[] = {c1, c2};
    run_chain(chain2, 2);

    printf("\nseq 1 20 | grep 1 | wc -l  (1이 들어간 수의 개수)\n");
    fflush(stdout);

    char *d1[] = {"seq", "1", "20", NULL};
    char *d2[] = {"grep", "1", NULL};
    char *d3[] = {"wc", "-l", NULL};
    char **chain3[] = {d1, d2, d3};
    run_chain(chain3, 3);

    printf("\n=== 4. 부모가 fd를 닫아야 하는 이유 ===\n");
    printf("파이프의 쓰는 끝을 '한 프로세스라도' 열어두면 EOF가 안 온다.\n");
    printf("부모가 fd[1]을 안 닫으면? wc가 입력이 끝나기를 영원히 기다린다.\n");
    printf("-> 파이프 프로그래밍에서 프로그램이 멈추는 원인 1위!\n");

    printf("\n=== 5. 명령이 동시에 돈다는 것 ===\n");
    printf("ls가 끝난 뒤 wc가 도는 게 아니라 '동시에' 돕니다.\n");
    printf("ls의 출력이 파이프 버퍼(64KB)를 채우면 ls가 잠시 멈추고,\n");
    printf("wc가 읽어가면 다시 진행합니다. 버퍼가 자동 흐름 제어를 해주는 것!\n");
    printf("-> 그래서 `yes | head -5` 같은 무한 출력도 안전하게 끝납니다.\n");

    return 0;
}
$ gcc -Wall -Wextra -std=gnu11 -g examples/pipe_shell.c -o build/pipe_shell
$ ./build/pipe_shell
=== 1. ls | wc -l : 두 명령 잇기 ===
(현재 디렉토리의 항목 수를 센다)
9

=== 2. 파이프라인의 정체 ===
...

=== 3. 3단 파이프라인 ===
cat /etc/passwd | grep -c bash  (bash를 쓰는 계정 수)
2

seq 1 20 | grep 1 | wc -l  (1이 들어간 수의 개수)
11
첫 숫자 9는 week19 폴더의 항목 수입니다(build를 만든 뒤라 9개). 셸에서 ls | wc -l을 쳐서 같은 숫자가 나오는지 확인해 보세요. 우리가 만든 것이 진짜 파이프라인이라는 증거입니다. grep -c bash의 결과 2는 이 컴퓨터에 bash를 로그인 셸로 쓰는 계정이 둘이라는 뜻이라 여러분의 컴퓨터에서는 다를 수 있습니다.
2.2 dup2 두 줄이 전부
    if (pid_left == 0) {
        close(fd[0]);                /* 읽는 끝 불필요 */
        dup2(fd[1], STDOUT_FILENO);  /* 표준 출력 -> 파이프 쓰는 끝 */
        close(fd[1]);                /* 복제했으니 원본은 닫는다 */

        execvp(left[0], left);
        ...
    }
dup2(fd[1], STDOUT_FILENO) 한 줄이 “이 프로세스의 1번 fd가 이제 파이프를 가리키게 하라”는 뜻입니다. 그 뒤 exec된 ls는 자기가 파이프에 연결된 줄도 모릅니다. ls의 코드 어딘가에는 결국 write(1, ...)이 있을 텐데, 1번이 파이프를 가리키니 출력이 파이프로 갑니다. ls를 고칠 필요가 전혀 없습니다.
STDOUT_FILENO는 <unistd.h>에 정의된 상수로 값은 1입니다. 그냥 1이라고 써도 같지만, 읽는 사람을 위해 이름을 씁니다.
이 구조가 유닉스 철학의 기술적 토대입니다. “작은 도구를 조합한다” 는 원칙이 가능한 이유는, 각 프로그램이 표준 입출력만 알면 되고 그 연결은 셸이 바깥에서 처리해 주기 때문입니다. ls와 wc는 서로의 존재를 모릅니다. 1주차 3절에서 apt list --installed | grep gcc를 칠 때 grep이 apt를 알 필요가 없었던 것과 같습니다.
2.3 부모가 닫지 않으면 — 파이프라인 멈추기
1.2절의 규칙이 파이프라인에서 어떻게 나타나는지 봅시다. pipe_shell.c의 run_pipeline에서 부모의 close 두 줄을 뺀 pipeline_noclose.c입니다.
    /* close(fd[0]); close(fd[1]);  <- 부모가 닫지 않는다 */
    wait(NULL);
    wait(NULL);
    printf("[부모] 끝\n");
$ timeout 5 ./pipeline_noclose
$ echo ${PIPESTATUS[0]}
124
ls는 정상적으로 끝났습니다. 자기 출력을 다 쓰고 종료했으니까요. 문제는 wc입니다. wc -l은 입력이 끝나야(EOF) 줄 수를 출력하는데, 부모가 쓰는 끝 fd[1]을 들고 있으니 EOF가 오지 않습니다. wc는 영원히 기다리고, 부모는 wait으로 wc를 영원히 기다립니다.
이 실험에서 배울 점이 하나 더 있습니다. 부모는 파이프에 아무것도 쓰지 않았는데도 닫아야 합니다. “쓰지 않으니 상관없겠지”가 아니라, “쓰는 끝을 가리키는 fd를 들고 있다”는 사실 자체가 EOF를 막습니다.
2.4 N단 파이프라인
3단 이상은 일반화가 필요합니다.
    for (int i = 0; i < n; i++) {
        int fd[2] = {-1, -1};
        if (i < n - 1) pipe(fd);             /* 마지막이 아니면 다음 파이프 */

        pid_t pid = fork();
        if (pid == 0) {
            if (prev_read >= 0) {            /* 첫 명령이 아니면 입력 연결 */
                dup2(prev_read, STDIN_FILENO);
                close(prev_read);
            }
            if (i < n - 1) {                 /* 마지막이 아니면 출력 연결 */
                close(fd[0]);
                dup2(fd[1], STDOUT_FILENO);
                close(fd[1]);
            }
            execvp(commands[i][0], commands[i]);
            ...
        }

        if (prev_read >= 0) close(prev_read);   /* 부모는 쓴 뒤 바로 닫는다 */
        if (i < n - 1) {
            close(fd[1]);
            prev_read = fd[0];       /* 다음 명령의 입력으로 물려준다 */
        }
    }
핵심은 prev_read를 바통처럼 넘기는 것입니다. seq 1 20 | grep 1 | wc -l을 따라가 봅시다.
| i | 명령 | 입력 | 출력 | 부모가 넘기는 prev_read |
|---|---|---|---|---|
| 0 | seq 1 20 |
터미널 (첫 명령이라 그대로) | 파이프 A의 쓰는 끝 | A의 읽는 끝 |
| 1 | grep 1 |
파이프 A의 읽는 끝 | 파이프 B의 쓰는 끝 | B의 읽는 끝 |
| 2 | wc -l |
파이프 B의 읽는 끝 | 터미널 (마지막이라 그대로) | (없음) |
각 단계는 “이전 단계의 읽는 끝”을 입력으로 받고, “새 파이프의 쓰는 끝”을 출력으로 씁니다. 그리고 부모가 매 단계마다 즉시 fd를 닫는다는 점을 보세요. 파이프 N개면 fd가 2N개인데, 부모에게 필요한 것은 “다음 자식에게 넘겨줄 읽는 끝” 하나뿐입니다. 안 닫으면 2.3절의 멈춤이 N배로 일어납니다.
2.5 명령이 “동시에” 돈다
흔한 오해가 하나 있습니다. ls | wc -l에서 ls가 다 끝난 뒤 wc가 시작하는 것이 아닙니다. 둘은 동시에 돕니다. 코드를 보면 당연합니다. fork를 두 번 연달아 하고 그다음에야 wait을 하니까요.
ls가 출력을 쏟아내고, wc가 그때그때 읽어 처리합니다. 1.4절에서 본 대로 파이프 버퍼(64KB)가 가득 차면 ls가 잠시 멈추고, wc가 읽어 가면 다시 진행하죠. 이 덕분에 무한한 데이터도 파이프라인으로 처리할 수 있습니다.
yes | head -5              # yes는 무한 출력인데도 즉시 끝난다 (1.5절)
cat huge.log | grep ERROR  # 100GB 파일도 메모리 걱정 없이 (1.4절)
중간 결과를 디스크나 메모리에 전부 담을 필요가 없다는 것, 이것이 유닉스 파이프라인의 진짜 힘입니다.
직접 해 보기: 18주차
mini_shell.c에|지원을 넣어 보세요. 입력 줄을|로 나누고, 조각마다 18주차의 토큰 분리를 적용한 뒤,run_chain에 넘기면 됩니다.ls -l | grep txt | wc -l이 동작하면 성공입니다. 14절 심화 문제 6번입니다.
3. FIFO: 남남끼리도 대화한다
3.1 이름을 가진 파이프
익명 파이프에는 결정적 한계가 있습니다. fork로 fd를 물려받은 프로세스끼리만 쓸 수 있죠. 터미널 두 개에서 따로 실행한 프로그램 둘은 어떻게 할까요? 서로의 fd 표를 볼 방법이 없습니다.
FIFO(named pipe, 명명 파이프) 가 답입니다. 파일 시스템에 이름을 가진 파이프입니다. 파이프의 버퍼는 커널이 갖고, 그 버퍼를 찾아가는 이름표만 파일 시스템에 둡니다. 이름만 알면 누구나 open해서 양 끝을 잡을 수 있습니다.
#include <sys/stat.h>
int mkfifo(const char *pathname, mode_t mode);
| 항목 | 설명 |
|---|---|
pathname |
만들 경로. 보통의 파일 경로와 똑같습니다 |
mode |
권한. 1주차의 chmod 숫자와 같습니다(0666 = rw-rw-rw-). umask가 적용되어 실제로는 0664가 됩니다 |
| 반환값 | 성공 0, 실패 -1 |
| 실패하는 경우 | EEXIST (이미 그 이름이 있다. 가장 흔함), EACCES (그 폴더에 쓸 권한이 없다) |
mkfifo는 이름표만 만듭니다. 데이터를 주고받으려면 18주차에서 배운 open으로 열어야 합니다. 한쪽은 O_WRONLY, 다른 쪽은 O_RDONLY로요.
examples/fifo_demo.c:
/*
 * fifo_demo.c - 명명 파이프(FIFO): 남남끼리도 대화한다
 * 19주차: IPC와 동기화
 *
 * 익명 파이프의 한계: fork로 fd를 물려받은 '혈연관계'만 쓸 수 있다.
 * 완전히 따로 실행된 두 프로그램은? -> FIFO(named pipe)!
 *
 * FIFO는 "파일 시스템에 이름을 가진 파이프"입니다.
 *   mkfifo("/tmp/mypipe", 0666)  -> 경로에 파이프 생성
 *   한쪽이 open(O_WRONLY), 다른 쪽이 open(O_RDONLY)
 *
 * ls -l로 보면 타입 문자가 'p'로 나옵니다 (18주차 S_ISFIFO!).
 * 디스크에 데이터를 저장하지는 않습니다 - 이름만 파일이고 내용은 커널 버퍼.
 *
 * 재미있는 성질: open이 짝을 기다린다 (랑데부!)
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <fcntl.h>
#include <sys/stat.h>
#include <sys/wait.h>
#include <errno.h>

#define FIFO_PATH "/tmp/week19_demo_fifo"

int main(void) {
    printf("=== 1. FIFO 만들기 ===\n");

    unlink(FIFO_PATH);               /* 이전 실행의 찌꺼기 제거 */

    if (mkfifo(FIFO_PATH, 0666) < 0) {
        perror("mkfifo");
        return 1;
    }
    printf("생성: %s\n", FIFO_PATH);

    /* 18주차의 stat으로 타입 확인 */
    struct stat st;
    if (lstat(FIFO_PATH, &st) == 0) {
        printf("파일 타입: %s (크기 %lld바이트)\n",
               S_ISFIFO(st.st_mode) ? "FIFO(p) - 명명 파이프!" : "???",
               (long long)st.st_size);
        printf("(이름은 파일 시스템에 있지만 크기는 0 - 데이터는 커널에!)\n");
        printf("직접 확인: ls -l %s\n\n", FIFO_PATH);
    }

    /* ---------- 2. 서로 다른 프로세스가 FIFO로 대화 ---------- */
    printf("=== 2. 남남 프로세스의 대화 ===\n");
    printf("(여기서는 시연을 위해 fork로 두 프로세스를 만들지만,\n");
    printf(" 핵심은 '경로 이름'만으로 만난다는 점입니다.\n");
    printf(" 완전히 따로 실행한 프로그램 둘이어도 똑같이 동작합니다!)\n\n");
    fflush(stdout);

    pid_t pid = fork();
    if (pid < 0) { perror("fork"); return 1; }

    if (pid == 0) {
        /* ---------- 자식 = 읽는 프로그램 ---------- */
        /* 주의: 이 open은 '쓰는 쪽이 열 때까지' 블록된다 (랑데부!) */
        int fd = open(FIFO_PATH, O_RDONLY);
        if (fd < 0) { perror("[읽기] open"); _exit(1); }

        printf("[읽기 프로세스] FIFO 열림! (쓰는 쪽과 만났다)\n");
        fflush(stdout);

        char buffer[256];
        ssize_t n;
        while ((n = read(fd, buffer, sizeof(buffer) - 1)) > 0) {
            buffer[n] = '\0';
            printf("[읽기 프로세스] 수신: %s", buffer);
            fflush(stdout);
        }
        printf("[읽기 프로세스] EOF - 상대가 닫았다\n");
        close(fd);
        _exit(0);
    }

    /* ---------- 부모 = 쓰는 프로그램 ---------- */
    usleep(200000);                  /* 자식이 먼저 열도록 잠깐 양보 */
    printf("[쓰기 프로세스] FIFO를 여는 중...\n");
    fflush(stdout);

    int fd = open(FIFO_PATH, O_WRONLY);
    if (fd < 0) { perror("[쓰기] open"); return 1; }
    printf("[쓰기 프로세스] 열림! 이제 보낸다\n");
    fflush(stdout);

    const char *lines[] = {
        "FIFO로 보내는 첫 줄\n",
        "익명 파이프와 달리 남남끼리도 OK\n",
        "이름만 알면 만날 수 있다\n",
    };
    for (int i = 0; i < 3; i++) {
        write(fd, lines[i], strlen(lines[i]));
        usleep(150000);
    }
    close(fd);
    wait(NULL);

    /* ---------- 3. 논블로킹 열기 ---------- */
    printf("\n=== 3. open이 '기다린다'는 것 (랑데부) ===\n");
    printf("FIFO의 open(O_RDONLY)은 쓰는 쪽이 열 때까지 블록됩니다.\n");
    printf("반대도 마찬가지. 서로 만날 때까지 기다리는 '랑데부'죠.\n\n");

    printf("기다리기 싫다면 O_NONBLOCK:\n");
    int nb = open(FIFO_PATH, O_WRONLY | O_NONBLOCK);
    if (nb < 0) {
        printf("  open(O_WRONLY|O_NONBLOCK) -> 실패, errno %d (%s)\n",
               errno, strerror(errno));
        printf("  ENXIO = '읽는 쪽이 아무도 없음'. 기다리지 않고 즉시 알려준다.\n");
    } else {
        printf("  (읽는 쪽이 있어서 바로 열렸습니다)\n");
        close(nb);
    }

    /* ---------- 4. 정리 ---------- */
    printf("\n=== 4. FIFO 정리 ===\n");
    unlink(FIFO_PATH);               /* 이름 제거 = 파일 삭제와 같다 */
    printf("unlink로 제거 완료 (mkfifo로 만든 것은 직접 지워야 합니다)\n");

    printf("\n=== 5. 익명 파이프 vs FIFO ===\n");
    printf("+------------+------------------+---------------------+\n");
    printf("|            | 익명 파이프      | FIFO(명명 파이프)   |\n");
    printf("+------------+------------------+---------------------+\n");
    printf("| 생성       | pipe()           | mkfifo() + open()   |\n");
    printf("| 이름       | 없음             | 파일 시스템 경로    |\n");
    printf("| 통신 상대  | 혈연(fork) 관계  | 아무나 (경로만 알면)|\n");
    printf("| 수명       | fd 닫히면 소멸   | unlink 할 때까지    |\n");
    printf("| 쓰임새     | 쉘 파이프라인    | 데몬-클라이언트     |\n");
    printf("+------------+------------------+---------------------+\n");
    printf("\n셸에서도 만들 수 있습니다:\n");
    printf("  $ mkfifo /tmp/p\n");
    printf("  $ cat /tmp/p     (터미널 1 - 기다린다)\n");
    printf("  $ echo hi > /tmp/p  (터미널 2 - 그 순간 터미널 1에 hi가!)\n");
    return 0;
}
$ gcc -Wall -Wextra -std=gnu11 -g examples/fifo_demo.c -o build/fifo_demo
$ ./build/fifo_demo
=== 1. FIFO 만들기 ===
생성: /tmp/week19_demo_fifo
파일 타입: FIFO(p) - 명명 파이프! (크기 0바이트)
(이름은 파일 시스템에 있지만 크기는 0 - 데이터는 커널에!)
직접 확인: ls -l /tmp/week19_demo_fifo

=== 2. 남남 프로세스의 대화 ===
(여기서는 시연을 위해 fork로 두 프로세스를 만들지만,
 핵심은 '경로 이름'만으로 만난다는 점입니다.
 완전히 따로 실행한 프로그램 둘이어도 똑같이 동작합니다!)

[쓰기 프로세스] FIFO를 여는 중...
[쓰기 프로세스] 열림! 이제 보낸다
[읽기 프로세스] FIFO 열림! (쓰는 쪽과 만났다)
[읽기 프로세스] 수신: FIFO로 보내는 첫 줄
[읽기 프로세스] 수신: 익명 파이프와 달리 남남끼리도 OK
[읽기 프로세스] 수신: 이름만 알면 만날 수 있다

=== 3. open이 '기다린다'는 것 (랑데부) ===
FIFO의 open(O_RDONLY)은 쓰는 쪽이 열 때까지 블록됩니다.
반대도 마찬가지. 서로 만날 때까지 기다리는 '랑데부'죠.

기다리기 싫다면 O_NONBLOCK:
  open(O_WRONLY|O_NONBLOCK) -> 실패, errno 6 (No such device or address)
  ENXIO = '읽는 쪽이 아무도 없음'. 기다리지 않고 즉시 알려준다.

=== 4. FIFO 정리 ===
unlink로 제거 완료 (mkfifo로 만든 것은 직접 지워야 합니다)
...
출력에서 눈여겨볼 것: “[읽기 프로세스] EOF – 상대가 닫았다”가 안 나왔습니다. 코드에는 있는데요. 이유는 1.2절과 같습니다. 자식(읽기 프로세스)이 EOF를 받고 printf한 뒤 _exit(0)으로 끝나는데, _exit는 exit와 달리 stdio 버퍼를 비우지 않고 즉시 종료합니다. 앞의 수신 줄들은 fflush(stdout)를 붙여서 나왔지만, EOF 줄에는 fflush가 없어서 버퍼에 남은 채 사라진 것입니다. 18주차에서 본 대로 _exit는 stdio 버퍼를 비우지 않고 끝나기 때문입니다. 직접 고쳐 보세요. printf("[읽기 프로세스] EOF ...") 뒤에 fflush(stdout); 한 줄을 넣으면 나옵니다.
3.2 이름은 파일, 내용은 커널
파일 타입: FIFO(p) - 명명 파이프! (크기 0바이트)
18주차의 lstat과 S_ISFIFO로 확인한 결과입니다. ls -l로 보면 1주차에서 배운 종류 글자 자리에 p 가 나옵니다.
$ ls -l /tmp/week19_demo_fifo
prw-rw-r-- 1 user user 0  9월 29 02:18 /tmp/week19_demo_fifo
맨 앞이 -(파일)도 d(폴더)도 아닌 p입니다. 권한은 mkfifo에 준 0666에서 umask 002를 뺀 rw-rw-r--(664)입니다. 1주차 9절의 umask 규칙이 여기서도 똑같이 적용됩니다.
중요한 것은 크기가 0이라는 점입니다. FIFO는 디스크에 데이터를 저장하지 않습니다. 이름만 파일 시스템에 있고 내용은 커널 버퍼에 있죠. 익명 파이프와 똑같은 메커니즘에 이름표만 붙인 것입니다. 그래서 FIFO를 cat으로 읽으면 파일을 읽는 게 아니라 누군가 써 주기를 기다립니다. 셸에서 직접 해 봅시다. 터미널 두 개를 여세요.
$ mkfifo /tmp/p
$ ls -l /tmp/p
prw-rw-r-- 1 user user 0  9월 29 02:18 /tmp/p
$ cat /tmp/p                # 터미널 1: 멈춘 것처럼 보인다 (쓰는 쪽을 기다리는 중)
$ echo "안녕" > /tmp/p      # 터미널 2: 이 순간 터미널 1에 "안녕"이 나타나고 cat이 끝난다
$ rm /tmp/p
터미널 하나로도 확인할 수 있습니다. cat을 백그라운드(&)로 띄우면 됩니다.
$ mkfifo /tmp/p
$ cat /tmp/p &
[1] 12345
$ echo "안녕" > /tmp/p
안녕
[1]+  완료                  cat /tmp/p
$ rm /tmp/p
echo가 쓰는 순간 cat이 받아 출력하고 EOF를 받아 끝났습니다. C 프로그램이 아니라 셸 명령 둘이 FIFO로 만난 것입니다. 이것이 “남남끼리”의 뜻입니다.
C로도 정말 남남인 두 프로그램을 만들어 봅시다. fifo_demo.c는 시연을 위해 fork를 썼지만, 여기서는 서버와 클라이언트가 별개의 실행 파일입니다. fifo_server.c는 FIFO를 만들고 읽기로 열어 기다리고, fifo_client.c는 쓰기로 열어 명령줄 인자를 한 줄씩 보냅니다.
/* fifo_server.c */
    unlink("/tmp/w19_chat");
    mkfifo("/tmp/w19_chat", 0666);
    printf("[서버] 클라이언트를 기다리는 중...\n"); fflush(stdout);
    int fd = open("/tmp/w19_chat", O_RDONLY);        /* 클라이언트가 열 때까지 */
    char buf[128];
    ssize_t n;
    while ((n = read(fd, buf, sizeof(buf) - 1)) > 0) {
        buf[n] = '\0';
        printf("[서버] 받음: %s", buf); fflush(stdout);
    }
    printf("[서버] 클라이언트가 끊었다\n");
    close(fd);
    unlink("/tmp/w19_chat");
/* fifo_client.c */
    int fd = open("/tmp/w19_chat", O_WRONLY);
    if (fd < 0) { perror("open"); return 1; }
    for (int i = 1; i < argc; i++) {
        char line[128];
        snprintf(line, sizeof(line), "%s\n", argv[i]);
        write(fd, line, strlen(line));
    }
    close(fd);
$ ./fifo_server &
[서버] 클라이언트를 기다리는 중...
$ ./fifo_client "안녕하세요" "남남인데 만났네요"
[서버] 받음: 안녕하세요
남남인데 만났네요
[서버] 클라이언트가 끊었다
두 프로그램은 fork 관계가 아닙니다. 서로의 PID도 모릅니다. /tmp/w19_chat이라는 이름 하나로 만났습니다. 클라이언트가 close하자 서버의 read가 0을 받아 “끊었다”가 나온 것도 1.2절의 EOF 규칙 그대로입니다.
그런데 출력을 자세히 보세요. 클라이언트는 write를 두 번 했는데 서버는 “[서버] 받음:”을 한 번만 찍었습니다. 두 줄이 한 번의 read에 붙어서 도착한 것입니다. 파이프와 FIFO는 바이트 흐름이라 어디까지가 한 메시지인지 기억하지 않습니다. 8.1절에서 이 성질을 실험으로 다시 봅니다.
3.3 랑데부: open이 짝을 기다린다 — 직접 멈춰 보기
FIFO의 독특한 성질입니다. open(O_RDONLY)은 쓰는 쪽이 열 때까지 돌아오지 않습니다. 반대도 마찬가지죠. 서로 만날 때까지 기다리는 랑데부(rendezvous) 입니다. 파일의 open은 즉시 돌아오는 것과 다릅니다.
정말 그런지 확인해 봅시다. 쓰는 쪽 없이 읽기로만 여는 fifo_alone.c입니다.
    unlink("/tmp/w19_alone");
    mkfifo("/tmp/w19_alone", 0666);
    printf("open(O_RDONLY) 호출... (쓰는 쪽이 없다)\n");
    fflush(stdout);
    int fd = open("/tmp/w19_alone", O_RDONLY);   /* 여기서 영원히 기다린다 */
    printf("열렸다! fd=%d\n", fd);
$ timeout 5 ./fifo_alone
open(O_RDONLY) 호출... (쓰는 쪽이 없다)
$ echo $?
124
“열렸다!”는 나오지 않았습니다. open 안에서 5초를 기다리다 timeout에 죽었습니다. 아직 파일을 열지도 못한 것입니다.
이 성질은 유용하기도 하고 함정이기도 합니다.
- 유용: 별도의 동기화 없이 “양쪽이 준비됐을 때 시작”이 보장됩니다.
fifo_demo.c에서 부모가usleep으로 양보한 것은 출력 순서를 보기 좋게 하려는 것이지, 없어도 동작합니다 - 함정: 상대가 영영 안 나타나면 프로그램이 멈춥니다. 위 실험이 그것입니다
기다리기 싫으면 O_NONBLOCK을 씁니다.
    int nb = open(FIFO_PATH, O_WRONLY | O_NONBLOCK);
    /* 읽는 쪽이 없으면 즉시 실패, errno = ENXIO */
ENXIO(errno 6)는 “읽는 쪽이 아무도 없다”는 뜻입니다. 데몬이 “클라이언트가 붙어 있나?”를 확인할 때 쓰는 기법이죠. 방향에 따라 규칙이 다릅니다.
| 여는 방식 | 상대가 없을 때 |
|---|---|
O_RDONLY |
쓰는 쪽이 올 때까지 기다림 |
O_RDONLY \| O_NONBLOCK |
즉시 성공. 이후 read는 0(EOF)을 돌려줌 |
O_WRONLY |
읽는 쪽이 올 때까지 기다림 |
O_WRONLY \| O_NONBLOCK |
즉시 실패, ENXIO |
읽기는 상대 없이도 열리는데 쓰기는 안 되는 이유는 1.5절의 SIGPIPE와 같습니다. 아무도 안 읽는 파이프에 쓰는 것은 처음부터 막는 것입니다.
3.4 익명 파이프 vs FIFO
| 익명 파이프 | FIFO (명명 파이프) | |
|---|---|---|
| 생성 | pipe() |
mkfifo() + open() |
| 이름 | 없음 | 파일 시스템 경로 |
| 통신 상대 | 혈연(fork) 관계 |
아무나 (경로만 알면) |
| 수명 | fd가 닫히면 소멸 | unlink 할 때까지 |
| 대표 쓰임새 | 셸 파이프라인 | 데몬-클라이언트 |
FIFO는 “간단한 서버”를 만들 때 유용합니다. 소켓보다 단순하고, 같은 컴퓨터 안에서라면 충분하죠. 다만 다른 컴퓨터와는 통신할 수 없습니다. 그건 21주차 소켓의 영역입니다.
unlink를 잊으면 /tmp에 p 파일이 남습니다. 실행 중에 프로그램이 죽으면 남는 것이라, fifo_demo.c가 시작할 때 unlink(FIFO_PATH)를 먼저 부르는 것은 그 찌꺼기 때문에 mkfifo가 EEXIST로 실패하는 것을 막으려는 것입니다. 이번 주의 모든 예제가 이 “시작할 때 먼저 지우기” 패턴을 씁니다.
4. popen: 파이프의 간편 버전
명령 하나의 출력만 읽고 싶은데 pipe + fork + dup2 + exec를 매번 쓰는 것은 번거롭습니다. popen은 그 네 단계를 한 줄로 압축합니다.
#include <stdio.h>
FILE *popen(const char *command, const char *type);
int pclose(FILE *stream);
| 항목 | 설명 |
|---|---|
command |
실행할 명령. 셸(sh -c)에 넘겨지는 문자열이라 \|, >, * 같은 셸 문법이 다 통합니다 |
type |
"r": 명령의 출력을 읽는다. "w": 명령에 입력을 써 준다. 둘 중 하나만 |
| 반환값 | 9주차의 FILE *. 실패하면 NULL |
pclose |
닫고 wait까지 해서 명령의 종료 상태를 돌려줍니다. 18주차의 WEXITSTATUS로 풉니다 |
examples/popen_demo.c:
/*
 * popen_demo.c - popen: 파이프의 간편 버전
 * 19주차: IPC와 동기화
 *
 * pipe + fork + dup2 + exec를 매번 쓰기는 번거롭습니다.
 * 명령 하나의 출력만 읽고 싶다면? popen 한 줄이면 됩니다:
 *
 *   FILE *fp = popen("ls -l", "r");   // 명령을 실행하고 출력을 FILE*로
 *   fgets(...)                         // 9주차처럼 읽으면 끝!
 *   pclose(fp);                        // 종료 상태까지 반환
 *
 * 내부적으로는 sh -c "명령"을 fork+exec 하고 파이프를 FILE*로 감쌉니다.
 * (18주차의 FILE* = fd + 버퍼 관계가 여기서 또!)
 *
 * 편하지만 함정도 있습니다 - 셸을 거치므로 보안 주의!
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <sys/wait.h>

int main(void) {
    printf("=== 1. popen(\"r\"): 명령의 출력 읽기 ===\n");

    FILE *fp = popen("uname -sr", "r");
    if (fp == NULL) {
        perror("popen");
        return 1;
    }

    char line[256];
    while (fgets(line, sizeof(line), fp) != NULL) {
        printf("  커널: %s", line);
    }

    int status = pclose(fp);         /* 종료 상태를 반환! (wait 내장) */
    printf("  pclose 종료 상태: %d\n\n", WEXITSTATUS(status));

    /* ---------- 2. 여러 줄 처리 ---------- */
    printf("=== 2. 여러 줄 출력 처리 ===\n");
    printf("명령: ls -1 /etc | head -5\n");

    fp = popen("ls -1 /etc | head -5", "r");
    if (fp != NULL) {
        int count = 0;
        while (fgets(line, sizeof(line), fp) != NULL) {
            line[strcspn(line, "\n")] = '\0';    /* 4주차 개행 제거 */
            printf("  [%d] %s\n", ++count, line);
        }
        pclose(fp);
    }

    /* ---------- 3. popen("w"): 명령에 입력 보내기 ---------- */
    printf("\n=== 3. popen(\"w\"): 명령에 입력 보내기 ===\n");
    printf("sort 명령에 줄을 써 넣으면?\n");
    fflush(stdout);

    fp = popen("sort", "w");
    if (fp != NULL) {
        fprintf(fp, "cherry\n");
        fprintf(fp, "apple\n");
        fprintf(fp, "banana\n");
        pclose(fp);                  /* 닫아야 sort가 EOF를 받고 출력한다 */
    }

    /* ---------- 4. 실전: 명령 결과를 프로그램에서 활용 ---------- */
    printf("\n=== 4. 실전 활용: 디스크 사용량 파싱 ===\n");

    fp = popen("df -h / | tail -1", "r");
    if (fp != NULL && fgets(line, sizeof(line), fp) != NULL) {
        char fs[64], size[32], used[32], avail[32], percent[16];
        if (sscanf(line, "%63s %31s %31s %31s %15s",
                   fs, size, used, avail, percent) == 5) {
            printf("  루트 파티션: 전체 %s 중 %s 사용 (%s)\n",
                   size, used, percent);
        }
    }
    if (fp) pclose(fp);

    /* ---------- 5. 함정: 셸을 거친다는 것 ---------- */
    printf("\n=== 5. popen의 함정 ===\n");
    printf("1. 셸(sh -c)을 거친다\n");
    printf("   -> 사용자 입력을 그대로 넣으면 명령 주입 공격!\n");
    printf("      popen(user_input, \"r\")  <- 절대 금지\n");
    printf("      \"; rm -rf ~\" 같은 것이 들어오면 그대로 실행된다\n");
    printf("2. 단방향이다 (읽기 또는 쓰기 하나만)\n");
    printf("   -> 양방향은 직접 pipe 두 개를 파야 한다\n");
    printf("3. 셸 시작 비용이 있다 (fork + exec sh + exec 명령)\n");
    printf("   -> 반복 호출이면 pipe+exec를 직접 쓰는 편이 빠르다\n");
    printf("4. 버퍼링 주의\n");
    printf("   -> pclose 전에는 출력이 안 나올 수 있다 (fflush!)\n");

    printf("\n=== 6. 언제 무엇을? ===\n");
    printf("popen          : 명령 하나의 출력을 간단히 읽을 때 (고정 명령!)\n");
    printf("pipe+fork+exec : 양방향, 세밀한 제어, 사용자 입력이 섞일 때\n");
    printf("system()       : 출력이 필요 없고 실행만 하면 될 때 (역시 셸 주의)\n");

    return 0;
}
$ gcc -Wall -Wextra -std=gnu11 -g examples/popen_demo.c -o build/popen_demo
$ ./build/popen_demo
=== 1. popen("r"): 명령의 출력 읽기 ===
  커널: Linux 7.0.0-34-generic
  pclose 종료 상태: 0

=== 2. 여러 줄 출력 처리 ===
명령: ls -1 /etc | head -5
  [1] ImageMagick-6
  [2] ModemManager
  [3] NetworkManager
  [4] ODBCDataSources
  [5] OpenCL

=== 3. popen("w"): 명령에 입력 보내기 ===
sort 명령에 줄을 써 넣으면?
apple
banana
cherry

=== 4. 실전 활용: 디스크 사용량 파싱 ===
  루트 파티션: 전체 1.8T 중 1.6T 사용 (89%)
...
/etc 목록과 디스크 용량은 컴퓨터마다 다릅니다. 여러분의 결과와 ls -1 /etc | head -5, df -h /를 셸에서 직접 친 결과가 같은지 비교해 보세요.
코드 읽기 포인트
popen이 돌려주는 것이FILE *입니다. 그래서 9주차의fgets,fprintf를 그대로 씁니다. 내부는sh -c "명령"을fork+exec하고 파이프의 한쪽 끝을FILE *로 감싼 것입니다. 18주차의 “FILE *= fd + 버퍼”가 또 나왔죠."w"모드의pclose가 하는 일: 3번 실험에서sort는 우리가 쓴 세 줄을 받아 두었다가 입력이 끝나야(EOF) 정렬해서 출력합니다.pclose가 쓰는 끝을 닫아 EOF를 보내고sort가 끝나기를 기다립니다. 1.2절의 규칙이popen에도 그대로 숨어 있습니다.sscanf로 한 줄 쪼개기:df -h /의 마지막 줄/dev/sda1 1.8T 1.6T ...을 공백 기준으로 다섯 칸 읽습니다.%63s처럼 폭을 적는 것은 4주차에서 배운 버퍼 넘침 방지입니다.
4.1 편한 만큼 위험하다 — 명령 주입 실험
popen에는 심각한 함정이 있습니다. 셸을 거친다는 것입니다. 사용자가 친 파일 이름을 ls -l에 붙여 실행하는 프로그램을 가정해 봅시다. popen_inject.c:
    char user_input[128] = "hello.txt; echo INJECTED-COMMAND-RAN";   /* 사용자가 친 것 */
    char cmd[256];
    snprintf(cmd, sizeof(cmd), "ls -l %s", user_input);
    printf("실행되는 명령: %s\n", cmd);
    FILE *fp = popen(cmd, "r");
$ ./popen_inject
실행되는 명령: ls -l hello.txt; echo INJECTED-COMMAND-RAN
  출력: -rw-rw-r-- 1 user user 0  9월 29 02:18 hello.txt
  출력: INJECTED-COMMAND-RAN
사용자가 파일 이름 뒤에 ; echo ...를 붙였더니 그 명령이 그대로 실행됐습니다. echo 자리에 rm -rf ~가 들어오면 홈 폴더가 지워집니다. 셸이 ;를 “명령 구분자”로 해석하기 때문이고, popen은 그 셸에 문자열을 통째로 넘깁니다. 이것이 명령 주입(command injection) 공격이며, 24주차 보안 편의 단골 주제입니다. 지금 기억할 규칙은 하나입니다.
popen과system에는 고정된 명령만 넣는다. 사용자 입력이 섞이면pipe+fork+execvp를 직접 쓴다.
execvp는 셸을 거치지 않고 인자를 배열로 넘기므로, "hello.txt; echo ..."는 통째로 파일 이름 하나가 됩니다. 셸이 없으니 ;를 해석할 주체가 없고, 주입이 원천적으로 불가능합니다. 2절의 pipe_shell.c가 바로 그 방식입니다.
나머지 함정도 정리해 두겠습니다.
- 단방향: 읽기 또는 쓰기 하나만. 양방향은 직접 파이프 두 개를 파야 합니다
- 셸 시작 비용:
fork+exec sh+exec 명령이라 프로세스가 둘 생깁니다. 반복 호출이면 느립니다 - 버퍼링:
"w"모드에서fprintf한 내용은pclose전에 상대에게 안 갈 수 있습니다. 중간에 보내려면fflush(fp)
5. 경쟁 조건: 동기화가 왜 필요한가
5.1 카운터가 증발한다
이제 후반부입니다. 프로세스들이 같은 데이터를 동시에 건드리면 무슨 일이 벌어질까요?
counter++는 C 코드로는 한 줄이지만, 1주차 7절에서 어셈블리를 봤던 것처럼 CPU 입장에서는 세 단계입니다.
1. 메모리에서 읽기   (load)     mov  rax, [counter]
2. 1 더하기          (add)      add  rax, 1
3. 메모리에 쓰기     (store)    mov  [counter], rax
두 프로세스가 1번과 3번 사이에 끼어들면?
시간 →
프로세스 A:  읽음(100)          더함(101)   씀(101)
프로세스 B:           읽음(100)  더함(101)           씀(101)
메모리:      100      100        100        101      101   ← 두 번 더했는데 101
두 번 더했는데 결과는 101. 한 번의 증가가 증발했습니다. 이것이 경쟁 조건(race condition) 입니다. 누가 먼저 도착하느냐(경쟁)에 따라 결과가 달라지는 상태라는 뜻입니다.
말로만 들으면 “그런 우연이 얼마나 일어나겠어”라고 생각하기 쉽습니다. 그래서 직접 재현합니다. 그런데 재현하려면 먼저 프로세스들이 정말로 같은 메모리를 봐야 합니다. fork는 메모리를 복사하니까요. 그 도구가 mmap의 MAP_SHARED | MAP_ANONYMOUS입니다.
    long *counter = mmap(NULL, sizeof(long),
                         PROT_READ | PROT_WRITE,
                         MAP_SHARED | MAP_ANONYMOUS, -1, 0);
| 인자 | 값 | 뜻 |
|---|---|---|
| 주소 | NULL |
어디에 붙일지는 커널이 정하라 |
| 크기 | sizeof(long) |
8바이트 |
| 보호 | PROT_READ \| PROT_WRITE |
읽고 쓸 수 있게 |
| 플래그 | MAP_SHARED |
fork한 자식과 공유. MAP_PRIVATE면 복사됨 |
MAP_ANONYMOUS |
파일 없이 빈 메모리를 달라 (7절에서 파일 기반과 비교) | |
| fd, offset | -1, 0 |
MAP_ANONYMOUS라 파일이 없으니 -1 |
| 반환값 | 주소, 실패하면 MAP_FAILED |
NULL이 아니라 MAP_FAILED와 비교해야 합니다 |
fork 전에 이렇게 만든 메모리는 복사되지 않고 공유됩니다. 18주차에서 fork 후 변수가 따로 논다고 했던 것의 예외입니다. 7절에서 자세히 다루고, 지금은 “진짜로 같은 8바이트를 네 프로세스가 본다”만 알면 됩니다.
examples/race_condition.c:
/*
 * race_condition.c - 경쟁 조건: 동기화가 왜 필요한가
 * 19주차: IPC와 동기화
 *
 * 여러 프로세스가 같은 데이터를 동시에 고치면 무슨 일이 벌어질까요?
 *
 * counter++ 는 한 줄처럼 보이지만 실제로는 세 단계입니다:
 *   1. 메모리에서 읽기   (load)
 *   2. 1 더하기          (add)
 *   3. 메모리에 쓰기     (store)
 *
 * 두 프로세스가 1번과 3번 사이에 서로 끼어들면?
 *   A: 읽음(100) -> B: 읽음(100) -> A: 씀(101) -> B: 씀(101)
 *   두 번 더했는데 결과는 101! 하나가 증발했습니다.
 *
 * 이것이 경쟁 조건(race condition)입니다.
 * 해결책은 다음 예제(sem_posix.c)에서!
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <sched.h>
#include <sys/mman.h>
#include <sys/wait.h>

#define WORKERS     4
#define FAST_LOOPS  200000       /* 그냥 ++ (창이 좁아 가끔만 터진다) */
#define SLOW_LOOPS  2000         /* 창을 넓힌 버전 (확실히 터진다) */

/* 자식 프로세스를 WORKERS개 만들어 work를 시키고 전부 기다린다 */
static void run_workers(void (*work)(long *, int), long *counter, int loops) {
    for (int i = 0; i < WORKERS; i++) {
        pid_t pid = fork();
        if (pid < 0) { perror("fork"); exit(1); }
        if (pid == 0) {
            work(counter, loops);
            _exit(0);
        }
    }
    while (wait(NULL) > 0) { }       /* 자식 모두 수거 (18주차!) */
}

/* 방식 1: 평범한 ++ */
static void plain_increment(long *counter, int loops) {
    for (int k = 0; k < loops; k++) {
        (*counter)++;                /* 읽기-더하기-쓰기: 끼어들 틈이 셋! */
    }
}

/* 방식 2: 읽기와 쓰기 '사이'를 일부러 넓힌 버전.
 * 하는 일은 위와 똑같다. 다만 끼어들 확률을 높여
 * '가끔 터지는 버그'를 '항상 터지는 버그'로 만든 것뿐! */
static void widened_increment(long *counter, int loops) {
    for (int k = 0; k < loops; k++) {
        long value = *counter;       /* 1. 읽기 */
        sched_yield();               /*    <- 여기서 다른 프로세스에게 양보 */
        *counter = value + 1;        /* 3. 쓰기 (남이 바꾼 값을 덮어쓴다!) */
    }
}

int main(void) {
    printf("=== 경쟁 조건 실험 ===\n");
    printf("프로세스 %d개가 공유 카운터를 함께 증가시킵니다.\n\n", WORKERS);

    /* 공유 메모리 한 칸 확보 (자세한 설명은 shm_posix.c에서!)
     * MAP_SHARED | MAP_ANONYMOUS = 이름 없는 공유 메모리.
     * fork한 자식들과 '진짜로 같은 메모리'를 쓴다 (복사 아님!) */
    long *counter = mmap(NULL, sizeof(long),
                         PROT_READ | PROT_WRITE,
                         MAP_SHARED | MAP_ANONYMOUS, -1, 0);
    if (counter == MAP_FAILED) {
        perror("mmap");
        return 1;
    }

    /* ---------- 1. 창을 넓힌 버전: 확실한 재현 ---------- */
    printf("[1] 읽기와 쓰기 사이를 넓힌 경우 (각 %d번)\n", SLOW_LOOPS);
    printf("    long v = *counter; sched_yield(); *counter = v + 1;\n");
    fflush(stdout);

    *counter = 0;
    run_workers(widened_increment, counter, SLOW_LOOPS);

    long expected = (long)WORKERS * SLOW_LOOPS;
    printf("    기대: %ld / 실제: %ld", expected, *counter);
    if (*counter != expected) {
        printf("  -> %ld번의 증가가 증발!\n", expected - *counter);
    } else {
        printf("  -> (이번엔 통과. 다시 실행해 보세요)\n");
    }

    /* ---------- 2. 평범한 ++ 버전 ---------- */
    printf("\n[2] 그냥 (*counter)++ 인 경우 (각 %d번)\n", FAST_LOOPS);
    fflush(stdout);

    *counter = 0;
    run_workers(plain_increment, counter, FAST_LOOPS);

    expected = (long)WORKERS * FAST_LOOPS;
    printf("    기대: %ld / 실제: %ld", expected, *counter);
    if (*counter != expected) {
        printf("  -> %ld번 증발 (창이 좁아도 결국 터진다!)\n",
               expected - *counter);
    } else {
        printf("  -> 이번엔 우연히 맞았습니다\n");
    }

    printf("\n    [1]은 창이 넓어 적은 횟수로도 바로 터지고,\n");
    printf("    [2]는 창이 좁아 횟수를 크게 늘려야 드러납니다.\n");
    printf("    (5만 번 정도로 줄이면 우연히 통과하기도 합니다!)\n");
    printf("    차이는 '드러나는 확률'뿐 - 버그의 존재 여부가 아닙니다.\n");

    /* ---------- 3. 왜 이런 일이? ---------- */
    printf("\n[3] counter++ 의 실체\n");
    printf("    어셈블리로 보면 대략 이렇습니다:\n");
    printf("      mov  rax, [counter]   ; 1. 읽기\n");
    printf("      add  rax, 1           ; 2. 더하기\n");
    printf("      mov  [counter], rax   ; 3. 쓰기\n");
    printf("    1번과 3번 사이에 다른 프로세스가 끼어들면?\n");
    printf("      A: 읽음(100) | B: 읽음(100) | A: 씀(101) | B: 씀(101)\n");
    printf("      두 번 더했는데 101. 한 번의 증가가 사라졌습니다.\n");

    /* ---------- 4. 임계 구역 ---------- */
    printf("\n[4] 임계 구역(critical section)\n");
    printf("    공유 자원을 건드리는 코드 조각을 '임계 구역'이라 합니다.\n");
    printf("    규칙: 임계 구역에는 한 번에 하나만 들어간다 (상호 배제)\n");
    printf("    도구: 세마포어, 뮤텍스, 락 - 다음 예제에서!\n");

    /* ---------- 5. 경쟁 조건이 무서운 이유 ---------- */
    printf("\n[5] 경쟁 조건이 무서운 이유\n");
    printf("    - 재현이 안 된다: 타이밍에 따라 되기도, 안 되기도\n");
    printf("    - 테스트를 통과한다: 부하가 낮으면 충돌 확률이 낮으니까\n");
    printf("    - 운영에서 터진다: 사용자가 몰리는 순간 확률이 올라간다\n");
    printf("    - 디버거를 붙이면 사라진다: 타이밍이 바뀌니까 (하이젠버그!)\n");
    printf("\n    그래서 '테스트해 봤더니 되더라'는 증거가 되지 못합니다.\n");
    printf("    공유 자원이 있으면 '반드시' 동기화해야 합니다.\n");

    munmap(counter, sizeof(long));
    return 0;
}

경쟁 조건을 눈으로
$ gcc -Wall -Wextra -std=gnu11 -g examples/race_condition.c -o build/race_condition
$ ./build/race_condition
=== 경쟁 조건 실험 ===
프로세스 4개가 공유 카운터를 함께 증가시킵니다.

[1] 읽기와 쓰기 사이를 넓힌 경우 (각 2000번)
    long v = *counter; sched_yield(); *counter = v + 1;
    기대: 8000 / 실제: 2207  -> 5793번의 증가가 증발!

[2] 그냥 (*counter)++ 인 경우 (각 200000번)
    기대: 800000 / 실제: 287554  -> 512446번 증발 (창이 좁아도 결국 터진다!)

    [1]은 창이 넓어 적은 횟수로도 바로 터지고,
    [2]는 창이 좁아 횟수를 크게 늘려야 드러납니다.
    (5만 번 정도로 줄이면 우연히 통과하기도 합니다!)
    차이는 '드러나는 확률'뿐 - 버그의 존재 여부가 아닙니다.
...
80만 번 중 51만 번이 증발했습니다. 64%가 사라진 것이죠. “그런 우연”이 절반 넘게 일어났습니다.
5.2 실행할 때마다 다르다
경쟁 조건의 본질은 결과가 타이밍에 달렸다는 것입니다. 같은 프로그램을 세 번 돌려 봤습니다.
$ for i in 1 2 3; do ./build/race_condition | grep "실제"; done
    기대: 8000 / 실제: 2209  -> 5791번의 증가가 증발!
    기대: 800000 / 실제: 321026  -> 478974번 증발 (창이 좁아도 결국 터진다!)
    기대: 8000 / 실제: 2252  -> 5748번의 증가가 증발!
    기대: 800000 / 실제: 331848  -> 468152번 증발 (창이 좁아도 결국 터진다!)
    기대: 8000 / 실제: 2357  -> 5643번의 증가가 증발!
    기대: 800000 / 실제: 325582  -> 474418번 증발 (창이 좁아도 결국 터진다!)
2209, 2252, 2357, 321026, 331848, 325582. 한 번도 같은 숫자가 없습니다. 코드는 한 글자도 바뀌지 않았는데요. 이것이 경쟁 조건 버그를 잡기 어려운 이유입니다. “다시 실행해 보니 다른 값이 나온다”는 것은 버그가 고쳐진 게 아니라 타이밍이 달라진 것뿐입니다.
5.3 창의 크기가 확률을 정한다
이 예제는 같은 버그를 두 가지 창 크기로 보여 줍니다.
/* 방식 2: 읽기와 쓰기 '사이'를 일부러 넓힌 버전 */
static void widened_increment(long *counter, int loops) {
    for (int k = 0; k < loops; k++) {
        long value = *counter;       /* 1. 읽기 */
        sched_yield();               /*    <- 여기서 다른 프로세스에게 양보 */
        *counter = value + 1;        /* 3. 쓰기 (남이 바꾼 값을 덮어쓴다!) */
    }
}
sched_yield()는 “지금 CPU를 다른 프로세스에게 양보하겠다”는 시스템 콜입니다. 읽기와 쓰기 사이에 끼워 넣으면 끼어들 확률이 거의 100% 가 됩니다. 그래서 겨우 2,000번씩만 돌려도 8,000 중 5,800번이 사라집니다.
여기서 배울 점이 있습니다. 버그의 존재와 버그가 드러나는 확률은 다른 문제입니다. (*counter)++는 세 단계가 연달아 실행되어 창이 아주 좁지만, 창이 좁다는 것은 “덜 자주 터진다”이지 “안전하다”가 아닙니다. 200,000번쯤 돌리니 절반이 날아갔습니다.
5.4 최적화가 버그를 숨긴다 — -O2 실험
1주차에서 배운 -O2로 컴파일하면 어떻게 될까요?
$ gcc -O2 -Wall -Wextra -std=gnu11 examples/race_condition.c -o build/race_O2
$ for i in 1 2 3; do ./build/race_O2 | grep "실제"; done
    기대: 8000 / 실제: 2177  -> 5823번의 증가가 증발!
    기대: 800000 / 실제: 800000  -> 이번엔 우연히 맞았습니다
    기대: 8000 / 실제: 2073  -> 5927번의 증가가 증발!
    기대: 800000 / 실제: 800000  -> 이번엔 우연히 맞았습니다
    기대: 8000 / 실제: 2200  -> 5800번의 증가가 증발!
    기대: 800000 / 실제: 800000  -> 이번엔 우연히 맞았습니다
[2]가 갑자기 세 번 다 정확해졌습니다. 버그가 사라진 걸까요? 아닙니다. 컴파일러가 for 루프 안의 (*counter)++ 200,000번을 *counter += 200000 한 번으로 바꿔 버린 것입니다. 결과가 같으니 최적화로는 정당합니다. 그러면 각 프로세스는 읽기-더하기-쓰기를 한 번씩만 하게 되고, 네 프로세스의 그 한 번이 겹칠 확률은 매우 낮아서 “우연히” 맞은 것입니다. [1]은 sched_yield()라는 함수 호출이 사이에 있어서 컴파일러가 합치지 못했고, 여전히 터집니다.
이 실험의 교훈은 두 가지입니다. 첫째, “-O2로 하니 되더라”는 고친 것이 아닙니다. 반복 횟수를 바꾸거나 컴파일러 버전이 바뀌면 다시 터집니다. 둘째, 공유 변수를 다루는 코드에서 컴파일러는 우리가 생각하는 것보다 훨씬 많은 것을 고쳐 씁니다. 20주차에서 이 문제를 원자적 연산으로 다시 만납니다.
5.5 경쟁 조건이 무서운 이유
예제의 마지막 부분이 핵심입니다.
- 재현이 안 된다: 타이밍에 따라 되기도, 안 되기도 (5.2절)
- 테스트를 통과한다: 부하가 낮으면 충돌 확률이 낮으니까 (5.3절의 좁은 창)
- 운영에서 터진다: 사용자가 몰리는 순간 확률이 올라간다
- 디버거를 붙이면 사라진다: 타이밍이 바뀌니까 (5.4절의 최적화도 같은 이유)
마지막 항목 때문에 하이젠버그(Heisenbug) 라는 별명이 붙었습니다. 관측하려 하면 사라지는 버그라는 뜻이죠(하이젠베르크의 불확정성 원리에서 따온 말입니다).
그래서 결론은 분명합니다.
“테스트해 봤더니 되더라”는 증거가 되지 못합니다. 공유 자원이 있으면 반드시 동기화해야 합니다.
5.6 임계 구역
공유 자원을 건드리는 코드 조각을 임계 구역(critical section) 이라고 합니다. 위 예제에서는 (*counter)++ 한 줄이 임계 구역입니다. 그리고 규칙은 하나입니다.
임계 구역에는 한 번에 하나만 들어간다 (상호 배제, mutual exclusion).
A가 읽기-더하기-쓰기를 끝낼 때까지 B가 시작하지 못하게 하면, 5.1절의 그림에서 B의 “읽음(100)”이 A의 “씀(101)” 뒤로 밀려 “읽음(101)”이 됩니다. 이 규칙을 강제하는 도구가 다음 절의 세마포어입니다.
6. 세마포어: 허가증이 든 통
6.1 P와 V
세마포어(semaphore) 는 “허가증이 N장 든 통”으로 생각하면 정확합니다. 1965년 다익스트라가 네덜란드어 동사의 머리글자를 따서 P(가져가기)와 V(돌려놓기)라고 이름 붙였고, POSIX에서는 sem_wait과 sem_post입니다.
#include <semaphore.h>
int sem_init(sem_t *sem, int pshared, unsigned int value);
int sem_wait(sem_t *sem);
int sem_post(sem_t *sem);
int sem_destroy(sem_t *sem);
| 함수 | 인자 | 하는 일 | 실패 |
|---|---|---|---|
sem_init |
sem: 세마포어 변수의 주소 |
초기화 | EINVAL (value가 너무 큼) |
pshared: 0이면 스레드끼리만, 0이 아니면 프로세스끼리 |
|||
value: 처음 허가증 개수 |
|||
sem_wait |
sem |
허가증 한 장 가져간다. 없으면 생길 때까지 잠든다 (P) | EINTR (시그널로 깨어남) |
sem_post |
sem |
허가증 한 장 돌려놓는다. 기다리던 프로세스가 있으면 깨운다 (V) | EOVERFLOW |
sem_trywait |
sem |
있으면 가져가고, 없으면 기다리지 않고 즉시 실패 | EAGAIN |
sem_timedwait |
sem, 마감 시각 |
마감까지 기다리다 포기 (10절에서) | ETIMEDOUT |
sem_getvalue |
sem, int * |
지금 허가증이 몇 장인지 (디버깅용) | |
sem_destroy |
sem |
정리 |
초기값에 따라 성격이 달라집니다.
- 초기값 1: 허가증 한 장 → 한 번에 하나만 → 뮤텍스(상호 배제). 5.6절의 규칙을 그대로 구현합니다
- 초기값 N: 최대 N개가 동시에 → 자원 개수 제한
종류도 두 가지입니다. 파이프와 FIFO의 관계와 같습니다.
- 무명(unnamed):
sem_init. 공유 메모리에 두고fork한 자식과 공유 - 기명(named):
sem_open("/이름"). 남남 프로세스끼리 (FIFO처럼 이름으로!)
examples/sem_posix.c:
/*
 * sem_posix.c - POSIX 세마포어: 경쟁 조건의 해결사
 * 19주차: IPC와 동기화
 *
 * 앞 예제에서 카운터가 증발하는 것을 봤습니다. 해결책이 세마포어입니다.
 *
 * 세마포어 = "허가증이 N장 든 통"
 *   sem_wait(s) : 허가증 한 장 가져간다. 없으면 생길 때까지 기다린다 (P 연산)
 *   sem_post(s) : 허가증 한 장 돌려놓는다 (V 연산)
 *
 * 초기값 1이면 허가증이 한 장 -> 한 번에 하나만 들어갈 수 있다
 *   = 이진 세마포어 = 뮤텍스(상호 배제)
 * 초기값 N이면 최대 N개가 동시에 -> 자원 개수 제한 (DB 커넥션 풀 등)
 *
 * 종류 두 가지:
 *   무명(unnamed): sem_init. 공유 메모리에 두고 fork한 자식과 공유
 *   기명(named)  : sem_open("/이름"). 남남 프로세스끼리 (FIFO처럼!)
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <fcntl.h>
#include <semaphore.h>
#include <sys/mman.h>
#include <sys/wait.h>
#include <sys/stat.h>
#include <time.h>

#define WORKERS 4
#define LOOPS   50000
#define SEM_NAME "/week19_demo_sem"

/* 공유 영역: 카운터 + 세마포어를 한 덩어리로 */
typedef struct {
    sem_t lock;                      /* 무명 세마포어도 공유 메모리에! */
    long  counter;
} Shared;

static double elapsed_ms(struct timespec a, struct timespec b) {
    return (b.tv_sec - a.tv_sec) * 1000.0 + (b.tv_nsec - a.tv_nsec) / 1e6;
}

int main(void) {
    printf("=== 1. 무명 세마포어로 경쟁 조건 해결 ===\n");

    Shared *sh = mmap(NULL, sizeof(Shared), PROT_READ | PROT_WRITE,
                      MAP_SHARED | MAP_ANONYMOUS, -1, 0);
    if (sh == MAP_FAILED) { perror("mmap"); return 1; }

    /* sem_init(sem, pshared, value)
     *   pshared = 1 : 프로세스 사이에서 공유 (0이면 스레드 사이에서만)
     *   value   = 1 : 허가증 한 장 = 뮤텍스 */
    if (sem_init(&sh->lock, 1, 1) < 0) { perror("sem_init"); return 1; }
    sh->counter = 0;

    printf("프로세스 %d개 x %d번 증가, 기대값 %ld\n",
           WORKERS, LOOPS, (long)WORKERS * LOOPS);
    fflush(stdout);

    struct timespec t0, t1;
    clock_gettime(CLOCK_MONOTONIC, &t0);

    for (int i = 0; i < WORKERS; i++) {
        pid_t pid = fork();
        if (pid < 0) { perror("fork"); return 1; }
        if (pid == 0) {
            for (int k = 0; k < LOOPS; k++) {
                sem_wait(&sh->lock);         /* ---- 임계 구역 진입 ---- */
                sh->counter++;               /*      한 번에 하나만!     */
                sem_post(&sh->lock);         /* ---- 임계 구역 탈출 ---- */
            }
            _exit(0);
        }
    }
    while (wait(NULL) > 0) { }
    clock_gettime(CLOCK_MONOTONIC, &t1);

    printf("결과: %ld  %s (%.1f ms)\n", sh->counter,
           sh->counter == (long)WORKERS * LOOPS ? "-> 정확!" : "-> 아직 문제?!",
           elapsed_ms(t0, t1));
    printf("한 번도 증발하지 않았습니다. 이것이 상호 배제입니다.\n");

    /* ---------- 2. 락의 비용 ---------- */
    printf("\n=== 2. 공짜는 아니다 ===\n");
    printf("락은 '기다림'을 만듭니다. 임계 구역이 길수록 대기가 길어지죠.\n");
    printf("원칙: 임계 구역은 최대한 짧게!\n");
    printf("  나쁜 예: 락 잡고 파일 읽기, 네트워크 요청, 긴 계산\n");
    printf("  좋은 예: 락 잡고 변수 몇 개만 고치고 즉시 놓기\n");

    sem_destroy(&sh->lock);
    munmap(sh, sizeof(Shared));

    /* ---------- 3. 세는 세마포어: 자원 N개 제한 ---------- */
    printf("\n=== 3. 세는 세마포어: 동시 접속 3명 제한 ===\n");

    Shared *sh2 = mmap(NULL, sizeof(Shared), PROT_READ | PROT_WRITE,
                       MAP_SHARED | MAP_ANONYMOUS, -1, 0);
    if (sh2 == MAP_FAILED) { perror("mmap"); return 1; }
    sem_init(&sh2->lock, 1, 3);      /* 허가증 3장! */
    sh2->counter = 0;

    printf("자식 6명이 '자리'를 차지하려 하지만 자리는 3개뿐입니다.\n");
    fflush(stdout);

    for (int i = 0; i < 6; i++) {
        pid_t pid = fork();
        if (pid == 0) {
            sem_wait(&sh2->lock);            /* 자리 하나 차지 */

            int now;
            sem_getvalue(&sh2->lock, &now);
            printf("  [손님 %d] 입장 (남은 자리 %d)\n", i, now);
            fflush(stdout);

            usleep(200000);                  /* 머무는 시간 */

            printf("  [손님 %d] 퇴장\n", i);
            fflush(stdout);
            sem_post(&sh2->lock);            /* 자리 반납 */
            _exit(0);
        }
        usleep(30000);                       /* 순서를 보기 좋게 */
    }
    while (wait(NULL) > 0) { }
    printf("-> 동시에 최대 3명. DB 커넥션 풀, 다운로드 슬롯이 이 원리입니다.\n");

    sem_destroy(&sh2->lock);
    munmap(sh2, sizeof(Shared));

    /* ---------- 4. 기명 세마포어 ---------- */
    printf("\n=== 4. 기명 세마포어: 남남끼리 (FIFO처럼 이름으로) ===\n");

    sem_unlink(SEM_NAME);                    /* 이전 찌꺼기 제거 */
    sem_t *named = sem_open(SEM_NAME, O_CREAT | O_EXCL, 0666, 1);
    if (named == SEM_FAILED) { perror("sem_open"); return 1; }

    printf("sem_open(\"%s\") 성공\n", SEM_NAME);
    printf("실제 파일로 보입니다: ls -l /dev/shm/sem.week19_demo_sem\n");

    int value;
    sem_getvalue(named, &value);
    printf("현재 허가증: %d장\n", value);

    sem_wait(named);
    sem_getvalue(named, &value);
    printf("sem_wait 후: %d장 (내가 한 장 가져감)\n", value);

    sem_post(named);
    sem_getvalue(named, &value);
    printf("sem_post 후: %d장 (돌려놓음)\n", value);

    sem_close(named);
    sem_unlink(SEM_NAME);                    /* 이름 제거 (FIFO의 unlink처럼) */
    printf("sem_close + sem_unlink로 정리 완료\n");

    /* ---------- 5. 정리 ---------- */
    printf("\n=== 5. 세마포어 사용 규칙 ===\n");
    printf("1. wait과 post는 반드시 짝을 이룬다 (post를 잊으면 영원한 대기!)\n");
    printf("2. 임계 구역 안에서 return/break/exit 하지 않기\n");
    printf("   -> 락을 든 채 죽으면 아무도 못 들어간다\n");
    printf("3. 락을 여러 개 잡을 때는 '항상 같은 순서로'\n");
    printf("   -> A->B와 B->A가 섞이면 교착 상태(deadlock)\n");
    printf("4. 무명은 공유 메모리에 두어야 한다 (지역 변수에 두면 각자 사본!)\n");
    printf("5. 기명은 안 지우면 재부팅까지 남는다 (/dev/shm 확인)\n");

    return 0;
}
$ gcc -Wall -Wextra -std=gnu11 -g examples/sem_posix.c -o build/sem_posix -pthread
$ ./build/sem_posix
=== 1. 무명 세마포어로 경쟁 조건 해결 ===
프로세스 4개 x 50000번 증가, 기대값 200000
결과: 200000  -> 정확! (12.9 ms)
한 번도 증발하지 않았습니다. 이것이 상호 배제입니다.

=== 2. 공짜는 아니다 ===
...

=== 3. 세는 세마포어: 동시 접속 3명 제한 ===
자식 6명이 '자리'를 차지하려 하지만 자리는 3개뿐입니다.
  [손님 0] 입장 (남은 자리 2)
  [손님 1] 입장 (남은 자리 1)
  [손님 2] 입장 (남은 자리 0)
  [손님 0] 퇴장
  [손님 3] 입장 (남은 자리 0)
  [손님 1] 퇴장
  [손님 4] 입장 (남은 자리 0)
  [손님 2] 퇴장
  [손님 5] 입장 (남은 자리 0)
  [손님 3] 퇴장
  [손님 4] 퇴장
  [손님 5] 퇴장
-> 동시에 최대 3명. DB 커넥션 풀, 다운로드 슬롯이 이 원리입니다.

=== 4. 기명 세마포어: 남남끼리 (FIFO처럼 이름으로) ===
sem_open("/week19_demo_sem") 성공
실제 파일로 보입니다: ls -l /dev/shm/sem.week19_demo_sem
현재 허가증: 1장
sem_wait 후: 0장 (내가 한 장 가져감)
sem_post 후: 1장 (돌려놓음)
sem_close + sem_unlink로 정리 완료
...
20만이 정확히 나왔습니다. 5절에서 64%가 증발했던 것과 똑같은 작업인데, sem_wait과 sem_post 두 줄로 감싼 것이 전부입니다. 다시 실행해도, 열 번을 실행해도 200000입니다. 이제 “정확히 나온다”가 우연이 아니라 보장입니다.
3번 실험의 손님 순서를 보세요. 0, 1, 2번이 입장한 뒤 0번이 퇴장해야 3번이 입장합니다. 허가증이 3장뿐이라 네 번째 손님은 sem_wait에서 잠들어 있다가, 누군가 sem_post로 돌려놓는 순간 깨어납니다. 이것이 세는 세마포어입니다.
6.2 실수 하나: post를 잊으면 영원히 기다린다
규칙 1번을 직접 어겨 봅시다. 자식이 락을 잡고 sem_post 없이 종료하는 sem_nopost.c입니다.
    sem_t *lock = mmap(NULL, sizeof(sem_t), PROT_READ | PROT_WRITE,
                       MAP_SHARED | MAP_ANONYMOUS, -1, 0);
    sem_init(lock, 1, 1);
    if (fork() == 0) {
        sem_wait(lock);
        printf("[자식] 락 획득, 일하는 중... 그리고 post 를 잊었다\n");
        fflush(stdout);
        _exit(0);                  /* sem_post(lock) 없이 종료 */
    }
    wait(NULL);
    printf("[부모] 락 잡는 중...\n");
    fflush(stdout);
    sem_wait(lock);                /* 아무도 돌려놓지 않으니 영원히 */
    printf("[부모] 락 획득\n");
$ timeout 5 ./sem_nopost
[자식] 락 획득, 일하는 중... 그리고 post 를 잊었다
[부모] 락 잡는 중...
$ echo $?
124
자식은 이미 죽었는데 허가증은 자식과 함께 사라졌습니다. 세마포어는 “누가 가져갔는지”를 기억하지 않습니다. 그냥 숫자가 0이 됐을 뿐이고, 프로세스가 죽어도 커널이 대신 돌려놓지 않습니다. 이것이 규칙 2번 “임계 구역 안에서 return/exit 하지 않기”의 이유이기도 합니다. 9절에서 System V 세마포어의 SEM_UNDO가 이 문제에 대한 답으로 나옵니다.
6.3 실수 둘: 무명 세마포어를 지역 변수에
규칙 4번입니다. 코드에서 세마포어가 어디 있는지 보세요.
typedef struct {
    sem_t lock;                      /* 무명 세마포어도 공유 메모리에! */
    long  counter;
} Shared;
세마포어 자체가 공유 메모리 안에 있어야 합니다. 지역 변수로 sem_t lock;을 선언하고 fork하면 어떻게 될까요? sem_local.c는 카운터는 공유 메모리에 두고 락만 지역 변수에 뒀습니다.
    long *counter = mmap(NULL, sizeof(long), PROT_READ | PROT_WRITE,
                         MAP_SHARED | MAP_ANONYMOUS, -1, 0);
    sem_t lock;                    /* 지역 변수! fork 하면 각자 사본 */
    sem_init(&lock, 1, 1);
    *counter = 0;
    for (int i = 0; i < 4; i++) {
        if (fork() == 0) {
            for (int k = 0; k < 50000; k++) {
                sem_wait(&lock);
                (*counter)++;
                sem_post(&lock);
            }
            _exit(0);
        }
    }
$ for i in 1 2 3; do ./sem_local; done
기대 200000 / 실제 134971
기대 200000 / 실제 135534
기대 200000 / 실제 135583
sem_wait과 sem_post를 분명히 썼는데 3분의 1이 증발합니다. fork가 지역 변수 lock을 복사해서 네 자식이 각자 자기만의 세마포어를 갖게 됐기 때문입니다. 자식 1이 자기 락을 잡는 것은 자식 2의 락과 아무 상관이 없습니다. 컴파일 오류도, 경고도, 실행 오류도 없습니다. 값이 틀릴 뿐입니다. 이런 버그는 “락을 걸었으니 안전하겠지”라는 믿음 때문에 더 찾기 어렵습니다.
6.4 실수 셋: pshared를 0으로
sem_init의 두 번째 인자입니다.
sem_init(&sh->lock, 1, 1);
/*                  ^ pshared: 1 = 프로세스 사이에서 공유, 0 = 스레드 사이에서만 */
세마포어를 공유 메모리에 제대로 두고 pshared만 0으로 하면 어떻게 될까요? sem_pshared0.c는 sem_posix.c의 1번 실험에서 그 숫자 하나만 바꾼 것입니다.
sem_init(&sh->lock, 0, 1); /* pshared = 0 : "스레드끼리만" */
$ timeout 10 ./sem_pshared0
$ echo $?
124
값이 틀리는 게 아니라 아예 멈춥니다. 리눅스의 세마포어는 내부적으로 futex라는 커널 기능으로 잠들고 깨어나는데, pshared = 0이면 “같은 프로세스 안에서만 깨워도 된다”는 빠른 모드를 씁니다. 다른 프로세스가 sem_post를 해도 잠든 쪽이 깨어나지 않고, 그대로 영원히 잠듭니다. 20주차에서 스레드를 다룰 때는 0이 맞고, 이번 주처럼 프로세스 간이면 반드시 0이 아닌 값이어야 합니다.
6.5 세는 세마포어: 자원 N개 제한
초기값을 3으로 주면 어떻게 될까요?
sem_init(&sh2->lock, 1, 3); /* 허가증 3장! */
실행 결과를 보면 손님 6명 중 최대 3명만 동시에 안에 있습니다. 한 명이 나가야 다음 사람이 들어가죠. 이 패턴의 실전 용도가 많습니다.
- DB 커넥션 풀: 커넥션 10개를 여러 요청이 나눠 씀
- 다운로드 슬롯: 동시 다운로드 3개까지
- API 호출 제한: 동시에 N개까지
- 메모리 제한: 큰 버퍼를 동시에 N개까지만 할당
sem_getvalue로 남은 개수를 볼 수도 있습니다. 다만 값을 읽는 순간과 출력하는 순간 사이에 다른 프로세스가 바꿀 수 있어서, 정확한 순간값은 아닙니다. 디버깅용으로만 쓰세요.
6.6 기명 세마포어
남남 프로세스끼리 쓰려면 이름이 필요합니다. FIFO와 같은 발상이죠.
#include <fcntl.h>
sem_t *sem_open(const char *name, int oflag, mode_t mode, unsigned int value);
int sem_close(sem_t *sem);
int sem_unlink(const char *name);
| 인자 | 설명 |
|---|---|
name |
/로 시작하는 이름. 폴더 경로가 아닙니다. /week19_demo_sem처럼 슬래시 하나 뒤에 이름만 |
oflag |
18주차 open의 그 플래그. O_CREAT(없으면 만들기), O_EXCL(이미 있으면 실패) |
mode, value |
O_CREAT일 때만 씁니다. 권한과 초기값 |
| 반환값 | 세마포어 주소. 실패하면 SEM_FAILED (NULL이 아닙니다) |
실체는 /dev/shm/sem.이름 파일입니다. 프로그램이 도는 동안 확인하면 이렇게 보입니다.
$ ls -l /dev/shm/
-rw-rw-r-- 1 user user 32  9월 29 02:18 sem.week19_demo_sem
크기가 32바이트입니다. sizeof(sem_t)가 32이니, 세마포어 구조체가 그대로 파일로 놓인 것입니다. 이 파일을 여러 프로세스가 mmap으로 붙이면 같은 세마포어를 보게 됩니다. 결국 기명 세마포어도 “공유 메모리 위의 무명 세마포어”이고, 이름표를 커널 대신 파일 시스템이 관리해 줄 뿐입니다.
sem_close는 내 프로세스에서만 떼는 것이고, sem_unlink를 해야 파일이 지워집니다. 잊으면 재부팅까지 남습니다. 12절의 정리 명령을 참고하세요.
6.7 세마포어 사용 규칙 다섯 가지
| # | 규칙 | 어기면 | 확인한 실험 |
|---|---|---|---|
| 1 | wait과 post는 반드시 짝 |
영원한 대기 | 6.2절 종료 코드 124 |
| 2 | 임계 구역 안에서 return/break/exit 하지 않기 |
락을 든 채 죽어 아무도 못 들어감 | 6.2절과 같음 |
| 3 | 락을 여러 개 잡을 때는 항상 같은 순서로 | 교착 상태 | 10절에서 |
| 4 | 무명은 공유 메모리에 | 각자 사본이라 동기화가 안 됨 | 6.3절 134971 |
| 5 | 기명은 반드시 unlink |
재부팅까지 남음 | 12절 |
2번을 지키는 실전 기법도 알아 두세요. 임계 구역을 가능한 짧게 만들고, 그 안에서는 오직 변수 조작만 합니다.
/* 나쁜 예 */
sem_wait(&lock);
    데이터 = 파일에서_읽기();      /* 오래 걸리는 I/O를 락 안에서! */
    네트워크로_전송();
sem_post(&lock);

/* 좋은 예 */
데이터 = 파일에서_읽기();          /* 오래 걸리는 일은 락 밖에서 */
sem_wait(&lock);
    공유_변수 = 데이터;            /* 락 안에서는 대입만 */
sem_post(&lock);
네트워크로_전송();
예제의 12.9ms를 보세요. 4개 프로세스가 20만 번 락을 잡고 놓는 데 걸린 시간입니다. 한 번에 약 65나노초, 싸 보이지만 락 안에 1ms짜리 파일 읽기를 넣으면 다른 세 프로세스가 매번 1ms씩 기다립니다. 락은 “기다림”을 만드는 도구라는 것을 잊지 마세요.
7. 공유 메모리: 가장 빠른 IPC
7.1 복사를 없앤다
파이프는 데이터를 복사합니다. 내 버퍼 → 커널 버퍼 → 상대 버퍼, 두 번이죠. 그리고 매번 커널을 거칩니다(시스템 콜). 공유 메모리는 아예 같은 물리 메모리를 두 프로세스가 봅니다. 복사가 없고 커널을 거치지 않으니 IPC 중 가장 빠릅니다.
5절에서 이미 MAP_ANONYMOUS로 이름 없는 공유 메모리를 썼습니다. fork한 자식하고만 공유할 수 있는 방식이었죠. 남남끼리 공유하려면 FIFO처럼 이름이 필요합니다. POSIX 방식은 파일을 다루는 것과 똑같은 세 단계입니다.
#include <sys/mman.h>
#include <fcntl.h>
int shm_open(const char *name, int oflag, mode_t mode);       /* 1. 열고 */
int ftruncate(int fd, off_t length);                          /* 2. 크기를 정하고 */
void *mmap(void *addr, size_t length, int prot, int flags,    /* 3. 붙인다 */
           int fd, off_t offset);
| 함수 | 인자 | 설명 |
|---|---|---|
shm_open |
name |
/이름. 기명 세마포어와 같은 규칙 |
oflag |
O_CREAT \| O_EXCL \| O_RDWR 등 18주차 open과 같음 |
|
mode |
권한 (0666) |
|
| 반환값 | fd. 18주차의 그 fd라서 fstat, close가 다 됩니다. 실패하면 -1 |
|
ftruncate |
fd, length |
파일 크기를 length로 맞춤. 새로 만든 공유 메모리는 크기가 0이라 이 단계가 필수 |
mmap |
length |
붙일 크기. 보통 구조체 하나의 sizeof |
prot |
PROT_READ \| PROT_WRITE |
|
flags |
MAP_SHARED. MAP_PRIVATE면 쓴 내용이 나한테만 보입니다 |
|
fd, offset |
shm_open이 준 fd, 파일 안의 시작 위치(보통 0) |
|
| 반환값 | 붙은 주소. 실패하면 MAP_FAILED |
실체는 /dev/shm/이름 파일입니다. /dev/shm은 tmpfs(메모리 위의 파일 시스템)라 디스크에는 안 내려가죠. 그래서 “파일을 열어서 메모리에 붙인다”는 절차가 실제로는 “메모리를 파일처럼 이름 붙여 공유한다”가 됩니다.
examples/shm_posix.c:
/*
 * shm_posix.c - POSIX 공유 메모리: 가장 빠른 IPC
 * 19주차: IPC와 동기화
 *
 * 파이프는 데이터를 '복사'합니다: 내 버퍼 -> 커널 버퍼 -> 상대 버퍼.
 * 공유 메모리는 아예 '같은 물리 메모리'를 두 프로세스가 봅니다.
 * 복사가 0번이라 IPC 중 가장 빠릅니다.
 *
 * POSIX 방식 (System V보다 현대적이고 파일처럼 다룰 수 있어 권장):
 *   shm_open("/이름", ...)  -> fd를 얻는다 (파일 열기와 똑같다!)
 *   ftruncate(fd, 크기)     -> 크기를 정한다
 *   mmap(...)               -> 내 주소 공간에 붙인다
 *   munmap / close / shm_unlink
 *
 * 실체는 /dev/shm/이름 파일입니다 (tmpfs = 메모리 위의 파일 시스템).
 * ls -l /dev/shm 으로 직접 볼 수 있습니다!
 *
 * 주의: 공유 메모리 자체에는 동기화 장치가 없습니다.
 *       세마포어와 반드시 함께 써야 합니다 (sem_posix.c 참고).
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <fcntl.h>
#include <semaphore.h>
#include <sys/mman.h>
#include <sys/stat.h>
#include <sys/wait.h>
#include <time.h>

#define SHM_NAME "/week19_demo_shm"
#define BOARD_LINES 5
#define LINE_LEN    64

/* 공유 메모리에 놓을 구조체: '게시판' */
typedef struct {
    sem_t lock;                      /* 동기화 장치도 같이! */
    int   count;                     /* 몇 줄 썼나 */
    char  lines[BOARD_LINES][LINE_LEN];
} Board;

static double elapsed_ms(struct timespec a, struct timespec b) {
    return (b.tv_sec - a.tv_sec) * 1000.0 + (b.tv_nsec - a.tv_nsec) / 1e6;
}

int main(void) {
    printf("=== 1. 공유 메모리 만들기 ===\n");

    shm_unlink(SHM_NAME);            /* 이전 실행 찌꺼기 제거 */

    /* 파일 열듯이 연다 - 반환값이 fd! (18주차의 그 fd) */
    int fd = shm_open(SHM_NAME, O_CREAT | O_EXCL | O_RDWR, 0666);
    if (fd < 0) { perror("shm_open"); return 1; }
    printf("shm_open(\"%s\") -> fd %d\n", SHM_NAME, fd);

    /* 크기 정하기 (새로 만든 공유 메모리는 크기가 0이다) */
    if (ftruncate(fd, sizeof(Board)) < 0) { perror("ftruncate"); return 1; }
    printf("ftruncate로 크기 지정: %zu바이트\n", sizeof(Board));

    /* 내 주소 공간에 붙이기 */
    Board *board = mmap(NULL, sizeof(Board), PROT_READ | PROT_WRITE,
                        MAP_SHARED, fd, 0);
    if (board == MAP_FAILED) { perror("mmap"); return 1; }
    printf("mmap 성공: 주소 %p에 붙었다\n", (void *)board);
    printf("실체 확인: ls -l /dev/shm%s\n\n", SHM_NAME);

    /* 초기화 */
    memset(board, 0, sizeof(Board));
    sem_init(&board->lock, 1, 1);

    /* ---------- 2. 여러 프로세스가 같은 메모리에 쓰기 ---------- */
    printf("=== 2. 자식 3명이 같은 게시판에 글쓰기 ===\n");
    fflush(stdout);

    for (int i = 0; i < 3; i++) {
        pid_t pid = fork();
        if (pid < 0) { perror("fork"); return 1; }
        if (pid == 0) {
            usleep((unsigned)i * 100000);

            sem_wait(&board->lock);              /* 반드시 락! */
            if (board->count < BOARD_LINES) {
                snprintf(board->lines[board->count], LINE_LEN,
                         "자식 %d (PID %d)이 남긴 글", i, getpid());
                board->count++;
            }
            sem_post(&board->lock);

            _exit(0);
        }
    }
    while (wait(NULL) > 0) { }

    printf("부모가 읽은 게시판 (%d줄):\n", board->count);
    for (int i = 0; i < board->count; i++) {
        printf("  %d) %s\n", i + 1, board->lines[i]);
    }
    printf("-> 자식이 쓴 글이 부모에게 그대로 보입니다.\n");
    printf("   fork로 복사된 변수였다면 절대 불가능한 일이죠! (18주차 대조)\n");

    /* ---------- 3. 속도 비교: 공유 메모리 vs 파이프 ---------- */
    printf("\n=== 3. 얼마나 빠른가: 파이프와 대결 ===\n");

    const int ROUNDS = 20000;
    const size_t CHUNK = 4096;

    /* (가) 파이프로 4KB씩 ROUNDS번 왕복 없이 단방향 전송 */
    int pfd[2];
    if (pipe(pfd) < 0) { perror("pipe"); return 1; }

    struct timespec t0, t1;
    clock_gettime(CLOCK_MONOTONIC, &t0);

    pid_t pid = fork();
    if (pid == 0) {
        close(pfd[1]);
        char *buf = malloc(CHUNK);
        ssize_t n;
        while ((n = read(pfd[0], buf, CHUNK)) > 0) { }
        free(buf);
        close(pfd[0]);
        _exit(0);
    }
    close(pfd[0]);
    {
        char *buf = calloc(1, CHUNK);
        for (int i = 0; i < ROUNDS; i++) write(pfd[1], buf, CHUNK);
        free(buf);
    }
    close(pfd[1]);
    wait(NULL);
    clock_gettime(CLOCK_MONOTONIC, &t1);
    double pipe_ms = elapsed_ms(t0, t1);

    /* (나) 공유 메모리에 같은 양을 쓰기 (복사 한 번) */
    size_t total = CHUNK * (size_t)ROUNDS;
    int big_fd = shm_open("/week19_bench_shm", O_CREAT | O_RDWR, 0666);
    if (big_fd >= 0 && ftruncate(big_fd, (off_t)CHUNK) == 0) {
        char *region = mmap(NULL, CHUNK, PROT_READ | PROT_WRITE,
                            MAP_SHARED, big_fd, 0);
        if (region != MAP_FAILED) {
            char *src = calloc(1, CHUNK);
            clock_gettime(CLOCK_MONOTONIC, &t0);
            for (int i = 0; i < ROUNDS; i++) memcpy(region, src, CHUNK);
            clock_gettime(CLOCK_MONOTONIC, &t1);
            free(src);
            munmap(region, CHUNK);

            double shm_ms = elapsed_ms(t0, t1);
            printf("데이터 %.1fMB 전송\n", total / (1024.0 * 1024.0));
            printf("  파이프     : %7.1f ms  (유저->커널->유저, 복사 2번)\n",
                   pipe_ms);
            printf("  공유 메모리: %7.1f ms  (내 메모리에 쓰기, 복사 1번)\n",
                   shm_ms);
            printf("  -> 약 %.1f배 빠름 (커널을 거치지 않으니까!)\n",
                   pipe_ms / (shm_ms > 0 ? shm_ms : 1));
        }
        close(big_fd);
    }
    shm_unlink("/week19_bench_shm");

    /* ---------- 4. 정리 ---------- */
    printf("\n=== 4. 정리: 붙였으면 떼고, 만들었으면 지운다 ===\n");
    sem_destroy(&board->lock);
    munmap(board, sizeof(Board));    /* 내 주소 공간에서 떼기 */
    close(fd);                       /* fd 닫기 */
    shm_unlink(SHM_NAME);            /* 이름 제거 - 이걸 해야 진짜 사라진다 */
    printf("munmap + close + shm_unlink 완료\n");
    printf("(shm_unlink를 잊으면 /dev/shm에 남아 재부팅까지 메모리를 차지!)\n");

    printf("\n=== 5. 공유 메모리의 특징 ===\n");
    printf("장점: IPC 중 가장 빠름 (복사 최소, 커널 개입 없음)\n");
    printf("      큰 데이터에 특히 유리 (동영상 프레임, 행렬 등)\n");
    printf("단점: 동기화를 직접 해야 한다 (세마포어 필수!)\n");
    printf("      포인터를 넣으면 안 된다 - 프로세스마다 주소가 다르니까!\n");
    printf("      (넣어야 한다면 '시작점으로부터의 오프셋'을 저장하세요)\n");

    return 0;
}

POSIX 공유 메모리
$ gcc -Wall -Wextra -std=gnu11 -g examples/shm_posix.c -o build/shm_posix -pthread -lrt
$ ./build/shm_posix
=== 1. 공유 메모리 만들기 ===
shm_open("/week19_demo_shm") -> fd 3
ftruncate로 크기 지정: 360바이트
mmap 성공: 주소 0x769c074ed000에 붙었다
실체 확인: ls -l /dev/shm/week19_demo_shm

=== 2. 자식 3명이 같은 게시판에 글쓰기 ===
부모가 읽은 게시판 (3줄):
  1) 자식 0 (PID 307137)이 남긴 글
  2) 자식 1 (PID 307138)이 남긴 글
  3) 자식 2 (PID 307139)이 남긴 글
-> 자식이 쓴 글이 부모에게 그대로 보입니다.
   fork로 복사된 변수였다면 절대 불가능한 일이죠! (18주차 대조)

=== 3. 얼마나 빠른가: 파이프와 대결 ===
데이터 78.1MB 전송
  파이프     :    13.4 ms  (유저->커널->유저, 복사 2번)
  공유 메모리:     0.6 ms  (내 메모리에 쓰기, 복사 1번)
  -> 약 22.1배 빠름 (커널을 거치지 않으니까!)

=== 4. 정리: 붙였으면 떼고, 만들었으면 지운다 ===
munmap + close + shm_unlink 완료
...
22배 차이입니다. 78MB를 파이프로 보내는 데 13.4ms, 공유 메모리에 쓰는 데 0.6ms입니다. 파이프 쪽은 4KB마다 write 시스템 콜 한 번, read 시스템 콜 한 번, 그리고 두 번의 복사가 있습니다. 공유 메모리 쪽은 memcpy 한 번뿐이고 커널은 전혀 개입하지 않습니다. 데이터가 클수록 격차가 벌어지죠. 주소값(0x769c...)과 PID, 시간은 실행마다 다릅니다.
코드 읽기 포인트
- 360바이트:
Board구조체의 크기입니다.sem_t32 +int4 +char[5][64]320 = 356인데, 구조체 전체 크기는 가장 큰 멤버의 정렬 단위(8)의 배수여야 해서 끝에 패딩 4바이트가 붙어 360이 됩니다. 8주차의 패딩 규칙이 여기서도 적용됩니다.ftruncate에sizeof(Board)를 넘기는 이유는 이 숫자를 직접 세지 않기 위해서입니다. O_CREAT | O_EXCL: “없으면 만들고, 이미 있으면 실패하라”. 시작할 때shm_unlink로 지운 뒤O_EXCL로 만들면, 다른 프로그램이 같은 이름을 쓰고 있을 때 조용히 덮어쓰는 대신 오류로 알 수 있습니다.memset(board, 0, ...): 새로 만든 공유 메모리는ftruncate가 0으로 채워 주지만, 이전 실행이 남긴 파일을 열었을 때는 옛 내용이 들어 있을 수 있습니다. 습관으로 초기화합니다.- 자식의
usleep(i * 100000): 세 자식이 0, 0.1, 0.2초 간격으로 쓰게 해서 출력 순서를 예측 가능하게 만든 것입니다. 없어도 동작하지만 순서가 바뀔 수 있습니다. 동기화(락)는 “겹치지 않게”를 보장할 뿐 “순서”를 보장하지는 않는다는 점을 기억하세요.
7.2 /dev/shm 에서 직접 보기
프로그램이 도는 동안 다른 터미널에서 /dev/shm을 보면 이렇게 나옵니다(예제는 순식간에 끝나므로, 6.6절과 7절의 자원을 3초간 잡고 있는 작은 프로그램으로 찍었습니다).
$ ls -l /dev/shm/
-rw-rw-r-- 1 user user  32  9월 29 02:18 sem.w19_hold_sem
-rw-rw-r-- 1 user user 360  9월 29 02:18 w19_hold_shm
공유 메모리는 우리가 ftruncate한 360바이트 그대로, 기명 세마포어는 sem. 접두사가 붙어 32바이트로 보입니다. 권한 rw-rw-r--는 0666에 umask 002를 적용한 결과입니다. 9주차 끝에서 본 “모든 것은 파일”이라는 리눅스의 원칙이 메모리에까지 적용되는 것입니다.
7.3 ftruncate 를 빼먹으면 — 버스 오류
ftruncate가 왜 필수인지 직접 확인해 봅시다. shm_notrunc.c는 크기를 정하지 않고 바로 mmap합니다.
    int fd = shm_open("/w19_notrunc", O_CREAT | O_RDWR, 0666);
    /* ftruncate(fd, 4096);  <- 크기를 정하지 않았다 */
    char *p = mmap(NULL, 4096, PROT_READ | PROT_WRITE, MAP_SHARED, fd, 0);
    if (p == MAP_FAILED) { perror("mmap"); return 1; }
    printf("mmap 은 성공했다: %p\n", (void *)p);
    fflush(stdout);
    strcpy(p, "hello");            /* 크기 0 인 파일의 밖을 건드린다 */
    printf("이 줄은 나오지 않는다\n");
$ ./shm_notrunc
mmap 은 성공했다: 0x790e30125000
bash: 줄 1: 324533 버스 오류           (코어 덤프됨) ./shm_notrunc
$ echo $?
135
mmap은 성공합니다. 붙이는 것 자체는 파일 크기와 상관없이 되니까요. 문제는 붙은 메모리에 처음 손을 대는 순간입니다. 파일은 0바이트인데 그 너머를 쓰려 하니 커널이 SIGBUS(시그널 7, 종료 코드 128 + 7 = 135)를 보냅니다. 6주차에서 본 세그멘테이션 오류(SIGSEGV, 139)와 이름이 다르다는 점을 기억하세요. “버스 오류”가 나면 mmap한 파일의 크기부터 의심하면 됩니다. 이 실험이 남긴 /dev/shm/w19_notrunc는 프로그램이 죽어서 shm_unlink에 도달하지 못했으니 직접 지워야 합니다. 12절 참고.
7.4 세 가지 정리 단계
    munmap(board, sizeof(Board));    /* 내 주소 공간에서 떼기 */
    close(fd);                       /* fd 닫기 */
    shm_unlink(SHM_NAME);            /* 이름 제거 - 이걸 해야 진짜 사라진다 */
세 단계가 각각 다른 일을 합니다.
| 단계 | 하는 일 | 다른 프로세스에는 |
|---|---|---|
munmap |
내 주소 공간에서만 뗍니다 | 영향 없음. 여전히 붙어 있음 |
close |
fd만 반납합니다 | 영향 없음 |
shm_unlink |
이름을 지웁니다. 마지막 프로세스가 munmap하면 진짜로 해제 |
이미 붙어 있는 프로세스는 계속 쓸 수 있음 |
FIFO의 unlink, 기명 세마포어의 sem_unlink와 같은 규칙입니다. shm_unlink를 잊으면 재부팅까지 메모리를 차지합니다. 프로그램이 죽어도 남죠. 7.3절의 버스 오류 실험이 남긴 파일이 그 예입니다. 개발 중에 ls -lh /dev/shm을 종종 확인하는 습관을 들이세요.
7.5 포인터를 넣으면 안 된다
공유 메모리의 가장 중요한 제약입니다.
공유 메모리 안에 포인터를 저장하면 안 됩니다.
mmap이 반환하는 주소는 프로세스마다 다릅니다. 6주차에서 ASLR 때문에 실행할 때마다 주소가 바뀌는 것을 봤죠. 프로세스 A에서 0x7f00...인 영역이 프로세스 B에서는 0x7b5a...일 수 있습니다. A가 저장한 포인터 0x7f00...1234를 B가 읽으면 B의 주소 공간에서 그 자리는 전혀 다른 것이거나 비어 있습니다.
그래서 10~14주차에서 만든 자료구조를 그대로 올릴 수 없습니다. 연결 리스트의 next 포인터, 트리의 left/right, 전부 쓸 수 없죠. 해법은 포인터 대신 인덱스(오프셋)를 저장하는 것입니다.
/* 이렇게 하면 안 된다 */
typedef struct Node { struct Node *next; int value; } Node;

/* 이렇게 한다 */
typedef struct { int next_index;  int value; } Node;   /* -1 = NULL 대신 */
Node pool[1000];                                        /* 배열 안에서 인덱스로 연결 */
배열의 3번 칸은 어느 프로세스에서 봐도 3번 칸입니다. 시작 주소가 달라도 “시작에서 몇 번째”는 같기 때문입니다. 프로젝트 2(공유 메모리 캐시)에서 이 원칙 때문에 연결 리스트 대신 개방 주소법을 쓰게 됩니다.
같은 이유로 char * 문자열도 안 됩니다. malloc으로 잡은 메모리는 그 프로세스의 힙이라 남이 볼 수 없습니다. 예제의 Board가 char *lines[5]가 아니라 char lines[5][64]인 이유입니다. 공유 메모리 안의 데이터는 전부 값으로 들어 있어야 합니다.
7.6 동기화는 별도로
공유 메모리 자체에는 동기화 장치가 없습니다. 두 프로세스가 동시에 같은 곳을 쓰면 5절의 경쟁 조건이 그대로 재현됩니다. 5절의 실험이 바로 MAP_SHARED 메모리에서 일어난 일이었죠.
그래서 예제에서도 세마포어를 함께 씁니다.
typedef struct {
    sem_t lock;                      /* 동기화 장치도 같이! */
    int   count;
    char  lines[BOARD_LINES][LINE_LEN];
} Board;
세마포어를 공유 메모리 구조체 안에 넣는 것이 정석입니다. 6.3절에서 세마포어가 공유 메모리에 있어야 한다고 했으니, 데이터를 담는 구조체의 첫 멤버로 넣으면 자연스럽게 해결됩니다. 데이터와 그 데이터를 지키는 락이 같은 곳에 있으니 관리도 쉽죠.
8. 메시지 큐: 우선순위가 있는 우편함
8.1 바이트 흐름 vs 메시지
파이프는 바이트 흐름입니다. 1절 실행 결과에서 write를 세 번 했더니 read도 세 번 됐지만, 그것은 usleep으로 간격을 뒀기 때문입니다. 간격 없이 쓰면 어떻게 될까요? coalesce.c는 부모가 "AAA", "BBBBBBBB", "CC"를 연달아 쓰고, 자식은 0.1초 뒤에 한 번만 read합니다.
    close(fd[0]);
    write(fd[1], "AAA", 3);
    write(fd[1], "BBBBBBBB", 8);
    write(fd[1], "CC", 2);
    close(fd[1]);
$ ./coalesce
read 한 번에 13바이트: [AAABBBBBBBBCC]
세 번 쓴 것이 한 번에 13바이트로 왔습니다. 3.2절의 FIFO 서버가 두 줄을 한꺼번에 받은 것과 같은 현상입니다. 파이프는 write의 경계를 기억하지 않습니다. 어디까지가 한 메시지인지 내가 정해야 합니다(줄바꿈으로 나누거나, 길이를 앞에 붙이거나). 프로젝트 3의 read_exact가 그 “길이 규칙”을 구현한 것입니다.
메시지 큐는 메시지 단위로 주고받습니다.
- 보낸 단위 그대로 받는다 (경계 보존)
- 우선순위를 붙일 수 있다
- 받는 쪽이 없어도 큐에 쌓아둘 수 있다
#include <mqueue.h>
mqd_t mq_open(const char *name, int oflag, mode_t mode, struct mq_attr *attr);
int mq_send(mqd_t mqdes, const char *msg_ptr, size_t msg_len, unsigned int msg_prio);
ssize_t mq_receive(mqd_t mqdes, char *msg_ptr, size_t msg_len, unsigned int *msg_prio);
int mq_close(mqd_t mqdes);
int mq_unlink(const char *name);
| 함수 | 인자 | 설명 |
|---|---|---|
mq_open |
name |
/이름 (앞의 둘과 같은 규칙) |
oflag |
O_CREAT, O_EXCL, O_RDONLY/O_WRONLY/O_RDWR, O_NONBLOCK |
|
attr |
큐의 속성. mq_maxmsg(최대 메시지 개수)와 mq_msgsize(메시지 하나의 최대 바이트) 두 개가 핵심. NULL이면 시스템 기본값 |
|
| 반환값 | mqd_t. fd처럼 생겼지만 타입이 다릅니다. 실패하면 (mqd_t)-1 |
|
mq_send |
msg_ptr, msg_len |
보낼 바이트와 길이. msg_len이 mq_msgsize보다 크면 EMSGSIZE |
msg_prio |
우선순위. 0이 가장 낮고 클수록 먼저 나옵니다 | |
| 큐가 꽉 차면 | 기다림. O_NONBLOCK이면 EAGAIN |
|
mq_receive |
msg_ptr, msg_len |
받을 버퍼와 그 크기. 버퍼가 mq_msgsize보다 작으면 EMSGSIZE (가장 흔한 실수) |
msg_prio |
받은 메시지의 우선순위를 돌려받을 자리. 필요 없으면 NULL |
|
| 반환값 | 받은 바이트 수. 큐가 비면 기다림, O_NONBLOCK이면 EAGAIN |
examples/mqueue_demo.c:
/*
 * mqueue_demo.c - POSIX 메시지 큐: 우선순위가 있는 우편함
 * 19주차: IPC와 동기화
 *
 * 파이프는 '바이트 흐름'입니다. 어디까지가 한 메시지인지 내가 정해야 하죠
 * (줄바꿈으로 나누거나, 길이를 앞에 붙이거나...).
 *
 * 메시지 큐는 '메시지 단위'로 주고받습니다:
 *   - 보낸 단위 그대로 받는다 (경계가 보존된다!)
 *   - 우선순위를 붙일 수 있다 (급한 것부터!)
 *   - 큐에 쌓아둘 수 있다 (받는 쪽이 없어도 보관)
 *
 * POSIX API (System V의 msgget보다 깔끔합니다):
 *   mq_open("/이름", ...)  -> mqd_t (fd 비슷한 것)
 *   mq_send(q, 버퍼, 길이, 우선순위)
 *   mq_receive(q, 버퍼, 버퍼크기, &우선순위)   <- 우선순위 높은 것부터!
 *   mq_close / mq_unlink
 *
 * 컴파일: gcc ... -lrt  (mq_* 함수는 실시간 라이브러리에)
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <fcntl.h>
#include <mqueue.h>
#include <errno.h>
#include <sys/wait.h>
#include <sys/stat.h>

#define MQ_NAME  "/week19_demo_mq"
#define MAX_MSG  10
#define MSG_SIZE 128

int main(void) {
    printf("=== 1. 메시지 큐 만들기 ===\n");

    mq_unlink(MQ_NAME);              /* 이전 찌꺼기 제거 */

    struct mq_attr attr;
    memset(&attr, 0, sizeof(attr));
    attr.mq_maxmsg  = MAX_MSG;       /* 최대 메시지 개수 */
    attr.mq_msgsize = MSG_SIZE;      /* 메시지 하나의 최대 크기 */

    mqd_t mq = mq_open(MQ_NAME, O_CREAT | O_EXCL | O_RDWR, 0666, &attr);
    if (mq == (mqd_t)-1) {
        perror("mq_open");
        if (errno == ENOSYS || errno == EACCES) {
            printf("(이 시스템에서 POSIX 메시지 큐를 쓸 수 없습니다.\n");
            printf(" 컨테이너라면 /dev/mqueue 마운트가 필요할 수 있습니다)\n");
        }
        return 1;
    }
    printf("mq_open(\"%s\") 성공\n", MQ_NAME);
    printf("최대 %ld개, 메시지당 최대 %ld바이트\n",
           attr.mq_maxmsg, attr.mq_msgsize);
    printf("실체 확인: ls -l /dev/mqueue%s\n\n", MQ_NAME);

    /* ---------- 2. 우선순위 실험 ---------- */
    printf("=== 2. 우선순위: 급한 것부터 나온다 ===\n");
    printf("보내는 순서와 받는 순서가 다릅니다!\n\n");

    struct { const char *text; unsigned prio; } outbox[] = {
        {"[일반] 일일 리포트 생성",      1},
        {"[일반] 캐시 정리",             1},
        {"[긴급] 디스크 가득참!",        9},
        {"[보통] 사용자 알림 발송",      5},
        {"[긴급] 서비스 응답 없음!",     9},
        {"[보통] 백업 시작",             5},
    };
    int n = (int)(sizeof(outbox) / sizeof(outbox[0]));

    printf("보낸 순서:\n");
    for (int i = 0; i < n; i++) {
        if (mq_send(mq, outbox[i].text, strlen(outbox[i].text) + 1,
                    outbox[i].prio) < 0) {
            perror("mq_send");
            break;
        }
        printf("  %d. (우선순위 %u) %s\n", i + 1, outbox[i].prio,
               outbox[i].text);
    }

    /* 현재 큐 상태 */
    mq_getattr(mq, &attr);
    printf("\n큐에 쌓인 메시지: %ld개\n", attr.mq_curmsgs);

    printf("\n받은 순서:\n");
    char buffer[MSG_SIZE];
    unsigned prio;
    for (int i = 0; i < n; i++) {
        ssize_t len = mq_receive(mq, buffer, sizeof(buffer), &prio);
        if (len < 0) { perror("mq_receive"); break; }
        printf("  %d. (우선순위 %u) %s\n", i + 1, prio, buffer);
    }
    printf("\n-> 우선순위 9 -> 5 -> 1 순서! 같은 우선순위는 보낸 순서(FIFO)\n");
    printf("   파이프였다면 무조건 보낸 순서대로만 나왔을 겁니다.\n");

    /* ---------- 3. 메시지 경계가 보존된다 ---------- */
    printf("\n=== 3. 메시지 경계 보존 ===\n");

    mq_send(mq, "AAA", 4, 0);
    mq_send(mq, "BBBBBBBB", 9, 0);
    mq_send(mq, "CC", 3, 0);

    printf("3개를 보냈습니다 (4, 9, 3바이트)\n");
    for (int i = 0; i < 3; i++) {
        ssize_t len = mq_receive(mq, buffer, sizeof(buffer), &prio);
        printf("  받음: \"%s\" (%zd바이트)\n", buffer, len);
    }
    printf("-> 보낸 단위 그대로! 파이프라면 \"AAABBBBBBBBCC\"가 뭉쳐 나와\n");
    printf("   내가 직접 잘라야 했을 겁니다. 이것이 메시지 지향의 장점.\n");

    /* ---------- 4. 논블로킹 수신 ---------- */
    printf("\n=== 4. 빈 큐에서 받으면? ===\n");
    printf("기본 동작: 메시지가 올 때까지 블록됩니다 (FIFO의 랑데부처럼)\n");
    printf("O_NONBLOCK이면 즉시 실패:\n");

    mqd_t nb = mq_open(MQ_NAME, O_RDONLY | O_NONBLOCK);
    if (nb != (mqd_t)-1) {
        ssize_t r = mq_receive(nb, buffer, sizeof(buffer), &prio);
        if (r < 0) {
            printf("  mq_receive -> 실패, errno %d (%s)\n",
                   errno, strerror(errno));
            printf("  EAGAIN = '지금은 없음, 나중에 다시'\n");
        }
        mq_close(nb);
    }

    /* ---------- 5. 프로세스 간 실제 통신 ---------- */
    printf("\n=== 5. 프로세스 간 작업 분배 ===\n");
    fflush(stdout);

    pid_t pid = fork();
    if (pid == 0) {
        /* 자식 = 작업자 */
        mqd_t worker_mq = mq_open(MQ_NAME, O_RDONLY);
        if (worker_mq == (mqd_t)-1) { perror("[작업자] mq_open"); _exit(1); }

        usleep(200000);          /* 배포자가 3건을 다 넣을 때까지 기다린다.
                                  * (빈 큐에서 기다리고 있으면 도착하는 대로
                                  *  바로 받게 되어 우선순위가 의미 없어진다!) */

        char task[MSG_SIZE];
        unsigned p;
        for (int i = 0; i < 3; i++) {
            ssize_t len = mq_receive(worker_mq, task, sizeof(task), &p);
            if (len < 0) break;
            printf("  [작업자] 처리 중: %s (우선순위 %u)\n", task, p);
            fflush(stdout);
            usleep(100000);
        }
        mq_close(worker_mq);
        _exit(0);
    }

    /* 부모 = 작업 배포자 */
    mq_send(mq, "이미지 변환", 20, 3);
    mq_send(mq, "로그 압축", 17, 1);
    mq_send(mq, "결제 처리", 17, 9);       /* 가장 급함! */
    printf("  [배포자] 작업 3건 전송 (결제가 우선순위 9)\n");
    fflush(stdout);
    wait(NULL);
    printf("  -> 쌓여 있던 3건 중 결제(9)가 먼저 처리됐습니다.\n");
    printf("     주의: 큐가 비어 있어 작업자가 '대기 중'이면, 도착하는 즉시\n");
    printf("     배달되므로 우선순위가 의미를 잃습니다. 우선순위는 '줄이\n");
    printf("     서 있을 때' 순서를 정하는 규칙입니다.\n");

    /* ---------- 6. 정리 ---------- */
    mq_close(mq);
    mq_unlink(MQ_NAME);
    printf("\n=== 6. 정리 완료 (mq_close + mq_unlink) ===\n");

    printf("\n=== 7. IPC 선택 가이드 ===\n");
    printf("+---------------+------------------+---------------------------+\n");
    printf("| 방식          | 데이터 단위      | 언제 쓰나                 |\n");
    printf("+---------------+------------------+---------------------------+\n");
    printf("| 파이프/FIFO   | 바이트 흐름      | 단순 전달, 쉘 파이프라인  |\n");
    printf("| 메시지 큐     | 메시지(+우선순위)| 작업 배분, 이벤트 전달    |\n");
    printf("| 공유 메모리   | 메모리 영역      | 대용량, 최고 속도         |\n");
    printf("| 소켓(21주차)  | 바이트/데이터그램| 다른 컴퓨터와도!          |\n");
    printf("+---------------+------------------+---------------------------+\n");
    return 0;
}
$ gcc -Wall -Wextra -std=gnu11 -g examples/mqueue_demo.c -o build/mqueue_demo -lrt
$ ./build/mqueue_demo
=== 1. 메시지 큐 만들기 ===
mq_open("/week19_demo_mq") 성공
최대 10개, 메시지당 최대 128바이트
실체 확인: ls -l /dev/mqueue/week19_demo_mq

=== 2. 우선순위: 급한 것부터 나온다 ===
보내는 순서와 받는 순서가 다릅니다!

보낸 순서:
  1. (우선순위 1) [일반] 일일 리포트 생성
  2. (우선순위 1) [일반] 캐시 정리
  3. (우선순위 9) [긴급] 디스크 가득참!
  4. (우선순위 5) [보통] 사용자 알림 발송
  5. (우선순위 9) [긴급] 서비스 응답 없음!
  6. (우선순위 5) [보통] 백업 시작

큐에 쌓인 메시지: 6개

받은 순서:
  1. (우선순위 9) [긴급] 디스크 가득참!
  2. (우선순위 9) [긴급] 서비스 응답 없음!
  3. (우선순위 5) [보통] 사용자 알림 발송
  4. (우선순위 5) [보통] 백업 시작
  5. (우선순위 1) [일반] 일일 리포트 생성
  6. (우선순위 1) [일반] 캐시 정리

-> 우선순위 9 -> 5 -> 1 순서! 같은 우선순위는 보낸 순서(FIFO)
   파이프였다면 무조건 보낸 순서대로만 나왔을 겁니다.

=== 3. 메시지 경계 보존 ===
3개를 보냈습니다 (4, 9, 3바이트)
  받음: "AAA" (4바이트)
  받음: "BBBBBBBB" (9바이트)
  받음: "CC" (3바이트)
-> 보낸 단위 그대로! 파이프라면 "AAABBBBBBBBCC"가 뭉쳐 나와
   내가 직접 잘라야 했을 겁니다. 이것이 메시지 지향의 장점.

=== 4. 빈 큐에서 받으면? ===
기본 동작: 메시지가 올 때까지 블록됩니다 (FIFO의 랑데부처럼)
O_NONBLOCK이면 즉시 실패:
  mq_receive -> 실패, errno 11 (Resource temporarily unavailable)
  EAGAIN = '지금은 없음, 나중에 다시'

=== 5. 프로세스 간 작업 분배 ===
  [배포자] 작업 3건 전송 (결제가 우선순위 9)
  [작업자] 처리 중: 결제 처리 (우선순위 9)
  [작업자] 처리 중: 이미지 변환 (우선순위 3)
  [작업자] 처리 중: 로그 압축 (우선순위 1)
  -> 쌓여 있던 3건 중 결제(9)가 먼저 처리됐습니다.
...
보낸 순서와 받는 순서가 다릅니다. 우선순위 9 → 5 → 1 순이고, 같은 우선순위 안에서는 보낸 순서(FIFO)입니다.
코드 읽기 포인트
strlen(text) + 1: 문자열의 끝\0까지 보냅니다. 4주차에서 배운 대로 받는 쪽이printf("%s")로 찍으려면\0이 있어야 합니다. 3번 실험의 “4, 9, 3바이트”도\0을 포함한 길이입니다.mq_getattr로 현황 보기:mq_curmsgs가 지금 쌓인 개수입니다. 6개를 보냈으니 6입니다.- 경계 보존:
"AAA","BBBBBBBB","CC"를 보내면 정확히 그 단위로 받습니다. 파이프였다면 한 번의read에AAA\0BBBBBBBB\0CC\0이 통째로 올 수 있고, 어디서 잘라야 할지 내가 알아내야 합니다.
8.2 우선순위의 함정
예제의 5번 실험에 중요한 주의사항이 있습니다. 작업자(자식)가 usleep(200000)으로 0.2초 기다린 뒤 큐를 읽는 이유입니다. 우선순위는 큐에 여러 개가 쌓여 있을 때만 의미가 있습니다. 작업자가 빈 큐에서 기다리고 있으면 첫 메시지 “이미지 변환(3)”이 도착하는 즉시 가져가 버리고, 뒤에 온 “결제 처리(9)”는 그다음 차례가 됩니다. usleep을 지우고 실행해 보세요. 처리 순서가 보낸 순서(3, 1, 9)로 바뀝니다.
이 성질은 실무에서 중요합니다. “긴급 작업이 왜 먼저 처리 안 되지?”의 답이 대개 이것입니다. 부하가 낮을 때는 우선순위가 무의미하고, 부하가 높아 줄이 생겨야 효과가 나타납니다.
8.3 한계를 넘기면 — EMSGSIZE 와 EAGAIN
mq_attr의 두 숫자가 실제로 어떻게 작동하는지 봅시다. mq_limits.c는 최대 3개, 메시지당 16바이트짜리 작은 큐를 논블로킹으로 만들어 한계를 하나씩 넘겨 봅니다.
    struct mq_attr attr = { .mq_maxmsg = 3, .mq_msgsize = 16 };
    mqd_t mq = mq_open("/w19_limits", O_CREAT | O_RDWR | O_NONBLOCK, 0666, &attr);

    char big[32]; memset(big, 'x', sizeof(big));
    if (mq_send(mq, big, 32, 0) < 0)
        printf("32바이트 보내기: errno %d (%s)  <- mq_msgsize=16 초과\n", errno, strerror(errno));

    for (int i = 0; i < 4; i++) {
        if (mq_send(mq, "hi", 3, 0) < 0) {
            printf("%d번째 보내기: errno %d (%s)  <- mq_maxmsg=3 이라 꽉 참\n", i + 1, errno, strerror(errno));
            break;
        }
        printf("%d번째 보내기: 성공\n", i + 1);
    }

    char small[8];
    if (mq_receive(mq, small, sizeof(small), NULL) < 0)
        printf("8바이트 버퍼로 받기: errno %d (%s)  <- 버퍼는 mq_msgsize 이상이어야\n", errno, strerror(errno));
$ ./mq_limits
32바이트 보내기: errno 90 (Message too long)  <- mq_msgsize=16 초과
1번째 보내기: 성공
2번째 보내기: 성공
3번째 보내기: 성공
4번째 보내기: errno 11 (Resource temporarily unavailable)  <- mq_maxmsg=3 이라 꽉 참
8바이트 버퍼로 받기: errno 90 (Message too long)  <- 버퍼는 mq_msgsize 이상이어야
세 가지 실패가 모두 errno로 정확히 구분됩니다.
EMSGSIZE(90) 보내기: 메시지가mq_msgsize보다 큽니다EAGAIN(11): 큐가mq_maxmsg개로 꽉 찼습니다.O_NONBLOCK이 없었다면 여기서 기다렸을 겁니다EMSGSIZE(90) 받기: 이것이 함정입니다. 받을 메시지는 3바이트짜리"hi"인데도 실패했습니다.mq_receive의 버퍼는 실제 메시지 크기가 아니라mq_msgsize(16) 이상이어야 합니다. “받을 게 얼마나 클지 모르니 최대 크기만큼 준비해 와라”는 규칙입니다. 예제에서buffer[MSG_SIZE]로 잡은 이유입니다
큐를 만들 때 정할 수 있는 상한은 시스템이 정합니다.
$ cat /proc/sys/fs/mqueue/msg_max /proc/sys/fs/mqueue/msgsize_max
10
8192
일반 사용자는 mq_maxmsg를 10, mq_msgsize를 8192 넘게 잡을 수 없습니다(EINVAL). 예제의 10과 128은 이 한계 안입니다. 더 큰 큐가 필요하면 관리자가 이 파일의 값을 올려야 합니다.
8.4 메시지 큐의 실체
메시지 큐도 파일 시스템에 나타납니다. 큐에 메시지가 두 개(각 4바이트) 들어 있는 동안 보면 이렇습니다.
$ ls -l /dev/mqueue/
-rw-rw-r-- 1 user user 80  9월 29 02:18 w19_hold_mq
$ cat /dev/mqueue/w19_hold_mq
QSIZE:8          NOTIFY:0     SIGNO:0     NOTIFY_PID:0
cat으로 읽으면 대기 중인 메시지의 총 바이트(QSIZE:8 = 4 + 4)를 보여 줍니다. 역시 “모든 것은 파일이다”의 연장입니다. ls의 크기 80은 실제 데이터가 아니라 커널이 계산해 보여 주는 관리 정보라, 신경 쓰지 않아도 됩니다.
컨테이너 환경(28주차)에서는 /dev/mqueue가 마운트되어 있지 않아 mq_open이 실패할 수 있습니다. 그럴 때는 관리자 권한으로 마운트합니다.
sudo mkdir -p /dev/mqueue && sudo mount -t mqueue none /dev/mqueue
9. System V IPC: 옛 방식도 알아야 하는 이유
IPC에는 두 가문이 있습니다.
- System V (1983):
shmget,semget,msgget— 정수 키(key) 로 식별 - POSIX (1993):
shm_open,sem_open,mq_open— 이름으로 식별
새 코드라면 POSIX가 낫습니다. 그런데 System V를 알아야 하는 이유가 있습니다.
- 오래된 코드와 상용 소프트웨어(오라클 등)가 아직 많이 씁니다
ipcs/ipcrm명령으로 시스템 전체를 관리합니다- 면접에 나옵니다 (진심입니다)
세 함수의 모양이 모두 같습니다. xxxget(키, 크기나 개수, 플래그 | 권한)으로 정수 ID를 얻고, 그 ID로 조작하고, xxxctl(ID, IPC_RMID, ...)로 지웁니다.
| 종류 | 만들기 | 쓰기 | 지우기 | POSIX 대응 |
|---|---|---|---|---|
| 공유 메모리 | shmget(key, size, flags) |
shmat(붙이기), shmdt(떼기) |
shmctl(id, IPC_RMID, NULL) |
shm_open/mmap |
| 세마포어 | semget(key, n, flags) |
semop(P/V를 구조체로), semctl |
semctl(id, 0, IPC_RMID) |
sem_open/sem_wait |
| 메시지 큐 | msgget(key, flags) |
msgsnd, msgrcv |
msgctl(id, IPC_RMID, NULL) |
mq_open/mq_send |
examples/sysv_ipc.c:
/*
 * sysv_ipc.c - System V IPC: 옛 방식도 알아야 하는 이유
 * 19주차: IPC와 동기화
 *
 * IPC에는 두 가문이 있습니다:
 *   System V (1983) : shmget, semget, msgget - 키(key)로 식별
 *   POSIX    (1993) : shm_open, sem_open, mq_open - 이름(/name)으로 식별
 *
 * 새 코드라면 POSIX가 낫습니다 (파일처럼 다룰 수 있고 API가 깔끔).
 * 그런데 System V를 알아야 하는 이유가 있습니다:
 *   1. 오래된 코드와 상용 소프트웨어(오라클 등)가 아직 많이 씁니다
 *   2. ipcs / ipcrm 명령으로 시스템 전체를 관리합니다
 *   3. 면접에 나옵니다 (진심입니다)
 *
 * 가장 큰 함정: System V IPC는 프로세스가 죽어도 사라지지 않습니다!
 * 명시적으로 지우지 않으면 재부팅까지 남습니다 (누수의 고전적 원인).
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <errno.h>
#include <sys/ipc.h>
#include <sys/shm.h>
#include <sys/sem.h>
#include <sys/msg.h>
#include <sys/wait.h>
#include <sys/stat.h>

#define KEY_PATH "/tmp"
#define SHM_SIZE 256

/* semctl에 넘길 공용체 - System V의 낡은 인터페이스 흔적 */
union semun {
    int val;
    struct semid_ds *buf;
    unsigned short *array;
};

/* 세마포어 P/V 연산 (System V는 이렇게 구조체로 한다) */
static int sem_op(int semid, int op) {
    struct sembuf sb;
    sb.sem_num = 0;                  /* 세마포어 집합의 0번 */
    sb.sem_op  = (short)op;          /* -1 = P(wait), +1 = V(post) */
    sb.sem_flg = SEM_UNDO;           /* 프로세스가 죽으면 자동 복원! */
    return semop(semid, &sb, 1);
}

int main(void) {
    printf("=== 1. 키(key) 만들기: ftok ===\n");

    /* System V는 '이름' 대신 '정수 키'로 IPC를 식별합니다.
     * ftok(경로, 프로젝트ID)로 경로의 inode와 ID를 섞어 키를 만듭니다. */
    key_t key = ftok(KEY_PATH, 'W');
    if (key == -1) { perror("ftok"); return 1; }
    printf("ftok(\"%s\", 'W') -> 0x%x\n", KEY_PATH, key);
    printf("(경로의 inode 번호가 섞이므로 경로가 존재해야 합니다!)\n");
    printf("주의: 파일이 지워졌다 다시 생기면 inode가 바뀌어 키도 바뀝니다\n\n");

    /* ---------- 2. System V 공유 메모리 ---------- */
    printf("=== 2. System V 공유 메모리 (shmget/shmat) ===\n");

    int shmid = shmget(key, SHM_SIZE, IPC_CREAT | 0666);
    if (shmid < 0) { perror("shmget"); return 1; }
    printf("shmget -> shmid %d  (POSIX의 fd에 해당)\n", shmid);

    char *shm = shmat(shmid, NULL, 0);       /* attach: 주소 공간에 붙이기 */
    if (shm == (char *)-1) { perror("shmat"); return 1; }
    printf("shmat  -> 주소 %p에 붙음\n", (void *)shm);

    strcpy(shm, "System V 공유 메모리 테스트");
    printf("부모가 쓴 내용: %s\n", shm);
    fflush(stdout);

    pid_t pid = fork();
    if (pid == 0) {
        char *child_shm = shmat(shmid, NULL, 0);   /* 자식도 붙인다 */
        printf("[자식] 같은 메모리에서 읽음: %s\n", child_shm);
        strcpy(child_shm, "자식이 고쳐 씀!");
        shmdt(child_shm);                          /* detach */
        _exit(0);
    }
    wait(NULL);
    printf("자식이 고친 뒤: %s\n", shm);

    /* 상태 조회 */
    struct shmid_ds shm_info;
    if (shmctl(shmid, IPC_STAT, &shm_info) == 0) {
        printf("붙어 있는 프로세스 수: %lu, 크기: %zu바이트\n",
               (unsigned long)shm_info.shm_nattch, shm_info.shm_segsz);
    }

    printf("\n터미널에서 확인해 보세요:\n");
    printf("  $ ipcs -m        # 공유 메모리 목록\n");
    printf("  $ ipcs -m -i %d  # 이 세그먼트 상세\n", shmid);

    /* ---------- 3. System V 세마포어 ---------- */
    printf("\n=== 3. System V 세마포어 (semget/semop) ===\n");

    int semid = semget(key, 1, IPC_CREAT | 0666);   /* 세마포어 1개짜리 집합 */
    if (semid < 0) { perror("semget"); return 1; }
    printf("semget -> semid %d (세마포어 '집합' - 여러 개를 한 번에!)\n", semid);

    union semun arg;
    arg.val = 1;
    if (semctl(semid, 0, SETVAL, arg) < 0) { perror("semctl"); return 1; }
    printf("초기값 1로 설정 (뮤텍스)\n");

    printf("현재 값: %d\n", semctl(semid, 0, GETVAL));
    sem_op(semid, -1);               /* P 연산 */
    printf("P 연산(-1) 후: %d\n", semctl(semid, 0, GETVAL));
    sem_op(semid, +1);               /* V 연산 */
    printf("V 연산(+1) 후: %d\n", semctl(semid, 0, GETVAL));

    printf("\nSEM_UNDO 플래그가 POSIX에는 없는 장점입니다:\n");
    printf("  락을 잡은 채 프로세스가 죽어도 커널이 자동으로 되돌려 줍니다.\n");
    printf("  (POSIX 세마포어는 이 경우 영원히 잠긴 상태가 됩니다!)\n");

    /* ---------- 4. System V 메시지 큐 ---------- */
    printf("\n=== 4. System V 메시지 큐 (msgget/msgsnd) ===\n");

    int msqid = msgget(key, IPC_CREAT | 0666);
    if (msqid < 0) { perror("msgget"); return 1; }
    printf("msgget -> msqid %d\n", msqid);

    /* System V 메시지는 첫 멤버가 반드시 long 타입 (메시지 '타입') */
    struct my_msg {
        long mtype;                  /* 1 이상. 0은 못 씀 */
        char mtext[64];
    } msg;
    memset(&msg, 0, sizeof(msg));    /* mtext 전체를 보내니 뒷부분도 채워 둔다 */

    msg.mtype = 100;
    strcpy(msg.mtext, "타입 100번 메시지");
    msgsnd(msqid, &msg, sizeof(msg.mtext), 0);

    msg.mtype = 200;
    strcpy(msg.mtext, "타입 200번 메시지");
    msgsnd(msqid, &msg, sizeof(msg.mtext), 0);

    printf("타입 100, 200 두 개를 보냈습니다.\n");

    /* msgrcv의 네 번째 인자로 '원하는 타입'을 지정 - POSIX에는 없는 기능! */
    struct my_msg got;
    if (msgrcv(msqid, &got, sizeof(got.mtext), 200, 0) > 0) {
        printf("타입 200만 콕 집어 수신: %s\n", got.mtext);
        printf("-> 우선순위가 아니라 '타입 선택'. 다중화에 유용합니다\n");
        printf("   (예: 클라이언트 PID를 타입으로 써서 응답을 구분)\n");
    }
    msgrcv(msqid, &got, sizeof(got.mtext), 0, 0);    /* 나머지도 비우기 */

    /* ---------- 5. 정리: 이게 진짜 중요합니다 ---------- */
    printf("\n=== 5. 정리 (안 하면 재부팅까지 남습니다!) ===\n");

    shmdt(shm);
    shmctl(shmid, IPC_RMID, NULL);   /* 공유 메모리 제거 */
    semctl(semid, 0, IPC_RMID);      /* 세마포어 제거 */
    msgctl(msqid, IPC_RMID, NULL);   /* 메시지 큐 제거 */
    printf("IPC_RMID로 세 가지 모두 제거 완료\n");

    printf("\n잊었을 때를 대비한 명령:\n");
    printf("  $ ipcs              # 내 IPC 자원 전체 보기\n");
    printf("  $ ipcrm -m <shmid>  # 공유 메모리 삭제\n");
    printf("  $ ipcrm -s <semid>  # 세마포어 삭제\n");
    printf("  $ ipcrm -q <msqid>  # 메시지 큐 삭제\n");

    /* ---------- 6. 비교표 ---------- */
    printf("\n=== 6. System V vs POSIX ===\n");
    printf("+-------------+-------------------+---------------------+\n");
    printf("|             | System V          | POSIX               |\n");
    printf("+-------------+-------------------+---------------------+\n");
    printf("| 식별자      | key_t (ftok)      | \"/이름\" 문자열      |\n");
    printf("| 공유 메모리 | shmget/shmat      | shm_open/mmap       |\n");
    printf("| 세마포어    | semget/semop      | sem_open/sem_wait   |\n");
    printf("| 메시지 큐   | msgget/msgsnd     | mq_open/mq_send     |\n");
    printf("| 확인 명령   | ipcs / ipcrm      | ls /dev/shm, /dev/mqueue |\n");
    printf("| 메시지 선택 | 타입 지정 가능    | 우선순위 순서       |\n");
    printf("| 죽었을 때   | SEM_UNDO로 복원   | 복원 없음           |\n");
    printf("| select/poll | 불가              | 가능 (fd니까!)      |\n");
    printf("+-------------+-------------------+---------------------+\n");
    printf("\n권장: 새 코드는 POSIX. 단, 죽는 프로세스가 걱정되면 SEM_UNDO 고려\n");
    return 0;
}
$ gcc -Wall -Wextra -std=gnu11 -g examples/sysv_ipc.c -o build/sysv_ipc
$ ./build/sysv_ipc
=== 1. 키(key) 만들기: ftok ===
ftok("/tmp", 'W') -> 0x57000001
(경로의 inode 번호가 섞이므로 경로가 존재해야 합니다!)
주의: 파일이 지워졌다 다시 생기면 inode가 바뀌어 키도 바뀝니다

=== 2. System V 공유 메모리 (shmget/shmat) ===
shmget -> shmid 101810190  (POSIX의 fd에 해당)
shmat  -> 주소 0x72c599713000에 붙음
부모가 쓴 내용: System V 공유 메모리 테스트
[자식] 같은 메모리에서 읽음: System V 공유 메모리 테스트
자식이 고친 뒤: 자식이 고쳐 씀!
붙어 있는 프로세스 수: 1, 크기: 256바이트

터미널에서 확인해 보세요:
  $ ipcs -m        # 공유 메모리 목록
  $ ipcs -m -i 101810190  # 이 세그먼트 상세

=== 3. System V 세마포어 (semget/semop) ===
semget -> semid 13 (세마포어 '집합' - 여러 개를 한 번에!)
초기값 1로 설정 (뮤텍스)
현재 값: 1
P 연산(-1) 후: 0
V 연산(+1) 후: 1
...

=== 4. System V 메시지 큐 (msgget/msgsnd) ===
msgget -> msqid 24
타입 100, 200 두 개를 보냈습니다.
타입 200만 콕 집어 수신: 타입 200번 메시지
-> 우선순위가 아니라 '타입 선택'. 다중화에 유용합니다
   (예: 클라이언트 PID를 타입으로 써서 응답을 구분)

=== 5. 정리 (안 하면 재부팅까지 남습니다!) ===
IPC_RMID로 세 가지 모두 제거 완료
...
코드 읽기 포인트
0x57000001:ftok은 프로젝트 ID'W'(ASCII 0x57)를 맨 앞 바이트에,/tmp의 장치 번호와 inode 번호 일부를 뒤에 섞어 키를 만듭니다. 같은 경로와 같은 글자를 쓰는 두 프로그램은 같은 키를 얻습니다. 그것이 “남남끼리 만나는” 방법입니다.shmid 101810190: 커널이 붙인 번호로, 실행마다 다르고 재부팅 후에는 작아집니다.semid 13,msqid 24도 마찬가지입니다.memset(&msg, 0, ...): 이 줄이 없으면 valgrind가 “msgsnd에 초기화되지 않은 바이트를 넘긴다”고 경고합니다.mtext[64]중 문자열 뒤의 빈칸이 쓰레기 값이기 때문입니다. 64바이트 전체를 보내니 전체를 초기화합니다.sizeof(msg.mtext):msgsnd와msgrcv의 크기 인자는 구조체 전체가 아니라mtype을 뺀 본문 크기입니다. System V의 오래된 관습입니다.
9.1 ftok: 경로를 키로
key_t key = ftok(KEY_PATH, 'W');
ftok은 경로의 inode 번호와 프로젝트 ID를 섞어 키를 만듭니다. 여기에 함정이 있습니다. 경로가 존재해야 하고, 그 파일이 지워졌다 다시 생기면 inode가 바뀌어 키도 바뀝니다. 로그 파일 경로를 ftok에 썼다가 로그 회전(오래된 로그를 지우고 새로 만드는 작업) 후 통신이 끊기는 사고가 실제로 있습니다. 안정적인 경로(/tmp 같은 디렉터리나 실행 파일 자신)를 쓰세요.
9.2 SEM_UNDO: POSIX에 없는 장점
sb.sem_flg = SEM_UNDO; /* 프로세스가 죽으면 자동 복원! */
System V 세마포어의 결정적 장점입니다. 락을 잡은 채 프로세스가 죽으면 커널이 자동으로 되돌려 줍니다. 6.2절에서 POSIX 세마포어의 post를 잊고 죽은 자식 때문에 부모가 영원히 멈추는 것을 봤습니다. SEM_UNDO가 있으면 커널이 “이 프로세스가 -1 한 것이 있으니 죽을 때 +1 해 두자”고 기록해 두었다가 되돌립니다.
죽을 수 있는 프로세스(사용자가 강제 종료할 수 있는 프로그램)를 다룬다면 System V의 SEM_UNDO가 실용적인 선택일 수 있습니다. POSIX에서 같은 효과를 내려면 pthread의 강건 뮤텍스(robust mutex)가 필요한데, 이 강좌에서는 다루지 않습니다.
9.3 메시지 타입 선택
msgrcv(msqid, &got, sizeof(got.mtext), 200, 0); /* 타입 200만! */
POSIX 메시지 큐가 “우선순위 순서”라면, System V는 “원하는 타입만 골라 받기” 입니다. 네 번째 인자의 규칙은 이렇습니다.
| 값 | 뜻 |
|---|---|
| 0 | 타입 상관없이 맨 앞 것 |
| 양수 N | 타입이 정확히 N인 것 중 맨 앞 |
| 음수 -N | 타입이 N 이하인 것 중 가장 작은 타입 |
이것이 유용한 패턴이 있습니다. 클라이언트의 PID를 메시지 타입으로 쓰는 것이죠. 서버는 타입 1로 요청을 받고, 응답은 클라이언트 PID를 타입으로 보냅니다. 그러면 각 클라이언트가 자기 응답만 골라 받을 수 있습니다. 큐 하나로 다중화가 되는 셈이죠.
9.4 정리하지 않으면 남는다 — 직접 남겨 보기
이번 절에서 가장 중요한 부분입니다. System V IPC는 프로세스가 죽어도 사라지지 않습니다. 정말 그런지 확인해 봅시다. sysv_leak.c는 공유 메모리를 만들고 IPC_RMID 없이 그냥 끝납니다.
    key_t key = ftok("/tmp", 'L');
    int shmid = shmget(key, 4096, IPC_CREAT | 0666);
    char *p = shmat(shmid, NULL, 0);
    strcpy(p, "지우는 걸 잊었다");
    printf("shmid %d 를 만들고 그냥 종료합니다\n", shmid);
    return 0;                      /* IPC_RMID 없이 끝 */
$ ./sysv_leak
shmid 101810193 를 만들고 그냥 종료합니다
$ ipcs -m

------ 공유 메모리 세그먼트 --------
key        shmid      소유     perms      bytes      nattch     status
0x4c000001 101810193  user       666        4096       0
프로그램은 끝났는데 ipcs -m에 세그먼트가 그대로 남아 있습니다. nattch(붙어 있는 프로세스 수)가 0인데도요. 키 0x4c000001의 4c는 'L'입니다. 이것을 지우는 방법이 ipcrm입니다.
$ ipcrm -M 0x4c000001         # 키로 지우기 (-m 은 shmid 로)
$ ipcs -m | grep 0x4c000001
$
사라졌습니다. 개발 중에 프로그램을 여러 번 강제 종료하면 이런 것이 쌓여 결국 “더 이상 만들 수 없음”(ENOSPC) 오류가 납니다. 관리 명령을 알아 두세요.
ipcs              # 내 IPC 자원 전체 보기 (공유 메모리, 세마포어, 메시지 큐)
ipcs -m           # 공유 메모리만
ipcrm -m <shmid>  # 공유 메모리 삭제 (ID로)
ipcrm -M <key>    # 공유 메모리 삭제 (키로)
ipcrm -s <semid>  # 세마포어 삭제
ipcrm -q <msqid>  # 메시지 큐 삭제
ipcrm -a          # 내 것 전부 삭제 (주의!)
9.5 비교표
| System V | POSIX | |
|---|---|---|
| 식별자 | key_t (ftok) |
"/이름" 문자열 |
| 공유 메모리 | shmget/shmat |
shm_open/mmap |
| 세마포어 | semget/semop |
sem_open/sem_wait |
| 메시지 큐 | msgget/msgsnd |
mq_open/mq_send |
| 확인 | ipcs/ipcrm |
ls /dev/shm, /dev/mqueue |
| 메시지 선택 | 타입 지정 가능 | 우선순위 순서 |
| 프로세스 사망 시 | SEM_UNDO로 복원 |
복원 없음 |
select/poll |
불가 | 가능 (fd니까!) |
마지막 줄이 실무에서 큰 차이를 만듭니다. POSIX는 fd 기반이라 select/poll/epoll로 다른 이벤트와 함께 감시할 수 있습니다. 프로젝트 3에서 select를 쓰고, 21주차에서 본격적으로 다룹니다. System V는 별도의 블로킹 호출이라 통합이 어렵죠.
10. 교착 상태: 서로가 서로를 기다린다
10.1 락이 만드는 새로운 병
락을 쓰면 경쟁 조건은 해결되지만 새로운 병이 생깁니다. 1.2절에서 “부모는 자식을 기다리고 자식은 부모를 기다리는” 상황을 잠깐 봤죠. 락이 둘 이상이면 같은 일이 생깁니다.
프로세스 A: 락1을 잡고 -> 락2를 원한다
프로세스 B: 락2를 잡고 -> 락1을 원한다
-> 둘 다 영원히 대기
교착 상태(deadlock) 입니다. 그림으로 그리면 고리가 보입니다.
          잡고 있음                 기다림
   [ A ] ──────────▶ ( 락1 ) ◀──────────  [ B ]
     ▲                                      │
     │        기다림             잡고 있음   │
     └──────────── ( 락2 ) ◀────────────────┘

   A → 락2 → B → 락1 → A ...  고리가 끊기지 않는다
A는 B가 락2를 놓기를, B는 A가 락1을 놓기를 기다립니다. 둘 다 “내가 가진 것은 일이 끝나야 놓는다”이고, 일은 상대 것을 받아야 끝납니다. 화살표를 따라가면 시작점으로 돌아옵니다. 이 고리가 교착의 정체입니다.
examples/deadlock.c:
/*
 * deadlock.c - 교착 상태: 서로가 서로를 기다린다
 * 19주차: IPC와 동기화
 *
 * 락을 쓰면 경쟁 조건은 해결되지만 새로운 병이 생깁니다 - 교착 상태.
 *
 *   프로세스 A: 락1을 잡고 -> 락2를 원한다
 *   프로세스 B: 락2를 잡고 -> 락1을 원한다
 *   -> 둘 다 영원히 대기. 아무도 진행하지 못한다.
 *
 * 교착 상태의 4가지 필요조건 (코프만 조건):
 *   1. 상호 배제 : 자원을 한 번에 하나만 쓸 수 있다
 *   2. 점유와 대기: 뭔가를 든 채로 다른 것을 기다린다
 *   3. 비선점    : 남이 든 것을 뺏을 수 없다
 *   4. 순환 대기 : A는 B를, B는 A를 기다리는 고리
 *
 * 넷 중 '하나만' 깨면 교착이 사라집니다. 보통 4번(순환)을 깹니다.
 *
 * 이 예제는 교착을 실제로 만들어 보고(타임아웃으로 탈출),
 * 락 순서를 통일해 해결합니다.
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <semaphore.h>
#include <sys/mman.h>
#include <sys/wait.h>
#include <time.h>
#include <errno.h>

typedef struct {
    sem_t lock_a;
    sem_t lock_b;
    int   progress;                  /* 몇 명이 일을 끝냈나 */
} Shared;

/* 제한 시간 안에 락을 못 잡으면 포기 (교착 탐지용) */
static int try_lock(sem_t *s, int seconds) {
    struct timespec ts;
    clock_gettime(CLOCK_REALTIME, &ts);
    ts.tv_sec += seconds;
    return sem_timedwait(s, &ts);    /* 실패 시 -1, errno = ETIMEDOUT */
}

int main(void) {
    Shared *sh = mmap(NULL, sizeof(Shared), PROT_READ | PROT_WRITE,
                      MAP_SHARED | MAP_ANONYMOUS, -1, 0);
    if (sh == MAP_FAILED) { perror("mmap"); return 1; }

    /* ---------- 1. 교착 상태 만들기 ---------- */
    printf("=== 1. 교착 상태 재현 ===\n");
    printf("일꾼 두 명이 자원 A와 B를 '반대 순서로' 잡습니다.\n\n");

    sem_init(&sh->lock_a, 1, 1);
    sem_init(&sh->lock_b, 1, 1);
    sh->progress = 0;

    fflush(stdout);                  /* fork 전 버퍼 비우기 (18주차 규칙!) */
    pid_t p1 = fork();
    if (p1 == 0) {
        printf("  [일꾼1] A 잡는 중...\n");   fflush(stdout);
        sem_wait(&sh->lock_a);
        printf("  [일꾼1] A 획득! 이제 B가 필요하다\n"); fflush(stdout);

        usleep(200000);              /* 상대가 B를 잡을 시간을 준다 */

        printf("  [일꾼1] B 잡는 중... (최대 2초 대기)\n"); fflush(stdout);
        if (try_lock(&sh->lock_b, 2) < 0) {
            printf("  [일꾼1] 2초 타임아웃! B를 못 잡았다 (errno=%d)\n", errno);
            sem_post(&sh->lock_a);
            _exit(1);
        }
        sh->progress++;
        sem_post(&sh->lock_b);
        sem_post(&sh->lock_a);
        _exit(0);
    }

    fflush(stdout);
    pid_t p2 = fork();
    if (p2 == 0) {
        printf("  [일꾼2] B 잡는 중...\n");   fflush(stdout);
        sem_wait(&sh->lock_b);       /* 순서가 반대! */
        printf("  [일꾼2] B 획득! 이제 A가 필요하다\n"); fflush(stdout);

        usleep(200000);

        printf("  [일꾼2] A 잡는 중... (최대 2초 대기)\n"); fflush(stdout);
        if (try_lock(&sh->lock_a, 2) < 0) {
            printf("  [일꾼2] 2초 타임아웃! A를 못 잡았다 (errno=%d)\n", errno);
            sem_post(&sh->lock_b);
            _exit(1);
        }
        sh->progress++;
        sem_post(&sh->lock_a);
        sem_post(&sh->lock_b);
        _exit(0);
    }

    int st1, st2;
    waitpid(p1, &st1, 0);
    waitpid(p2, &st2, 0);

    printf("\n  일을 끝낸 사람: %d명 / 2명\n", sh->progress);
    if (sh->progress < 2) {
        printf("  -> 교착! 타임아웃이 없었다면 둘 다 영원히 멈췄을 겁니다.\n");
        printf("     (실제 서비스에서는 프로세스가 '응답 없음'으로 보입니다)\n");
    }

    sem_destroy(&sh->lock_a);
    sem_destroy(&sh->lock_b);

    /* ---------- 2. 해결: 락 순서 통일 ---------- */
    printf("\n=== 2. 해결책: 락 획득 순서를 통일한다 ===\n");
    printf("둘 다 'A 먼저, B 나중' 순서를 지키게 하면?\n\n");

    sem_init(&sh->lock_a, 1, 1);
    sem_init(&sh->lock_b, 1, 1);
    sh->progress = 0;

    for (int i = 1; i <= 2; i++) {
        fflush(stdout);
        pid_t pid = fork();
        if (pid == 0) {
            printf("  [일꾼%d] A 잡는 중...\n", i); fflush(stdout);
            sem_wait(&sh->lock_a);               /* 언제나 A 먼저! */
            printf("  [일꾼%d] A 획득\n", i);    fflush(stdout);

            usleep(100000);

            printf("  [일꾼%d] B 잡는 중...\n", i); fflush(stdout);
            sem_wait(&sh->lock_b);               /* 그 다음 B */
            printf("  [일꾼%d] B 획득! 작업 완료\n", i); fflush(stdout);

            sh->progress++;

            sem_post(&sh->lock_b);               /* 놓을 땐 역순이 관례 */
            sem_post(&sh->lock_a);
            _exit(0);
        }
        usleep(50000);
    }
    while (wait(NULL) > 0) { }

    printf("\n  일을 끝낸 사람: %d명 / 2명 -> 교착 없음!\n", sh->progress);
    printf("  순환 고리가 생길 수 없으니 (모두 A->B 방향) 교착이 불가능합니다.\n");

    sem_destroy(&sh->lock_a);
    sem_destroy(&sh->lock_b);
    munmap(sh, sizeof(Shared));

    /* ---------- 3. 예방 전략 ---------- */
    printf("\n=== 3. 교착 예방 전략 ===\n");
    printf("1. 락 순서 통일 (가장 실용적)\n");
    printf("   모든 코드가 같은 순서로 잡으면 순환이 생길 수 없다\n");
    printf("   예: 주소값 순, 계좌번호 순, ID 순\n");
    printf("2. 한 번에 전부 잡기 (점유와 대기 깨기)\n");
    printf("   필요한 락을 모두 확보하지 못하면 가진 것도 놓고 재시도\n");
    printf("3. 타임아웃 (비선점 깨기)\n");
    printf("   sem_timedwait로 일정 시간 후 포기 - 이 예제가 쓴 방법\n");
    printf("4. 락 자체를 줄이기 (근본 해결)\n");
    printf("   불변 데이터, 메시지 전달, 원자적 연산으로 설계\n");

    printf("\n=== 4. 교착의 사촌들 ===\n");
    printf("라이브락(livelock): 서로 양보하다 진행을 못 함\n");
    printf("  (좁은 복도에서 서로 비켜주다 계속 마주치는 상황)\n");
    printf("기아(starvation)  : 특정 프로세스만 계속 자원을 못 받음\n");
    printf("  (우선순위가 낮아 항상 뒤로 밀리는 경우)\n");
    printf("-> 셋 다 '진행을 못 한다'는 점은 같지만 원인이 다릅니다\n");
    return 0;
}

교착 상태와 회피
$ gcc -Wall -Wextra -std=gnu11 -g examples/deadlock.c -o build/deadlock -pthread
$ ./build/deadlock
=== 1. 교착 상태 재현 ===
일꾼 두 명이 자원 A와 B를 '반대 순서로' 잡습니다.

  [일꾼1] A 잡는 중...
  [일꾼1] A 획득! 이제 B가 필요하다
  [일꾼2] B 잡는 중...
  [일꾼2] B 획득! 이제 A가 필요하다
  [일꾼1] B 잡는 중... (최대 2초 대기)
  [일꾼2] A 잡는 중... (최대 2초 대기)

  일을 끝낸 사람: 1명 / 2명
  -> 교착! 타임아웃이 없었다면 둘 다 영원히 멈췄을 겁니다.
     (실제 서비스에서는 프로세스가 '응답 없음'으로 보입니다)

=== 2. 해결책: 락 획득 순서를 통일한다 ===
둘 다 'A 먼저, B 나중' 순서를 지키게 하면?

  [일꾼1] A 잡는 중...
  [일꾼1] A 획득
  [일꾼2] A 잡는 중...
  [일꾼1] B 잡는 중...
  [일꾼1] B 획득! 작업 완료
  [일꾼2] A 획득
  [일꾼2] B 잡는 중...
  [일꾼2] B 획득! 작업 완료

  일을 끝낸 사람: 2명 / 2명 -> 교착 없음!
  순환 고리가 생길 수 없으니 (모두 A->B 방향) 교착이 불가능합니다.
...
1번에서 “일을 끝낸 사람: 1명”입니다. 두 일꾼 모두 2초를 기다린 뒤 타임아웃이 났고, errno=110(ETIMEDOUT) 메시지가 화면에 없는 이유는 그 줄에 fflush가 없는 상태에서 _exit(1)로 끝났기 때문입니다(3.1절과 같은 이유). 한 명이 포기하며 자기 락을 놓자, 그 순간 다른 한 명의 try_lock이 성공해서 그 사람은 일을 끝낼 수 있었습니다. 그래서 0명이 아니라 1명입니다. 타임아웃 덕에 살아난 것이지, 교착이 안 생긴 것이 아닙니다.
10.2 타임아웃이 없으면 — 직접 멈춰 보기
try_lock 대신 그냥 sem_wait을 쓰는 deadlock_forever.c입니다.
    if (fork() == 0) {
        sem_wait(&L->a); printf("[1] A 획득\n"); fflush(stdout);
        usleep(100000);
        printf("[1] B 기다림...\n"); fflush(stdout);
        sem_wait(&L->b);           /* 타임아웃 없음 */
        printf("[1] B 획득 (여기 못 온다)\n");
        _exit(0);
    }
    if (fork() == 0) {
        sem_wait(&L->b); printf("[2] B 획득\n"); fflush(stdout);
        usleep(100000);
        printf("[2] A 기다림...\n"); fflush(stdout);
        sem_wait(&L->a);
        printf("[2] A 획득 (여기 못 온다)\n");
        _exit(0);
    }
멈춘 상태에서 프로세스들이 무엇을 하고 있는지 보려고, 실행 중에 다른 터미널에서 ps를 찍었습니다.
$ timeout 4 ./deadlock_forever &
[1] A 획득
[2] B 획득
[1] B 기다림...
[2] A 기다림...
$ ps -o pid,stat,wchan:22,cmd -C deadlock_forever
    PID STAT WCHAN                  CMD
 324588 S    do_wait                ./deadlock_forever
 324589 S    futex_do_wait          ./deadlock_forever
 324590 S    futex_do_wait          ./deadlock_forever
[1]+  나감 124              timeout 4 ./deadlock_forever
세 프로세스 모두 STAT이 S(sleeping, 잠듦)입니다. WCHAN(wait channel, 커널 안에서 무엇을 기다리는지)을 보면 부모는 do_wait(자식을 기다림), 두 자식은 futex_do_wait (세마포어를 기다림)입니다. CPU는 0%이고 아무도 깨워 주지 않습니다. 4초 뒤 timeout이 죽여서 124가 나왔습니다. 실제 서비스라면 “응답 없음”으로 영원히 남습니다. 프로그램이 멈췄을 때 ps로 WCHAN을 보는 것은 원인을 좁히는 좋은 첫 단계입니다. futex가 보이면 락, anon_pipe_read가 보이면 1.2절의 파이프 문제입니다.
10.3 교착의 네 가지 필요조건
교착이 일어나려면 네 조건이 모두 만족되어야 합니다(1971년 코프만이 정리해서 코프만 조건이라고 부릅니다).
| # | 조건 | 위 예제에서 |
|---|---|---|
| 1 | 상호 배제: 자원을 한 번에 하나만 쓸 수 있다 | 세마포어 초기값이 1 |
| 2 | 점유와 대기: 뭔가를 든 채로 다른 것을 기다린다 | A를 든 채 B를 기다림 |
| 3 | 비선점: 남이 든 것을 뺏을 수 없다 | 커널이 세마포어를 강제로 빼앗지 않음 |
| 4 | 순환 대기: A는 B를, B는 A를 기다리는 고리 | 10.1절의 그림 |
그리고 넷 중 하나만 깨면 교착이 사라집니다. 이것이 예방 전략의 출발점입니다.
10.4 가장 실용적인 해법: 락 순서 통일
실무에서 가장 많이 쓰는 방법은 4번(순환 대기)을 깨는 것입니다.
            sem_wait(&sh->lock_a);               /* 언제나 A 먼저! */
            ...
            sem_wait(&sh->lock_b);               /* 그 다음 B */
            ...
            sem_post(&sh->lock_b);               /* 놓을 땐 역순이 관례 */
            sem_post(&sh->lock_a);
모든 코드가 같은 순서로 락을 잡으면 순환 고리가 생길 수 없습니다. 모두 A→B 방향이니 “A를 기다리는 사람이 B를 들고 있는” 상황이 불가능하죠. 예제 2번 출력을 보면 일꾼2는 A를 잡으려다 일꾼1이 다 끝낼 때까지 기다렸다가 진행합니다. 기다리긴 하지만 끝은 납니다.
순서를 정하는 기준은 무엇이든 됩니다. 일관되기만 하면 됩니다.
- 락의 메모리 주소 순
- 계좌번호, 사용자 ID 순
- 락에 붙인 번호 순
계좌 이체 예제가 고전적입니다.
/* 잘못된 코드: A->B 이체와 B->A 이체가 동시에 일어나면 교착 */
void transfer(Account *from, Account *to, int amount) {
    lock(from); lock(to);
    ...
}

/* 올바른 코드: 항상 번호가 작은 계좌부터 */
void transfer(Account *from, Account *to, int amount) {
    Account *first  = (from->id < to->id) ? from : to;
    Account *second = (from->id < to->id) ? to : from;
    lock(first); lock(second);
    ...
}
10.5 나머지 세 가지 전략
한 번에 전부 잡기 (점유와 대기 깨기): 필요한 락을 모두 확보하지 못하면 가진 것도 놓고 재시도합니다. sem_trywait으로 두 번째 락을 시도하고, 실패하면 첫 락을 놓고 처음부터 다시 합니다. 구현이 복잡하지만 확실합니다.
타임아웃 (비선점 깨기): sem_timedwait으로 일정 시간 후 포기합니다. 이 예제가 쓴 방법이죠.
static int try_lock(sem_t *s, int seconds) {
    struct timespec ts;
    clock_gettime(CLOCK_REALTIME, &ts);
    ts.tv_sec += seconds;
    return sem_timedwait(s, &ts);    /* 실패 시 -1, errno = ETIMEDOUT */
}
sem_timedwait의 두 번째 인자는 “몇 초 기다릴지”가 아니라 “몇 시 몇 분까지 기다릴지” 라는 절대 시각입니다. 그래서 CLOCK_REALTIME으로 현재 시각을 읽어 seconds를 더합니다. 교착을 예방하지는 못하지만 탐지하고 탈출할 수 있습니다. 최후의 안전장치로 유용합니다.
락 자체를 줄이기 (근본 해결): 불변 데이터, 메시지 전달(8절의 메시지 큐), 원자적 연산으로 설계를 바꿉니다. 가장 좋은 해법이지만 설계 단계에서만 가능하죠.
10.6 교착의 사촌들
비슷하지만 다른 문제들도 알아 두세요.
- 라이브락(livelock): 서로 양보하다 진행을 못 함. 좁은 복도에서 서로 비켜주다 계속 마주치는 상황입니다. 프로세스는 열심히 일하는데(CPU를 씀) 아무 진전이 없죠. 10.5절의 “한 번에 전부 잡기”를 잘못 구현하면(둘 다 동시에 놓고 동시에 다시 시도) 생깁니다
- 기아(starvation): 특정 프로세스만 계속 자원을 못 받음. 우선순위가 낮아 항상 뒤로 밀리는 경우입니다. 8.2절에서 우선순위 높은 메시지가 계속 들어오면 우선순위 1인 메시지는 영영 처리되지 않는 것이 그 예입니다
셋 다 “진행을 못 한다”는 점은 같지만 원인이 다릅니다. 교착은 멈춰 있고(CPU 0%, 10.2절의 S 상태), 라이브락은 바쁘게 헛돌고(CPU 100%), 기아는 일부만 손해를 봅니다.
11. 실습 프로젝트
projects/ 폴더에는 이번 주 기술을 실제 시스템처럼 묶은 세 프로그램이 있습니다. 전체 코드는 각각 250~360줄이라 글에는 핵심 부분만 싣습니다. 파일을 열어 놓고 읽으세요.
$ cd week19
$ make
$ ./build/producer_consumer    # 또는 shm_cache, work_queue
프로젝트 1: 생산자-소비자 시스템 (producer_consumer.c)
동시성 프로그래밍의 “Hello World”입니다. 생산자가 데이터를 만들어 버퍼에 넣고, 소비자가 꺼내 처리합니다. 풀어야 할 문제가 셋입니다.
- 버퍼가 가득 차면 생산자는 기다려야 한다
- 버퍼가 비면 소비자는 기다려야 한다
- 둘이 동시에 버퍼를 건드리면 안 된다
해법은 세마포어 세 개입니다. 6절에서 배운 두 종류(뮤텍스, 세는 세마포어)를 함께 씁니다.
#define BUFFER_SIZE 5            /* 일부러 작게: 가득 참/빔을 관찰하려고 */

typedef struct {
    sem_t empty;                 /* 빈 칸 개수 */
    sem_t full;                  /* 찬 칸 개수 */
    sem_t mutex;                 /* 버퍼 상호 배제 */
    sem_t stat_lock;             /* 통계 상호 배제 */

    Item buffer[BUFFER_SIZE];
    int  in;                     /* 다음에 넣을 위치 */
    int  out;                    /* 다음에 꺼낼 위치 */

    int  produced;               /* 통계 */
    int  consumed;
    int  max_fill;               /* 관측된 최대 적재량 */
} Shared;
| 세마포어 | 초기값 | 의미 | 종류 |
|---|---|---|---|
empty |
버퍼 크기(5) | 빈 칸 수. 생산자가 기다리는 대상 | 세는 세마포어 |
full |
0 | 찬 칸 수. 소비자가 기다리는 대상 | 세는 세마포어 |
mutex |
1 | 버퍼 접근 상호 배제 | 뮤텍스 |
생산자의 핵심은 이 순서입니다.
        /* 1) 빈 칸을 하나 확보한다 (없으면 여기서 기다린다!) */
        sem_wait(&sh->empty);

        /* 2) 버퍼를 독점해서 넣는다 */
        sem_wait(&sh->mutex);
        sh->buffer[sh->in] = item;
        sh->in = (sh->in + 1) % BUFFER_SIZE;      /* 링 버퍼: 끝나면 처음으로 */
        sem_post(&sh->mutex);

        /* 3) 찬 칸이 하나 늘었다고 알린다 (자고 있던 소비자를 깨운다) */
        sem_post(&sh->full);
소비자는 full과 empty의 자리가 바뀐 거울상입니다. 실제 파일에서는 sem_wait(&sh->empty) 앞에 sem_trywait으로 “지금 꽉 찼는지”를 먼저 확인해서 “대기” 줄을 찍는 코드가 붙어 있습니다. 관찰용이고 동작에는 영향이 없습니다.
$ ./build/producer_consumer
╔══════════════════════════════════════════════╗
║      생산자-소비자 시스템 (세마포어 3종)     ║
╚══════════════════════════════════════════════╝
버퍼 크기 5 | 생산자 3명 | 소비자 1명 | 총 항목 15개

  생산자1     넣음 [#....] 1/5  (항목 1000)
  생산자2     넣음 [##...] 2/5  (항목 2000)
  생산자3     넣음 [###..] 3/5  (항목 3000)
  소비자1     꺼냄 [##...] 2/5  (항목 1000)
  생산자1     넣음 [###..] 3/5  (항목 1001)
  생산자2     넣음 [####.] 4/5  (항목 2001)
  생산자3     넣음 [#####] 5/5  (항목 3001)
  생산자1     대기 [#####] 5/5  <- 가득참! 소비자를 기다린다
  생산자2     대기 [#####] 5/5  <- 가득참! 소비자를 기다린다
  생산자3     대기 [#####] 5/5  <- 가득참! 소비자를 기다린다
  소비자1     꺼냄 [####.] 4/5  (항목 2000)
  생산자1     넣음 [#####] 5/5  (항목 1002)
  생산자1     대기 [#####] 5/5  <- 가득참! 소비자를 기다린다
  ...
  소비자1     꺼냄 [#....] 1/5  (항목 2004)
  소비자1     꺼냄 [.....] 0/5  (항목 3004)

═══════════════ 결과 ═══════════════
생산: 15개 / 소비: 15개  -> 일치! 유실도 중복도 없음
관측된 최대 적재량: 5 / 5
소요 시간: 3756 ms
종료 시 세마포어: empty=5, full=0 (합이 5면 정상)
...
생산자가 빠르고 소비자가 느리면 버퍼가 가득 차고, 생산자들이 줄줄이 대기합니다. 그리고 소비자가 하나 꺼낼 때마다 한 명씩 깨어나죠. 흐름 제어가 저절로 이루어지는 것입니다. 1.4절의 파이프 버퍼가 하던 일을 우리가 세마포어로 직접 만든 셈입니다. 항목 번호가 1000, 2000, 3000 순으로 소비되는 것도 보세요. 넣은 순서대로 나오는 링 버퍼입니다.
① empty와 full은 짝이다
/* 생산 */
sem_wait(&sh->empty);     /* 빈 칸 하나 확보 */
   ... 버퍼에 넣기 ...
sem_post(&sh->full);      /* 찬 칸 하나 증가 */

/* 소비 */
sem_wait(&sh->full);      /* 찬 칸 하나 확보 */
   ... 버퍼에서 꺼내기 ...
sem_post(&sh->empty);     /* 빈 칸 하나 증가 */
빈 칸을 찬 칸으로, 찬 칸을 빈 칸으로 변환하는 구조입니다. 그래서 두 값의 합은 항상 버퍼 크기로 유지됩니다. 출력의 마지막 줄(empty=5, full=0)이 그 검증입니다.
② 순서가 생명이다 — 직접 교착시켜 보기
sem_wait(&sh->empty);     /* 1. 자원 세마포어 먼저 */
sem_wait(&sh->mutex);     /* 2. 뮤텍스 나중 */
이 순서를 뒤집으면 교착입니다. 말로 설명하기보다 직접 해 봅시다. pc_wrong_order.c는 버퍼 3칸에, 생산자가 뮤텍스를 먼저 잡고, 소비자는 0.1초마다 하나씩 꺼내는 작은 버전입니다.
    if (fork() == 0) {                     /* 생산자: 빠르게 10개 */
        for (int i = 0; i < 10; i++) {
            sem_wait(&sh->mutex);          /* 뮤텍스 먼저! (틀린 순서) */
            sem_wait(&sh->empty);
            sh->buf[sh->in] = i; sh->in = (sh->in + 1) % N;
            printf("[생산] %d 넣음\n", i); fflush(stdout);
            sem_post(&sh->mutex);
            sem_post(&sh->full);
        }
        _exit(0);
    }
    if (fork() == 0) {                     /* 소비자: 느리게 */
        for (int i = 0; i < 10; i++) {
            usleep(100000);
            sem_wait(&sh->full);
            sem_wait(&sh->mutex);          /* 생산자가 쥔 뮤텍스를 기다린다 */
            ...
$ timeout 5 ./pc_wrong_order
[생산] 0 넣음
[생산] 1 넣음
[생산] 2 넣음
$ echo $?
124
세 개를 넣어 버퍼가 가득 찬 순간 멈췄습니다. 무슨 일이 일어났는지 따라가 봅시다.
- 생산자가 네 번째 항목을 넣으려고 뮤텍스를 잡고
empty를 기다립니다. 빈 칸이 0이니 잠듭니다. 뮤텍스를 쥔 채로요. - 소비자가 깨어나 꺼내려고
full을 잡고(3개 있으니 성공), 그다음 뮤텍스를 기다립니다. 생산자가 들고 있으니 잠듭니다. - 소비자가 꺼내야
empty가 생기는데 소비자는 뮤텍스를 기다리고, 생산자가 뮤텍스를 놓아야 하는데 생산자는empty를 기다립니다. 10.1절의 고리입니다.
규칙: 자원 세마포어 먼저, 뮤텍스 나중. 10.4절의 “락 순서 통일”이 여기서 구체적으로 적용된 것입니다.
③ 바쁜 대기가 없다
/* 이렇게 하면 안 된다 */
while (버퍼가_비었나()) { }        /* CPU를 100% 태우며 빙빙 돈다 */

/* 세마포어는 이렇게 한다 */
sem_wait(&sh->full);               /* 커널이 재워주고, 때가 되면 깨워준다 */
sem_wait으로 잠든 프로세스는 CPU를 한 톨도 쓰지 않습니다. 10.2절의 ps에서 본 S 상태입니다. 커널이 조건이 맞을 때 깨워주죠. 이것이 동기화 도구를 쓰는 큰 이유 중 하나입니다.
④ 이 구조는 어디에 쓰이나
웹 서버의 요청 큐, 로그 수집기, 메시지 브로커(Kafka, RabbitMQ), 스레드 풀의 작업 큐. 전부 이 패턴입니다. 20주차에서 같은 것을 스레드로 만들어 비교합니다.
확장 아이디어: 버퍼 크기를 바꿔가며 처리량 측정, 생산자/소비자 비율 실험(./build/producer_consumer 2 4 8), 우선순위 큐로 교체, 종료 신호(독약 알약, poison pill) 구현
프로젝트 2: 공유 메모리 캐시 서버 (shm_cache.c)
여러 프로세스가 같은 캐시를 함께 쓰는 시스템입니다. nginx의 공유 캐시, PHP의 APCu가 이런 구조죠.
#define SLOTS   1024            /* 2의 거듭제곱 (& 마스크로 나머지 계산) */
#define STRIPES 16              /* 락을 16개로 쪼갠다 */

typedef struct {
    int  state;                  /* SlotState: EMPTY / USED / DEAD */
    char key[KEY_LEN];
    char value[VAL_LEN];
    long hits;                   /* 이 항목이 몇 번 조회됐나 */
} Slot;

typedef struct {
    sem_t big_lock;              /* 방식 A: 테이블 전체에 락 하나 */
    sem_t stripe[STRIPES];       /* 방식 B: 구역별 락 (경합 분산) */
    sem_t stat_lock;
    Slot  slot[SLOTS];
    long  gets, sets, hits, misses, evictions;
} Cache;

static int cache_set(const char *key, const char *value);
static int cache_get(const char *key, char *out, size_t out_size);
static int cache_del(const char *key);
$ ./build/shm_cache
╔══════════════════════════════════════════════╗
║        공유 메모리 캐시 서버 (19주차)        ║
╚══════════════════════════════════════════════╝
공유 메모리: /week19_shm_cache (112.6 KB, 슬롯 1024개)
확인: ls -lh /dev/shm/week19_shm_cache

=== 1. 기본 동작 (SET / GET / DEL) ===
  SET user:001 = 김철수
  SET user:002 = 이영희
  SET config:timeout = 30
  GET user:001       -> 김철수
  GET user:999       -> (없음 - miss)
  SET user:001 덮어쓰기 후 GET -> 김철수(수정)
  DEL user:002 후 GET -> (없음 - 삭제됨)

=== 2. 클라이언트 4개가 동시 접속 ===
각자 20000번 연산 (읽기 75%, 쓰기 25%, 키 500종)

  총 연산 : 80000회 (15 ms)
  조회    : 60015회 (적중 58394 / 실패 1621, 적중률 97.3%)
  저장    : 19985회
  처리량  : 5223507 연산/초

  조회가 많았던 키 상위 5개:
    1) user:094     150회 조회
    2) user:398     149회 조회
    ...

=== 3. 락 분할(lock striping)의 효과 ===
같은 작업을 락 하나 vs 락 16개로 처리해 비교합니다.

  [A] 전역 락 1개  :      55 ms  (모든 프로세스가 한 문으로)
  [B] 구역 락 16개 :      16 ms  (해시값에 따라 다른 문으로)

  -> 3.55배 빠름
...
① 왜 연결 리스트가 아니라 개방 주소법인가
13주차에서 해시 테이블을 만들 때 체이닝(연결 리스트)을 먼저 배웠습니다. 그런데 여기서는 개방 주소법을 씁니다. 7.5절에서 본 이유 때문이죠.
공유 메모리에는 포인터를 저장할 수 없다.
프로세스마다 mmap 주소가 다르니 next 포인터가 무의미합니다. 배열 인덱스만 쓰는 개방 주소법이 정답입니다. 그리고 13주차에서 배운 묘비(tombstone) 가 여기서도 그대로 필요합니다.
        if (s->state == SLOT_DEAD) {
            if (first_dead == SLOTS) first_dead = idx;
            continue;                                /* 13주차 묘비 규칙! */
        }
② 왜 문자열도 고정 크기 배열인가
Slot의 key와 value가 char *가 아니라 char[32], char[64]입니다. malloc으로 잡은 메모리는 그 프로세스의 것이라서, 공유 메모리 안의 데이터는 전부 값으로 들어 있어야 합니다. 메모리는 좀 낭비되지만(슬롯 하나가 112바이트, 1024개면 112.6KB) 다른 방법이 없습니다.
③ 락 분할(lock striping)
이 프로젝트의 하이라이트입니다. 전역 락 하나 대신 락 16개를 두고, 해시값에 따라 다른 락을 씁니다.
static void lock_for(unsigned long h) {
    if (use_striping) sem_wait(&cache->stripe[h % STRIPES]);
    else              sem_wait(&cache->big_lock);
}
결과는 3.55배입니다(같은 명령을 bench만으로 다시 돌리면 91ms 대 31ms, 2.91배가 나왔습니다. 벤치마크라 실행마다 다르지만 3배 안팎으로 일정합니다). 이유는 단순합니다. 서로 다른 구역을 건드리는 연산끼리는 기다릴 이유가 없기 때문이죠. 전역 락은 “모두가 한 문으로”, 구역 락은 “해시값에 따라 다른 문으로”입니다. 클라이언트 4개가 키 500종을 무작위로 건드리니, 같은 구역에서 부딪힐 확률은 대략 16분의 1입니다.
자바의 ConcurrentHashMap, 리눅스 커널의 여러 자료구조가 이 기법을 씁니다. 물론 공짜는 아닙니다. 테이블 전체를 훑는 연산(전체 삭제, 정확한 통계)은 락 16개를 모두 잡아야 해서 오히려 복잡해집니다. 그리고 그때는 10.4절의 순서 규칙을 지켜야 하죠(항상 0번부터 15번 순으로). 이 프로젝트의 통계 카운터가 별도의 stat_lock을 쓰는 것도 그래서입니다.
④ 더 나아가려면
읽기가 압도적으로 많다면 읽기-쓰기 락이 유리합니다. 읽기끼리는 서로 기다릴 필요가 없으니까요. 이 프로젝트는 읽기 75%인데도 읽기끼리 서로 막고 있습니다. 20주차 pthread_rwlock에서 다룹니다.
확장 아이디어: LRU 축출(가장 오래 안 쓴 항목 삭제), TTL(유효 기간), 읽기-쓰기 락으로 교체, STRIPES 수를 1, 4, 16, 64로 바꿔가며 최적점 찾기
프로젝트 3: 멀티프로세스 워커 풀 (work_queue.c)
웹 서버, 빌드 시스템(make -j), 이미지 변환 배치. 전부 이 구조입니다. 파이프(1절), dup2 없이 fd를 직접 주고받는 방식, select, 그리고 18주차의 read 교훈이 한꺼번에 들어갑니다.
마스터 ─┬─ 파이프 ─> 워커1 ─ 파이프 ─┐
        ├─ 파이프 ─> 워커2 ─ 파이프 ─┼─> 결과 수집
        └─ 파이프 ─> 워커3 ─ 파이프 ─┘
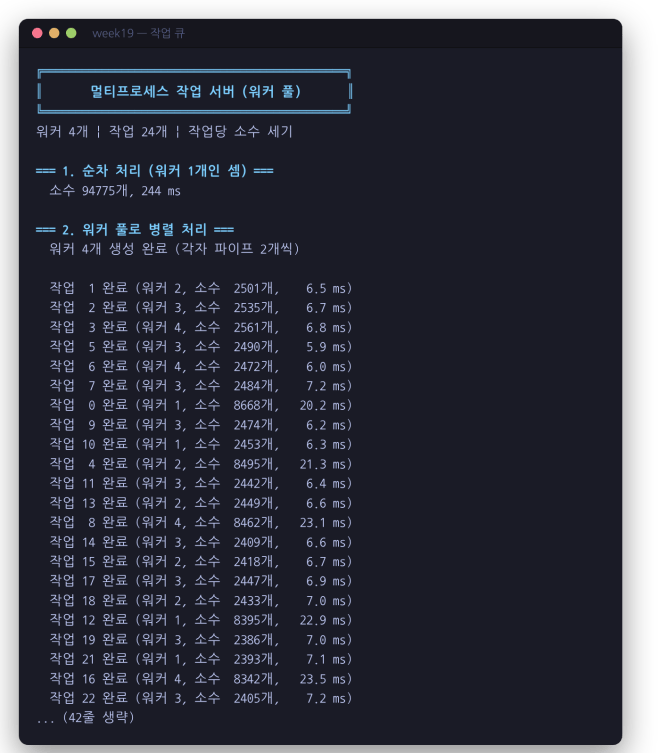
작업 큐
typedef struct { int id; long from, to; int stop; } Task;      /* 마스터 -> 워커 */
typedef struct { int task_id, worker_id; long primes; double ms; } Result;

typedef struct {
    pid_t pid;
    int   to_worker;             /* 마스터가 쓰는 끝 */
    int   from_worker;           /* 마스터가 읽는 끝 */
    int   busy;
    int   done_count;
} Worker;

static int  read_exact(int fd, void *buf, size_t n);   /* 정확히 n바이트 */
static void worker_loop(int id, int in_fd, int out_fd);
$ ./build/work_queue
╔══════════════════════════════════════════════╗
║       멀티프로세스 작업 서버 (워커 풀)       ║
╚══════════════════════════════════════════════╝
워커 4개 | 작업 24개 | 작업당 소수 세기

=== 1. 순차 처리 (워커 1개인 셈) ===
  소수 94775개, 254 ms

=== 2. 워커 풀로 병렬 처리 ===
  워커 4개 생성 완료 (각자 파이프 2개씩)

  작업  1 완료 (워커 2, 소수  2501개,    6.5 ms)
  작업  3 완료 (워커 4, 소수  2561개,    6.8 ms)
  작업  2 완료 (워커 3, 소수  2535개,   10.5 ms)
  작업  5 완료 (워커 4, 소수  2490개,    5.9 ms)
  ...
  작업  0 완료 (워커 1, 소수  8668개,   24.1 ms)
  ...
  작업 20 완료 (워커 3, 소수  8254개,   28.9 ms)

═══════════════ 결과 ═══════════════
검증  : 순차 94775개 vs 병렬 94775개  -> 일치!
순차  :     254 ms
병렬  :      82 ms  (워커 4개)
가속비: 3.11배 (이상적 최대 4배)
효율  : 78% (가속비 / 워커 수)

워커별 처리 작업 수:
  워커 1:  7개 #######
  워커 2:  4개 ####
  워커 3:  5개 #####
  워커 4:  8개 ########
-> 균등하지 않습니다. 작업 크기가 달랐으니 당연하죠.
   중요한 건 '놀고 있는 워커가 없었다'는 것입니다.
...
작업 완료 순서가 1, 3, 2, 5로 뒤섞여 있습니다. 작업 0은 큰 작업이라(24ms) 한참 뒤에 끝났죠. 이 순서는 실행마다 달라집니다.
① 정적 분배 대신 동적 분배
작업 24개를 워커 4개에 미리 6개씩 나눠주면 어떻게 될까요? 이 예제는 4개마다 하나씩 3배 큰 작업을 섞어 뒀습니다. 큰 작업을 몰아 받은 워커만 늦게 끝나고 나머지는 놉니다.
이 프로젝트는 “끝난 사람이 다음 것을 가져간다” 방식입니다.
            if (next_task < TASK_COUNT) {           /* 다음 작업 즉시 투입 */
                write(workers[i].to_worker, &tasks[next_task], sizeof(Task));
                next_task++;
            }
그래서 워커별 처리 개수가 7, 4, 5, 8로 일부러 균등하지 않습니다. 작은 작업을 많이 받은 워커와 큰 작업을 받은 워커가 비슷한 시각에 끝나도록 저절로 조절된 것입니다.
② select로 여러 워커 동시 감시
        fd_set readfds;
        FD_ZERO(&readfds);
        for (int i = 0; i < n_workers; i++) {
            if (!workers[i].busy) continue;
            FD_SET(workers[i].from_worker, &readfds);
            ...
        }
        select(maxfd + 1, &readfds, NULL, NULL, NULL);
워커를 순서대로 read하면 어떻게 될까요? 1번 워커가 느린 큰 작업을 하는 동안, 2번이 결과를 냈어도 받아주지 못합니다. 마스터가 1번의 read에 블록되어 있으니까요.
select는 “이 fd들 중 아무나 읽을 준비가 되면 알려줘” 라고 커널에게 부탁합니다. fd_set은 fd 번호를 비트로 표시한 집합이고(FD_ZERO로 비우고 FD_SET으로 넣습니다), 첫 인자는 “가장 큰 fd + 1″이라는 옛날식 규칙입니다. 돌아오면 준비된 fd만 집합에 남아 있어 FD_ISSET으로 확인합니다. 이것이 다중화(multiplexing) 이고, 21주차 네트워크 프로그래밍의 핵심 주제입니다. 거기서는 select의 한계와 epoll까지 갑니다. 9.5절의 비교표에서 “POSIX IPC는 fd라서 select가 된다”고 한 것이 실제로 쓰이는 장면입니다.
③ read_exact가 필요한 이유
static int read_exact(int fd, void *buf, size_t n) {
    char *p = buf;
    size_t got = 0;
    while (got < n) {
        ssize_t r = read(fd, p + got, n - got);
        if (r == 0) return 0;                /* EOF */
        if (r < 0) {
            if (errno == EINTR) continue;    /* 시그널로 끊겼으면 재시도 */
            return -1;
        }
        got += (size_t)r;
    }
    return 1;
}
18주차의 그 교훈입니다. read는 요청한 만큼 안 줄 수 있습니다. Result 구조체 32바이트를 요청했는데 20바이트만 올 수 있죠. 8.1절에서 파이프는 바이트 흐름이라 경계가 없다고 했던 것의 실제 결과입니다. 구조체를 주고받는 프로토콜에서는 반드시 “정확히 n바이트” 루프가 필요합니다. 이걸 빼먹으면 평소에는 잘 동작하다가 부하가 걸리면 구조체가 깨져 엉뚱한 값이 나옵니다.
EINTR 처리도 함께 보세요. 시그널이 도착하면 read가 중단될 수 있는데(18주차의 SA_RESTART 이야기), 그럴 때는 재시도해야 합니다.
④ 자식이 형들의 파이프까지 닫는 이유
        if (pid == 0) {
            close(down[1]);
            close(up[0]);
            /* 이미 만들어진 형들의 파이프도 닫아야 한다! (fd 누수 방지) */
            for (int k = 0; k < i; k++) {
                close(workers[k].to_worker);
                close(workers[k].from_worker);
            }
            worker_loop(i + 1, down[0], up[1]);
        }
fork는 열린 fd를 전부 물려줍니다. 워커 3을 만들 때 마스터는 이미 워커 1, 2의 파이프 fd를 들고 있고, 워커 3은 그것까지 물려받습니다. 워커 3이 워커 1의 파이프 쓰는 끝을 들고 있으면, 마스터가 닫아도 “쓰는 쪽”이 남아 EOF가 전달되지 않습니다. 1.2절의 EOF 규칙이 여기서 다시 발목을 잡는 것이죠. 워커가 여럿인 구조에서 프로그램이 종료되지 않는다면 십중팔구 이 문제입니다. 이 for 문을 주석 처리하고 돌려 보세요.
⑤ 가속비가 4배가 안 되는 이유
워커 4개인데 3.11배입니다. 왜 4배가 아닐까요? 워커 수를 바꿔 가며 재 봤습니다. 이 컴퓨터는 물리 코어 6개, 논리 CPU 12개(코어당 스레드 2개)입니다.
$ for n in 1 2 4 8 12; do ./build/work_queue $n | grep -E "^병렬|가속비"; done
| 워커 수 | 병렬 시간 | 가속비 | 효율 |
|---|---|---|---|
| 1 | 331 ms | 0.98배 | 98% |
| 2 | 160 ms | 1.78배 | 89% |
| 4 | 87 ms | 3.21배 | 80% |
| 8 | 53~58 ms | 4.3~4.7배 | 54~59% |
| 12 | 60 ms | 4.2배 | 35% |
워커 1개는 순차 처리보다 오히려 느립니다(0.98배). 파이프로 작업을 주고받는 비용만 더해졌으니까요. 8개까지는 빨라지지만 효율이 떨어지고, 12개는 8개보다 나아지지 않습니다. 물리 코어가 6개라 그 이상은 코어를 나눠 쓰기 때문입니다. 벤치마크라서 실행마다 흔들립니다. 8개 워커가 한 번은 115ms(2.41배)로 나오기도 했으니, 여러 번 돌려 경향을 보세요.
4배가 안 되는 이유는 이렇습니다.
- 프로세스 생성 비용:
fork4번 - 파이프 통신 비용: 작업/결과 전달. 워커 1개 실험이 이 비용을 보여 줍니다
- 꼬리 지연: 마지막에 남은 큰 작업 하나를 다른 워커들이 놀면서 기다리는 시간
- 순차 부분: 작업 목록 생성, 결과 집계
암달의 법칙입니다. 병렬화할 수 없는 부분이 전체 가속의 상한을 정하죠. 23주차 성능 최적화와 29주차 고성능 컴퓨팅에서 이 법칙을 수식으로 다시 봅니다.
확장 아이디어: 워커가 죽으면 재시작(SIGCHLD 감지), 작업 재시도, 결과를 파일로 저장, 워커 수를 CPU 코어 수에 맞추기(sysconf(_SC_NPROCESSORS_ONLN))
12. 남은 IPC 자원 찾아서 지우기
이번 주에 반복해서 나온 경고를 한곳에 모읍니다. 파이프를 제외한 모든 IPC 자원은 프로그램이 죽어도 남습니다. 7.3절의 버스 오류 실험처럼 프로그램이 중간에 죽으면 unlink에 도달하지 못하니까요. 개발 중에는 Ctrl + C로 끊는 일이 잦아서 더 자주 남습니다.
| 자원 | 어디에 남나 | 확인 | 지우기 |
|---|---|---|---|
| FIFO | 만든 경로 (ls -l에서 p) |
ls -l /tmp |
rm /tmp/이름 |
| POSIX 공유 메모리 | /dev/shm/이름 |
ls -l /dev/shm |
rm /dev/shm/이름 또는 프로그램에서 shm_unlink |
| POSIX 기명 세마포어 | /dev/shm/sem.이름 |
ls -l /dev/shm |
rm /dev/shm/sem.이름 또는 sem_unlink |
| POSIX 메시지 큐 | /dev/mqueue/이름 |
ls -l /dev/mqueue |
rm /dev/mqueue/이름 또는 mq_unlink |
| System V 셋 | 커널 안 (파일 아님) | ipcs |
ipcrm -m/-s/-q <id> 또는 ipcrm -M/-S/-Q <key> |
이번 주 예제가 남길 수 있는 것을 한 번에 정리하는 명령입니다. 이름이 week19_ 또는 w19_로 시작하는 것만 지우니 다른 프로그램의 자원은 건드리지 않습니다.
$ rm -f /dev/shm/week19_* /dev/shm/sem.week19_* /dev/shm/w19_* /tmp/week19_demo_fifo /tmp/w19_*
$ rm -f /dev/mqueue/week19_* /dev/mqueue/w19_*
$ ipcs
$ ipcrm -a        # 내 System V 자원 전부 삭제. 다른 프로그램이 쓰는 게 없을 때만!
POSIX 자원이 /dev/shm과 /dev/mqueue에 파일로 보이는 덕분에 rm으로 지울 수 있습니다. System V만 ipcrm이 필요합니다. 프로그램이 “이미 있다”(EEXIST)거나 “만들 수 없다”(ENOSPC)고 하면 이 표부터 확인하세요.
13. 자주 하는 실수와 함정
이번 주 실험에서 실제로 멈추거나 틀린 값을 본 것들입니다. 종료 코드 124는 “멈춤”입니다.
| # | 실수 | 증상 | 확인한 곳 |
|---|---|---|---|
| 1 | 파이프의 안 쓰는 끝을 안 닫음 | read가 EOF를 못 받아 멈춤 (124) |
1.2절 |
| 2 | 부모가 파이프 fd를 안 닫고 wait |
부모와 자식이 서로 기다림 (124) | 1.2절, 2.3절 |
| 3 | 여러 워커 구조에서 형제의 fd를 안 닫음 | 같은 이유로 종료 안 됨 | 11절 프로젝트 3 ④ |
| 4 | 읽는 끝에 쓰기, 쓰는 끝에서 읽기 | EBADF |
1.3절 |
| 5 | SIGPIPE를 처리하지 않은 서버 |
클라이언트가 끊으면 서버가 죽음 (141) | 1.5절 |
| 6 | FIFO를 상대 없이 열고 기다림 | open에서 멈춤 (124) |
3.3절 |
| 7 | popen/system에 사용자 입력 |
명령 주입 | 4.1절 |
| 8 | 공유 변수를 락 없이 고침 | 값이 증발. 실행마다 다름 | 5절 |
| 9 | -O2로 하니 안 터진다고 안심 |
버그는 그대로 | 5.4절 |
| 10 | sem_post를 잊음 |
다음 sem_wait이 영원히 (124) |
6.2절 |
| 11 | 무명 세마포어를 지역 변수에 | 각자 사본이라 동기화 안 됨. 값 틀림 | 6.3절 |
| 12 | sem_init의 pshared를 0으로 |
프로세스 간이면 멈춤 (124) | 6.4절 |
| 13 | ftruncate 없이 mmap |
접근하는 순간 버스 오류 (135) | 7.3절 |
| 14 | 공유 메모리에 포인터 저장 | 다른 프로세스에서 쓰레기 주소 | 7.5절 |
| 15 | mq_receive 버퍼가 mq_msgsize보다 작음 |
EMSGSIZE. 메시지가 작아도 실패 |
8.3절 |
| 16 | shm_unlink/mq_unlink/sem_unlink/IPC_RMID 누락 |
재부팅까지 남음 | 9.4절, 12절 |
| 17 | 락 순서가 코드마다 다름 | 교착 (124), futex_do_wait |
10.2절 |
| 18 | wait(mutex)를 wait(empty)보다 먼저 |
버퍼가 차는 순간 교착 (124) | 11절 프로젝트 1 ② |
| 19 | read가 요청한 만큼 준다고 가정 |
구조체가 쪼개져 도착 | 11절 프로젝트 3 ③ |
| 20 | 임계 구역 안에서 I/O나 긴 계산 | 다른 프로세스가 줄줄이 대기 | 6.7절 |
14. 연습 문제
기본 문제
wc -l직접 구현: 파이프로ls의 출력을 받아 직접 줄 수를 세는 프로그램을 만드세요(wc를exec하지 말고, 자식이ls를exec하고 부모가read로 받아\n을 셉니다).- 양방향 계산기: 파이프 두 개로 부모가
"3 + 4"같은 수식을 보내고 자식이 답을 돌려주는 프로그램을 만드세요. - FIFO 채팅: FIFO 두 개로 두 터미널 사이의 간단한 채팅을 만드세요. 3.3절의 표를 참고해
open순서를 정해야 멈추지 않습니다. - 세마포어로 순서 강제: 자식 3개가 반드시 1→2→3 순서로 출력하도록 세마포어를 배치하세요. 힌트는 초기값 0인 세마포어 두 개입니다.
- 공유 카운터: 공유 메모리 + 세마포어로 여러 프로세스가 안전하게 증가시키는 카운터를 만들고, 6.2~6.4절의 실수 세 가지를 하나씩 일부러 넣어 무엇이 달라지는지 기록하세요.
심화 문제
- 미니 쉘에 파이프 달기: 18주차
mini_shell.c에|지원을 추가하세요.ls -l | grep txt | wc -l이 동작해야 합니다. - 버퍼 크기와 처리량: 생산자-소비자의
BUFFER_SIZE를 1, 5, 50, 500으로 바꿔가며 총 처리 시간을 측정하세요. 어디서 수익이 줄어드나요? - 교착 탐지기: 여러 락의 획득 순서를 기록해 순환이 생기면 경고하는 래퍼 함수를 만드세요(간단한 자원 할당 그래프. 14주차의 그래프 순환 탐지가 쓰입니다).
- LRU 캐시로 확장:
shm_cache에 “가장 오래 안 쓴 항목 축출”을 추가하세요. 공유 메모리라 포인터를 못 쓴다는 제약 아래서 어떻게 구현할까요? - 워커 장애 복구:
work_queue에서 워커가 죽으면(kill로 테스트) 마스터가 감지해 새 워커를 띄우고 잃어버린 작업을 재시도하게 만드세요.
마치며
이번 주에 배운 것을 정리합니다.
- 파이프: 단방향 관. EOF 규칙(쓰는 끝이 전부 닫혀야)이 핵심. 안 닫으면 멈춥니다
- 파이프라인:
dup2두 줄로ls | wc -l. 유닉스 철학의 기술적 토대 - FIFO: 이름을 가진 파이프. 남남끼리도 통신, 랑데부 성질
- 경쟁 조건:
counter++는 세 단계. 공유 자원에는 반드시 동기화. 실행마다 값이 다릅니다 - 세마포어: 허가증 통. 초기값 1이면 뮤텍스, N이면 자원 제한. 공유 메모리에,
pshared는 0이 아닌 값으로 - 공유 메모리: 가장 빠른 IPC(22배). 대신 포인터 금지, 동기화 별도,
ftruncate필수 - 메시지 큐: 메시지 경계 보존 + 우선순위. 버퍼는
mq_msgsize이상 - 교착: 4조건 중 하나만 깨면 된다. 실무의 답은 락 순서 통일
이번 주의 큰 그림을 하나 짚고 넘어가겠습니다. IPC의 선택은 “무엇을 주고받는가”가 정합니다.
| 주고받는 것 | 도구 |
|---|---|
| 바이트 흐름 | 파이프, FIFO |
| 구조화된 메시지 | 메시지 큐 |
| 큰 데이터 덩어리 | 공유 메모리 |
| 신호만 | 시그널(18주차), 세마포어 |
| 다른 컴퓨터와 | 소켓(21주차) |
그리고 동기화는 선택이 아니라 필수입니다. 공유 자원이 있는데 동기화가 없다면, 그것은 “아직 안 터진 버그”일 뿐입니다. 5절의 실험이 그 증거였고, 5.4절의 -O2는 그 버그를 숨겨 줄 뿐이었습니다.
다음 주는 멀티스레딩입니다. 같은 문제를 프로세스 대신 스레드로 풀면 무엇이 달라질까요?
- 스레드는 메모리를 기본적으로 공유합니다.
mmap도 IPC도 필요 없죠 - 대신 모든 변수가 공유 자원이라 경쟁 조건의 위험이 훨씬 큽니다
- 생성 비용이 프로세스보다 훨씬 쌉니다
이번 주에 배운 세마포어와 교착 지식이 그대로 쓰입니다. 거기에 뮤텍스, 조건 변수, 읽기-쓰기 락이 더해지죠. 그리고 이번 주의 생산자-소비자를 스레드로 다시 만들어 성능과 복잡도를 비교합니다.
수고하셨습니다. IPC와 동기화는 시스템 프로그래밍에서 가장 실수하기 쉬운 영역입니다. 이번 주에 종료 코드 124를 여러 번 봤을 겁니다. 그 하나하나가 “왜 멈추는지”를 몸에 새기는 과정입니다. 파이프 fd 하나를 안 닫아 프로그램이 멈추는 것을 직접 겪은 사람은 그 규칙을 잊지 않습니다.
체크리스트
- [ ]
pipe(fd)의fd[0]/fd[1]역할을 헷갈리지 않는다 - [ ] 안 쓰는 파이프 끝을 닫아야 하는 이유(EOF 규칙)를 설명하고, 안 닫으면 멈추는 것을 직접 봤다
- [ ] 파이프 버퍼가 64KB이고 가득 차면
write가 기다린다는 것을 확인했다 - [ ]
SIGPIPE/EPIPE가 언제 발생하는지 알고 종료 코드 141의 뜻을 안다 - [ ]
dup2로ls | wc -l을 구현할 수 있다 - [ ] N단 파이프라인에서
prev_read를 넘기는 구조를 안다 - [ ] 파이프라인의 명령들이 동시에 실행된다는 것을 안다
- [ ] FIFO와 익명 파이프의 차이를 설명할 수 있다
- [ ] FIFO
open의 랑데부 성질과O_NONBLOCK을 안다 - [ ]
popen의 편리함과 명령 주입 위험을 함께 안다 - [ ]
counter++가 세 단계임을 알고 경쟁 조건을 설명할 수 있다 - [ ] 경쟁 조건이 실행마다 다른 값을 내는 것과,
-O2가 그것을 숨길 수 있다는 것을 봤다 - [ ] 임계 구역과 상호 배제의 정의를 말할 수 있다
- [ ]
sem_wait/sem_post로 임계 구역을 보호할 수 있다 - [ ] 무명 세마포어를 공유 메모리에 두어야 하고
pshared가 0이면 안 되는 이유를 안다 - [ ] 세는 세마포어(초기값 N)의 용도를 예로 들 수 있다
- [ ]
shm_open+ftruncate+mmap3단계를 쓸 수 있고,ftruncate를 빼면 버스 오류가 나는 것을 안다 - [ ] 공유 메모리에 포인터를 넣으면 안 되는 이유를 안다
- [ ]
munmap/close/shm_unlink의 역할 차이를 안다 - [ ] 메시지 큐의 경계 보존과 우선순위 성질,
EMSGSIZE와EAGAIN이 언제 나는지 안다 - [ ] 우선순위가 “줄이 서 있을 때만” 의미 있음을 안다
- [ ] System V IPC가 재부팅까지 남는다는 것을
ipcs로 확인하고ipcrm으로 지워 봤다 - [ ] 교착의 4조건을 말하고 하나를 깨는 방법을 설명할 수 있다
- [ ] 락 순서 통일이 왜 교착을 막는지 안다
- [ ] 생산자-소비자의 세마포어 3종과 획득 순서를 알고, 순서를 뒤집으면 멈추는 것을 봤다
- [ ] 락 분할(striping)이 왜 빨라지는지 설명할 수 있다
- [ ]
read_exact가 필요한 이유를 안다 - [ ] 세 프로젝트를 빌드하고 실행해 봤다
- [ ] 남은 IPC 자원을
/dev/shm,/dev/mqueue,ipcs에서 찾아 지울 수 있다 - [ ] (도전) 18주차 미니 쉘에 파이프
|를 추가해 봤다
참고 자료
- “The Linux Programming Interface” (Kerrisk) — 43~55장이 IPC 전체를 다룹니다
- “Advanced Programming in the UNIX Environment” (Stevens) — 15장(IPC), 17장(고급 IPC)
man 7 pipe,man 7 fifo,man 7 shm_overview,man 7 sem_overview,man 7 mq_overview— 개념 설명서. 함수별 설명서(man 2 pipe,man 3 sem_wait)는 1주차에서 설치한manpages-dev가 있어야 나옵니다man 7 svipc— System V IPC 개요- Dining Philosophers Problem (Wikipedia) — 교착의 고전 문제
- 다음 주차: 20주차 멀티스레딩과 병렬 프로그래밍