학습 목표
- 구조체(
struct)로 서로 다른 자료형을 하나의 새 자료형으로 묶고, 정의·선언·초기화·멤버 접근의 문법 요소를 하나씩 설명할 수 있다 sizeof와offsetof로 구조체의 실제 메모리 배치를 찍어 보고, 패딩과 정렬 때문에 크기가 멤버 합보다 커지는 이유를 바이트 단위로 설명할 수 있다- 멤버 순서만 바꿔서 구조체 크기를 줄일 수 있다
typedef로 이름을 다듬고, 자기참조 구조체에 태그 이름이 필요한 이유를 안다- 구조체 배열, 구조체 포인터(
->), 구조체를 함수에 넘기는 두 방식(값/포인터)의 차이를 주소를 찍어 확인할 수 있다 - 공용체(
union)가 같은 바이트를 다른 타입으로 읽는 모습을 실제 바이트로 확인하고, 태그드 유니온으로 안전하게 쓸 수 있다 - 열거형(
enum)과 비트 필드의 쓰임새와 한계를 안다 - 구조체와 포인터로 연결 리스트의 뼈대를 만들 수 있다
들어가며
지금까지 우리는 int, double, char 같은 기본 자료형과, 같은 자료형을 여러 개 묶는 배열을 배웠습니다. 그런데 현실의 데이터는 대부분 종류가 뒤섞여 있습니다.
“학생 한 명”을 프로그램으로 표현한다고 해 봅시다. 이름은 문자열(char[]), 나이는 정수(int), 평균 점수는 실수(double)입니다. 지금까지 배운 도구로는 이 셋을 따로따로 변수로 두는 수밖에 없습니다.
char   name[50];
int    age;
double average;
학생이 한 명이면 참을 만합니다. 하지만 100명이면요? 배열 세 개를 만들고, “3번 학생의 이름은 name[3], 나이는 age[3], 점수는 average[3]” 이라고 인덱스를 맞춰 가며 관리해야 합니다.
char   name[100][50];
int    age[100];
double average[100];
이렇게 인덱스로만 이어진 배열들을 병렬 배열(parallel array) 이라고 부릅니다. 문제는 이 셋이 “같은 학생”이라는 사실을 컴파일러는 전혀 모른다는 것입니다. 이름 배열만 정렬하고 나이 배열을 깜빡하면, 그 순간부터 김철수의 이름에 이영희의 나이가 붙습니다. 컴파일러는 경고 한 줄 해 주지 않습니다. 학생을 함수에 넘길 때도 print_student(name[i], age[i], average[i]) 처럼 조각을 전부 따로 넘겨야 합니다. 논리적으로는 “한 학생”인데 코드에서는 뿔뿔이 흩어져 있는 것, 이것이 문제의 뿌리입니다.
구조체(structure) 는 바로 이 문제를 해결합니다. 서로 다른 자료형의 값들을 하나의 새로운 자료형으로 묶어 줍니다. 학생 한 명을 통째로 Student 라는 타입으로 정의하면, students[3] 하나로 3번 학생의 모든 정보를 함께 다룰 수 있습니다. 정렬할 때도 학생이 통째로 움직이니 정보가 섞일 일이 없습니다.
구조체는 C에서 “나만의 자료형”을 만드는 첫걸음입니다. 앞으로 만들 연결 리스트(10주차), 스택과 큐(11주차), 트리(12주차)와 해시 테이블(13주차), 그리고 18주차부터 매일 쓸 리눅스 시스템 함수들(struct stat, struct sockaddr 등)이 모두 구조체입니다. 이번 주에 구조체를 제대로 익혀 두면 앞으로의 코드가 훨씬 쉽게 읽힙니다.
이번 주에는 궁금한 것을 계속 직접 확인해 볼 겁니다. 예를 들어 이런 질문들입니다.
char[50]과int와double을 묶으면 50 + 4 + 8 = 62바이트일까? (답: 아닙니다. 64바이트입니다. 남는 2바이트는 어디에 있을까요?)- 똑같은 멤버 세 개인데, 순서만 바꿨더니 크기가 12바이트에서 8바이트로 줄어드는 이유는?
- 같은 4바이트를 정수로 읽을 때와 실수로 읽을 때, 메모리 안에서는 무슨 일이 일어날까?
- 구조체를
=로 복사했는데, 한쪽 이름을 바꾸니 다른 쪽 이름도 같이 바뀌는 경우는?
7주차에서 익힌 포인터와 동적 메모리 지식이 이번 주에 본격적으로 쓰입니다.
0. 이번 주 작업 준비
이번 주 예제는 examples/ 폴더에, 실습 프로젝트는 projects/ 폴더에 있고, Makefile 이 한 번에 빌드해 build/ 폴더에 실행 파일을 모아 줍니다. 5주차에 배운 make 그대로입니다.
$ cd week08
$ make
컴파일: examples/bitfield.c
컴파일: examples/enum_basic.c
...
✓ 예제 파일 빌드 완료
컴파일: projects/address_book.c
컴파일: projects/simple_database.c
컴파일: projects/student_manager.c
✓ 프로젝트 파일 빌드 완료
✓ 모든 파일 빌드 완료!
$ ./build/struct_basic
Makefile 은 1주차부터 써 온 -Wall -Wextra -std=c11 -g 옵션으로 컴파일합니다. 모든 예제는 경고 0개로 컴파일됩니다.
이 글에는 예제 파일 외에도 “이렇게 바꾸면 어떻게 될까?” 실험 코드가 많이 나옵니다. 실험 코드는 따로 폴더를 하나 만들어 거기서 해 보세요.
$ mkdir -p ~/c_programming/week08/lab
$ cd ~/c_programming/week08/lab
실험 코드는 모두 같은 방법으로 컴파일합니다.
$ gcc -Wall -Wextra -std=c11 -g 파일이름.c -o 파일이름 && ./파일이름
1. 구조체 기초
1.1 구조체 정의 — 설계도 그리기
구조체는 여러 변수를 하나로 묶어 새로운 자료형을 만드는 문법입니다. 서랍이 여러 칸으로 나뉜 정리함을 떠올려 보세요. 한 칸에는 이름을, 다른 칸에는 나이를, 또 다른 칸에는 키를 넣어 두고, 이 정리함 하나를 통째로 들고 다니는 것입니다. 각 칸을 멤버(member) 또는 필드(field) 라고 부릅니다.
struct Person {
    char name[50];   // 멤버 1: 이름
    int  age;        // 멤버 2: 나이
    double height;   // 멤버 3: 키
};   // <- 세미콜론을 빠뜨리기 쉬우니 주의!
한 글자씩 뜯어봅시다.
| 부분 | 이름 | 뜻 |
|---|---|---|
struct |
키워드 | “지금부터 구조체를 정의한다” |
Person |
태그(tag) | 이 구조체의 이름. 합쳐서 struct Person 이 자료형 이름이 됩니다 |
{ ... } |
멤버 목록 | 이 구조체가 가질 칸들 |
char name[50]; |
멤버 선언 | 평소 변수 선언과 똑같은 모양. 배열도, 다른 구조체도 멤버가 될 수 있습니다 |
}; |
끝 | 닫는 중괄호 뒤의 세미콜론이 꼭 필요합니다 |
마지막 세미콜론이 유난히 눈에 띕니다. 함수 정의 int main(void) { ... } 뒤에는 세미콜론을 붙이지 않는데, 구조체 정의 뒤에는 왜 붙일까요? 구조체 정의는 선언문이기 때문입니다. int x; 의 int 자리에 struct Person { ... } 이 들어간 모양이라고 보면 됩니다. 실제로 정의와 동시에 변수를 만들 수도 있습니다.
struct Person {
    char name[50];
    int  age;
    double height;
} p1, p2;   // 정의하면서 곧바로 변수 p1, p2 도 만든다
} 와 ; 사이에 변수 이름을 적으면 그 변수들이 만들어집니다. 그러니 변수 이름을 비워 둔 }; 도 “변수 없이 선언만 끝낸다”는 뜻의 세미콜론입니다. 이 세미콜론을 빼먹으면 어떻게 되는지는 14절에서 실제 오류 메시지로 봅니다.
중요한 점: 위의 정의는 설계도(틀)를 그린 것일 뿐, 아직 메모리를 차지하지 않습니다. struct Person 이라는 새 자료형이 생겼을 뿐이고, 실제 데이터를 담으려면 이 자료형으로 변수를 선언해야 합니다.
struct Person p1; // 이제서야 메모리에 struct Person 크기만큼 공간이 잡힌다
int 가 “정수를 담을 수 있는 칸의 모양”이고 int x; 가 “그 모양의 칸을 실제로 하나 만든다”인 것과 똑같습니다. 붕어빵 틀과 붕어빵의 관계죠. 그리고 자료형 이름은 Person 이 아니라 struct Person 전체입니다. struct 를 빼고 Person p1; 이라고 쓰면 컴파일 오류가 납니다(3절에서 실제 메시지를 보고, typedef 로 이 불편을 없앱니다).
1.2 멤버 접근 — 점(.) 연산자
멤버에 접근할 때는 점 연산자(.) 를 씁니다. p1.age 는 “p1이라는 정리함의 age 칸”입니다.
p1.age = 25;               // p1 의 age 칸에 25 를 넣는다
printf("%d\n", p1.age);    // p1 의 age 칸을 읽는다
p1.age 는 평범한 int 변수와 똑같이 쓸 수 있습니다. 더하고, 비교하고, 주소를 구하고(&p1.age), scanf 로 값을 받을 수도 있습니다(scanf("%d", &p1.age)). 점은 “이 구조체 안의 저 칸”이라는 주소 찾아가기일 뿐, 꺼낸 멤버는 원래 자료형 그대로입니다.
1.3 초기화 — 세 가지 방법
방법 1: 선언한 뒤 하나씩 대입
struct Person p1;
strcpy(p1.name, "김철수");   // 문자열 멤버는 = 로 대입할 수 없다! strcpy 사용
p1.age = 25;
p1.height = 175.5;
방법 2: 선언과 동시에 중괄호로 초기화
struct Person p2 = {"이영희", 30, 162.3}; // 멤버 순서대로
중괄호 안의 값이 정의된 멤버 순서(name, age, height)대로 하나씩 들어갑니다. 배열 초기화 int a[3] = {1, 2, 3}; 과 같은 모양입니다.
방법 3: 지정 초기화 (designated initializer, C99부터)
struct Person p3 = {.age = 28, .name = "박민수", .height = 180.0};
.멤버이름 = 값 으로 어느 칸에 무엇을 넣을지 직접 적습니다. 순서를 지키지 않아도 되고, 코드를 읽을 때 어떤 값이 어디로 가는지 한눈에 보입니다. 멤버가 많은 구조체일수록 이 방식이 안전합니다. 나중에 누군가 구조체 정의에 멤버를 하나 끼워 넣어도, 방법 2는 값이 한 칸씩 밀려 엉뚱한 칸에 들어가지만 방법 3은 이름으로 찾아가니 그대로 맞습니다.
실험: 값을 일부만 주면 나머지는?
init.c:
#include <stdio.h>

typedef struct {
    char name[8];
    int  age;
    double height;
} Person;

int main(void) {
    Person a = {"kim"};
    Person b = {.height = 180.0};
    Person z = {0};
    printf("a: \"%s\" %d %.1f\n", a.name, a.age, a.height);
    printf("b: \"%s\" %d %.1f\n", b.name, b.age, b.height);
    printf("z: \"%s\" %d %.1f\n", z.name, z.age, z.height);
    return 0;
}
(typedef 는 3절에서 설명합니다. 지금은 struct 를 안 써도 되게 해 주는 문법이라고만 알아 두세요.)
$ gcc -Wall -Wextra -std=c11 init.c -o init && ./init
init.c: In function ‘main’:
init.c:10:5: warning: missing initializer for field ‘age’ of ‘Person’ [-Wmissing-field-initializers]
   10 |     Person a = {"kim"};
      |     ^~~~~~
init.c:5:10: note: ‘age’ declared here
    5 |     int  age;
      |          ^~~
a: "kim" 0 0.0
b: "" 0 180.0
z: "" 0 0.0
결과에서 두 가지를 알 수 있습니다.
- 초기화 목록에 적지 않은 멤버는 모두 0으로 채워집니다.
a는 이름만 줬는데 나이와 키가 0,b는 키만 줬는데 이름이 빈 문자열입니다. C 표준이 보장하는 규칙입니다. 그래서{0}한 줄이 “모든 멤버를 0으로”라는 관용구가 됩니다. - 방법 2로 일부만 준
a에 대해서는-Wextra가 “age의 초기값을 빠뜨렸다”고 경고합니다. 순서대로 주다가 실수로 빠뜨린 것일 수 있기 때문입니다. 반면 지정 초기화(b)와{0}은 의도가 분명하니 경고하지 않습니다.
반대로 초기화를 아예 하지 않은 지역 구조체 변수는 0이 아니라 쓰레기 값입니다. 1주차 10절의 초기화하지 않은 int x 와 똑같습니다(14절에서 경고를 봅니다).
1.4 문자열 멤버는 왜 = 로 넣을 수 없을까
방법 1에서 strcpy 를 썼습니다. 그냥 p1.name = "김철수"; 라고 쓰면 어떻게 될까요?
$ gcc -Wall -Wextra -std=c11 strassign.c -o strassign
strassign.c: In function ‘main’:
strassign.c:11:12: error: assignment to expression with array type
   11 |     p.name = "김철수";
      |            ^
“배열 타입인 식에 대입했다”는 오류입니다. name 은 char 50개짜리 배열이고, 4주차에서 배웠듯 C에서 배열은 = 로 통째로 대입할 수 없습니다. int a[3], b[3]; a = b; 가 안 되는 것과 같은 이유입니다. 문자열은 strcpy (또는 길이를 제한하는 strncpy, snprintf)로 한 글자씩 복사해야 합니다.
그런데 초기화할 때는 {"이영희", 30, 162.3} 처럼 문자열을 바로 썼습니다. 이건 되는데 대입은 왜 안 될까요? 초기화와 대입은 다른 문법이기 때문입니다. 초기화는 “변수가 태어날 때 어떤 값으로 태어날지”를 정하는 것이고, 배열도 char s[10] = "hi"; 처럼 초기화는 됩니다. 이미 태어난 배열에 나중에 = 로 값을 넣는 대입만 안 됩니다.
이름을 초기화할 때 배열 크기보다 긴 문자열을 주면 어떻게 될까요?
char name[4]에"김철수"(9바이트)를 넣어 보면 GCC가warning: initializer-string for array of ‘char’ is too long이라고 경고합니다. 1주차에서 봤듯 한글 한 글자는 3바이트라서,char name[4]에는 한글이 한 글자밖에 안 들어갑니다. 한글 이름을 담을 배열은 넉넉하게 잡으세요.
1.5 구조체 통째로 복사하기 — 그리고 비교는 안 되는 이유
배열은 = 로 복사할 수 없지만, 구조체는 = 한 번으로 전체가 복사됩니다. 안에 배열 멤버가 있어도 통째로 복사됩니다.
struct Person copy = p2;               // p2 의 모든 멤버가 copy 로 복사된다
strcpy(copy.name, "이영희(복사본)");   // copy 만 바뀐다
copy 와 p2 는 메모리의 서로 다른 곳에 있는 독립된 데이터입니다. copy 를 바꿔도 p2 는 그대로입니다. 곧 볼 예제의 실행 결과에서 확인할 수 있습니다.
배열은 안 되는데 구조체는 왜 될까요? 구조체는 처음부터 “크기가 정해진 값 하나”로 설계됐기 때문입니다. 컴파일러는 sizeof(struct Person) 바이트를 그대로 복사하는 코드를 만듭니다. 그래서 배열을 통째로 복사하고 싶을 때 배열을 구조체 안에 넣는 요령도 있습니다.
단, 두 가지를 알아 두세요.
- 멤버 중에 포인터가 있으면, 포인터가 가리키는 내용이 아니라 주소만 복사됩니다. 두 구조체가 같은 메모리를 가리키게 되는 “얕은 복사” 함정인데, 14절에서 실제로 사고를 내 봅니다.
- 복사는 되지만 비교(
==)는 안 됩니다.
Point a = {1, 2}, b = {1, 2};
if (a == b) printf("같다\n");
$ gcc -Wall -Wextra -std=c11 cmp.c -o cmp
cmp.c: In function ‘main’:
cmp.c:7:11: error: invalid operands to binary == (have ‘Point’ and ‘Point’)
    7 |     if (a == b) printf("같다\n");
      |           ^~
“== 에 Point 와 Point 를 줄 수 없다”는 오류입니다. 구조체를 비교하려면 a.x == b.x && a.y == b.y 처럼 멤버를 하나씩 비교하는 함수를 직접 만들어야 합니다. 복사는 되는데 비교는 왜 안 될까요? 바이트를 그대로 복사하는 건 항상 옳지만, 바이트를 그대로 비교하는 건 틀린 답을 낼 수 있기 때문입니다. 그 이유가 바로 다음 2절의 주제인 “패딩”입니다.
1.6 예제: struct_basic.c
지금까지의 내용을 모은 예제입니다.
전체 실행 코드:
examples/struct_basic.c
#include <stdio.h>
#include <string.h>

/* 구조체 정의: 'struct Person'이라는 새로운 자료형을 만든다.
 * 이 정의만으로는 메모리가 잡히지 않는다. 설계도(틀)일 뿐이다. */
struct Person {
    char name[50];   /* 이름 */
    int  age;        /* 나이 */
    double height;   /* 키(cm) */
};

int main(void) {
    /* 1) 선언 후 멤버에 하나씩 값 대입 */
    struct Person p1;
    strcpy(p1.name, "김철수");   /* 문자열은 = 로 대입 불가, strcpy 사용 */
    p1.age = 25;
    p1.height = 175.5;

    /* 2) 선언과 동시에 중괄호로 초기화 (멤버 순서대로) */
    struct Person p2 = {"이영희", 30, 162.3};

    /* 3) 지정 초기화(designated initializer, C99~): 멤버 이름을 명시 */
    struct Person p3 = {.age = 28, .name = "박민수", .height = 180.0};

    /* 멤버 접근은 점(.) 연산자 사용 */
    printf("=== 구조체 기본 ===\n");
    printf("%s: %d세, %.1fcm\n", p1.name, p1.age, p1.height);
    printf("%s: %d세, %.1fcm\n", p2.name, p2.age, p2.height);
    printf("%s: %d세, %.1fcm\n", p3.name, p3.age, p3.height);

    /* 구조체 전체 복사는 = 한 번으로 가능 (모든 멤버가 통째로 복사됨) */
    struct Person copy = p2;
    strcpy(copy.name, "이영희(복사본)");
    printf("\n원본은 그대로: %s\n", p2.name);     /* 이영희 */
    printf("복사본만 변경: %s\n", copy.name);      /* 이영희(복사본) */

    /* 구조체의 크기: 멤버 크기의 합 + 정렬(padding)로 인해 더 클 수 있다 */
    printf("\nstruct Person 크기: %zu 바이트\n", sizeof(struct Person));

    return 0;
}
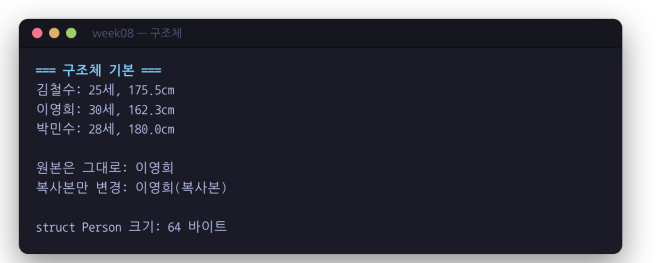
$ ./build/struct_basic
=== 구조체 기본 ===
김철수: 25세, 175.5cm
이영희: 30세, 162.3cm
박민수: 28세, 180.0cm

원본은 그대로: 이영희
복사본만 변경: 이영희(복사본)

struct Person 크기: 64 바이트
구조체
세 가지 초기화 방법이 모두 같은 모양의 결과를 냈고, 복사본을 바꿔도 원본이 그대로라는 것이 확인됩니다.
그런데 마지막 줄을 보세요. 64바이트입니다. 멤버를 더해 보면 char[50] 50바이트 + int 4바이트 + double 8바이트 = 62바이트여야 합니다. 2바이트는 어디서 왔을까요?
2. 구조체의 크기: 패딩과 정렬
이 절은 이번 주에서 가장 “컴퓨터 속”을 들여다보는 부분입니다. 조금 어렵게 느껴져도 끝까지 따라와 보세요. 이걸 이해하면 9주차에 구조체를 파일에 저장할 때, 21주차에 네트워크로 구조체를 보낼 때 생기는 이상한 문제들이 전부 설명됩니다.
2.1 CPU는 “딱 맞는 자리”에 있는 데이터를 좋아한다
메모리는 1바이트마다 주소가 붙어 있는 긴 칸의 줄입니다. 그런데 CPU는 메모리를 1바이트씩 읽지 않습니다. 4바이트나 8바이트를 한 번에 읽습니다. 그리고 그렇게 한 번에 읽는 덩어리의 시작 주소는 4의 배수, 8의 배수처럼 정해진 경계에 맞춰져 있을 때 가장 빠르고 간단합니다.
그래서 C 컴파일러는 약속을 하나 지킵니다. 각 자료형은 자기 크기의 배수인 주소에 놓는다. 이 “배수”를 그 자료형의 정렬 요구(alignment) 라고 합니다. C11에는 정렬 요구를 알려 주는 _Alignof 연산자가 있으니 직접 물어봅시다.
printf("sizeof(char)=%zu int=%zu double=%zu\n", sizeof(char), sizeof(int), sizeof(double));
printf("_Alignof: char=%zu int=%zu double=%zu\n", _Alignof(char), _Alignof(int), _Alignof(double));
sizeof(char)=1 int=4 double=8
_Alignof: char=1 int=4 double=8
x86-64 리눅스에서는 크기와 정렬 요구가 같습니다.
| 자료형 | 크기 | 정렬 요구 | 놓일 수 있는 주소 |
|---|---|---|---|
char |
1 | 1 | 아무 곳 |
int |
4 | 4 | 0, 4, 8, 12, … |
double |
8 | 8 | 0, 8, 16, 24, … |
그런데 구조체는 멤버를 적은 순서대로 이어 붙입니다. 그러다 보면 앞 멤버가 끝난 자리가 다음 멤버의 정렬 요구를 만족하지 않는 경우가 생깁니다. 그러면 컴파일러는 그 사이에 빈 바이트를 끼워 넣어 다음 멤버를 알맞은 자리로 밀어냅니다. 이 빈 바이트를 패딩(padding) 이라고 합니다.
2.2 offsetof 로 멤버 위치 찍어 보기
멤버가 구조체 시작점에서 몇 바이트 떨어진 곳에 있는지는 <stddef.h> 의 offsetof(구조체타입, 멤버) 로 알 수 있습니다. offset은 “시작점으로부터의 거리”라는 뜻입니다. struct Person 을 찍어 봅시다.
#include <stdio.h>
#include <stddef.h>

struct Person {
    char name[50];
    int  age;
    double height;
};

int main(void) {
    printf("struct Person: %zu 바이트\n", sizeof(struct Person));
    printf("  name   offset %2zu, 크기 %zu\n", offsetof(struct Person, name), sizeof(((struct Person*)0)->name));
    printf("  age    offset %2zu, 크기 %zu\n", offsetof(struct Person, age), sizeof(int));
    printf("  height offset %2zu, 크기 %zu\n", offsetof(struct Person, height), sizeof(double));
    return 0;
}
sizeof(((struct Person*)0)->name) 은 “변수를 만들지 않고 멤버의 크기만 알아내는” 관용구입니다. sizeof 는 실제로 값을 읽지 않고 타입만 보기 때문에 안전합니다. 지금은 모양만 봐 두세요.
struct Person: 64 바이트
  name   offset  0, 크기 50
  age    offset 52, 크기 4
  height offset 56, 크기 8
name 은 0번 바이트부터 50바이트, 즉 0~49번을 씁니다. 그러면 age 는 50번부터 시작할 것 같은데 52번에서 시작합니다. 50은 4의 배수가 아니기 때문입니다. 50 다음의 4의 배수인 52까지 2바이트를 비워 둔 것입니다. age 는 52~55번, height 는 56번부터인데, 56은 8의 배수라 바로 붙습니다. 그림으로 그리면 이렇습니다.
바이트:  0 ─────────────── 49 │ 50  51 │ 52  53  54  55 │ 56 ─────────── 63
        ┌───────────────────┬─────────┬────────────────┬──────────────────┐
        │   name[50]        │ 패딩 2  │   age (int)    │  height (double) │
        └───────────────────┴─────────┴────────────────┴──────────────────┘
          50바이트             ↑         4바이트            8바이트
                              50은 4의 배수가 아니라서
                              age 를 52로 밀어낸 빈칸
사라졌던 2바이트는 name 과 age 사이의 패딩이었습니다. 50 + 2 + 4 + 8 = 64.
2.3 패딩 바이트를 눈으로 보기
패딩이 정말 “아무도 쓰지 않는 빈칸”인지 직접 들여다봅시다. 구조체 메모리를 먼저 0xAA 라는 눈에 띄는 값으로 칠해 두고, 멤버에만 값을 넣은 다음 바이트를 하나씩 찍어 봅니다.
#include <stdio.h>
#include <string.h>

struct Bad {
    char a;
    int  b;
    char c;
};

int main(void) {
    struct Bad x;
    memset(&x, 0xAA, sizeof x);     /* 모든 바이트를 0xAA 로 칠한다 */
    x.a = 1; x.b = 2; x.c = 3;      /* 멤버에만 값을 넣는다 */

    const unsigned char *p = (const unsigned char *)&x;
    printf("struct Bad 의 바이트:");
    for (size_t k = 0; k < sizeof x; k++) printf(" %02x", p[k]);
    printf("\n");
    return 0;
}
memset(주소, 값, 바이트수)는 메모리를 한 가지 값으로 채우는 함수입니다(<string.h>).(const unsigned char *)&x는 “x의 주소를 바이트 단위로 읽는 포인터로 보겠다”는 뜻입니다. 6주차에서 배운 포인터 형 변환입니다. 어떤 객체든unsigned char포인터로 한 바이트씩 읽는 것은 C 표준이 허락하는 방법입니다.
struct Bad 의 바이트: 01 aa aa aa 02 00 00 00 03 aa aa aa
이 한 줄을 칸별로 나눠 보면 이렇습니다.
오프셋:   0    1    2    3    4    5    6    7    8    9   10   11
        ┌────┬────┬────┬────┬────┬────┬────┬────┬────┬────┬────┬────┐
        │ 01 │ aa │ aa │ aa │ 02 │ 00 │ 00 │ 00 │ 03 │ aa │ aa │ aa │
        └────┴────┴────┴────┴────┴────┴────┴────┴────┴────┴────┴────┘
          a    └── 패딩 ──┘   └────── b ────────┘   c    └ 끝 패딩 ┘
aa가 남아 있는 칸이 패딩입니다. 아무도 쓰지 않았으니 칠해 둔 값이 그대로 남았습니다. 실제 프로그램에서는memset을 안 하니 이 칸에는 그때그때 다른 쓰레기 값이 들어 있습니다.b는 2인데02 00 00 00으로 저장됐습니다. 숫자의 작은 자리 바이트가 앞(낮은 주소) 에 오는 방식으로, 리틀 엔디언(little-endian) 이라고 부릅니다. 1주차에서file명령이 알려 준LSB가 바로 이것입니다. 3주차의 비트 이야기와 이어지고, 21주차에 네트워크로 숫자를 보낼 때 다시 중요해집니다.- 맨 끝에도 패딩이 3바이트 붙었습니다. 왜 끝에 빈칸이 필요할까요? 2.6에서 답합니다.
이제 1.5의 수수께끼가 풀립니다. 구조체 두 개를 바이트 그대로 비교하면(memcmp), 멤버 값이 모두 같아도 패딩 칸의 쓰레기 값이 달라서 “다르다”는 답이 나올 수 있습니다. 그래서 C는 구조체의 == 를 아예 허락하지 않고, 멤버를 하나씩 비교하게 합니다.
2.4 멤버 순서만 바꿨는데 크기가 달라진다
struct Bad 는 char, int, char 순서였습니다. 멤버는 그대로 두고 순서만 int, char, char 로 바꾸면 어떻게 될까요?
struct Bad {        struct Good {
    char a;             int  b;
    int  b;             char a;
    char c;             char c;
};                  };
struct Bad  (char, int, char): 12 바이트
  a 0, b 4, c 8
struct Good (int, char, char): 8 바이트
  b 0, a 4, c 5
같은 멤버 세 개인데 12바이트와 8바이트입니다.
struct Bad (12바이트)
 0    1    2    3    4    5    6    7    8    9   10   11
┌────┬────┬────┬────┬────┬────┬────┬────┬────┬────┬────┬────┐
│ a  │ 패 │ 패 │ 패 │ b  │ b  │ b  │ b  │ c  │ 패 │ 패 │ 패 │
└────┴────┴────┴────┴────┴────┴────┴────┴────┴────┴────┴────┘

struct Good (8바이트)
 0    1    2    3    4    5    6    7
┌────┬────┬────┬────┬────┬────┬────┬────┐
│ b  │ b  │ b  │ b  │ a  │ c  │ 패 │ 패 │
└────┴────┴────┴────┴────┴────┴────┴────┘
Good 은 int 를 먼저 두니 char 두 개가 그 뒤에 빈틈없이 붙고, 끝에 2바이트만 채우면 됩니다. 멤버가 더 많으면 차이가 더 커집니다.
struct Mixed {          struct Sorted {
    char   a;               double d;
    double d;               int    i;
    char   b;               char   a;
    int    i;               char   b;
    char   c;               char   c;
};                      };
struct Mixed : 32 바이트 (a 0, d 8, b 16, i 20, c 24)
struct Sorted: 16 바이트 (d 0, i 8, a 12, b 13, c 14)
똑같은 다섯 멤버가 32바이트와 16바이트, 정확히 두 배 차이입니다. Mixed 는 char 1바이트 뒤에 double 을 8번 자리로 밀려고 7바이트를 비우는 일을 되풀이하기 때문입니다. 구조체 하나에서는 16바이트지만, 이런 구조체 100만 개를 배열로 두면 16MB 차이가 납니다.
그래서 실무의 요령은 간단합니다. 멤버를 큰 자료형부터 작은 자료형 순서로 적으면 패딩이 최소가 됩니다. 물론 읽기 좋은 순서(관련된 멤버끼리)가 더 중요한 경우가 많으니, 메모리가 정말 중요한 구조체에서만 신경 쓰면 됩니다.
2.5 컴파일러에게 패딩을 알려 달라고 하기
패딩이 어디 생겼는지 매번 offsetof 로 찍기는 번거롭습니다. GCC의 -Wpadded 옵션을 주면 패딩이 생기는 곳마다 알려 줍니다.
$ gcc -Wpadded -c wp.c -o /dev/null
wp.c:3:10: warning: padding struct to align ‘b’ [-Wpadded]
    3 |     int  b;
      |          ^
wp.c:5:1: warning: padding struct size to alignment boundary with 3 bytes [-Wpadded]
    5 | };
      | ^
첫 경고는 “b 를 정렬하려고 패딩을 넣었다”, 둘째는 “구조체 끝을 정렬 경계에 맞추려고 3바이트를 넣었다”입니다. 패딩 자체는 잘못이 아니라서 -Wall 에는 들어 있지 않습니다. 구조체 크기를 줄이고 싶을 때만 켜 보는 옵션입니다. (-c 는 1주차 7절에서 본 “링크하지 말고 오브젝트 파일까지만”, -o /dev/null 은 “결과물은 버려라”라는 뜻입니다.)
2.6 끝에 붙는 패딩은 왜 필요할까 — 배열 때문
struct Bad 끝의 3바이트 패딩은 뒤에 멤버도 없는데 왜 있을까요? 구조체 배열을 생각하면 답이 나옵니다.
배열의 원소는 빈틈없이 연달아 놓입니다. struct Bad 가 끝 패딩 없이 9바이트라면, 배열의 두 번째 원소는 9번 주소에서 시작하고, 그 안의 b 는 9 + 4 = 13번 주소에 놓입니다. 13은 4의 배수가 아닙니다! 모든 원소의 모든 멤버가 정렬되려면, 구조체 크기 자체가 가장 큰 멤버의 정렬 요구의 배수여야 합니다. 그래서 12로 맞춘 것입니다.
실제로 구조체 배열의 원소 주소를 찍어 보면, 정확히 구조체 크기만큼씩 떨어져 있습니다.
typedef struct {
    char name[32];
    int  score;
} Student;

Student s[3] = {{"김철수", 85}, {"이영희", 92}, {"박민수", 78}};
sizeof(Student) = 36, sizeof(s) = 108, 원소 수 = 3
&s[0] = 0x7ffc87d05670  (s[0] 에서 0 바이트)
&s[1] = 0x7ffc87d05694  (s[0] 에서 36 바이트)
&s[2] = 0x7ffc87d056b8  (s[0] 에서 72 바이트)
p + 1 은 s[0] 에서 36 바이트 뒤
주소 값은 실행할 때마다 다르지만, 간격은 항상 36바이트입니다. Student 는 32 + 4 = 36이고 36은 4의 배수라 끝 패딩이 필요 없었습니다. 그리고 마지막 줄을 보세요. Student *p 에 1을 더하면 1바이트가 아니라 36바이트 뒤로 갑니다. 6주차에 배운 “포인터에 1을 더하면 가리키는 자료형 크기만큼 이동한다”가 구조체에도 그대로 적용됩니다. sizeof s / sizeof s[0] 으로 원소 수를 구하는 4주차의 요령도 똑같이 통합니다.
패딩을 기억해야 할 순간들
- 구조체를 바이트 그대로 비교할 때 (
memcmp): 패딩의 쓰레기 값 때문에 틀린 답이 나올 수 있습니다.- 구조체를 파일에 통째로 저장할 때 (9주차
fwrite): 패딩 바이트까지 파일에 들어갑니다. 컴파일러나 CPU가 다른 컴퓨터에서 읽으면 멤버 위치가 어긋날 수 있습니다.- 구조체를 네트워크로 보낼 때 (21주차): 같은 이유로, 구조체를 그대로 보내지 않고 멤버를 하나씩 정해진 순서로 보냅니다.
10주차에서
void *로 아무 자료형이나 담는 범용 자료구조를 만들 때, 이 정렬 규칙을 한 번 더 깊이 다룹니다.
3. typedef로 구조체 이름 다듬기
3.1 typedef — 자료형에 별명 붙이기
매번 struct Person 이라고 쓰는 것은 은근히 번거롭습니다. 그런데 struct 를 빼면 컴파일러가 못 알아듣습니다.
$ gcc -Wall -Wextra -std=c11 nostruct.c -o nostruct
nostruct.c: In function ‘main’:
nostruct.c:9:5: error: unknown type name ‘Person’; use ‘struct’ keyword to refer to the type
    9 |     Person p = {"김철수", 25};
      |     ^~~~~~
      |     struct
...
“Person 이라는 자료형은 모른다. struct 키워드를 붙여라”라고, 고칠 곳까지 알려 줍니다. C에서 구조체 태그는 일반 이름과 따로 관리되는 이름 공간에 들어가기 때문입니다. Person 만으로는 찾지 못하고, struct Person 이라고 해야 찾습니다. (이 오류 하나 때문에 뒤따라 경고와 오류가 몇 개 더 나오는데, 1주차 10절에서 배운 대로 첫 오류만 고치면 전부 사라집니다.)
typedef 는 이미 있는 자료형에 새 이름(별명) 을 붙여 주는 문법입니다. 구조체에 쓰기 전에 단순한 예부터 봅시다.
typedef unsigned int uint;   // 이제 unsigned int 대신 uint 라고 써도 된다
uint count = 10;
모양을 보세요. 변수 선언 앞에 typedef 를 붙이면, 변수 이름 자리에 쓴 단어가 자료형의 새 이름이 됩니다. unsigned int uint; 는 “uint 라는 변수”지만, typedef unsigned int uint; 는 “uint 라는 자료형 이름”입니다. 새 자료형을 만드는 게 아니라 별명을 붙일 뿐이라서, uint 와 unsigned int 는 완전히 같은 타입입니다.
이미 여러분이 쓰고 있는 size_t 도 typedef 로 만든 이름입니다. 1주차 7절에서 본 전처리된 hello.i 파일에 typedef 가 수십 개 들어 있던 것을 기억하나요? 표준 라이브러리는 이렇게 이름을 붙여서 “크기를 나타내는 값”(size_t)처럼 뜻이 드러나는 자료형 이름을 제공합니다.
3.2 구조체에 typedef 쓰기 — 세 가지 모양
구조체에 typedef 를 붙이는 모양은 세 가지입니다.
/* 모양 1: 정의 따로, typedef 따로 */
struct Point {
    double x;
    double y;
};
typedef struct Point Point;       // "struct Point" 에 "Point" 라는 별명

/* 모양 2: 정의와 typedef 를 한 번에 (태그 있음) */
typedef struct Point {
    double x;
    double y;
} Point;

/* 모양 3: 태그 없이 (익명 구조체에 별명만) */
typedef struct {
    double x;
    double y;
} Point;
셋 다 이후로 Point p = {3.0, 4.0}; 처럼 struct 없이 쓸 수 있게 해 줍니다. 차이는 이렇습니다.
| 모양 | struct Point 로도 쓸 수 있나 |
자기 자신을 가리키는 멤버를 넣을 수 있나 |
|---|---|---|
| 1, 2 (태그 있음) | 예 | 예 |
| 3 (태그 없음) | 아니오 | 아니오 |
이 강좌는 보통 모양 3을 쓰고, 자기 자신을 가리켜야 할 때만 모양 2를 씁니다. 모양 1과 2에서 태그 이름과 별명을 똑같이 Point 로 지어도 되는 이유는 3.1에서 말한 대로 둘이 다른 이름 공간에 살기 때문입니다.
리눅스 커널 코딩 스타일처럼 구조체에
typedef를 쓰지 말라는 곳도 있습니다.struct가 붙어 있어야 “이건 구조체구나”를 바로 알 수 있다는 이유입니다. 둘 다 흔하니 읽을 줄만 알면 됩니다. 18주차부터 볼 리눅스 시스템 함수들은struct stat,struct timespec처럼struct를 붙이는 쪽입니다.
3.3 자기참조 구조체에는 태그 이름이 필요하다
구조체가 자기 자신과 같은 종류의 구조체를 가리키는 포인터를 멤버로 가져야 할 때가 있습니다. 연결 리스트의 노드가 대표적입니다. 노드마다 “다음 노드”를 가리켜야 하죠. 태그 없는 모양 3으로 써 보면 이렇게 됩니다.
typedef struct {
    int value;
    Node *next;
} Node;
$ gcc -Wall -Wextra -std=c11 anonself.c -o anonself
anonself.c:5:5: error: unknown type name ‘Node’
    5 |     Node *next;
      |     ^~~~
“Node 라는 자료형은 모른다.” 별명 Node 는 맨 아래 } Node; 에 도달해야 비로소 생깁니다. 그런데 next 멤버는 그보다 위에서, 구조체 정의가 아직 진행 중일 때 등장합니다. 아직 태어나지 않은 이름을 쓴 것입니다.
해결책은 태그 이름을 주는 것입니다. 태그는 struct Node { 를 읽는 순간 이미 알려지기 때문에, 정의 도중에도 struct Node 라고 부를 수 있습니다.
typedef struct Node {
    int value;
    struct Node *next;   // 태그 이름으로 자기 자신을 가리킨다
} Node;                  // 여기서부터는 Node 라고 불러도 된다
그런데 아직 크기도 다 정해지지 않은 구조체를 어떻게 멤버로 쓸 수 있을까요? 비밀은 포인터라는 데 있습니다. 포인터는 무엇을 가리키든 크기가 8바이트로 정해져 있어서, 가리키는 대상의 크기를 몰라도 칸을 만들 수 있습니다. 반대로 포인터가 아니라 struct Node next; 처럼 자기 자신을 통째로 멤버로 넣는 것은 불가능합니다. 노드 안에 노드가 있고 그 안에 또 노드가 있어서, 크기가 끝없이 커지니까요.
이 패턴은 10주차의 연결 리스트, 11주차의 스택과 큐, 12주차의 트리까지 계속 나오니 눈에 익혀 두세요.
3.4 예제: struct_typedef.c
전체 실행 코드:
examples/struct_typedef.c
#include <stdio.h>
#include <math.h>

/* 방법 1: 구조체 정의와 typedef를 한 번에
 * 이제 'struct Point' 대신 'Point'만 써도 된다. */
typedef struct {
    double x;
    double y;
} Point;

/* 방법 2: 태그 이름과 typedef 별칭을 모두 주는 방식.
 * 자기 자신을 가리키는 포인터가 필요한 경우(연결 리스트 등)에는
 * 태그 이름(struct Node)이 반드시 필요하다. */
typedef struct Node {
    int value;
    struct Node *next;   /* typedef 별칭 Node는 이 시점에 아직 미완성이라 struct Node 사용 */
} Node;

/* 두 점 사이의 거리 */
double distance(Point a, Point b) {
    double dx = a.x - b.x;
    double dy = a.y - b.y;
    return sqrt(dx * dx + dy * dy);
}

int main(void) {
    /* struct 키워드 없이 바로 사용 */
    Point origin = {0.0, 0.0};
    Point p = {3.0, 4.0};

    printf("=== typedef 구조체 ===\n");
    printf("원점(%.1f, %.1f)과 점(%.1f, %.1f) 사이 거리: %.2f\n",
           origin.x, origin.y, p.x, p.y, distance(origin, p));

    /* 태그 이름을 사용하는 자기참조 구조체 */
    Node c = {30, NULL};
    Node b = {20, &c};
    Node a = {10, &b};

    printf("\n연결된 노드 순회: ");
    for (Node *cur = &a; cur != NULL; cur = cur->next) {
        printf("%d ", cur->value);
    }
    printf("\n");

    return 0;
}
$ ./build/struct_typedef
=== typedef 구조체 ===
원점(0.0, 0.0)과 점(3.0, 4.0) 사이 거리: 5.00

연결된 노드 순회: 10 20 30
코드 읽기 포인트
sqrt는<math.h>의 제곱근 함수입니다. 수학 라이브러리를 쓰므로 링크할 때-lm이 필요합니다.Makefile의LDFLAGS = -lm이 그 역할입니다. 직접 컴파일한다면gcc ... struct_typedef.c -o struct_typedef -lm처럼 끝에 붙이세요. 빼먹으면 1주차 10절에서 본undefined reference to 'sqrt'링크 오류가 납니다.- 노드 세 개를 거꾸로 만든 점을 보세요.
c를 먼저 만들어야b가&c를 가리킬 수 있고,b가 있어야a가&b를 가리킬 수 있습니다. for (Node *cur = &a; cur != NULL; cur = cur->next)는 연결 리스트를 순회하는 관용구입니다. “첫 노드에서 시작해서,NULL이 아닌 동안, 다음 노드로 옮겨 가며”라고 읽습니다.->는 5절에서 설명합니다.
메모리로 그리면 이렇게 이어져 있습니다.
   a                  b                  c
┌───────┬──────┐   ┌───────┬──────┐   ┌───────┬──────┐
│ 10    │ next ─┼──▶│ 20    │ next ─┼──▶│ 30    │ NULL │
└───────┴──────┘   └───────┴──────┘   └───────┴──────┘
4. 구조체 배열
4.1 같은 종류를 여러 개 다루기
학생 한 명이 Student 라면, 학생 여러 명은 Student 배열입니다. 들어가며에서 말한 병렬 배열의 문제가 여기서 사라집니다. 배열의 각 원소가 하나의 완결된 학생이니, 인덱스가 어긋나 정보가 섞일 일이 없습니다.
typedef struct {
    char name[32];
    int  score;
} Student;

Student students[5] = {
    {"김철수", 85},
    {"이영희", 92},
    {"박민수", 78},
    {"최지우", 95},
    {"정해인", 88}
};
초기화는 배열의 중괄호 안에 구조체의 중괄호가 들어간 이중 중괄호입니다. 바깥 { } 가 배열, 안쪽 { } 하나가 학생 한 명입니다.
각 원소는 students[i] 로, 그 멤버는 students[i].name 처럼 접근합니다. [] 로 몇 번째 학생인지 고르고, . 으로 그 학생의 어느 칸인지 고르는 것입니다. 두 연산자는 왼쪽부터 차례로 적용됩니다.
students[2].name
└──┬───┘└┬┘└─┬┘
   │     │   └─ 그 학생의 name 칸
   │     └───── 2번 원소 (세 번째 학생)
   └─────────── 학생 배열
메모리에서는 2.6에서 확인한 대로 학생들이 36바이트 간격으로 빈틈없이 줄지어 있습니다.
4.2 예제: struct_array.c
구조체 배열로 합계, 평균, 최댓값, 조건 필터링을 해 봅니다. 모두 4주차에서 배열로 하던 일인데, 비교 대상이 “값”이 아니라 “구조체의 특정 멤버”라는 점만 다릅니다.
전체 실행 코드:
examples/struct_array.c
#include <stdio.h>
#include <string.h>

typedef struct {
    char name[32];
    int  score;
} Student;

int main(void) {
    /* 구조체 배열을 선언과 동시에 초기화.
     * 각 원소를 {} 로 감싸 학생 한 명씩 지정한다. */
    Student students[5] = {
        {"김철수", 85},
        {"이영희", 92},
        {"박민수", 78},
        {"최지우", 95},
        {"정해인", 88}
    };
    int count = 5;

    printf("=== 학생 명단 ===\n");
    for (int i = 0; i < count; i++) {
        printf("%d번 %s: %d점\n", i + 1, students[i].name, students[i].score);
    }

    /* 평균 계산 */
    int total = 0;
    for (int i = 0; i < count; i++) {
        total += students[i].score;
    }
    double average = (double)total / count;
    printf("\n평균 점수: %.2f점\n", average);

    /* 최고 점수 학생 찾기 (인덱스를 기억) */
    int best = 0;
    for (int i = 1; i < count; i++) {
        if (students[i].score > students[best].score) {
            best = i;
        }
    }
    printf("최고 점수: %s (%d점)\n", students[best].name, students[best].score);

    /* 평균 이상인 학생 표시 */
    printf("\n평균 이상 학생:\n");
    for (int i = 0; i < count; i++) {
        if (students[i].score >= average) {
            printf("  - %s (%d점)\n", students[i].name, students[i].score);
        }
    }

    return 0;
}
$ ./build/struct_array
=== 학생 명단 ===
1번 김철수: 85점
2번 이영희: 92점
3번 박민수: 78점
4번 최지우: 95점
5번 정해인: 88점

평균 점수: 87.60점
최고 점수: 최지우 (95점)

평균 이상 학생:
  - 이영희 (92점)
  - 최지우 (95점)
  - 정해인 (88점)
코드 읽기 포인트
(double)total / count:total과count가 둘 다int라서, 그냥 나누면 2주차에서 배운 정수 나눗셈이 되어 소수점이 버려집니다(438 / 5 = 87). 한쪽을double로 바꿔야 87.60이 나옵니다.- 최고 점수를 찾을 때 값이 아니라 인덱스(
best)를 기억합니다. 점수 95만 기억해서는 “누가” 95점인지 알 수 없습니다. 인덱스를 기억하면students[best].name으로 이름을 포함한 모든 정보를 꺼낼 수 있습니다. 구조체 배열에서 아주 자주 쓰는 요령입니다. students[i].score >= average:int와double을 비교하면int가double로 바뀐 뒤 비교됩니다. 85 >= 87.6 은 거짓이라 김철수는 빠졌습니다.
직접 해 보기
- 학생을 한 명 더 추가하고,
count를 직접 고치는 대신int count = sizeof students / sizeof students[0];으로 바꿔 보세요. 원소 수를 컴파일러가 세어 줍니다. - 최저 점수 학생도 찾아서 출력해 보세요.
- 도전: 3주차에서 배운 반복문으로 점수 순으로 정렬해 보세요. 두 원소를 바꿀 때
Student tmp = students[i]; students[i] = students[j]; students[j] = tmp;처럼 구조체를 통째로 바꾸면 이름과 점수가 함께 움직입니다. 병렬 배열이었다면 배열마다 따로 바꿔야 했을 겁니다.
5. 구조체 포인터와 화살표(->) 연산자
5.1 구조체를 가리키는 포인터
6주차에서 int *p = &x; 로 정수를 가리키는 포인터를 만들었습니다. 구조체도 똑같습니다.
Person kim = {"김철수", 25};
Person *ptr = &kim;       // kim 이 있는 곳의 주소를 담는다
ptr 은 Person 을 가리키는 포인터입니다. 크기는 다른 포인터와 마찬가지로 8바이트이고, 안에는 kim 의 시작 주소가 들어 있습니다. 그럼 ptr 을 통해 kim 의 나이를 읽으려면 어떻게 할까요? 6주차대로라면 *ptr 이 “가리키는 대상”, 즉 kim 이니 거기에 .age 를 붙이면 됩니다.
(*ptr).age // ptr 이 가리키는 구조체의 age
괄호가 반드시 필요합니다. 괄호 없이 *ptr.age 라고 쓰면 어떻게 될까요?
$ gcc -Wall -Wextra -std=c11 noparen.c -o noparen
noparen.c: In function ‘main’:
noparen.c:11:24: error: ‘ptr’ is a pointer; did you mean to use ‘->’?
   11 |     printf("%d\n", *ptr.age);
      |                        ^
      |                        ->
점(.)이 별표(*)보다 먼저 적용되기 때문입니다(연산자 우선순위). 그래서 컴파일러는 *ptr.age 를 *(ptr.age), “포인터 ptr 의 age 멤버를 역참조”로 읽습니다. 포인터에는 멤버가 없으니 오류입니다. 친절하게도 GCC는 “ptr 은 포인터인데, -> 를 쓰려던 것 아니냐”고 고칠 방법까지 알려 줍니다.
5.2 화살표 연산자 ->
(*ptr).age 는 괄호 때문에 쓰기도 읽기도 불편합니다. 구조체 포인터는 C 코드에서 너무 자주 쓰여서, C는 이것만을 위한 전용 연산자를 준비해 두었습니다. 화살표 -> 입니다.
ptr->age // (*ptr).age 와 완전히 같은 뜻
-> 는 - 와 > 두 글자를 붙여 쓴 연산자로, 이름 그대로 “포인터가 가리키는 곳의 멤버”입니다. 정리하면 규칙은 딱 하나입니다.
| 왼쪽에 있는 것 | 쓰는 연산자 | 예 |
|---|---|---|
| 구조체 변수 | 점 . |
kim.age |
| 구조체를 가리키는 포인터 | 화살표 -> |
ptr->age |
반대로 쓰면 컴파일러가 바로 잡아 줍니다.
$ gcc -Wall -Wextra -std=c11 dotarrow.c -o dotarrow
dotarrow.c: In function ‘main’:
dotarrow.c:11:6: error: ‘p’ is a pointer; did you mean to use ‘->’?
   11 |     p.age = 30;
      |      ^
      |      ->
dotarrow.c:12:8: error: invalid type argument of ‘->’ (have ‘Person’)
   12 |     kim->age = 31;
      |        ^~
첫 오류는 “포인터에 점을 썼다”, 둘째는 “-> 는 포인터에 쓰는 건데 Person(구조체 그 자체)에 썼다”입니다. 오류 메시지만 보고도 어느 쪽을 바꿔야 할지 알 수 있으니 겁먹을 필요 없습니다.
5.3 포인터로 원본 바꾸기
6주차에서 배운 “포인터로 넘기면 함수가 원본을 바꿀 수 있다”가 구조체에도 그대로 적용됩니다. 읽기만 하는 함수는 const 를 붙여서 받습니다(6주차 8절).
전체 실행 코드:
examples/struct_pointer.c
#include <stdio.h>
#include <string.h>

typedef struct {
    char name[32];
    int  age;
} Person;

/* 포인터로 받으면 원본을 직접 수정할 수 있다.
 * (값으로 받으면 복사본만 바뀌어 원본은 그대로다.) */
void birthday(Person *p) {
    p->age += 1;   /* (*p).age += 1 과 같은 의미 */
}

/* 읽기만 할 때는 const 포인터로 받아 실수로 수정하는 것을 막는다.
 * 큰 구조체를 값으로 넘기면 통째로 복사되어 느리므로 포인터가 효율적이다. */
void print_person(const Person *p) {
    printf("%s (%d세)\n", p->name, p->age);
}

int main(void) {
    Person kim = {"김철수", 25};

    /* 구조체 변수의 주소를 포인터에 저장 */
    Person *ptr = &kim;

    printf("=== 구조체 포인터 ===\n");
    /* 세 가지 표기법이 모두 같은 값을 출력한다 */
    printf("kim.age      = %d\n", kim.age);
    printf("(*ptr).age   = %d\n", (*ptr).age);
    printf("ptr->age     = %d\n", ptr->age);

    /* 포인터를 통해 원본 수정 */
    printf("\n생일 전: ");
    print_person(ptr);
    birthday(ptr);
    printf("생일 후: ");
    print_person(ptr);
    printf("원본도 바뀜: kim.age = %d\n", kim.age);

    return 0;
}
$ ./build/struct_pointer
=== 구조체 포인터 ===
kim.age      = 25
(*ptr).age   = 25
ptr->age     = 25

생일 전: 김철수 (25세)
생일 후: 김철수 (26세)
원본도 바뀜: kim.age = 26
세 표기가 같은 값을 읽고, birthday 가 포인터로 받은 덕분에 main 의 kim 이 실제로 한 살 늘었습니다.
직접 해 보기: print_person 안에 p->age = 100; 을 넣고 컴파일해 보세요. const 로 받았기 때문에 error: assignment of member ‘age’ in read-only object 가 납니다. “이 함수는 원본을 바꾸지 않는다”는 약속을 컴파일러가 지켜 주는 것입니다.
6. 구조체와 함수: 값이냐 포인터냐
6.1 두 가지 전달 방식을 주소로 확인하기
구조체를 함수에 넘기는 방법은 두 가지입니다.
- 값 전달(pass by value):
void f(Person p). 구조체 전체가 복사되어 함수로 갑니다. - 포인터 전달(pass by pointer):
void f(Person *p). 주소만 넘어갑니다.
말로만 들으면 와닿지 않으니, 함수 안에서 받은 것의 주소를 찍어 봅시다. pass.c:
#include <stdio.h>

typedef struct {
    char name[50];
    int  age;
    double height;
} Person;

void by_value(Person p) {
    printf("  by_value   안의 p 주소: %p\n", (void *)&p);
    p.age = 99;
}

void by_pointer(Person *p) {
    printf("  by_pointer 가 받은 주소: %p\n", (void *)p);
    p->age = 99;
}

int main(void) {
    Person kim = {"김철수", 25, 175.5};
    printf("main 의 kim 주소:          %p\n", (void *)&kim);
    by_value(kim);
    printf("by_value 후 kim.age = %d\n", kim.age);
    by_pointer(&kim);
    printf("by_pointer 후 kim.age = %d\n", kim.age);
    printf("넘기는 크기: 값 %zu 바이트, 포인터 %zu 바이트\n", sizeof(Person), sizeof(Person *));
    return 0;
}
$ gcc -Wall -Wextra -std=c11 pass.c -o pass && ./pass
main 의 kim 주소:          0x7ffc76699ba0
  by_value   안의 p 주소: 0x7ffc76699b60
by_value 후 kim.age = 25
  by_pointer 가 받은 주소: 0x7ffc76699ba0
by_pointer 후 kim.age = 99
넘기는 크기: 값 64 바이트, 포인터 8 바이트
주소 값은 실행할 때마다 다르지만, 관계는 항상 같습니다.
by_value안의p는kim과 다른 주소(...b60)에 있습니다. 64바이트짜리 사본이 새로 만들어진 것입니다. 그래서 사본의 나이를 99로 바꿔도kim은 25 그대로입니다.by_pointer가 받은 주소는kim의 주소(...ba0)와 똑같습니다. 같은 메모리를 보고 있으니 바꾸면 원본이 바뀝니다.- 마지막 줄: 값 전달은 호출할 때마다 64바이트를 복사하고, 포인터 전달은 8바이트(주소 하나)만 넘깁니다.
Person 은 64바이트라 차이가 작아 보이지만, 13절의 데이터베이스 프로젝트에 나오는 Database 구조체는 레코드 100개를 품고 있어 sizeof 가 10,408바이트입니다. 그런 구조체를 값으로 넘기면 함수를 부를 때마다 1만 바이트를 복사합니다.
6.2 구조체를 돌려주는 함수
값 전달에도 장점이 있습니다. 원본을 건드리지 않고 새 결과를 만들어 돌려줄 수 있다는 것입니다. C 함수는 구조체를 통째로 반환할 수도 있습니다.
전체 실행 코드:
examples/struct_function.c
#include <stdio.h>

typedef struct {
    double x;
    double y;
} Vector;

/* 값 전달: v 는 복사본. 여기서 바꿔도 호출한 쪽 원본은 안 바뀐다. */
Vector scale_by_value(Vector v, double factor) {
    v.x *= factor;
    v.y *= factor;
    return v;   /* 새 결과를 반환 (구조체도 반환값이 될 수 있다) */
}

/* 포인터 전달: 원본을 직접 수정 */
void scale_in_place(Vector *v, double factor) {
    v->x *= factor;
    v->y *= factor;
}

/* 읽기 전용은 const 포인터: 복사 없이 넘기되 수정은 막는다 */
double magnitude_squared(const Vector *v) {
    return v->x * v->x + v->y * v->y;
}

int main(void) {
    Vector a = {3.0, 4.0};

    printf("=== 값 전달 ===\n");
    Vector b = scale_by_value(a, 2.0);
    printf("반환값 b: (%.1f, %.1f)\n", b.x, b.y);   /* (6, 8) */
    printf("원본 a:   (%.1f, %.1f)\n", a.x, a.y);   /* (3, 4) 그대로 */

    printf("\n=== 포인터 전달 ===\n");
    scale_in_place(&a, 2.0);
    printf("원본 a:   (%.1f, %.1f)\n", a.x, a.y);   /* (6, 8) 바뀜 */

    printf("\n크기의 제곱: %.1f\n", magnitude_squared(&a));  /* 6*6+8*8=100 */

    return 0;
}
$ ./build/struct_function
=== 값 전달 ===
반환값 b: (6.0, 8.0)
원본 a:   (3.0, 4.0)

=== 포인터 전달 ===
원본 a:   (6.0, 8.0)

크기의 제곱: 100.0
scale_by_value 는 a 를 그대로 두고 두 배 된 새 벡터 b 를 돌려줬고, scale_in_place 는 a 자체를 두 배로 만들었습니다. 같은 “두 배로 만들기”인데 쓰임새가 다릅니다. “원본은 두고 새 값을 얻고 싶다”면 앞쪽, “원본을 바꾸고 싶다”면 뒤쪽입니다.
6.3 어느 쪽을 쓸까
| 상황 | 방식 | 예 |
|---|---|---|
| 원본을 바꿔야 한다 | 포인터 | void scale_in_place(Vector *v, ...) |
| 읽기만 한다 | const 포인터 |
double magnitude_squared(const Vector *v) |
| 아주 작고, 새 값을 만들어 돌려주는 게 자연스럽다 | 값 | Vector scale_by_value(Vector v, ...) |
특별한 이유가 없으면 구조체는 포인터(읽기만 하면 const 포인터)로 받는 것이 기본이라고 기억하세요. 18주차부터 볼 리눅스 시스템 함수들도 거의 전부 구조체를 포인터로 주고받습니다. 예를 들어 파일 정보를 얻는 stat(경로, &정보구조체) 는 우리가 만든 구조체의 주소를 받아서 그 안을 채워 줍니다.
7. 구조체 동적 할당
7.1 실행 중에 개수를 정하기
지금까지는 Student students[5] 처럼 개수를 미리 정했습니다. 하지만 학생이 몇 명일지는 프로그램을 실행해 봐야 아는 경우가 대부분입니다. 7주차에서 배운 malloc / calloc / realloc 을 구조체에 그대로 쓰면 됩니다.
Book *b = malloc(sizeof(Book));   // Book 하나 크기만큼 힙에 공간을 잡는다
if (b == NULL) {                  // 실패 확인은 필수
    fprintf(stderr, "메모리 할당 실패\n");
    return 1;
}
strcpy(b->title, "C 프로그래밍");   // 포인터니까 화살표
b->year = 2024;

free(b);    // 다 쓰면 반드시 해제
b = NULL;   // 해제한 주소를 다시 쓰지 않도록
하나씩 짚어 봅시다.
sizeof(Book): 몇 바이트를 달라고 할지 직접 계산하지 않습니다. 2절에서 봤듯 패딩 때문에 크기는 멤버 합과 다를 수 있으니, 항상sizeof에게 맡깁니다.Book은char[64]+char[32]+int= 100바이트이고, 100은 4의 배수라 패딩이 없습니다.- 돌려받은 주소는
Book *에 담습니다. 그래서 멤버 접근은 5절의 규칙대로->입니다. free(b)다음의b = NULL: 해제한 뒤에도b에는 옛 주소가 그대로 남아 있습니다. 실수로 다시 쓰면 7주차의 “해제 후 사용(use after free)” 버그가 됩니다.NULL을 넣어 두면, 실수로 쓰는 순간 바로 죽어서 버그를 빨리 찾을 수 있습니다.
7.2 구조체 배열 동적 할당
개수를 실행 중에 정할 수 있다는 것이 동적 할당의 핵심입니다.
int n = 3;   // 실행 중에 정해진 값이라고 생각하자
Book *shelf = calloc(n, sizeof(Book));   // Book n개를, 전부 0으로 채워서
strcpy(shelf[0].title, "운영체제");      // 일반 배열처럼 shelf[i].멤버
free(shelf);
calloc(개수, 하나의크기) 는 malloc 과 달리 받은 메모리를 모두 0으로 채워 줍니다. 1.3에서 본 {0} 초기화와 같은 효과라서, 모든 제목이 빈 문자열, 모든 연도가 0인 상태로 시작합니다.
돌려받은 shelf 는 Book * 인데, 6주차에서 배운 대로 포인터에 [i] 를 붙이면 배열처럼 쓸 수 있습니다. shelf[i] 는 *(shelf + i) 와 같고, 2.6에서 본 대로 shelf + i 는 i × 100 바이트 뒤를 가리킵니다. 그래서 shelf[i].title 과 (shelf + i)->title 은 같은 칸입니다. 대괄호 쪽이 읽기 쉬우니 보통 그쪽을 씁니다.
7.3 예제: struct_dynamic.c
전체 실행 코드:
examples/struct_dynamic.c
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

typedef struct {
    char title[64];
    char author[32];
    int  year;
} Book;

int main(void) {
    /* 1) 구조체 하나를 동적 할당
     * sizeof(Book)만큼 힙에 공간을 잡고, 그 주소를 포인터로 받는다. */
    Book *b = malloc(sizeof(Book));
    if (b == NULL) {                 /* 할당 실패 시 반드시 확인 */
        fprintf(stderr, "메모리 할당 실패\n");
        return 1;
    }
    strcpy(b->title, "C 프로그래밍");
    strcpy(b->author, "홍길동");
    b->year = 2024;

    printf("=== 동적 할당한 구조체 ===\n");
    printf("%s / %s / %d\n", b->title, b->author, b->year);

    free(b);      /* 다 쓰면 해제 */
    b = NULL;     /* 해제 후 NULL 로 (dangling pointer 방지) */

    /* 2) 구조체 배열을 동적 할당
     * 개수(n)를 실행 중에 정할 수 있다는 것이 핵심이다. */
    int n = 3;
    Book *shelf = calloc(n, sizeof(Book));   /* calloc 은 0 으로 초기화까지 해준다 */
    if (shelf == NULL) {
        fprintf(stderr, "메모리 할당 실패\n");
        return 1;
    }

    strcpy(shelf[0].title, "운영체제");
    shelf[0].year = 2020;
    strcpy(shelf[1].title, "네트워크");
    shelf[1].year = 2021;
    strcpy(shelf[2].title, "알고리즘");
    shelf[2].year = 2022;

    printf("\n=== 동적 구조체 배열 ===\n");
    for (int i = 0; i < n; i++) {
        /* 배열 원소는 shelf[i], 그 멤버는 shelf[i].title
         * (shelf + i)->title 로도 접근 가능하다 */
        printf("%d) %s (%d)\n", i + 1, shelf[i].title, shelf[i].year);
    }

    free(shelf);
    shelf = NULL;

    return 0;
}
$ ./build/struct_dynamic
=== 동적 할당한 구조체 ===
C 프로그래밍 / 홍길동 / 2024

=== 동적 구조체 배열 ===
1) 운영체제 (2020)
2) 네트워크 (2021)
3) 알고리즘 (2022)
free 를 빠짐없이 했는지는 7주차에서 배운 valgrind 로 확인합니다.
$ valgrind --leak-check=full ./build/struct_dynamic
...
==PID== HEAP SUMMARY:
==PID==     in use at exit: 0 bytes in 0 blocks
==PID==   total heap usage: 3 allocs, 3 frees, 4,496 bytes allocated
==PID== All heap blocks were freed -- no leaks are possible
==PID== ERROR SUMMARY: 0 errors from 0 contexts (suppressed: 0 from 0)
(==PID== 자리에는 실행할 때마다 다른 프로세스 번호가 찍힙니다.)
“할당 3번, 해제 3번”. 그런데 우리 코드의 할당은 malloc 과 calloc 두 번뿐입니다. 하나는 어디서 왔을까요? 바이트 수를 계산해 보면 답이 나옵니다. Book 하나 100바이트 + Book 셋 300바이트 = 400바이트인데, 합계는 4,496바이트입니다. 나머지 4,096바이트는 printf 가 화면 출력을 모아 두려고 스스로 잡은 출력 버퍼입니다. 9주차 파일 입출력에서 이 버퍼가 왜 필요한지 다룹니다. 이 버퍼는 프로그램이 끝날 때 C 라이브러리가 알아서 정리하니 걱정할 필요 없습니다.
실험: free 를 잊으면?
leak.c 에서 malloc 만 하고 free 를 빼 봅시다.
$ valgrind --leak-check=full ./leak
...
==PID== HEAP SUMMARY:
==PID==     in use at exit: 100 bytes in 1 blocks
==PID==   total heap usage: 2 allocs, 1 frees, 4,196 bytes allocated
==PID== 100 bytes in 1 blocks are definitely lost in loss record 1 of 1
==PID==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==PID==    by 0x10917E: main (leak.c:12)
==PID== LEAK SUMMARY:
==PID==    definitely lost: 100 bytes in 1 blocks
...
==PID== ERROR SUMMARY: 1 errors from 1 contexts (suppressed: 0 from 0)
“leak.c 12번째 줄의 malloc 에서 잡은 100바이트(= sizeof(Book))가 확실히 새어 나갔다(definitely lost).” 새어 나간 크기가 정확히 구조체 하나 크기라서, 어떤 구조체를 해제하지 않았는지 바로 짐작할 수 있습니다. 줄 번호가 나오는 것은 1주차에서 배운 -g 옵션 덕분입니다.
8. 중첩 구조체
구조체의 멤버로 또 다른 구조체를 넣을 수 있습니다. 이를 중첩 구조체라고 합니다. “회사원”은 이름과 생년월일, 주소로 이루어지는데, 생년월일과 주소 자체가 여러 항목으로 된 덩어리입니다.
typedef struct { int year, month, day; } Date;
typedef struct { char city[32], street[64], zipcode[8]; } Address;

typedef struct {
    char    name[32];
    Date    birth;    // 구조체 안의 구조체
    Address addr;     // 구조체 안의 구조체
} Employee;
int year, month, day; 처럼 같은 자료형의 멤버는 한 줄에 쉼표로 이어 선언할 수 있습니다. 평소 변수 선언 int a, b, c; 와 같습니다.
메모리에서는 어떻게 생겼을까요? 중첩 구조체는 멤버 구조체가 통째로 그 자리에 들어 있습니다. 포인터로 연결된 게 아닙니다.
Date 12, Address 104, Employee 148
offsetof(Employee, birth)=32, addr=44, addr.city=44, addr.zipcode=140
Employee (148바이트)
 0            31 32         43 44                                   147
┌──────────────┬─────────────┬────────────────────────────────────────┐
│  name[32]    │   birth     │               addr                     │
│              │ ┌──┬──┬──┐  │ ┌──────────┬───────────────┬─────────┐ │
│              │ │yr│mo│dy│  │ │ city[32] │  street[64]   │ zip[8]  │ │
│              │ └──┴──┴──┘  │ └──────────┴───────────────┴─────────┘ │
└──────────────┴─────────────┴────────────────────────────────────────┘
                 12바이트        44          76              140
Employee 의 크기 148은 name 32 + Date 12 + Address 104 = 148, 멤버의 합과 정확히 같습니다. int 들이 모두 4의 배수 자리에 떨어져 패딩이 필요 없었기 때문입니다. offsetof(Employee, addr.zipcode) 처럼 중첩된 멤버의 위치도 한 번에 물어볼 수 있습니다.
초기화할 때는 중괄호도 중첩합니다. 바깥 구조체의 멤버 자리에 안쪽 구조체의 { } 를 넣는 것입니다.
Employee emp = {
    "김철수",
    {1995, 3, 15},                     // birth
    {"서울", "테헤란로 123", "06234"}   // addr
};
접근할 때는 점을 이어서 씁니다. emp.birth.year 는 왼쪽부터 “emp 의 → birth 의 → year” 입니다.
printf("%d년 %d월 %d일\n", emp.birth.year, emp.birth.month, emp.birth.day);
strcpy(emp.addr.city, "부산");   // 중첩 멤버 수정
포인터와 섞이면 . 과 -> 를 각 단계에 맞게 고릅니다. Employee *e = &emp; 라면 e->birth.year 입니다. e 는 포인터라 ->, birth 는 구조체 변수(포인터가 아닌 멤버)라 . 입니다. 5.2의 규칙을 한 단계씩 적용하면 됩니다.
전체 실행 코드:
examples/struct_nested.c
#include <stdio.h>
#include <string.h>

typedef struct {
    int year;
    int month;
    int day;
} Date;

typedef struct {
    char city[32];
    char street[64];
    char zipcode[8];
} Address;

typedef struct {
    char    name[32];
    Date    birth;     /* 중첩된 구조체 멤버 */
    Address addr;      /* 중첩된 구조체 멤버 */
} Employee;

int main(void) {
    /* 중첩 구조체는 중괄호도 중첩해서 초기화한다 */
    Employee emp = {
        "김철수",
        {1995, 3, 15},                       /* birth */
        {"서울", "테헤란로 123", "06234"}      /* addr  */
    };

    printf("=== 중첩 구조체 ===\n");
    printf("이름: %s\n", emp.name);

    /* 중첩된 멤버는 점을 이어서 접근한다: emp.birth.year */
    printf("생년월일: %d년 %d월 %d일\n",
           emp.birth.year, emp.birth.month, emp.birth.day);
    printf("주소: %s %s (%s)\n",
           emp.addr.city, emp.addr.street, emp.addr.zipcode);

    /* 중첩 멤버 수정 */
    strcpy(emp.addr.city, "부산");
    emp.birth.day = 16;

    printf("\n수정 후:\n");
    printf("생일: %d일, 도시: %s\n", emp.birth.day, emp.addr.city);

    return 0;
}
$ ./build/struct_nested
=== 중첩 구조체 ===
이름: 김철수
생년월일: 1995년 3월 15일
주소: 서울 테헤란로 123 (06234)

수정 후:
생일: 16일, 도시: 부산
직접 해 보기: 회사 정보를 담는 Company 구조체(회사 이름 + Address)를 만들고, Employee 에 Company 멤버를 추가해 emp.company.addr.city 처럼 세 단계로 접근해 보세요. Date 하나만 고치면 생일을 쓰는 모든 곳이 함께 바뀌는 것, 이것이 중첩 구조체로 데이터를 계층화하는 이유입니다.
9. 공용체(union)
9.1 구조체와 무엇이 다른가 — 크기부터
공용체는 구조체와 문법이 거의 같습니다. struct 자리에 union 을 쓸 뿐입니다. 하지만 메모리를 쓰는 방식이 정반대입니다.
- 구조체(
struct): 멤버마다 각자의 칸이 있습니다. 크기 = 멤버들의 합(+ 패딩). - 공용체(
union): 모든 멤버가 같은 칸을 함께 씁니다. 크기 = 가장 큰 멤버의 크기.
똑같은 멤버로 구조체와 공용체를 만들어 크기와 주소를 비교해 봅시다.
union Value {
    int   i;
    float f;
    unsigned char bytes[4];
};

struct Both {
    int   i;
    float f;
    unsigned char bytes[4];
};
sizeof(union Value) = 4, sizeof(struct Both) = 12
주소: &v.i=0x7ffc1d01d094 &v.f=0x7ffc1d01d094 &v.bytes=0x7ffc1d01d094
구조체는 4 + 4 + 4 = 12바이트, 공용체는 4바이트입니다. 그리고 공용체 멤버 세 개의 주소가 전부 같습니다. 세 이름이 같은 4바이트를 가리키는 서로 다른 “안경”인 셈입니다.
struct Both (12바이트)                      union Value (4바이트)
┌────────────┬────────────┬────────────┐    ┌────────────┐
│     i      │     f      │  bytes[4]  │    │ i          │
└────────────┴────────────┴────────────┘    │ f          │ ← 같은 4바이트를
                                            │ bytes[4]   │   세 가지로 읽는다
                                            └────────────┘
9.2 같은 바이트, 다른 해석 — 실제로 보기
같은 칸을 쓴다는 것은 마지막으로 넣은 값이 칸을 차지하고, 다른 멤버로 읽으면 그 바이트들을 다른 자료형으로 해석한 결과가 나온다는 뜻입니다. 값을 하나씩 넣으면서 바이트와 세 가지 해석을 모두 찍어 봅시다.
static void dump(const char *label, const union Value *v) {
    printf("%-14s bytes = %02x %02x %02x %02x | i = %d | f = %g\n", label,
           v->bytes[0], v->bytes[1], v->bytes[2], v->bytes[3], v->i, v->f);
}

union Value v;
v.i = 65;              dump("v.i = 65", &v);
v.i = 0x41424344;      dump("v.i = 0x41424344", &v);
v.f = 3.14f;           dump("v.f = 3.14f", &v);
v.f = 1.0f;            dump("v.f = 1.0f", &v);
v.bytes[3] = 0xc0;     dump("bytes[3]=0xc0", &v);
%g 는 실수를 알맞은 모양(보통 소수 또는 지수 표기)으로 찍어 주는 서식 지정자입니다.
v.i = 65       bytes = 41 00 00 00 | i = 65 | f = 9.10844e-44
v.i = 0x41424344 bytes = 44 43 42 41 | i = 1094861636 | f = 12.1414
v.f = 3.14f    bytes = c3 f5 48 40 | i = 1078523331 | f = 3.14
v.f = 1.0f     bytes = 00 00 80 3f | i = 1065353216 | f = 1
bytes[3]=0xc0  bytes = 00 00 80 c0 | i = -1065353216 | f = -4
한 줄씩 읽어 봅시다.
v.i = 65: 정수 65는 16진수로0x41이고, 2.3에서 본 리틀 엔디언이라41 00 00 00으로 저장됩니다.bytes[0]이0x41, 즉 문자'A'입니다(ASCII 65). 이 바이트들을float으로 읽으면9.1e-44, 0에 아주 가까운 이상한 수가 나옵니다.v.i = 0x41424344: 네 바이트가44 43 42 41, 넣은 순서와 거꾸로 저장됐습니다. 리틀 엔디언이 “작은 자리 바이트(44)가 먼저”라는 것을 가장 잘 보여 주는 예입니다. 이 바이트를 문자로 읽으면D C B A입니다.v.f = 3.14f: 이번엔 실수를 넣었습니다. 3.14의 실수 표현은0x4048f5c3이고, 이것을 정수로 읽으면 1078523331 입니다. 흔히 이 값을 “쓰레기 값”이라고 부르지만 정확하지 않습니다. 몇 번을 실행해도 항상 같은 값이 나옵니다. 3.14를 나타내는 비트 32개를 정수의 규칙으로 읽은, 정해진 결과입니다.v.f = 1.0f: 1.0은3f 80 00 00, 정수로는 1065353216입니다. 실수 1과 정수 1은 비트가 전혀 다릅니다. 컴퓨터가 정수와 실수를 완전히 다른 규칙(실수는 IEEE 754라는 표준 형식)으로 저장한다는 증거입니다.bytes[3] = 0xc0: 마지막 바이트 하나만3f에서c0으로 바꿨는데 실수가1에서-4가 됐습니다. 맨 위 비트가 부호, 그다음 비트들이 지수(2의 몇 제곱인지)라서, 그 바이트를 건드리면 부호와 크기가 한꺼번에 바뀝니다. 2주차에서3.14159f가 정확히 저장되지 않고 “가장 가까운 근사값”이 된다고 했던 것도, 실수를 이런 비트 형식으로 저장하기 때문입니다.
C에서 다른 멤버로 읽어도 될까? C 표준은 공용체에 마지막으로 쓴 멤버가 아닌 다른 멤버로 읽으면, 그 바이트들을 새 자료형으로 재해석한 값을 준다고 정해 두었습니다(C99 개정판 이후, C11 도 같습니다). 위 실험이 합법적인 이유입니다. 다만 결과는 CPU의 엔디언과 자료형 표현에 따라 달라지므로, 위 숫자들은 x86-64 리눅스 기준입니다. (참고로 C++ 에서는 같은 코드가 정의되지 않은 동작이라, C와 C++ 가 갈리는 대표적인 곳입니다.)
9.3 그래서 공용체는 어디에 쓸까
공용체의 쓸모는 두 가지입니다.
- 메모리 절약: “이 자리에는 정수 또는 실수 또는 문자열 중 하나만 온다”는 데이터를 표현할 때, 셋을 다 가진 구조체보다 작게 만들 수 있습니다.
- 같은 바이트를 여러 방식으로 보기: 위 실험처럼 실수의 비트를 들여다보거나, 네트워크 패킷의 바이트를 정수로 읽을 때 씁니다.
그런데 1번 용도에는 큰 위험이 있습니다. 공용체 자신은 지금 어떤 멤버가 들어 있는지 기억하지 않습니다. 정수를 넣어 놓고 문자열로 읽으면, 9.2처럼 엉뚱한 해석이 나오거나 \0 이 없는 바이트를 문자열로 읽어 메모리 밖까지 출력할 수도 있습니다.
9.4 태그드 유니온 — 공용체를 안전하게 쓰는 법
그래서 실무에서는 공용체를 혼자 쓰지 않고, “지금 어떤 멤버가 유효한지” 적어 두는 태그(tag) 를 붙인 구조체로 감싸 씁니다. 이것을 태그드 유니온(tagged union) 이라고 합니다. 태그로는 10절에서 배울 열거형이 딱 맞습니다.
typedef enum { TYPE_INT, TYPE_DOUBLE, TYPE_STRING } ValueType;

typedef struct {
    ValueType type;      // 지금 data 의 어떤 멤버가 유효한지 알려 주는 태그
    union {
        int    int_val;
        double double_val;
        char   str_val[32];
    } data;
} Variant;
값을 넣을 때마다 type 도 함께 기록하고, 읽을 때는 반드시 type 을 먼저 보고 알맞은 멤버를 고릅니다.
void print_variant(const Variant *v) {
    switch (v->type) {
        case TYPE_INT:    printf("정수: %d\n", v->data.int_val);      break;
        case TYPE_DOUBLE: printf("실수: %.2f\n", v->data.double_val); break;
        case TYPE_STRING: printf("문자열: %s\n", v->data.str_val);    break;
    }
}
Variant 의 크기와 배치도 확인해 봅시다.
Variant 40 (type 0, data 8), data 크기 32
Variant (40바이트)
 0      3 4     7 8                                           39
┌────────┬────────┬─────────────────────────────────────────────┐
│ type   │ 패딩 4 │ data: int_val / double_val / str_val[32]   │
└────────┴────────┴─────────────────────────────────────────────┘
                   ↑ 공용체 안에 double 이 있어서 8의 배수 자리로
공용체 data 의 크기는 가장 큰 멤버인 str_val 의 32바이트이고, 정렬 요구는 가장 까다로운 멤버인 double 의 8입니다. 그래서 4바이트짜리 type 뒤에 4바이트 패딩이 생겼습니다. 2절의 규칙이 공용체에도 그대로 적용됩니다. 공용체 대신 세 멤버를 전부 가진 구조체(type, int_val, double_val, str_val[32])로 만들어 재 보면 48바이트가 나옵니다. 어차피 한 번에 하나만 쓸 값인데 8바이트를 더 쓰는 셈이고, 레코드가 수백만 개면 이 차이가 커집니다.
이 패턴은 13절의 데이터베이스 프로젝트의 핵심이고, 실제로 인터프리터(파이썬 같은 언어의 변수), JSON 처리기 등 “여러 타입의 값을 하나의 틀에 담아야 하는” 곳에서 널리 쓰입니다.
9.5 예제: union_basic.c
전체 실행 코드:
examples/union_basic.c
#include <stdio.h>
#include <string.h>

/* 같은 4~8바이트 공간을 int / float / char[4] 로 번갈아 해석 */
union Value {
    int   i;
    float f;
    unsigned char bytes[4];   /* 바이트 값을 0~255 로 보려고 unsigned */
};

/* 태그드 유니온(tagged union): 지금 어떤 멤버가 유효한지 별도 태그로 관리.
 * 이것이 union 을 안전하게 쓰는 대표적인 방법이다. */
typedef enum { TYPE_INT, TYPE_DOUBLE, TYPE_STRING } ValueType;

typedef struct {
    ValueType type;      /* 현재 data 의 어떤 멤버가 유효한지 */
    union {
        int    int_val;
        double double_val;
        char   str_val[32];
    } data;
} Variant;

void print_variant(const Variant *v) {
    switch (v->type) {
        case TYPE_INT:    printf("정수: %d\n", v->data.int_val);      break;
        case TYPE_DOUBLE: printf("실수: %.2f\n", v->data.double_val); break;
        case TYPE_STRING: printf("문자열: %s\n", v->data.str_val);    break;
    }
}

int main(void) {
    printf("=== union 크기 비교 ===\n");
    printf("union Value 크기: %zu 바이트 (가장 큰 멤버 기준)\n\n",
           sizeof(union Value));

    union Value v;
    v.i = 65;
    /* i 에 값을 넣었으니 지금은 i 만 유효하다.
     * bytes 로 읽으면 int 65 가 메모리에 어떻게 저장됐는지 볼 수 있다. */
    printf("v.i = %d 일 때 첫 바이트: %d ('%c')\n",
           v.i, v.bytes[0], v.bytes[0]);

    v.f = 3.14f;   /* 이제 f 를 쓰면 i 에 넣었던 65 는 덮어써진다 */
    /* i 로 읽으면 쓰레기가 아니라, 3.14f 를 표현하는 비트 32개를
     * 정수로 해석한 값이 나온다. 매번 똑같은 값이다. */
    printf("v.f = %.2f 로 덮어쓴 뒤 v.i = %d (0x%08x)\n", v.f, v.i, (unsigned)v.i);
    printf("그 4바이트: %02x %02x %02x %02x\n",
           v.bytes[0], v.bytes[1], v.bytes[2], v.bytes[3]);

    printf("\n=== 태그드 유니온 (안전한 사용법) ===\n");
    Variant a = {.type = TYPE_INT,    .data.int_val = 42};
    Variant b = {.type = TYPE_DOUBLE, .data.double_val = 2.718};
    Variant c = {.type = TYPE_STRING};
    /* 배열 멤버에는 = 로 문자열을 넣을 수 없으니 strcpy 로 복사한다 */
    strcpy(c.data.str_val, "hello");

    print_variant(&a);
    print_variant(&b);
    print_variant(&c);

    return 0;
}
$ ./build/union_basic
=== union 크기 비교 ===
union Value 크기: 4 바이트 (가장 큰 멤버 기준)

v.i = 65 일 때 첫 바이트: 65 ('A')
v.f = 3.14 로 덮어쓴 뒤 v.i = 1078523331 (0x4048f5c3)
그 4바이트: c3 f5 48 40

=== 태그드 유니온 (안전한 사용법) ===
정수: 42
실수: 2.72
문자열: hello

공용체는 같은 메모리를 다르게 본다
코드 읽기 포인트
.data.int_val = 42: 지정 초기화(1.3)는 중첩된 멤버도 점을 이어 지정할 수 있습니다.Variant c = {.type = TYPE_STRING};: 1.3의 규칙대로 지정하지 않은data는 전부 0으로 채워집니다. 그다음strcpy로 문자열을 넣었습니다. 1.4에서 본 대로 배열 멤버에는=로 문자열을 넣을 수 없기 때문입니다.%.2f로 찍은 2.718 이2.72: 소수 둘째 자리에서 반올림된 것입니다.
직접 해 보기: print_variant(&a) 대신, 태그를 무시하고 printf("%s\n", a.data.str_val); 로 정수 42가 든 a 를 문자열로 읽어 보세요. 42는 ASCII로 '*' 이고 나머지 바이트가 0이라 * 한 글자가 찍힙니다. 우연히 멀쩡해 보이는 결과가 나올 뿐, 태그를 무시한 읽기가 얼마나 위험한지 보여 주는 실험입니다.
10. 열거형(enum)
10.1 이름 붙은 정수 상수
요일, 방향, 상태처럼 “정해진 몇 가지 중 하나”를 코드로 표현해야 할 때가 많습니다. 숫자로 0은 일요일, 1은 월요일… 이라고 정할 수도 있지만, if (day == 6) 을 읽는 사람은 6이 무슨 뜻인지 알 수 없습니다. 열거형(enumeration) 은 이런 정수에 이름을 붙인 묶음입니다.
typedef enum {
    SUN, MON, TUE, WED, THU, FRI, SAT   // 자동으로 0, 1, 2, ... 6
} Weekday;
enum { ... }안에 이름들을 쉼표로 나열합니다. 이 이름 하나하나를 열거자(enumerator) 라고 합니다.- 값을 적지 않으면 첫 이름이 0, 그다음부터 1씩 커집니다.
- 이름은 관례상 대문자로 씁니다. 상수라는 표시입니다.
값을 직접 정할 수도 있고, 정한 뒤로는 다시 1씩 커집니다.
typedef enum {
    LOW = 1,      // 1
    MEDIUM,       // 2 (자동)
    HIGH = 10,    // 10
    CRITICAL      // 11 (자동)
} Priority;
10.2 예제: enum_basic.c
전체 실행 코드:
examples/enum_basic.c
#include <stdio.h>

/* 값을 생략하면 0부터 자동으로 1씩 증가한다: SUN=0, MON=1, ... SAT=6 */
typedef enum {
    SUN, MON, TUE, WED, THU, FRI, SAT
} Weekday;

/* 값을 직접 지정할 수도 있다. 지정 후에는 다시 1씩 증가한다.
 * LOW=1, MEDIUM=2, HIGH=10, CRITICAL=11 */
typedef enum {
    LOW = 1,
    MEDIUM,
    HIGH = 10,
    CRITICAL
} Priority;

/* enum 은 switch 와 궁합이 좋다 */
const char *weekday_name(Weekday d) {
    switch (d) {
        case SUN: return "일요일";
        case MON: return "월요일";
        case TUE: return "화요일";
        case WED: return "수요일";
        case THU: return "목요일";
        case FRI: return "금요일";
        case SAT: return "토요일";
        default:  return "알 수 없음";
    }
}

int is_weekend(Weekday d) {
    return d == SUN || d == SAT;
}

int main(void) {
    printf("=== 열거형 기본 ===\n");
    /* enum 값은 정수처럼 출력된다 */
    printf("SUN=%d, MON=%d, ... SAT=%d\n", SUN, MON, SAT);
    printf("LOW=%d, MEDIUM=%d, HIGH=%d, CRITICAL=%d\n",
           LOW, MEDIUM, HIGH, CRITICAL);

    printf("\n=== 요일 활용 ===\n");
    for (Weekday d = SUN; d <= SAT; d++) {
        printf("%d: %s %s\n", d, weekday_name(d),
               is_weekend(d) ? "(주말!)" : "");
    }

    Priority task = HIGH;
    printf("\n작업 우선순위 값: %d\n", task);
    if (task >= HIGH) {
        printf("높은 우선순위 작업입니다!\n");
    }

    return 0;
}
$ ./build/enum_basic
=== 열거형 기본 ===
SUN=0, MON=1, ... SAT=6
LOW=1, MEDIUM=2, HIGH=10, CRITICAL=11

=== 요일 활용 ===
0: 일요일 (주말!)
1: 월요일
2: 화요일
3: 수요일
4: 목요일
5: 금요일
6: 토요일 (주말!)

작업 우선순위 값: 10
높은 우선순위 작업입니다!
코드 읽기 포인트
printf("%d", SUN): 열거자는 정수 상수라서%d로 그대로 찍힙니다. 이름("SUN")이 찍히지는 않습니다. 이름을 글자로 보여 주려면weekday_name처럼 변환 함수를 직접 만들어야 합니다. C의 열거형은 컴파일할 때 이름이 숫자로 바뀌고, 실행 파일에는 이름이 남지 않기 때문입니다.const char *weekday_name(...): 문자열 상수의 주소를 돌려주는 함수입니다."일요일"같은 문자열 상수는 1주차 7절에서 본 읽기 전용 영역(.rodata)에 프로그램이 끝날 때까지 있으니, 그 주소를 돌려줘도 안전합니다. 수정하면 안 되니const를 붙였습니다.for (Weekday d = SUN; d <= SAT; d++): 열거형 변수도 정수처럼 더하고 비교할 수 있습니다. 값이 0부터 빈틈없이 이어질 때만 이렇게 순회할 수 있다는 점은 기억하세요(Priority는 1, 2, 10, 11이라 이렇게 돌면 3~9도 거칩니다).is_weekend(d) ? "(주말!)" : "": 3주차에서 배운 삼항 연산자입니다.
10.3 실험: 열거형은 얼마나 엄격할까
열거형 변수에 목록에 없는 값을 넣으면 어떻게 될까요? en.c:
#include <stdio.h>

typedef enum { SUN, MON, TUE, WED, THU, FRI, SAT } Weekday;
typedef enum { RED, GREEN, BLUE } Color;

int main(void) {
    Weekday d = 100;
    Color c = MON;
    printf("sizeof(Weekday) = %zu\n", sizeof(Weekday));
    printf("d = %d, c = %d\n", d, c);
    d = SAT + 1;
    printf("SAT + 1 = %d\n", d);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 en.c -o en && ./en
en.c: In function ‘main’:
en.c:8:15: warning: implicit conversion from ‘enum <anonymous>’ to ‘Color’ [-Wenum-conversion]
    8 |     Color c = MON;
      |               ^~~
sizeof(Weekday) = 4
d = 100, c = 1
SAT + 1 = 7
결과가 꽤 느슨합니다.
- 열거형 변수의 크기는 4바이트,
int와 같습니다. C에서 열거형은 사실상 이름 붙은int입니다. Weekday d = 100;처럼 목록에 없는 값을 넣어도 아무 경고가 없습니다.SAT + 1로 7을 만들어도 마찬가지입니다.- 다른 열거형의 값(
Color c = MON;)을 넣을 때만-Wenum-conversion경고가 납니다.
그러니 C의 열거형은 “잘못된 값을 막아 주는 자물쇠”가 아니라 “숫자에 붙인 이름표” 입니다. 값이 올바른지는 여전히 프로그래머가 지켜야 합니다.
10.4 열거형과 switch — default 를 빼면 생기는 일
그래도 열거형을 쓰면 컴파일러가 도와주는 곳이 하나 있습니다. switch 입니다. weekday_name 에서 default 를 빼고 case 를 일부러 몇 개 빠뜨려 봅시다.
const char *name(Weekday d) {
    switch (d) {
        case SUN: return "일";
        case MON: return "월";
        case SAT: return "토";
    }
    return "?";
}
$ gcc -Wall -Wextra -std=c11 sw.c -o sw
sw.c: In function ‘name’:
sw.c:6:5: warning: enumeration value ‘TUE’ not handled in switch [-Wswitch]
    6 |     switch (d) {
      |     ^~~~~~
sw.c:6:5: warning: enumeration value ‘WED’ not handled in switch [-Wswitch]
sw.c:6:5: warning: enumeration value ‘THU’ not handled in switch [-Wswitch]
sw.c:6:5: warning: enumeration value ‘FRI’ not handled in switch [-Wswitch]
switch 의 대상이 열거형이면, 컴파일러는 처리하지 않은 열거자를 하나하나 짚어 줍니다. 나중에 열거형에 새 값(예: HOLIDAY)을 추가했을 때, 그 값을 처리하지 않은 switch 를 컴파일러가 전부 찾아 준다는 뜻입니다. 숫자 상수로는 절대 얻을 수 없는 도움입니다.
그런데 default: 가 있으면 “나머지는 default 가 처리한다”고 보고 이 경고를 하지 않습니다. 그래서 열거형을 switch 할 때는 default 를 일부러 빼고, 모든 열거자를 case 로 적는 습관이 있습니다. 목록에 없는 값에 대비하려면 위 예처럼 switch 뒤에 return "?"; 를 두면 됩니다.
10.5 이름 충돌에 주의
열거자 이름은 파일 전체에서 하나의 이름 공간을 씁니다. 구조체 멤버처럼 열거형마다 따로 있는 게 아닙니다.
$ gcc -Wall dup.c -o dup
dup.c:2:10: error: redeclaration of enumerator ‘X’
    2 | enum B { X, Z };
      |          ^
dup.c:1:10: note: previous definition of ‘X’ with type ‘enum A’
    1 | enum A { X, Y };
      |          ^
서로 다른 열거형 A 와 B 가 둘 다 X 를 쓰려 하자 “이미 정의된 이름”이라는 오류가 납니다. 그래서 실무에서는 TYPE_INT, FIELD_INT 처럼 열거형마다 접두어를 붙여 충돌을 피합니다. 이번 주 예제의 ValueType 과 13절의 FieldType 이 그렇게 되어 있습니다.
11. 비트 필드(bit field)
11.1 멤버 크기를 비트 단위로 정하기
지금까지 멤버의 최소 단위는 1바이트(char)였습니다. 그런데 “켜짐/꺼짐”처럼 0과 1만 필요한 값에 8비트는 넉넉합니다. 비트 필드는 구조체 멤버가 쓸 비트 수를 직접 지정하는 기능입니다.
typedef struct {
    unsigned is_active   : 1;   // 1비트: 0 또는 1
    unsigned is_visible  : 1;
    unsigned is_deleted  : 1;
    unsigned permission  : 2;   // 2비트: 0~3
} Flags;
자료형 이름 : 비트수; 모양입니다. 자료형은 unsigned(= unsigned int)나 int, _Bool 을 씁니다. n 비트 멤버는 0부터 2ⁿ − 1까지 담을 수 있으니, 1비트는 0~1, 2비트는 0~3, 3비트는 0~7입니다. 3주차에서 배운 2진수 그대로입니다.
11.2 비트가 실제로 어디 들어가는지 보기
값을 넣고 구조체 전체를 정수 하나로 꺼내서 비트를 찍어 봅시다. memcpy 로 구조체의 바이트를 unsigned 변수에 그대로 복사하는 방법을 씁니다.
Flags f = {0};
f.is_active = 1;
f.is_visible = 0;
f.is_deleted = 1;
f.permission = 3;
unsigned raw;
memcpy(&raw, &f, sizeof raw);
printf("Flags 의 실제 값: 0x%08x = ", raw);
for (int b = 7; b >= 0; b--) printf("%u", (raw >> b) & 1u);
printf(" (아래 8비트)\n");
(raw >> b) & 1u 는 3주차의 비트 연산입니다. b 번째 비트를 맨 오른쪽으로 밀어서(>>) 1과 AND 하면, 그 비트가 0인지 1인지만 남습니다.
Flags 의 실제 값: 0x0000001d = 00011101 (아래 8비트)
비트 번호:   7   6   5   4   3   2   1   0
           ┌───┬───┬───┬───┬───┬───┬───┬───┐
           │ 0 │ 0 │ 0 │ 1 │ 1 │ 1 │ 0 │ 1 │
           └───┴───┴───┴───┴───┴───┴───┴───┘
             (안 씀)    └permission┘  │   │   └ is_active  = 1
                          = 11(2)=3   │   └──── is_visible = 0
                                      └──────── is_deleted = 1
첫 멤버 is_active 가 가장 낮은 비트(0번) 에, 그다음 멤버가 1번, 2번… 차례로 쌓였습니다. 멤버 다섯 개 분량의 정보가 1바이트도 안 되는 5비트에 들어갔습니다.
이 배치는 컴파일러마다 다를 수 있습니다. 비트를 낮은 쪽부터 채울지 높은 쪽부터 채울지, 경계를 넘을 때 어떻게 할지는 C 표준이 정하지 않고 구현(컴파일러와 CPU)에 맡깁니다. 위 결과는 x86-64의 GCC 기준입니다. 그래서 비트 필드 구조체를 파일에 저장하거나 네트워크로 보내면, 다른 컴퓨터에서 비트 순서가 어긋날 수 있습니다. 그런 곳에서는 3주차의 비트 연산(
&,|,<<)으로 직접 비트를 다루는 편이 안전합니다.
11.3 범위를 넘으면 잘린다
3비트 멤버에 8(= 2진수 1000)을 넣으면 어떻게 될까요? 4비트가 필요한 수라서 아래 3비트(000)만 남고 0이 됩니다. 상수를 바로 넣으면 컴파일러가 알려 줍니다.
typedef struct { unsigned red : 3; } Color3;
Color3 c;
c.red = 8;
warning: unsigned conversion from ‘int’ to ‘unsigned char:3’ changes value from ‘8’ to ‘0’ [-Woverflow]
“8을 3비트짜리에 넣으면 0으로 바뀐다”고 정확히 말해 줍니다. 문제는 값이 실행 중에 정해질 때입니다. 변수를 거쳐서 넣으면 컴파일러는 값을 미리 알 수 없으니 아무 말도 하지 않고, 실행하면 조용히 잘립니다.
unsigned v = 8;
c.red = v;       // 0
c.red = v + 1;   // 9  = 1001 → 001 = 1
c.red = v + 7;   // 15 = 1111 → 111 = 7
3비트 red 에 8 → 0, 9 → 1, 15 → 7
9는 1, 15는 7이 됐습니다. 8로 나눈 나머지와 같습니다(3비트 = 8가지 값). 비트 필드에 값을 넣을 때는 범위를 넘지 않는지 코드로 확인해야 합니다.
11.4 비트 필드는 주소가 없다
& 로 비트 필드 멤버의 주소를 구하려고 하면 오류가 납니다.
$ gcc -Wall bfaddr.c -o bfaddr
bfaddr.c: In function ‘main’:
bfaddr.c:3:44: error: cannot take address of bit-field ‘a’
메모리 주소는 바이트 단위로만 매겨지기 때문입니다. 한 바이트 안의 3번 비트에는 주소가 없습니다. 그래서 scanf("%u", &f.permission) 처럼 비트 필드에 직접 입력받을 수도 없고, 일반 변수로 받은 뒤 대입해야 합니다.
11.5 정말 메모리를 아낄까? — 정직한 비교
비트 필드는 “메모리를 아낀다”고 소개되는데, 실제로 얼마나 아끼는지 재 봅시다. 같은 네 플래그를 unsigned char 멤버 네 개로 만든 구조체와 비교했습니다.
sizeof(Flags)=4, sizeof(FlagsBytes)=4, int 4개=16
int네 개로 만들면 16바이트이니, 비트 필드(4바이트)가 4분의 1입니다.- 하지만
unsigned char네 개로 만들어도 4바이트로 똑같습니다. 비트 필드 구조체는 바탕 자료형(unsigned, 4바이트) 단위로 자리를 잡기 때문에, 5비트만 써도 4바이트를 차지합니다.
그러니 비트 필드가 정말 이득인 것은 플래그가 많을 때입니다. 플래그 32개면 unsigned char 로는 32바이트지만 비트 필드로는 4바이트입니다. 그리고 그보다 더 큰 쓸모는 비트 배치 자체에 의미가 있는 데이터, 예를 들어 하드웨어 장치의 설정 레지스터(27주차 임베디드)나 파일 형식의 헤더처럼 “3번 비트는 무엇, 4~5번 비트는 무엇”이 정해진 데이터를 이름으로 읽고 쓸 수 있다는 점입니다(단, 11.2의 주의 사항을 기억하세요).
11.6 예제: bitfield.c
전체 실행 코드:
examples/bitfield.c
#include <stdio.h>

/* RGB 색상: 각 채널은 0~7(3비트)만 쓰는 예시.
 * 보통 색은 8비트지만, 여기서는 비트 필드 문법을 보이기 위해 3비트로 제한한다. */
typedef struct {
    unsigned red   : 3;   /* 0~7 */
    unsigned green : 3;   /* 0~7 */
    unsigned blue  : 3;   /* 0~7 */
} Color3;

/* 여러 개의 켜짐/꺼짐 상태를 1비트씩 묶기 */
typedef struct {
    unsigned is_active   : 1;
    unsigned is_visible  : 1;
    unsigned is_deleted  : 1;
    unsigned permission  : 2;   /* 0~3: 없음/읽기/쓰기/전체 */
} Flags;

int main(void) {
    printf("=== 비트 필드 ===\n");

    Color3 c = {7, 3, 0};   /* 최대 밝기 빨강, 중간 초록, 파랑 없음 */
    printf("색상 (R,G,B) = (%u, %u, %u)\n", c.red, c.green, c.blue);

    /* 비트 필드 범위를 넘기면 잘린다: 3비트에 8(=1000b)을 넣으면 0이 된다.
     * c.red = 8; 처럼 상수를 바로 쓰면 컴파일러가 -Woverflow 경고로 막아 준다.
     * 여기서는 실행 중에 정해지는 값처럼 변수를 거쳐서, 경고 없이 잘리는
     * 모습을 보여 준다. (실제 프로그램에서 더 위험한 쪽이 바로 이 경우다.) */
    unsigned value = 8;
    c.red = value;   /* 하위 3비트(000)만 남아 0 */
    printf("red 에 8 대입 후: %u (3비트라 잘림)\n", c.red);

    Flags f = {0};
    f.is_active  = 1;
    f.is_visible = 1;
    f.permission = 2;   /* 쓰기 권한 */
    printf("\n활성:%u 보임:%u 삭제됨:%u 권한:%u\n",
           f.is_active, f.is_visible, f.is_deleted, f.permission);

    /* 비트 필드를 잔뜩 넣어도 구조체 전체는 매우 작다 */
    printf("\nColor3 크기: %zu 바이트\n", sizeof(Color3));
    printf("Flags  크기: %zu 바이트\n", sizeof(Flags));
    printf("(Flags 의 멤버 4개를 각각 int 로 뒀다면 %zu 바이트)\n", 4 * sizeof(int));

    return 0;
}
$ ./build/bitfield
=== 비트 필드 ===
색상 (R,G,B) = (7, 3, 0)
red 에 8 대입 후: 0 (3비트라 잘림)

활성:1 보임:1 삭제됨:0 권한:2

Color3 크기: 4 바이트
Flags  크기: 4 바이트
(Flags 의 멤버 4개를 각각 int 로 뒀다면 16 바이트)

비트 필드와 정렬
비트 필드 값을 printf 로 찍을 때는 %u 를 썼습니다. 정확히 말하면 int 보다 좁은 비트 필드는 함수에 넘어갈 때 int 로 바뀌지만(2주차에서 float 가 printf 로 넘어갈 때 double 로 바뀌던 것과 같은 승격입니다), 값이 음수가 될 수 없으니 %u 로 찍어도 같은 숫자가 나옵니다.
12. 자료구조의 기초: 구조체 + 포인터 = 연결 리스트
이번 주에 배운 것 중 앞으로 가장 오래 쓸 조합은 구조체 + 포인터입니다. 3.3에서 만든 자기참조 구조체가 바로 연결 리스트(linked list) 의 노드입니다.
typedef struct Node {
    int data;
    struct Node *next;   // 다음 노드를 가리킨다
} Node;
배열과 비교해 봅시다.
| 배열 | 연결 리스트 | |
|---|---|---|
| 메모리 배치 | 원소가 빈틈없이 연달아 (2.6) | 노드가 메모리 여기저기에, 포인터로 이어짐 |
| 개수 | 만들 때 정함 (늘리려면 realloc) |
필요할 때마다 malloc 으로 하나씩 |
| 중간에 끼워 넣기 | 뒤의 원소를 전부 한 칸씩 밀어야 함 | 포인터 두 개만 바꾸면 됨 |
| i번째 원소 찾기 | a[i], 한 번에 |
처음부터 next 를 i번 따라가야 함 |
각 노드는 데이터와 “다음 노드의 주소”를 갖습니다. 마지막 노드의 next 는 NULL 로 두어 사슬의 끝을 표시합니다. 순회는 3.4에서 본 관용구 그대로입니다.
for (Node *cur = head; cur != NULL; cur = cur->next) {
    printf("%d ", cur->data);
}
head 는 첫 노드를 가리키는 포인터입니다. 연결 리스트 전체를 알려면 첫 노드의 주소 하나만 알면 됩니다. 나머지는 사슬을 따라가면 되니까요.
“중간에 끼워 넣기가 포인터 두 개만 바꾸면 된다”는 것이 무슨 뜻인지는 13절의 주소록 프로젝트에서 그림과 함께 직접 봅니다. 연결 리스트의 삭제, 뒤집기, 배열과의 성능 비교는 10주차에서 본격적으로 다루고, 11주차에는 이것으로 스택과 큐를 만듭니다.
13. 실습 프로젝트
이번 주의 개념을 한데 모은 세 프로젝트입니다. 모두 projects/ 폴더에 완전한 코드가 있고, -Wall -Wextra 로 경고 없이 컴파일되며, valgrind 메모리 검사에서 누수와 오류가 0개입니다. 전체 코드를 여기에 다 옮기지 않고, 이번 주 개념이 쓰인 핵심 부분을 짚어 가며 읽겠습니다. 에디터에 전체 코드를 열어 놓고 함께 보세요.
| 프로젝트 | 이번 주 개념 | 7주차 이전 개념 |
|---|---|---|
| 학생 관리 시스템 | 구조체, 구조체 동적 배열, ->, const 포인터 |
malloc / realloc, 입력 처리 |
| 주소록 | 자기참조 구조체, 연결 리스트 | strcmp, malloc / free |
| 간단한 데이터베이스 | 구조체 + 공용체 + 열거형 (태그드 유니온) | strncpy, switch |
프로젝트 1: 학생 관리 시스템 (student_manager.c)
목표: 학생 정보를 추가·목록·검색·삭제·통계 내는 대화형 프로그램. 학생 수에 제한이 없어야 합니다.
자료 설계: 구조체 두 개
#define NAME_LEN 32

/* 학생 한 명을 나타내는 구조체 */
typedef struct {
    int  id;                 /* 학번 */
    char name[NAME_LEN];     /* 이름 */
    int  korean;             /* 국어 점수 */
    int  english;            /* 영어 점수 */
    int  math;               /* 수학 점수 */
} Student;

/* 학생 배열을 담는 관리자 구조체.
 * count(현재 학생 수)와 capacity(할당된 공간)를 나눠 관리해
 * 공간이 부족할 때만 realloc 으로 늘린다. */
typedef struct {
    Student *items;
    int      count;
    int      capacity;
} StudentDB;
설계에서 눈여겨볼 점이 두 가지입니다.
첫째, Student 는 48바이트입니다. int 4 + char[32] 32 + int 3개 12 = 48, 모든 int 가 4의 배수 자리에 떨어져 패딩이 없습니다. (2절 연습: name 을 맨 앞으로 옮겨도 48바이트입니다. 왜일까요?)
둘째, “학생 목록”도 구조체로 만들었습니다. items(학생 배열의 주소), count(지금 몇 명), capacity(몇 명분 자리를 잡아 뒀나) 세 값은 항상 함께 다녀야 합니다. 들어가며에서 본 병렬 배열 문제와 같은 이유로, 따로 두면 어긋나기 쉽습니다. 이 셋을 StudentDB 로 묶으니, 함수들이 StudentDB *db 하나만 받으면 됩니다.
자리가 모자라면 두 배로
/* DB 초기화: 처음엔 4칸으로 시작 */
int db_init(StudentDB *db) {
    db->capacity = 4;
    db->count = 0;
    db->items = malloc(db->capacity * sizeof(Student));
    return db->items != NULL;
}

/* 공간이 꽉 차면 두 배로 늘린다 */
int db_ensure_capacity(StudentDB *db) {
    if (db->count < db->capacity) return 1;

    int new_cap = db->capacity * 2;
    Student *tmp = realloc(db->items, new_cap * sizeof(Student));
    if (tmp == NULL) return 0;   /* 실패 시 기존 items 는 그대로 유효 */

    db->items = tmp;
    db->capacity = new_cap;
    return 1;
}
7주차의 동적 배열 기법을 구조체 배열에 적용했습니다. 짚어 볼 곳이 있습니다.
realloc결과를 바로db->items에 넣지 않고tmp에 먼저 받습니다.realloc이 실패하면NULL을 돌려주는데, 그때 기존 메모리는 그대로 살아 있습니다. 바로db->items = realloc(...)이라고 쓰면 실패하는 순간 기존 주소를NULL로 덮어써서, 학생 데이터를 가리키는 유일한 주소를 잃어버립니다(메모리 누수 + 데이터 분실). 7주차에서 본 함정입니다.- 왜 하나씩이 아니라 두 배씩 늘릴까요?
realloc은 자리가 부족하면 새 공간을 잡고 기존 내용을 통째로 복사합니다. 학생이 들어올 때마다 1칸씩 늘리면 매번 전체를 복사하게 됩니다. 두 배씩 늘리면 4 → 8 → 16 → 32… 로 복사 횟수가 확 줄어듭니다. 10주차에서 이 전략의 성능을 직접 재 봅니다.
실제로 늘어나는지 valgrind 로 확인할 수 있습니다. 학생 5명을 넣으면 4칸이 꽉 찬 뒤 다섯 번째에서 한 번 늘어나야 합니다.
$ printf '1\n1001 a 1 1 1\n1\n1002 b 1 1 1\n1\n1003 c 1 1 1\n1\n1004 d 1 1 1\n1\n1005 e 1 1 1\n0\n' | valgrind ./build/student_manager 2>&1 >/dev/null | grep "total heap"
==PID==   total heap usage: 4 allocs, 4 frees, 8,768 bytes allocated
$ printf '0\n' | valgrind ./build/student_manager 2>&1 >/dev/null | grep "total heap"
==PID==   total heap usage: 3 allocs, 3 frees, 8,384 bytes allocated
(2>&1 >/dev/null 은 “valgrind 의 보고(오류 출력)만 남기고 프로그램의 화면 출력은 버려라”는 뜻입니다. 순서가 중요한데, 18주차에 입출력 방향 바꾸기를 배우면서 정확히 다룹니다.)
바이트 수를 맞춰 봅시다.
| 할당 | 바이트 | 5명 넣을 때 | 바로 종료할 때 |
|---|---|---|---|
db_init 의 malloc (4칸 × 48) |
192 | 예 | 예 |
다섯 번째 학생에서 realloc (8칸 × 48) |
384 | 예 | 아니오 |
scanf 가 쓰는 입력 버퍼 |
4,096 | 예 | 예 |
printf 가 쓰는 출력 버퍼 |
4,096 | 예 | 예 |
| 합계 | 8,768 | 8,384 |
정확히 맞습니다. 7.3에서 본 출력 버퍼에 더해, 이번에는 scanf 를 쓰니 입력 버퍼도 하나 더 생겼습니다. 두 실행의 차이 384바이트가 바로 realloc 으로 늘린 8칸짜리 배열입니다.
삭제: 구조체를 통째로 당기기
for (int i = idx; i < db->count - 1; i++) {
    db->items[i] = db->items[i + 1];   /* 구조체 통째 복사로 당기기 */
}
db->count--;
1.5에서 배운 구조체 대입이 여기서 빛납니다. 학번, 이름, 점수 세 개를 따로 옮길 필요 없이 = 한 번으로 학생 한 명이 통째로 한 칸 앞으로 옵니다. name 이 배열인데도 구조체 안에 있으니 함께 복사됩니다. 공간을 줄이지는 않고 count 만 줄입니다. 뒤쪽 칸은 다음에 추가할 때 다시 씁니다.
한글 이름이 섞인 표 맞추기
이 프로젝트의 처음 버전은 목록을 이렇게 출력했습니다.
printf("\n%-6s %-12s %4s %4s %4s %5s %6s\n",
       "학번", "이름", "국어", "영어", "수학", "총점", "평균");
...
printf("%-6d %-12s %4d %4d %4d %5d %6.1f\n", s->id, s->name, ...);
그랬더니 결과가 이랬습니다.
학번 이름       국어 영어 수학 총점 평균
--------------------------------------------------
1001   김철수      85   90   78   253   84.3
1002   이영희      95   88  100   283   94.3
머리글과 내용이 어긋납니다. 1주차 8절의 계산기 상자와 같은 문제입니다. %-12s 의 12는 바이트 수인데, 한글은 한 글자가 3바이트이면서 화면에서는 2칸입니다.
| 문자열 | 바이트 | 화면 칸 | %-12s 가 붙이는 공백 |
결과 화면 폭 |
|---|---|---|---|---|
"김철수" |
9 | 6 | 12 − 9 = 3 | 6 + 3 = 9칸 |
"Tom" |
3 | 3 | 12 − 3 = 9 | 3 + 9 = 12칸 |
"학번" (%-6s) |
6 | 4 | 6 − 6 = 0 | 4칸 |
printf 는 바이트만 셀 뿐 화면에 몇 칸으로 그려질지 모릅니다. 그래서 화면 칸 수를 직접 세어 공백을 채우는 함수를 만들어 고쳤습니다.
static void print_cell(const char *s, int width)
{
    int cells = 0;

    for (const unsigned char *p = (const unsigned char *)s; *p; p++) {
        if (*p < 0x80)
            cells += 1;
        else if (*p >= 0xE0)
            cells += 2;
        else if (*p >= 0xC0)
            cells += 1;
    }
    printf("%s", s);
    for (int i = cells; i < width; i++)
        putchar(' ');
}
UTF-8 은 각 글자의 첫 바이트만 보면 그 글자가 몇 바이트짜리인지 알 수 있게 설계되어 있습니다.
| 첫 바이트 | 뜻 | 셀 칸 |
|---|---|---|
0x00 ~ 0x7F |
영어·숫자 (1바이트 글자) | 1 |
0x80 ~ 0xBF |
글자의 뒷부분 바이트 | 0 (앞에서 이미 셈) |
0xC0 ~ 0xDF |
2바이트 글자의 시작 (é 같은 라틴 문자) | 1 |
0xE0 이상 |
3~4바이트 글자의 시작 (한글, 한자) | 2 |
1주차 6절에서 '안' 이 ec 95 88 이었던 것을 떠올려 보세요. 첫 바이트 ec 는 0xE0 이상이라 2칸, 뒤의 95 와 88 은 뒷부분이라 0칸입니다. 이 함수로 머리글과 이름을 찍으니 표가 반듯해졌습니다.
학번   이름         국어 영어 수학  총점   평균
-----------------------------------------------
1001   김철수         85   90   78   253   84.3
1002   이영희         95   88  100   283   94.3
1003   박민수         70   65   80   215   71.7
const unsigned char * 로 문자열을 읽는 점도 보세요. 2.3에서 구조체 바이트를 볼 때처럼, 바이트 값을 0~255 로 비교하려면 unsigned char 여야 합니다. 그냥 char 는 이 컴퓨터에서 부호가 있어서 0xE0 같은 바이트가 음수로 읽힙니다.
이 함수는 한글·영어가 섞인 경우를 위한 간단한 근사입니다. 이모지나 결합 문자까지 정확히 세려면
wcwidth같은 라이브러리 함수가 필요하고, 26주차 터미널 UI 프로그래밍에서 다룹니다.
실행해 보기
대화형 프로그램이라 직접 실행해서 메뉴를 고르면 됩니다. 여기서는 입력을 미리 파일처럼 만들어 파이프로 넣었습니다. 파이프로 넣은 입력은 화면에 다시 찍히지 않기 때문에, 아래에서 선택: 뒤에 우리가 친 숫자가 보이지 않습니다.
$ printf '1\n1001 김철수 85 90 78\n1\n1002 이영희 95 88 100\n1\n1003 박민수 70 65 80\n2\n3\n1002\n5\n4\n1001\n2\n7\nabc\n0\n' | ./build/student_manager
=== 학생 관리 시스템 ===

[1]추가 [2]목록 [3]검색 [4]삭제 [5]통계 [0]종료
선택: 학번: 이름: 국어 영어 수학 (공백 구분): => 김철수 학생을 추가했습니다.
...
[1]추가 [2]목록 [3]검색 [4]삭제 [5]통계 [0]종료
선택:
학번   이름         국어 영어 수학  총점   평균
-----------------------------------------------
1001   김철수         85   90   78   253   84.3
1002   이영희         95   88  100   283   94.3
1003   박민수         70   65   80   215   71.7

[1]추가 [2]목록 [3]검색 [4]삭제 [5]통계 [0]종료
선택: 검색할 학번: 찾음: 이영희 (국어 95, 영어 88, 수학 100, 평균 94.3)

[1]추가 [2]목록 [3]검색 [4]삭제 [5]통계 [0]종료
선택:
=== 통계 (학생 3명) ===
국어 평균: 83.3
영어 평균: 81.0
수학 평균: 86.0
전체 1등: 이영희 (총점 283)

[1]추가 [2]목록 [3]검색 [4]삭제 [5]통계 [0]종료
선택: 삭제할 학번: => 김철수 학생을 삭제합니다.

[1]추가 [2]목록 [3]검색 [4]삭제 [5]통계 [0]종료
선택:
학번   이름         국어 영어 수학  총점   평균
-----------------------------------------------
1002   이영희         95   88  100   283   94.3
1003   박민수         70   65   80   215   71.7

[1]추가 [2]목록 [3]검색 [4]삭제 [5]통계 [0]종료
선택: 잘못된 선택입니다.

[1]추가 [2]목록 [3]검색 [4]삭제 [5]통계 [0]종료
선택: 숫자를 입력하세요.

[1]추가 [2]목록 [3]검색 [4]삭제 [5]통계 [0]종료
선택: 프로그램을 종료합니다.
마지막 부분에서 메뉴에 없는 7 과 숫자가 아닌 abc 를 넣었더니 각각 “잘못된 선택”, “숫자를 입력하세요”로 처리하고 계속 돌아갑니다. 입력 처리에는 3주차에서 본 flush_line() 과, 입력이 끝나면 멈추는 exit_if_eof() 가 쓰였습니다. 파이프로 입력을 주다가 중간에 끊겨도 무한 반복에 빠지지 않고 이렇게 끝납니다.
$ printf '1\n1004 최\n' | ./build/student_manager | tail -3
[1]추가 [2]목록 [3]검색 [4]삭제 [5]통계 [0]종료
선택: 학번: 이름: 국어 영어 수학 (공백 구분):
입력이 끝났습니다. 종료합니다.
직접 해 보기
- 학생을 5명 이상 넣어
realloc이 일어나게 하고,db_ensure_capacity에printf("[자리 늘림: %d → %d]\n", db->capacity, new_cap);을 넣어 언제 늘어나는지 확인해 보세요. - “이름으로 검색” 메뉴를 추가해 보세요.
db_find_by_id를 본떠strcmp로 비교하면 됩니다. - 도전: 9주차에 배울
fwrite를 미리 찾아보고(man 3 fwrite), 종료할 때db->items를 파일에 저장해 보세요. 2.6의 상자에서 말한 “패딩까지 저장된다”는 것을od -An -tx1 파일로 확인할 수 있습니다.
프로젝트 2: 주소록 (address_book.c)
목표: 구조체 포인터로 연결 리스트를 만들어 연락처를 이름순으로 관리합니다.
자료 설계
#define NAME_LEN  32
#define PHONE_LEN 20

/* 연락처 노드: 데이터 + 다음 노드 주소 */
typedef struct Contact {
    char name[NAME_LEN];
    char phone[PHONE_LEN];
    struct Contact *next;   /* 자기참조: 다음 연락처를 가리킴 */
} Contact;

/* 주소록: 첫 노드(head)만 알면 전체를 순회할 수 있다 */
typedef struct {
    Contact *head;
    int      size;
} AddressBook;
3.3의 자기참조 구조체입니다. Contact 의 크기를 재 보면 64바이트인데, 2절의 연습 문제로 좋습니다.
Contact 64 (name 0, phone 32, next 56)
name 32 + phone 20 = 52바이트에서 끝나는데, next 는 포인터라 8의 배수 자리가 필요합니다. 52 다음의 8의 배수는 56이라 4바이트 패딩이 들어갔습니다. 32 + 20 + 4 + 8 = 64.
정렬된 자리에 끼워 넣기
새 연락처는 이름순으로 알맞은 자리에 끼워 넣습니다. 핵심 코드입니다.
/* 삽입 위치 찾기: 이름이 node 보다 크거나 같은 첫 위치 앞에 넣는다.
 * prev 는 삽입 위치의 바로 앞 노드. head 앞에 넣어야 하면 prev == NULL. */
Contact *prev = NULL;
Contact *cur = ab->head;
while (cur != NULL && strcmp(cur->name, name) < 0) {
    prev = cur;
    cur = cur->next;
}

if (prev == NULL) {          /* 맨 앞에 삽입 */
    node->next = ab->head;
    ab->head = node;
} else {                     /* 중간 또는 맨 뒤에 삽입 */
    node->next = prev->next;
    prev->next = node;
}
prev 와 cur 두 포인터가 나란히 사슬을 따라 내려가다가, cur 의 이름이 새 이름보다 크거나 같아지는(또는 끝에 닿는) 곳에서 멈춥니다. 새 노드는 prev 와 cur 사이에 들어갑니다. 데모에서 “박민수”, “김철수”, “이영희” 순서로 넣을 때, 세 번째 “이영희”가 들어가는 순간을 그려 봅시다.
끼워 넣기 전:  head → [김철수] → [박민수] → NULL
                        prev      (cur 는 박민수를 지나 NULL 까지 감)

"이영희" 는 "박민수" 보다 크므로 prev = [박민수], cur = NULL 에서 멈춘다

① node->next = prev->next;     [이영희] → NULL
② prev->next = node;           [박민수] → [이영희]

끼워 넣은 뒤: head → [김철수] → [박민수] → [이영희] → NULL
순서가 중요합니다. ②를 먼저 하면 prev->next 에 있던 “원래 다음 노드”의 주소를 덮어써서 잃어버립니다. 항상 새 노드가 뒤를 먼저 잡고(①), 그다음 앞 노드가 새 노드를 잡습니다(②). 배열이었다면 뒤의 원소를 전부 한 칸씩 밀어야 했을 일을, 포인터 두 개로 끝냈습니다. 12절의 표에서 말한 연결 리스트의 장점입니다.
“이름순”은 어떻게 정해질까?
그런데 strcmp 로 한글을 비교하면 정말 가나다순이 될까요? strcmp 는 4주차에서 배웠듯 바이트 값을 앞에서부터 비교합니다. 세 이름의 첫 글자 바이트를 봅시다.
$ printf '김' | od -An -tx1
 ea b9 80
$ printf '박' | od -An -tx1
 eb b0 95
$ printf '이' | od -An -tx1
 ec 9d b4
첫 바이트가 ea < eb < ec 이니 김 < 박 < 이, 가나다순이 맞습니다. 유니코드는 한글 음절을 가나다순으로 번호를 매겨 두었고(김 U+AE40, 박 U+BC15, 이 U+C774), UTF-8 은 번호가 큰 글자일수록 바이트도 크도록 설계되어 있기 때문입니다. 그래서 운 좋게(사실은 설계 덕분에) 바이트 비교가 가나다순과 일치합니다. 단, 대소문자가 섞인 영어나 숫자가 섞인 이름(“학생10” 과 “학생9”)에서는 우리가 기대하는 순서와 다를 수 있습니다.
삭제와 전체 해제
삭제는 끼워 넣기의 반대입니다. 앞 노드(prev)의 next 가 삭제할 노드를 건너뛰고 그다음 노드를 가리키게 한 뒤 free 합니다. 프로그램을 끝낼 때는 모든 노드를 해제합니다.
/* 프로그램 종료 시 모든 노드 해제 (메모리 누수 방지) */
void ab_free(AddressBook *ab) {
    Contact *cur = ab->head;
    while (cur != NULL) {
        Contact *next = cur->next;   /* free 전에 다음 주소를 먼저 저장 */
        free(cur);
        cur = next;
    }
    ab->head = NULL;
    ab->size = 0;
}
free(cur) 하기 전에 cur->next 를 먼저 챙겨 둬야 합니다. free 한 뒤에 cur->next 를 읽으면, 이미 돌려준 메모리를 읽는 7주차의 “해제 후 사용” 버그입니다. 흔한 실수라서 for (cur = head; cur; cur = cur->next) free(cur); 같은 코드가 자주 보이는데, free(cur) 다음에 cur = cur->next 가 실행되니 정확히 이 버그입니다.
실행 결과
데모 데이터로 자동 실행됩니다. 일부러 이름 순서를 섞어서 넣었는데 목록은 가나다순으로 나오는 것을 확인하세요.
$ ./build/address_book
=> 박민수 추가됨
=> 김철수 추가됨
=> 이영희 추가됨

=== 주소록 (3명, 이름순) ===
 1. 김철수    010-1111-1111
 2. 박민수    010-3333-3333
 3. 이영희    010-2222-2222

[검색] '이영희'
찾음: 이영희 -> 010-2222-2222

[삭제] '김철수'
=> 김철수 삭제됨

=== 주소록 (2명, 이름순) ===
 1. 박민수    010-3333-3333
 2. 이영희    010-2222-2222

주소록을 정리하고 종료합니다.

주소록
valgrind 로도 확인합니다.
$ valgrind --leak-check=full ./build/address_book
...
==PID== All heap blocks were freed -- no leaks are possible
==PID== ERROR SUMMARY: 0 errors from 0 contexts (suppressed: 0 from 0)
직접 해 보기
main의 데모 데이터에"Tom"을 추가해 보세요. 영어는 한글보다 바이트 값이 작아서 맨 앞에 오고, 목록 출력의%-12s때문에 전화번호 줄이 어긋날 겁니다. 프로젝트 1의print_cell을 가져와 고쳐 보세요.ab_free의Contact *next = cur->next;를 없애고free(cur); cur = cur->next;로 바꾼 뒤 valgrind 를 돌려 보세요.Invalid read오류가 몇 번째 줄에서 나는지 확인하고, 다시 원래대로 돌려놓으세요.
프로젝트 3: 간단한 데이터베이스 (simple_database.c)
목표: 구조체 + 공용체 + 열거형을 모두 써서, 정수·실수·문자열 중 어떤 타입이든 저장하는 키-값(key-value) 데이터베이스를 만듭니다. "age" → 30, "name" → "홍길동" 처럼 이름(키)으로 값을 넣고 찾습니다.
자료 설계: 9.4의 태그드 유니온 그대로
#define MAX_RECORDS 100
#define KEY_LEN     32
#define STR_LEN     64

/* 값의 종류를 나타내는 열거형 */
typedef enum {
    FIELD_INT,
    FIELD_DOUBLE,
    FIELD_STRING
} FieldType;

/* 실제 값은 공용체로 저장한다: 한 번에 하나의 타입만 유효하므로
 * 세 멤버가 같은 공간을 공유해 메모리를 아낀다. */
typedef union {
    long   int_val;
    double double_val;
    char   str_val[STR_LEN];
} FieldValue;

/* 하나의 레코드 = 키 + 타입 태그 + 값.
 * 타입 태그(type)가 있어야 공용체의 어떤 멤버가 유효한지 알 수 있다. */
typedef struct {
    char       key[KEY_LEN];
    FieldType  type;
    FieldValue value;
} Record;
Record 하나의 크기는 104바이트입니다. 이번 주에 배운 것으로 전부 설명할 수 있습니다.
Record 104 (key 0 type 32 value 40)
Record (104바이트)
 0              31 32   35 36   39 40                              103
┌─────────────────┬───────┬───────┬───────────────────────────────────┐
│    key[32]      │ type  │ 패딩4 │ value: long / double / str_val[64]│
└─────────────────┴───────┴───────┴───────────────────────────────────┘
                   enum=4   ↑       공용체: 가장 큰 멤버 str_val[64] = 64바이트
                           공용체 안의 long/double 때문에 8의 배수 자리로
key32바이트 (0~31)type은 열거형이라 4바이트 (32~35, 10.3)value공용체의 크기는 가장 큰 멤버str_val의 64바이트 (9.1), 정렬 요구는long·double의 8 (9.4)- 36은 8의 배수가 아니라서 4바이트 패딩 후 40번부터 (2.2)
- 32 + 4 + 4 + 64 = 104
넣기: 같은 키면 덮어쓰기
/* 내부 공통 처리: 키가 이미 있으면 그 자리를, 없으면 새 자리를 돌려준다.
 * 꽉 찼으면 NULL. */
static Record *db_slot(Database *db, const char *key) {
    int idx = db_find(db, key);
    if (idx >= 0) return &db->records[idx];        /* 덮어쓰기 */
    if (db->count >= MAX_RECORDS) return NULL;     /* 가득 참 */
    Record *r = &db->records[db->count++];         /* 새 레코드 */
    strncpy(r->key, key, KEY_LEN - 1);
    r->key[KEY_LEN - 1] = '\0';
    return r;
}

void db_put_int(Database *db, const char *key, long v) {
    Record *r = db_slot(db, key);
    if (r == NULL) { printf("DB 가득 참\n"); return; }
    r->type = FIELD_INT;
    r->value.int_val = v;
}
db_slot은 레코드의 주소(Record *)를 돌려줍니다. 호출한 쪽이 그 주소로r->type,r->value.int_val을 바로 채웁니다. 6.3에서 말한 “구조체는 포인터로 주고받는다”의 예입니다.&db->records[db->count++]: 연산자가 여러 개 겹쳐 있습니다.db->records(포인터로 구조체 멤버),[db->count++](지금count번째 원소, 그리고count를 1 늘림),&(그 원소의 주소). 3주차에서 배운 후위++는 “값을 먼저 쓰고 나중에 늘린다”였죠.strncpy뒤에\0을 직접 넣습니다.strncpy는 원본이 길면\0을 붙이지 않고 잘라 버리기 때문입니다(4주차). 1주차에서 “C 문자열은\0으로 끝난다”고 했던 것, 여기서도 지켜야 합니다.type과value를 항상 함께 바꿉니다. 이 두 줄이 떨어지면 태그드 유니온의 약속이 깨집니다.
꺼내기: 태그를 보고 알맞은 멤버로
void print_record(const Record *r) {
    printf("  %-12s = ", r->key);
    switch (r->type) {
        case FIELD_INT:    printf("%ld (정수)\n", r->value.int_val);       break;
        case FIELD_DOUBLE: printf("%.4f (실수)\n", r->value.double_val);   break;
        case FIELD_STRING: printf("\"%s\" (문자열)\n", r->value.str_val);  break;
    }
}
switch 에 default 가 없습니다. 10.4에서 본 대로, 나중에 FIELD_BOOL 같은 새 타입을 추가하면 컴파일러가 “이 switch 가 FIELD_BOOL 을 처리하지 않는다”고 경고해 줍니다. long 을 찍으니 서식 지정자는 %ld 입니다(2주차).
실행 결과
$ ./build/simple_database
=== 간단한 데이터베이스 ===

=== 데이터베이스 (5개 레코드) ===
  name         = "홍길동" (문자열)
  age          = 30 (정수)
  height       = 175.5000 (실수)
  score        = 95 (정수)
  city         = "서울" (문자열)

[갱신] age 를 31 로, score 를 문자열로 변경
조회:  age          = 31 (정수)
조회:  score        = "A+" (문자열)
키 'unknown' 없음

=== 데이터베이스 (5개 레코드) ===
  name         = "홍길동" (문자열)
  age          = 31 (정수)
  height       = 175.5000 (실수)
  score        = "A+" (문자열)
  city         = "서울" (문자열)

Record 하나의 크기: 104 바이트
score 가 정수 95에서 문자열 "A+" 로 타입까지 바뀌었지만 레코드 수는 5개 그대로입니다. 같은 키의 자리를 찾아 type 과 value 를 함께 덮어썼기 때문입니다. 공용체 덕분에 “정수 칸”과 “문자열 칸”을 따로 둘 필요 없이 같은 64바이트를 번갈아 썼습니다. 실제 데이터베이스가 여러 타입의 컬럼 값을 다루는 방식의 축소판입니다.
직접 해 보기
FieldType에FIELD_BOOL을 추가하고 컴파일해 보세요.print_record의switch에서-Wswitch경고가 나는 것을 확인한 뒤, 공용체에int bool_val;을 더하고db_put_bool과 출력case를 만들어 경고를 없애 보세요.Database의 크기를sizeof로 찍어 보세요. 10,408바이트가 나옵니다. 104 × 100 +count4 = 10,404인데 4바이트는 어디서 왔을까요? (힌트: 2.6의 끝 패딩.Record안에 8바이트 정렬이 필요한 멤버가 있습니다.)
14. 자주 하는 실수와 함정
이번 주 내용에서 초보자가 가장 자주 만나는 실수를 모았습니다. 모두 실제로 컴파일하고 실행해서 나온 메시지입니다. 1주차 10절에서 배운 대로, 메시지의 첫 오류와 줄 번호부터 읽으세요.
1) 구조체 정의 끝의 세미콜론 누락
#include <stdio.h>

struct Person {
    char name[50];
    int  age;
}

int main(void) {
    struct Person p = {"김철수", 25};
    printf("%s\n", p.name);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 semi.c -o semi
semi.c:8:1: error: expected ‘;’, identifier or ‘(’ before ‘int’
    8 | int main(void) {
      | ^~~
오류가 8번째 줄 int main 을 가리킵니다. 실수는 6번째 줄 } 뒤인데요. 1.1에서 본 대로 } 뒤에는 변수 이름이 올 수 있어서, 컴파일러는 struct Person { ... } int main... 을 한 문장으로 읽으려다 int 에서 막힌 것입니다. “구조체 정의 다음 줄에서 이상한 오류가 나면 정의 끝의 세미콜론부터 확인한다”고 기억하세요.
2) 문자열 멤버를 = 로 대입
p.name = "김철수";        // error: assignment to expression with array type
strcpy(p.name, "김철수");  // 올바름
1.4에서 봤습니다. 배열 멤버에는 strcpy, 길이가 걱정되면 snprintf(p.name, sizeof p.name, "%s", 원본) 을 씁니다. sizeof p.name 은 배열 멤버의 크기(바이트)라서 넘칠 걱정이 없습니다.
3) 포인터인데 점(.), 변수인데 화살표(->)
Person *p = &kim;
p.age = 30;      // error: ‘p’ is a pointer; did you mean to use ‘->’?
kim->age = 31;   // error: invalid type argument of ‘->’ (have ‘Person’)
5.2에서 봤습니다. 변수는 점, 포인터는 화살표.
4) 얕은 복사 — 두 구조체가 같은 메모리를 가리킨다
1.5에서 “멤버에 포인터가 있으면 주소만 복사된다”고 했습니다. 실제로 어떤 일이 생기는지 봅시다. 이번에는 이름을 배열이 아니라 힙에 따로 잡고 포인터로 가리키게 했습니다.
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

typedef struct {
    char *name;   /* 이름을 힙에 따로 둔다 */
    int   age;
} Person;

int main(void) {
    Person a;
    a.name = malloc(16);
    strcpy(a.name, "김철수");
    a.age = 25;

    Person b = a;              /* 구조체 복사 */
    strcpy(b.name, "박민수");  /* b 의 이름만 바꿨다...? */
    b.age = 30;

    printf("a: %s, %d세 (name 주소 %p)\n", a.name, a.age, (void *)a.name);
    printf("b: %s, %d세 (name 주소 %p)\n", b.name, b.age, (void *)b.name);

    free(a.name);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 shallow.c -o shallow && ./shallow
a: 박민수, 25세 (name 주소 0x...)
b: 박민수, 30세 (name 주소 0x...)
(주소는 실행마다 다르지만, 두 줄의 주소가 항상 같습니다.)
b 의 이름만 바꿨는데 a 의 이름도 “박민수”가 됐습니다. 반면 나이는 a 25, b 30으로 따로입니다. Person b = a; 는 name 포인터 값(주소) 과 age 정수 값을 복사했습니다. 정수는 값 자체가 복사되니 독립적이지만, 포인터는 “같은 곳을 가리키는 주소”가 복사되니 두 구조체가 같은 힙 메모리를 가리키게 됩니다.
  a                    b
┌──────┬────┐       ┌──────┬────┐
│ name │ 25 │       │ name │ 30 │
└──┬───┴────┘       └──┬───┴────┘
   │                   │
   └───────┬───────────┘
           ▼
      ┌──────────┐
      │ "박민수" │  ← 힙의 16바이트, 하나뿐
      └──────────┘
더 나쁜 일은 해제할 때 생깁니다. 두 구조체를 “각자” 정리한다고 둘 다 free 하면 어떻게 될까요? dfree.c:
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

typedef struct { char *name; int age; } Person;

int main(void) {
    Person a = {malloc(16), 25};
    strcpy(a.name, "김철수");
    Person b = a;
    free(a.name);
    free(b.name);
    printf("여기까지 오면 운이 좋은 것\n");
    return 0;
}
a.name 과 b.name 은 같은 주소이니, 같은 메모리를 두 번 해제하게 됩니다.
$ gcc -Wall -Wextra -std=c11 -g dfree.c -o dfree
$ ./dfree
free(): double free detected in tcache 2
중지됨 (코어 덤프됨)
$ echo $?
134
printf 까지 가지도 못했습니다. C 라이브러리가 “같은 메모리를 두 번 해제(double free)했다”는 것을 감지하고 프로그램을 강제로 중단시켰습니다. 종료 코드 134는 128 + 6, “6번 시그널(SIGABRT, 강제 중단)로 죽었다”는 뜻입니다(시그널은 18주차에서 다룹니다). valgrind 로 보면 어디서 두 번 해제했는지까지 알려 줍니다.
$ valgrind ./dfree
==PID== Invalid free() / delete / delete[] / realloc()
==PID==    at 0x484988F: free (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==PID==    by 0x1091E8: main (dfree.c:12)
==PID==  Address 0x4aac040 is 0 bytes inside a block of size 16 free'd
==PID==    at 0x484988F: free (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==PID==    by 0x1091DC: main (dfree.c:11)
==PID==  Block was alloc'd at
==PID==    at 0x4846828: malloc (in /usr/libexec/valgrind/vgpreload_memcheck-amd64-linux.so)
==PID==    by 0x10919E: main (dfree.c:8)
==PID==
여기까지 오면 운이 좋은 것
...
아래에서 위로 읽으면 사건의 순서가 됩니다. “8번째 줄에서 16바이트를 할당했고(alloc’d), 11번째 줄에서 해제했는데(free’d), 12번째 줄에서 그 블록을 또 해제하려 했다(Invalid free).” valgrind 는 잘못된 해제를 막아 주고 기록만 하기 때문에, 이번에는 프로그램이 끝까지 실행되어 printf 도 찍혔습니다. “valgrind 아래에서는 멀쩡히 끝났다”를 “버그가 없다”로 착각하지 마세요. 보고서의 ERROR SUMMARY 가 0인지가 기준입니다.
해결책은 깊은 복사(deep copy) 입니다. 구조체를 복사할 때 포인터가 가리키는 내용까지 새로 할당해서 복사하는 함수를 직접 만듭니다.
Person person_copy(const Person *src) {
    Person dst = *src;                          // 일단 전부 복사 (얕은 복사)
    dst.name = malloc(strlen(src->name) + 1);   // 이름은 새 공간에
    if (dst.name != NULL)
        strcpy(dst.name, src->name);            // 내용을 복사
    return dst;
}
+ 1 은 문자열 끝의 \0 자리입니다. 이 함정 때문에 이번 주 예제들은 이름을 char *name 대신 char name[32] 배열 멤버로 두었습니다. 배열 멤버는 구조체 안에 통째로 들어 있으니 = 복사로 안전하게 함께 복사됩니다.
5) 공용체를 마지막에 넣지 않은 멤버로 읽기
v.i = 65;
printf("%f\n", v.f);   // 9.1e-44 같은 엉뚱한 실수
9.2에서 봤듯, 멤버를 바꿔 읽으면 같은 바이트를 다른 규칙으로 해석한 값이 나옵니다. 의도한 게 아니라면 버그입니다. 여러 타입을 담을 때는 태그드 유니온(9.4) 으로 “지금 무엇이 들어 있는지”를 함께 기록하세요.
6) 초기화하지 않은 구조체 사용
Person p;
printf("%d %f\n", p.age, p.height);
$ gcc -Wall -Wextra -std=c11 uninit.c -o uninit
uninit.c: In function ‘main’:
uninit.c:10:5: warning: ‘p.height’ is used uninitialized [-Wuninitialized]
   10 |     printf("%d %f\n", p.age, p.height);
      |     ^~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~
uninit.c:9:12: note: ‘p’ declared here
    9 |     Person p;
      |            ^
uninit.c:10:5: warning: ‘p.age’ is used uninitialized [-Wuninitialized]
...
1주차에서 본 int x 경고와 같습니다. 구조체는 멤버마다 경고해 줍니다. 지역 구조체 변수는 자동으로 0이 되지 않으니, Person p = {0}; 으로 시작하거나(1.3) 동적 할당이라면 calloc 을 쓰세요(7.2).
7) free 한 구조체를 다시 쓰기
Book *b = malloc(sizeof(Book));
...
free(b);
printf("%s\n", b->title);   // 해제한 메모리를 읽는다
free 한 뒤에도 b 에는 옛 주소가 남아 있어서, 코드가 그럴듯하게 돌아가는 것처럼 보일 수 있습니다. 7주차의 “해제 후 사용” 버그입니다. free(b); b = NULL; 로 습관을 들이고(7.1), 의심스러우면 valgrind 로 확인하세요. 주소록 프로젝트의 ab_free 에서 본 “해제 전에 next 를 먼저 챙기기”도 같은 함정을 피하는 방법입니다.
8) 구조체를 == 나 memcmp 로 비교
if (a == b) ...                      // error: invalid operands to binary ==
if (memcmp(&a, &b, sizeof a) == 0)   // 컴파일은 되지만 틀릴 수 있다
1.5와 2.3에서 봤습니다. == 는 아예 안 되고, memcmp 는 패딩 바이트의 쓰레기 값까지 비교해서 멤버가 모두 같아도 “다르다”고 할 수 있습니다. 멤버를 하나씩 비교하는 함수를 만드세요.
마치며
이번 주에는 C에서 “나만의 자료형”을 만드는 도구를 모두 다뤘습니다.
- 구조체로 흩어진 데이터를 하나의 단위로 묶었습니다. 정의는 설계도, 선언은 실제 메모리라는 것, 초기화의 세 가지 방법과 빠진 멤버가 0이 되는 규칙, 복사는 되지만 비교는 안 되는 이유를 봤습니다.
- 패딩과 정렬을
offsetof와 바이트 덤프로 직접 들여다봤습니다. 62바이트가 아니라 64바이트인 이유, 멤버 순서만 바꿔 32바이트를 16바이트로 줄이는 법, 끝 패딩이 배열 때문에 필요하다는 것을 확인했습니다. - 구조체 배열, 포인터(
->), 함수 전달에서는 주소를 찍어 보고 값 전달이 64바이트 사본을 만들고 포인터 전달은 8바이트 주소만 넘긴다는 것을 눈으로 확인했습니다. - 공용체로 같은 4바이트를 정수, 실수, 바이트 배열로 번갈아 읽었습니다. 1078523331 은 쓰레기가 아니라 3.14 의 비트였습니다. 그리고 그 위험을 태그드 유니온으로 막았습니다.
- 열거형은 “잘못된 값을 막는 자물쇠”가 아니라 “숫자에 붙인 이름표”지만,
switch에서 빠진 경우를 찾아 준다는 것을 봤습니다. - 비트 필드가 실제로 비트를 어떻게 채우는지, 그리고 정말 메모리를 아끼는 건 언제인지 정직하게 따져 봤습니다.
세 프로젝트에서는 이 개념들이 따로 노는 문법이 아니라 실제 프로그램에서 어떻게 맞물리는지 봤습니다. 동적 구조체 배열, 연결 리스트, 태그드 유니온은 모두 앞으로 배울 자료구조와 시스템 프로그래밍의 축소판입니다.
9주차에서는 파일 입출력을 배웁니다. 지금까지 만든 데이터는 프로그램이 끝나면 사라졌지만, 파일에 저장하면 남길 수 있습니다. 특히 구조체를 파일에 통째로 저장하고 읽어 오는 fwrite / fread 를 배우면 이번 주의 학생 관리 시스템에 “저장” 기능을 붙일 수 있습니다. 그때 2절에서 본 패딩까지 파일에 저장된다는 사실이 다시 등장하니, 오늘 본 바이트 그림을 기억해 두세요. 그리고 10주차에는 이번 주 12절의 연결 리스트를 완전히 다루고, 정렬과 패딩 이야기도 한 단계 더 깊이 들어갑니다.
예제를 그대로 따라 치는 데서 멈추지 말고, 각 절의 “직접 해 보기”와 실험을 꼭 해 보세요. sizeof 와 offsetof 를 찍어 보는 5분이, 앞으로 구조체를 볼 때마다 머릿속에 바이트 그림을 떠올리게 해 줄 겁니다.
체크리스트
각 항목을 설명하거나 직접 해 볼 수 있으면 체크합니다.
- [ ] 구조체 정의(설계도)와 변수 선언(실제 메모리)의 차이를 설명할 수 있다
- [ ] 구조체 정의 끝에 세미콜론이 필요한 이유와, 빠뜨렸을 때 오류가 다음 줄에서 나는 이유를 안다
- [ ] 순서대로, 지정 초기화,
{0}으로 구조체를 초기화할 수 있고, 적지 않은 멤버가 0이 된다는 것을 안다 - [ ] 문자열 멤버를
=로 대입할 수 없는 이유를 알고strcpy로 넣을 수 있다 - [ ] 구조체는
=로 복사되지만==로 비교할 수 없는 이유를 패딩과 연결해 설명할 수 있다 - [ ]
sizeof와offsetof로 구조체의 메모리 배치를 찍고, 패딩 위치를 그림으로 그릴 수 있다 - [ ] 멤버 순서를 바꿔 구조체 크기를 줄일 수 있다
- [ ] 끝 패딩이 필요한 이유를 구조체 배열로 설명할 수 있다
- [ ]
typedef의 세 가지 모양을 알고, 자기참조 구조체에 태그 이름이 필요한 이유를 안다 - [ ] 점(
.)과 화살표(->)를 구분해 쓰고,(*p).x에 괄호가 필요한 이유를 안다 - [ ] 값 전달과 포인터 전달의 차이를 주소를 찍어 확인했고,
const포인터를 쓸 줄 안다 - [ ] 구조체를
malloc/calloc/realloc으로 할당하고 valgrind 로 누수가 없음을 확인했다 - [ ] 중첩 구조체에
.과->를 단계별로 이어 접근할 수 있다 - [ ] 공용체의 크기가 가장 큰 멤버 크기인 이유와, 다른 멤버로 읽었을 때 나오는 값의 정체를 설명할 수 있다
- [ ] 태그드 유니온으로 여러 타입의 값을 안전하게 담을 수 있다
- [ ] 열거형이 사실상
int라는 것과,switch에서default를 빼면 빠진case를 경고받을 수 있다는 것을 안다 - [ ] 비트 필드가 비트를 채우는 순서를 확인했고, 주소를 구할 수 없는 이유와 값이 잘리는 규칙을 안다
- [ ] 연결 리스트에 노드를 끼워 넣을 때 포인터를 바꾸는 순서를 설명할 수 있다
- [ ] 얕은 복사가 double free 로 이어지는 과정을 재현하고, 깊은 복사 함수를 만들 수 있다
- [ ] 세 프로젝트를 빌드해 실행하고, valgrind 로 오류 0개를 확인했다
참고 자료
man 3 offsetof,man 3 memset,man 3 memcpy— 이번 주에 쓴 함수들의 설명서- The C Programming Language (K&R) — 6장 Structures
- cppreference — Struct declaration
- cppreference — Union declaration
- cppreference — Enumerations
- cppreference — Bit-field
- cppreference — Object alignment (
_Alignof) - 다음 주차: 9주차 파일 입출력 — 구조체를 파일에 저장하고 읽어 오기