학습 목표
이번 주차를 마치면 다음을 할 수 있습니다.
pthread_create의 인자 네 개가 각각 무엇인지 설명하고, 스레드를 만들고, 인자를 넘기고, 결과를 회수할 수 있다- 스레드와 프로세스가 무엇이 다른지 주소를 직접 찍어서 설명할 수 있다
- 락 없이 공유 변수를 고치면 왜 값이 사라지는지, 기계어 수준에서 설명할 수 있다
- 뮤텍스와 조건 변수로 안전한 공유 자료구조를 만들 수 있다
- 교착 상태를 일부러 만들고,
gdb로 어느 스레드가 무엇을 기다리는지 찾을 수 있다 -fsanitize=thread의 보고를 읽고 경쟁 조건이 있는 줄을 짚을 수 있다- 읽기-쓰기 락과 스핀락이 언제 이득이고 언제 손해인지 측정으로 판단할 수 있다
- 원자적 연산과 CAS 를 이해하고 락-프리의 한계(ABA)를 안다
- 거짓 공유를 인식하고 패딩으로 피할 수 있다
- 스레드 안전하지 않은 함수를 식별하고
_r버전으로 바꿀 수 있다 - 스레드 풀을 구현하고, 스레드를 코어 수보다 늘려도 왜 더 빨라지지 않는지 설명할 수 있다
들어가며
19주차에서 프로세스들이 대화하는 법을 배웠습니다. 파이프를 파고, 공유 메모리를 만들고, 세마포어로 순서를 맞췄죠. 꽤 번거로웠습니다.
그런데 생각해 보면 이상합니다. 같은 프로그램의 일부끼리 왜 그렇게 어렵게 대화해야 할까요? 웹 서버가 요청 100개를 동시에 처리한다고 합시다. 요청을 처리하는 코드는 전부 같은 코드이고, 같은 설정과 같은 캐시를 봐야 합니다. 그런데 요청마다 fork 로 프로세스를 만들면 메모리가 통째로 갈라지고, 캐시 하나를 공유하려고 다시 공유 메모리를 만들어야 합니다. 배보다 배꼽이 큽니다.
스레드(thread) 가 그 답입니다. 스레드는 같은 프로세스 안에서 실행 흐름만 여럿인 것입니다. 실이라는 뜻의 이름 그대로, 한 프로그램 안에 실행의 실이 여러 가닥 지나가는 모습을 떠올리면 됩니다.
프로세스 (fork)              스레드 (pthread)
┌─────────────┐             ┌─────────────────────┐
│ 코드 | 데이터 │             │ 코드 | 데이터 | 힙   │  <- 전부 공유!
│ 힙   | 스택  │             ├──────┬──────┬──────┤
└─────────────┘             │ 스택1 │ 스택2 │ 스택3 │  <- 이것만 각자
┌─────────────┐             └──────┴──────┴──────┘
│ 코드 | 데이터 │  <- 복사
│ 힙   | 스택  │
└─────────────┘
18주차에서 프로세스의 메모리가 코드, 데이터(전역 변수), 힙, 스택으로 나뉜다는 것을 배웠습니다. fork 는 이 네 가지를 전부 복사합니다(정확히는 복사한 것처럼 보이게 합니다). 스레드는 코드, 데이터, 힙을 그대로 공유하고, 스택 하나와 레지스터 한 벌만 새로 받습니다.
왜 스택만 따로일까요? 5주차에서 함수를 부를 때마다 스택에 새 칸이 쌓이고, 지역 변수가 거기 산다는 것을 봤습니다. 실행 흐름이 둘이면 각자 “지금 어느 함수의 어느 줄을 실행 중인가”가 다르니, 함수 호출의 흔적을 쌓는 스택도 각자 있어야 합니다. 반대로 전역 변수와 힙은 “이 프로그램의 데이터”이지 “이 흐름의 데이터”가 아니니 나눌 이유가 없습니다.
그래서 IPC 가 필요 없습니다. 전역 변수 하나가 곧 공유 메모리입니다. 공유 메모리를 만들고, 세마포어를 초기화하고, mmap 하던 그 준비가 전부 사라집니다.
대신 대가가 있습니다. 19주차에는 “내가 명시적으로 만든 공유 메모리”만 조심하면 됐습니다. 스레드에서는 모든 전역 변수와 모든 힙 데이터가 잠재적 공유 자원입니다. 위험 범위가 프로그램 전체로 넓어지는 것이죠. 그리고 프로세스 하나가 죽으면 그 프로세스만 죽지만, 스레드 하나가 잘못된 주소를 건드리면 프로세스 전체가 죽습니다. 이번 주에 직접 확인합니다.
이번 주는 그 위험을 다루는 도구들을 배웁니다. 뮤텍스, 조건 변수, 읽기-쓰기 락, 원자적 연산. 그리고 측정을 많이 합니다. “스핀락이 빠르다”, “락-프리가 빠르다” 같은 통념이 실제로 맞는지 이 컴퓨터에서 직접 재 봅니다. 결과가 교과서와 다를 때도 있습니다.
이 글의 측정 환경: AMD Ryzen 5 5600X (물리 코어 6개, 논리 CPU 12개), GCC 13.3.0, glibc 2.39. 시간과 주소는 실행마다, 컴퓨터마다 다릅니다. 절대값이 아니라 배율과 순서를 보세요. 여러분 컴퓨터의 논리 CPU 수는
nproc으로 확인합니다.
컴파일 옵션
이번 주의 모든 예제는 이렇게 컴파일합니다.
gcc -Wall -Wextra -std=gnu11 -g 파일이름.c -o 실행파일이름 -pthread
1주차의 기본 명령과 두 곳이 다릅니다.
① -std=c11 이 아니라 -std=gnu11 입니다. 이번 주 예제는 usleep 처럼 C 표준에는 없고 POSIX 에만 있는 함수를 씁니다. -std=c11 로 컴파일하면 이렇게 됩니다.
$ gcc -Wall -Wextra -std=c11 examples/thread_basic.c -o build/thread_basic -pthread
examples/thread_basic.c: In function ‘simple_worker’:
examples/thread_basic.c:31:5: warning: implicit declaration of function ‘usleep’; did you mean ‘sleep’? [-Wimplicit-function-declaration]
   31 |     usleep(100000);
      |     ^~~~~~
      |     sleep
1주차 10절에서 본 “선언 없이 함수를 썼다”는 경고입니다. -std=c11 은 “표준 C 에 있는 것만 보여 달라”는 뜻이라, 헤더가 usleep 선언을 숨겨 버립니다. gnu11 은 C11 에 GNU 와 POSIX 확장을 더한 것이라 이런 함수가 그대로 보입니다. 18주차부터 시스템 프로그래밍 예제가 계속 gnu11 을 써 온 이유입니다.
② 끝에 -pthread 가 붙습니다. 인터넷의 옛 글에는 -lpthread 라고 적혀 있는 경우가 많습니다. 둘의 차이와 현재 상황을 정확히 알아 둡시다.
-lpthread는 2주차에서 배운-lm과 같은 종류로, “libpthread라이브러리를 링크하라”는 뜻입니다.-pthread는 그 링크에 더해, 컴파일 단계에도 스레드용 설정을 켭니다. 실제로 이 옵션이_REENTRANT라는 이름을 정의하는 것을 확인할 수 있습니다.
$ echo | gcc -pthread -dM -E - | grep REENTRANT
#define _REENTRANT 1
그런데 요즘 리눅스에서는 사정이 바뀌었습니다. glibc 2.34(2021년)부터 스레드 함수들이 별도 라이브러리가 아니라 C 표준 라이브러리 libc.so.6 안에 들어갔습니다. 이 컴퓨터의 glibc 는 2.39 라서, 아무 옵션 없이도 링크됩니다.
$ gcc -Wall -Wextra -std=gnu11 examples/mutex_basic.c -o build/mutex_basic
$ echo $?
0
그럼 -pthread 를 왜 붙일까요? 여러분의 코드가 오래된 배포판이나 다른 유닉스에서도 컴파일되게 하려면 여전히 필요하고, 붙여서 손해 볼 것은 없기 때문입니다. -pthread 를 붙이는 것을 습관으로 삼되, 어느 날 이 옵션 없이도 링크가 된다고 놀라지는 마세요. 그것이 정상입니다.
Makefile 에는 이 옵션들이 이미 들어 있습니다. 5주차에서 배운 대로 make 한 번이면 예제 9개와 프로젝트 3개가 build/ 아래에 만들어집니다.
$ cd week20
$ make
컴파일: examples/atomic_ops.c
...
✓ 모든 파일 빌드 완료!
1. 스레드의 첫걸음
1.1 만들고, 기다리기
스레드를 만드는 함수는 pthread_create, 끝나기를 기다리는 함수는 pthread_join 입니다. 18주차의 fork 와 wait 에 대응합니다.
pthread_t th;
pthread_create(&th, NULL, 함수, 인자);   /* 만들기 */
pthread_join(th, &반환값);                /* 기다리기 */
fork 와 결정적으로 다른 점이 하나 있습니다. fork 는 “호출한 지점부터 둘 다 계속” 실행됐습니다. 스레드는 “이 함수를 새 흐름으로 실행해라” 입니다. 어느 함수부터 시작할지 우리가 정합니다.
pthread_create 의 원형을 /usr/include/pthread.h 에서 그대로 가져왔습니다. 인자가 넷입니다.
extern int pthread_create (pthread_t *__restrict __newthread,
                           const pthread_attr_t *__restrict __attr,
                           void *(*__start_routine) (void *),
                           void *__restrict __arg);
| 인자 | 타입 | 뜻 |
|---|---|---|
① newthread |
pthread_t * |
새 스레드의 이름표를 받을 변수의 주소. pthread_t 는 스레드를 가리키는 번호표 타입입니다. 함수가 여기에 값을 써 주므로 6주차에서 배운 대로 주소(&th)를 넘깁니다 |
② attr |
const pthread_attr_t * |
스택 크기 같은 속성. NULL 이면 기본값. 이번 주 내내 NULL 을 씁니다 |
③ start_routine |
void *(*)(void *) |
새 흐름이 처음 실행할 함수. 7주차의 함수 포인터입니다 |
④ arg |
void * |
그 함수에 넘길 인자 하나 |
| 반환값 | int |
성공하면 0, 실패하면 오류 번호. 18주차의 시스템 콜과 달리 errno 에 넣지 않고 직접 돌려줍니다 |
__restrict 는 “이 포인터들이 서로 겹치지 않는다”는 컴파일러 힌트입니다. 지금은 무시해도 됩니다.
③ 의 타입이 낯설게 생겼습니다. 7주차에서 배운 오른쪽-왼쪽 규칙으로 읽으면 “void * 하나를 받아 void * 를 돌려주는 함수를 가리키는 포인터”입니다. 그러니 스레드 함수는 반드시 이런 모양이어야 합니다.
void *함수이름(void *arg);
왜 하필 void * 일까요? 7주차에서 void * 는 “무슨 타입인지 모르는 주소”라고 했습니다. pthread_create 를 만든 사람은 여러분이 스레드에 정수를 넘길지, 구조체를 넘길지, 문자열을 넘길지 알 수 없습니다. 그래서 “뭐든 주소로 넘겨라, 받는 쪽에서 원래 타입으로 되돌려 써라” 고 정한 것입니다. 반환값이 void * 인 것도 같은 이유입니다. 10주차의 제네릭 벡터가 void * 로 아무 타입이나 담았던 것과 같은 발상입니다.
pthread_join 은 인자가 둘입니다.
extern int pthread_join (pthread_t __th, void **__thread_return);
- ①
th: 기다릴 스레드의 번호표. 이번에는 주소가 아니라 값입니다. 읽기만 하니까요. - ②
thread_return: 스레드 함수가return한void *를 받을 변수의 주소. 그래서void **입니다. 관심 없으면NULL.
이제 예제를 봅시다. 조금 길지만 1절 전체가 이 파일 하나입니다.
examples/thread_basic.c:
/*
 * thread_basic.c - 스레드의 첫걸음
 * 20주차: 멀티스레딩과 병렬 프로그래밍
 *
 * 18~19주차에서는 fork로 '프로세스'를 만들었습니다.
 * 프로세스는 메모리가 분리되어 있어서 대화하려면 IPC가 필요했죠.
 *
 * 스레드는 다릅니다. 같은 프로세스 안에서 실행 흐름만 여럿입니다:
 *   - 코드, 전역 변수, 힙, 열린 파일 -> 전부 공유!
 *   - 스택과 레지스터만 각자 하나씩
 *
 * 그래서 IPC가 필요 없습니다. 전역 변수가 곧 공유 메모리니까요.
 * 대신 '모든 변수가 공유 자원'이라 경쟁 조건 위험이 훨씬 큽니다.
 *
 * 컴파일: gcc ... -pthread
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <pthread.h>

/* 전역 변수: 모든 스레드가 공유한다 (fork와 결정적 차이!) */
static int shared_counter = 0;

/* 스레드 함수의 시그니처는 정해져 있다: void *(*)(void *) */
static void *simple_worker(void *arg) {
    int id = *(int *)arg;

    printf("  [스레드 %d] 시작! (TID %lu)\n", id, (unsigned long)pthread_self());
    usleep(100000);
    printf("  [스레드 %d] 끝\n", id);

    return NULL;                 /* 반환값도 void* */
}

/* 인자를 구조체로 넘기는 실전 방식 */
typedef struct {
    int  id;
    long from, to;
} SumArg;

typedef struct {
    long sum;
    long count;
} SumResult;

static void *range_sum(void *arg) {
    SumArg *a = arg;

    long total = 0;
    for (long n = a->from; n <= a->to; n++) total += n;

    /* 결과는 힙에 담아 반환한다 (지역 변수 주소는 절대 금지!) */
    SumResult *result = malloc(sizeof(SumResult));
    if (result == NULL) return NULL;
    result->sum = total;
    result->count = a->to - a->from + 1;

    printf("  [스레드 %d] %ld~%ld 합계 = %ld\n", a->id, a->from, a->to, total);
    return result;
}

/* 공유 변수를 그냥 건드리는 스레드 (19주차의 그 문제가 재현된다) */
static void *unsafe_increment(void *arg) {
    long loops = (long)arg;
    for (long i = 0; i < loops; i++) {
        shared_counter++;        /* 락 없음! */
    }
    return NULL;
}

int main(void) {
    printf("=== 1. 스레드 만들기 ===\n");
    printf("메인 스레드 TID: %lu, PID: %d\n\n",
           (unsigned long)pthread_self(), getpid());

    pthread_t threads[4];
    int ids[4];

    for (int i = 0; i < 3; i++) {
        ids[i] = i + 1;
        /* pthread_create(스레드핸들, 속성, 함수, 인자) */
        if (pthread_create(&threads[i], NULL, simple_worker, &ids[i]) != 0) {
            perror("pthread_create");
            return 1;
        }
    }

    /* join = 스레드판 wait. 끝날 때까지 기다린다 */
    for (int i = 0; i < 3; i++) {
        pthread_join(threads[i], NULL);
    }
    printf("모든 스레드 종료 (PID는 %d로 그대로!)\n", getpid());
    printf("-> fork였다면 PID가 다른 프로세스가 생겼을 겁니다.\n");
    printf("   스레드는 '같은 프로세스 안의 다른 실행 흐름'입니다.\n\n");

    /* ---------- 2. 인자와 반환값 ---------- */
    printf("=== 2. 인자 전달과 반환값 ===\n");
    printf("1~4000000을 4등분해서 각 스레드가 합산합니다.\n");

    SumArg args[4];
    long chunk = 1000000;
    for (int i = 0; i < 4; i++) {
        args[i].id = i + 1;
        args[i].from = (long)i * chunk + 1;
        args[i].to = (long)(i + 1) * chunk;
        pthread_create(&threads[i], NULL, range_sum, &args[i]);
    }

    long grand_total = 0, total_count = 0;
    for (int i = 0; i < 4; i++) {
        void *ret = NULL;
        pthread_join(threads[i], &ret);          /* 반환값 회수! */
        if (ret != NULL) {
            SumResult *r = ret;
            grand_total += r->sum;
            total_count += r->count;
            free(r);                             /* 스레드가 malloc, 내가 free */
        }
    }
    printf("전체 합계: %ld (%ld개 숫자)\n", grand_total, total_count);

    long expected = 4000000L * 4000001L / 2;
    printf("검증: %ld  %s\n\n", expected,
           grand_total == expected ? "-> 일치!" : "-> 불일치?!");

    /* ---------- 3. 인자 전달의 함정 ---------- */
    printf("=== 3. 인자 전달의 함정 ===\n");
    printf("흔한 실수: 반복 변수의 주소를 그대로 넘기기\n\n");
    printf("  for (int i = 0; i < 3; i++)\n");
    printf("      pthread_create(&t[i], NULL, func, &i);   <- 위험!\n\n");
    printf("i는 하나뿐이라 모든 스레드가 같은 주소를 봅니다.\n");
    printf("스레드가 읽을 때쯤 i는 이미 3이 되어 있을 수도 있죠.\n");
    printf("해법: 스레드마다 별도의 저장소 (배열 또는 malloc)\n\n");

    /* ---------- 4. 스레드도 경쟁 조건이 있다 ---------- */
    printf("=== 4. 공유 변수와 경쟁 조건 (19주차 재방문) ===\n");
    printf("전역 변수는 모든 스레드가 공유합니다. 락 없이 올리면?\n");

    shared_counter = 0;
    long loops = 200000;
    for (int i = 0; i < 4; i++) {
        pthread_create(&threads[i], NULL, unsafe_increment, (void *)loops);
    }
    for (int i = 0; i < 4; i++) pthread_join(threads[i], NULL);

    printf("기대: %ld / 실제: %d", loops * 4, shared_counter);
    if (shared_counter != loops * 4) {
        printf("  -> %ld번 증발!\n", loops * 4 - shared_counter);
    } else {
        printf("  -> 이번엔 통과 (운이 좋았습니다)\n");
    }
    printf("19주차와 똑같은 문제입니다. 해결도 똑같이 '락'으로 합니다.\n");
    printf("다만 스레드는 '모든 전역 변수'가 공유라 위험 범위가 훨씬 넓죠.\n\n");

    /* ---------- 5. 분리(detach) 스레드 ---------- */
    printf("=== 5. join 하지 않는 스레드 (detach) ===\n");
    printf("join을 안 하면 스레드 자원이 남습니다 (18주차 좀비와 비슷!).\n");
    printf("기다릴 생각이 없다면 detach로 '알아서 정리해라'라고 선언합니다.\n");

    pthread_t detached;
    int did = 99;
    pthread_create(&detached, NULL, simple_worker, &did);
    pthread_detach(detached);        /* 이제 join 불가, 끝나면 자동 정리 */
    usleep(250000);                  /* 출력 볼 시간만 주기 */

    printf("\n=== 6. 스레드 vs 프로세스 요약 ===\n");
    printf("+----------------+---------------------+--------------------+\n");
    printf("|                | 프로세스 (fork)     | 스레드 (pthread)   |\n");
    printf("+----------------+---------------------+--------------------+\n");
    printf("| 메모리         | 분리 (COW 복사)     | 공유 (스택만 별도) |\n");
    printf("| 통신           | IPC 필요            | 전역 변수면 끝     |\n");
    printf("| 생성 비용      | 비쌈                | 쌈                 |\n");
    printf("| 격리(안정성)   | 하나 죽어도 무사    | 하나 죽으면 전부   |\n");
    printf("| 동기화 범위    | 명시적 공유 자원만  | 모든 전역/힙       |\n");
    printf("| 대기           | wait/waitpid        | pthread_join       |\n");
    printf("+----------------+---------------------+--------------------+\n");
    return 0;
}
컴파일하고 실행합니다.
$ cd week20
$ gcc -Wall -Wextra -std=gnu11 -g examples/thread_basic.c -o build/thread_basic -pthread
$ ./build/thread_basic
=== 1. 스레드 만들기 ===
메인 스레드 TID: 124009367398208, PID: 305265

  [스레드 1] 시작! (TID 124009364584128)
  [스레드 2] 시작! (TID 124009356191424)
  [스레드 3] 시작! (TID 124009347798720)
  [스레드 1] 끝
  [스레드 2] 끝
  [스레드 3] 끝
모든 스레드 종료 (PID는 305265로 그대로!)
-> fork였다면 PID가 다른 프로세스가 생겼을 겁니다.
   스레드는 '같은 프로세스 안의 다른 실행 흐름'입니다.

=== 2. 인자 전달과 반환값 ===
1~4000000을 4등분해서 각 스레드가 합산합니다.
  [스레드 3] 2000001~3000000 합계 = 2500000500000
  [스레드 4] 3000001~4000000 합계 = 3500000500000
  [스레드 1] 1~1000000 합계 = 500000500000
  [스레드 2] 1000001~2000000 합계 = 1500000500000
전체 합계: 8000002000000 (4000000개 숫자)
검증: 8000002000000  -> 일치!

=== 3. 인자 전달의 함정 ===
...

=== 4. 공유 변수와 경쟁 조건 (19주차 재방문) ===
전역 변수는 모든 스레드가 공유합니다. 락 없이 올리면?
기대: 800000 / 실제: 227368  -> 572632번 증발!
19주차와 똑같은 문제입니다. 해결도 똑같이 '락'으로 합니다.
다만 스레드는 '모든 전역 변수'가 공유라 위험 범위가 훨씬 넓죠.

=== 5. join 하지 않는 스레드 (detach) ===
join을 안 하면 스레드 자원이 남습니다 (18주차 좀비와 비슷!).
기다릴 생각이 없다면 detach로 '알아서 정리해라'라고 선언합니다.
  [스레드 99] 시작! (TID 124009347798720)
  [스레드 99] 끝
...
출력을 위에서부터 읽어 봅시다.
PID 가 그대로입니다. 스레드 세 개를 만들고 끝냈는데 getpid() 는 처음과 같은 305265 입니다. 스레드는 새 프로세스가 아닙니다. 대신 pthread_self() 가 돌려주는 TID(스레드 번호표) 는 넷이 전부 다릅니다. 124009367398208 처럼 이상하게 큰 숫자인 이유는, glibc 가 pthread_t 에 그 스레드의 관리 구조체 주소를 넣어 두기 때문입니다. 즉 이 숫자는 주소입니다.
시작 순서와 끝나는 순서가 실행마다 다릅니다. 2번 실험에서 스레드 3이 스레드 1보다 먼저 출력했습니다. 누가 먼저 CPU 를 받을지는 커널 스케줄러가 정하고, 우리는 통제할 수 없습니다. 스레드 프로그램에서 “먼저 만든 스레드가 먼저 끝나겠지” 같은 순서 가정은 전부 버려야 합니다. 이번 주의 첫 번째 교훈입니다.
스레드 99의 TID 가 스레드 3과 같습니다. 124009347798720 이 두 번 나왔습니다. 스레드 3이 끝나고 자원이 회수된 뒤, 같은 자리에 새 스레드가 만들어졌기 때문입니다. pthread_t 는 살아 있는 동안만 유일한 번호표이고, 죽은 스레드의 번호표는 재사용됩니다. 끝난 스레드의 pthread_t 를 들고 있다가 나중에 쓰면 엉뚱한 스레드를 가리킬 수 있습니다.
800000 이 되어야 할 카운터가 227368 입니다. 4절에서 다룹니다. 지금은 “락 없이 공유 변수를 고치면 값이 사라진다”는 사실만 확인해 두세요. 다시 실행하면 다른 숫자가 나옵니다.
$ ./build/thread_basic | grep 기대
기대: 800000 / 실제: 262395  -> 537605번 증발!
스레드를 밖에서 들여다보기
스레드가 정말 “같은 프로세스 안”에 있는지 밖에서 확인할 수 있습니다. 18주차에서 쓴 ps 에 -L 옵션을 주면 프로세스가 아니라 스레드 단위로 보여 줍니다. 1.4초쯤 도는 cond_var 예제(4절)를 뒤에서 돌려 놓고 봅시다.
$ ./build/cond_var > /dev/null &
$ ps -L -o pid,lwp,nlwp,comm -p $!
    PID     LWP NLWP COMMAND
 314352  314352    3 cond_var
 314352  314354    3 cond_var
 314352  314355    3 cond_var
세 줄 모두 PID 는 314352 로 같고, LWP 가 다릅니다. LWP 는 lightweight process, 경량 프로세스라는 뜻으로 리눅스 커널이 스레드를 부르는 이름입니다. NLWP 는 이 프로세스의 스레드 수(3개: 메인, 생산자, 소비자)입니다.
리눅스 커널 입장에서 스레드는 “메모리를 공유하는 프로세스”입니다. 실제로 pthread_create 는 18주차의 fork 와 같은 뿌리인 clone 시스템 콜을 “메모리를 공유하라”는 플래그와 함께 부릅니다. 첫 번째 LWP 번호가 PID 와 같은 것도 그래서입니다. 메인 스레드가 곧 그 프로세스입니다.
1.2 인자 전달의 함정
예제의 3번이 경고하는, 스레드 초보가 거의 반드시 한 번은 하는 실수입니다. 이번에는 말로만 듣지 말고 직접 저질러 봅시다. loopvar.c 로 저장하세요.
#include <stdio.h>
#include <unistd.h>
#include <pthread.h>

static void *worker(void *arg) {
    usleep(1000);                          /* 잠깐 늦게 읽는다 */
    int id = *(int *)arg;
    printf("  스레드가 읽은 id = %d\n", id);
    return NULL;
}

int main(void) {
    pthread_t t[3];
    for (int i = 0; i < 3; i++)
        pthread_create(&t[i], NULL, worker, &i);   /* 셋 다 같은 주소! */
    for (int i = 0; i < 3; i++) pthread_join(t[i], NULL);
    return 0;
}
의도는 스레드 세 개가 0, 1, 2 를 출력하는 것입니다.
$ gcc -Wall -Wextra -std=gnu11 loopvar.c -o loopvar -pthread
$ ./loopvar
  스레드가 읽은 id = 3
  스레드가 읽은 id = 3
  스레드가 읽은 id = 3
셋 다 3 입니다. 0, 1, 2 중 어느 것도 아니고, 반복문이 끝났을 때의 값입니다. 무슨 일이 일어났는지 그려 봅시다.
메인:   i = 0, create(&i)   i = 1, create(&i)   i = 2, create(&i)   i = 3, 반복 끝
스레드1:                    (1ms 자는 중) ................................. *(&i) 읽음 -> 3
스레드2:                                       (1ms 자는 중) .............. *(&i) 읽음 -> 3
스레드3:                                                         (자는 중).. *(&i) 읽음 -> 3
i 는 변수 하나입니다. 세 스레드에 넘긴 것은 값이 아니라 그 하나뿐인 변수의 주소입니다. 스레드가 그 주소를 들여다볼 때쯤 메인 스레드는 이미 반복문을 끝내고 i 를 3으로 만들었습니다. usleep 을 빼면 어떻게 될까요? 타이밍에 따라 0 1 2 가 나올 수도, 1 2 3 이 나올 수도, 2 2 3 이 나올 수도 있습니다. 잘 되는 것처럼 보이다가 어느 날 깨지는 최악의 종류입니다.
더 나쁜 경우도 있습니다. 이 예제는 main 이 join 으로 기다려 주니 i 가 살아 있기라도 하지만, 반복문이 함수 안에 있고 그 함수가 먼저 끝나면 스레드는 이미 사라진 스택 칸을 읽게 됩니다.
해법은 스레드마다 자기만의 저장소를 주는 것입니다. thread_basic.c 의 1번이 그렇게 합니다.
    int ids[4];
    for (int i = 0; i < 3; i++) {
        ids[i] = i + 1;                          /* 각자 자기 칸 */
        pthread_create(&threads[i], NULL, simple_worker, &ids[i]);
    }
ids[0], ids[1], ids[2] 는 서로 다른 칸이고, main 이 join 할 때까지 살아 있습니다. 세 가지 방법이 있습니다.
| 방법 | 코드 | 언제 |
|---|---|---|
| 배열 | pthread_create(..., &ids[i]) |
스레드 수를 미리 알고, 만든 쪽이 끝까지 기다릴 때 |
malloc |
int *p = malloc(sizeof *p); *p = i; pthread_create(..., p) 그리고 스레드가 free |
스레드가 만든 쪽보다 오래 살 때 |
| 값을 포인터에 끼워 넣기 | pthread_create(..., (void *)(long)i) 받는 쪽 (int)(long)arg |
넘길 값이 포인터 크기(8바이트) 안에 들어갈 때 |
세 번째 방법이 예제의 4번(unsafe_increment 에 (void *)loops 를 넘기고 (long)arg 로 되돌림)입니다. 주소를 넘기는 척하면서 사실은 값 자체를 넘기는 트릭입니다. 7주차에서 void * 는 그냥 8바이트 숫자라고 했던 것을 기억하면 이해가 됩니다. long 은 8바이트라 손실 없이 들어갑니다.
1.3 반환값 회수
예제의 2번은 스레드가 계산한 결과를 돌려받습니다.
static void *range_sum(void *arg) {
    ...
    SumResult *result = malloc(sizeof(SumResult));   /* 힙에! */
    result->sum = total;
    return result;
}

/* 호출 쪽 */
    void *ret = NULL;
    pthread_join(threads[i], &ret);          /* 반환값 회수! */
    SumResult *r = ret;
    ...
    free(r);                                 /* 스레드가 malloc, 내가 free */
pthread_join 의 두 번째 인자 &ret 은 void ** 입니다. “스레드가 return 한 포인터를 이 변수에 담아 달라”는 뜻입니다. 결과가 여러 개(sum, count)라 구조체를 힙에 만들어 그 주소를 돌려줬고, 받은 쪽이 다 쓴 뒤 free 합니다. 7주차의 “malloc 한 쪽과 free 하는 쪽이 다를 수 있다”는 규칙이 여기서 쓰입니다.
실험: 지역 변수의 주소를 돌려주면?
힙 대신 지역 변수의 주소를 돌려주면 어떻게 될까요? retlocal.c:
#include <stdio.h>
#include <pthread.h>

static void *worker(void *arg) {
    (void)arg;
    long result = 42;
    return &result;                        /* 스택 변수의 주소! */
}

int main(void) {
    pthread_t t;
    void *ret;
    pthread_create(&t, NULL, worker, NULL);
    pthread_join(t, &ret);
    printf("받은 포인터: %p\n", ret);
    if (ret) printf("가리키는 값: %ld\n", *(long *)ret);
    return 0;
}
$ gcc -Wall -Wextra -std=gnu11 retlocal.c -o retlocal -pthread
retlocal.c: In function ‘worker’:
retlocal.c:7:12: warning: function returns address of local variable [-Wreturn-local-addr]
    7 |     return &result;                        /* 스택 변수의 주소! */
      |            ^~~~~~~
$ ./retlocal
받은 포인터: (nil)
컴파일러가 경고를 내고, 실행하면 NULL 이 돌아옵니다. 6주차에서 봤던 것과 똑같습니다. GCC 는 지역 변수의 주소를 돌려주는 코드가 어차피 쓸모없다는 것을 알고, 아예 NULL 을 돌려주도록 바꿔 버립니다. 경고를 무시했다면 “포인터가 왜 NULL 이지?” 하고 한참을 헤맸을 겁니다. 스레드가 끝나면 그 스택은 통째로 사라지므로, 결과는 반드시 힙이나 만든 쪽이 준비한 공간에 담아야 합니다.
1.4 detach: 기다리지 않을 스레드
join 을 하지 않으면 스레드가 끝나도 자원이 남습니다. 스레드의 스택과 관리 구조체는 누군가 join 으로 “결과 잘 받았다”고 해 줄 때까지 보관됩니다. 18주차의 좀비 프로세스와 같은 상황입니다. Valgrind 로 보면 이렇게 나옵니다.
==314383== 272 bytes in 1 blocks are possibly lost in loss record 1 of 1
==314383==      possibly lost: 272 bytes in 1 blocks
join 도 detach 도 하지 않은 스레드 하나가 남긴 흔적입니다. 결과를 받을 생각이 없다면 미리 선언합니다.
    pthread_create(&detached, NULL, simple_worker, &did);
    pthread_detach(detached);        /* 이제 join 불가, 끝나면 자동 정리 */
pthread_detach 는 “이 스레드는 끝나는 즉시 스스로 정리하라”는 뜻입니다. 대신 join 은 할 수 없고 반환값도 받을 수 없습니다. 로그 기록, 통계 전송처럼 결과를 안 봐도 되는 백그라운드 작업에 씁니다.
한 가지 주의할 점이 있습니다. 예제에서 detach 뒤에 usleep(250000) 이 있는 이유입니다. main 이 return 하면 프로세스 전체가 끝납니다. 아직 돌고 있는 스레드가 있어도, detach 했든 안 했든, 전부 그 자리에서 사라집니다. 스레드가 하던 파일 쓰기가 중간에 끊길 수도 있습니다. main 이 다른 스레드보다 오래 살아야 한다는 것을 잊지 마세요.
1.5 스레드는 몇 개까지 만들 수 있을까
pthread_create 가 0 이 아닌 값을 돌려주는 경우를 실제로 만들어 봅시다. 스레드를 될 때까지 만들어 보는 겁니다. manythreads.c:
#include <stdio.h>
#include <string.h>
#include <unistd.h>
#include <pthread.h>

static void *sleeper(void *arg) { (void)arg; pause(); return NULL; }   /* 영원히 잠든다 */

int main(void) {
    pthread_t t;
    long n = 0;
    for (;;) {
        int rc = pthread_create(&t, NULL, sleeper, NULL);
        if (rc != 0) {
            printf("%ld개째에서 실패: 반환값 %d (%s)\n", n + 1, rc, strerror(rc));
            break;
        }
        n++;
        if (n == 100000) { printf("100000개 성공. 여기서 멈춥니다.\n"); break; }
    }
    fflush(stdout);                        /* _exit 는 stdio 버퍼를 비우지 않는다 (18주차) */
    _exit(0);                              /* 잠든 스레드들과 함께 즉시 종료 */
}
$ gcc -Wall -Wextra -std=gnu11 manythreads.c -o manythreads -pthread
$ ./manythreads
34812개째에서 실패: 반환값 11 (Resource temporarily unavailable)
이 컴퓨터에서는 34,812개에서 막혔습니다. 반환값 11은 EAGAIN 입니다. pthread_create 는 errno 를 건드리지 않고 오류 번호를 직접 돌려주므로 strerror(rc) 로 읽습니다. perror 를 쓰면 엉뚱한 메시지가 나오니 주의하세요.
왜 3만 개쯤에서 막힐까요? 스레드 하나마다 스택이 필요한데, 그 기본 크기가 얼마인지 물어볼 수 있습니다.
    pthread_attr_t attr;
    size_t size;
    pthread_attr_init(&attr);              /* 기본 속성 */
    pthread_attr_getstacksize(&attr, &size);
    printf("스레드 기본 스택 크기: %zu 바이트 (%zu MB)\n", size, size / (1024 * 1024));
스레드 기본 스택 크기: 8388608 바이트 (8 MB)
스레드 하나에 8MB 입니다. 쉘의 ulimit -s 값(8192KB, 메인 스레드의 스택 한도)을 그대로 따릅니다. 34,812개면 약 272GB 의 가상 주소 공간입니다. 실제로 쓰는 메모리가 아니라 “예약”이라서 이만큼 만들 수 있었지만, 어느 순간 커널의 한도(/proc/sys/kernel/threads-max, 사용자별 ulimit -u)에 걸립니다.
여기서 알 수 있는 것은 두 가지입니다. 스레드는 프로세스보다 싸지만 공짜는 아니고, 그래서 “요청마다 스레드 하나”는 답이 아니라는 것입니다. 10절의 스레드 풀이 그 해법입니다. 그리고 pthread_create 의 반환값을 확인해야 한다는 것입니다. thread_basic.c 의 1번이 != 0 을 검사하는 이유입니다.
1.6 스레드 하나가 죽으면
들어가며에서 “스레드 하나가 잘못된 주소를 건드리면 프로세스 전체가 죽는다”고 했습니다. 확인합니다. thsegv.c:
#include <stdio.h>
#include <unistd.h>
#include <pthread.h>

static void *bad_thread(void *arg) {
    (void)arg;
    int *p = NULL;
    *p = 1;                                /* 스레드 하나가 죽는다 */
    return NULL;
}

int main(void) {
    pthread_t t;
    pthread_create(&t, NULL, bad_thread, NULL);
    sleep(1);
    printf("메인은 살아 있나요?\n");         /* 여기까지 올까? */
    return 0;
}
$ gcc -Wall -Wextra -std=gnu11 thsegv.c -o thsegv -pthread
$ ./thsegv
세그멘테이션 오류 (코어 덤프됨)
$ echo $?
139
“메인은 살아 있나요?”는 출력되지 않았습니다. main 은 아무 잘못도 없이 그저 1초 자고 있었는데, 다른 스레드의 세그폴트에 같이 죽었습니다. 종료 코드 139 는 6주차에서 본 그대로 “시그널 11(SIGSEGV)로 죽음”입니다.
프로세스라면 어땠을까요? 2절의 예제가 자식 프로세스를 일부러 세그폴트로 죽이고, 부모는 멀쩡하게 그 사실을 보고하는 것을 보여 줍니다. 이것이 크롬이 탭마다 프로세스를 쓰는 이유입니다. 탭 하나의 버그가 브라우저 전체를 죽이면 안 되니까요.
2. 스레드 vs 프로세스: 실측으로 비교
“프로세스와 스레드 중 뭘 쓸까?”는 시스템 설계의 단골 질문입니다. 말로 외우지 말고 직접 재 봅시다. 네 가지를 잽니다. 생성 비용, 메모리가 정말 공유되는지, 통신 비용, 그리고 하나가 죽었을 때 어떻게 되는지입니다.
examples/thread_vs_process.c:
/*
 * thread_vs_process.c - 스레드 vs 프로세스: 무엇이 얼마나 다른가
 * 20주차: 멀티스레딩과 병렬 프로그래밍
 *
 * "프로세스와 스레드 중 뭘 쓸까?"는 시스템 설계의 단골 질문입니다.
 * 말로 외우지 말고 직접 측정해 봅시다:
 *
 *   1. 생성 비용    : fork vs pthread_create
 *   2. 메모리 공유  : 변수가 정말 공유되는가
 *   3. 문맥 전환 비용: 핑퐁 통신으로 측정
 *   4. 격리         : 하나가 죽으면 어떻게 되는가
 *
 * 결론부터: 스레드가 싸고 빠르지만, 그만큼 위험합니다.
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <pthread.h>
#include <time.h>
#include <sys/wait.h>
#include <sys/mman.h>

#define ROUNDS 2000

static int global_value = 100;       /* 스레드는 공유, 프로세스는 복사 */

static double elapsed_ms(struct timespec a, struct timespec b) {
    return (b.tv_sec - a.tv_sec) * 1000.0 + (b.tv_nsec - a.tv_nsec) / 1e6;
}

static void *noop_thread(void *arg) { (void)arg; return NULL; }

static void *modify_thread(void *arg) {
    (void)arg;
    global_value = 999;              /* 전역 변수를 고친다 */
    return NULL;
}

int main(void) {
    struct timespec t0, t1;

    /* ---------- 1. 생성 비용 ---------- */
    printf("=== 1. 생성 비용: %d개를 만들고 거두기 ===\n", ROUNDS);

    clock_gettime(CLOCK_MONOTONIC, &t0);
    for (int i = 0; i < ROUNDS; i++) {
        pid_t pid = fork();
        if (pid == 0) _exit(0);
        waitpid(pid, NULL, 0);
    }
    clock_gettime(CLOCK_MONOTONIC, &t1);
    double fork_ms = elapsed_ms(t0, t1);

    clock_gettime(CLOCK_MONOTONIC, &t0);
    for (int i = 0; i < ROUNDS; i++) {
        pthread_t th;
        pthread_create(&th, NULL, noop_thread, NULL);
        pthread_join(th, NULL);
    }
    clock_gettime(CLOCK_MONOTONIC, &t1);
    double thread_ms = elapsed_ms(t0, t1);

    printf("  fork + wait      : %7.1f ms  (%.1f us/개)\n",
           fork_ms, fork_ms * 1000 / ROUNDS);
    printf("  pthread + join   : %7.1f ms  (%.1f us/개)\n",
           thread_ms, thread_ms * 1000 / ROUNDS);
    printf("  -> 스레드가 약 %.1f배 빠름\n", fork_ms / thread_ms);
    printf("  (fork는 페이지 테이블 복사, 스레드는 스택만 잡으면 끝)\n\n");

    /* ---------- 2. 메모리 공유 ---------- */
    printf("=== 2. 전역 변수는 공유되는가 ===\n");

    global_value = 100;
    pthread_t th;
    pthread_create(&th, NULL, modify_thread, NULL);
    pthread_join(th, NULL);
    printf("  스레드가 999로 바꾼 뒤 -> %d  (공유됨!)\n", global_value);

    global_value = 100;
    fflush(stdout);
    pid_t pid = fork();
    if (pid == 0) {
        global_value = 999;
        _exit(0);
    }
    waitpid(pid, NULL, 0);
    printf("  프로세스가 999로 바꾼 뒤 -> %d  (복사본이라 그대로)\n",
           global_value);
    printf("  -> 이 한 줄 차이가 '스레드는 IPC가 필요 없다'는 뜻입니다.\n\n");

    /* ---------- 3. 통신 비용: 핑퐁 ---------- */
    printf("=== 3. 문맥 전환 비용: %d번 핑퐁 ===\n", ROUNDS);

    /* (가) 프로세스 + 파이프 (19주차 방식) */
    int up[2], down[2];
    if (pipe(up) < 0 || pipe(down) < 0) { perror("pipe"); return 1; }

    fflush(stdout);
    pid = fork();
    if (pid == 0) {
        close(down[1]); close(up[0]);
        char c;
        for (int i = 0; i < ROUNDS; i++) {
            if (read(down[0], &c, 1) != 1) break;
            write(up[1], &c, 1);
        }
        close(down[0]); close(up[1]);
        _exit(0);
    }
    close(down[0]); close(up[1]);

    clock_gettime(CLOCK_MONOTONIC, &t0);
    {
        char c = 'x';
        for (int i = 0; i < ROUNDS; i++) {
            write(down[1], &c, 1);
            if (read(up[0], &c, 1) != 1) break;
        }
    }
    clock_gettime(CLOCK_MONOTONIC, &t1);
    double pipe_ms = elapsed_ms(t0, t1);
    close(down[1]); close(up[0]);
    waitpid(pid, NULL, 0);

    printf("  프로세스+파이프 : %7.2f ms  (왕복당 %.1f us)\n",
           pipe_ms, pipe_ms * 1000 / ROUNDS);
    printf("  (스레드끼리는 애초에 '전달'이 필요 없습니다 - 같은 메모리니까)\n\n");

    /* ---------- 4. 격리: 하나가 죽으면? ---------- */
    printf("=== 4. 격리: 하나가 죽으면 어떻게 되나 ===\n");

    fflush(stdout);
    pid = fork();
    if (pid == 0) {
        /* 자식이 세그폴트로 죽는다 */
        int *p = NULL;
        *p = 1;                      /* SIGSEGV! */
        _exit(0);
    }
    int status;
    waitpid(pid, &status, 0);
    if (WIFSIGNALED(status)) {
        printf("  자식 프로세스가 시그널 %d로 사망\n", WTERMSIG(status));
        printf("  그런데 부모는? 이 줄을 출력하고 있으니 멀쩡합니다.\n");
    }
    printf("  -> 프로세스는 격리되어 있습니다. 하나가 죽어도 나머지는 무사.\n");
    printf("  -> 스레드가 세그폴트를 내면? 프로세스 전체가 죽습니다!\n");
    printf("     (같은 주소 공간이니 당연하죠. 이 예제에서 시연하면\n");
    printf("      프로그램이 여기서 끝나 버리므로 설명으로 대신합니다)\n\n");

    /* ---------- 5. 선택 가이드 ---------- */
    printf("=== 5. 그래서 뭘 쓸까? ===\n");
    printf("스레드를 쓰는 경우:\n");
    printf("  - 데이터를 많이 주고받는다 (공유 메모리가 공짜)\n");
    printf("  - 작업이 짧고 자주 생성된다 (생성 비용이 싸다)\n");
    printf("  - 같은 코드가 같은 데이터를 다룬다\n");
    printf("  예: 웹 서버의 요청 처리, 병렬 계산, GUI의 백그라운드 작업\n\n");
    printf("프로세스를 쓰는 경우:\n");
    printf("  - 안정성이 중요하다 (하나가 죽어도 서비스 유지)\n");
    printf("  - 보안 격리가 필요하다 (권한을 다르게)\n");
    printf("  - 서로 다른 프로그램을 조합한다\n");
    printf("  예: 크롬의 탭별 프로세스, nginx 워커, 셸 파이프라인\n\n");
    printf("실전에서는 '프로세스 여러 개 x 각자 스레드 여러 개'가 흔합니다.\n");
    printf("(nginx: 워커 프로세스 N개, 각 워커가 이벤트 루프 + 스레드 풀)\n");
    return 0;
}
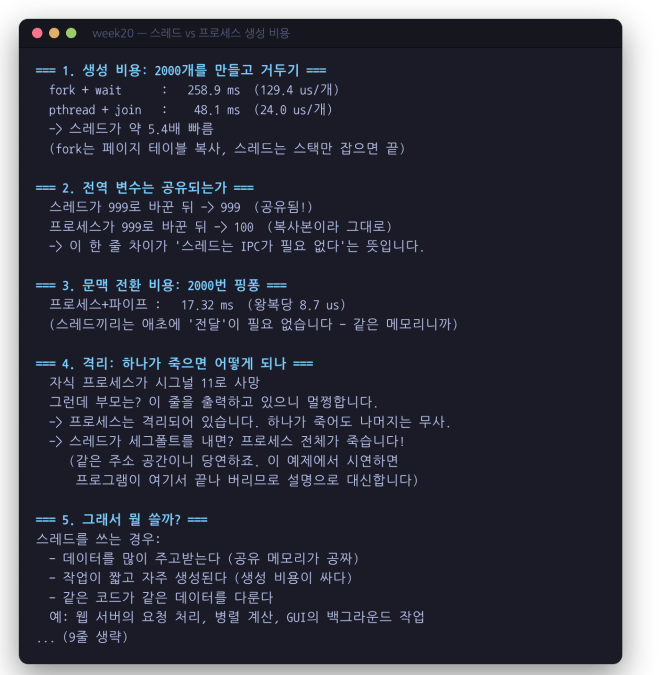
스레드 vs 프로세스 생성 비용
그림은 글을 쓴 뒤 다시 돌린 결과입니다. 벤치마크라서 본문 표와 수치가 몇 % 다릅니다. 배속과 순서가 같은지를 보세요 — 절대값이 아니라 그게 이 측정이 말하려는 것입니다.
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/thread_vs_process.c -o build/thread_vs_process -pthread
$ ./build/thread_vs_process
=== 1. 생성 비용: 2000개를 만들고 거두기 ===
  fork + wait      :   238.9 ms  (119.4 us/개)
  pthread + join   :    46.0 ms  (23.0 us/개)
  -> 스레드가 약 5.2배 빠름
  (fork는 페이지 테이블 복사, 스레드는 스택만 잡으면 끝)

=== 2. 전역 변수는 공유되는가 ===
  스레드가 999로 바꾼 뒤 -> 999  (공유됨!)
  프로세스가 999로 바꾼 뒤 -> 100  (복사본이라 그대로)
  -> 이 한 줄 차이가 '스레드는 IPC가 필요 없다'는 뜻입니다.

=== 3. 문맥 전환 비용: 2000번 핑퐁 ===
  프로세스+파이프 :   15.20 ms  (왕복당 7.6 us)
  (스레드끼리는 애초에 '전달'이 필요 없습니다 - 같은 메모리니까)

=== 4. 격리: 하나가 죽으면 어떻게 되나 ===
  자식 프로세스가 시그널 11로 사망
  그런데 부모는? 이 줄을 출력하고 있으니 멀쩡합니다.
  -> 프로세스는 격리되어 있습니다. 하나가 죽어도 나머지는 무사.
  -> 스레드가 세그폴트를 내면? 프로세스 전체가 죽습니다!
...
2.1 숫자가 말하는 것
생성 비용 5.2배. fork 는 2000번에 239ms, 한 번에 약 119us 입니다. 18주차에서 fork 가 메모리를 실제로 복사하지는 않고(Copy-On-Write) 페이지 테이블이라는 “메모리 지도”만 복사한다고 배웠습니다. 그 지도를 복사하고 파일 디스크립터 테이블을 준비하는 데 이만큼 듭니다. 스레드는 스택 하나 잡고 커널에 등록하면 끝이라 23us 입니다.
실무적 의미가 있습니다. 요청마다 프로세스를 만드는 옛날 CGI 방식 서버가 초당 수천 요청에서 무너지는 이유입니다. 119us × 10,000 = 1.2초, CPU 하나를 생성 비용에만 쓰는 셈입니다.
전역 변수 공유. 이 한 줄 실험이 이번 주의 출발점입니다. 스레드가 바꾼 999 는 메인에게 보이고, 자식 프로세스가 바꾼 999 는 부모에게 보이지 않습니다.
핑퐁 7.6us. 프로세스 둘이 파이프로 글자 하나를 주고받는 데 왕복 7.6us 입니다. 스레드끼리는 이 비용이 0 입니다. 전달할 필요 자체가 없으니까요. 대신 이번 주에 배울 락의 비용이 대신 들어옵니다.
격리. 자식이 시그널 11로 죽었는데 부모는 다음 줄을 출력했습니다. 1.6절의 스레드 실험과 정반대입니다.
2.2 같은 주소인데 다른 값이라고?
2번 실험을 한 번 더 파 봅시다. global_value 의 주소를 스레드와 자식 프로세스에서 각각 찍어 보면 어떨까요? addr.c:
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <pthread.h>
#include <sys/wait.h>

int global_value = 100;

static void *thread_fn(void *arg) {
    (void)arg;
    global_value = 999;
    printf("  [스레드]   global_value 주소 %p, 값 %d\n", (void *)&global_value, global_value);
    return NULL;
}

int main(void) {
    printf("  [메인]     global_value 주소 %p, 값 %d\n", (void *)&global_value, global_value);

    pthread_t th;
    pthread_create(&th, NULL, thread_fn, NULL);
    pthread_join(th, NULL);
    printf("  [메인]     스레드가 끝난 뒤 값 %d\n\n", global_value);

    global_value = 100;
    fflush(stdout);
    pid_t pid = fork();
    if (pid == 0) {
        global_value = 999;
        printf("  [자식]     global_value 주소 %p, 값 %d\n", (void *)&global_value, global_value);
        _exit(0);
    }
    waitpid(pid, NULL, 0);
    printf("  [부모]     자식이 끝난 뒤 주소 %p, 값 %d\n", (void *)&global_value, global_value);
    return 0;
}
$ gcc -Wall -Wextra -std=gnu11 addr.c -o addr -pthread
$ ./addr
  [메인]     global_value 주소 0x5a684a484010, 값 100
  [스레드]   global_value 주소 0x5a684a484010, 값 999
  [메인]     스레드가 끝난 뒤 값 999

  [자식]     global_value 주소 0x5a684a484010, 값 999
  [부모]     자식이 끝난 뒤 주소 0x5a684a484010, 값 100
스레드 쪽은 예상대로입니다. 같은 주소, 같은 변수, 그래서 값이 999 로 바뀌었습니다.
프로세스 쪽이 놀랍습니다. 자식과 부모가 찍은 주소가 똑같이 0x5a684a484010 인데 값은 999 와 100 으로 다릅니다. 같은 주소에 다른 값이 들어 있을 수 있을까요?
있습니다. 우리가 보는 주소는 가상 주소이기 때문입니다. 18주차에서 프로세스마다 자기만의 주소 공간을 갖는다고 배웠습니다. 0x5a684a484010 이라는 번지는 “이 프로세스의 지도에서 그 위치”라는 뜻이고, 부모의 지도와 자식의 지도는 같은 번지를 다른 물리 메모리로 연결할 수 있습니다. fork 직후에는 두 지도가 같은 물리 메모리를 가리키다가, 자식이 값을 쓰는 순간 그 페이지만 복사해서 갈라놓습니다. 그것이 Copy-On-Write 입니다.
스레드는 지도가 하나입니다. 그래서 같은 주소는 정말로 같은 곳입니다. “스레드는 주소 공간을 공유한다”는 말의 정확한 뜻이 이것입니다.
2.3 선택 가이드
| 스레드 | 프로세스 | |
|---|---|---|
| 데이터를 많이 주고받는다 | ✓ 공유 메모리가 공짜 | 파이프나 공유 메모리 필요 |
| 작업이 짧고 자주 생긴다 | ✓ 생성 23us | 생성 119us |
| 하나가 죽어도 서비스가 살아야 한다 | 하나 죽으면 전부 | ✓ 격리됨 |
| 권한을 다르게 주고 싶다 | 불가 (같은 프로세스) | ✓ 프로세스마다 다르게 |
| 서로 다른 프로그램을 조합한다 | 불가 | ✓ 쉘 파이프라인 |
실전에서는 둘을 섞습니다. nginx 는 워커 프로세스를 여러 개 띄우고, 각 워커가 이벤트 루프와 스레드 풀을 씁니다. 프로세스로 격리하고 스레드로 효율을 얻는 것입니다. 크롬은 탭마다 프로세스를 쓰고, 각 탭 프로세스 안에서 렌더링과 자바스크립트를 스레드로 나눕니다.
3. 뮤텍스: 스레드의 자물쇠
3.1 왜 800000 이 227368 이 되었나
1절의 4번 실험으로 돌아갑시다. 스레드 4개가 각각 shared_counter++ 를 20만 번 했는데, 결과는 80만이 아니라 227,368 이었습니다. 57만 번의 덧셈이 증발했습니다. 어디로 갔을까요?
counter++ 는 한 줄이지만 CPU 에게는 세 가지 일입니다. 7절에서 실제 기계어를 보게 되는데 미리 가져오면 이렇습니다.
mov    counter의 값, %rax     ← ① 메모리에서 읽어 레지스터에
add    $1, %rax               ← ② 레지스터에서 1 더하기
mov    %rax, counter          ← ③ 레지스터 값을 메모리에 쓰기
스레드 두 개가 이 세 단계를 번갈아 실행하면 이렇게 됩니다.
| 시각 | 스레드 A | 스레드 B | counter |
|---|---|---|---|
| 1 | ① 읽기 → 100 | 100 | |
| 2 | ① 읽기 → 100 | 100 | |
| 3 | ② 더하기 → 101 | 100 | |
| 4 | ② 더하기 → 101 | 100 | |
| 5 | ③ 쓰기 101 | 101 | |
| 6 | ③ 쓰기 101 | 101 |
두 스레드가 한 번씩 올렸으니 102 가 되어야 하는데 101 입니다. B 가 A 의 결과를 덮어썼습니다. 이것이 19주차에서 배운 경쟁 조건(race condition) 이고, 스레드 4개가 20만 번씩 하면 이런 충돌이 수십만 번 일어납니다. 12개의 논리 CPU 가 정말로 동시에 실행하니 충돌이 더 잦습니다.
해결책도 19주차와 같습니다. ①②③ 이 끝날 때까지 다른 스레드가 끼어들지 못하게 막는 것입니다. 19주차에서는 세마포어(초기값 1)를 썼습니다. 스레드 세계에는 이 용도의 전용 도구가 있습니다. 뮤텍스(mutex) 입니다. mutual exclusion, 상호 배제의 줄임말입니다.
pthread_mutex_lock(&m);      /* 잠근다. 이미 잠겨 있으면 풀릴 때까지 기다린다 */
   ... 임계 구역 ...          /* 이 안에는 한 번에 한 스레드만 */
pthread_mutex_unlock(&m);    /* 푼다 */
화장실 문의 자물쇠와 같습니다. 잠그고 들어가면 밖의 사람은 기다립니다. 세마포어와 다른 점이 셋입니다.
- 소유자가 있습니다. 잠근 스레드만 풀 수 있습니다. 세마포어는 아무나
post할 수 있었습니다. - 그래서 실수를 잡아냅니다. 남의 락을 푸는 코드, 자기가 잠근 락을 또 잠그는 코드를 탐지할 수 있습니다(3.4절).
- 보통 더 빠릅니다. 경합이 없으면 커널을 거치지 않고 사용자 공간에서 원자적 연산 한 번으로 처리됩니다. 이 기법의 이름이 futex(fast userspace mutex)입니다. 경합이 생겼을 때만 커널이 스레드를 재웁니다.
examples/mutex_basic.c:
/*
 * mutex_basic.c - 뮤텍스: 스레드의 자물쇠
 * 20주차: 멀티스레딩과 병렬 프로그래밍
 *
 * 19주차의 세마포어(초기값 1)와 목적이 같습니다 - 상호 배제.
 * 그런데 스레드 세계에는 전용 도구가 있습니다: 뮤텍스(mutex).
 *
 *   pthread_mutex_lock(&m);     // 잠근다 (이미 잠겼으면 기다린다)
 *      ... 임계 구역 ...
 *   pthread_mutex_unlock(&m);   // 푼다
 *
 * 세마포어와의 차이:
 *   - 뮤텍스는 '소유자' 개념이 있다 (잠근 스레드만 풀 수 있다)
 *   - 그래서 잘못된 사용을 잡아낼 수 있다 (에러체크 타입)
 *   - 보통 더 빠르다 (경합이 없으면 시스템 콜 없이 처리 - futex)
 *
 * 뮤텍스 종류 세 가지도 실험합니다:
 *   NORMAL(기본), ERRORCHECK(실수 탐지), RECURSIVE(같은 스레드 재잠금 허용)
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <pthread.h>
#include <errno.h>
#include <time.h>

#define THREADS 4
#define LOOPS   200000

static long counter = 0;
static pthread_mutex_t lock = PTHREAD_MUTEX_INITIALIZER;   /* 정적 초기화 */

static double elapsed_ms(struct timespec a, struct timespec b) {
    return (b.tv_sec - a.tv_sec) * 1000.0 + (b.tv_nsec - a.tv_nsec) / 1e6;
}

/* 락 없이 */
static void *unsafe_worker(void *arg) {
    (void)arg;
    for (int i = 0; i < LOOPS; i++) counter++;
    return NULL;
}

/* 락 걸고 */
static void *safe_worker(void *arg) {
    (void)arg;
    for (int i = 0; i < LOOPS; i++) {
        pthread_mutex_lock(&lock);
        counter++;                       /* 임계 구역 */
        pthread_mutex_unlock(&lock);
    }
    return NULL;
}

/* 락을 '덩어리로' 잡는 버전 - 같은 결과, 훨씬 빠르다 */
static void *batched_worker(void *arg) {
    (void)arg;
    long local = 0;
    for (int i = 0; i < LOOPS; i++) local++;   /* 지역 변수는 내 것! */

    pthread_mutex_lock(&lock);
    counter += local;                          /* 마지막에 한 번만 합친다 */
    pthread_mutex_unlock(&lock);
    return NULL;
}

static double run(void *(*fn)(void *)) {
    pthread_t th[THREADS];
    counter = 0;

    struct timespec t0, t1;
    clock_gettime(CLOCK_MONOTONIC, &t0);
    for (int i = 0; i < THREADS; i++) pthread_create(&th[i], NULL, fn, NULL);
    for (int i = 0; i < THREADS; i++) pthread_join(th[i], NULL);
    clock_gettime(CLOCK_MONOTONIC, &t1);
    return elapsed_ms(t0, t1);
}

int main(void) {
    long expected = (long)THREADS * LOOPS;

    printf("=== 1. 락 없음 vs 락 있음 ===\n");
    printf("스레드 %d개 x %d번 증가, 기대값 %ld\n\n", THREADS, LOOPS, expected);

    double ms1 = run(unsafe_worker);
    printf("  [락 없음]   결과 %8ld  (%6.1f ms)  %s\n", counter, ms1,
           counter == expected ? "정확" : "<- 증발 발생!");

    double ms2 = run(safe_worker);
    printf("  [매번 락]   결과 %8ld  (%6.1f ms)  %s\n", counter, ms2,
           counter == expected ? "정확" : "<- 증발 발생!");

    double ms3 = run(batched_worker);
    printf("  [모아서 락] 결과 %8ld  (%6.1f ms)  %s\n", counter, ms3,
           counter == expected ? "정확" : "<- 증발 발생!");

    printf("\n관찰:\n");
    printf("1. 락이 없으면 빠르지만 틀립니다 (빠른 오답은 무가치!)\n");
    printf("2. 매번 락을 잡으면 정확하지만 %.1f배 느립니다\n", ms2 / ms1);
    printf("3. 지역 변수로 모았다가 마지막에 한 번만 락을 잡으면?\n");
    printf("   정확하면서도 락 버전보다 %.1f배 빠릅니다!\n", ms2 / ms3);
    printf("   -> 락의 비용은 '횟수'에 비례합니다. 임계 구역을 줄이세요.\n");
    printf("   (이것이 병렬 프로그래밍의 기본 전략: 지역에서 계산, 전역에 합산)\n");

    /* ---------- 2. 뮤텍스의 종류 ---------- */
    printf("\n=== 2. 뮤텍스 종류 3가지 ===\n");

    /* (가) ERRORCHECK: 실수를 잡아준다 */
    pthread_mutexattr_t attr;
    pthread_mutex_t err_lock;
    pthread_mutexattr_init(&attr);
    pthread_mutexattr_settype(&attr, PTHREAD_MUTEX_ERRORCHECK);
    pthread_mutex_init(&err_lock, &attr);

    printf("[ERRORCHECK] 같은 스레드가 두 번 잠그면?\n");
    pthread_mutex_lock(&err_lock);
    int rc = pthread_mutex_lock(&err_lock);       /* 두 번째 잠금! */
    printf("  두 번째 lock 반환값: %d (%s)\n", rc, strerror(rc));
    printf("  -> EDEADLK: '이대로면 교착이다'라고 알려준다\n");
    printf("  (기본 NORMAL 타입이었다면 그냥 멈춰버립니다!)\n");
    pthread_mutex_unlock(&err_lock);

    printf("\n[ERRORCHECK] 내가 안 잠근 것을 풀면?\n");
    rc = pthread_mutex_unlock(&err_lock);
    printf("  unlock 반환값: %d (%s)\n", rc, strerror(rc));
    printf("  -> EPERM: 소유자가 아니면 못 푼다 (세마포어에는 없는 보호!)\n");
    pthread_mutex_destroy(&err_lock);

    /* (나) RECURSIVE: 같은 스레드의 재잠금 허용 */
    pthread_mutex_t rec_lock;
    pthread_mutexattr_settype(&attr, PTHREAD_MUTEX_RECURSIVE);
    pthread_mutex_init(&rec_lock, &attr);

    printf("\n[RECURSIVE] 같은 스레드가 세 번 잠그면?\n");
    pthread_mutex_lock(&rec_lock);
    pthread_mutex_lock(&rec_lock);
    pthread_mutex_lock(&rec_lock);
    printf("  세 번 다 성공! (내부 카운터가 3)\n");
    pthread_mutex_unlock(&rec_lock);
    pthread_mutex_unlock(&rec_lock);
    pthread_mutex_unlock(&rec_lock);
    printf("  세 번 풀어야 완전히 풀립니다.\n");
    printf("  용도: 락을 잡은 함수가 다시 자기를 부르는 재귀 구조\n");
    printf("  주의: 편해 보이지만 '락 구조가 꼬였다'는 신호일 때가 많습니다\n");
    pthread_mutex_destroy(&rec_lock);
    pthread_mutexattr_destroy(&attr);

    /* ---------- 3. trylock ---------- */
    printf("\n=== 3. trylock: 기다리지 않기 ===\n");
    pthread_mutex_lock(&lock);
    rc = pthread_mutex_trylock(&lock);
    printf("  이미 잠긴 뮤텍스에 trylock -> %d (%s)\n", rc, strerror(rc));
    printf("  -> EBUSY. 블록되지 않고 즉시 반환됩니다.\n");
    printf("  용도: '기다릴 바에 다른 일을 하겠다'는 경우, 교착 회피\n");
    pthread_mutex_unlock(&lock);

    /* ---------- 4. 초기화 두 가지 ---------- */
    printf("\n=== 4. 뮤텍스 초기화 두 가지 ===\n");
    printf("정적: pthread_mutex_t m = PTHREAD_MUTEX_INITIALIZER;\n");
    printf("      -> 전역/정적 변수에. destroy 불필요\n");
    printf("동적: pthread_mutex_init(&m, &attr);  ...  pthread_mutex_destroy(&m);\n");
    printf("      -> 속성이 필요하거나 malloc한 구조체 안에 있을 때\n");

    printf("\n=== 5. 뮤텍스 vs 세마포어 ===\n");
    printf("+----------------+------------------+---------------------+\n");
    printf("|                | 뮤텍스           | 세마포어            |\n");
    printf("+----------------+------------------+---------------------+\n");
    printf("| 목적           | 상호 배제        | 상호 배제 + 자원 세기|\n");
    printf("| 소유자         | 있다 (잠근 스레드)| 없다 (아무나 post)  |\n");
    printf("| 잘못된 unlock  | 탐지 가능        | 그냥 통과 (위험!)   |\n");
    printf("| 초기값         | 잠김/풀림 둘뿐   | 0 이상 아무 값      |\n");
    printf("| 프로세스 간    | 속성 설정 필요   | 기본 지원           |\n");
    printf("| 조건 대기      | 조건 변수와 짝   | 자체적으로 가능     |\n");
    printf("+----------------+------------------+---------------------+\n");
    printf("\n한 줄 정리: 스레드 안에서 '한 번에 하나'면 뮤텍스,\n");
    printf("            '몇 개까지'나 프로세스 간이면 세마포어.\n");
    return 0;
}
코드에서 새로 나온 것부터 봅시다.
PTHREAD_MUTEX_INITIALIZER: 전역 변수로 선언한 뮤텍스를 초기화하는 가장 쉬운 방법입니다. 컴파일할 때 값이 정해지므로init함수를 부를 필요가 없습니다.run함수: 세 종류의 워커를 같은 방식으로 돌리려고 7주차의 함수 포인터를 받습니다.void *(*fn)(void *)는pthread_create의 세 번째 인자와 같은 타입입니다.(void)arg;: 인자를 쓰지 않는데 시그니처 때문에 받아야 할 때, “일부러 안 쓴다”고 컴파일러에게 알려 1주차에서 본-Wunused-parameter경고를 막는 관용구입니다.
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/mutex_basic.c -o build/mutex_basic -pthread
$ ./build/mutex_basic
=== 1. 락 없음 vs 락 있음 ===
스레드 4개 x 200000번 증가, 기대값 800000

  [락 없음]   결과   287912  (   7.6 ms)  <- 증발 발생!
  [매번 락]   결과   800000  (  14.2 ms)  정확
  [모아서 락] 결과   800000  (   0.2 ms)  정확

관찰:
1. 락이 없으면 빠르지만 틀립니다 (빠른 오답은 무가치!)
2. 매번 락을 잡으면 정확하지만 1.9배 느립니다
3. 지역 변수로 모았다가 마지막에 한 번만 락을 잡으면?
   정확하면서도 락 버전보다 70.2배 빠릅니다!
   -> 락의 비용은 '횟수'에 비례합니다. 임계 구역을 줄이세요.
   (이것이 병렬 프로그래밍의 기본 전략: 지역에서 계산, 전역에 합산)

=== 2. 뮤텍스 종류 3가지 ===
[ERRORCHECK] 같은 스레드가 두 번 잠그면?
  두 번째 lock 반환값: 35 (Resource deadlock avoided)
  -> EDEADLK: '이대로면 교착이다'라고 알려준다
  (기본 NORMAL 타입이었다면 그냥 멈춰버립니다!)

[ERRORCHECK] 내가 안 잠근 것을 풀면?
  unlock 반환값: 1 (Operation not permitted)
  -> EPERM: 소유자가 아니면 못 푼다 (세마포어에는 없는 보호!)

[RECURSIVE] 같은 스레드가 세 번 잠그면?
  세 번 다 성공! (내부 카운터가 3)
  세 번 풀어야 완전히 풀립니다.
  용도: 락을 잡은 함수가 다시 자기를 부르는 재귀 구조
  주의: 편해 보이지만 '락 구조가 꼬였다'는 신호일 때가 많습니다

=== 3. trylock: 기다리지 않기 ===
  이미 잠긴 뮤텍스에 trylock -> 16 (Device or resource busy)
  -> EBUSY. 블록되지 않고 즉시 반환됩니다.
  용도: '기다릴 바에 다른 일을 하겠다'는 경우, 교착 회피
...
3.2 이번 주에서 가장 중요한 숫자: 70배
첫 표의 세 줄을 봅시다.
| 방식 | 결과 | 시간 |
|---|---|---|
| 락 없음 | 287,912 (틀림) | 7.6 ms |
| 매번 락 | 800,000 | 14.2 ms |
| 모아서 락 | 800,000 | 0.2 ms |
매번 락을 잡는 버전은 정확하지만, 락 없는 버전보다 2배 가까이 느립니다. 80만 번의 lock 과 unlock 이 그 값입니다. 그런데 세 번째 줄은 정확하면서도 70배 빠릅니다. 비결은 이것입니다.
static void *batched_worker(void *arg) {
    long local = 0;
    for (int i = 0; i < LOOPS; i++) local++;   /* 지역 변수는 내 것! */

    pthread_mutex_lock(&lock);
    counter += local;                          /* 마지막에 한 번만 합친다 */
    pthread_mutex_unlock(&lock);
    return NULL;
}
들어가며에서 “스택은 스레드마다 따로”라고 했습니다. local 은 이 스레드의 스택에 있으니 다른 스레드가 볼 수도, 건드릴 수도 없습니다. 공유 자원이 아니면 락이 필요 없습니다. 20만 번의 락이 한 번으로 줄었습니다.
병렬 프로그래밍의 제1원칙: 지역에서 계산하고, 마지막에 한 번 합친다.
이 원칙은 이번 주 내내 반복됩니다. 8절의 거짓 공유에서도, 프로젝트 2의 병렬 정렬에서도 같은 이야기가 나옵니다. 맵리듀스, OpenMP 의 reduction, GPU 의 리덕션이 전부 이 원칙의 구현입니다.
3.3 실험: 틀린 결과는 매번 다르다, 그리고 최적화를 켜면 숨는다
락 없는 버전을 세 번 돌려 봅시다.
$ for i in 1 2 3; do ./build/mutex_basic | grep "락 없음"; done
  [락 없음]   결과   344537  (   6.6 ms)  <- 증발 발생!
  [락 없음]   결과   294979  (   6.8 ms)  <- 증발 발생!
  [락 없음]   결과   297710  (   7.4 ms)  <- 증발 발생!
매번 다릅니다. 언제 어느 스레드가 끼어드는지는 그때그때 다르기 때문입니다. 경쟁 조건 버그가 무서운 첫 번째 이유입니다. 재현이 안 됩니다. 고객 컴퓨터에서 한 달에 한 번 나는 버그를 개발자 컴퓨터에서는 만날 수 없습니다.
두 번째 이유는 더 무섭습니다. -O2 로 컴파일해 봅시다.
$ gcc -Wall -Wextra -std=gnu11 -O2 examples/mutex_basic.c -o build/mutex_basic_O2 -pthread
$ for i in 1 2 3; do ./build/mutex_basic_O2 | grep "락 없음"; done
  [락 없음]   결과   800000  (   0.1 ms)  정확
  [락 없음]   결과   800000  (   0.1 ms)  정확
  [락 없음]   결과   800000  (   0.1 ms)  정확
버그가 사라진 것처럼 보입니다. 세 번 다 800,000 입니다. 무슨 일일까요? 1주차 7절의 objdump 로 unsafe_worker 가 어떻게 번역됐는지 봅시다.
$ objdump -d build/mutex_basic_O2 | grep -A5 "<unsafe_worker>:"
0000000000001780 <unsafe_worker>:
    1780:	f3 0f 1e fa          	endbr64
    1784:	48 81 05 d9 28 00 00 	addq   $0x30d40,0x28d9(%rip)        # 4068 <counter>
    178b:	40 0d 03 00
    178f:	31 c0                	xor    %eax,%eax
    1791:	c3                   	ret
반복문이 없습니다. 0x30d40 은 십진수로 200000 입니다. 컴파일러가 “20만 번 1을 더하는 것은 200000 을 한 번 더하는 것과 같다”고 판단해 counter += 200000 한 줄로 바꿔 버렸습니다. 이제 각 스레드는 메모리를 딱 한 번, 그것도 스레드가 만들어지자마자 나노초 안에 건드립니다. 네 스레드가 겹칠 틈이 사실상 없어서 우연히 맞는 답이 나온 것뿐입니다.
이 코드는 여전히 틀린 코드입니다. 10주차에서 -O2 가 측정 반복문을 통째로 지웠던 것과 같은 현상이고, “최적화를 켰더니 버그가 사라졌다”는 말은 거의 항상 “버그가 숨었다”는 뜻입니다. 이런 버그를 옵션과 운에 상관없이 잡아내는 도구가 3.6절의 ThreadSanitizer 입니다.
3.4 뮤텍스 3종
ERRORCHECK 는 실수를 잡아 줍니다.
pthread_mutexattr_settype(&attr, PTHREAD_MUTEX_ERRORCHECK);
같은 스레드가 두 번 잠그면 EDEADLK(35, “Resource deadlock avoided”, 이대로면 교착)를, 남의 락을 풀면 EPERM(1, “Operation not permitted”)을 반환합니다. 기본 NORMAL 타입에서 같은 스레드가 두 번 잠그면 아무 말 없이 영원히 멈춥니다. 자기가 잠근 문이 열리기를 자기가 기다리는 꼴이니까요. 개발 중에는 ERRORCHECK 를 쓰고 배포할 때 NORMAL 로 바꾸는 전략이 유용합니다.
RECURSIVE 는 같은 스레드의 재잠금을 허용합니다. 세 번 잠그면 내부 카운터가 3이 되고, 세 번 풀어야 완전히 풀립니다. 락을 잡은 함수가 다시 자신을 부르는 재귀 구조에서 필요합니다. 다만 “이 함수가 락을 잡은 상태로 불릴 수도, 아닐 수도 있다”는 설계는 유지보수가 어렵습니다. 락을 잡는 공개 함수와 잡지 않는 내부 함수를 나누는 편이 낫습니다.
trylock 은 기다리지 않습니다. 이미 잠겨 있으면 EBUSY(16) 를 즉시 돌려줍니다. “기다릴 바에 다른 일을 하겠다”는 경우와, 3.5절의 교착 상태를 피하는 데 씁니다.
timedlock 은 정해진 시각까지만 기다립니다.
    struct timespec deadline;
    clock_gettime(CLOCK_REALTIME, &deadline);
    deadline.tv_sec += 2;                  /* 지금부터 2초 뒤까지 */

    printf("2초만 기다려 봅니다...\n");
    int rc = pthread_mutex_timedlock(&m, &deadline);
    printf("반환값 %d (%s)\n", rc, strerror(rc));
2초만 기다려 봅니다...
반환값 110 (Connection timed out)
주의할 점은 인자가 “얼마 동안”이 아니라 “언제까지” 라는 것입니다. 19주차의 sem_timedwait 과 같은 규칙입니다. 반환값 110 은 ETIMEDOUT 인데, 메시지가 “Connection timed out” 인 것은 이 번호가 원래 네트워크용으로 만들어졌기 때문입니다.
3.5 교착 상태를 직접 만들어 보기
19주차에서 교착 상태(deadlock)를 배웠습니다. 스레드 둘이 서로가 쥔 락을 기다리며 영원히 멈추는 것입니다. 말로만 듣지 말고 직접 만들어 봅시다. deadlock.c:
#include <stdio.h>
#include <unistd.h>
#include <pthread.h>

static pthread_mutex_t a = PTHREAD_MUTEX_INITIALIZER;
static pthread_mutex_t b = PTHREAD_MUTEX_INITIALIZER;

static void *thread1(void *arg) {
    (void)arg;
    pthread_mutex_lock(&a);
    printf("  [스레드 1] a 잠금. 이제 b 를 기다립니다\n");
    usleep(1000);
    pthread_mutex_lock(&b);                /* 스레드 2가 b 를 쥐고 있다 */
    printf("  [스레드 1] b 잠금 (여기는 절대 안 나옵니다)\n");
    pthread_mutex_unlock(&b);
    pthread_mutex_unlock(&a);
    return NULL;
}

static void *thread2(void *arg) {
    (void)arg;
    pthread_mutex_lock(&b);
    printf("  [스레드 2] b 잠금. 이제 a 를 기다립니다\n");
    usleep(1000);
    pthread_mutex_lock(&a);                /* 스레드 1이 a 를 쥐고 있다 */
    printf("  [스레드 2] a 잠금 (여기도 안 나옵니다)\n");
    pthread_mutex_unlock(&a);
    pthread_mutex_unlock(&b);
    return NULL;
}

int main(void) {
    pthread_t t1, t2;
    pthread_create(&t1, NULL, thread1, NULL);
    pthread_create(&t2, NULL, thread2, NULL);
    pthread_join(t1, NULL);
    pthread_join(t2, NULL);
    printf("끝 (여기까지 오면 교착이 아닙니다)\n");
    return 0;
}
스레드 1은 a 다음 b, 스레드 2는 b 다음 a 순서로 잠급니다. 그냥 실행하면 영원히 끝나지 않으니, 19주차에서 쓴 timeout 으로 5초 뒤에 끊습니다.
$ gcc -Wall -Wextra -std=gnu11 -g deadlock.c -o deadlock -pthread
$ timeout 5 ./deadlock
  [스레드 1] a 잠금. 이제 b 를 기다립니다
  [스레드 2] b 잠금. 이제 a 를 기다립니다
$ echo $?
124
두 줄을 찍고 멈췄습니다. 종료 코드 124 는 timeout 이 “시간이 다 돼서 죽였다”는 뜻입니다.
멈춘 프로그램은 어디서 멈췄나: gdb
실전에서는 프로그램이 왜 멈췄는지 모르는 채 발견합니다. 6주차의 gdb 로 모든 스레드가 지금 무엇을 하고 있는지 볼 수 있습니다. 문제는 멈춘 프로그램을 어떻게 gdb 에게 넘기느냐입니다. main 첫 줄에 alarm(3); 을 넣어 3초 뒤 스스로 시그널을 받게 하고, gdb 에게 그 시그널에서 멈추라고 하면 됩니다.
$ gdb -q -batch -ex "handle SIGALRM stop print nopass" -ex run -ex "thread apply all bt 2" ./deadlock_alarm
  [스레드 1] a 잠금. 이제 b 를 기다립니다
  [스레드 2] b 잠금. 이제 a 를 기다립니다
Thread 1 "deadlock_alarm" received signal SIGALRM, Alarm clock.

Thread 3 (Thread 0x7ffff73fe6c0 (LWP 325570) "deadlock_alarm"):
#0  futex_wait (private=0, expected=2, futex_word=0x555555558040 <a>) at ../sysdeps/nptl/futex-internal.h:146
#1  __GI___lll_lock_wait (futex=futex@entry=0x555555558040 <a>, private=0) at ./nptl/lowlevellock.c:49

Thread 2 (Thread 0x7ffff7bff6c0 (LWP 325569) "deadlock_alarm"):
#0  futex_wait (private=0, expected=2, futex_word=0x555555558080 <b>) at ../sysdeps/nptl/futex-internal.h:146
#1  __GI___lll_lock_wait (futex=futex@entry=0x555555558080 <b>, private=0) at ./nptl/lowlevellock.c:49

Thread 1 (Thread 0x7ffff7f7c740 (LWP 325566) "deadlock_alarm"):
#0  0x00007ffff7c98e51 in __futex_abstimed_wait_common64 (...) at ./nptl/futex-internal.c:57
#1  __futex_abstimed_wait_common (...) at ./nptl/futex-internal.c:87
(긴 인자 목록은 (...) 로 줄였습니다.) thread apply all bt 2 는 “모든 스레드에 대해 스택의 위 2단을 보여 달라”는 뜻입니다. 읽어 봅시다.
- Thread 3 은
futex_wait에서 멈춰 있고, 기다리는 것은<a>입니다. 스레드 2(코드의thread2)가a를 기다리는 모습입니다. - Thread 2 는
<b>를 기다립니다. 코드의thread1입니다. - Thread 1 은 메인 스레드로,
pthread_join안에서 스레드가 끝나기를 기다립니다.
“3번은 a 를 기다리고, a 를 쥔 2번은 b 를 기다리고, b 를 쥔 3번은…” 고리가 닫혔습니다. 이것이 교착의 지문입니다. 3절의 뮤텍스가 왜 futex 위에서 도는지도 여기서 보입니다. 기다리는 스레드는 커널의 futex_wait 안에서 잠들어 있습니다.
실전 팁: 이미 돌고 있는 프로그램에 붙이려면
sudo gdb -p PID를 씁니다. 우분투는 보안 설정(/proc/sys/kernel/yama/ptrace_scope가 1)으로 남의 프로세스에 붙는 것을 막기 때문에, 내가 띄운 프로세스라도 다른 터미널에서 붙일 때는sudo가 필요합니다. 붙은 뒤에는thread apply all bt를 치면 됩니다.
교착을 피하는 법
교착의 조건은 “서로 다른 순서로 잠근다”였습니다. 그래서 규칙은 간단합니다.
- 락 순서를 정해 두고 모두가 지킨다. 항상
a다음b면 교착은 불가능합니다. 위 예제에서thread2의 두 줄을 바꾸면 끝납니다. - 순서를 지킬 수 없다면
trylock으로 시도하고, 실패하면 가진 것을 전부 놓고 처음부터 다시 합니다. - 락을 쥔 채로 다른 락을 기다리는 시간을 줄입니다. 임계 구역이 짧을수록 겹칠 일도 줄어듭니다.
3.6 실험: unlock 을 빼먹으면
락을 잠그고 푸는 것을 잊는 실수는 교착보다 훨씬 흔합니다. nounlock.c:
#include <stdio.h>
#include <pthread.h>

static pthread_mutex_t m = PTHREAD_MUTEX_INITIALIZER;
static int counter = 0;

static void *worker(void *arg) {
    (void)arg;
    for (int i = 0; i < 3; i++) {
        pthread_mutex_lock(&m);
        counter++;
        /* unlock 을 깜빡했다! */
    }
    return NULL;
}

int main(void) {
    pthread_t t;
    pthread_create(&t, NULL, worker, NULL);
    pthread_join(t, NULL);
    printf("counter = %d\n", counter);
    return 0;
}
$ gcc -Wall -Wextra -std=gnu11 nounlock.c -o nounlock -pthread
$ timeout 5 ./nounlock
$ echo $?
124
스레드가 하나뿐인데도 멈췄습니다. 첫 번째 반복에서 잠근 락을 두 번째 반복에서 자기가 또 잠그려다가, 자기가 풀어 주기를 기다리며 영원히 멈춘 것입니다. 3.4절에서 말한 “기본 NORMAL 타입은 아무 말 없이 멈춘다”가 이것입니다. ERRORCHECK 였다면 EDEADLK 를 돌려줬을 겁니다.
이 실수를 막는 습관은 lock 을 쓴 직후에 unlock 을 먼저 써 두고, 그 사이를 채우는 것입니다. 그리고 임계 구역 안에서 return 이나 break 로 빠져나가는 길이 있으면 그 길마다 unlock 이 있는지 확인합니다. 4절의 queue_pop 이 return 0; 앞에 unlock 을 넣는 이유입니다.
3.7 ThreadSanitizer: 경쟁 조건을 잡아 주는 도구
3.3절에서 경쟁 조건은 재현이 안 되고 최적화에 숨는다고 했습니다. 다행히 이런 버그를 실행 중에 자동으로 잡아 주는 도구가 GCC 에 들어 있습니다. 6주차의 AddressSanitizer 와 형제인 ThreadSanitizer 입니다. 옵션은 -fsanitize=thread 입니다.
작은 예제로 봅시다. race.c:
#include <stdio.h>
#include <pthread.h>

static long counter = 0;

static void *worker(void *arg) {
    (void)arg;
    for (int i = 0; i < 100000; i++) counter++;
    return NULL;
}

int main(void) {
    pthread_t t1, t2;
    pthread_create(&t1, NULL, worker, NULL);
    pthread_create(&t2, NULL, worker, NULL);
    pthread_join(t1, NULL);
    pthread_join(t2, NULL);
    printf("counter = %ld\n", counter);
    return 0;
}
$ gcc -Wall -Wextra -std=gnu11 -g -fsanitize=thread race.c -o race_tsan -pthread
$ ./race_tsan
==================
WARNING: ThreadSanitizer: data race (pid=323326)
  Read of size 8 at 0x58ff9969b018 by thread T2:
    #0 worker race.c:8 (race_tsan+0x127d)

  Previous write of size 8 at 0x58ff9969b018 by thread T1:
    #0 worker race.c:8 (race_tsan+0x1297)

  Location is global 'counter' of size 8 at 0x58ff9969b018 (race_tsan+0x4018)

  Thread T2 (tid=323330, running) created by main thread at:
    #0 pthread_create ...
    #1 main race.c:15 (race_tsan+0x1320)

  Thread T1 (tid=323329, running) created by main thread at:
    #0 pthread_create ...
    #1 main race.c:14 (race_tsan+0x1303)

SUMMARY: ThreadSanitizer: data race race.c:8 in worker
==================
...
ThreadSanitizer: reported 2 warnings
counter = 200000
$ echo $?
66
(BuildId 같은 긴 식별자는 줄였습니다.) 보고서를 읽는 법입니다.
| 줄 | 뜻 |
|---|---|
data race |
두 스레드가 동기화 없이 같은 메모리를 건드렸다 |
Read of size 8 ... by thread T2: worker race.c:8 |
T2 가 8바이트를 읽은 곳: race.c 8번째 줄 |
Previous write ... by thread T1: worker race.c:8 |
그 직전에 T1 이 같은 곳에 쓴 곳: 역시 8번째 줄 |
Location is global 'counter' |
문제의 메모리는 전역 변수 counter |
Thread T2 ... created by main thread at: main race.c:15 |
T2 는 main 15번째 줄에서 만들어졌다 |
SUMMARY: ... race.c:8 in worker |
한 줄 요약. 8번째 줄의 counter++ |
변수 이름, 줄 번호, 어느 스레드가 만들었는지까지 전부 알려 줍니다. 그리고 결과가 200000 으로 우연히 맞았는데도 잡아냈습니다. 값이 맞고 틀리고는 보지 않고, “동기화 없이 겹쳤다”는 사실 자체를 감시하기 때문입니다. -O2 로 컴파일해도 똑같이 잡아냅니다. 종료 코드 66 은 ThreadSanitizer 가 경고를 냈을 때 쓰는 값입니다.
락을 넣은 버전(race_ok.c, counter++ 를 pthread_mutex_lock 과 unlock 으로 감싼 것)은 조용합니다.
$ ./race_ok
counter = 200000
$ echo $?
0
ThreadSanitizer 는 프로그램을 5~15배 느리게 만들고 메모리도 많이 씁니다. 배포용이 아니라 테스트용입니다. 하지만 스레드 코드를 쓰면서 한 번도 안 돌려 봤다면, 그 코드에는 아직 발견 못 한 경쟁 조건이 있다고 보는 게 안전합니다. 이번 주 예제 중 락이 빠진 것을 골라 직접 돌려 보세요.
실행했을 때
FATAL: ThreadSanitizer: unexpected memory mapping이라고 나오며 죽는 경우가 있습니다. 최근 리눅스 커널이 주소를 더 넓게 무작위화해서 ThreadSanitizer 가 예상한 자리와 어긋나는 문제입니다. 6주차에서 ASLR 을 끌 때 쓴setarch -R ./race_ok로 돌리면 됩니다.
3.8 뮤텍스 vs 세마포어
| 뮤텍스 | 세마포어 | |
|---|---|---|
| 목적 | 상호 배제 | 상호 배제 + 자원 세기 |
| 소유자 | 있다 (잠근 스레드) | 없다 (아무나 post) |
| 잘못된 unlock | 탐지 가능 (ERRORCHECK) | 그냥 통과 (위험!) |
| 초기값 | 잠김/풀림 둘뿐 | 0 이상 아무 값 |
| 프로세스 간 | 속성 설정 필요 | 기본 지원 |
| 조건 대기 | 조건 변수와 짝 (4절) | 자체적으로 가능 |
한 줄로 정리하면 스레드 안에서 “한 번에 하나”면 뮤텍스, “몇 개까지”나 프로세스 간이면 세마포어입니다.
4. 조건 변수: “때가 되면 깨워줘”
4.1 바쁜 대기를 없애기
뮤텍스는 “들어가도 되나?”를 해결합니다. 그런데 스레드 프로그래밍에는 또 다른 종류의 기다림이 있습니다. “데이터가 올 때까지 기다린다” 입니다. 소비자 스레드는 생산자가 큐에 무언가 넣을 때까지 할 일이 없습니다.
뮤텍스만으로 이것을 하려면 이렇게 됩니다.
/* 나쁜 방법: 바쁜 대기 */
while (1) {
    lock(m); int ready = 준비됐나; unlock(m);
    if (ready) break;            /* CPU를 태우며 계속 확인! */
}
문을 열어 보고, 없으면 닫고, 다시 열어 보고, 다시 닫고. 이것을 바쁜 대기(busy waiting) 라고 합니다. 논리적으로는 동작하지만 CPU 코어 하나를 통째로 낭비합니다. 그 시간에 다른 스레드가 일할 수 있었을 텐데요. 노트북이라면 팬이 돌고 배터리가 녹습니다.
원하는 것은 “누가 넣을 때까지 잠들어 있다가, 넣으면 깨워 달라“입니다. 그것이 조건 변수(condition variable) 입니다.
lock(m);
while (!준비됐나) pthread_cond_wait(&cv, &m);   /* 잠든다 (CPU 0%) */
... 처리 ...
unlock(m);
조건 변수의 함수는 셋입니다.
| 함수 | 하는 일 |
|---|---|
pthread_cond_wait(&cv, &m) |
뮤텍스 m 을 풀고 잠든다. 깨어나면 m 을 다시 잠그고 돌아온다 |
pthread_cond_signal(&cv) |
cv 에서 자는 스레드 하나를 깨운다 |
pthread_cond_broadcast(&cv) |
cv 에서 자는 스레드 전부를 깨운다 |
wait 이 뮤텍스를 받는 이유는 잠깐 뒤에 알게 됩니다. 먼저 예제입니다. 19주차의 생산자-소비자를 뮤텍스 하나와 조건 변수 두 개로 다시 만듭니다.
examples/cond_var.c:
/*
 * cond_var.c - 조건 변수: "때가 되면 깨워줘"
 * 20주차: 멀티스레딩과 병렬 프로그래밍
 *
 * 뮤텍스는 "들어가도 되나?"를 해결합니다.
 * 그런데 "데이터가 올 때까지 기다린다"는 어떻게 할까요?
 *
 * 나쁜 방법 - 바쁜 대기(busy waiting):
 *   while (1) {
 *       lock(m); int ready = 준비됐나; unlock(m);
 *       if (ready) break;            // CPU를 태우며 계속 확인!
 *   }
 *
 * 좋은 방법 - 조건 변수:
 *   lock(m);
 *   while (!준비됐나) pthread_cond_wait(&cv, &m);   // 잠든다 (CPU 0%)
 *   ... 처리 ...
 *   unlock(m);
 *
 * pthread_cond_wait의 마법: 뮤텍스를 '자동으로 풀고' 잠들었다가,
 * 깨어날 때 '자동으로 다시 잠급니다'. 이 원자성이 핵심입니다.
 *
 * 주의: 반드시 while로 감싸세요! (가짜 깨어남 - spurious wakeup)
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <pthread.h>
#include <time.h>

#define QUEUE_SIZE 4
#define ITEMS 8

/* 공유 큐 + 그것을 지키는 뮤텍스 + 두 개의 조건 변수 */
typedef struct {
    pthread_mutex_t lock;
    pthread_cond_t  not_empty;       /* "뭔가 들어왔다" 알림 */
    pthread_cond_t  not_full;        /* "자리가 생겼다" 알림 */

    int  data[QUEUE_SIZE];
    int  count;
    int  in, out;
    int  closed;                     /* 더 이상 생산 없음 */

    long waits_empty, waits_full;    /* 통계: 몇 번 기다렸나 */
} Queue;

static Queue q;

static void queue_init(void) {
    memset(&q, 0, sizeof(q));
    pthread_mutex_init(&q.lock, NULL);
    pthread_cond_init(&q.not_empty, NULL);
    pthread_cond_init(&q.not_full, NULL);
}

static void queue_push(int value) {
    pthread_mutex_lock(&q.lock);

    /* while! if가 아니라 while이어야 한다 (이유는 아래 설명) */
    while (q.count == QUEUE_SIZE) {
        q.waits_full++;
        printf("    [생산자] 큐가 가득참(%d/%d). 기다린다...\n",
               q.count, QUEUE_SIZE);
        fflush(stdout);
        pthread_cond_wait(&q.not_full, &q.lock);   /* 락을 풀고 잠든다 */
    }

    q.data[q.in] = value;
    q.in = (q.in + 1) % QUEUE_SIZE;
    q.count++;
    printf("    [생산자] %d 넣음 (%d/%d)\n", value, q.count, QUEUE_SIZE);
    fflush(stdout);

    pthread_cond_signal(&q.not_empty);             /* 소비자를 깨운다 */
    pthread_mutex_unlock(&q.lock);
}

/* 꺼내기. 큐가 닫히고 비면 0 반환 */
static int queue_pop(int *out) {
    pthread_mutex_lock(&q.lock);

    while (q.count == 0 && !q.closed) {
        q.waits_empty++;
        printf("    [소비자] 큐가 비었다. 기다린다...\n");
        fflush(stdout);
        pthread_cond_wait(&q.not_empty, &q.lock);
    }

    if (q.count == 0) {              /* 닫혔고 비었다 = 끝 */
        pthread_mutex_unlock(&q.lock);
        return 0;
    }

    *out = q.data[q.out];
    q.out = (q.out + 1) % QUEUE_SIZE;
    q.count--;
    printf("    [소비자] %d 꺼냄 (%d/%d)\n", *out, q.count, QUEUE_SIZE);
    fflush(stdout);

    pthread_cond_signal(&q.not_full);              /* 생산자를 깨운다 */
    pthread_mutex_unlock(&q.lock);
    return 1;
}

static void queue_close(void) {
    pthread_mutex_lock(&q.lock);
    q.closed = 1;
    pthread_cond_broadcast(&q.not_empty);          /* 전부 깨워서 끝내게 */
    pthread_mutex_unlock(&q.lock);
}

static void *producer(void *arg) {
    (void)arg;
    for (int i = 1; i <= ITEMS; i++) {
        queue_push(i * 10);
        usleep(60000);
    }
    queue_close();
    return NULL;
}

static void *consumer(void *arg) {
    (void)arg;
    int value;
    long sum = 0;
    while (queue_pop(&value)) {
        sum += value;
        usleep(180000);              /* 소비가 더 느리다 -> 큐가 찬다 */
    }
    long *result = malloc(sizeof(long));
    if (result) *result = sum;
    return result;
}

int main(void) {
    printf("=== 1. 조건 변수로 만드는 생산자-소비자 ===\n");
    printf("큐 크기 %d, 항목 %d개. 생산이 빠르고 소비가 느립니다.\n\n",
           QUEUE_SIZE, ITEMS);

    queue_init();

    pthread_t prod, cons;
    pthread_create(&prod, NULL, producer, NULL);
    pthread_create(&cons, NULL, consumer, NULL);

    pthread_join(prod, NULL);
    void *ret = NULL;
    pthread_join(cons, &ret);

    printf("\n소비자가 받은 합계: %ld\n", ret ? *(long *)ret : -1);
    printf("기대값: %d\n", (10 + ITEMS * 10) * ITEMS / 2);
    free(ret);
    printf("생산자가 기다린 횟수: %ld (큐가 가득 차서)\n", q.waits_full);
    printf("소비자가 기다린 횟수: %ld (큐가 비어서)\n", q.waits_empty);

    /* ---------- 2. 왜 while인가 ---------- */
    printf("\n=== 2. 왜 if가 아니라 while인가 ===\n");
    printf("  while (조건이 아직 아님) pthread_cond_wait(&cv, &m);\n\n");
    printf("이유 세 가지:\n");
    printf("1. 가짜 깨어남(spurious wakeup)\n");
    printf("   POSIX는 '신호 없이도 깨어날 수 있다'고 명시합니다.\n");
    printf("   구현/하드웨어 사정으로 그럴 수 있어요. 깨면 다시 확인해야 합니다.\n");
    printf("2. 도둑맞은 알림(stolen wakeup)\n");
    printf("   내가 깨어나 락을 잡기 전에 다른 스레드가 먼저 가져갈 수 있습니다.\n");
    printf("   깨어났을 때 조건이 이미 거짓일 수 있죠.\n");
    printf("3. broadcast\n");
    printf("   전부 깨우면 그중 하나만 조건을 만족할 수 있습니다.\n");
    printf("\n-> if로 쓰면 '가끔' 깨지는 코드가 됩니다. 반드시 while!\n");

    /* ---------- 3. signal vs broadcast ---------- */
    printf("\n=== 3. signal vs broadcast ===\n");
    printf("pthread_cond_signal    : 기다리는 스레드 중 '하나'를 깨운다\n");
    printf("pthread_cond_broadcast : 기다리는 스레드 '전부'를 깨운다\n\n");
    printf("언제 broadcast인가?\n");
    printf("  - 상태가 바뀌어 여러 스레드가 진행 가능할 때\n");
    printf("  - 기다리는 조건이 서로 다를 때 (한 조건 변수에 여러 조건)\n");
    printf("  - 종료 신호 (이 예제의 queue_close!)\n");
    printf("애매하면 broadcast가 안전합니다 (느릴 뿐 틀리지는 않음).\n");

    /* ---------- 4. 락과의 관계 ---------- */
    printf("\n=== 4. cond_wait이 락을 다루는 방식 ===\n");
    printf("pthread_cond_wait(&cv, &m)이 하는 일:\n");
    printf("  1. m을 푼다        (다른 스레드가 상태를 바꿀 수 있게)\n");
    printf("  2. 잠든다          (여기서 CPU를 쓰지 않는다)\n");
    printf("  3. 깨어나면 m을 다시 잠근다\n\n");
    printf("1과 2가 '원자적'이라는 점이 핵심입니다.\n");
    printf("만약 풀고 잠드는 사이에 틈이 있다면? 그 틈에 신호가 오면\n");
    printf("놓쳐버리고 영원히 잠들게 됩니다 (lost wakeup 문제).\n");
    printf("조건 변수가 뮤텍스와 짝으로만 동작하는 이유입니다.\n");

    /* ---------- 5. 타임아웃 ---------- */
    printf("\n=== 5. 무한정 기다리지 않기 ===\n");
    printf("pthread_cond_timedwait(&cv, &m, &절대시각)\n");
    printf("  -> 시각을 넘기면 ETIMEDOUT 반환\n");
    printf("  주의: '얼마 동안'이 아니라 '언제까지'입니다 (절대 시각!)\n");
    printf("  clock_gettime(CLOCK_REALTIME, &ts); ts.tv_sec += 5;\n");

    pthread_mutex_destroy(&q.lock);
    pthread_cond_destroy(&q.not_empty);
    pthread_cond_destroy(&q.not_full);
    return 0;
}
큐의 구조는 11주차의 원형 큐 그대로입니다. in 은 넣을 자리, out 은 꺼낼 자리, % QUEUE_SIZE 로 끝에서 처음으로 돌아갑니다. 새로 붙은 것은 세 가지입니다. 큐를 지키는 뮤텍스 lock, “비어 있지 않다”를 알리는 not_empty, “가득 차지 않았다”를 알리는 not_full 입니다. 조건 변수가 둘인 이유는 기다리는 이유가 둘이기 때문입니다. 생산자는 자리가 나기를, 소비자는 물건이 들어오기를 기다립니다.
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/cond_var.c -o build/cond_var -pthread
$ ./build/cond_var
=== 1. 조건 변수로 만드는 생산자-소비자 ===
큐 크기 4, 항목 8개. 생산이 빠르고 소비가 느립니다.

    [생산자] 10 넣음 (1/4)
    [소비자] 10 꺼냄 (0/4)
    [생산자] 20 넣음 (1/4)
    [생산자] 30 넣음 (2/4)
    [소비자] 20 꺼냄 (1/4)
    [생산자] 40 넣음 (2/4)
    [생산자] 50 넣음 (3/4)
    [생산자] 60 넣음 (4/4)
    [소비자] 30 꺼냄 (3/4)
    [생산자] 70 넣음 (4/4)
    [생산자] 큐가 가득참(4/4). 기다린다...
    [소비자] 40 꺼냄 (3/4)
    [생산자] 80 넣음 (4/4)
    [소비자] 50 꺼냄 (3/4)
    [소비자] 60 꺼냄 (2/4)
    [소비자] 70 꺼냄 (1/4)
    [소비자] 80 꺼냄 (0/4)

소비자가 받은 합계: 360
기대값: 360
생산자가 기다린 횟수: 1 (큐가 가득 차서)
소비자가 기다린 횟수: 0 (큐가 비어서)
...
생산자는 60ms 마다, 소비자는 180ms 마다 움직이니 큐가 점점 찹니다. 큐 상태를 따라가 봅시다.
| 순서 | 사건 | 큐 (count) | 생산자 | 소비자 |
|---|---|---|---|---|
| 1 | 생산자 10 넣음 | [10] (1) | signal(not_empty) |
|
| 2 | 소비자 10 꺼냄 | [] (0) | signal(not_full), 180ms 처리 |
|
| 3~4 | 생산자 20, 30 넣음 | [20 30] (2) | 아직 처리 중 | |
| 5 | 소비자 20 꺼냄 | [30] (1) | ||
| 6~8 | 생산자 40, 50, 60 넣음 | [30 40 50 60] (4) | ||
| 9 | 소비자 30 꺼냄 | [40 50 60] (3) | ||
| 10 | 생산자 70 넣음 | [40 50 60 70] (4) | ||
| 11 | 생산자 80 넣으려 함 | 가득 참 | wait(not_full) 로 잠듦 |
|
| 12 | 소비자 40 꺼냄 | [50 60 70] (3) | signal(not_full) → 생산자 깸 |
|
| 13 | 생산자 80 넣음 | [50 60 70 80] (4) | queue_close() 후 종료 |
|
| 14~17 | 소비자가 나머지를 꺼냄 | [] (0) | closed 라 0 반환, 종료 |
11번에서 생산자가 잠들고 12번에서 소비자의 signal 이 깨웁니다. 잠든 동안 생산자는 CPU 를 전혀 쓰지 않습니다. 이것이 바쁜 대기와의 차이입니다. 마지막에 소비자가 “큐가 비었다”고 기다린 적이 없는 것은 생산이 소비보다 빨라서 큐가 빌 틈이 없었기 때문입니다. usleep 값을 바꿔서 반대 상황을 만들어 보세요.
4.2 cond_wait 이 뮤텍스를 받는 이유
pthread_cond_wait(&cv, &m) 이 하는 일은 셋입니다.
1. m 을 푼다          (다른 스레드가 상태를 바꿀 수 있게)
2. 잠든다             (여기서 CPU 를 쓰지 않는다)
3. 깨어나면 m 을 다시 잠근다
왜 조건 변수가 뮤텍스를 받아서 풀었다 잠갔다 해야 할까요? 소비자를 생각해 봅시다. “큐가 비었나?”를 확인하려면 큐를 봐야 하고, 큐를 보려면 락을 잡아야 합니다. 그런데 락을 잡은 채로 잠들면 생산자가 큐에 넣을 수 없으니 영원히 비어 있습니다. 그러니 잠들기 전에 락을 풀어야 합니다.
그럼 락을 풀고 나서 잠들면 되지 않을까요? 여기에 함정이 있습니다.
소비자: lock → 큐 확인: 비었다 → unlock →  (틈!)  → 잠든다
생산자:                                    ↑ 이 틈에 넣고 signal 을 보냄
소비자가 락을 풀고 아직 잠들기 전, 그 짧은 틈에 생산자가 물건을 넣고 signal 을 보내면 어떻게 될까요? 아직 자는 사람이 없으니 신호는 허공에 사라집니다. 그리고 소비자는 잠듭니다. 다음 물건이 올 때까지, 어쩌면 영원히. 이것을 잃어버린 깨어남(lost wakeup) 이라고 합니다.
그래서 pthread_cond_wait 은 1번과 2번을 원자적으로, 즉 그 사이에 아무도 끼어들 수 없게 처리합니다. 락을 푸는 것과 잠드는 것이 한 동작입니다. 이것을 보장하려면 조건 변수가 뮤텍스를 알아야 하고, 그래서 두 번째 인자로 받습니다. 조건 변수는 혼자서는 쓸 수 없고 항상 뮤텍스와 짝입니다.
4.3 실험: 상태 변수 없이 신호만 기다리면
“신호는 허공에 사라진다”를 직접 봅시다. 조건 변수를 “신호가 오면 깨어나는 장치”로만 생각하는 초보자가 자주 하는 실수입니다. lostwakeup.c:
#include <stdio.h>
#include <unistd.h>
#include <pthread.h>

static pthread_mutex_t m  = PTHREAD_MUTEX_INITIALIZER;
static pthread_cond_t  cv = PTHREAD_COND_INITIALIZER;
static int ready = 0;                      /* 상태 변수 */

static void *waiter(void *arg) {
    int use_flag = *(int *)arg;
    sleep(1);                              /* 일부러 늦게 기다리기 시작한다 */
    pthread_mutex_lock(&m);
    if (use_flag) {
        while (!ready) pthread_cond_wait(&cv, &m);   /* 상태를 먼저 본다 */
    } else {
        pthread_cond_wait(&cv, &m);                  /* 신호만 기다린다 */
    }
    pthread_mutex_unlock(&m);
    printf("  깨어났습니다!\n");
    return NULL;
}

int main(int argc, char *argv[]) {
    (void)argv;
    int use_flag = argc > 1;               /* 인자가 있으면 상태 변수를 쓴다 */
    pthread_t t;
    pthread_create(&t, NULL, waiter, &use_flag);

    pthread_mutex_lock(&m);
    ready = 1;
    pthread_cond_signal(&cv);              /* 상대는 아직 잠들지 않았다! */
    pthread_mutex_unlock(&m);
    printf("  신호를 보냈습니다 (상대가 기다리기 시작하기 전에)\n");

    pthread_join(t, NULL);
    printf("끝\n");
    return 0;
}
메인 스레드는 즉시 ready = 1 로 만들고 신호를 보냅니다. 그런데 waiter 는 1초 뒤에야 기다리기 시작합니다. 신호가 먼저, 기다림이 나중입니다.
$ gcc -Wall -Wextra -std=gnu11 lostwakeup.c -o lostwakeup -pthread
$ timeout 5 ./lostwakeup
  신호를 보냈습니다 (상대가 기다리기 시작하기 전에)
$ echo $?
124
신호만 기다린 버전은 영원히 멈춥니다. 신호는 1초 전에 이미 사라졌고, 다시 보내 줄 사람은 없습니다.
$ timeout 5 ./lostwakeup flag
  신호를 보냈습니다 (상대가 기다리기 시작하기 전에)
  깨어났습니다!
끝
상태 변수를 보는 버전은 잠들지도 않았습니다. while (!ready) 에서 ready 가 이미 1이라 wait 을 부르지 않고 지나갔기 때문입니다.
교훈은 이것입니다. 조건 변수는 “상태가 바뀌었을지 모르니 다시 확인해 봐”라는 알림일 뿐, 상태 자체가 아닙니다. 상태는 언제나 우리가 관리하는 변수(ready, q.count)에 있어야 하고, 잠들기 전에 반드시 그 변수를 먼저 확인해야 합니다. 그래서 조건 변수를 쓰는 코드는 언제나 이 세 줄 세트입니다.
pthread_mutex_lock(&m);
while (!조건)                     /* ① 상태 변수 확인 */
    pthread_cond_wait(&cv, &m);   /* ② 아니면 잠들기 */
...                               /* ③ 조건이 참인 상태로 진행 */
pthread_mutex_unlock(&m);
4.4 왜 if 가 아니라 while 인가
위 세 줄 세트에서 while 을 if 로 바꾸면 안 되는 이유가 셋 있습니다.
① 가짜 깨어남(spurious wakeup). POSIX 표준이 명시적으로 “신호 없이도 깨어날 수 있다”고 규정합니다. 구현과 하드웨어 사정으로 그럴 수 있고, 리눅스에서는 시그널이 도착했을 때 생길 수 있습니다. 표준이 허용한 이상 방어해야 합니다.
② 도둑맞은 알림(stolen wakeup). signal 을 받아 깨어나도, 뮤텍스를 다시 잡기까지 시간이 걸립니다. 그 사이에 다른 소비자 스레드가 먼저 들어가 물건을 가져가 버릴 수 있습니다. 깨어나 보니 큐가 다시 비어 있는 상황입니다. if 였다면 빈 큐에서 꺼내려다 쓰레기를 읽습니다.
③ broadcast. broadcast 로 열 스레드를 깨웠는데 물건은 하나뿐일 수 있습니다. 아홉은 다시 자야 합니다.
if 로 쓴 코드는 대부분 잘 동작하다가 가끔 깨집니다. 재현도 안 되고 원인도 안 보입니다. 조건 변수를 쓸 때 while 은 선택이 아니라 문법의 일부라고 생각하세요. 이 예제의 queue_push, queue_pop, 10절 스레드 풀의 worker_main, pool_submit, pool_wait 이 전부 while 입니다.
4.5 signal vs broadcast
pthread_cond_signal(&cv);      /* 기다리는 스레드 중 '하나'를 깨운다 */
pthread_cond_broadcast(&cv);   /* 기다리는 스레드 '전부'를 깨운다 */
물건 하나를 넣었으면 소비자 하나만 깨우면 됩니다(signal). 전부 깨우면 나머지는 헛걸음합니다. 그런데 broadcast 를 써야 하는 경우가 있습니다.
- 상태가 바뀌어 여러 스레드가 동시에 진행할 수 있을 때
- 한 조건 변수에 서로 다른 조건으로 기다리는 스레드가 섞여 있을 때
- 종료 신호. 이 예제의
queue_close가 그렇습니다.
마지막이 특히 중요합니다. 소비자가 셋인데 종료할 때 signal 을 쓰면 하나만 깨어나고 둘은 영원히 잠듭니다. pthread_join 이 돌아오지 않아 프로그램이 끝나지 않는, 아주 흔한 버그입니다. 애매하면 broadcast 가 안전합니다. 느릴 뿐 틀리지는 않습니다.
4.6 타임아웃
struct timespec ts;
clock_gettime(CLOCK_REALTIME, &ts);
ts.tv_sec += 5;                     /* 지금부터 5초 뒤까지 */
int rc = pthread_cond_timedwait(&cv, &m, &ts);   /* 넘기면 ETIMEDOUT */
3.4절의 timedlock 과 같은 규칙입니다. “얼마 동안”이 아니라 “언제까지”이고, 절대 시각을 CLOCK_REALTIME 기준으로 줍니다. 서버가 “5초 안에 응답이 없으면 포기”하는 코드가 이렇게 생겼습니다.
5. 읽기-쓰기 락: 읽기끼리는 기다리지 말자
5.1 통찰
뮤텍스는 “한 번에 하나”입니다. 그런데 생각해 보면, 읽기만 하는 스레드끼리는 서로 방해할 이유가 없습니다. 3.1절의 표에서 값이 깨진 이유는 두 스레드가 같은 곳에 썼기 때문이었습니다. 아무도 안 고치는 데이터를 열 스레드가 동시에 읽는 것은 아무 문제가 없습니다.
읽기-쓰기 락(rwlock)은 이 통찰을 구현합니다.
- 읽기 락(
rdlock): 여러 스레드가 동시에 가질 수 있습니다 - 쓰기 락(
wrlock): 혼자만 가질 수 있고, 읽기도 못 들어옵니다
도서관 열람실과 같습니다. 책을 읽는 사람은 몇 명이든 같이 앉을 수 있지만, 책을 고쳐 쓰는 사람이 들어오면 모두 나가야 합니다. 설정 캐시, 라우팅 테이블, DNS 캐시처럼 읽기가 압도적으로 많은 데이터에 씁니다. 그런데 정말 뮤텍스보다 빠를까요? 쓰기 비율을 바꿔 가며 재 봅니다.
examples/rwlock.c:
/*
 * rwlock.c - 읽기-쓰기 락: 읽기끼리는 기다리지 말자
 * 20주차: 멀티스레딩과 병렬 프로그래밍
 *
 * 뮤텍스는 "한 번에 하나"입니다. 그런데 생각해 보면,
 * 읽기만 하는 스레드끼리는 서로 방해할 이유가 없습니다.
 * (아무도 안 고치는데 동시에 읽는 게 무슨 문제겠어요?)
 *
 * 읽기-쓰기 락(rwlock)은 이 통찰을 구현합니다:
 *   읽기 락: 여러 스레드가 동시에 가질 수 있다
 *   쓰기 락: 혼자만 가질 수 있다 (읽기도 못 들어옴)
 *
 * 읽기가 압도적으로 많은 워크로드(설정 캐시, 라우팅 테이블, DNS 캐시)에서
 * 뮤텍스보다 훨씬 빠릅니다. 직접 측정해 봅시다.
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <pthread.h>
#include <time.h>

#define THREADS    8
#define OPS        60000
#define TABLE_SIZE 64
#define WORK_LOOPS 200           /* 임계 구역에서 하는 '일'의 양 */

/* 보호할 공유 데이터: 간단한 설정 테이블 */
static int  table[TABLE_SIZE];
static long checksum_sink;       /* 최적화로 지워지지 않게 */

static pthread_mutex_t  mtx = PTHREAD_MUTEX_INITIALIZER;
static pthread_rwlock_t rwl = PTHREAD_RWLOCK_INITIALIZER;

static int write_percent = 5;    /* 쓰기 비율 */

static double elapsed_ms(struct timespec a, struct timespec b) {
    return (b.tv_sec - a.tv_sec) * 1000.0 + (b.tv_nsec - a.tv_nsec) / 1e6;
}

/* 임계 구역에서 하는 일 (읽기): 테이블을 훑어 합계 */
static long do_read(void) {
    long sum = 0;
    for (int k = 0; k < WORK_LOOPS; k++) {
        sum += table[k % TABLE_SIZE];
    }
    return sum;
}

/* 임계 구역에서 하는 일 (쓰기): 테이블 갱신 */
static void do_write(int value) {
    for (int k = 0; k < WORK_LOOPS; k++) {
        table[k % TABLE_SIZE] = value + k;
    }
}

/* ---------- 방식 A: 모든 접근에 뮤텍스 ---------- */
static void *mutex_worker(void *arg) {
    unsigned seed = (unsigned)(long)arg;
    long local = 0;

    for (int i = 0; i < OPS; i++) {
        seed = seed * 1103515245u + 12345u;
        int is_write = ((seed >> 16) % 100) < (unsigned)write_percent;

        pthread_mutex_lock(&mtx);
        if (is_write) do_write((int)(seed % 1000));
        else          local += do_read();
        pthread_mutex_unlock(&mtx);
    }
    __atomic_fetch_add(&checksum_sink, local, __ATOMIC_RELAXED);
    return NULL;
}

/* ---------- 방식 B: 읽기-쓰기 락 ---------- */
static void *rwlock_worker(void *arg) {
    unsigned seed = (unsigned)(long)arg;
    long local = 0;

    for (int i = 0; i < OPS; i++) {
        seed = seed * 1103515245u + 12345u;
        int is_write = ((seed >> 16) % 100) < (unsigned)write_percent;

        if (is_write) {
            pthread_rwlock_wrlock(&rwl);     /* 독점 */
            do_write((int)(seed % 1000));
            pthread_rwlock_unlock(&rwl);
        } else {
            pthread_rwlock_rdlock(&rwl);     /* 공유 - 여럿이 동시에! */
            local += do_read();
            pthread_rwlock_unlock(&rwl);
        }
    }
    __atomic_fetch_add(&checksum_sink, local, __ATOMIC_RELAXED);
    return NULL;
}

static double run(void *(*fn)(void *)) {
    pthread_t th[THREADS];
    checksum_sink = 0;

    struct timespec t0, t1;
    clock_gettime(CLOCK_MONOTONIC, &t0);
    for (long i = 0; i < THREADS; i++)
        pthread_create(&th[i], NULL, fn, (void *)(i + 1));
    for (int i = 0; i < THREADS; i++) pthread_join(th[i], NULL);
    clock_gettime(CLOCK_MONOTONIC, &t1);
    return elapsed_ms(t0, t1);
}

int main(void) {
    for (int i = 0; i < TABLE_SIZE; i++) table[i] = i;

    printf("=== 읽기-쓰기 락 vs 뮤텍스 ===\n");
    printf("스레드 %d개, 각 %d번 연산, 임계 구역에서 %d회 반복 작업\n\n",
           THREADS, OPS, WORK_LOOPS);

    printf("%-12s %12s %12s %10s\n", "쓰기 비율", "뮤텍스", "rwlock", "개선");
    printf("---------------------------------------------------\n");

    int ratios[] = {0, 5, 20, 50};
    for (int r = 0; r < 4; r++) {
        write_percent = ratios[r];

        double m = run(mutex_worker);
        double w = run(rwlock_worker);

        printf("%9d%%  %9.0f ms %9.0f ms %9.2f배\n",
               write_percent, m, w, m / (w > 0 ? w : 1));
    }

    printf("\n관찰:\n");
    printf("1. 쓰기가 적을수록 rwlock이 유리합니다\n");
    printf("   읽기끼리는 동시에 들어가니 스레드 수만큼 병렬화되죠.\n");
    printf("2. 쓰기가 많아지면 이점이 사라집니다\n");
    printf("   쓰기는 어차피 독점이고, rwlock 자체가 뮤텍스보다 무겁습니다.\n");
    printf("3. 경계선은 대략 '쓰기 10%% 이하'입니다 (워크로드마다 다름)\n");
    printf("   반드시 측정해 보고 결정하세요.\n");

    printf("\n=== 주의사항 ===\n");
    printf("1. 쓰기 기아(writer starvation)\n");
    printf("   읽기가 끊임없이 들어오면 쓰기가 영원히 못 들어갈 수 있습니다.\n");
    printf("   리눅스 기본 구현은 읽기 우선이라 이 위험이 있습니다.\n");
    printf("   pthread_rwlockattr_setkind_np로 쓰기 우선으로 바꿀 수 있습니다.\n");
    printf("2. 읽기 락 안에서 쓰기 금지!\n");
    printf("   읽기 락을 잡고 데이터를 고치면 다른 읽기 스레드와 충돌합니다.\n");
    printf("   컴파일러도 막아주지 않으니 const 포인터로 자신을 지키세요.\n");
    printf("3. 업그레이드 불가\n");
    printf("   읽기 락 -> 쓰기 락으로 '승격'하는 안전한 방법이 없습니다.\n");
    printf("   (두 스레드가 동시에 승격하려 하면 교착!)\n");
    printf("   읽기를 풀고 쓰기를 새로 잡되, 그 사이에 상태가 변했을 수\n");
    printf("   있으니 다시 확인해야 합니다.\n");

    printf("\n=== 언제 쓰나 ===\n");
    printf("좋은 경우: 설정 캐시, 라우팅 테이블, DNS 캐시, 읽기 전용 인덱스\n");
    printf("           (읽기 95%%, 쓰기 5%% 같은 워크로드)\n");
    printf("나쁜 경우: 쓰기가 잦은 카운터, 큐, 작업 목록\n");
    printf("           (이럴 땐 뮤텍스나 원자적 연산이 낫습니다)\n");

    pthread_rwlock_destroy(&rwl);
    pthread_mutex_destroy(&mtx);
    return 0;
}
코드에서 눈여겨볼 곳입니다.
seed = seed * 1103515245u + 12345u;: 3주차에서 본 선형 합동 난수입니다.rand()를 안 쓰는 이유는 9절에서 배웁니다(rand는 스레드 안전하지 않습니다). 스레드마다 다른 시드(i + 1)를 주니 각자 다른 순서로 읽기와 쓰기를 섞습니다.checksum_sink와__atomic_fetch_add: 읽은 합계를 아무 데도 안 쓰면 10주차에서 본 것처럼 컴파일러가 읽기 자체를 지워 버릴 수 있습니다. 그래서 결과를 전역 변수에 더하는데, 여러 스레드가 더하니 7절에서 배울 원자적 덧셈을 씁니다.(void *)(i + 1): 1.2절의 세 번째 방법입니다. 시드 값을 포인터에 끼워 넣어 넘깁니다.
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/rwlock.c -o build/rwlock -pthread
$ ./build/rwlock
=== 읽기-쓰기 락 vs 뮤텍스 ===
스레드 8개, 각 60000번 연산, 임계 구역에서 200회 반복 작업

쓰기 비율    뮤텍스       rwlock     개선
---------------------------------------------------
        0%        279 ms        24 ms     11.82배
        5%        271 ms       218 ms      1.24배
       20%        293 ms       503 ms      0.58배
       50%        320 ms       370 ms      0.86배
...
5.2 숫자를 정직하게 읽기
쓰기 0%: 11.8배 빠릅니다. 읽기끼리는 동시에 들어가니 스레드 8개가 정말로 병렬로 돕니다. 뮤텍스는 읽기조차 한 줄로 세우니 279ms 가 걸립니다.
쓰기 5%: 1.24배. 벌써 이점이 거의 사라졌습니다. 쓰기 하나가 들어오면 읽기 전부가 멈춰야 하고, 그 뒤에 쌓인 읽기가 한꺼번에 풀리는 식으로 흐름이 끊깁니다.
쓰기 20%: 0.58배, 오히려 두 배 가까이 느립니다. 쓰기는 어차피 독점이라 이득이 없고, rwlock 자체가 뮤텍스보다 무겁기 때문입니다. 읽는 사람이 몇 명인지 세고, 쓰기 대기자가 있는지 확인하고, 상태를 옮기는 일이 락을 잡고 풀 때마다 따라붙습니다. 뮤텍스는 그냥 “잠김/풀림” 하나입니다.
교훈은 이렇습니다.
읽기-쓰기 락은 “읽기가 압도적으로 많을 때”만 이득입니다. 경계선은 대략 쓰기 10% 이하이지만, 워크로드마다 다르니 반드시 측정하세요.
“읽기가 많으니 rwlock 이 좋겠지”라고 추측하고 바꿨다가 느려지는 경우가 실제로 많습니다. 이 표의 마지막 세 줄이 그 증거입니다.
5.3 세 가지 주의사항
① 쓰기 기아(writer starvation)
읽기가 끊임없이 들어오면 쓰기가 영원히 못 들어갈 수 있습니다. 열람실에 사람이 끊이지 않으면 책을 고칠 사람이 영영 못 들어오는 것입니다. 리눅스 glibc 의 기본 구현은 읽기 우선이라 이 위험이 있습니다.
pthread_rwlockattr_setkind_np(&attr, PTHREAD_RWLOCK_PREFER_WRITER_NONRECURSIVE_NP);
쓰기 우선으로 바꿀 수 있습니다. 이름 끝의 _np 는 non-portable, 리눅스 전용이라는 표시입니다.
② 읽기 락 안에서 쓰기 금지
읽기 락을 잡고 데이터를 고치면 같이 들어와 있는 다른 읽기 스레드와 충돌합니다. 컴파일러가 막아 주지 않습니다. 읽기용 함수가 const 포인터만 받게 만들어 두면(2주차의 const), 실수로 고치려 할 때 컴파일러가 잡아 줍니다.
③ 업그레이드 불가
읽기 락을 쓰기 락으로 “승격”하는 안전한 방법이 없습니다. 두 스레드가 읽기 락을 쥔 채로 동시에 승격하려 하면, 서로 상대가 나가기를 기다리며 교착합니다. 읽기를 풀고 쓰기를 새로 잡되, 그 사이에 상태가 변했을 수 있으니 다시 확인해야 합니다.
pthread_rwlock_rdlock(&rwl);
int need_update = check(...);
pthread_rwlock_unlock(&rwl);

if (need_update) {
    pthread_rwlock_wrlock(&rwl);
    if (check(...)) {          /* 다시 확인! 다른 스레드가 이미 했을 수도 */
        update(...);
    }
    pthread_rwlock_unlock(&rwl);
}
이 패턴을 이중 검사(double-checked) 라고 합니다. 4.4절의 while 과 같은 발상입니다. 락을 놓았다 다시 잡았으면 세상이 바뀌었다고 가정하세요.
6. 스핀락: 통념을 측정으로 검증하기
6.1 교과서가 말하는 것
뮤텍스는 락을 못 잡으면 잠듭니다. 3.5절의 gdb 화면에서 봤듯이 커널의 futex_wait 안에서 재워지고, 락이 풀리면 커널이 깨웁니다. 이 “재우고 깨우기”에 대략 마이크로초 단위의 비용이 듭니다.
임계 구역이 아주 짧다면(나노초 단위) 자고 깨는 비용이 기다리는 시간보다 비쌉니다. 침대에 눕는 데 1분이 걸리는데 5초만 기다리면 되는 상황입니다. 그래서 나온 것이 스핀락(spinlock) 입니다.
while (락이 잠겨있다) { } /* 자지 않고 CPU를 태우며 계속 확인 */
4.1절에서 나쁘다고 한 바쁜 대기를 일부러 하는 것입니다. 교과서는 보통 “짧은 임계 구역 = 스핀락”이라고 가르칩니다. 정말 그럴까요? 이 예제는 임계 구역 길이와 스레드 수를 바꿔 가며 뮤텍스, glibc 의 스핀락, 직접 만든 스핀락을 비교합니다.
examples/spinlock.c:
/*
 * spinlock.c - 스핀락: 자지 말고 기다려라
 * 20주차: 멀티스레딩과 병렬 프로그래밍
 *
 * 뮤텍스는 락을 못 잡으면 '잠듭니다'. 커널이 재우고, 나중에 깨우죠.
 * 이 재우고 깨우는 비용이 대략 마이크로초 단위입니다.
 *
 * 임계 구역이 아주 짧다면 자고 깨는 비용이 대기 시간보다 비싸집니다.
 * 그래서 나온 것이 스핀락입니다:
 *
 *   while (락이 잠겨있다) { }   <- 자지 않고 CPU를 태우며 계속 확인
 *
 * 교과서는 보통 "짧은 임계 구역 = 스핀락"이라고 가르칩니다.
 * 그런데 이 예제를 직접 돌려 보면 그렇게 단순하지 않습니다:
 *
 *   - 요즘 glibc 뮤텍스는 이미 '적응형 스핀'을 내장하고 있습니다
 *   - 코어보다 스레드가 많아지면 스핀락은 오히려 크게 느려집니다
 *
 * 통념을 외우지 말고 직접 측정하는 것 - 그것이 이 예제의 진짜 주제입니다.
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <pthread.h>
#include <stdatomic.h>
#include <time.h>

#define MAX_THREADS 64
#define OPS         100000

static long counter = 0;
static pthread_mutex_t    mtx = PTHREAD_MUTEX_INITIALIZER;
static pthread_spinlock_t spin;

/* 직접 만드는 스핀락 (원리를 보기 위해) */
static atomic_flag my_spin = ATOMIC_FLAG_INIT;

static void my_spin_lock(void) {
    /* test-and-set: 원자적으로 '설정하고 이전 값을 반환'
     * 이전 값이 true였다면 이미 누가 잡고 있다는 뜻 -> 계속 시도 */
    while (atomic_flag_test_and_set_explicit(&my_spin, memory_order_acquire)) {
        /* 바쁜 대기. CPU에게 "회전 중"이라고 힌트를 줄 수도 있다:
         *   __builtin_ia32_pause();   (x86의 PAUSE 명령) */
    }
}

static void my_spin_unlock(void) {
    atomic_flag_clear_explicit(&my_spin, memory_order_release);
}

static int work_amount = 1;      /* 임계 구역의 길이 (반복 횟수) */
static int n_threads = 4;        /* 동시에 도는 스레드 수 */

static double elapsed_ms(struct timespec a, struct timespec b) {
    return (b.tv_sec - a.tv_sec) * 1000.0 + (b.tv_nsec - a.tv_nsec) / 1e6;
}

/* 임계 구역에서 하는 일 */
static void critical_work(void) {
    for (int i = 0; i < work_amount; i++) counter++;
}

static void *mutex_worker(void *arg) {
    (void)arg;
    for (int i = 0; i < OPS; i++) {
        pthread_mutex_lock(&mtx);
        critical_work();
        pthread_mutex_unlock(&mtx);
    }
    return NULL;
}

static void *spin_worker(void *arg) {
    (void)arg;
    for (int i = 0; i < OPS; i++) {
        pthread_spin_lock(&spin);
        critical_work();
        pthread_spin_unlock(&spin);
    }
    return NULL;
}

static void *myspin_worker(void *arg) {
    (void)arg;
    for (int i = 0; i < OPS; i++) {
        my_spin_lock();
        critical_work();
        my_spin_unlock();
    }
    return NULL;
}

static double run(void *(*fn)(void *)) {
    pthread_t th[MAX_THREADS];
    counter = 0;

    struct timespec t0, t1;
    clock_gettime(CLOCK_MONOTONIC, &t0);
    for (int i = 0; i < n_threads; i++) pthread_create(&th[i], NULL, fn, NULL);
    for (int i = 0; i < n_threads; i++) pthread_join(th[i], NULL);
    clock_gettime(CLOCK_MONOTONIC, &t1);
    return elapsed_ms(t0, t1);
}

int main(void) {
    pthread_spin_init(&spin, PTHREAD_PROCESS_PRIVATE);

    long cores = sysconf(_SC_NPROCESSORS_ONLN);
    printf("=== 스핀락 vs 뮤텍스 ===\n");
    printf("이 시스템의 코어 수: %ld개\n\n", cores);

    /* ---------- 실험 1: 임계 구역 길이를 바꿔가며 ---------- */
    n_threads = 4;
    printf("[실험 1] 스레드 %d개 (코어보다 적음), 각 %d번 락 획득\n",
           n_threads, OPS);
    printf("%-14s %12s %12s %12s\n",
           "임계구역 길이", "뮤텍스", "스핀락", "직접 만든 것");
    printf("-------------------------------------------------------\n");

    int lengths[] = {1, 10, 100, 1000};
    for (int i = 0; i < 4; i++) {
        work_amount = lengths[i];

        double m = run(mutex_worker);
        long m_result = counter;
        double s = run(spin_worker);
        double my = run(myspin_worker);

        printf("%10d회  %9.0f ms %9.0f ms %9.0f ms",
               work_amount, m, s, my);
        if (m_result != (long)n_threads * OPS * work_amount) printf("  <- 오류!");
        printf("\n");
    }

    printf("\n관찰 (교과서와 다를 수 있습니다!):\n");
    printf("- 임계 구역이 아주 짧을 때 오히려 뮤텍스가 빠릅니다.\n");
    printf("  요즘 glibc 뮤텍스는 '적응형'이라 먼저 잠깐 스핀해 보고,\n");
    printf("  안 되면 그때 잠듭니다. 즉 이미 스핀락의 장점을 갖고 있죠.\n");
    printf("  반면 순수 스핀락은 모든 스레드가 '같은 한 줄'을 계속 두드려\n");
    printf("  캐시 라인 핑퐁이 심해집니다.\n");
    printf("- 임계 구역이 길어지면 스핀락이 앞섭니다. 코어가 남아돌아\n");
    printf("  기다리는 스레드가 남의 자리를 뺏지 않기 때문입니다.\n");

    /* ---------- 실험 2: 코어보다 스레드가 많으면? ---------- */
    printf("\n[실험 2] 스핀락이 무너지는 조건: 코어보다 스레드가 많을 때\n");
    work_amount = 200;
    printf("%-14s %12s %12s %10s\n", "스레드 수", "뮤텍스", "스핀락", "스핀락/뮤텍스");
    printf("-------------------------------------------------------\n");

    int counts[] = {2, 4, 8, 16, 32, 64};
    for (int i = 0; i < 6; i++) {
        n_threads = counts[i];
        if (n_threads > MAX_THREADS) break;

        double m = run(mutex_worker);
        double s = run(spin_worker);

        printf("%8d개%s  %9.0f ms %9.0f ms %9.2f배\n",
               n_threads, n_threads > cores ? "*" : " ", m, s, s / (m > 0 ? m : 1));
    }
    printf("(* = 코어 수를 초과)\n");
    printf("\n스레드가 코어보다 많아질수록 스핀락의 우위가 사라집니다.\n");
    printf("이유: 락을 쥔 스레드가 스케줄러에게 선점당하면, 기다리는\n");
    printf("스레드들은 '실행되지도 않는 스레드'를 기다리며 CPU를 태웁니다.\n");
    printf("그 CPU를 양보했다면 락을 쥔 스레드가 빨리 끝냈을 텐데 말이죠.\n");
    printf("뮤텍스는 잠들어 버리니 이 문제가 없습니다.\n");

    printf("\n=== 스핀락을 쓰면 안 되는 경우 ===\n");
    printf("1. 임계 구역이 길 때 (I/O, 시스템 콜, 긴 계산)\n");
    printf("2. 코어 수보다 스레드가 많을 때 (실험 2에서 확인!)\n");
    printf("3. 단일 코어 시스템\n");
    printf("   -> 기다리는 동안 락을 쥔 스레드가 실행될 수 없으니 무한 낭비\n");
    printf("4. 우선순위가 다른 스레드들 (우선순위 역전)\n");
    printf("   -> 낮은 우선순위 스레드가 락을 쥐었는데 높은 쪽이 스핀하면\n");
    printf("      낮은 쪽이 영원히 실행되지 못합니다\n");

    printf("\n=== 직접 만든 스핀락의 구조 ===\n");
    printf("  while (test_and_set(&flag)) { }      // 잠글 때까지 반복\n");
    printf("      ... 임계 구역 ...\n");
    printf("  clear(&flag);                        // 풀기\n\n");
    printf("test-and-set은 '값을 설정하고 이전 값을 반환'하는 원자적 연산입니다.\n");
    printf("이전 값이 '잠김'이었다면 내가 못 잡은 것이니 다시 시도하죠.\n");
    printf("acquire/release 메모리 순서가 붙은 이유도 중요합니다:\n");
    printf("  acquire - 락을 잡은 뒤의 읽기가 락 앞으로 새어 나가지 못하게\n");
    printf("  release - 락을 풀기 전의 쓰기가 뒤로 밀리지 못하게\n");
    printf("이게 없으면 CPU가 명령을 재배치해 임계 구역이 새어나갑니다!\n");

    printf("\n=== 요약 ===\n");
    printf("- '스핀락이 항상 빠르다'는 통념은 사실이 아닙니다\n");
    printf("- 요즘 뮤텍스는 이미 적응형 스핀을 내장하고 있습니다\n");
    printf("- 스핀락이 이기는 구간은 '코어가 남고 임계 구역이 짧을 때'로 좁습니다\n");
    printf("- 현실적 조언: 먼저 뮤텍스로 만들고, 프로파일링에서 락 경합이\n");
    printf("  병목으로 확인되면 그때 측정하며 바꾸세요 (23주차!)\n");

    pthread_spin_destroy(&spin);
    return 0;
}
직접 만든 스핀락 my_spin_lock 을 봅시다. 딱 한 줄이 핵심입니다.
while (atomic_flag_test_and_set_explicit(&my_spin, memory_order_acquire)) { }
test_and_set 은 “플래그를 켜고, 켜기 전의 값을 돌려준다”를 한 번에 하는 원자적 연산입니다. 돌려받은 값이 “이미 켜져 있었음”이면 누군가 락을 쥐고 있다는 뜻이니 다시 시도합니다. “꺼져 있었음”이면 내가 방금 켠 것이니 락을 잡은 것입니다. 이 두 단계가 한 번에 되지 않으면 3.1절의 표처럼 두 스레드가 동시에 “꺼져 있네” 하고 들어와 버립니다. 원자적 연산이 무엇인지는 7절에서 기계어로 확인합니다.
memory_order_acquire 와 release 는 7.5절에서 다룹니다. 지금은 “락을 잡은 뒤의 일이 락 앞으로, 락을 풀기 전의 일이 락 뒤로 새어 나가지 못하게 막는 표시”라고만 알아 두세요.
컴파일하고 실행합니다. 12초쯤 걸립니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/spinlock.c -o build/spinlock -pthread
$ ./build/spinlock
=== 스핀락 vs 뮤텍스 ===
이 시스템의 코어 수: 12개

[실험 1] 스레드 4개 (코어보다 적음), 각 100000번 락 획득
임계구역 길이    뮤텍스    스핀락 직접 만든 것
-------------------------------------------------------
         1회          8 ms        17 ms        19 ms
        10회         23 ms        12 ms        19 ms
       100회         93 ms        35 ms        48 ms
      1000회        480 ms       242 ms       251 ms
...
[실험 2] 스핀락이 무너지는 조건: 코어보다 스레드가 많을 때
스레드 수     뮤텍스    스핀락 스핀락/뮤텍스
-------------------------------------------------------
       2개          50 ms        30 ms      0.60배
       4개         148 ms        56 ms      0.38배
       8개         374 ms       147 ms      0.39배
      16개*        759 ms       375 ms      0.49배
      32개*       1532 ms      1407 ms      0.92배
      64개*       3018 ms      3525 ms      1.17배
(* = 코어 수를 초과)
...
6.2 교과서와 반대 결과
실험 1의 첫 줄을 보세요. 임계 구역이 가장 짧을 때(1회) 뮤텍스가 8ms, 스핀락이 17ms 입니다. 뮤텍스가 2배 빠릅니다. 교과서가 말한 것과 반대입니다. 왜일까요? 두 가지 이유가 있습니다.
① 요즘 뮤텍스는 이미 스핀합니다. glibc 의 뮤텍스는 적응형(adaptive) 입니다. 락이 잠겨 있으면 곧바로 커널로 가서 잠드는 게 아니라, 먼저 잠깐 회전하며 기다려 보고, 그래도 안 풀리면 그때 futex_wait 으로 잠듭니다. 즉 이미 스핀락의 장점을 내장하고 있습니다. 3.5절의 gdb 화면에서 스레드가 futex_wait 에 있었던 것은 오래 기다려야 해서 결국 잠든 상태였던 것입니다.
② 순수 스핀락은 캐시 라인을 두드립니다. 기다리는 스레드 셋이 모두 같은 메모리 위치에 쉴 새 없이 원자적 연산을 시도합니다. 그러면 그 메모리를 담은 캐시 라인이 코어 사이를 정신없이 오갑니다. 8절에서 이 현상이 얼마나 비싼지 직접 보게 됩니다. 락을 쥔 스레드가 락을 풀려고 할 때조차 이 소동 때문에 느려집니다.
임계 구역이 길어지면(10회 이상) 스핀락이 앞서기 시작합니다. 코어가 남아돌아(12개 중 4개만 사용) 기다리는 스레드가 남의 자리를 뺏지 않고, 락을 풀자마자 깨어나는 지연 없이 바로 들어가기 때문입니다.
6.3 스핀락이 무너지는 조건
실험 2가 교과서의 경고를 실제로 보여 줍니다. 임계 구역 길이는 200회로 고정하고 스레드 수만 늘렸습니다.
| 스레드 수 | 스핀락/뮤텍스 | 뜻 |
|---|---|---|
| 4개 | 0.38배 | 스핀락이 2.6배 빠름 |
| 8개 (코어 이하) | 0.39배 | 스핀락이 2.6배 빠름 |
| 16개* | 0.49배 | 격차가 줄어듦 |
| 32개* | 0.92배 | 거의 같음 |
| 64개* | 1.17배 | 스핀락이 느려짐 |
스레드가 코어(12개)보다 많아질수록 스핀락의 우위가 사라지고, 결국 역전됩니다.
이유를 생각해 봅시다. 스레드가 64개인데 코어는 12개이니, 어느 순간에도 52개는 실행되지 못하고 차례를 기다립니다. 락을 쥔 스레드가 하필 그 52개에 속하면 어떻게 될까요? 락을 쥔 채로 멈춰 있는데, 실행 중인 다른 스레드들은 그 락이 풀리기를 CPU 를 돌리며 기다립니다. 그 CPU 시간을 양보했다면 락을 쥔 스레드가 실행되어 빨리 풀었을 텐데 말이죠. 실행되지도 않는 스레드를 기다리며 CPU 를 태우는 것입니다.
뮤텍스는 잠들어 버리니 이 문제가 없습니다. 기다리는 스레드가 CPU 를 내놓으면 커널이 그 자리에 락을 쥔 스레드를 올릴 수 있습니다.
6.4 결론
- “스핀락이 항상 빠르다”는 통념은 사실이 아닙니다. 이 컴퓨터에서 가장 짧은 임계 구역에서는 뮤텍스가 2배 빨랐습니다.
- 요즘 뮤텍스는 이미 적응형 스핀을 내장하고 있습니다.
- 스핀락이 이기는 구간은 “코어가 남고 임계 구역이 적당히 길 때”로 좁습니다.
- 커널 코드처럼 “절대 잠들면 안 되는” 문맥에서는 여전히 필수입니다. 30주차에서 다시 만납니다.
현실적 조언: 먼저 뮤텍스로 만드세요. 프로파일링에서 락 경합이 병목으로 확인되면, 그때 측정하며 바꾸세요. 23주차 성능 최적화에서 그 방법을 다룹니다.
이 예제의 진짜 교훈은 스핀락 자체가 아닙니다. 통념을 외우지 말고 직접 측정하라는 것입니다. 그리고 이 표의 숫자는 이 컴퓨터, 오늘의 부하에서 나온 것입니다. 여러분 컴퓨터에서는 경계선이 다른 곳에 있을 수 있습니다.
7. 원자적 연산: 락 없이 안전하게
7.1 CPU 가 주는 무기
3.1절에서 counter++ 가 위험한 이유는 “읽기, 더하기, 쓰기” 세 단계라서였습니다. 그런데 CPU 에는 이 셋을 한 덩어리로 수행하는 명령이 있습니다. 1주차 7절의 objdump 로 예제의 두 함수를 비교해 봅시다.
$ objdump -d build/atomic_ops | grep -A6 "<plain_worker>:"
00000000000012d6 <plain_worker>:
    ...
    12eb:	48 8b 05 4e 2d 00 00 	mov    0x2d4e(%rip),%rax        # 4040 <plain_counter>
    12f2:	48 83 c0 01          	add    $0x1,%rax
    12f6:	48 89 05 43 2d 00 00 	mov    %rax,0x2d43(%rip)        # 4040 <plain_counter>
plain_counter++ 는 정확히 3.1절의 세 줄입니다. 메모리에서 읽고(mov), 더하고(add), 메모리에 쓰기(mov). 세 명령 사이 어디에서든 다른 스레드가 끼어들 수 있습니다.
$ objdump -d build/atomic_ops | grep -A4 "<atomic_worker>:"
0000000000001311 <atomic_worker>:
    ...
    1326:	f0 48 83 05 19 2d 00 	lock addq $0x1,0x2d19(%rip)        # 4048 <atomic_counter>
atomic_fetch_add 는 한 명령입니다. addq 앞에 붙은 lock 접두사(기계어 f0)가 핵심입니다. “이 명령이 메모리를 읽고 쓰는 동안 다른 코어가 그 메모리를 건드리지 못하게 하라”는 뜻입니다. CPU 가 하드웨어 수준에서 캐시 라인을 잠급니다. 끼어들 틈이 명령 안에 있으니 끼어들 수가 없습니다.
C11 부터 이것을 표준 함수로 쓸 수 있습니다.
#include <stdatomic.h>
atomic_long counter = 0;
atomic_fetch_add(&counter, 1);     /* 락 없이 안전 */
examples/atomic_ops.c:
/*
 * atomic_ops.c - 원자적 연산: 락 없이 안전하게
 * 20주차: 멀티스레딩과 병렬 프로그래밍
 *
 * counter++ 가 위험한 이유는 '읽기-더하기-쓰기' 세 단계라서였습니다.
 * 그런데 CPU에는 이 셋을 '한 덩어리로' 수행하는 명령이 있습니다.
 *
 *   lock xadd    <- x86의 원자적 덧셈. 중간에 끼어들 수 없다!
 *
 * C11부터 표준으로 쓸 수 있습니다 (<stdatomic.h>):
 *   atomic_int counter;
 *   atomic_fetch_add(&counter, 1);     // 락 없이 안전
 *
 * 락보다 빠릅니다. 대신 '한 변수'에만 쓸 수 있죠.
 * 여러 변수를 한꺼번에 일관되게 바꿔야 한다면 여전히 락이 필요합니다.
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <pthread.h>
#include <stdatomic.h>
#include <time.h>

#define THREADS 4
#define LOOPS   500000

static long            plain_counter = 0;
static atomic_long     atomic_counter = 0;
static long            mutex_counter = 0;
static pthread_mutex_t lock = PTHREAD_MUTEX_INITIALIZER;

static double elapsed_ms(struct timespec a, struct timespec b) {
    return (b.tv_sec - a.tv_sec) * 1000.0 + (b.tv_nsec - a.tv_nsec) / 1e6;
}

static void *plain_worker(void *arg) {
    (void)arg;
    for (int i = 0; i < LOOPS; i++) plain_counter++;
    return NULL;
}

static void *atomic_worker(void *arg) {
    (void)arg;
    for (int i = 0; i < LOOPS; i++) {
        atomic_fetch_add(&atomic_counter, 1);    /* 원자적! */
    }
    return NULL;
}

static void *mutex_worker(void *arg) {
    (void)arg;
    for (int i = 0; i < LOOPS; i++) {
        pthread_mutex_lock(&lock);
        mutex_counter++;
        pthread_mutex_unlock(&lock);
    }
    return NULL;
}

static double run(void *(*fn)(void *)) {
    pthread_t th[THREADS];
    struct timespec t0, t1;
    clock_gettime(CLOCK_MONOTONIC, &t0);
    for (int i = 0; i < THREADS; i++) pthread_create(&th[i], NULL, fn, NULL);
    for (int i = 0; i < THREADS; i++) pthread_join(th[i], NULL);
    clock_gettime(CLOCK_MONOTONIC, &t1);
    return elapsed_ms(t0, t1);
}

/* ---------- CAS로 만드는 락-프리 스택 ---------- */
typedef struct Node {
    int value;
    struct Node *next;
} Node;

static _Atomic(Node *) stack_top = NULL;

static void lockfree_push(int value) {
    Node *node = malloc(sizeof(Node));
    if (node == NULL) return;
    node->value = value;

    /* CAS 루프: "내가 본 top이 아직 그대로면 바꿔라" */
    Node *old_top;
    do {
        old_top = atomic_load(&stack_top);
        node->next = old_top;
    } while (!atomic_compare_exchange_weak(&stack_top, &old_top, node));
    /*        ^ 실패하면 old_top에 '현재 값'이 담겨 다시 시도한다 */
}

static int lockfree_pop(int *out) {
    Node *old_top;
    do {
        old_top = atomic_load(&stack_top);
        if (old_top == NULL) return 0;
    } while (!atomic_compare_exchange_weak(&stack_top, &old_top, old_top->next));

    *out = old_top->value;
    free(old_top);               /* 주의: 실전에서는 ABA 문제 때문에 위험! */
    return 1;
}

static void *push_worker(void *arg) {
    long base = (long)arg;
    for (int i = 0; i < 1000; i++) lockfree_push((int)(base * 1000 + i));
    return NULL;
}

int main(void) {
    long expected = (long)THREADS * LOOPS;

    printf("=== 1. 세 가지 카운터 대결 ===\n");
    printf("스레드 %d개 x %d번 증가, 기대값 %ld\n\n", THREADS, LOOPS, expected);

    plain_counter = 0;
    double ms_plain = run(plain_worker);
    printf("  [그냥 ++]   %9ld  %7.1f ms  %s\n", plain_counter, ms_plain,
           plain_counter == expected ? "정확" : "<- 틀림!");

    atomic_store(&atomic_counter, 0);
    double ms_atomic = run(atomic_worker);
    printf("  [원자적]    %9ld  %7.1f ms  %s\n",
           atomic_load(&atomic_counter), ms_atomic,
           atomic_load(&atomic_counter) == expected ? "정확" : "<- 틀림!");

    mutex_counter = 0;
    double ms_mutex = run(mutex_worker);
    printf("  [뮤텍스]    %9ld  %7.1f ms  %s\n", mutex_counter, ms_mutex,
           mutex_counter == expected ? "정확" : "<- 틀림!");

    printf("\n  원자적 연산이 뮤텍스보다 %.2f배 빠릅니다.\n",
           ms_mutex / (ms_atomic > 0 ? ms_atomic : 1));
    printf("  생각보다 차이가 작죠? 요즘 glibc 뮤텍스는 아주 잘 만들어져\n");
    printf("  있습니다. 경합이 없으면 원자적 연산 하나로 처리하고, 경합이\n");
    printf("  있어도 잠깐 회전(spin)한 뒤에야 커널로 들어가거든요(futex).\n");
    printf("  원자적 연산의 진짜 장점은 속도보다 '절대 블록되지 않는다'는\n");
    printf("  것입니다 - 시그널 핸들러 안에서도, 실시간 코드에서도 안전하죠.\n");

    /* ---------- 2. 왜 항상 원자적 연산을 안 쓰나 ---------- */
    printf("\n=== 2. 그럼 왜 락을 쓰나? ===\n");
    printf("원자적 연산은 '변수 하나'만 보호합니다.\n");
    printf("여러 변수를 '함께' 일관되게 바꿔야 한다면 못 씁니다:\n\n");
    printf("  /* 계좌 이체: 둘이 한 덩어리여야 한다 */\n");
    printf("  atomic_fetch_sub(&from_balance, 1000);\n");
    printf("  /* <- 이 사이에 다른 스레드가 보면 돈이 사라진 상태! */\n");
    printf("  atomic_fetch_add(&to_balance, 1000);\n\n");
    printf("이런 '불변식(invariant)'을 지키려면 락이 필요합니다.\n");

    /* ---------- 3. CAS: 원자적 연산의 심장 ---------- */
    printf("\n=== 3. CAS (Compare-And-Swap) ===\n");
    printf("모든 락-프리 자료구조의 기본 연산입니다:\n\n");
    printf("  bool CAS(주소, 기대값, 새값):\n");
    printf("      원자적으로 { if (*주소 == 기대값) { *주소 = 새값; return true; }\n");
    printf("                  else { 기대값 = *주소; return false; } }\n\n");
    printf("\"내가 본 값이 아직 그대로면 바꿔라. 아니면 실패를 알려라.\"\n");
    printf("실패하면 새로 읽어서 다시 시도합니다 (낙관적 동시성).\n");

    atomic_store(&stack_top, NULL);
    pthread_t th[THREADS];
    for (long i = 0; i < THREADS; i++)
        pthread_create(&th[i], NULL, push_worker, (void *)(i + 1));
    for (int i = 0; i < THREADS; i++) pthread_join(th[i], NULL);

    int count = 0, value;
    while (lockfree_pop(&value)) count++;
    printf("\n락-프리 스택에 스레드 %d개가 각 1000개씩 넣었습니다.\n", THREADS);
    printf("꺼낸 개수: %d (기대 %d)  %s\n", count, THREADS * 1000,
           count == THREADS * 1000 ? "-> 하나도 안 잃었습니다!" : "-> 유실!");

    /* ---------- 4. 메모리 순서 ---------- */
    printf("\n=== 4. 메모리 순서(memory order) ===\n");
    printf("CPU와 컴파일러는 성능을 위해 명령 순서를 바꿉니다.\n");
    printf("단일 스레드에서는 문제없지만 여러 스레드에서는 재앙이 될 수 있죠.\n\n");
    printf("  memory_order_relaxed : 순서 보장 없음. 카운터처럼 순서가 무의미할 때\n");
    printf("  memory_order_acquire : 이 뒤의 읽기가 앞으로 오지 못함 (락 획득)\n");
    printf("  memory_order_release : 이 앞의 쓰기가 뒤로 가지 못함 (락 해제)\n");
    printf("  memory_order_seq_cst : 전체 순서 일관성 (기본값, 가장 안전/느림)\n\n");
    printf("기본값(seq_cst)이면 대부분 안전합니다.\n");
    printf("relaxed는 '정말 순서가 상관없을 때'만 쓰세요 - 통계 카운터 등.\n");

    /* ---------- 5. ABA 문제 ---------- */
    printf("\n=== 5. 락-프리의 함정: ABA 문제 ===\n");
    printf("CAS는 '값이 같은가'만 봅니다. '변하지 않았는가'가 아니라요.\n\n");
    printf("  스레드1: top(A)을 읽고 CAS 준비\n");
    printf("  스레드2: A를 pop -> B를 pop -> A를 다시 push (top이 A로 복귀!)\n");
    printf("  스레드1: CAS 성공! (값이 A로 같으니까)\n");
    printf("           그런데 A->next는 이미 해제된 B를 가리킨다 -> 참사\n\n");
    printf("해결책: 태그 붙이기(포인터+카운터), 위험 포인터(hazard pointer),\n");
    printf("        RCU, 에폭 기반 회수 등 - 전부 만만치 않습니다.\n");
    printf("\n-> 그래서 락-프리 자료구조는 '직접 만들지 말고 검증된 것을 쓰라'가\n");
    printf("   업계의 조언입니다. 위 스택도 교육용이지 실전용이 아닙니다.\n");

    return 0;
}

원자 연산 vs 뮤텍스
그림은 글을 쓴 뒤 다시 돌린 결과입니다. 벤치마크라서 본문 표와 수치가 몇 % 다릅니다. 배속과 순서가 같은지를 보세요 — 절대값이 아니라 그게 이 측정이 말하려는 것입니다.
새로 나온 타입과 함수를 정리합니다.
| 이름 | 뜻 |
|---|---|
atomic_long |
원자적으로 다룰 수 있는 long. <stdatomic.h> 에 atomic_int 등 타입마다 있습니다 |
_Atomic(Node *) |
임의의 타입을 원자적으로 만드는 일반형. 여기서는 포인터 |
atomic_load(&x) / atomic_store(&x, v) |
원자적으로 읽기 / 쓰기. 일반 변수처럼 x 라고만 써도 되지만 의도를 드러내려고 명시합니다 |
atomic_fetch_add(&x, n) |
x += n 을 원자적으로 하고 더하기 전 값을 돌려줍니다 |
atomic_compare_exchange_weak(&x, &expected, desired) |
7.4절의 CAS |
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/atomic_ops.c -o build/atomic_ops -pthread
$ ./build/atomic_ops
=== 1. 세 가지 카운터 대결 ===
스레드 4개 x 500000번 증가, 기대값 2000000

  [그냥 ++]      588164     19.1 ms  <- 틀림!
  [원자적]      2000000     29.6 ms  정확
  [뮤텍스]      2000000     31.0 ms  정확

  원자적 연산이 뮤텍스보다 1.05배 빠릅니다.
  ...
락-프리 스택에 스레드 4개가 각 1000개씩 넣었습니다.
꺼낸 개수: 4000 (기대 4000)  -> 하나도 안 잃었습니다!
...
7.2 1.05배: 정직한 결과
원자적 연산이 뮤텍스보다 겨우 1.05배 빠릅니다. “락-프리가 훨씬 빠르다”는 기대와 다릅니다.
6절에서 본 이유와 같습니다. glibc 뮤텍스는 경합이 없으면 원자적 연산 하나로 락을 잡습니다. 즉 뮤텍스의 빠른 경로가 이미 lock addq 와 거의 같은 비용입니다. 경합이 있어도 잠깐 회전한 뒤에야 커널로 들어갑니다.
그리고 원자적 연산도 공짜가 아닙니다. 락 없는 plain_counter++ 가 19ms 인데 lock addq 는 30ms 입니다. lock 접두사가 캐시 라인을 잠그고 다른 코어와 조율하는 데 시간이 듭니다. 네 스레드가 같은 변수를 두드리니 8절의 캐시 라인 핑퐁도 일어납니다.
그렇다면 원자적 연산의 진짜 장점은 무엇일까요? 속도가 아니라 “절대 블록되지 않는다”는 성질입니다.
- 시그널 핸들러 안에서도 안전합니다. 18주차의 async-signal-safe 규칙을 떠올리세요. 핸들러 안에서 뮤텍스를 잡으면, 그 락을 쥔 채로 시그널을 받은 경우 자기 자신을 기다리는 교착이 됩니다.
- 실시간 코드에서 예측 가능한 지연을 보장합니다. 잠들었다 깨는 시간은 예측할 수 없습니다.
- 락을 쥔 스레드가 죽어도 다른 스레드가 멈추지 않습니다. 락이 없으니까요.
7.3 그럼 왜 락을 쓰나
원자적 연산은 변수 하나만 보호합니다. 여러 변수를 함께 일관되게 바꿔야 한다면 못 씁니다.
/* 계좌 이체: 둘이 한 덩어리여야 한다 */
atomic_fetch_sub(&from_balance, 1000);
/* <- 이 사이에 다른 스레드가 보면 돈이 사라진 상태! */
atomic_fetch_add(&to_balance, 1000);
각 연산은 원자적이지만 둘을 합친 것은 원자적이지 않습니다. 두 줄 사이에 다른 스레드가 두 계좌를 합산하면 1000원이 비는 순간을 보게 됩니다. “두 계좌의 합은 항상 같다” 같은 규칙을 불변식(invariant) 이라고 하는데, 불변식이 여러 변수에 걸쳐 있으면 락이 필요합니다. 4절의 큐가 count, in, out 세 변수를 뮤텍스 하나로 함께 보호한 것이 그 예입니다.
7.4 CAS: 락-프리의 심장
atomic_fetch_add 는 더하기만 할 수 있습니다. 더 복잡한 것, 예를 들어 연결 리스트의 머리를 바꾸는 일을 락 없이 하려면 어떻게 할까요? 모든 락-프리 자료구조의 기본 연산인 CAS(Compare-And-Swap) 가 답입니다.
bool CAS(주소, 기대값, 새값):
    원자적으로 {
        if (*주소 == 기대값) { *주소 = 새값; return true; }
        else { 기대값 = *주소; return false; }
    }
“내가 본 값이 아직 그대로면 바꿔라. 아니면 실패를 알려라.” 실패하면 새로 읽어서 다시 시도합니다. “충돌은 드물 테니 일단 해 보고, 부딪히면 다시 하자”는 이 전략을 낙관적 동시성이라고 합니다. 락은 “충돌할지 모르니 미리 문을 잠근다”는 비관적 전략입니다.
예제의 락-프리 스택이 이 패턴입니다. 10주차의 연결 리스트 push_front 를 떠올리면서 봅시다.
static void lockfree_push(int value) {
    Node *node = malloc(sizeof(Node));
    node->value = value;

    Node *old_top;
    do {
        old_top = atomic_load(&stack_top);     /* ① 지금의 머리를 읽는다 */
        node->next = old_top;                  /* ② 내 노드가 그것을 가리키게 */
    } while (!atomic_compare_exchange_weak(&stack_top, &old_top, node));
    /*        ③ "머리가 아직 old_top 이면 node 로 바꿔라" */
}
①②③ 사이에 다른 스레드가 먼저 push 했다면 머리는 이미 old_top 이 아닙니다. 그러면 ③ 이 실패하면서 old_top 에 현재 머리를 담아 주고, do-while 이 ①부터 다시 합니다. 새 머리 뒤에 내 노드를 다시 붙이고 다시 시도하는 것입니다. 실행 결과에서 네 스레드가 동시에 1000개씩 넣었는데 4000개가 다 나온 것이 그 증거입니다.
함수 이름의 weak 은 “가짜 실패”가 있을 수 있다는 뜻입니다. 값이 같은데도 실패했다고 할 수 있습니다. 루프 안에서는 어차피 재시도하니 상관없고, 일부 CPU 에서 더 빠릅니다. 루프 없이 한 번만 시도할 때는 strong 을 씁니다.
7.5 메모리 순서
1주차 7절에서 컴파일러가 코드를 뜻대로 번역한다고 했고, 10주차에서 최적화가 반복문을 지우는 것을 봤습니다. CPU 도 마찬가지로 성능을 위해 명령의 실행 순서를 바꿉니다. 단일 스레드에서는 결과가 같도록 바꾸니 문제없지만, 다른 스레드가 중간 상태를 보면 이야기가 다릅니다.
data = 42;          /* ① */
ready = 1;          /* ② */    /* 다른 스레드: ready 가 1이면 data 를 읽는다 */
CPU 가 ②를 ①보다 먼저 메모리에 반영하면, 다른 스레드는 ready == 1 을 보고 data 를 읽었는데 아직 42가 아닐 수 있습니다. 원자적 연산 함수들의 _explicit 판에는 이런 재배치를 얼마나 막을지 정하는 인자가 있습니다.
| 메모리 순서 | 의미 |
|---|---|
memory_order_relaxed |
순서 보장 없음. 이 변수만 원자적이면 되고 다른 변수와의 순서는 상관없을 때 |
memory_order_acquire |
이 뒤의 읽기가 앞으로 오지 못함. 락을 잡을 때 |
memory_order_release |
이 앞의 쓰기가 뒤로 가지 못함. 락을 풀 때 |
memory_order_seq_cst |
모든 스레드가 같은 순서로 본다. 기본값, 가장 안전하고 가장 느림 |
6절의 직접 만든 스핀락이 acquire 로 잡고 release 로 푼 이유가 이것입니다. 락을 푸는 release 앞에 임계 구역의 쓰기가 전부 끝나 있고, 락을 잡는 acquire 뒤에야 임계 구역의 읽기가 시작되도록 보장합니다. 이것이 없으면 임계 구역이 락 밖으로 새어 나갑니다.
기본값(seq_cst)이면 대부분 안전합니다. atomic_fetch_add 처럼 _explicit 가 없는 함수는 전부 기본값입니다. relaxed 는 통계 카운터처럼 “정확한 순서가 무의미할 때”만 쓰세요. 5절의 checksum_sink 가 그런 경우였습니다.
메모리 순서를 잘못 쓴 버그는 특정 CPU 에서만, 특정 타이밍에만 나타납니다. 이 글의 x86 은 메모리 모델이 강해서 웬만하면 넘어가지만, 스마트폰의 ARM 에서는 바로 터집니다. 확신이 없으면 기본값을 쓰세요.
7.6 락-프리의 함정: ABA 문제
CAS 는 “값이 같은가” 만 봅니다. “변하지 않았는가”가 아닙니다. 예제의 lockfree_pop 을 두 스레드가 동시에 부르면 이런 일이 생길 수 있습니다.
스택: A -> B -> C

스레드1: old_top = A 를 읽고, A->next(= B) 를 새 머리로 준비. CAS 직전에 멈춤
스레드2: A 를 pop (free!) -> B 를 pop (free!) -> 새 노드를 push 했는데
         malloc 이 방금 free 한 A 의 주소를 다시 줌 -> 머리가 다시 A
스레드1: CAS(머리, 기대 A, 새값 B) -> 머리가 A 니까 성공!
         이제 머리는 B. 그런데 B 는 이미 free 된 메모리 -> 참사
값은 A 로 같지만 그 사이에 세계가 바뀐 것입니다. A 가 갔다가 다른 A 로 돌아왔다고 해서 ABA 문제라고 부릅니다. 7주차의 해제 후 사용(use-after-free)이 락-프리 세계에서 나타나는 모양입니다.
해결책들이 있긴 합니다.
- 태그 붙이기: 포인터에 세대 번호를 붙여 “몇 번째 A 인가”를 구분
- 위험 포인터(hazard pointer): 사용 중인 포인터를 등록해 해제를 막음
- RCU(Read-Copy-Update): 리눅스 커널이 쓰는 방식. 30주차에서 봅니다
- 에폭 기반 회수: 세대를 나눠 안전한 시점에 일괄 해제
전부 만만치 않습니다. 그래서 업계의 조언은 이렇습니다.
락-프리 자료구조는 직접 만들지 말고 검증된 것을 쓰세요.
이 예제의 스택도 교육용이지 실전용이 아닙니다. pop 의 free 가 ABA 에 취약하다는 것을 이제 여러분은 압니다. 락-프리는 “원리를 이해하되 구현은 전문가에게”의 영역입니다.
8. 거짓 공유: 캐시 라인이 만드는 48배
8.1 공유하지 않는데 느리다
지금까지의 문제는 전부 “같은 변수를 여럿이 건드려서” 생겼습니다. 그럼 스레드 4개가 각자 다른 변수를 올리면 어떨까요? 공유하는 것이 없으니 락도 필요 없고, 완벽하게 병렬이어야 합니다.
static long packed[THREADS];      /* 각 스레드가 자기 칸만 건드린다 */

static void *packed_worker(void *arg) {
    int id = ((Arg *)arg)->id;
    for (long i = 0; i < ITERATIONS; i++) {
        packed[id]++;                    /* 내 변수만 건드리는데... */
    }
    return NULL;
}
그런데 이 코드가 엄청나게 느립니다. 같은 일을 하는데 배치만 바꾼 두 버전과 비교해 봅니다.
examples/false_sharing.c:
/*
 * false_sharing.c - 거짓 공유: 서로 다른 변수인데 왜 느릴까
 * 20주차: 멀티스레딩과 병렬 프로그래밍
 *
 * 스레드 4개가 '각자 다른 변수'를 올립니다. 공유하는 것이 없으니
 * 락도 필요 없고, 완벽하게 병렬이어야 하죠. 그런데...
 *
 * CPU는 메모리를 바이트가 아니라 '캐시 라인'(보통 64바이트) 단위로
 * 다룹니다. 변수 네 개가 한 캐시 라인 안에 나란히 있으면?
 *
 *   코어1이 counter[0]을 쓰면 -> 그 캐시 라인 전체가 '더러워짐'
 *   -> 다른 코어의 같은 라인 사본이 무효화됨
 *   -> 코어2가 counter[1]을 쓰려면 라인을 다시 가져와야 함
 *
 * 논리적으로는 아무것도 공유하지 않는데 하드웨어 수준에서는
 * 캐시 라인을 두고 싸우는 것입니다. 이것이 '거짓 공유'입니다.
 *
 * 이 예제는 그 비용을 직접 측정합니다. 10배 넘게 차이 납니다!
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <pthread.h>
#include <time.h>
#include <stdalign.h>

#define THREADS    4
#define ITERATIONS 30000000
#define CACHE_LINE 64            /* x86-64의 일반적인 캐시 라인 크기 */

/* (가) 나쁜 배치: 카운터 4개가 한 캐시 라인에 옹기종기 */
static long packed[THREADS];

/* (나) 좋은 배치: 각 카운터를 캐시 라인 크기로 떨어뜨린다 */
typedef struct {
    alignas(CACHE_LINE) long value;      /* C11의 정렬 지정 */
    char padding[CACHE_LINE - sizeof(long)];
} PaddedCounter;

static PaddedCounter padded[THREADS];

typedef struct { int id; } Arg;

static double elapsed_ms(struct timespec a, struct timespec b) {
    return (b.tv_sec - a.tv_sec) * 1000.0 + (b.tv_nsec - a.tv_nsec) / 1e6;
}

static void *packed_worker(void *arg) {
    int id = ((Arg *)arg)->id;
    for (long i = 0; i < ITERATIONS; i++) {
        packed[id]++;                    /* 내 변수만 건드리는데... */
    }
    return NULL;
}

static void *padded_worker(void *arg) {
    int id = ((Arg *)arg)->id;
    for (long i = 0; i < ITERATIONS; i++) {
        padded[id].value++;              /* 같은 일인데 배치만 다르다 */
    }
    return NULL;
}

/* (다) 최선: 지역 변수에 모았다가 마지막에 한 번만 쓰기 */
static void *local_worker(void *arg) {
    int id = ((Arg *)arg)->id;
    long local = 0;                      /* 레지스터/스택에 산다 */
    for (long i = 0; i < ITERATIONS; i++) {
        local++;
    }
    padded[id].value = local;
    return NULL;
}

static double run(void *(*fn)(void *)) {
    pthread_t th[THREADS];
    Arg args[THREADS];

    memset(packed, 0, sizeof(packed));
    memset(padded, 0, sizeof(padded));

    struct timespec t0, t1;
    clock_gettime(CLOCK_MONOTONIC, &t0);
    for (int i = 0; i < THREADS; i++) {
        args[i].id = i;
        pthread_create(&th[i], NULL, fn, &args[i]);
    }
    for (int i = 0; i < THREADS; i++) pthread_join(th[i], NULL);
    clock_gettime(CLOCK_MONOTONIC, &t1);
    return elapsed_ms(t0, t1);
}

int main(void) {
    printf("=== 거짓 공유(false sharing) 실험 ===\n");
    printf("스레드 %d개가 '각자 다른 변수'를 %d번 증가시킵니다.\n",
           THREADS, ITERATIONS);
    printf("공유 자원이 없으니 락도 없고, 완벽히 병렬이어야 합니다.\n\n");

    printf("메모리 배치 확인:\n");
    for (int i = 0; i < THREADS; i++) {
        printf("  packed[%d] 주소: %p", i, (void *)&packed[i]);
        if (i > 0) {
            printf("  (앞과의 거리: %ld바이트)",
                   (long)((char *)&packed[i] - (char *)&packed[i - 1]));
        }
        printf("\n");
    }
    printf("  -> 8바이트 간격. 캐시 라인 %d바이트 안에 %d개가 다 들어갑니다!\n\n",
           CACHE_LINE, CACHE_LINE / (int)sizeof(long));

    for (int i = 0; i < 2; i++) {
        printf("  padded[%d].value 주소: %p", i, (void *)&padded[i].value);
        if (i > 0) {
            printf("  (앞과의 거리: %ld바이트)",
                   (long)((char *)&padded[i].value - (char *)&padded[i-1].value));
        }
        printf("\n");
    }
    printf("  -> %d바이트 간격. 각자 다른 캐시 라인에 삽니다.\n\n", CACHE_LINE);

    printf("측정 (같은 계산, 배치만 다름):\n");

    double packed_ms = run(packed_worker);
    printf("  [A] 붙여놓기 (거짓 공유) : %8.0f ms\n", packed_ms);

    double padded_ms = run(padded_worker);
    printf("  [B] 패딩으로 분리        : %8.0f ms\n", padded_ms);

    double local_ms = run(local_worker);
    printf("  [C] 지역 변수에 누적     : %8.0f ms\n", local_ms);

    printf("\n  B는 A보다 %.1f배 빠릅니다.\n",
           packed_ms / (padded_ms > 0 ? padded_ms : 1));
    printf("  C는 A보다 %.1f배 빠릅니다.\n",
           packed_ms / (local_ms > 0 ? local_ms : 1));

    printf("\n=== 무슨 일이 일어났나 ===\n");
    printf("[A] 네 카운터가 한 캐시 라인(64바이트)에 함께 있습니다.\n");
    printf("    코어1이 packed[0]을 쓰면 그 라인이 '수정됨' 상태가 되고,\n");
    printf("    다른 코어들이 가진 사본이 전부 무효화됩니다.\n");
    printf("    코어2가 packed[1]을 쓰려면 라인을 다시 가져와야 하죠.\n");
    printf("    논리적으로는 남남인데 하드웨어는 같은 덩어리로 봅니다.\n");
    printf("    -> 캐시 라인을 서로 뺏고 뺏기는 '핑퐁' 현상\n\n");
    printf("[B] 패딩으로 각자 다른 라인에 두면 핑퐁이 사라집니다.\n");
    printf("    메모리는 %d배 쓰지만 속도는 훨씬 빠릅니다.\n",
           (int)(sizeof(PaddedCounter) / sizeof(long)));
    printf("    (공간을 내주고 시간을 사는 전형적인 거래)\n\n");
    printf("[C] 가장 좋은 방법: 공유 메모리를 아예 안 건드리기.\n");
    printf("    지역 변수는 레지스터나 각자의 스택에 있어 충돌이 없습니다.\n");
    printf("    '지역에서 계산하고 마지막에 한 번 합친다' - 병렬 프로그래밍의\n");
    printf("    제1원칙입니다.\n");

    printf("\n=== 실전에서 조심할 곳 ===\n");
    printf("1. 스레드별 통계 배열: stats[thread_id]++ <- 전형적인 거짓 공유\n");
    printf("2. 구조체 배열의 인접 필드를 여러 스레드가 나눠 쓸 때\n");
    printf("3. 락 여러 개를 배열에 나란히 둘 때 (19주차 락 분할!)\n");
    printf("   -> 락 배열에도 패딩이 필요합니다\n");
    printf("4. 생산자-소비자 큐의 head/tail 인덱스\n");
    printf("   -> 생산자는 tail을, 소비자는 head를 고치는데 붙어 있으면 충돌\n");

    printf("\n=== 확인하는 방법 ===\n");
    printf("  $ getconf LEVEL1_DCACHE_LINESIZE   # 내 CPU의 캐시 라인 크기\n");
    printf("  $ perf stat -e cache-misses ./프로그램\n");
    printf("  $ perf c2c record ./프로그램        # 거짓 공유 전용 분석!\n");
    printf("(23주차 성능 최적화에서 perf를 본격적으로 다룹니다)\n");
    return 0;
}

거짓 공유
그림은 글을 쓴 뒤 다시 돌린 결과입니다. 벤치마크라서 본문 표와 수치가 몇 % 다릅니다. 배속과 순서가 같은지를 보세요 — 절대값이 아니라 그게 이 측정이 말하려는 것입니다.
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/false_sharing.c -o build/false_sharing -pthread
$ ./build/false_sharing
=== 거짓 공유(false sharing) 실험 ===
스레드 4개가 '각자 다른 변수'를 30000000번 증가시킵니다.
공유 자원이 없으니 락도 없고, 완벽히 병렬이어야 합니다.

메모리 배치 확인:
  packed[0] 주소: 0x5a699ffd7080
  packed[1] 주소: 0x5a699ffd7088  (앞과의 거리: 8바이트)
  packed[2] 주소: 0x5a699ffd7090  (앞과의 거리: 8바이트)
  packed[3] 주소: 0x5a699ffd7098  (앞과의 거리: 8바이트)
  -> 8바이트 간격. 캐시 라인 64바이트 안에 8개가 다 들어갑니다!

  padded[0].value 주소: 0x5a699ffd70c0
  padded[1].value 주소: 0x5a699ffd7100  (앞과의 거리: 64바이트)
  -> 64바이트 간격. 각자 다른 캐시 라인에 삽니다.

측정 (같은 계산, 배치만 다름):
  [A] 붙여놓기 (거짓 공유) :     1196 ms
  [B] 패딩으로 분리        :       25 ms
  [C] 지역 변수에 누적     :       17 ms

  B는 A보다 47.6배 빠릅니다.
  C는 A보다 70.5배 빠릅니다.
...
47.6배. 같은 계산인데 메모리 배치만 바꿔서 이만큼 빨라졌습니다. 이번 주에서 가장 놀라운 숫자입니다.
주소부터 읽어 봅시다. packed[0] 부터 packed[3] 까지는 0x...080, 088, 090, 098 로 8바이트씩 붙어 있습니다. 6주차에서 배운 대로 long 배열이니 당연합니다. 이 넷은 0x...080 부터 0x...0bf 까지의 64바이트 한 덩어리 안에 있습니다. 반면 padded[0].value 는 0x...0c0, padded[1].value 는 0x...100 으로 정확히 64바이트 떨어져 있고, 둘 다 64로 나누어떨어지는 주소입니다. 8주차의 정렬(alignment)이 여기서 쓰입니다.
8.2 무슨 일이 일어났나
CPU 는 메모리를 바이트 단위가 아니라 캐시 라인 단위로 다룹니다. 변수 하나(8바이트)만 읽어도 그 주변 64바이트를 통째로 캐시에 가져옵니다. 이 컴퓨터의 캐시 라인 크기를 확인해 봅시다.
$ getconf LEVEL1_DCACHE_LINESIZE
64
이제 packed[0] 부터 packed[3] 까지가 한 캐시 라인 안에 있을 때, 코어 넷이 각자 자기 칸을 올리면 어떻게 되는지 따라가 봅시다. 여러 코어가 같은 메모리를 캐시에 갖고 있을 때 일관성을 지키는 규칙이 있습니다. “한 코어가 쓰면 다른 코어의 사본은 전부 무효” 입니다.
코어1이 packed[0]을 쓴다
  -> 코어1의 캐시 라인이 '수정됨' 상태가 된다
  -> 코어2, 3, 4가 가진 같은 라인의 사본이 전부 무효화된다
코어2가 packed[1]을 쓰려 한다
  -> 내 사본이 무효화됐으니 라인을 다시 가져와야 한다
  -> 코어1에게서 넘겨받는다 (코어 사이의 통신, 수십 나노초)
  -> 이번엔 코어1의 사본이 무효화된다
코어1이 다시 packed[0]을 쓰려 한다
  -> 다시 코어2에게서 넘겨받는다
  -> ... 3천만 번 반복
논리적으로는 아무것도 공유하지 않는데, 하드웨어 수준에서는 캐시 라인 하나를 두고 네 코어가 싸우는 것입니다. 그래서 “거짓” 공유입니다. 코어 사이를 캐시 라인이 탁구공처럼 오간다고 해서 캐시 라인 핑퐁이라고도 부릅니다. 메모리 접근 하나가 레지스터 접근이 아니라 코어 간 통신이 되니, 수십 배 느려질 수밖에 없습니다.
6절에서 순수 스핀락이 짧은 임계 구역에서 느렸던 이유가 바로 이것이었습니다. 기다리는 스레드들이 같은 플래그를 두드리며 캐시 라인을 뺏고 뺏겼습니다.
8.3 두 가지 해법
① 패딩으로 분리하기
typedef struct {
    alignas(CACHE_LINE) long value;      /* C11의 정렬 지정 */
    char padding[CACHE_LINE - sizeof(long)];
} PaddedCounter;
alignas(64) 는 “이 구조체를 64의 배수 주소에 놓아라”(8주차), padding 은 구조체 크기를 64바이트로 채우는 빈칸입니다. 그러면 padded[i].value 마다 자기만의 캐시 라인을 갖습니다. 메모리를 8배 쓰지만 48배 빨라집니다. 공간을 내주고 시간을 사는 전형적인 거래입니다. alignas 는 <stdalign.h> 의 C11 표준이고, GCC 확장 __attribute__((aligned(64))) 도 같은 일을 합니다.
② 아예 공유 메모리를 안 건드리기 (더 좋음)
static void *local_worker(void *arg) {
    int id = ((Arg *)arg)->id;
    long local = 0;                      /* 레지스터/스택에 산다 */
    for (long i = 0; i < ITERATIONS; i++) {
        local++;
    }
    padded[id].value = local;
    return NULL;
}
3.2절의 그 원칙입니다. 지역에서 계산하고 마지막에 한 번 합친다. 70.5배로 가장 빠릅니다. 지역 변수는 각 스레드의 스택에 있고, 컴파일러가 아예 레지스터에 올려 둘 수도 있습니다. 애초에 메모리를 안 건드리니 캐시 경합이 있을 수 없습니다.
8.4 실전에서 조심할 곳
거짓 공유는 눈에 보이지 않기 때문에 위험합니다. 코드만 봐서는 아무 문제가 없어 보입니다. 락도 없고, 공유 변수도 없고, ThreadSanitizer 도 조용합니다. 그저 느릴 뿐입니다. 흔한 패턴을 알아 두세요.
- 스레드별 통계 배열:
stats[thread_id]++. 가장 전형적인 거짓 공유입니다. 프로젝트 3에서 이것을 피하는 코드를 봅니다. - 구조체 배열의 인접 필드를 여러 스레드가 나눠 쓸 때.
worker[0].count와worker[1].count는 한 줄에 있을 수 있습니다. - 락 배열: 19주차의 락 분할(striping)에서 락 16개를 배열에 나란히 두면, 서로 다른 락을 잡는 스레드들이 캐시 라인을 두고 싸웁니다. 락에도 패딩이 필요합니다.
- 큐의 head/tail 인덱스: 생산자는
tail을, 소비자는head를 고치는데, 4절의Queue구조체처럼 붙어 있으면 충돌합니다. 4절 예제는 성능이 목적이 아니라 그냥 두었지만, 초당 수백만 건을 처리하는 큐라면 둘을 다른 라인에 놓습니다.
8.5 확인하는 방법
getconf LEVEL1_DCACHE_LINESIZE     # 내 CPU의 캐시 라인 크기
perf stat -e cache-misses ./프로그램
perf c2c record ./프로그램          # 거짓 공유 전용 분석!
perf c2c(cache-to-cache)는 거짓 공유를 찾아내는 전용 도구입니다. 어느 캐시 라인이 코어 사이를 오가는지, 어느 코드 줄이 원인인지 알려 줍니다. 23주차 성능 최적화에서 perf 를 본격적으로 다룹니다.
9. 스레드 안전성: 이 함수를 동시에 불러도 되나
9.1 숨은 지뢰: 기존 함수들
스레드 프로그래밍의 함정은 내가 쓴 코드에만 있는 게 아닙니다. C 표준 라이브러리에 내부 정적 변수를 쓰는 함수들이 있습니다. 9주차 CSV 파서에서 쓴 strtok 이 대표입니다. strtok 은 “어디까지 잘랐는지”를 자기 안의 static 변수에 기억합니다. 그 변수는 프로그램에 하나뿐이니, 두 스레드가 동시에 strtok 을 부르면 서로의 진행 상황을 덮어씁니다.
strtok, asctime, ctime, localtime, gmtime, getpwnam, rand, ...
이런 함수를 여러 스레드에서 부르면 어떻게 되는지, 그리고 errno 는 왜 괜찮은지 봅니다.
examples/thread_safety.c:
/*
 * thread_safety.c - 스레드 안전성: 이 함수를 동시에 불러도 되나?
 * 20주차: 멀티스레딩과 병렬 프로그래밍
 *
 * 스레드 프로그래밍의 숨은 지뢰: '기존 함수들'입니다.
 * C 표준 라이브러리에는 내부에 정적 변수를 쓰는 함수들이 있습니다.
 * 여러 스레드가 동시에 부르면 서로의 상태를 망가뜨리죠.
 *
 *   strtok, asctime, ctime, localtime, gmtime, getpwnam, rand ...
 *
 * 이들의 스레드 안전 버전에는 보통 _r(reentrant) 접미사가 붙습니다:
 *   strtok -> strtok_r,  localtime -> localtime_r,  rand -> rand_r
 *
 * 그리고 errno! 전역 변수처럼 보이지만 사실 스레드마다 따로 있습니다.
 * (TLS - Thread Local Storage 덕분입니다. 이 예제에서 확인합니다)
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <pthread.h>
#include <errno.h>
#include <time.h>
#include <fcntl.h>

#define THREADS 4

/* ---------- 1. strtok의 함정 ---------- */
static void *unsafe_tokenize(void *arg) {
    int id = *(int *)arg;
    char input[64];
    snprintf(input, sizeof(input), "%d-a,%d-b,%d-c,%d-d", id, id, id, id);

    char result[128] = "";
    /* strtok은 '어디까지 잘랐는지'를 내부 정적 변수에 기억한다.
     * 여러 스레드가 동시에 부르면 그 상태를 서로 덮어쓴다! */
    char *token = strtok(input, ",");
    while (token != NULL) {
        strncat(result, token, sizeof(result) - strlen(result) - 1);
        strncat(result, " ", sizeof(result) - strlen(result) - 1);
        usleep(1000);                /* 다른 스레드가 끼어들 틈을 준다 */
        token = strtok(NULL, ",");
    }
    printf("  [스레드 %d] strtok  : %s\n", id, result);
    return NULL;
}

static void *safe_tokenize(void *arg) {
    int id = *(int *)arg;
    char input[64];
    snprintf(input, sizeof(input), "%d-a,%d-b,%d-c,%d-d", id, id, id, id);

    char result[128] = "";
    char *saveptr = NULL;            /* 상태를 '내가' 들고 있는다 */
    char *token = strtok_r(input, ",", &saveptr);
    while (token != NULL) {
        strncat(result, token, sizeof(result) - strlen(result) - 1);
        strncat(result, " ", sizeof(result) - strlen(result) - 1);
        usleep(1000);
        token = strtok_r(NULL, ",", &saveptr);
    }
    printf("  [스레드 %d] strtok_r: %s\n", id, result);
    return NULL;
}

/* ---------- 2. errno는 스레드마다 따로 ---------- */
static void *errno_test(void *arg) {
    int id = *(int *)arg;

    /* 일부러 실패시킨다 (스레드마다 다른 에러) */
    if (id % 2 == 0) {
        open("/no/such/file", O_RDONLY);          /* ENOENT (2) */
    } else {
        open("/etc/shadow", O_RDONLY);            /* EACCES (13) */
    }

    usleep(20000);                   /* 다른 스레드가 errno를 바꿀 시간 */

    printf("  [스레드 %d] errno = %d (%s)  주소: %p\n",
           id, errno, strerror(errno), (void *)&errno);
    return NULL;
}

/* ---------- 3. TLS: 스레드마다 자기 변수 ---------- */
static __thread int tls_counter = 0;         /* GCC/C11 스레드 지역 저장소 */
static int           shared_counter = 0;     /* 비교용 전역 */

static void *tls_test(void *arg) {
    int id = *(int *)arg;
    for (int i = 0; i < 1000; i++) {
        tls_counter++;               /* 내 것만 올라간다 */
        shared_counter++;            /* 모두가 공유 (경쟁 조건!) */
    }
    printf("  [스레드 %d] tls_counter=%d (내 것), 주소 %p\n",
           id, tls_counter, (void *)&tls_counter);
    return NULL;
}

/* ---------- 4. 시각 함수 ---------- */
static void *time_test(void *arg) {
    int id = *(int *)arg;
    time_t now = time(NULL) - id * 86400;        /* 스레드마다 다른 날짜 */

    /* localtime은 내부 정적 struct tm을 반환한다 - 공유! */
    struct tm  safe_tm;
    localtime_r(&now, &safe_tm);                 /* 내 버퍼에 받는다 */

    char buf[64];
    strftime(buf, sizeof(buf), "%Y-%m-%d %H:%M", &safe_tm);
    printf("  [스레드 %d] localtime_r: %s\n", id, buf);
    return NULL;
}

static void run_all(void *(*fn)(void *)) {
    pthread_t th[THREADS];
    int ids[THREADS];
    for (int i = 0; i < THREADS; i++) {
        ids[i] = i + 1;
        pthread_create(&th[i], NULL, fn, &ids[i]);
    }
    for (int i = 0; i < THREADS; i++) pthread_join(th[i], NULL);
}

int main(void) {
    printf("=== 1. strtok: 스레드 안전하지 않은 고전 ===\n");
    printf("각 스레드가 자기 문자열을 자릅니다. 결과가 섞이나요?\n");
    run_all(unsafe_tokenize);
    printf("  -> 숫자가 섞여 나왔다면 strtok의 내부 상태가 덮어써진 것입니다.\n");
    printf("     (운이 좋으면 멀쩡해 보이지만, 그게 더 위험합니다)\n\n");

    printf("=== 2. strtok_r: 상태를 내가 들고 있기 ===\n");
    run_all(safe_tokenize);
    printf("  -> saveptr를 각자 가지므로 절대 섞이지 않습니다.\n\n");

    printf("=== 3. errno는 전역이 아니다 ===\n");
    run_all(errno_test);
    printf("  -> 주소가 스레드마다 다릅니다!\n");
    printf("     errno는 매크로이고 실제로는 스레드별 저장소를 가리킵니다.\n");
    printf("     (#define errno (*__errno_location()))\n");
    printf("     그래서 스레드 A의 실패가 스레드 B의 errno를 망치지 않습니다.\n\n");

    printf("=== 4. TLS: 스레드마다 자기 변수 ===\n");
    shared_counter = 0;
    run_all(tls_test);
    printf("  공유 카운터: %d (기대 %d) %s\n", shared_counter, THREADS * 1000,
           shared_counter == THREADS * 1000 ? "" : "<- 경쟁 조건!");
    printf("  -> __thread 변수는 스레드마다 사본이 생깁니다 (주소가 다르죠).\n");
    printf("     락 없이 안전하지만, 스레드 간 공유는 당연히 불가능합니다.\n");
    printf("     용도: 스레드별 버퍼, 캐시, 통계, 랜덤 시드\n\n");

    printf("=== 5. 시각 함수도 _r 버전으로 ===\n");
    run_all(time_test);
    printf("  -> localtime은 내부 정적 struct tm을 반환합니다.\n");
    printf("     두 스레드가 동시에 부르면 서로의 결과를 덮어씁니다.\n\n");

    printf("=== 6. 스레드 안전성 세 단계 ===\n");
    printf("1. 스레드 안전(thread-safe)\n");
    printf("   여러 스레드가 동시에 불러도 올바르게 동작한다\n");
    printf("   (내부에 락이 있거나, 공유 상태가 없거나)\n");
    printf("2. 재진입 가능(reentrant)\n");
    printf("   실행 도중 다시 불려도 안전하다 (시그널 핸들러에서도!)\n");
    printf("   더 강한 조건입니다 - 락조차 쓰면 안 됩니다(교착 위험)\n");
    printf("3. 둘 다 아님\n");
    printf("   strtok, localtime, asctime, getpwnam, rand ...\n\n");

    printf("=== 7. 함수가 안전한지 확인하는 법 ===\n");
    printf("  $ man 3 strtok     # ATTRIBUTES 절을 보세요!\n");
    printf("    MT-Safe    : 스레드 안전\n");
    printf("    MT-Unsafe  : 위험 (이유도 적혀 있습니다)\n");
    printf("  $ man 7 attributes # 표기법 설명\n\n");
    printf("직접 만든 함수라면 이 질문을 하세요:\n");
    printf("  - static 변수를 쓰는가?\n");
    printf("  - 전역 변수를 고치는가?\n");
    printf("  - 내부 버퍼의 포인터를 반환하는가?\n");
    printf("셋 중 하나라도 '예'라면 스레드 안전하지 않습니다.\n");
    return 0;
}
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/thread_safety.c -o build/thread_safety -pthread
$ ./build/thread_safety
=== 1. strtok: 스레드 안전하지 않은 고전 ===
각 스레드가 자기 문자열을 자릅니다. 결과가 섞이나요?
  [스레드 4] strtok  : 4-a
  [스레드 1] strtok  : 1-a 4-b
  [스레드 2] strtok  : 2-a 4-c
  [스레드 3] strtok  : 3-a 4-d
  -> 숫자가 섞여 나왔다면 strtok의 내부 상태가 덮어써진 것입니다.
     (운이 좋으면 멀쩡해 보이지만, 그게 더 위험합니다)

=== 2. strtok_r: 상태를 내가 들고 있기 ===
  [스레드 1] strtok_r: 1-a 1-b 1-c 1-d
  [스레드 3] strtok_r: 3-a 3-b 3-c 3-d
  [스레드 2] strtok_r: 2-a 2-b 2-c 2-d
  [스레드 4] strtok_r: 4-a 4-b 4-c 4-d
  -> saveptr를 각자 가지므로 절대 섞이지 않습니다.

=== 3. errno는 전역이 아니다 ===
  [스레드 1] errno = 13 (Permission denied)  주소: 0x7603df9ff640
  [스레드 4] errno = 2 (No such file or directory)  주소: 0x7603de1fc640
  [스레드 3] errno = 13 (Permission denied)  주소: 0x7603de9fd640
  [스레드 2] errno = 2 (No such file or directory)  주소: 0x7603df1fe640
  -> 주소가 스레드마다 다릅니다!
...
=== 4. TLS: 스레드마다 자기 변수 ===
  [스레드 1] tls_counter=1000 (내 것), 주소 0x7603de1fc6bc
  [스레드 2] tls_counter=1000 (내 것), 주소 0x7603de9fd6bc
  [스레드 3] tls_counter=1000 (내 것), 주소 0x7603df1fe6bc
  [스레드 4] tls_counter=1000 (내 것), 주소 0x7603df9ff6bc
  공유 카운터: 4000 (기대 4000)
...
=== 5. 시각 함수도 _r 버전으로 ===
  [스레드 1] localtime_r: 2026-09-28 02:14
  [스레드 2] localtime_r: 2026-09-27 02:14
  [스레드 3] localtime_r: 2026-09-26 02:14
  [스레드 4] localtime_r: 2026-09-25 02:14
...
스레드 1의 결과가 1-a 4-b 입니다. 자기 문자열 1-a,1-b,1-c,1-d 를 자르고 있었는데, 두 번째 토큰부터 스레드 4의 것을 받아 왔습니다. 스레드 2, 3도 마찬가지입니다. 무슨 일이 일어났는지 그려 봅시다.
strtok 내부의 static 변수 = "다음에 자를 위치"

스레드 1: strtok("1-a,1-b,...")  -> 위치 = 스레드 1의 문자열 안
스레드 4: strtok("4-a,4-b,...")  -> 위치 = 스레드 4의 문자열 안 (덮어씀!)
스레드 1: strtok(NULL)           -> "다음 위치"를 봤더니 스레드 4의 문자열 -> 4-b
usleep(1000) 은 이 끼어들기가 잘 일어나도록 틈을 준 것입니다. 실전에서는 usleep 없이도 수만 번에 한 번 일어나고, 그때 재현이 안 됩니다. Valgrind 로 이 프로그램을 돌리면 스레드 2가 다른 스레드의 스택을 읽었다는 Invalid read 경고가 나옵니다. 스레드 4의 문자열은 스레드 4의 스택에 있는데, 스레드 4가 먼저 끝나 버리면 그 스택은 사라진 뒤이기 때문입니다.
4번의 공유 카운터가 4000으로 정확한 것은 우연입니다. 반복이 1000번뿐이라 스레드들이 겹칠 틈이 거의 없었습니다. 3.3절에서 배운 대로 “정확하게 나왔다”는 “안전하다”의 증거가 아닙니다.
9.2 _r 접미사: 상태를 내가 들고 있기
해법은 상태를 함수 안이 아니라 호출자가 관리하는 것입니다.
    char *saveptr = NULL;            /* 상태를 '내가' 들고 있는다 */
    char *token = strtok_r(input, ",", &saveptr);
    while (token != NULL) {
        ...
        token = strtok_r(NULL, ",", &saveptr);
    }
strtok_r 은 “다음에 자를 위치”를 자기 안에 두지 않고, 세 번째 인자로 받은 saveptr 에 저장합니다. saveptr 은 지역 변수이므로 스레드마다 자기 것입니다. 절대 섞이지 않습니다.
_r 은 reentrant(재진입 가능) 의 약자입니다. 주요 변환표를 알아 두세요.
| 위험 | 안전 | 상태를 어디에 |
|---|---|---|
strtok |
strtok_r |
saveptr 인자 |
localtime / gmtime |
localtime_r / gmtime_r |
호출자가 준 struct tm |
ctime / asctime |
ctime_r / asctime_r |
호출자가 준 문자 배열 |
rand |
rand_r |
호출자가 준 시드 변수 |
getpwnam / getgrnam |
getpwnam_r / getgrnam_r |
호출자가 준 구조체와 버퍼 |
readdir |
(버전 관계없이) 디렉터리마다 DIR * 를 따로 열기 |
18주차 참고 |
공통점이 보이나요? 전부 “결과를 담을 곳을 호출자가 준다” 입니다. 5절의 rwlock.c 가 rand() 대신 시드 변수를 직접 굴린 이유가 이것입니다.
9.3 errno 의 정체
이 예제의 가장 흥미로운 발견입니다.
[스레드 1] errno = 13  주소: 0x7603df9ff640
[스레드 2] errno = 2   주소: 0x7603df1fe640
errno 의 주소가 스레드마다 다릅니다! 18주차에서 errno 를 전역 변수처럼 썼는데, 전역 변수라면 주소가 하나여야 합니다. 그리고 스레드 1이 EACCES(13) 를 받은 뒤 20ms 동안 다른 스레드들이 ENOENT(2) 를 만들었는데도, 스레드 1의 errno 는 13 그대로입니다.
errno 는 사실 매크로입니다.
#define errno (*__errno_location())
__errno_location() 이 지금 이 스레드의 errno 가 있는 주소를 돌려주고, 그 앞의 * 가 그 자리를 변수처럼 쓰게 해 줍니다. 그래서 errno = 0 이나 if (errno == EAGAIN) 처럼 변수처럼 쓸 수 있으면서도, 스레드마다 다른 곳을 가리킵니다.
이것이 없었다면 멀티스레드 프로그램에서 에러 처리가 불가능했을 겁니다. 18주차에서 “errno 를 즉시 저장하라”고 했던 규칙은 같은 스레드 안에서 다음 호출이 덮어쓰는 것을 막기 위한 것이고, 스레드 사이에는 애초에 분리되어 있습니다.
9.4 TLS: 스레드마다 자기 변수
errno 가 쓰는 기법을 우리도 쓸 수 있습니다. 스레드 지역 저장소(Thread Local Storage, TLS) 입니다.
static __thread int tls_counter = 0; /* 스레드 지역 저장소 */
__thread 를 붙이면 스레드마다 사본이 생깁니다. 출력에서 네 스레드의 tls_counter 가 전부 1000이고 주소가 전부 다른 것을 확인할 수 있습니다. 같은 이름, 같은 코드인데 스레드마다 다른 변수입니다. 주소 끝이 ...6bc 로 같고 앞자리만 다른 것도 보세요. 각 스레드의 저장소 안에서 같은 위치에 있고, 저장소 자체가 스레드마다 다릅니다. errno 주소(...640)와 같은 저장소 안에 있습니다.
- 락 없이 안전합니다. 애초에 공유가 아니니까요.
- 대신 스레드 간 공유는 당연히 불가능합니다.
- 용도: 스레드별 버퍼, 캐시, 통계, 난수 시드, 현재 처리 중인 요청 정보
C11 표준 철자는 _Thread_local 이고, <threads.h> 를 포함하면 thread_local 로 쓸 수 있습니다. GCC 와 Clang 에서는 __thread 가 오래전부터 지원됐고 실무 코드에서 더 흔히 보입니다. 10절의 스레드 풀이 __thread int my_slot 으로 “내 번호”를 기억하는 데 씁니다.
동적으로 관리하려면 pthread_key_create / pthread_setspecific 을 씁니다. 스레드가 끝날 때 부를 정리 함수를 등록할 수 있어, 스레드별로 malloc 한 버퍼를 자동으로 free 할 때 유용합니다.
9.5 세 단계의 안전성
용어를 정확히 구분해 둡시다.
① 스레드 안전(thread-safe): 여러 스레드가 동시에 불러도 올바르게 동작한다. 내부에 락이 있거나(printf 가 그렇습니다), 공유 상태가 없거나(strlen).
② 재진입 가능(reentrant): 실행 도중 같은 스레드에서 다시 불려도 안전하다. 18주차의 시그널 핸들러가 이 경우입니다. printf 를 실행하다가 시그널이 와서 핸들러가 또 printf 를 부르면? 첫 번째 printf 가 잡은 락을 두 번째가 또 잡으려다 3.6절의 자기 교착이 됩니다. 그래서 재진입 가능하려면 락조차 쓰면 안 됩니다. 더 강한 조건입니다.
③ 둘 다 아님: strtok, localtime, asctime, getpwnam, rand…
내부에 뮤텍스가 있는 함수는 스레드 안전하지만 재진입 가능하지는 않습니다. 18주차의 async-signal-safe 가 바로 이 재진입성을 요구하는 것이었습니다.
9.6 확인하는 법
어떤 함수가 안전한지 외울 필요는 없습니다. 1주차에서 배운 man 페이지에 적혀 있습니다.
$ man 3 strtok
ATTRIBUTES 절을 찾으세요. 함수마다 Thread safety 항목에 MT-Safe 또는 MT-Unsafe 가 적혀 있고, MT-Unsafe 뒤에는 이유가 race:strtok 같은 식으로 붙습니다. man 7 attributes 에 표기법 설명이 있습니다. 1주차 3절에서 설치한 manpages-dev 가 없으면 man 3 이 안 나오니 확인하세요.
직접 만든 함수라면 이 세 질문을 하세요.
static변수를 쓰는가?- 전역 변수를 고치는가?
- 내부 버퍼의 포인터를 반환하는가?
셋 중 하나라도 “예”라면 스레드 안전하지 않습니다. 4주차와 9주차에서 만든 함수들을 이 기준으로 다시 훑어 보면 좋은 연습이 됩니다.
10. 실습 프로젝트
지금까지 배운 부품으로 실전 구조 세 개를 만듭니다. 전부 make 로 빌드되어 있습니다.
$ cd week20
$ make
$ ./build/thread_pool      # 또는 parallel_sort, parallel_grep
프로젝트 소스는 각각 300줄 안팎이라 핵심 부분만 싣습니다. 여기 실린 코드는 projects/ 의 실제 파일에서 그대로 가져온 것입니다.
프로젝트 1: 스레드 풀 (thread_pool.c)
“요청이 올 때마다 스레드를 만들면 되지 않나요?” 2절에서 스레드 생성이 약 23us 라는 것을 봤고, 1.5절에서 3만 개쯤에서 더 못 만든다는 것도 봤습니다. 작업 하나가 50us 라면 생성 비용이 작업의 절반이고, 1초에 10만 요청이면 CPU 하나를 생성에만 씁니다.
스레드 풀(thread pool) 이 답입니다. 스레드 N 개를 미리 만들어 두고, 작업이 오면 큐에 넣고, 놀고 있는 스레드가 가져가 처리하고, 끝나면 죽지 않고 다시 큐를 기다립니다. 웹 서버, DB 커넥션 처리, 이미지 변환 배치가 전부 이 구조입니다. 19주차의 워커 풀과 구조가 같은데, 프로세스와 파이프 대신 스레드와 조건 변수를 씁니다.
자료구조
/* ---------- 작업 하나 ---------- */
typedef struct {
    void (*function)(void *);
    void *argument;
} Task;

/* ---------- 스레드 풀 ---------- */
typedef struct {
    pthread_mutex_t lock;
    pthread_cond_t  work_ready;      /* "할 일이 생겼다" */
    pthread_cond_t  all_idle;        /* "전부 놀고 있다" (대기용) */

    Task   queue[QUEUE_CAP];
    int    head, tail, count;

    pthread_t threads[MAX_THREADS];
    int    thread_count;
    int    working;                  /* 지금 일하는 중인 스레드 수 */
    int    shutdown;                 /* 종료 신호 */

    long   completed;                /* 통계 */
    long   per_thread[MAX_THREADS];
} ThreadPool;
스레드 풀
Task 는 “무슨 함수를 어떤 인자로 부를 것인가”입니다. 7주차의 함수 포인터가 여기서 작업을 표현하는 수단이 됩니다. pthread_create 가 함수와 인자를 받았던 것과 같은 모양입니다. queue 는 4절과 같은 원형 큐이고, 뮤텍스 하나와 조건 변수 둘이 붙어 있는 것도 같습니다.
워커 스레드의 본체
static void *worker_main(void *arg) {
    ThreadPool *pool = arg;

    /* 내 슬롯 번호 찾기 (통계용) */
    pthread_mutex_lock(&pool->lock);
    for (int i = 0; i < pool->thread_count; i++) {
        if (pthread_equal(pool->threads[i], pthread_self())) { my_slot = i; break; }
    }
    pthread_mutex_unlock(&pool->lock);

    for (;;) {
        pthread_mutex_lock(&pool->lock);

        /* 할 일이 없으면 잔다 (while! 가짜 깨어남 대비) */
        while (pool->count == 0 && !pool->shutdown) {
            pthread_cond_wait(&pool->work_ready, &pool->lock);
        }

        if (pool->shutdown && pool->count == 0) {
            pthread_mutex_unlock(&pool->lock);
            break;                   /* 종료 */
        }

        /* 큐에서 하나 꺼낸다 */
        Task task = pool->queue[pool->head];
        pool->head = (pool->head + 1) % QUEUE_CAP;
        pool->count--;
        pool->working++;

        pthread_mutex_unlock(&pool->lock);   /* 작업은 락 밖에서! */

        task.function(task.argument);        /* 실제 일 */

        pthread_mutex_lock(&pool->lock);
        pool->working--;
        pool->completed++;
        if (my_slot >= 0) pool->per_thread[my_slot]++;

        if (pool->working == 0 && pool->count == 0) {
            pthread_cond_broadcast(&pool->all_idle);   /* "다 끝났다" */
        }
        pthread_mutex_unlock(&pool->lock);
    }
    return NULL;
}
한 바퀴를 따라가 봅시다.
- 락을 잡고, 큐가 비어 있고 종료 신호도 없으면
work_ready에서 잠듭니다. 4.4절의while세트 그대로입니다. - 깨어나서 종료 신호가 있고 큐도 비었으면 락을 풀고 나갑니다.
pool_destroy가 이 길로 스레드를 끝냅니다. - 큐에서 작업 하나를 복사해서 꺼내고(
Task task = ...),working을 올립니다. - 락을 풉니다. 그리고 나서 작업을 실행합니다.
- 다시 락을 잡고 통계를 갱신합니다. 일하는 스레드가 없고 큐도 비었으면, 기다리는 사람들(
pool_wait)에게all_idle로 알립니다.
my_slot 은 9.4절의 __thread 변수입니다. 스레드마다 “내가 몇 번 스레드인가”를 기억하는 데 TLS 를 씁니다. pthread_equal 은 두 pthread_t 가 같은 스레드인지 비교하는 함수입니다. 1.1절에서 pthread_t 가 사실 주소라고 했지만 표준은 그것을 보장하지 않으니 == 대신 이 함수를 씁니다.
작업 넣기, 기다리기, 끝내기
/* 작업 추가. 큐가 가득 차면 자리가 날 때까지 기다린다 */
static int pool_submit(ThreadPool *pool, void (*fn)(void *), void *arg) {
    pthread_mutex_lock(&pool->lock);

    if (pool->shutdown) {
        pthread_mutex_unlock(&pool->lock);
        return 0;
    }
    while (pool->count == QUEUE_CAP) {
        /* 큐가 가득: 누군가 꺼내갈 때까지 기다린다 (역압, backpressure) */
        pthread_cond_wait(&pool->all_idle, &pool->lock);
    }

    pool->queue[pool->tail].function = fn;
    pool->queue[pool->tail].argument = arg;
    pool->tail = (pool->tail + 1) % QUEUE_CAP;
    pool->count++;

    pthread_cond_signal(&pool->work_ready);      /* 자는 워커 하나 깨우기 */
    pthread_mutex_unlock(&pool->lock);
    return 1;
}

/* 큐가 빌 때까지 기다린다 (종료하지는 않는다) */
static void pool_wait(ThreadPool *pool) {
    pthread_mutex_lock(&pool->lock);
    while (pool->count > 0 || pool->working > 0) {
        pthread_cond_wait(&pool->all_idle, &pool->lock);
    }
    pthread_mutex_unlock(&pool->lock);
}

static void pool_destroy(ThreadPool *pool) {
    pthread_mutex_lock(&pool->lock);
    pool->shutdown = 1;
    pthread_cond_broadcast(&pool->work_ready);   /* 자는 워커 전부 깨우기 */
    pthread_mutex_unlock(&pool->lock);

    for (int i = 0; i < pool->thread_count; i++) {
        pthread_join(pool->threads[i], NULL);
    }
    pthread_mutex_destroy(&pool->lock);
    pthread_cond_destroy(&pool->work_ready);
    pthread_cond_destroy(&pool->all_idle);
}
pool_submit 은 작업 하나를 넣었으니 워커 하나만 signal 로 깨웁니다. pool_destroy 는 모든 워커를 끝내야 하니 broadcast 입니다. 4.5절의 규칙이 그대로 적용됩니다.
실행 결과입니다. 작업은 “이 구간에 소수가 몇 개인가”를 세는 계산 48개입니다.
$ ./build/thread_pool
╔══════════════════════════════════════════════╗
║              스레드 풀 (20주차)              ║
╚══════════════════════════════════════════════╝
워커 스레드 4개 | 큐 용량 64 | 이 시스템 코어 12개

=== 1. 순차 처리 ===
  작업 48개, 소수 142027개, 326 ms

=== 2. 스레드 풀로 처리 ===
  스레드 4개 생성 (이제 죽지 않고 작업을 기다립니다)
  작업 48개, 소수 142027개, 92 ms
  검증: 일치!
  가속비: 3.52배 (스레드 4개)

  스레드별 처리 작업 수:
    스레드 1:  15개 ###############
    스레드 2:  12개 ############
    스레드 3:  11개 ###########
    스레드 4:  10개 ##########

=== 3. 같은 풀로 두 번째 배치 ===
  (스레드를 새로 만들지 않습니다 - 이것이 풀의 핵심!)
  두 번째 배치: 93 ms (총 처리 96건)
...
스레드 4개로 3.52배, 88% 효율입니다. 스레드마다 처리한 작업 수가 15, 12, 11, 10 으로 고르지 않은 것은 작업 크기가 제각각이기 때문입니다(4개마다 하나가 3배 큽니다). 큐 방식의 장점이 여기 보입니다. 먼저 끝난 스레드가 다음 작업을 가져가니 알아서 균형이 맞습니다. 작업을 미리 4등분해서 나눠 줬다면 큰 작업을 맡은 스레드가 끝날 때까지 나머지가 놀았을 겁니다.
① 작업은 반드시 락 밖에서
이 프로젝트에서 가장 중요한 설계입니다.
        /* 큐에서 하나 꺼낸다 */
        Task task = pool->queue[pool->head];
        ...
        pthread_mutex_unlock(&pool->lock);   /* 작업은 락 밖에서! */

        task.function(task.argument);        /* 실제 일 */
락을 쥔 채로 작업하면 어떻게 될까요? 스레드가 4개여도 한 번에 하나만 일하게 됩니다. 병렬화가 완전히 무의미해집니다. 이 실수는 의외로 흔합니다. “락을 잡고 안전하게 처리하자”는 선의가 성능을 망칩니다. 락은 자료구조를 보호하는 것이지 작업을 보호하는 것이 아닙니다. 그래서 작업을 큐에서 복사해 꺼낸 뒤 락을 풀고, 그다음에 실행합니다.
② 역압(backpressure)
pool_submit 은 큐가 가득 차면 기다립니다. 무한정 쌓이게 두면 메모리가 터지니까요. “생산자를 늦추는” 이 설계가 안정성의 핵심입니다. 19주차 파이프의 “버퍼가 차면 write 가 블록”과 같은 원리입니다. 실전 시스템에서 역압이 없으면, 부하가 몰릴 때 메모리를 다 쓰고 죽습니다.
다만 이 구현에는 개선할 점이 하나 있습니다. 큐가 가득 찼을 때 기다리는 조건 변수가 all_idle 인데, 이 신호는 큐가 완전히 비고 모든 워커가 놀 때만 옵니다. 그래서 큐가 가득 차면 다음 제출은 큐가 다 빌 때까지 기다립니다. 작업 200개를 넣어 보면 여전히 3.4배가 나오니 성능은 큰 문제가 없지만, 정석은 “자리 하나가 났다”를 알리는 not_full 조건 변수를 따로 두고 워커가 작업을 꺼낼 때마다 signal 하는 것입니다. 4절의 Queue 가 그렇게 했습니다. 연습 문제로 고쳐 보세요.
③ 종료는 broadcast 로
signal 이면 하나만 깨어나고 나머지는 영원히 잠듭니다. pthread_join 이 돌아오지 않아 프로그램이 종료되지 않습니다. 4.5절의 그 규칙입니다.
④ 19주차 워커 풀과 비교
| 19주차 (프로세스) | 20주차 (스레드) | |
|---|---|---|
| 작업 전달 | 파이프에 구조체 write | 큐에 포인터 저장 |
| 결과 수집 | 파이프에서 read | 공유 메모리 직접 |
| 대기 | select 로 다중화 |
조건 변수 |
| 작업 크기 | 구조체 복사 필요 | 포인터만 |
스레드 버전이 훨씬 단순합니다. read_exact 같은 함수도, fd 관리도 필요 없습니다. 메모리를 공유하니 전달이라는 개념 자체가 없습니다.
스레드 수는 몇 개가 좋은가
“코어가 12개니 12개가 제일 빠르겠지”가 맞을까요? 직접 재 봅시다.
$ for n in 1 2 4 6 8 12 16; do echo -n "$n: "; ./build/thread_pool $n | grep 가속비; done
1:   가속비: 1.00배 (스레드 1개)
2:   가속비: 1.97배 (스레드 2개)
4:   가속비: 3.55배 (스레드 4개)
6:   가속비: 4.38배 (스레드 6개)
8:   가속비: 4.10배 (스레드 8개)
12:   가속비: 5.11배 (스레드 12개)
16:   가속비: 4.67배 (스레드 16개)
2개까지는 거의 2배, 4개에서 3.55배, 그런데 12개에서 5.11배가 최고이고 16개는 오히려 떨어집니다. 왜 12배가 안 될까요? 이 문제를 더 단순한 실험으로 파 봅시다. 스레드 풀 없이, 4억 개의 숫자를 N 개 스레드가 나눠 더하는 프로그램입니다. psum.c:
#include <stdio.h>
#include <stdlib.h>
#include <pthread.h>
#include <time.h>

#define N 400000000L                     /* 4억 개 */

typedef struct { long from, to, sum; } Job;

static void *sum_range(void *arg) {
    Job *j = arg;
    long s = 0;
    for (long i = j->from; i < j->to; i++) s += i % 7;   /* 계산이 좀 있게 */
    j->sum = s;
    return NULL;
}

static double now_ms(void) {
    struct timespec t; clock_gettime(CLOCK_MONOTONIC, &t);
    return t.tv_sec * 1000.0 + t.tv_nsec / 1e6;
}

int main(int argc, char *argv[]) {
    int n = argc > 1 ? atoi(argv[1]) : 1;
    pthread_t th[64]; Job jobs[64];
    double t0 = now_ms();
    for (int i = 0; i < n; i++) {
        jobs[i].from = N / n * i;
        jobs[i].to   = (i == n - 1) ? N : N / n * (i + 1);
        pthread_create(&th[i], NULL, sum_range, &jobs[i]);
    }
    long total = 0;
    for (int i = 0; i < n; i++) { pthread_join(th[i], NULL); total += jobs[i].sum; }
    double ms = now_ms() - t0;
    printf("스레드 %2d개: %7.0f ms  (합 %ld)\n", n, ms, total);
    return 0;
}
3.2절의 원칙대로 각 스레드는 자기 sum 에만 쓰고, 메인이 마지막에 합칩니다. 락이 하나도 없습니다. 이보다 더 병렬화하기 좋은 문제는 없습니다.
$ nproc
12
$ gcc -Wall -Wextra -std=gnu11 -O2 psum.c -o psum -pthread
$ for n in 1 2 4 6 8 12 16 24; do ./psum $n; done
스레드  1개:     309 ms  (합 1199999997)
스레드  2개:     158 ms  (합 1199999997)
스레드  4개:      79 ms  (합 1199999997)
스레드  6개:      92 ms  (합 1199999997)
스레드  8개:      75 ms  (합 1199999997)
스레드 12개:      69 ms  (합 1199999997)
스레드 16개:      72 ms  (합 1199999997)
스레드 24개:      65 ms  (합 1199999997)
세 번 돌려도 같은 모양입니다.
| 스레드 | 시간 | 가속비 | 효율 |
|---|---|---|---|
| 1 | 309 ms | 1.0배 | 100% |
| 2 | 158 ms | 2.0배 | 98% |
| 4 | 79 ms | 3.9배 | 98% |
| 6 | 92 ms | 3.4배 | 56% |
| 8 | 75 ms | 4.1배 | 52% |
| 12 | 69 ms | 4.5배 | 37% |
| 24 | 65 ms | 4.8배 | 20% |
4개까지는 거의 완벽하게 4배인데, 그 뒤로는 거의 늘지 않습니다. nproc 이 12라고 했는데 왜 4~5배에서 멈출까요? 이 컴퓨터의 CPU 를 자세히 보면 답이 있습니다.
$ lscpu | grep -E "모델 이름|코어 당 스레드|소켓 당 코어"
모델 이름:                        AMD Ryzen 5 5600X 6-Core Processor
코어 당 스레드:                   2
소켓 당 코어 수:                  6
물리 코어는 6개이고, 코어마다 논리 CPU 가 2개씩 있어 nproc 이 12로 보이는 것입니다. 이것을 SMT(동시 멀티스레딩, 인텔 이름은 하이퍼스레딩)라고 합니다. 논리 CPU 두 개가 하나의 계산 장치를 나눠 씁니다. 한쪽이 메모리를 기다리는 동안 다른 쪽이 계산할 수 있어 I/O 가 섞인 작업에서는 이득이지만, 이 실험처럼 순수 계산이면 둘이 같은 장치를 두고 줄을 섭니다. 그래서 6개를 넘어가면 이득이 거의 없습니다.
그럼 6개에서는 6배가 나와야 하지 않을까요? 두 가지가 더 있습니다. 코어를 많이 쓸수록 CPU 가 발열 때문에 클럭을 낮춥니다(1개일 때 4.6GHz 까지 올라가던 것이 6개면 그보다 낮아집니다). 그리고 운영체제가 6개 스레드를 반드시 6개의 서로 다른 물리 코어에 놓아 주지는 않습니다. 6개 결과가 4개보다 느린 이유가 그것입니다. 두 스레드가 같은 물리 코어의 논리 CPU 둘에 배정되면 그 둘은 절반 속도로 돕니다.
이것이 “코어가 N 개니 N 배 빨라지겠지”는 거의 항상 틀리는 이유입니다.
- 논리 CPU 수와 물리 코어 수는 다릅니다.
- 코어를 많이 쓰면 클럭이 내려갑니다.
- 나눌 수 없는 순차 부분이 남습니다(프로젝트 2의 병합). 이 상한을 암달의 법칙이라고 합니다.
- 메모리 통로는 코어 수만큼 늘지 않습니다(프로젝트 2).
- 스레드가 코어보다 많아지면 문맥 전환 비용만 늘어납니다(6절 실험 2).
그래서 스레드 수의 정답은 이렇습니다.
| 작업 종류 | 스레드 수 | 이유 |
|---|---|---|
| 순수 계산 | 물리 코어 수 근처 | 그 이상은 줄 서기 |
| I/O 가 많음(파일, 네트워크) | 코어 수보다 훨씬 많게 | 기다리는 동안 남이 CPU 를 씀 |
| 혼합 | 측정해서 정하기 | 이번 주의 결론 |
확장 아이디어: 작업에 우선순위 추가(12주차의 힙), 결과를 받는 future 패턴, not_full 조건 변수로 역압 개선, 작업 훔치기(work stealing)
프로젝트 2: 병렬 정렬 (parallel_sort.c)
15주차의 병합 정렬을 여러 코어에 나눠 돌립니다. 병합 정렬은 병렬화의 교과서입니다.
왼쪽 절반과 오른쪽 절반은 완전히 독립적이다 → 동시에 정렬 가능!
그런데 순진하게 만들면 오히려 느려집니다. 재귀마다 스레드를 만들면 200만 개를 정렬할 때 스레드가 200만 개 생기고(1.5절에서 3만 개에서 막힌 것을 떠올리세요), 작은 구간까지 병렬화하면 관리 비용이 계산보다 비쌉니다. 해법은 깊이 제한과 임계 크기입니다.
#define SMALL_THRESHOLD 32       /* 이하면 삽입 정렬 */

static int max_depth;            /* 이 깊이까지만 스레드 생성 */
병렬 정렬
그림은 글을 쓴 뒤 다시 돌린 결과입니다. 벤치마크라서 본문 표와 수치가 몇 % 다릅니다. 배속과 순서가 같은지를 보세요 — 절대값이 아니라 그게 이 측정이 말하려는 것입니다.
static void merge_sort_par(int *a, int *tmp, int left, int right, int depth) {
    if (right - left + 1 <= SMALL_THRESHOLD) {
        insertion_sort(a + left, right - left + 1);
        return;
    }

    int mid = left + (right - left) / 2;

    if (depth >= max_depth) {
        /* 깊이 제한을 넘었으면 그냥 순차로 (스레드 폭발 방지!) */
        merge_sort_seq(a, tmp, left, mid);
        merge_sort_seq(a, tmp, mid + 1, right);
    } else {
        /* 왼쪽은 새 스레드에게, 오른쪽은 내가 (스레드 하나 절약) */
        SortArg left_arg = { a, tmp, left, mid, depth + 1 };
        pthread_t th;

        if (pthread_create(&th, NULL, sort_thread, &left_arg) == 0) {
            pthread_mutex_lock(&stat_lock);
            thread_count++;
            pthread_mutex_unlock(&stat_lock);

            merge_sort_par(a, tmp, mid + 1, right, depth + 1);   /* 내 몫 */
            pthread_join(th, NULL);
        } else {
            /* 스레드를 못 만들면 순차로 대체 (견고성!) */
            merge_sort_seq(a, tmp, left, mid);
            merge_sort_seq(a, tmp, mid + 1, right);
        }
    }

    merge(a, tmp, left, mid, right);      /* 병합은 순차 */
}
left_arg 는 지역 변수인데 스레드에 그 주소를 넘깁니다. 1.2절에서 위험하다고 한 패턴 아닌가요? 여기서는 안전합니다. 이 함수가 pthread_join 으로 그 스레드가 끝나기를 기다린 뒤에야 돌아가므로, 스레드가 left_arg 를 쓰는 동안 이 함수의 스택 칸이 살아 있습니다. 1.2절의 문제는 “만든 쪽이 먼저 사라지거나 값을 바꾸는 것”이었고, 여기서는 둘 다 일어나지 않습니다.
$ ./build/parallel_sort
╔══════════════════════════════════════════════╗
║           병렬 정렬 라이브러리 (20주차)      ║
╚══════════════════════════════════════════════╝
원소 2000000개 | 코어 12개

=== 1. 순차 병합 정렬 (15주차 그대로) ===
  194 ms | 정렬 OK | 체크섬 OK

=== 2. 표준 라이브러리 qsort ===
  303 ms | 정렬 OK

=== 3. 병렬 병합 정렬: 깊이 제한에 따라 ===
깊이     스레드수     시간  가속비     검증
------------------------------------------------------
       0          0      190 ms      1.02배         OK
       1          1      106 ms      1.84배         OK
       2          3       59 ms      3.29배         OK
       3          7       47 ms      4.15배         OK
       4         15       49 ms      4.01배         OK
       5         31       49 ms      4.00배         OK
...
① 깊이 제한이 왜 필요한가
깊이 d 까지만 스레드를 만들면 스레드는 2^d - 1 개입니다(깊이 1은 1개, 2는 3개, 3은 7개). 표에서 깊이 3(7개) 이후로 이득이 멈춥니다. 적정 깊이는 log2(물리 코어 수) 근처입니다. 6코어면 깊이 2~3 입니다.
② 왜 “왼쪽만 스레드”인가
pthread_create(왼쪽);
오른쪽은 내가 직접;      /* 새 스레드를 안 만든다 */
pthread_join(왼쪽);
양쪽 다 스레드를 만들면 나는 놀면서 기다리기만 합니다. 한쪽을 직접 처리하면 스레드 수가 절반으로 줄고 성능은 같거나 낫습니다. 병렬 재귀의 표준 기법입니다.
③ 가속비가 4배에서 멈추는 이유
물리 코어 6개인데 왜 4배일까요? 프로젝트 1의 이유에 두 가지가 더해집니다.
병합은 병렬화되지 않습니다. 최상위 병합은 배열 전체를 훑는 O(n) 작업이고 혼자 합니다. 그 아래 단계도 마찬가지입니다. 전체 작업의 상당 부분이 순차라 암달의 법칙에 걸립니다.
메모리 대역폭이 병목입니다. 정렬은 계산보다 “메모리 읽고 쓰기”가 많습니다. 코어를 늘려도 메모리로 가는 통로는 그대로라 어느 순간 포화됩니다. 프로젝트 1(소수 세기, 계산 위주)이 4스레드에서 88% 효율인데 정렬이 4배에서 멈추는 이유입니다. 계산 중심 작업은 잘 병렬화되고, 메모리 중심 작업은 덜 됩니다. 병렬화 대상을 고를 때 기억해 둘 기준입니다.
④ 우리 정렬이 qsort 보다 빠릅니다
순차 버전만으로도 194ms 대 303ms 입니다. 15주차에서 만든 인트로 정렬이 glibc 에 밀렸던 것과 대조적입니다. 여기서는 타입이 int 로 고정이라 함수 포인터 호출과 바이트 단위 복사가 없기 때문입니다. 10주차의 제네릭 정렬이 치르는 대가를 보여 주는 사례입니다.
확장 아이디어: 스레드 풀 재사용(프로젝트 1과 결합), 병렬 병합 구현, 퀵 정렬 병렬화 비교, 메모리 대역폭 측정
프로젝트 3: 멀티스레드 검색 엔진 (parallel_grep.c)
16주차의 grep 을 여러 코어에 나눠 돌립니다. 파일 검색은 병렬화의 좋은 사례입니다. 파일마다 독립적이라 공유 상태가 거의 없고, I/O 대기가 있어 코어 수보다 많은 스레드도 도움이 됩니다.
static atomic_int next_file = 0; /* 작업 분배: 원자적 인덱스 하나! */
/* 거짓 공유를 피하려고 스레드별 통계를 캐시 라인만큼 떼어 놓는다 (20주차!) */
typedef struct {
    long files;
    long matches;
    long bytes;
    char padding[64 - 3 * sizeof(long)];
} ThreadStat;

static ThreadStat stats[MAX_THREADS];
/* ---------- 워커 스레드 ---------- */
static void *worker(void *arg) {
    int slot = (int)(long)arg;

    for (;;) {
        /* 작업 분배: 원자적으로 다음 인덱스를 가져간다.
         * 뮤텍스도 큐도 필요 없다 - 이것이 가장 단순한 작업 분배! */
        int idx = atomic_fetch_add(&next_file, 1);
        if (idx >= file_count) break;

        search_file(file_list[idx], slot);
    }
    return NULL;
}
$ ./build/parallel_grep
╔══════════════════════════════════════════════╗
║        멀티스레드 검색 엔진 (20주차)         ║
╚══════════════════════════════════════════════╝
데모 모드: 테스트 파일을 만들어 검색합니다
(직접 검색: ./parallel_grep 패턴 디렉토리 [스레드수])

테스트 파일 생성 중... 완료 (파일 60개 x 8000줄)

패턴: "mutex" | 디렉토리: pgrep_demo | 코어 12개
검색 대상 파일: 60개

=== 스레드 수에 따른 성능 ===
스레드      시간  가속비   효율
----------------------------------------
       1개       43 ms      1.00배     100%
       2개       22 ms      1.92배      96%
       4개       12 ms      3.60배      90%
       8개        7 ms      6.24배      78%
      16개        7 ms      6.21배      39%

  파일 60개, 매치 91282줄, 26.5 MB 스캔
...
① 작업 분배가 원자적 정수 하나뿐
int idx = atomic_fetch_add(&next_file, 1);
큐도, 뮤텍스도, 조건 변수도 없습니다. 7절의 atomic_fetch_add 가 “더하기 전 값”을 돌려준다는 성질을 이용합니다. 스레드 넷이 동시에 불러도 0, 1, 2, 3 을 정확히 하나씩 받아 갑니다. 작업이 “배열의 인덱스”로 표현될 때 쓸 수 있는 가장 단순하고 빠른 분배 방식입니다. 19주차 워커 풀은 파이프로, 프로젝트 1은 큐와 조건 변수로 작업을 나눴습니다. 여기서는 정수 하나입니다. 문제에 맞는 가장 단순한 도구를 고르는 것, 그것이 설계입니다.
② 출력도 공유 자원이다
                pthread_mutex_lock(&print_lock);
                printf("  %s:%d: %.100s\n", path, lineno, line);
                pthread_mutex_unlock(&print_lock);
여러 스레드가 printf 를 하면 한 줄 안에서 섞일 수 있습니다. glibc 의 printf 는 9.5절에서 말한 대로 스레드 안전하지만(내부에 락이 있습니다), 그것은 printf 한 번의 원자성입니다. 한 줄을 여러 번의 printf 로 만들면 그 사이에 다른 스레드가 끼어듭니다. 이 예제는 한 번의 printf 로 한 줄을 완성하고, 그것을 다시 락으로 감쌌습니다.
③ 통계에 패딩
stats[slot].files++ 를 여러 스레드가 합니다. 8절에서 48배 차이를 봤으니 처음부터 padding 으로 64바이트를 채워 스레드마다 다른 캐시 라인에 놓았습니다.
④ 불변 데이터는 동기화가 필요 없다
16주차의 보이어-무어 나쁜 문자 표(16주차 예제에서는 last, 여기서는 bad_char)를 모든 스레드가 공유합니다. 그런데 락이 없습니다. 읽기만 하기 때문입니다. 검색을 시작하기 전에 한 번 채우고, 그 뒤로는 아무도 고치지 않는 데이터는 몇 개의 스레드가 봐도 안전합니다.
불변 데이터는 동기화가 필요 없다 — 병렬 설계의 황금률.
그래서 함수형 언어들이 병렬 처리에 강하고, 실무에서도 “가능한 한 불변으로 설계하라”는 조언이 나옵니다. 락을 잘 쓰는 것보다 락이 필요 없게 설계하는 것이 낫습니다.
⑤ 효율이 떨어지는 지점
8개에서 6.24배(78%), 16개에서도 6.21배(39%)입니다. 물리 코어 6개를 넘으니 당연합니다. 파일이 페이지 캐시에 올라와 있어 이 데모는 사실상 CPU 작업입니다. 진짜 디스크에서 읽는다면 한 스레드가 디스크를 기다리는 동안 다른 스레드가 CPU 를 쓸 수 있으니, 코어 수보다 많은 스레드가 더 도움이 됩니다. I/O 가 섞인 작업은 코어 수보다 많은 스레드가 낫다는 프로젝트 1의 표가 여기서 나옵니다.
확장 아이디어: 스레드 풀로 교체, 정규식 지원(16주차의 mini_regex), 결과를 파일 순서대로 정렬 출력, 큰 파일 하나를 여러 스레드가 나눠 읽기
11. 자주 하는 실수와 함정
이번 주에 직접 저질러 본 것들부터입니다.
1. 반복 변수의 주소를 스레드 인자로. (1.2절) 모든 스레드가 같은 주소를 보고, 전부 3을 읽었습니다. 배열이나 malloc 으로 각자 저장소를 주세요.
2. 지역 변수의 주소를 반환. (1.3절) 스레드가 끝나면 스택이 사라집니다. GCC 는 아예 NULL 을 돌려줬습니다. 힙에 담아 반환하세요.
3. pthread_create 의 반환값을 안 봄. (1.5절) EAGAIN 을 놓치면 만들어지지도 않은 스레드를 join 하게 됩니다. errno 가 아니라 반환값에 오류 번호가 옵니다.
4. 락 없이 공유 변수 수정. (3.1절) 값이 증발합니다. 실행마다 다르고, -O2 에서는 숨습니다. ThreadSanitizer 로 잡으세요.
5. unlock 누락. (3.6절) 다음 lock 에서 자기 자신을 기다리며 멈춥니다. 임계 구역에서 빠져나가는 모든 길에 unlock 이 있는지 확인하세요.
6. 락 순서가 제각각. (3.5절) 교착입니다. 순서를 정하고 모두가 지키세요.
7. 상태 변수 없이 조건 변수만 기다림. (4.3절) 신호가 먼저 오면 영원히 잠듭니다. while (!조건) wait 세트를 지키세요.
8. pthread_cond_wait 을 if 로 감쌈. (4.4절) 가짜 깨어남과 도둑맞은 알림 때문에 가끔 깨지는 코드가 됩니다.
9. 종료 시 signal 사용. (4.5절) 스레드 하나만 깨어나고 나머지는 영원히 잠듭니다. broadcast 를 쓰세요.
10. 락을 쥔 채로 작업. (10절) 스레드가 여러 개여도 하나씩 돌게 됩니다. 락은 자료구조 조작만 감싸세요.
11. 매번 락을 잡고 카운터 증가. (3.2절) 지역 변수에 모았다가 마지막에 한 번 합치면 70배 빨라집니다.
12. 스레드별 배열에 패딩 없음. (8절) 거짓 공유로 수십 배 손해입니다.
13. strtok, localtime 등을 스레드에서 사용. (9절) 결과가 섞입니다. _r 버전을 쓰세요.
14. join 도 detach 도 안 함. (1.4절) 스레드 자원이 누수됩니다. Valgrind 가 possibly lost 로 알려 줍니다.
15. main 이 먼저 끝남. (1.4절) 다른 스레드가 하던 일이 중간에 끊깁니다.
16. 스레드 수를 무작정 늘림. (10절) 물리 코어 수를 넘으면 늘지 않고, 더 넘으면 문맥 전환 비용만 늘어납니다. I/O 작업은 예외입니다.
17. 측정 없이 최적화. (5, 6, 7절) 스핀락이 느릴 수도, rwlock 이 손해일 수도, 원자적 연산이 겨우 5% 빠를 수도 있습니다. 이번 주가 그 증거입니다.
12. 연습 문제
기본 문제
- 병렬 합계: 10절의
psum.c를 고쳐, 각 스레드가 전역 변수에 락을 잡고 더하는 버전을 만드세요. 지역 변수에 모으는 원래 버전과 시간을 비교하고, 왜 그런지 3.2절로 설명해 보세요. - 스레드 안전 카운터: 뮤텍스 버전과 원자적 연산 버전을 만들고, 스레드 수를 1, 2, 4, 8, 16 으로 늘려 가며 시간을 재 표로 정리하세요. 스레드가 늘수록 둘 다 느려지는 이유는 무엇인가요? (8절 참고)
- 생산자-소비자 확장:
cond_var.c를 생산자 셋, 소비자 셋으로 확장하세요.queue_close의broadcast를signal로 바꾸면 무슨 일이 생기는지timeout 10으로 확인해 보세요. - 병렬 행렬 곱셈: N×N 행렬 곱을 행 단위로 스레드에 분배하세요. 가속비를 측정하고, 프로젝트 1과 2 중 어느 쪽에 가까운지 설명해 보세요.
- TLS 난수 생성기:
rand_r과__thread시드로 스레드마다 독립적인 난수를 만드세요. 그냥rand()를 쓰면 무엇이 문제인지 9절로 설명하세요.
심화 문제
- 거짓 공유 찾기: 일부러 거짓 공유가 있는 코드를 만들고
perf stat -e cache-misses로 패딩 전후를 비교해 보세요. - 스레드 풀 개선: 프로젝트 1에
not_full조건 변수를 추가해 큐가 가득 찼을 때 자리 하나가 나자마자 제출이 진행되게 하세요. 작업 200개를 넣어 전후를 비교하세요. - 스레드 풀에 우선순위: 프로젝트 1의 큐를 12주차의 최소 힙으로 바꿔 우선순위 작업 큐를 만드세요.
- 읽기-쓰기 락 직접 구현: 뮤텍스와 조건 변수만으로
rwlock을 만드세요. 쓰기 기아를 어떻게 막을까요? - ThreadSanitizer 실습: 이번 주 예제 중 하나에서 락을 하나 지우고
-fsanitize=thread로 빌드해 보세요. 보고서에서 변수 이름과 줄 번호를 찾아 원래대로 고치고, 다시 조용해지는지 확인하세요.
마치며
이번 주에 배운 것을 정리합니다.
- 스레드: 주소 공간을 공유하는 실행 흐름. 생성이 5배 싸고 통신이 공짜. 대신 모든 전역과 힙이 공유 자원이고, 하나가 죽으면 전부 죽는다
pthread_create: 번호표 받을 주소, 속성, 시작 함수, 인자 하나. 반환값에 오류 번호- 뮤텍스: 소유자가 있는 자물쇠. ERRORCHECK 로 실수를 잡고, 교착은 gdb 로 찾는다
- 조건 변수: “때가 되면 깨워줘”. 상태 변수와
while이 세트, 종료는broadcast - 읽기-쓰기 락: 쓰기 5% 에서 이미 이득이 사라졌다
- 스핀락: 짧은 임계 구역에서 뮤텍스가 2배 빨랐다
- 원자적 연산:
lock접두사 하나. 속도(1.05배)보다 “블록되지 않음”이 진짜 장점 - 거짓 공유: 배치만 바꿔 48배. 눈에 안 보이는 성능 함정
- 스레드 안전성:
_r함수, TLS,errno의 정체,man의 ATTRIBUTES 절 - 도구:
ps -L,timeout,gdb의thread apply all bt,-fsanitize=thread,valgrind
그리고 이번 주에 반복해서 나온 주제가 있습니다.
① 지역에서 계산하고 마지막에 한 번 합친다. 3.2절(70배), 8.3절(70배), 10절의 psum, 프로젝트 2와 3에서 계속 나왔습니다. 공유를 줄이는 것이 동기화를 잘하는 것보다 낫습니다.
② 불변 데이터는 동기화가 필요 없다. 프로젝트 3의 보이어-무어 표가 그랬습니다. 설계로 문제를 없애는 것이 최선입니다.
③ 통념보다 측정. 스핀락이 짧은 임계 구역에서 느렸고(6절), 원자적 연산이 뮤텍스보다 1.05배밖에 안 빨랐고(7절), rwlock 이 쓰기 20% 에서 두 배 가까이 느렸습니다(5절). 교과서의 일반론은 출발점이지 결론이 아닙니다. 여러분의 워크로드에서 직접 재 보세요.
④ 병렬화의 상한은 구조와 하드웨어가 정한다. nproc 이 12라도 물리 코어는 6개였고, 순수 계산도 4~5배에서 멈췄습니다. 정렬은 메모리 대역폭에, 스레드 풀은 작업의 순차 부분에 걸렸습니다. “코어가 N 개니 N 배 빨라지겠지”는 거의 항상 틀립니다.
다음 주는 네트워크 프로그래밍입니다. 지금까지는 같은 컴퓨터 안의 이야기였습니다. 이제 다른 컴퓨터와 대화합니다.
- 소켓: 18주차의 fd 가 네트워크로 확장됩니다
- TCP/UDP: 신뢰성 있는 스트림과 빠른 데이터그램
select/poll/epoll: 19주차 프로젝트에서 맛본 다중화의 본편- 그리고 이번 주의 스레드 풀로 진짜 웹 서버를 만듭니다
18주차의 fd, 19주차의 다중화, 20주차의 스레드. 세 주의 내용이 21주차에서 하나로 합쳐집니다.
수고하셨습니다. 멀티스레딩은 “동작하는 코드”와 “올바른 코드”의 간극이 가장 큰 영역입니다. 3.3절에서 봤듯이 테스트를 통과했다고 안심할 수 없습니다. 공유 자원이 있으면 반드시 보호했는지 확인하고, -fsanitize=thread 를 한 번은 돌려 보는 습관을 들이세요.
체크리스트
각 항목을 설명할 수 있으면 체크합니다.
- [ ]
pthread_create의 인자 넷과 반환값의 뜻을 안다 - [ ] 스레드 함수가
void *를 받고 돌려주는 이유를 안다 - [ ]
ps -L로 스레드를 보고 PID 와 LWP 의 관계를 설명할 수 있다 - [ ] 반복 변수 주소를 인자로 넘기면 안 되는 이유를 실험으로 확인했다
- [ ] 스레드 함수가 지역 변수 주소를 반환하면 안 되는 이유를 안다
- [ ]
detach가 필요한 경우와main이 먼저 끝나면 안 되는 이유를 안다 - [ ] 스레드 하나의 세그폴트가 프로세스 전체를 죽이는 것을 확인했다
- [ ] 같은 주소인데 부모와 자식의 값이 다른 이유를 가상 메모리로 설명할 수 있다
- [ ]
counter++가 왜 세 단계인지 기계어로 설명할 수 있다 - [ ]
-O2에서 경쟁 조건 버그가 숨는 이유를 안다 - [ ]
pthread_mutex_lock/unlock으로 임계 구역을 보호할 수 있다 - [ ] 락을 덩어리로 잡는 기법(지역 누적)의 효과를 안다
- [ ] ERRORCHECK/RECURSIVE 뮤텍스와
trylock,timedlock의 용도를 안다 - [ ] 교착 상태를 만들고 gdb 로 각 스레드가 무엇을 기다리는지 찾을 수 있다
- [ ] ThreadSanitizer 보고서에서 변수와 줄 번호를 읽을 수 있다
- [ ] 조건 변수가 뮤텍스를 받는 이유(잃어버린 깨어남)를 안다
- [ ] 상태 변수 없이 신호만 기다리면 왜 멈추는지 실험으로 확인했다
- [ ] 조건 변수를
while로 감싸야 하는 세 가지 이유를 말할 수 있다 - [ ]
signal과broadcast를 상황에 맞게 고를 수 있다 - [ ] 읽기-쓰기 락이 이득인 조건과 손해인 조건을 안다
- [ ] 스핀락이 무너지는 조건(코어 초과)과 적응형 뮤텍스를 설명할 수 있다
- [ ]
lock접두사가 무엇을 하는지, 원자적 연산의 진짜 장점이 무엇인지 안다 - [ ] CAS 의 동작과 재시도 루프, ABA 문제를 설명할 수 있다
- [ ] 거짓 공유가 왜 생기는지 캐시 라인으로 설명하고 두 해법을 쓸 수 있다
- [ ]
strtok이 스레드에서 위험한 이유와_r함수의 공통점을 안다 - [ ]
errno가 스레드마다 다르다는 것을 주소로 확인했다 - [ ]
__thread로 스레드 지역 변수를 만들 수 있다 - [ ] 스레드 풀에서 작업을 락 밖에서 실행해야 하는 이유를 안다
- [ ] 논리 CPU 와 물리 코어의 차이, 가속비가 코어 수만큼 안 나오는 이유를 설명할 수 있다
- [ ] 세 프로젝트를 빌드하고 스레드 수를 바꿔 가며 측정해 봤다
참고 자료
- “The Linux Programming Interface” (Kerrisk) — 29~33장이 pthread 전체
- “Programming with POSIX Threads” (David Butenhof) — 스레드의 고전
- “C++ Concurrency in Action” (Anthony Williams) — C++ 책이지만 메모리 모델 설명이 최고
man 7 pthreads,man 7 attributes(MT-Safe 표기법)- Herb Sutter, “The Free Lunch Is Over” — 멀티코어 시대의 선언문
- ThreadSanitizer 문서
- 다음 주차: 21주차 네트워크 프로그래밍