학습 목표
이번 주차를 마치면 다음을 할 수 있습니다.
printf밑에write가 있다는 것을strace로 직접 확인하고, 시스템 콜과 라이브러리 함수의 차이를 버퍼링으로 설명할 수 있다open/read/write/close의 인자와 반환값을 하나씩 알고, 파일 디스크립터 번호만으로 파일을 다룰 수 있다fork가 왜 두 번 돌아오는지 PID 로 확인하고,exec로 변신하고,wait로 종료 코드를 받아 1주차의echo $?와 연결할 수 있다- 좀비와 고아 프로세스를 일부러 만들어
ps와/proc에서 관찰하고, 뒷정리 방법을 고를 수 있다 sigaction으로 시그널을 안전하게 처리할 수 있다 (핸들러 3계명)stat과readdir로ls -l,du,find의 축소판을 만들 수 있다- 미니 쉘과 데몬을 직접 만들고, 매일 쓰는 도구가 어떻게 돌아가는지 설명할 수 있다
들어가며 — 1주차에 미뤄 둔 약속을 지킬 때
1주차를 기억하시나요? 그때 이런 말을 여러 번 했습니다.
- “
man의 섹션 2는 운영체제 기능을 부르는 함수(시스템 콜)입니다. 18주차부터 매일 봅니다.“ - “
cd가 쉘 내장 명령이어야 하는 이유, 이 ‘프로세스’라는 개념은 18주차에서fork와exec로 직접 다룹니다.“ - “
./hello를 실행하면 운영체제가_start를 부르고,main이 돌려준 0이 쉘의$?에 들어갑니다.”
그 약속을 지키는 주가 왔습니다. 지금까지 여러분의 프로그램은 자기 메모리 안에서만 살았습니다. 배열을 정렬하고, 트리를 걷고, 문자열을 찾았지만 전부 자기 세계 안의 일이었죠. 바깥과 닿는 곳은 printf 와 fopen 뿐이었고, 그마저도 “그냥 되는 것”으로 여겼습니다.
오늘부터는 다릅니다. 여러분의 프로그램이 운영체제(커널)와 직접 대화합니다. 프로세스를 낳고(fork), 다른 프로그램으로 변신하고(exec), 자식의 종료 코드를 받고(wait), 커널의 알림을 받고(시그널), 파일 시스템을 걷습니다(readdir). 그리고 이번 주가 끝나면 매일 쓰는 도구들이 여러분 손에서 만들어집니다. 쉘(bash), 시스템 모니터(top), 데몬(웹 서버의 뼈대)의 축소판입니다.
감각이 하나 달라질 겁니다. 지금까지는 “내 코드가 어떻게 동작하는가”를 생각했다면, 이제부터는 “내 코드와 커널이 어떻게 협력하는가” 를 생각하게 됩니다. ls 를 치면 무슨 일이 일어나는지, Ctrl+C 가 어떻게 프로그램을 멈추는지, 백그라운드 프로세스가 어떻게 살아남는지를 코드로 확인합니다.
이 글의 표기법은 1주차와 같습니다. 줄 맨 앞의
$는 “여기부터 입력”이라는 뜻이고,$가 없는 줄은 실행 결과입니다. 실행 결과는 전부 이 글을 쓰면서 실제로 돌려 얻은 것이고, PID 처럼 실행마다 바뀌는 숫자는 여러분 화면에서 다르게 나옵니다.
준비물: 컴파일 옵션이 바뀝니다
이번 주부터 컴파일 옵션이 -std=c11 에서 -std=gnu11 로 바뀝니다.
$ gcc -Wall -Wextra -std=gnu11 -g 파일이름.c -o 실행파일이름
왜일까요? 직접 확인해 보는 것이 제일 빠릅니다. 이번 주 예제 하나를 예전 옵션으로 컴파일해 봅시다.
$ gcc -Wall -Wextra -std=c11 -g examples/file_stat.c -o build/file_stat
examples/file_stat.c: In function ‘type_char’:
examples/file_stat.c:32:9: warning: implicit declaration of function ‘S_ISSOCK’ [-Wimplicit-function-declaration]
   32 |     if (S_ISSOCK(mode)) return 's';      /* 소켓 */
      |         ^~~~~~~~
examples/file_stat.c: In function ‘print_stat_line’:
examples/file_stat.c:51:9: warning: implicit declaration of function ‘lstat’; did you mean ‘fstat’? [-Wimplicit-function-declaration]
   51 |     if (lstat(path, &st) < 0) {          /* lstat: 링크 자체를 조사 */
      |         ^~~~~
      |         fstat
/usr/bin/ld: /tmp/cc48RhyR.o: in function `type_char':
file_stat.c:32:(.text+0xa1): undefined reference to `S_ISSOCK'
collect2: error: ld returned 1 exit status
1주차 10절에서 본 두 가지 오류가 한꺼번에 나왔습니다. “선언 없이 쓰인 함수”(implicit declaration) 경고와, 링크 단계의 undefined reference 입니다. 헤더는 분명히 포함했는데 컴파일러가 lstat 을 모른다고 합니다.
이유는 이렇습니다. lstat, fileno, kill 같은 함수는 C 언어 표준에 없습니다. 유닉스 계열 운영체제들이 공통으로 지키기로 약속한 POSIX 표준에 속합니다. -std=c11 은 “C 표준에 있는 것만 보여 달라”는 뜻이라, 헤더 파일이 POSIX 함수의 선언을 숨깁니다. 1주차 7절에서 #include 가 헤더를 그대로 붙여 넣는다고 했는데, 그 헤더 안에 “이 옵션이면 이 부분은 빼라”는 #ifdef 조건(6절 예제 5에서 본 조건부 컴파일)이 들어 있는 것입니다.
시스템 프로그래밍은 “C 표준 + POSIX 표준” 의 세계입니다. -std=gnu11 은 C11 에 GNU 확장을 더한 것인데, 이 옵션이면 헤더가 POSIX 선언을 숨기지 않습니다. 정식 방법은 소스 맨 위에 어떤 표준의 기능을 쓸지 선언하는 것입니다.
#define _POSIX_C_SOURCE 200809L    /* 모든 #include 앞에! */
#include <unistd.h>
“POSIX.1-2008 기능을 쓰겠다”는 선언입니다. 이렇게 하면 -std=c11 로도 경고 없이 컴파일됩니다. 실제로 확인했습니다.
$ gcc -Wall -Wextra -std=c11 -D_POSIX_C_SOURCE=200809L -g examples/file_stat.c -o build/file_stat
$ echo $?
0
-D이름=값 은 소스에 #define 을 쓴 것과 같은 효과를 내는 옵션입니다. 이번 주 예제들은 학습 편의를 위해 -std=gnu11 을 쓰고, Makefile 도 그렇게 돼 있습니다. 무엇이 C 표준이고 무엇이 POSIX 인지는 man 페이지의 CONFORMING TO 항목에 적혀 있습니다. 이 경계를 의식하는 것 자체가 이번 주의 배움 중 하나입니다.
예제 코드는 week18/examples/ 와 week18/projects/ 에 있고, week18 폴더에서 make 를 치면 build/ 아래에 실행 파일이 전부 만들어집니다. 이 글의 명령은 모두 week18 폴더에서 치는 것을 기준으로 합니다.
$ cd ~/c_programming/week18       # 저장소를 받은 위치에 맞추세요
$ make
✓ 예제 파일 빌드 완료
✓ 프로젝트 파일 빌드 완료
✓ 모든 파일 빌드 완료!
man 2가 안 나온다면: 시스템 콜의 설명서는 1주차 3절에서 설치한manpages-dev패키지에 들어 있습니다.man 2 open이 “설명서 항목이 없습니다”라고 하면sudo apt install manpages-dev를 하세요. 이 글을 쓴 컴퓨터에도 그 패키지가 없어서man 2 open이 나오지 않았습니다. 대신 같은 내용을 웹(https://man7.org/linux/man-pages/)에서 볼 수 있습니다.
1. 시스템 콜: 커널과의 대화 규약
1.1 printf 밑에는 write가 있다
1주차 7절에서 hello 실행 파일이 printf 의 몸통을 libc.so.6 에서 가져다 쓴다고 했습니다. 그럼 그 printf 는 글자를 어떻게 화면에 찍을까요? 화면은 하드웨어이고, 하드웨어를 만질 수 있는 것은 커널뿐입니다. 그러니 printf 도 결국 커널에게 부탁해야 합니다. 그 부탁이 시스템 콜(system call) 이고, 화면(정확히는 파일 디스크립터 1번)에 바이트를 쓰는 시스템 콜의 이름이 write 입니다.
printf("hi")   ->  [C 라이브러리(glibc): 서식 변환, 버퍼에 모으기]  ->  write(1, "hi", 2)  ->  커널  ->  화면
fopen("a.txt") ->  [FILE 구조체 만들기, 버퍼 준비]                 ->  open("a.txt", ...) ->  커널  ->  디스크
두 층입니다. 위층은 우리가 지금까지 쓴 라이브러리 함수, 아래층이 시스템 콜입니다. 정말 그런지 1주차의 hello 로 확인해 봅시다. strace 는 프로그램이 커널에 보내는 시스템 콜을 전부 엿듣는 도구입니다.
$ strace ./hello
execve("./hello", ["./hello"], 0x7ffd... /* 97 vars */) = 0
brk(NULL)                               = 0x571309015000
...
write(1, "Hello, World!\n", 14Hello, World!
)         = 14
exit_group(0)                           = ?
+++ exited with 0 +++
수십 줄이 나오지만(프로그램을 메모리에 올리고 libc.so.6 을 연결하는 준비 작업입니다) 마지막 두 줄이 핵심입니다. write(1, "Hello, World!\n", 14) — 우리는 printf 를 불렀는데 커널에 도착한 것은 write 입니다. 1번 파일에, 이 바이트들을, 14개. 그리고 = 14 는 “14바이트를 썼다”는 커널의 대답입니다. 출력 한가운데 Hello, World! 가 끼어든 것은 strace 의 기록과 프로그램의 진짜 출력이 같은 화면에 섞였기 때문입니다.
그다음 exit_group(0) 은 return 0 의 정체입니다. 1주차에서 main 의 반환값이 종료 코드가 된다고 했는데, 그 0을 커널에 넘기는 시스템 콜이 이것입니다.
strace -c 를 붙이면 통계를 내 줍니다.
$ strace -c ./hello > /dev/null
% time     seconds  usecs/call     calls    errors syscall
------ ----------- ----------- --------- --------- ----------------
...
100.00    0.000000           0        44        10 total
다섯 줄짜리 Hello World 가 시스템 콜을 44번 부릅니다. 그중 우리 코드가 직접 원인인 것은 write 한 번과 exit_group 한 번뿐이고, 나머지는 프로그램을 시작하는 준비 작업입니다.
라이브러리 함수와 시스템 콜을 구분해서 보는 도구가 하나 더 있습니다. ltrace 는 라이브러리 함수 호출을 엿듣습니다.
$ ltrace ./hello
puts("Hello, World!")                            = 14
Hello, World!
+++ exited (status 0) +++
printf 가 아니라 puts 가 보이죠. 1주차 7절에서 본 GCC 의 바꿔치기가 여기서도 드러납니다. 정리하면 이렇습니다.
| 도구 | 엿듣는 것 | hello 에서 보이는 것 |
|---|---|---|
ltrace |
프로그램 → 라이브러리 함수 | puts("Hello, World!") |
strace |
라이브러리(또는 프로그램) → 커널 | write(1, "Hello, World!\n", 14) |
1.2 왜 두 층일까 — 시스템 콜은 비싸다
라이브러리가 그냥 write 를 바로 부르면 될 텐데 왜 중간에 층을 하나 더 두었을까요? 시스템 콜이 비싸기 때문입니다.
시스템 콜은 유저 모드에서 커널 모드로의 전환을 동반합니다. CPU 가 특권 수준을 바꾸고, 지금 쓰던 레지스터를 전부 저장하고, 커널의 스택으로 갈아탔다가, 일이 끝나면 그 역순으로 돌아옵니다. 일반 함수 호출보다 수십에서 수백 배 느립니다.
그래서 라이브러리는 버퍼에 모았다가 한 번에 보냅니다. printf 를 100번 불러도 write 는 몇 번만 일어나죠. 이번 주 첫 예제가 바로 그것을 보여 줍니다.
examples/syscall_basic.c:
/*
 * syscall_basic.c - 시스템 콜: 커널과의 첫 대화
 * 18주차: POSIX 시스템 프로그래밍
 *
 * 지금까지 쓴 printf, fopen은 "라이브러리 함수"입니다.
 * 그 밑에는 커널에게 직접 부탁하는 "시스템 콜"이 있습니다:
 *
 *   printf("hi")  ->  [C 라이브러리: 버퍼링, 서식]  ->  write(1, "hi", 2)
 *   fopen(...)    ->  [FILE* 구조체 관리]           ->  open(...)
 *
 * 시스템 콜은 유저 모드 -> 커널 모드 전환이라 비싸다!
 * 그래서 라이브러리가 버퍼로 호출 횟수를 줄여주는 것입니다.
 *
 * 확인 도구: strace ./build/syscall_basic 으로 직접 보세요!
 */
#include <stdio.h>
#include <string.h>
#include <errno.h>
#include <unistd.h>      /* write, read, close - POSIX의 심장 */
#include <fcntl.h>       /* open과 O_* 플래그 */

int main(void) {
    /* ---------- 1. write 시스템 콜 직접 호출 ---------- */
    /* fd 1 = 표준 출력. printf 없이 커널에게 직접 부탁한다 */
    const char *msg = "=== 1. write(1, ...): printf 없이 출력 ===\n";
    ssize_t written = write(1, msg, strlen(msg));

    char info[128];
    int len = snprintf(info, sizeof(info),
                       "write가 쓴 바이트: %zd (요청한 만큼 확인 필수!)\n\n",
                       written);
    write(1, info, (size_t)len);

    /* ---------- 2. 버퍼링의 차이 체험 ---------- */
    printf("=== 2. printf(버퍼) vs write(직행) ===\n");
    printf("printf 100번 호출 -> write 시스템 콜은? ");
    for (int i = 0; i < 100; i++) {
        printf(".");                 /* 라이브러리 버퍼에 쌓일 뿐! */
    }
    printf("\n(strace로 보면 write는 몇 번뿐 - 버퍼가 모아서 보낸다)\n");
    printf("(참고로 터미널 출력은 개행마다, 파일 출력은 4KB마다 비운다)\n\n");

    /* ---------- 3. errno: 시스템 콜의 실패 신고 체계 ---------- */
    printf("=== 3. errno와 에러 처리 ===\n");

    int fd = open("/etc/shadow", O_RDONLY);      /* 일반 유저는 권한 없음 */
    if (fd < 0) {
        int saved = errno;           /* 9주차 규칙: 실패 즉시 저장! */
        printf("open(\"/etc/shadow\") 실패!\n");
        printf("  errno = %d\n", saved);
        printf("  perror  -> ");
        fflush(stdout);              /* printf 버퍼를 먼저 비우고 */
        errno = saved;
        perror("  open");
        printf("  strerror -> %s\n", strerror(saved));
    } else {
        printf("(root로 실행했군요! /etc/shadow가 열렸습니다)\n");
        close(fd);
    }

    int fd2 = open("/no/such/dir/file.txt", O_RDONLY);
    if (fd2 < 0) {
        printf("없는 경로 open -> errno %d (%s)\n\n", errno, strerror(errno));
    }

    /* ---------- 4. 시스템 콜 반환값 규약 ---------- */
    printf("=== 4. 반환값 규약 (외우세요) ===\n");
    printf("성공: 0 이상 (fd, 바이트 수, PID...)\n");
    printf("실패: -1 + errno 설정\n");
    printf("-> 모든 시스템 콜 뒤에 if (ret < 0) 검사가 기본기!\n\n");

    printf("=== 직접 확인해 보기 ===\n");
    printf("$ strace -c ./build/syscall_basic   # 시스템 콜 통계\n");
    printf("$ strace -e write ./build/syscall_basic  # write만 추적\n");
    printf("$ man 2 write   # 섹션 2 = 시스템 콜 (3 = 라이브러리)\n");
    return 0;
}
새로 나온 것들을 한 줄씩 봅시다.
#include <unistd.h>: Unix standard, POSIX 함수의 본진입니다.write,read,close,fork,getpid가 전부 여기서 선언됩니다. 이번 주 내내 첫 줄에 들어갑니다.#include <fcntl.h>: file control.open과O_RDONLY같은 플래그가 있습니다.write(1, msg, strlen(msg)): 인자가 셋입니다. 어디에(파일 디스크립터 1번 = 표준 출력), 무엇을(바이트가 있는 주소), 몇 바이트.printf와 달리 문자열의 끝을\0로 알아내지 않고, 우리가 길이를 세어 줘야 합니다. 서식(%d)도 해석하지 않습니다. 커널은 글자를 모르고 바이트만 압니다.ssize_t written:write의 반환값입니다. 실제로 쓴 바이트 수이거나, 실패하면 -1 입니다.size_t는 부호가 없어서 -1 을 담을 수 없으니, 부호 있는(signed) 크기 타입ssize_t를 씁니다.printf로 찍을 때는%zd입니다.write(1, info, (size_t)len):snprintf로 문자열을 만든 뒤write로 내보냈습니다.printf없이 서식 있는 출력을 하는 방법입니다.snprintf가 돌려주는 글자 수(int)를size_t로 바꿔 넘기는 형 변환에 주의하세요.open("/etc/shadow", O_RDONLY): 비밀번호 해시가 든 파일이라 일반 사용자는 읽을 수 없습니다. 일부러 실패시켜 오류 처리를 보여 주려는 것입니다.
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/syscall_basic.c -o build/syscall_basic
$ ./build/syscall_basic
=== 1. write(1, ...): printf 없이 출력 ===
write가 쓴 바이트: 47 (요청한 만큼 확인 필수!)

=== 2. printf(버퍼) vs write(직행) ===
printf 100번 호출 -> write 시스템 콜은? ....................................................................................................
(strace로 보면 write는 몇 번뿐 - 버퍼가 모아서 보낸다)
(참고로 터미널 출력은 개행마다, 파일 출력은 4KB마다 비운다)

=== 3. errno와 에러 처리 ===
open("/etc/shadow") 실패!
  errno = 13
  perror  ->   open: Permission denied
  strerror -> Permission denied
없는 경로 open -> errno 2 (No such file or directory)

=== 4. 반환값 규약 (외우세요) ===
성공: 0 이상 (fd, 바이트 수, PID...)
실패: -1 + errno 설정
-> 모든 시스템 콜 뒤에 if (ret < 0) 검사가 기본기!

=== 직접 확인해 보기 ===
$ strace -c ./build/syscall_basic   # 시스템 콜 통계
$ strace -e write ./build/syscall_basic  # write만 추적
$ man 2 write   # 섹션 2 = 시스템 콜 (3 = 라이브러리)
첫 줄의 47은 === 1. write(1, ...): printf 없이 출력 ===\n 의 바이트 수입니다. 한글이 없으니 글자 수와 같습니다. 1주차 6절의 UTF-8 이야기를 떠올리면, 한글이 섞였다면 글자 수보다 큰 값이 나왔을 겁니다.
1.3 strace: 시스템 프로그래머의 청진기
이제 이 프로그램의 write 만 골라서 엿들어 봅시다. -e trace=write 는 “write 시스템 콜만 보여 달라”는 옵션입니다.
$ strace -e trace=write ./build/syscall_basic
printf(".") 100번이 정말 write 몇 번으로 합쳐지는지 세어 보겠습니다. 결과가 출력이 어디로 가느냐에 따라 달라서, 두 경우를 비교합니다. strace 의 기록은 표준 에러(2번)로 나가므로 2>&1 >/dev/null 로 프로그램 출력만 버리고 기록만 남겼습니다.
$ strace -e trace=write ./build/syscall_basic 2>&1 | grep -c "^write(1"     # 터미널에 출력할 때
22
$ strace -e trace=write ./build/syscall_basic 2>&1 >/dev/null | grep -c "^write(1"   # 파일(/dev/null)로 보낼 때
4
프로그램은 printf 를 100번 넘게 부르는데, 터미널이면 write 가 22번, 파일이면 4번입니다. 파일로 보낼 때의 기록을 보면 무슨 일인지 보입니다.
write(1, "=== 1. write(1, ...): printf \354\227\206"..., 47) = 47
write(1, "write\352\260\200 \354\223\264 \353\260\224\354\235\264\355\212\270: 47 (\354\232\224\354"..., 62) = 62
write(1, "=== 2. printf(\353\262\204\355\215\274) vs write(\354"..., 435) = 435
write(2, "  open: Permission denied\n", 26) = 26
write(1, "  strerror -> Permission denied\n"..., 486) = 486
앞의 두 write 는 우리가 직접 부른 것이라 그대로 나갔습니다. 그다음 435바이트짜리 write 하나가 printf 수십 번을 합친 것입니다. 100개의 점도 이 안에 들어 있습니다. 4번째 줄은 perror 가 표준 에러(2번)에 쓴 것이고, 마지막 486바이트가 나머지 전부입니다.
버퍼가 비워지는 규칙은 이렇습니다.
| 출력 대상 | 버퍼링 방식 | 언제 write 하나 |
|---|---|---|
| 터미널 | 줄 버퍼링(line buffered) | \n 을 만날 때마다 |
| 파일, 파이프 | 전체 버퍼링(fully buffered) | 버퍼(보통 4096바이트)가 차거나 프로그램이 끝날 때 |
| 표준 에러(2번) | 버퍼링 없음 | 즉시 |
한글 바이트가 \354\227\206 처럼 보이는 것은 strace 가 ASCII 가 아닌 바이트를 8진수로 적기 때문입니다. write 에 넘어간 것이 글자가 아니라 바이트라는 사실이 여기서도 보입니다.
실험: 버퍼 크기를 바꾸면 시스템 콜 횟수가 어떻게 될까?
다음 절의 fd_basics.c 에는 4096바이트 버퍼로 파일을 복사하는 코드가 있습니다. 그 버퍼를 16바이트, 1바이트로 줄여 컴파일하고 strace -c 로 read 와 write 횟수만 세어 봤습니다.
| 버퍼 크기 | read 횟수 |
write 횟수 |
|---|---|---|
| 4096 | 3 | 3 |
| 16 | 7 | 7 |
| 1 | 76 | 76 |
74바이트짜리 파일을 복사하는 데 1바이트 버퍼는 시스템 콜을 150번 넘게 부릅니다. 버퍼가 시스템 콜을 줄여 준다는 말이 숫자로 보입니다. 파일이 74바이트가 아니라 74메가바이트였다면 이 차이가 몇 초와 몇 분의 차이가 됩니다.
실험: printf 와 write 를 섞으면 순서가 뒤집힌다
두 층을 섞어 쓰면 어떻게 될까요? printf, write, printf 순서로 부르는 작은 프로그램입니다.
#include <stdio.h>
#include <unistd.h>

int main(void) {
    printf("printf: 1번째\n");
    const char msg[] = "write : 2번째\n";
    write(1, msg, sizeof(msg) - 1);
    printf("printf: 3번째\n");
    return 0;
}
터미널과 파이프에서 각각 실행합니다.
$ ./mix
printf: 1번째
write : 2번째
printf: 3번째
$ ./mix | cat
write : 2번째
printf: 1번째
printf: 3번째
파이프에서는 2번째가 맨 앞에 나왔습니다. printf 의 글자들은 버퍼에서 기다리다 프로그램이 끝날 때 나갔고, write 는 버퍼 없이 즉시 커널로 갔기 때문입니다. 터미널에서는 줄 버퍼링이라 \n 마다 비워져서 순서가 맞았고요. FILE * 계열과 fd 계열을 한 출력에 섞어 쓰면 순서를 믿을 수 없습니다. 꼭 섞어야 한다면 write 전에 fflush(stdout) 을 부르세요. 이 교훈은 3.4절의 fork 에서 한 번 더 중요해집니다.
1.4 반환값 규약과 errno
시스템 콜의 대답 규칙은 단 하나입니다.
성공하면 0 이상(파일 디스크립터, 바이트 수, PID 등), 실패하면 -1 을 돌려주고
errno에 이유를 적어 둔다.
9주차 파일 입출력에서 errno 와 perror 를 봤습니다. 시스템 콜은 전부 이 규칙을 따르므로, 어떤 실패가 어떤 errno 가 되는지 한자리에서 확인해 두면 앞으로 오류 메시지를 읽기 쉬워집니다. 일부러 여러 가지로 실패시키는 프로그램을 만들었습니다.
#include <stdio.h>
#include <errno.h>
#include <string.h>
#include <unistd.h>
#include <fcntl.h>

static void try(const char *what, int ret) {
    if (ret < 0) printf("%-42s -> -1, errno=%2d %s\n", what, errno, strerror(errno));
    else         printf("%-42s -> %d (성공)\n", what, ret);
}

int main(void) {
    try("open(\"/no/such/file\", O_RDONLY)", open("/no/such/file", O_RDONLY));
    try("open(\"/etc/shadow\", O_RDONLY)", open("/etc/shadow", O_RDONLY));
    try("open(\"/tmp\", O_WRONLY)", open("/tmp", O_WRONLY));
    try("open(\"/etc/hostname\", O_WRONLY)", open("/etc/hostname", O_WRONLY));
    int fd = open("x.txt", O_WRONLY | O_CREAT, 0644);
    try("open(\"x.txt\", O_WRONLY|O_CREAT, 0644)", fd);
    try("open(\"x.txt\", O_WRONLY|O_CREAT|O_EXCL, 0644)", open("x.txt", O_WRONLY | O_CREAT | O_EXCL, 0644));
    close(fd);
    try("write(fd 닫은 뒤, ...)", (int)write(fd, "a", 1));
    try("read(1 = 표준 출력, ...)", (int)read(1, (char[1]){0}, 1));
    unlink("x.txt");
    return 0;
}
try 함수의 (char[1]){0} 는 C99 의 복합 리터럴로, 이름 없는 1바이트 배열을 그 자리에서 만드는 표기입니다. read 에 넘길 임시 버퍼가 필요했을 뿐입니다.
$ ./errs
open("/no/such/file", O_RDONLY)            -> -1, errno= 2 No such file or directory
open("/etc/shadow", O_RDONLY)              -> -1, errno=13 Permission denied
open("/tmp", O_WRONLY)                     -> -1, errno=21 Is a directory
open("/etc/hostname", O_WRONLY)            -> -1, errno=13 Permission denied
open("x.txt", O_WRONLY|O_CREAT, 0644)      -> 3 (성공)
open("x.txt", O_WRONLY|O_CREAT|O_EXCL, 0644) -> -1, errno=17 File exists
write(fd 닫은 뒤, ...)                  -> -1, errno= 9 Bad file descriptor
read(1 = 표준 출력, ...)               -> -1, errno= 9 Bad file descriptor
errno |
이름 | 메시지 | 언제 |
|---|---|---|---|
| 2 | ENOENT |
No such file or directory | 경로가 없다. 1주차부터 본 그 메시지의 정체 |
| 13 | EACCES |
Permission denied | 권한이 없다. 1주차 9절의 허가 거부 |
| 21 | EISDIR |
Is a directory | 디렉터리를 쓰기로 열려 했다 |
| 17 | EEXIST |
File exists | O_EXCL(없을 때만 만들어라)인데 이미 있다 |
| 9 | EBADF |
Bad file descriptor | 닫힌 번호, 또는 읽기용을 쓰기로(반대로) 썼다 |
이름들은 <errno.h> 에 정의된 상수입니다. 코드에서 if (errno == ENOENT) 처럼 숫자가 아니라 이름으로 비교하세요. 숫자는 운영체제마다 다를 수 있습니다.
errno 를 즉시 저장하는 습관은 9주차에서 배운 그대로입니다. errno 는 “가장 최근 실패”를 담는 변수라, 사이에 다른 함수를 부르면 덮어써질 수 있습니다. syscall_basic.c 가 int saved = errno; 로 받아 두고 perror 직전에 errno = saved; 로 복원한 이유입니다. 중간에 printf 가 세 번이나 있었으니까요.
메시지를 얻는 방법은 둘입니다.
perror("문맥"): 표준 에러에문맥: 메시지형식으로 찍습니다. 위 실행 결과에서open: Permission denied가 그것입니다. 표준 에러라서> 파일로 출력을 돌려도 화면에 남습니다.strerror(errno): 메시지 문자열만 돌려줍니다. 직접 서식을 만들 때 씁니다.
그리고 man 의 섹션 번호입니다. 1주차 2절에서 printf 가 섹션 1(명령어)과 3(C 함수)에 둘 다 있다고 했죠. 시스템 콜은 섹션 2입니다.
$ man 2 write    # 섹션 2 = 시스템 콜
$ man 3 printf   # 섹션 3 = 라이브러리 함수
$ man 7 signal   # 섹션 7 = 개념 설명
man write 만 치면 섹션 1 의 write 명령(다른 사용자에게 메시지 보내기)이 나옵니다. 시스템 프로그래밍에서는 섹션 번호를 붙이는 습관이 필요합니다. 이 글에서 man 2 fork 라고 쓰면 “섹션 2 의 fork 문서”라는 뜻입니다.
2. 파일 디스크립터: 모든 것은 번호다
2.1 유닉스의 대통일 이론
유닉스 설계의 핵심 철학이 하나 있습니다.
“모든 것은 파일이다(Everything is a file).”
일반 파일뿐 아니라 터미널, 파이프, 소켓, 장치(/dev/null, 디스크), 심지어 커널의 내부 상태(/proc)까지 전부 파일처럼 읽고 씁니다. 그리고 그 모든 것을 파일 디스크립터(file descriptor, 줄여서 fd) 라는 정수 하나로 가리킵니다. 커널은 프로세스마다 “이 프로세스가 연 것들”의 표를 갖고 있고, fd 는 그 표의 칸 번호입니다.
번호에는 규칙이 있습니다.
| 번호 | 이름 | 기본적으로 연결된 곳 |
|---|---|---|
| 0 | 표준 입력 (stdin) | 키보드(터미널) |
| 1 | 표준 출력 (stdout) | 화면(터미널) |
| 2 | 표준 에러 (stderr) | 화면(터미널) |
| 3 이상 | 프로그램이 새로 여는 것 | 비어 있는 가장 작은 번호를 받는다 |
정말 그런지 커널에게 직접 물어볼 수 있습니다. /proc/self 는 “지금 이 명령 자신”의 정보이고, 그 안의 fd 폴더에 열려 있는 파일들이 번호별로 있습니다.
$ ls -l /proc/self/fd
합계 0
lrwx------ 1 user user 64  9월 29 02:16 0 -> /dev/pts/14
lrwx------ 1 user user 64  9월 29 02:16 1 -> /dev/pts/14
lrwx------ 1 user user 64  9월 29 02:16 2 -> /dev/pts/14
lr-x------ 1 user user 64  9월 29 02:16 3 -> /proc/315867/fd
0, 1, 2 가 전부 /dev/pts/14 를 가리킵니다. 지금 쓰고 있는 터미널 창의 장치 파일입니다. 1주차 2절의 “터미널, 쉘, 명령어” 구분에서 터미널이 실제로는 이 장치 파일이었던 것입니다. 3번은 ls 자신이 /proc/self/fd 폴더를 읽으려고 연 것이고요.
이번에는 출력을 파일로 돌려서 같은 명령을 쳐 봅시다.
$ ls -l /proc/self/fd > fdlist.txt
$ cat fdlist.txt
합계 0
lrwx------ 1 user user 64  9월 29 02:15 0 -> /dev/pts/14
l-wx------ 1 user user 64  9월 29 02:15 1 -> /home/user/c_programming/week18/fdlist.txt
lrwx------ 1 user user 64  9월 29 02:15 2 -> /dev/pts/14
lr-x------ 1 user user 64  9월 29 02:15 3 -> /proc/313331/fd
1번만 fdlist.txt 로 바뀌었습니다. > 파일 이 하는 일이 정확히 이것입니다. 프로그램은 평소처럼 1번에 쓰는데, 1번이 가리키는 곳이 터미널에서 파일로 바뀐 것뿐입니다. ls 는 자기 출력이 파일로 가는지도 모릅니다. 쉘이 이 바꿔치기를 어떻게 하는지는 프로젝트 1 에서 직접 만듭니다.
2.2 open, read, write, close — 네 개면 충분하다
파일을 다루는 시스템 콜은 사실상 넷입니다. 9주차의 fopen, fread, fwrite, fclose 와 하나씩 짝이 맞습니다.
| 시스템 콜 | 원형 | 하는 일 | 9주차의 짝 |
|---|---|---|---|
open |
int open(const char *path, int flags, mode_t mode) |
경로를 열어 fd 번호를 받는다 | fopen |
read |
ssize_t read(int fd, void *buf, size_t count) |
fd 에서 최대 count 바이트를 buf 로 |
fread |
write |
ssize_t write(int fd, const void *buf, size_t count) |
buf 의 count 바이트를 fd 로 |
fwrite |
close |
int close(int fd) |
번호를 반납한다 | fclose |
open 의 인자를 하나씩 봅시다.
path: 열 파일의 경로. 1주차의 절대 경로와 상대 경로 규칙 그대로입니다.flags: 어떻게 열지.O_RDONLY(읽기만),O_WRONLY(쓰기만),O_RDWR(둘 다) 중 하나에, 필요하면O_CREAT(없으면 만들어라),O_TRUNC(있으면 내용을 비워라),O_APPEND(끝에 이어 써라),O_EXCL(이미 있으면 실패해라)을|로 더합니다. 3주차 비트 연산의 대표적인 쓰임입니다. 플래그 하나가 비트 하나라서|로 합쳐도 서로 섞이지 않습니다.mode:O_CREAT로 새로 만들 때만 쓰이는 권한입니다.0644처럼 8진수로 씁니다(1주차 2절의 권한 숫자).O_CREAT가 없으면 이 인자는 생략합니다.
read 와 write 의 두 번째 인자가 void * 인 것도 보세요. 10주차에서 배운 “아무 타입이나 가리키는 포인터”입니다. 커널은 바이트만 옮기므로 그 메모리가 char 배열이든 구조체든 상관하지 않습니다.
examples/fd_basics.c:
/*
 * fd_basics.c - 파일 디스크립터: 모든 것은 번호다
 * 18주차: POSIX 시스템 프로그래밍
 *
 * 유닉스의 대통일 이론: "모든 것은 파일이다."
 * 파일, 터미널, 파이프, 소켓... 전부 파일 디스크립터(fd)라는
 * 정수 하나로 다룹니다.
 *
 * 예약석: 0 = 표준 입력, 1 = 표준 출력, 2 = 표준 에러
 * 새로 열면: "비어 있는 가장 작은 번호"를 준다 (보통 3부터)
 *
 * 9주차 FILE*과의 관계: FILE*는 fd를 감싼 버퍼 달린 포장지!
 * (fileno(fp)로 속의 fd를 꺼낼 수 있다)
 */
#include <stdio.h>
#include <string.h>
#include <unistd.h>
#include <fcntl.h>

int main(void) {
    printf("=== 1. fd는 그냥 정수다 ===\n");
    printf("표준 입력=0, 표준 출력=1, 표준 에러=2 (이미 열려 있음)\n");

    /* 파일을 열면 3번부터 배정된다 */
    int fd_a = open("file_a.txt", O_WRONLY | O_CREAT | O_TRUNC, 0644);
    int fd_b = open("file_b.txt", O_WRONLY | O_CREAT | O_TRUNC, 0644);
    printf("file_a.txt -> fd %d\n", fd_a);
    printf("file_b.txt -> fd %d (빈 번호 중 최소!)\n", fd_b);

    close(fd_a);                     /* 3번 반납 */
    int fd_c = open("file_c.txt", O_WRONLY | O_CREAT | O_TRUNC, 0644);
    printf("a를 닫고 c를 열면 -> fd %d (반납된 3번 재사용!)\n\n", fd_c);
    close(fd_b);
    close(fd_c);

    /* ---------- 2. open 플래그 삼총사 ---------- */
    printf("=== 2. open 플래그 (9주차 fopen 모드의 정체) ===\n");
    printf("fopen \"r\"  = O_RDONLY\n");
    printf("fopen \"w\"  = O_WRONLY | O_CREAT | O_TRUNC  (내용 삭제!)\n");
    printf("fopen \"a\"  = O_WRONLY | O_CREAT | O_APPEND\n");
    printf("0644 = rw-r--r-- (생성 시 권한, 8진수!)\n\n");

    /* ---------- 3. 미니 cp: read/write 루프 ---------- */
    printf("=== 3. 미니 cp: 시스템 콜 버전 파일 복사 ===\n");

    /* 원본 만들기 */
    int src = open("source.txt", O_WRONLY | O_CREAT | O_TRUNC, 0644);
    const char *content = "fd로 직접 복사하는 파일입니다.\n"
                          "read가 0을 반환하면 EOF!\n";
    write(src, content, strlen(content));
    close(src);

    /* 복사 루프 - cp 명령의 핵심 코드가 이 10줄이다 */
    src = open("source.txt", O_RDONLY);
    int dst = open("copy.txt", O_WRONLY | O_CREAT | O_TRUNC, 0644);
    if (src < 0 || dst < 0) {
        perror("open");
        return 1;
    }

    char buffer[4096];               /* 4KB: 페이지 크기와 맞춘 관례 */
    ssize_t got;
    long total = 0;
    while ((got = read(src, buffer, sizeof(buffer))) > 0) {
        ssize_t put = write(dst, buffer, (size_t)got);
        if (put != got) {            /* 부분 쓰기 검사 (디스크 꽉참 등) */
            perror("write");
            break;
        }
        total += put;
    }
    if (got < 0) perror("read");

    close(src);
    close(dst);
    printf("source.txt -> copy.txt: %ld바이트 복사 완료\n\n", total);

    /* ---------- 4. read의 3가지 반환 ---------- */
    printf("=== 4. read 반환값 3형제 (핵심!) ===\n");
    printf("  > 0 : 읽은 바이트 수 (요청보다 적을 수 있다!)\n");
    printf("  == 0: EOF (파일 끝, 상대가 연결을 닫음)\n");
    printf("  < 0 : 에러 (errno 확인)\n");
    printf("-> \"요청한 만큼 안 줄 수 있다\"가 소켓 프로그래밍(21주차)의\n");
    printf("   최대 함정이 됩니다. 지금부터 몸에 새기세요!\n\n");

    /* ---------- 5. FILE*과의 다리 ---------- */
    printf("=== 5. FILE* 속의 fd ===\n");
    printf("fileno(stdin)=%d, fileno(stdout)=%d, fileno(stderr)=%d\n",
           fileno(stdin), fileno(stdout), fileno(stderr));
    printf("9주차의 fopen은 이 fd 위에 버퍼를 씌운 것이었습니다.\n");

    /* 정리 */
    unlink("file_a.txt");            /* unlink = 파일 삭제 시스템 콜 */
    unlink("file_b.txt");
    unlink("file_c.txt");
    unlink("source.txt");
    unlink("copy.txt");
    printf("\n(데모 파일은 unlink로 정리했습니다)\n");
    return 0;
}
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/fd_basics.c -o build/fd_basics
$ ./build/fd_basics
=== 1. fd는 그냥 정수다 ===
표준 입력=0, 표준 출력=1, 표준 에러=2 (이미 열려 있음)
file_a.txt -> fd 3
file_b.txt -> fd 4 (빈 번호 중 최소!)
a를 닫고 c를 열면 -> fd 3 (반납된 3번 재사용!)

=== 2. open 플래그 (9주차 fopen 모드의 정체) ===
fopen "r"  = O_RDONLY
fopen "w"  = O_WRONLY | O_CREAT | O_TRUNC  (내용 삭제!)
fopen "a"  = O_WRONLY | O_CREAT | O_APPEND
0644 = rw-r--r-- (생성 시 권한, 8진수!)

=== 3. 미니 cp: 시스템 콜 버전 파일 복사 ===
source.txt -> copy.txt: 74바이트 복사 완료

=== 4. read 반환값 3형제 (핵심!) ===
  > 0 : 읽은 바이트 수 (요청보다 적을 수 있다!)
  == 0: EOF (파일 끝, 상대가 연결을 닫음)
  < 0 : 에러 (errno 확인)
-> "요청한 만큼 안 줄 수 있다"가 소켓 프로그래밍(21주차)의
   최대 함정이 됩니다. 지금부터 몸에 새기세요!

=== 5. FILE* 속의 fd ===
fileno(stdin)=0, fileno(stdout)=1, fileno(stderr)=2
9주차의 fopen은 이 fd 위에 버퍼를 씌운 것이었습니다.

(데모 파일은 unlink로 정리했습니다)
fd 3번을 닫고 새 파일을 열었더니 다시 3번이 배정됐습니다. “빈 번호 중 최소” 규칙이 눈에 보이는 순간입니다. 이 예측 가능성이 프로젝트 1 의 리다이렉션을 성립시킵니다. 1번을 닫고 파일을 열면 그 파일이 1번이 되니까요.
마지막의 unlink 는 파일을 지우는 시스템 콜입니다. rm 명령의 정체죠. 이름이 “삭제”가 아니라 “링크 해제”인 이유는 22주차 파일 시스템에서 하드 링크를 배우면 알게 됩니다. 지금은 “이름과 내용의 연결을 끊는다”고만 알아 두세요.
이 프로그램이 커널에 실제로 무엇을 보내는지 strace 로 보면, 위의 표가 그대로 나타납니다.
$ strace -e trace=openat,read,write,close ./build/fd_basics > /dev/null
openat(AT_FDCWD, "file_a.txt", O_WRONLY|O_CREAT|O_TRUNC, 0644) = 3
openat(AT_FDCWD, "file_b.txt", O_WRONLY|O_CREAT|O_TRUNC, 0644) = 4
openat(AT_FDCWD, "file_c.txt", O_WRONLY|O_CREAT|O_TRUNC, 0644) = 3
close(4)                                = 0
openat(AT_FDCWD, "source.txt", O_WRONLY|O_CREAT|O_TRUNC, 0644) = 3
write(3, "fd\353\241\234 \354\247\201\354\240\221 "..., 74) = 74
openat(AT_FDCWD, "source.txt", O_RDONLY) = 3
openat(AT_FDCWD, "copy.txt", O_WRONLY|O_CREAT|O_TRUNC, 0644) = 4
read(3, "fd\353\241\234 \354\247\201\354\240\221 "..., 4096) = 74
write(4, "fd\353\241\234 \354\247\201\354\240\221 "..., 74) = 74
read(3, "", 4096)                       = 0
close(4)                                = 0
write(1, "=== 1. fd\353\212\224 ..."..., 1106) = 1106
두 가지가 눈에 띕니다. 첫째, 우리는 open 을 불렀는데 커널에 도착한 것은 openat 입니다. AT_FDCWD 는 “현재 작업 디렉터리 기준”이라는 뜻으로, 최근 리눅스는 open 을 openat 의 특수한 경우로 처리합니다. 라이브러리가 그렇게 바꿔서 보냅니다. 둘째, read(3, ..., 4096) = 74 다음에 read(3, "", 4096) = 0 이 있습니다. 4096 바이트를 요청했는데 74 바이트만 받았고, 다음 요청에 0 이 왔습니다. 이 0 이 “파일 끝”입니다. 2.5절에서 자세히 봅니다.
2.3 open 플래그와 권한 — fopen 모드의 정체
9주차에서 fopen(path, "w") 를 배웠습니다. 그 "w" 의 정체가 여기 있습니다.
fopen 모드 |
open 플래그 |
|---|---|
"r" |
O_RDONLY |
"w" |
O_WRONLY \| O_CREAT \| O_TRUNC |
"a" |
O_WRONLY \| O_CREAT \| O_APPEND |
"r+" |
O_RDWR |
"w+" |
O_RDWR \| O_CREAT \| O_TRUNC |
정말 그런지 fopen 을 쓰는 작은 프로그램을 strace 로 엿들어 봅시다.
#include <stdio.h>

int main(void) {
    FILE *fp = fopen("ft.txt", "w");
    for (int i = 0; i < 100; i++) {
        fprintf(fp, "줄 %d\n", i);
    }
    fclose(fp);
    return 0;
}
$ strace -e trace=openat,write,close ./fopen_trace
openat(AT_FDCWD, "ft.txt", O_WRONLY|O_CREAT|O_TRUNC, 0666) = 3
write(3, "\354\244\204 0\n\354\244\204 1\n\354\244\204 2\n"..., 690) = 690
close(3)                                = 0
+++ exited with 0 +++
세 가지를 확인할 수 있습니다.
fopen(..., "w")는 정말로O_WRONLY|O_CREAT|O_TRUNC로openat을 부릅니다. 9주차에서 “쓰기 모드로 열면 기존 내용이 지워진다”고 배운 이유가O_TRUNC입니다.fprintf100번이write한 번(690바이트) 으로 나갔습니다. 1.3절의 버퍼링입니다. 파일은 전체 버퍼링이라fclose때 한꺼번에 나갑니다.- 권한 인자가
0666입니다.rw-rw-rw-, 즉 “모두에게 읽기·쓰기”를 요청했습니다. 그런데 만들어진 파일을 보면 그렇지 않습니다.
$ ls -l ft.txt
-rw-rw-r-- 1 user user 690  9월 29 02:19 ft.txt
rw-rw-r--(664)입니다. 요청한 666 에서 “기타 사용자의 쓰기”가 빠졌습니다. 1주차 9절에서 본 umask 가 여기서도 작용한 것입니다. 프로그램이 요청한 권한에서 umask(우분투 기본값 002)만큼을 빼고 만드는 규칙이죠. open 도 똑같습니다. 직접 확인해 봅시다.
#include <stdio.h>
#include <unistd.h>
#include <fcntl.h>
#include <sys/stat.h>

int main(void) {
    mode_t old = umask(0);          /* 현재 umask 를 읽는 유일한 방법: 바꾸면서 옛 값을 받는다 */
    umask(old);
    printf("현재 umask = %03o\n", old);
    int fd = open("m666.txt", O_WRONLY | O_CREAT | O_TRUNC, 0666);
    close(fd);
    fd = open("m777.txt", O_WRONLY | O_CREAT | O_TRUNC, 0777);
    close(fd);
    fd = open("m600.txt", O_WRONLY | O_CREAT | O_TRUNC, 0600);
    close(fd);
    struct stat st;
    const char *names[] = {"m666.txt", "m777.txt", "m600.txt"};
    const char *want[]  = {"666", "777", "600"};
    for (int i = 0; i < 3; i++) {
        stat(names[i], &st);
        printf("%s: 요청 %s -> 실제 %03o\n", names[i], want[i], st.st_mode & 0777);
    }
    return 0;
}
$ ./umask_test
현재 umask = 002
m666.txt: 요청 666 -> 실제 664
m777.txt: 요청 777 -> 실제 775
m600.txt: 요청 600 -> 실제 600
umask 함수는 새 값을 설정하면서 옛 값을 돌려주는 구조라, “읽기만” 하려면 아무 값으로 바꿨다가 바로 되돌려야 합니다. 조금 불편하지만 그렇게 정해져 있습니다. 결과를 보면 규칙이 분명합니다. 요청 권한 AND NOT umask. 600 은 umask 에 걸리는 비트가 없어서 그대로입니다.
그래서 관례가 있습니다. 프로그램은 0666(일반 파일)이나 0777(실행 파일, 디렉터리)처럼 넉넉하게 요청하고, 실제 권한은 사용자의 umask 에 맡깁니다. gcc 가 만든 실행 파일이 1주차에서 rwxrwxr-x 였던 것도 gcc 가 777 을 요청하고 umask 002 가 빼 준 결과입니다. 이번 주 예제가 0644 를 직접 준 것은 “이 파일은 남이 고치면 안 된다”는 의도를 코드에 박아 둔 것이고요.
권한 인자를 빼먹으면?
open("x", O_WRONLY | O_CREAT)처럼 세 번째 인자 없이O_CREAT를 쓰면 어떻게 될까요? 직접 해 봤습니다.-O0으로는-Wall -Wextra를 켜도 경고 없이 컴파일되고, 만들어진 파일의 권한은 이랬습니다.$ ls -l nomode.txt -rws--s--T 1 user user 0 9월 29 02:24 nomode.txt
rws--s--T— 1주차에서 본 적 없는 글자들이 섞인 엉터리 권한입니다. 커널이 세 번째 인자 자리에 우연히 남아 있던 쓰레기 값을 권한으로 썼기 때문입니다. C 는 인자 개수를 검사해 주지 않습니다. 다행히-O2로 컴파일하면 우분투의 glibc 가 이 실수를 잡아 컴파일 오류를 냅니다(open with O_CREAT ... needs 3 arguments). 하지만 이 강좌는 배우는 동안-O0을 쓰므로 그 보호막이 없습니다.O_CREAT를 쓸 때는 반드시 권한을 함께 주세요.
2.4 미니 cp: 열 줄짜리 파일 복사
    char buffer[4096];               /* 4KB: 페이지 크기와 맞춘 관례 */
    ssize_t got;
    long total = 0;
    while ((got = read(src, buffer, sizeof(buffer))) > 0) {
        ssize_t put = write(dst, buffer, (size_t)got);
        if (put != got) {            /* 부분 쓰기 검사 (디스크 꽉참 등) */
            perror("write");
            break;
        }
        total += put;
    }
    if (got < 0) perror("read");
cp 명령의 심장이 이 열 줄입니다. 읽고, 쓰고, 반복. 세부를 하나씩 봅시다.
버퍼 크기 4096: 리눅스의 메모리 페이지 크기입니다. getconf PAGESIZE 를 치면 4096 이 나옵니다. 1.3절의 실험에서 봤듯 너무 작으면 시스템 콜이 많아지고, 너무 크면 메모리만 낭비합니다. 4KB 에서 64KB 사이가 관례적인 선택입니다.
while ((got = read(...)) > 0): 3주차에서 본 “대입하면서 비교하는” 관용구입니다. read 의 반환값을 got 에 넣고, 그것이 양수인 동안 반복합니다. 0(끝)이나 -1(오류)이 나오면 빠져나옵니다.
write(dst, buffer, got): 세 번째 인자가 sizeof(buffer) 가 아니라 got 입니다. 마지막 읽기에서는 버퍼가 꽉 차지 않으니(위의 strace 에서 74바이트) 실제로 읽은 만큼만 써야 합니다. sizeof(buffer) 로 쓰면 파일 끝에 버퍼에 남아 있던 쓰레기 4022바이트가 붙습니다. 초보자가 정말 자주 하는 실수입니다.
put != got 검사: write 도 요청한 만큼 다 못 쓸 수 있습니다. 디스크가 꽉 찼거나, 파이프의 상대가 느릴 때입니다. 견고한 도구는 이것도 확인합니다.
if (got < 0) perror("read"): 루프가 끝난 이유가 “끝”인지 “오류”인지 구분합니다. 0 이면 정상, -1 이면 오류입니다.
2.5 read 반환값 3형제
이번 주에서 가장 중요한 것 하나를 꼽으라면 이것입니다.
| 반환값 | 의미 |
|---|---|
| > 0 | 읽은 바이트 수. 요청보다 적을 수 있다! |
| == 0 | 끝(EOF). 파일이 끝났거나, 상대가 연결을 닫았다 |
| < 0 | 오류. errno 를 본다 |
“요청보다 적을 수 있다”가 정말인지 실험해 봅시다. 4096 바이트씩 요청하며 표준 입력(0번)을 읽고, 매번 몇 바이트를 받았는지 찍는 프로그램입니다.
#include <stdio.h>
#include <unistd.h>

int main(void) {
    char buf[4096];
    ssize_t n;
    int round = 0;
    while ((n = read(0, buf, sizeof(buf))) > 0) {
        printf("read #%d: 4096바이트 요청 -> %zd바이트 받음\n", ++round, n);
    }
    printf("read #%d: 반환 %zd (EOF)\n", ++round, n);
    return 0;
}
파일, 파이프, 그리고 천천히 도착하는 파이프에 각각 물려 봅니다.
$ ./partial < /etc/hostname
read #1: 4096바이트 요청 -> 19바이트 받음
read #2: 반환 0 (EOF)

$ head -c 10000 /usr/bin/bash | ./partial
read #1: 4096바이트 요청 -> 4096바이트 받음
read #2: 4096바이트 요청 -> 4096바이트 받음
read #3: 4096바이트 요청 -> 1808바이트 받음
read #4: 반환 0 (EOF)

$ (printf 'abc'; sleep 0.3; printf 'defgh') | ./partial
read #1: 4096바이트 요청 -> 3바이트 받음
read #2: 4096바이트 요청 -> 5바이트 받음
read #3: 반환 0 (EOF)
마지막 실험을 보세요. 8바이트짜리 데이터인데 read 는 3바이트, 5바이트로 나눠 받았습니다. 상대가 3바이트를 보내고 0.3초 쉬었다가 5바이트를 보냈기 때문입니다. read 는 “지금 도착해 있는 만큼”을 돌려줄 뿐, 우리가 요청한 양을 채워 주려고 기다리지 않습니다.
파일에서는 이 상황이 드물어서 대충 짜도 대개 동작합니다. 그런데 파이프(19주차)와 소켓(21주차)에서는 일상입니다. “당연히 다 읽었겠지”라고 가정한 코드가 네트워크에서 산산조각 나는 것이 초보 네트워크 프로그래머의 통과 의례입니다. 지금부터 몸에 새겨 두세요. read 의 반환값을 반드시 확인하고, 필요한 양이 정해져 있으면 루프로 채운다.
2.6 FILE* 와 fd 의 관계
fileno(stdin)=0, fileno(stdout)=1, fileno(stderr)=2
9주차의 FILE * 는 사실 fd 위에 버퍼를 씌운 포장지였습니다.
FILE = { fd 번호, 버퍼(보통 4096바이트), 버퍼 안의 현재 위치, 오류 플래그, EOF 플래그, ... }
fileno(fp) 로 속의 fd 를 꺼낼 수 있고, 반대로 fdopen(fd, "r") 로 fd 를 FILE * 로 감쌀 수도 있습니다. 두 세계를 오갈 수 있는 것이죠.
언제 무엇을 쓸까요?
FILE * (stdio) |
fd (시스템 콜) | |
|---|---|---|
| 버퍼링 | 자동 | 없음 (직접 관리) |
| 서식 | fprintf, fscanf |
없음 (snprintf 로 만들어서 write) |
| 이식성 | C 표준. 윈도우에서도 됨 | POSIX. 유닉스 계열 |
| 세밀한 제어 | 어려움 | 가능 (권한, 플래그, 논블로킹, 시그널 반응) |
| 파이프·소켓·장치 | 어색함 | 자연스러움 |
일반적인 파일 입출력은 FILE * 가 편하고, 시스템 프로그래밍(프로세스 간 통신, 네트워크, 장치 제어)에서는 fd 가 필수입니다. 섞어 쓰는 것은 조심하세요. 1.3절의 mix 실험에서 봤듯, 같은 곳에 printf 와 write 를 섞으면 버퍼 때문에 순서가 꼬입니다.
3. fork: 프로세스가 세포분열하다
3.1 프로세스란 무엇인가 — 먼저 눈으로 보기
fork 를 배우기 전에 프로세스가 무엇인지 확실히 해 둡시다. 프로그램은 디스크에 있는 파일(hello)이고, 프로세스는 그 프로그램이 메모리에 올라가 실행되고 있는 상태입니다. 같은 프로그램을 두 번 실행하면 프로세스는 둘입니다. 커널은 프로세스마다 PID(process ID)라는 번호를 붙이고, 누가 누구를 만들었는지(부모 PID, PPID)를 기록합니다.
지금 쓰고 있는 쉘도 프로세스입니다. $$ 는 쉘 자신의 PID 를 담은 특수 변수입니다.
$ echo $$
313148
$ ps -o pid,ppid,comm -p $$
    PID    PPID COMMAND
 313148    7121 bash
쉘의 PID 는 313148 이고, 이 쉘을 만든 부모는 7121 입니다. 부모의 부모를 계속 따라가면 어디까지 갈까요? pstree 가 그려 줍니다.
$ pstree -p -s $$
systemd(1)---systemd(1674)---gnome-terminal-(6105)---bash(6371)---(중략)---bash(313148)---pstree(313360)
맨 왼쪽의 systemd(1) 이 부팅할 때 커널이 처음 만드는 프로세스입니다. 그 아래로 터미널 프로그램, 그 아래로 쉘, 그 아래로 지금 실행한 pstree 까지 한 그루의 나무입니다. 12주차에서 배운 트리가 여기서도 나옵니다. 그리고 이 나무의 모든 가지는 딱 하나의 방법으로 뻗어 나갑니다. 그것이 fork 입니다.
3.2 한 번 호출, 두 번 반환
fork() 는 유닉스에서 가장 철학적인 시스템 콜입니다. 호출하는 순간 프로세스가 통째로 복제되어 둘이 됩니다. 코드도, 변수도, 열려 있던 파일도 같은 것을 가진 프로세스가 하나 더 생깁니다. 원래 것을 부모, 새로 생긴 것을 자식이라고 부릅니다.
그리고 가장 기묘한 성질이 여기 있습니다.
한 번 호출했는데 두 번 반환됩니다.
pid_t pid = fork();
if (pid == 0) {
    /* 자식: fork 가 0 을 돌려줬다 */
} else if (pid > 0) {
    /* 부모: fork 가 자식의 PID 를 돌려줬다 */
} else {
    /* 실패: -1. 프로세스를 더 만들 수 없을 때 */
}
호출한 프로세스(부모)에서 한 번, 새로 생긴 프로세스(자식)에서 한 번. 같은 코드의 같은 줄에서 두 프로세스가 각자 다른 값을 받고 깨어납니다. 반환값이 다른 것이 유일한 구분법입니다. 왜 자식에게는 0 을 줄까요? 자식은 getppid() 로 부모를 언제든 알 수 있지만, 부모는 자식이 여럿일 수 있어서 방금 누가 태어났는지 알려 줄 필요가 있기 때문입니다. pid_t 는 PID 를 담는 정수 타입으로, <sys/types.h> 에 정의돼 있고 %d 로 찍으면 됩니다.
examples/fork_basic.c:
/*
 * fork_basic.c - fork: 프로세스가 세포분열하다
 * 18주차: POSIX 시스템 프로그래밍
 *
 * fork()는 유닉스에서 가장 철학적인 시스템 콜입니다.
 * 호출하는 순간 프로세스가 통째로 복제되어 둘이 됩니다.
 *
 * 가장 기묘한 점: "한 번 호출했는데 두 번 반환된다!"
 *   부모에게는 -> 자식의 PID
 *   자식에게는 -> 0
 * 이 반환값 차이로 "내가 부모인가 자식인가"를 구분합니다.
 *
 * 메모리는 복사되므로(정확히는 Copy-On-Write) 이후는 완전 독립!
 */
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <sys/wait.h>

int main(void) {
    printf("=== 1. fork의 기본: 하나가 둘이 된다 ===\n");
    printf("fork 전: 나의 PID = %d (프로세스는 1개)\n\n", getpid());
    fflush(stdout);      /* fork 전에 버퍼 비우기! (안 하면 출력이 복제된다) */

    pid_t pid = fork();

    if (pid < 0) {
        perror("fork");
        return 1;
    }

    if (pid == 0) {
        /* ---------- 자식만 실행하는 영역 ---------- */
        printf("[자식] fork()가 %d를 반환. 내 PID=%d, 부모 PID=%d\n",
               pid, getpid(), getppid());
    } else {
        /* ---------- 부모만 실행하는 영역 ---------- */
        printf("[부모] fork()가 %d(자식 PID)를 반환. 내 PID=%d\n",
               pid, getpid());
        wait(NULL);              /* 자식이 끝날 때까지 대기 */
    }

    /* 여기부터는 둘 다 실행! */
    printf("[%s] 공통 코드도 각자 실행한다 (PID %d)\n",
           pid == 0 ? "자식" : "부모", getpid());

    if (pid == 0) {
        exit(0);                 /* 자식은 여기서 하차 (아래 실험은 부모만) */
    }

    /* ---------- 2. 메모리 독립성 실험 ---------- */
    printf("\n=== 2. 변수는 복사된다 (공유 아님!) ===\n");
    fflush(stdout);

    int counter = 100;
    pid = fork();
    if (pid == 0) {
        counter += 1;            /* 자식이 자기 사본을 수정 */
        printf("[자식] counter를 1 더했다: %d\n", counter);
        exit(0);
    }
    wait(NULL);
    printf("[부모] 내 counter는 그대로: %d\n", counter);
    printf("-> fork 순간의 값을 '복사'했을 뿐, 이후는 남남!\n");
    printf("   (커널은 Copy-On-Write로 실제 복사를 수정 순간까지 미룬다)\n");

    /* ---------- 3. fork 폭탄의 원리 (직접 돌리진 마세요!) ---------- */
    printf("\n=== 3. fork를 반복하면? ===\n");
    fflush(stdout);

    /* 2번 fork -> 프로세스 4개 (각자 인사) */
    fork();
    fork();
    printf("PID %d 출석!\n", getpid());
    /* 4개가 출력된다: 1 -> 2 -> 4 (지수 증가!)
     * while(1) fork(); 가 시스템을 마비시키는 'fork 폭탄'인 이유 */

    /* 부모만 정리 메시지 (제일 작은 PID가 원조 부모라는 보장은 없지만
     * 여기선 wait로 전부 수거하는 시늉만) */
    while (wait(NULL) > 0) {}    /* 내 자식들 모두 수거 */

    return 0;
}
새로 나온 것들입니다.
#include <sys/wait.h>:wait가족이 선언된 헤더입니다. 4절에서 자세히 봅니다.getpid(),getppid(): 내 PID, 부모 PID 를 돌려줍니다. 실패하지 않는 드문 시스템 콜입니다.fflush(stdout)가fork직전마다 있는 것: 3.4절에서 실험으로 이유를 봅니다.wait(NULL): 자식이 끝날 때까지 기다립니다.NULL은 “종료 코드는 필요 없다”는 뜻입니다.exit(0):return 0과 비슷하지만 함수 어디서든 프로그램을 끝냅니다. 자식이 부모의 나머지 코드를 실행하지 않게 하려고 씁니다.
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/fork_basic.c -o build/fork_basic
$ ./build/fork_basic
=== 1. fork의 기본: 하나가 둘이 된다 ===
fork 전: 나의 PID = 306685 (프로세스는 1개)

[자식] fork()가 0를 반환. 내 PID=306686, 부모 PID=306685
[자식] 공통 코드도 각자 실행한다 (PID 306686)
[부모] fork()가 306686(자식 PID)를 반환. 내 PID=306685
[부모] 공통 코드도 각자 실행한다 (PID 306685)

=== 2. 변수는 복사된다 (공유 아님!) ===
[자식] counter를 1 더했다: 101
[부모] 내 counter는 그대로: 100
-> fork 순간의 값을 '복사'했을 뿐, 이후는 남남!
   (커널은 Copy-On-Write로 실제 복사를 수정 순간까지 미룬다)

=== 3. fork를 반복하면? ===
PID 306689 출석!
PID 306690 출석!
PID 306688 출석!
PID 306685 출석!
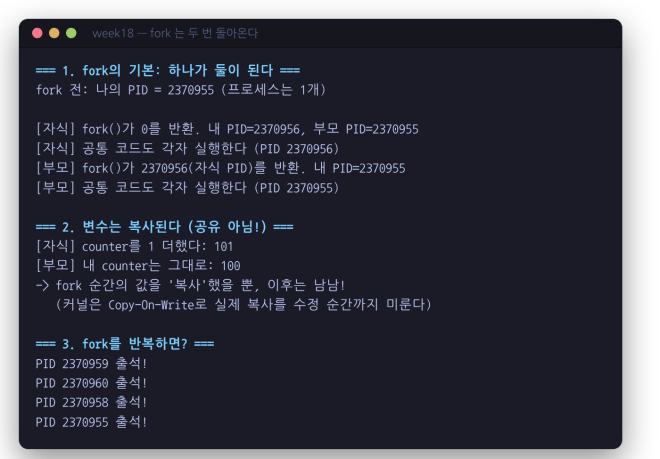
fork 는 두 번 돌아온다
첫 실험을 표로 정리하면 fork 의 성질이 한눈에 들어옵니다.
| 부모 | 자식 | |
|---|---|---|
fork() 반환값 |
306686 (자식 PID) | 0 |
getpid() |
306685 | 306686 |
getppid() |
(쉘) | 306685 |
자식의 getppid() 가 부모의 getpid() 와 같습니다. 3.1절에서 본 프로세스 나무에 가지가 하나 뻗은 것입니다. “공통 코드”가 두 번 찍힌 것도 보세요. if/else 밖의 코드는 두 프로세스가 각자 실행합니다. fork 뒤의 모든 코드는 기본적으로 두 번 실행된다고 생각해야 합니다.
3.3 메모리는 복사된다, 공유가 아니다
두 번째 실험이 중요합니다. 자식이 counter 를 101 로 바꿨는데 부모의 counter 는 100 그대로입니다.
fork 는 복사입니다. 공유가 아닙니다. fork 순간의 메모리 상태를 그대로 본뜬 뒤, 이후로는 완전히 남남입니다. 자식이 무엇을 하든 부모에게 영향이 없고 그 반대도 마찬가지입니다. 1주차에서 “cd 는 왜 쉘 내장 명령이어야 하나”라고 물었던 답이 여기 있습니다. cd 를 별도 프로세스로 만들면 그 프로세스가 자기 작업 디렉터리를 바꾸고 끝날 뿐, 쉘의 작업 디렉터리는 그대로입니다. 프로젝트 1 에서 이것을 코드로 확인합니다.
그런데 의문이 생깁니다. 수 GB 짜리 프로세스를 fork 하면 그걸 다 복사하나요? 그러면 fork 한 번에 몇 초가 걸릴 텐데요.
답은 Copy-On-Write(COW, 쓸 때 복사) 입니다. 커널은 fork 시점에 메모리를 실제로 복사하지 않습니다. 부모와 자식이 같은 물리 메모리를 읽기 전용으로 공유하게 해 두고, 둘 중 하나가 쓰려고 할 때 그 페이지(4KB)만 복사합니다. 위 실험에서 자식이 counter += 1 을 하는 순간, counter 가 들어 있는 4KB 한 장만 복사된 것입니다. 덕분에 fork 는 아주 빠르고, fork 직후 바로 exec 하는 흔한 패턴(4절)에서는 복사가 거의 일어나지 않습니다. 어차피 exec 가 메모리를 통째로 갈아엎으니까요.
3.4 fork 전에는 fflush — 실험으로 보는 이유
코드에 fflush(stdout) 이 fork 직전마다 있었습니다. 빼면 어떻게 될까요? 빼고 만든 프로그램입니다.
#include <stdio.h>
#include <unistd.h>
#include <sys/wait.h>

int main(void) {
    printf("fork 전에 찍은 줄 (버퍼에만 있을 수 있음)\n");
    pid_t pid = fork();
    if (pid == 0) {
        printf("[자식] 안녕\n");
        return 0;
    }
    wait(NULL);
    printf("[부모] 끝\n");
    return 0;
}
터미널에서 실행하면 멀쩡해 보입니다.
$ ./noflush
fork 전에 찍은 줄 (버퍼에만 있을 수 있음)
[자식] 안녕
[부모] 끝
그런데 출력을 파일로 보내면 이렇게 됩니다.
$ ./noflush > out.txt
$ cat out.txt
fork 전에 찍은 줄 (버퍼에만 있을 수 있음)
[자식] 안녕
fork 전에 찍은 줄 (버퍼에만 있을 수 있음)
[부모] 끝
“fork 전에 찍은 줄”이 두 번 나왔습니다. printf 는 한 번만 불렀는데요.
1.3절의 버퍼링 표를 떠올리면 풀립니다. 파일로 보낼 때는 전체 버퍼링이라, 첫 printf 의 글자는 write 되지 않고 stdio 버퍼에 남아 있었습니다. 그 상태에서 fork 가 메모리를 복제했으니 버퍼도 복제됐고, 부모와 자식이 프로그램을 끝낼 때 각자 자기 버퍼를 비웠습니다. 그래서 두 번입니다. 터미널에서는 줄 버퍼링이라 \n 에서 이미 나가 버려서 버퍼가 비어 있었고요.
이 버그의 무서운 점은 터미널에서는 안 보인다는 것입니다. 개발할 때는 멀쩡하다가 로그 파일로 돌리는 순간 줄이 두 배로 늘어납니다. 그래서 규칙이 있습니다. fork 전에는 fflush(stdout). 이번 주 프로젝트 3 의 데몬에도 이 실수가 하나 숨어 있었는데, 그 이야기는 10절에서 합니다.
3.5 누가 먼저 실행될까 — 보장은 없다
fork 직후 부모와 자식 중 누가 먼저 CPU 를 잡을까요? 아무것도 기다리지 않고 각자 한 줄씩 찍는 프로그램입니다.
#include <stdio.h>
#include <unistd.h>
#include <sys/wait.h>

int main(void) {
    fflush(stdout);
    pid_t pid = fork();
    if (pid == 0) {
        printf("자식\n");
        return 0;
    }
    printf("부모\n");
    wait(NULL);
    return 0;
}
터미널에서 여섯 번 돌렸습니다.
$ for i in 1 2 3 4 5 6; do ./order; done
부모
자식
부모
자식
...
이 컴퓨터에서는 여섯 번 모두 부모가 먼저였습니다. 그러면 “부모가 먼저”라고 믿어도 될까요? 안 됩니다. 부모 쪽에 usleep(1000)(1밀리초)을 넣으면 곧바로 뒤집힙니다.
$ ./order2          # 부모가 출력 전에 1ms 쉰다
자식
부모
누가 먼저 도는지는 코드의 순서가 아니라 커널의 스케줄러가 그때그때 정합니다. CPU 개수, 다른 프로세스의 상태, 운에 따라 바뀝니다. 결과가 순서에 의존하는 코드는 언젠가 반드시 깨집니다. 순서가 중요하면 wait(4절)로 명시적으로 기다리거나, 19주차의 동기화 도구를 써야 합니다. 이 성질을 경쟁 조건(race condition) 이라고 부르고, 20주차 멀티스레딩의 핵심 주제입니다.
한 가지 더. 같은
order를 파이프에 물리면(./order | cat) 항상 “자식, 부모” 순서로 나옵니다. 스케줄링이 달라진 게 아닙니다. 파이프는 전체 버퍼링이라 부모의printf가 버퍼에 남았다가wait가 끝난 뒤 프로그램 종료 시점에 나가기 때문입니다. 출력 순서로 실행 순서를 추측할 때는 버퍼링을 먼저 의심하세요.
3.6 fork 폭탄의 원리
세 번째 실험은 fork 를 두 번 연속 호출합니다.
    fork();
    fork();
    printf("PID %d 출석!\n", getpid());
출력이 4줄 나옵니다. 첫 fork 로 2개, 각각이 두 번째 fork 를 실행해 4개가 되죠. 1 → 2 → 4 → 8… 지수 증가입니다. 세 번 돌려 보면 출력 순서가 매번 조금씩 다릅니다. 3.5절에서 말한 스케줄러 때문입니다.
$ ./build/fork_basic | grep 출석 | tr '\n' ' '
PID 313385 출석! PID 313386 출석! PID 313384 출석! PID 313378 출석!
$ ./build/fork_basic | grep 출석 | tr '\n' ' '
PID 313394 출석! PID 313395 출석! PID 313393 출석! PID 313387 출석!
그래서 이런 코드가 유명합니다.
while (1) fork(); /* 절대 실행하지 마세요! */
fork 폭탄입니다. 프로세스 수가 지수적으로 폭발해 프로세스 테이블을 고갈시키고, 시스템 전체가 응답하지 않게 됩니다. 재부팅 말고는 답이 없는 경우가 많습니다. 쉘에서 :(){ :|:& };: 같은 난해한 문자열을 본 적이 있다면, 그것도 같은 원리의 bash 버전입니다. 인터넷에서 본 명령어를 이해하지 못한 채 실행하지 마세요.
리눅스는 사용자당 프로세스 수를 제한할 수 있습니다.
$ ulimit -u
116220
이 컴퓨터는 한 사용자가 116,220 개까지 만들 수 있습니다. 개발 서버라면 이 값을 낮춰 두는 것이 안전합니다.
3.7 fork 의 정체는 clone — strace 로 보기
strace 에 -f (follow, 자식까지 따라가기) 옵션을 주면 fork 가 커널에 무엇으로 도착하는지 보입니다. 3.5절의 order 로 확인했습니다.
$ strace -f -e trace=clone,wait4,exit_group ./order > /dev/null
clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x791fe5ce0a10) = 316379
strace: Process 316379 attached
[pid 316378] wait4(-1,  <unfinished ...>
[pid 316379] exit_group(0)              = ?
[pid 316379] +++ exited with 0 +++
<... wait4 resumed>NULL, 0, NULL)       = 316379
--- SIGCHLD {si_signo=SIGCHLD, si_code=CLD_EXITED, si_pid=316379, ...} ---
exit_group(0)                           = ?
+++ exited with 0 +++
우리는 fork() 를 불렀는데 커널에 도착한 것은 clone 입니다. 리눅스는 프로세스와 스레드(20주차)를 같은 clone 시스템 콜로 만들고, 플래그로 “무엇을 공유할지”를 정합니다. fork 는 아무것도 공유하지 않는 clone 입니다. 마지막 인자에 붙은 SIGCHLD 는 “자식이 끝나면 이 시그널로 알려 달라”는 뜻이고, 그 결과가 아래쪽의 --- SIGCHLD ... --- 줄입니다. wait(NULL) 은 wait4 로 도착했고, 자식이 exit_group 으로 끝나자 wait4 가 자식의 PID 316379 를 돌려주며 깨어났습니다.
이 한 화면에 3, 4, 6절의 내용이 전부 들어 있습니다. 프로세스 생성(clone), 대기(wait4), 종료(exit_group), 그리고 커널의 알림(SIGCHLD)입니다.
4. exec와 wait: 쉘의 3박자
4.1 exec는 변신이다 — PID 가 그대로인 것을 확인하기
fork 가 “복제”라면 exec 는 “변신” 입니다. exec 계열 함수를 부르면 현재 프로세스의 메모리가 통째로 새 프로그램으로 교체됩니다. 새 프로세스가 생기는 것이 아니라, 같은 프로세스가 다른 프로그램이 되는 것입니다. 정말 같은 프로세스인지 PID 로 확인해 봅시다.
#include <stdio.h>
#include <unistd.h>

int main(void) {
    printf("exec 전: 나는 exec_pid, PID = %d\n", getpid());
    fflush(stdout);
    execlp("sh", "sh", "-c", "echo \"exec 후: 나는 sh, PID = $$\"", NULL);
    perror("execlp");
    return 1;
}
$ ./exec_pid
exec 전: 나는 exec_pid, PID = 315860
exec 후: 나는 sh, PID = 315860
exec_pid 였던 프로세스가 sh 가 됐는데 PID 는 315860 그대로입니다. sh -c 안의 $$ 는 3.1절에서 본 “쉘 자신의 PID” 변수인데, 그 값이 exec 전에 찍은 getpid() 와 같습니다. 바뀌는 것과 유지되는 것을 정리하면 이렇습니다.
| 바뀐다 | 유지된다 |
|---|---|
| 코드, 데이터, 힙, 스택 (메모리 전부) | PID, 부모 PID |
| 프로그램 이름 | 열린 파일 디스크립터 (기본적으로) |
| 시그널 핸들러 (기본 동작으로 초기화) | 무시(SIG_IGN)로 설정한 시그널 |
| 현재 작업 디렉터리, umask |
fd 가 유지된다는 점이 프로젝트 1 의 리다이렉션의 핵심 원리입니다. exec 전에 1번 fd 를 파일로 바꿔 두면, 새 프로그램은 그 사실을 모른 채 1번에 쓰고, 그 출력이 파일로 갑니다.
4.2 fork + exec + wait
examples/exec_wait.c:
/*
 * exec_wait.c - fork + exec + wait: 쉘의 3박자
 * 18주차: POSIX 시스템 프로그래밍
 *
 * fork는 "복제"고, exec는 "변신"입니다.
 * exec 계열을 호출하면 현재 프로세스의 메모리가 통째로
 * 새 프로그램으로 교체됩니다 (PID는 그대로!).
 *
 * 여러분이 터미널에 ls를 치면 bash가 하는 일:
 *   1. fork()  - 자신을 복제
 *   2. exec()  - 자식이 ls로 변신
 *   3. wait()  - 부모(bash)는 끝나기를 기다림
 * 이 3박자가 유닉스 프로세스 모델의 전부입니다!
 */
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <sys/wait.h>

int main(void) {
    printf("=== 1. exec: 프로세스 변신 ===\n");
    printf("자식을 만들어 'echo' 명령으로 변신시킵니다.\n\n");
    fflush(stdout);

    pid_t pid = fork();
    if (pid == 0) {
        /* execlp: PATH에서 프로그램을 찾아 변신
         * 인자: 프로그램, argv[0], argv[1], ..., NULL 종결자! */
        execlp("echo", "echo", "[echo] 나는 exec로 변신한 자식!", NULL);

        /* exec가 성공하면 아래 줄은 '존재하지 않는 코드'가 된다.
         * 여기 도달했다 = exec 실패! */
        perror("execlp");
        exit(127);               /* 127 = 명령을 찾을 수 없음 (쉘 관례) */
    }
    wait(NULL);

    /* ---------- 2. exec 실패 처리 ---------- */
    printf("\n=== 2. 없는 명령이면? ===\n");
    fflush(stdout);

    pid = fork();
    if (pid == 0) {
        execlp("no_such_command_xyz", "no_such_command_xyz", NULL);
        perror("[자식] execlp");         /* 반드시 이 줄이 실행된다 */
        exit(127);
    }

    int status;
    waitpid(pid, &status, 0);            /* 특정 자식을 콕 집어 대기 */

    /* ---------- 3. 종료 상태 해부 ---------- */
    printf("\n=== 3. 종료 상태 읽기 (wait의 보고서) ===\n");
    if (WIFEXITED(status)) {
        printf("자식이 정상 종료. exit 코드 = %d (127 = 명령 없음)\n",
               WEXITSTATUS(status));
    } else if (WIFSIGNALED(status)) {
        printf("자식이 시그널 %d로 사망\n", WTERMSIG(status));
    }

    /* ---------- 4. execvp: 배열 버전 (쉘이 실제 쓰는 것) ---------- */
    printf("\n=== 4. execvp: 인자를 배열로 (미니 쉘의 핵심 부품) ===\n");
    fflush(stdout);

    /* 쉘이 "ls -l /etc/hostname /etc/passwd" 를 받았다면 이런 배열을 만든다.
     * argv[0] = 프로그램 이름, 마지막은 반드시 NULL! */
    char *argv_ls[] = {"ls", "-l", "/etc/hostname", "/etc/passwd", NULL};
    printf("실행: ls -l /etc/hostname /etc/passwd\n");
    fflush(stdout);

    pid = fork();
    if (pid == 0) {
        execvp(argv_ls[0], argv_ls);     /* PATH 에서 ls 를 찾아 변신 */
        perror("execvp");
        exit(127);
    }
    waitpid(pid, &status, 0);

    printf("\n=== 5. 쉘의 정체 요약 ===\n");
    printf("while (1) {\n");
    printf("    명령 입력받기;\n");
    printf("    pid = fork();\n");
    printf("    if (pid == 0) { execvp(명령, 인자들); exit(127); }\n");
    printf("    waitpid(pid, &status, 0);\n");
    printf("}\n");
    printf("-> 이번 주 프로젝트에서 진짜로 만듭니다!\n");
    return 0;
}
새로 나온 것들입니다.
execlp("echo", "echo", "...", NULL):exec가족의 하나입니다(4.4절에 표가 있습니다). 첫 인자는 찾을 프로그램, 그다음부터는 그 프로그램에 넘길argv[0],argv[1], … 이고, 마지막은 반드시NULL입니다.exit(127):exec가 실패했을 때의 종료 코드입니다. 1주차에서 없는 명령을 치면$?가 127 이었죠. 쉘의 관례입니다.waitpid(pid, &status, 0): 특정 자식을 콕 집어 기다리고, 종료 상태를status에 받습니다. 4.5절에서 해부합니다.WIFEXITED,WEXITSTATUS,WIFSIGNALED,WTERMSIG:status를 읽는 매크로들입니다. 역시 4.5절에서.char *argv_ls[] = {"ls", "-l", "/etc/hostname", "/etc/passwd", NULL}: 쉘이 명령줄을 잘라 만드는 바로 그 배열입니다.NULL종결을 잊지 마세요.execvp(argv_ls[0], argv_ls): 배열 버전exec. 미니 쉘의 핵심 부품입니다.
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/exec_wait.c -o build/exec_wait
$ ./build/exec_wait
=== 1. exec: 프로세스 변신 ===
자식을 만들어 'echo' 명령으로 변신시킵니다.

[echo] 나는 exec로 변신한 자식!

=== 2. 없는 명령이면? ===
[자식] execlp: No such file or directory

=== 3. 종료 상태 읽기 (wait의 보고서) ===
자식이 정상 종료. exit 코드 = 127 (127 = 명령 없음)

=== 4. execvp: 인자를 배열로 (미니 쉘의 핵심 부품) ===
실행: ls -l /etc/hostname /etc/passwd
-rw-r--r-- 1 root root   19  1월 12  2026 /etc/hostname
-rw-r--r-- 1 root root 3162  7월 15 08:40 /etc/passwd

=== 5. 쉘의 정체 요약 ===
while (1) {
    명령 입력받기;
    pid = fork();
    if (pid == 0) { execvp(명령, 인자들); exit(127); }
    waitpid(pid, &status, 0);
}
-> 이번 주 프로젝트에서 진짜로 만듭니다!
4번 실험의 출력은 ls 가 찍은 것입니다. 우리 프로그램에는 ls 코드가 한 줄도 없는데, 자식이 ls 로 변신해서 일을 하고 사라진 것입니다.
4.3 exec 뒤의 코드는 존재하지 않는다
        execlp("echo", "echo", "[echo] 나는 exec로 변신한 자식!", NULL);

        /* exec가 성공하면 아래 줄은 '존재하지 않는 코드'가 된다.
         * 여기 도달했다 = exec 실패! */
        perror("execlp");
        exit(127);               /* 127 = 명령을 찾을 수 없음 (쉘 관례) */
exec 가 성공하면 그 아래 코드는 영원히 실행되지 않습니다. 메모리가 통째로 교체됐으니 “그 아래 코드”라는 것이 이미 존재하지 않기 때문입니다. 그래서 exec 는 성공하면 돌아오지 않는 함수입니다. 반환값을 검사하는 if 도 필요 없습니다. 다음 줄에 도달했다는 것 자체가 실패의 증거니까요. 2번 실험이 그것을 보여 줍니다. 없는 명령이라 execlp 가 돌아왔고, perror 가 실행됐고, exit(127) 로 끝났습니다.
perror 가 찍은 No such file or directory 는 1.4절 표의 ENOENT 입니다. execlp 가 PATH 의 모든 폴더에서 그 이름을 찾지 못했다는 뜻입니다. 1주차 2절에서 “명령을 찾을 수 없습니다”가 PATH 때문이라고 했는데, 그 판단을 하는 코드가 바로 execlp/execvp 안에 있습니다.
4.4 exec 계열 6형제와 PATH 검색
exec 는 함수가 하나가 아니라 여섯입니다. 이름의 접미사가 차이를 말해 줍니다.
| 함수 | 인자 전달 | PATH 검색 | 환경 변수 |
|---|---|---|---|
execl |
list: 나열 | 안 함 (전체 경로 필요) | 상속 |
execlp |
list | path 검색 | 상속 |
execle |
list | 안 함 | env 직접 지정 |
execv |
vector: 배열 | 안 함 | 상속 |
execvp |
vector | path 검색 | 상속 |
execvpe |
vector | path 검색 | env 지정 |
- l 과 v: 인자를 나열로 주느냐(
execlp("ls", "ls", "-l", NULL)), 배열로 주느냐(execvp("ls", argv)). 인자 개수를 컴파일할 때 아는 경우는l, 실행할 때 정해지면v입니다. 쉘은 사용자가 몇 개를 칠지 모르니v입니다. - p:
PATH환경 변수에서 프로그램을 찾아 줍니다.p가 없으면/bin/ls처럼 전체 경로를 줘야 합니다. - e: 새 프로그램에 넘길 환경 변수를 직접 정합니다. 없으면 지금 것을 그대로 물려줍니다.
p 가 정말 PATH 를 뒤지는지 strace 로 볼 수 있습니다. 우분투 기본 PATH 로 exec_wait 를 돌리고 execve(여섯 형제가 결국 부르는 진짜 시스템 콜)만 골랐습니다.
$ strace -f -e trace=execve ./build/exec_wait > /dev/null
execve("./build/exec_wait", ["./build/exec_wait"], ...) = 0
[pid 316365] execve("/usr/local/sbin/echo", ["echo", "[echo] ..."], ...) = -1 ENOENT (그런 파일이나 디렉터리가 없습니다)
[pid 316365] execve("/usr/local/bin/echo", ["echo", "[echo] ..."], ...) = -1 ENOENT (그런 파일이나 디렉터리가 없습니다)
[pid 316365] execve("/usr/sbin/echo", ["echo", "[echo] ..."], ...) = -1 ENOENT (그런 파일이나 디렉터리가 없습니다)
[pid 316365] execve("/usr/bin/echo", ["echo", "[echo] ..."], ...) = 0
/usr/local/sbin, /usr/local/bin, /usr/sbin 에서 차례로 실패(ENOENT)하다가 /usr/bin/echo 에서 성공했습니다. 1주차 2절에서 설명한 “PATH 를 왼쪽부터 차례로 뒤진다”가 정확히 이 모습입니다. 쉘이 하는 일이 아니라 execlp 라이브러리 함수가 하는 일이었던 것이죠. 그리고 여섯 함수 모두 마지막에는 execve 하나로 커널에 갑니다. 나머지는 인자를 정리해 주는 편의 함수입니다.
모든 exec 는 NULL 로 끝나야 합니다.
char *argv_ls[] = {"ls", "-l", "/etc/hostname", "/etc/passwd", NULL}; /* NULL 종결! */
NULL 이 “인자 끝” 표시입니다. 빠뜨리면 함수가 배열 끝을 지나 쓰레기 값을 인자로 읽습니다. 4주차의 널 종료 문자열과 같은 발상입니다.
argv[0] 을 프로그램 이름으로 한 번 더 주는 것도 눈여겨보세요. execlp("echo", "echo", ...) 에서 첫 "echo" 는 찾을 프로그램, 두 번째는 그 프로그램이 볼 argv[0] 입니다. 관례상 같게 쓰지만 일부러 다르게 줄 수도 있습니다. busybox 처럼 argv[0] 을 보고 동작을 바꾸는 프로그램이 이것을 활용합니다.
4.5 wait: 종료 상태 해부 — 1주차의 $? 가 여기서 나온다
1주차 5절에서 return 42; 로 바꾸고 echo $? 를 치면 42 가 나왔습니다. 그 42 가 어떻게 쉘까지 오는지 이제 볼 수 있습니다. 쉘이 wait 로 받아 온 것입니다.
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <sys/wait.h>

int main(void) {
    pid_t pid = fork();
    if (pid == 0) {
        exit(42);
    }
    int status;
    waitpid(pid, &status, 0);
    printf("status 원본 = %d (0x%04x)\n", status, status);
    printf("WIFEXITED = %d, WEXITSTATUS = %d\n", WIFEXITED(status), WEXITSTATUS(status));
    return 0;
}
$ ./exit42
status 원본 = 10752 (0x2a00)
WIFEXITED = 1, WEXITSTATUS = 42
status 를 그냥 찍으면 42 가 아니라 10752 입니다. 16진수로 0x2a00, 즉 42(0x2a)가 8비트 왼쪽으로 밀려 들어 있습니다. status 는 단순한 종료 코드가 아니라 여러 정보가 비트로 포장된 정수이기 때문입니다. 아래 8비트에는 “어떻게 끝났는지”, 그 위 8비트에는 “종료 코드”가 들어갑니다. 그래서 매크로로 해부해야 합니다.
| 매크로 | 뜻 |
|---|---|
WIFEXITED(status) |
정상 종료했는가 (exit 또는 return) |
WEXITSTATUS(status) |
그 경우의 종료 코드 (0~255) |
WIFSIGNALED(status) |
시그널로 죽었는가 |
WTERMSIG(status) |
그 경우의 시그널 번호 |
WIFSTOPPED(status) |
정지됐는가 (Ctrl+Z 등) |
시그널로 죽은 경우도 실험해 봅시다. 자식을 SIGKILL 로 죽이고 status 를 봅니다.
#include <stdio.h>
#include <stdlib.h>
#include <signal.h>
#include <unistd.h>
#include <sys/wait.h>

int main(void) {
    pid_t pid = fork();
    if (pid == 0) {
        while (1) pause();       /* 시그널 올 때까지 잠든다 */
    }
    sleep(1);
    kill(pid, SIGKILL);
    int status;
    waitpid(pid, &status, 0);
    printf("status 원본 = %d (0x%04x)\n", status, status);
    printf("WIFEXITED = %d, WIFSIGNALED = %d, WTERMSIG = %d\n",
           WIFEXITED(status), WIFSIGNALED(status), WTERMSIG(status));
    return 0;
}
$ ./killed
status 원본 = 9 (0x0009)
WIFEXITED = 0, WIFSIGNALED = 1, WTERMSIG = 9
이번에는 status 가 9 입니다. 아래 8비트에 시그널 번호가 들어갔고, 위 8비트는 0 입니다. 정상 종료가 아니므로 WEXITSTATUS 를 읽으면 안 됩니다. 먼저 WIFEXITED 로 물어보고, 참일 때만 WEXITSTATUS 를 읽는 것이 규칙입니다.
쉘은 이 정보를 $? 하나로 뭉쳐서 보여 줍니다. 규칙은 이렇습니다.
$ sh -c 'exit 42'; echo $?
42
$ /bin/false; echo $?
1
$ no_such_cmd_xyz; echo $?
127
$ sh -c 'kill -TERM $$'; echo $?
종료됨
143
$ sh -c 'kill -9 $$'; echo $?
죽었음
137
$ sh -c 'kill -INT $$'; echo $?
130
| 끝난 방식 | $? |
계산 |
|---|---|---|
exit(N) / return N |
N | 그대로 |
| 명령을 못 찾음 | 127 | 쉘 관례 |
| 시그널 N 으로 죽음 | 128 + N | SIGTERM(15) → 143, SIGKILL(9) → 137, SIGINT(2) → 130 |
$? 가 128 보다 크면 “시그널로 죽었구나, 번호는 빼기 128” 이라고 읽으면 됩니다. bash 가 “종료됨”, “죽었음” 같은 메시지를 덧붙이는 것도 WIFSIGNALED 가 참일 때입니다. kill -9 만 유독 “죽었음”이라고 하는 이유는 6절에서 봅니다.
wait 와 waitpid 의 차이도 알아 둡시다.
wait(&status): 아무 자식이나 하나가 끝날 때까지 기다립니다.waitpid(pid, &status, options): 특정 자식을 지정할 수 있고(-1이면 아무나), 옵션을 줄 수 있습니다.
옵션 중 WNOHANG 이 중요합니다. “끝난 자식이 없으면 기다리지 말고 바로 0 을 돌려줘라”는 뜻입니다. 자식이 아직 도는 동안 부모가 다른 일을 하고 싶을 때 씁니다.
#include <stdio.h>
#include <stdlib.h>
#include <errno.h>
#include <string.h>
#include <unistd.h>
#include <sys/wait.h>

int main(void) {
    pid_t pid = fork();
    if (pid == 0) {
        sleep(1);
        exit(7);
    }
    int status;
    pid_t r = waitpid(pid, &status, WNOHANG);
    printf("바로 waitpid(WNOHANG): 반환 %d (0 = 아직 안 끝남, 기다리지 않고 돌아옴)\n", r);
    r = waitpid(pid, &status, 0);
    printf("waitpid(0): 반환 %d, 종료 코드 %d\n", r, WEXITSTATUS(status));
    r = wait(&status);
    printf("자식이 더 없을 때 wait(): 반환 %d, errno=%d %s\n", r, errno, strerror(errno));
    return 0;
}
$ ./wnohang
바로 waitpid(WNOHANG): 반환 0 (0 = 아직 안 끝남, 기다리지 않고 돌아옴)
waitpid(0): 반환 322481, 종료 코드 7
자식이 더 없을 때 wait(): 반환 -1, errno=10 No child processes
waitpid 의 반환값이 셋으로 갈립니다. 끝난 자식의 PID(수거 성공), 0(WNOHANG 인데 아직 아무도 안 끝남), -1(오류, 대표적으로 ECHILD = 기다릴 자식이 없음). 2.5절의 read 3형제와 같은 구조입니다. 시스템 콜의 반환값은 언제나 이렇게 갈래가 있으니 하나씩 확인하는 습관이 중요합니다. WNOHANG 은 5.4절의 좀비 방지와 프로젝트 1 의 백그라운드 실행에서 다시 나옵니다.
4.6 쉘의 정체
이 예제의 마지막 출력이 이번 주의 요약입니다.
while (1) {
    명령 입력받기;
    pid = fork();
    if (pid == 0) { execvp(명령, 인자들); exit(127); }
    waitpid(pid, &status, 0);
}
터미널에 ls 를 치면 bash 가 하는 일이 정확히 이것입니다.
- fork — 자기 자신을 복제한다
- exec — 자식이
ls로 변신한다 - wait — 부모(bash)는 자식이 끝나기를 기다렸다가 종료 코드를
$?에 넣는다
여기서 “왜 fork 를 먼저 하는가?”라는 질문이 자연스럽습니다. 답은 간단합니다. exec 는 되돌아올 수 없으니까요. bash 가 자신을 직접 ls 로 변신시키면 ls 가 끝나는 순간 bash 도 사라집니다. 그래서 버릴 수 있는 복제본을 먼저 만들고, 그 복제본을 변신시킵니다. 3.3절의 Copy-On-Write 덕분에 이 “버릴 복제본” 만들기가 거의 공짜라는 것도 다시 떠올려 보세요.
이 3박자가 유닉스 프로세스 모델의 전부입니다. 프로젝트 1 에서 진짜로 만듭니다.
5. 좀비와 고아: 뒷정리의 책임
5.1 좀비: 죽었는데 성불 못 한 프로세스
자식이 죽으면 곧바로 사라질까요? 아닙니다.
커널은 자식의 종료 상태(4.5절의 그 status)를 보관해 둡니다. 부모가 wait 로 가져갈 때까지요. 그 기간 동안 자식은 좀비(zombie) 상태입니다.
- 메모리는 전부 반납했습니다.
- 그런데 프로세스 테이블의 한 칸을 계속 차지합니다. 종료 상태를 어딘가에 들고 있어야 하니까요.
ps에서 상태Z, 이름에<defunct>로 나타납니다.
좀비 하나는 문제가 아닙니다. 그런데 부모가 계속 fork 만 하고 wait 을 안 하면 좀비가 쌓이고, 결국 프로세스 테이블이 고갈되어 시스템 전체가 새 프로세스를 만들지 못하게 됩니다. 서버 장애의 고전적인 원인입니다.
examples/zombie_orphan.c:
/*
 * zombie_orphan.c - 좀비와 고아: 프로세스의 뒷정리
 * 18주차: POSIX 시스템 프로그래밍
 *
 * 좀비(zombie): 자식은 죽었는데 부모가 wait()로 종료 상태를
 *   안 가져간 상태. 프로세스 테이블 한 칸을 계속 차지한다!
 *   (죽었는데 성불을 못 한 상태)
 *
 * 고아(orphan): 부모가 먼저 죽은 자식.
 *   -> init(PID 1, 요즘은 systemd)이 입양해서 대신 wait 해준다.
 *
 * 좀비는 쌓이면 시스템 장애(프로세스 테이블 고갈)가 되므로
 * "fork 했으면 반드시 wait"가 철칙입니다.
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <sys/wait.h>

/* /proc/PID/stat에서 상태 문자 읽기 (R/S/Z...) */
char get_state(pid_t pid) {
    char path[64], buffer[256];
    snprintf(path, sizeof(path), "/proc/%d/stat", pid);
    FILE *fp = fopen(path, "r");
    if (fp == NULL) return '?';
    if (fgets(buffer, sizeof(buffer), fp) == NULL) {
        fclose(fp);
        return '?';
    }
    fclose(fp);
    /* 형식: pid (이름) 상태 ... - ')' 뒤의 문자가 상태 */
    char *p = strrchr(buffer, ')');
    return (p != NULL && p[1] == ' ') ? p[2] : '?';
}

int main(void) {
    printf("=== 1. 좀비 만들기 (일부러!) ===\n");
    fflush(stdout);

    pid_t pid = fork();
    if (pid == 0) {
        printf("[자식 %d] 바로 종료합니다. 안녕히!\n", getpid());
        exit(42);                /* 종료 상태 42를 남기고 죽는다 */
    }

    sleep(1);                    /* 자식이 확실히 죽을 시간 */

    printf("[부모] 자식(%d)이 죽었지만 아직 wait 안 함\n", pid);
    printf("[부모] /proc/%d/stat의 상태: '%c' %s\n",
           pid, get_state(pid),
           get_state(pid) == 'Z' ? "<- Z = 좀비!!" : "");
    printf("[부모] ps로도 확인 가능: ps -o pid,stat,comm -p %d\n", pid);
    printf("       (STAT에 Z, 이름에 <defunct>가 붙는다)\n\n");

    /* ---------- wait로 성불시키기 ---------- */
    printf("=== 2. wait = 좀비 수거 ===\n");
    int status;
    pid_t reaped = waitpid(pid, &status, 0);
    printf("[부모] waitpid가 %d를 수거. 종료 코드 = %d\n",
           reaped, WEXITSTATUS(status));
    printf("[부모] 수거 후 상태: '%c' (?= 프로세스 테이블에서 소멸)\n\n",
           get_state(pid));

    /* ---------- 고아 실험: 손자를 이용한다 ---------- */
    printf("=== 3. 고아 만들기: 부모가 먼저 죽으면? ===\n");
    fflush(stdout);

    /* 구조: 나 -> 중간 부모 -> 손자.
     * 중간 부모가 즉시 죽으면 손자는 고아가 되어 입양된다! */
    pid_t middle = fork();
    if (middle == 0) {
        /* 중간 부모 */
        pid_t grandchild = fork();
        if (grandchild == 0) {
            /* 손자: 부모(중간)가 죽기를 기다렸다가 ppid 확인 */
            pid_t before = getppid();
            printf("[손자 %d] 태어날 때 부모 = %d\n", getpid(), before);
            fflush(stdout);
            sleep(2);            /* 그 사이 중간 부모가 사망 */
            printf("[손자 %d] 부모 사망 후 부모 = %d %s\n",
                   getpid(), getppid(),
                   getppid() == before ? "(아직 그대로?)"
                                       : "<- init/systemd가 입양!");
            exit(0);
        }
        printf("[중간 부모 %d] 손자(%d)를 남기고 즉시 사망!\n",
               getpid(), grandchild);
        fflush(stdout);
        exit(0);                 /* 손자를 wait 하지 않고 죽는다 -> 고아 발생 */
    }
    waitpid(middle, NULL, 0);    /* 중간 부모는 내가 수거 (좀비 방지) */
    sleep(3);                    /* 손자의 두 번째 출력을 기다린다
                                  * (손자는 이제 내 자식이 아니라 wait 불가!) */

    printf("\n=== 4. 실전 뒷정리 규칙 ===\n");
    printf("1. fork 했으면 wait/waitpid - 좀비 방지 철칙\n");
    printf("2. 자식이 많고 기다리기 싫다면?\n");
    printf("   signal(SIGCHLD, SIG_IGN);       // \"수거 안 함\" 선언\n");
    printf("   또는 SIGCHLD 핸들러에서 waitpid(-1, NULL, WNOHANG) 루프\n");
    printf("3. 데몬을 만들 때 fork 2번 하는 이유도 이 뒷정리와 관련\n");
    printf("   (프로젝트 log_daemon에서 확인!)\n");
    return 0;
}
새로 나온 것들입니다.
/proc/PID/stat읽기: 커널이 프로세스 상태를 파일처럼 보여 주는 곳입니다. 9주차의fopen/fgets로 그냥 읽으면 됩니다.strrchr(buffer, ')'): 4주차의 문자열 함수. 마지막)를 찾습니다. 이유는 5.2절에서.sleep(1): 1초 잠듭니다. 자식이 확실히 죽은 뒤에 관찰하려는 것입니다.exit(42): 종료 코드 42 를 남기고 죽습니다. 4.5절의 실험과 같습니다.
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/zombie_orphan.c -o build/zombie_orphan
$ ./build/zombie_orphan
=== 1. 좀비 만들기 (일부러!) ===
[자식 306704] 바로 종료합니다. 안녕히!
[부모] 자식(306704)이 죽었지만 아직 wait 안 함
[부모] /proc/306704/stat의 상태: 'Z' <- Z = 좀비!!
[부모] ps로도 확인 가능: ps -o pid,stat,comm -p 306704
       (STAT에 Z, 이름에 <defunct>가 붙는다)

=== 2. wait = 좀비 수거 ===
[부모] waitpid가 306704를 수거. 종료 코드 = 42
[부모] 수거 후 상태: '?' (?= 프로세스 테이블에서 소멸)

=== 3. 고아 만들기: 부모가 먼저 죽으면? ===
[중간 부모 306747] 손자(306748)를 남기고 즉시 사망!
[손자 306748] 태어날 때 부모 = 306747
[손자 306748] 부모 사망 후 부모 = 1674 <- init/systemd가 입양!

=== 4. 실전 뒷정리 규칙 ===
1. fork 했으면 wait/waitpid - 좀비 방지 철칙
2. 자식이 많고 기다리기 싫다면?
   signal(SIGCHLD, SIG_IGN);       // "수거 안 함" 선언
   또는 SIGCHLD 핸들러에서 waitpid(-1, NULL, WNOHANG) 루프
3. 데몬을 만들 때 fork 2번 하는 이유도 이 뒷정리와 관련
   (프로젝트 log_daemon에서 확인!)

좀비와 고아 프로세스
좀비를 일부러 만들어 /proc 에서 관찰합니다. 상태 문자가 Z 로 찍히고, waitpid 후에는 ?(파일이 없음 = 프로세스 소멸)가 됩니다. 이론으로만 듣던 것을 눈으로 확인하는 순간입니다.
프로그램 밖에서도 볼 수 있습니다. 프로그램을 백그라운드로 띄우고, 1초 안에 다른 명령으로 자식을 들여다봤습니다.
$ ./build/zombie_orphan > /dev/null &
$ ps -o pid,ppid,stat,cmd --ppid $!
    PID    PPID STAT CMD
 315872  315870 Z    [zombie_orphan] <defunct>
$ cat /proc/315872/status | head -3
Name:	zombie_orphan
State:	Z (zombie)
Tgid:	315872
$! 는 “방금 백그라운드로 띄운 프로세스의 PID” 이고, --ppid 는 “이 프로세스의 자식들만”입니다. STAT 이 Z, 이름이 [zombie_orphan] <defunct> 로 표시됩니다. defunct 는 “더 이상 기능하지 않는”이라는 뜻입니다. /proc 의 status 파일은 State: Z (zombie) 라고 사람이 읽기 좋게 알려 줍니다. 서버에서 ps aux | grep defunct 를 쳐서 좀비를 찾는 것이 이 원리입니다.
5.2 /proc 에서 상태 읽기
char get_state(pid_t pid) {
    char path[64], buffer[256];
    snprintf(path, sizeof(path), "/proc/%d/stat", pid);
    FILE *fp = fopen(path, "r");
    ...
    /* 형식: pid (이름) 상태 ... - ')' 뒤의 문자가 상태 */
    char *p = strrchr(buffer, ')');
    return (p != NULL && p[1] == ' ') ? p[2] : '?';
}
/proc/PID/stat 은 커널이 제공하는 가짜 파일입니다. 디스크에 없고, 읽는 순간 커널이 내용을 만들어 줍니다. “모든 것은 파일이다”의 극치죠. 실제 내용은 이렇게 생겼습니다.
$ cat /proc/self/stat
315862 (cat) R 315105 315862 315105 0 -1 4194304 118 0 0 0 0 0 0 0 20 0 1 0 ...
PID, 괄호 안의 이름, 그다음 한 글자가 상태(R)입니다. 파싱에서 strrchr(마지막 ) 찾기) 를 쓴 것이 중요한 디테일입니다. 프로그램 이름에 괄호가 들어갈 수 있기 때문입니다. 앞에서부터 찾으면 이름 안의 ) 에 걸려 엉뚱한 글자를 읽습니다. 뒤에서부터 찾으면 안전합니다. 이런 “형식은 단순한데 예외가 숨어 있는” 파싱은 시스템 프로그래밍에서 흔합니다. 실제 ps 도 같은 고민을 합니다.
주요 상태 문자는 이렇습니다.
| 문자 | 뜻 |
|---|---|
R |
실행 중 또는 실행 대기 |
S |
잠든 상태 (인터럽트 가능. sleep, 입력 대기 등 대부분의 대기) |
D |
잠든 상태 (인터럽트 불가. 디스크 I/O 대기) |
Z |
좀비 |
T |
정지됨 (Ctrl+Z 등) |
5.3 고아: 부모가 먼저 죽으면
반대 상황도 있습니다. 부모가 자식보다 먼저 죽으면 그 자식은 고아(orphan) 가 됩니다. 그러면 그 자식의 종료 상태는 누가 수거할까요? 아무도 안 하면 영원한 좀비가 될 텐데요.
누군가가 입양합니다. 전통적으로는 PID 1(init, 요즘은 systemd)이 모든 고아를 입양해 주기적으로 wait 을 돌려 수거합니다. 예제는 손자 프로세스 기법으로 이 순간을 포착합니다.
나(부모) → 중간 부모 → 손자
중간 부모가 즉시 죽으면 손자는 고아가 되고, getppid() 가 바뀝니다.
[손자 306748] 태어날 때 부모 = 306747
[손자 306748] 부모 사망 후 부모 = 1674 <- init/systemd가 입양!
부모 PID 가 306747 에서 1674 로 바뀌었습니다. 그런데 1 이 아니라 1674 입니다. 누구일까요?
$ ps -o pid,ppid,comm,args -p 1674
    PID    PPID COMMAND         COMMAND
   1674       1 systemd         /usr/lib/systemd/systemd --user
사용자 세션의 systemd --user 입니다. 최근 리눅스에는 “내 자손 중 고아가 생기면 PID 1 대신 내가 입양하겠다”고 선언하는 기능(subreaper)이 있고, 우분투 데스크톱의 systemd --user 가 그렇게 선언돼 있습니다. 그래서 그래픽 로그인 세션에서 실행하면 1674 같은 번호가, 서버나 다른 배포판에서는 1 이 나옵니다. 위 스크린샷은 다른 시점에 찍은 것이라 1 로 나와 있습니다. 어느 쪽이든 “누군가 입양해서 좀비를 막아 준다” 는 사실은 같습니다.
그리고 이 “고아 만들기”가 데몬화의 첫 단계입니다. 쉘에서 독립해 백그라운드에서 살아가려면 일부러 고아가 되어야 합니다. 프로젝트 3 에서 확인합니다.
5.4 좀비 방지 3가지 방법
1. 그냥 wait 한다 (가장 단순)
pid_t pid = fork();
if (pid == 0) { ... exit(0); }
waitpid(pid, &status, 0);        /* 여기서 멈춰 기다린다 */
자식이 끝날 때까지 부모가 멈춥니다. 순차 실행이면 이걸로 충분합니다.
2. SIGCHLD 를 무시한다고 선언한다
signal(SIGCHLD, SIG_IGN); /* "수거 안 할게요" */
이렇게 하면 커널이 자식의 종료 상태를 아예 보관하지 않습니다. 좀비가 생기지 않죠. 대신 wait 으로 종료 코드를 알 수 없게 됩니다. 자식의 결과에 관심 없을 때만 쓰세요.
3. SIGCHLD 핸들러에서 WNOHANG 루프 (실전 패턴)
void reap_children(int signo) {
    (void)signo;
    while (waitpid(-1, NULL, WNOHANG) > 0) { }   /* 끝난 자식 전부 수거 */
}
자식이 죽으면 커널이 SIGCHLD 시그널(3.7절의 strace 에서 본 그것)을 보내고, 핸들러가 끝난 자식들을 즉시 수거합니다. 부모는 멈추지 않고 자기 일을 계속합니다. -1 은 “아무 자식이나”, WNOHANG 은 “없으면 바로 0″입니다.
while 루프인 이유가 중요합니다. 시그널은 합쳐질 수 있기 때문입니다(6.3절에서 실험합니다). 자식 셋이 거의 동시에 죽으면 SIGCHLD 가 한 번만 배달될 수 있으니, 핸들러 한 번에 가능한 만큼 전부 수거해야 합니다. WNOHANG 덕분에 수거할 자식이 없으면 즉시 0 을 돌려주고 루프가 끝납니다. 이 패턴이 미니 쉘의 백그라운드 실행(&)에 그대로 쓰입니다.
6. 시그널: 커널의 문자 메시지
6.1 Ctrl+C 는 어떻게 프로그램을 멈출까
1주차 2절에서 “프로그램이 무한 반복에 빠지면 Ctrl + C” 라고 했습니다. 그 키를 누르면 정확히 무슨 일이 일어날까요?
키보드 → 터미널 → 커널이 프로세스에 SIGINT 라는 시그널을 보낸다 → 프로세스는 기본 동작(종료)을 한다. 이것이 전부입니다. 시그널은 프로세스에게 비동기로 배달되는 알림입니다. Ctrl+C 를 누르거나, kill 명령을 쓰거나, 잘못된 메모리에 접근하거나, 자식이 죽으면 커널이 시그널을 보냅니다.
“문자 메시지”에 비유하면 정확합니다. 짧고, 언제 올지 모르고, 내용은 없고 종류만 있습니다. 종류는 번호로 정해져 있고, kill -l 로 전부 볼 수 있습니다.
$ kill -l
 1) SIGHUP	 2) SIGINT	 3) SIGQUIT	 4) SIGILL	 5) SIGTRAP
 6) SIGABRT	 7) SIGBUS	 8) SIGFPE	 9) SIGKILL	10) SIGUSR1
11) SIGSEGV	12) SIGUSR2	13) SIGPIPE	14) SIGALRM	15) SIGTERM
16) SIGSTKFLT	17) SIGCHLD	18) SIGCONT	19) SIGSTOP	20) SIGTSTP
...
자주 만나는 것들입니다.
| 시그널 | 번호 | 언제 오나 | 기본 동작 |
|---|---|---|---|
SIGINT |
2 | Ctrl+C | 종료 |
SIGTERM |
15 | kill 명령의 기본값. “정중한 종료 요청” |
종료 |
SIGKILL |
9 | kill -9. 잡을 수도 무시할 수도 없음 |
종료 |
SIGSEGV |
11 | 잘못된 메모리 접근 (6주차의 세그멘테이션 오류) | 종료 + 코어 덤프 |
SIGFPE |
8 | 0 으로 나누기 (3주차) | 종료 + 코어 덤프 |
SIGCHLD |
17 | 자식 프로세스가 끝남 | 무시 |
SIGUSR1 / SIGUSR2 |
10 / 12 | 용도 자유. 프로그램 마음대로 | 종료 |
SIGALRM |
14 | alarm / ualarm 타이머 만료 |
종료 |
SIGHUP |
1 | 터미널 연결 끊김. 데몬에서는 “설정 다시 읽기” 관례 | 종료 |
SIGSTOP / SIGCONT |
19 / 18 | 정지 / 재개 (Ctrl+Z 는 SIGTSTP) |
정지 / 재개 |
3주차에서 0 으로 나누면 프로그램이 죽고 종료 코드가 136 이었죠. 4.5절의 표대로 128 + 8, 즉 SIGFPE 로 죽은 것입니다. 6주차의 세그멘테이션 오류 139 는 128 + 11, SIGSEGV 입니다. 이제 그 숫자들이 어디서 왔는지 압니다.
6.2 기본 동작을 바꾸기 — 핸들러
시그널마다 기본 동작이 있지만, 프로그램은 “이 시그널이 오면 대신 이 함수를 실행해 달라”고 등록할 수 있습니다. 그 함수를 핸들러(handler) 라고 합니다. Ctrl+C 를 받아도 죽지 않는 프로그램을 만들어 봅시다.
#include <stdio.h>
#include <signal.h>
#include <string.h>
#include <unistd.h>

static volatile sig_atomic_t got_int = 0;

static void on_int(int signo) {
    (void)signo;
    got_int = 1;
}

int main(void) {
    struct sigaction sa;
    memset(&sa, 0, sizeof(sa));
    sa.sa_handler = on_int;
    sigaction(SIGINT, &sa, NULL);

    printf("PID %d: Ctrl+C 를 기다립니다...\n", getpid());
    fflush(stdout);
    while (!got_int) {
        pause();                 /* 시그널이 올 때까지 잠든다 */
    }
    printf("\nSIGINT 를 받았지만 죽지 않았습니다. 정리하고 끝냅니다.\n");
    return 0;
}
struct sigaction: 핸들러와 옵션을 담는 구조체입니다.memset으로 0 으로 밀고sa_handler에 함수 주소를 넣습니다. 7주차의 함수 포인터가 여기서 쓰입니다.sigaction(SIGINT, &sa, NULL): “SIGINT가 오면sa대로 하라”고 커널에 등록합니다. 세 번째 인자는 이전 설정을 받을 자리인데, 필요 없으면NULL입니다.volatile sig_atomic_t: 핸들러와 메인 코드가 함께 보는 변수의 타입입니다. 7.4절에서 두 단어를 각각 설명합니다.pause(): 시그널이 올 때까지 잠듭니다. 바쁘게 도는 대신 CPU 를 안 쓰고 기다리는 방법입니다.
터미널에서 실행하고 Ctrl+C 를 눌러 봅시다.
$ ./sigint_handler
PID 415667: Ctrl+C 를 기다립니다...
^C
SIGINT 를 받았지만 죽지 않았습니다. 정리하고 끝냅니다.
$ echo $?
0
^C 는 터미널이 Ctrl+C 를 표시하는 방식입니다. 프로그램은 죽지 않고 우리 핸들러가 깃발을 세웠고, pause 가 깨어나 루프를 빠져나와 정상 종료(0)했습니다. 핸들러가 없는 프로그램이었다면 그 자리에서 죽고 $? 는 130 이었을 겁니다.
다른 터미널에서 kill 명령으로 보내도 똑같습니다. kill 은 이름과 달리 “죽이는 명령”이 아니라 시그널 배달부입니다. 무엇을 보낼지 고를 수 있습니다.
$ kill -INT 415667      # SIGINT 보내기 (Ctrl+C 와 같음)
$ kill 415667           # 아무것도 안 쓰면 SIGTERM
$ kill -9 415667        # SIGKILL. 최후 수단
6.3 예제: 시그널을 자기 자신에게 보내기
examples/signal_basic.c 는 자동으로 실행할 수 있도록 자기 자신에게 시그널을 보냅니다. C 에서 시그널을 보내는 함수도 kill 입니다.
/*
 * signal_basic.c - 시그널: 커널이 보내는 문자 메시지
 * 18주차: POSIX 시스템 프로그래밍
 *
 * 시그널 = 프로세스에게 비동기로 배달되는 알림.
 * Ctrl+C(SIGINT), kill 명령(SIGTERM), 0으로 나눔(SIGFPE),
 * 세그폴트(SIGSEGV), 자식 종료(SIGCHLD)... 전부 시그널입니다.
 *
 * 이 예제는 자동 실행 가능하도록 "자기 자신에게" 시그널을 보냅니다.
 * (kill()은 이름과 달리 '시그널 배달부'일 뿐 - 죽이는 건 기본 동작일 뿐)
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <signal.h>
#include <sys/wait.h>

/* 핸들러에서 건드릴 변수는 반드시 이 타입! (다음 예제에서 자세히) */
static volatile sig_atomic_t usr1_count = 0;
static volatile sig_atomic_t got_term = 0;

void handle_usr1(int signo) {
    (void)signo;
    usr1_count++;                /* 핸들러에선 최소한의 일만! */
}

void handle_term(int signo) {
    (void)signo;
    got_term = 1;
}

int main(void) {
    printf("=== 1. 시그널 기본: 종류와 번호 ===\n");
    printf("  SIGINT  = %2d (Ctrl+C)\n", SIGINT);
    printf("  SIGTERM = %2d (kill 기본값 - '정중한 종료 요청')\n", SIGTERM);
    printf("  SIGKILL = %2d (즉사 - 잡을 수도 무시할 수도 없다!)\n", SIGKILL);
    printf("  SIGSEGV = %2d (잘못된 메모리 접근)\n", SIGSEGV);
    printf("  SIGCHLD = %2d (자식 종료 알림)\n", SIGCHLD);
    printf("  SIGUSR1 = %2d (용도 자유 - 프로그램 마음대로)\n\n", SIGUSR1);

    /* ---------- 2. sigaction으로 핸들러 등록 ---------- */
    printf("=== 2. sigaction: 핸들러 등록 (signal()보다 이걸 쓰세요) ===\n");

    struct sigaction sa;
    memset(&sa, 0, sizeof(sa));
    sa.sa_handler = handle_usr1;
    sigemptyset(&sa.sa_mask);    /* 핸들러 실행 중 추가로 막을 시그널: 없음 */
    sa.sa_flags = SA_RESTART;    /* 시그널로 끊긴 시스템 콜 자동 재시작 */

    if (sigaction(SIGUSR1, &sa, NULL) < 0) {
        perror("sigaction");
        return 1;
    }

    /* 자기 자신에게 3발 발사 */
    printf("나 자신(PID %d)에게 SIGUSR1을 3번 보낸다...\n", getpid());
    kill(getpid(), SIGUSR1);
    kill(getpid(), SIGUSR1);     /* 주의: 같은 시그널이 연달아 오면 */
    kill(getpid(), SIGUSR1);     /* 합쳐질 수 있다 (표준 시그널은 큐 없음!) */
    printf("핸들러가 센 횟수: %d (3보다 적을 수도 - 시그널은 '깃발'이지 '큐'가 아니다!)\n\n",
           (int)usr1_count);

    /* ---------- 3. 시그널 블로킹(마스킹) ---------- */
    printf("=== 3. 시그널 잠시 막기 (중요 작업 보호) ===\n");

    sigset_t block_set, old_set;
    sigemptyset(&block_set);
    sigaddset(&block_set, SIGUSR1);

    sigprocmask(SIG_BLOCK, &block_set, &old_set);    /* 우편함 잠금 */
    printf("SIGUSR1 블록 중... 이 사이에 온 시그널은 '보류'된다\n");

    usr1_count = 0;
    kill(getpid(), SIGUSR1);
    kill(getpid(), SIGUSR1);
    printf("블록 중 2발 발사. 핸들러 실행 횟수: %d (아직 배달 안 됨!)\n",
           (int)usr1_count);

    sigprocmask(SIG_SETMASK, &old_set, NULL);        /* 잠금 해제 */
    printf("블록 해제! 핸들러 실행 횟수: %d ", (int)usr1_count);
    printf("(보류됐던 게 배달됨. 단, 2발이 1발로 합쳐졌다!)\n\n");

    /* ---------- 4. 부모-자식 시그널 통신 ---------- */
    printf("=== 4. 프로세스 간 시그널: 정중한 종료 요청 ===\n");
    fflush(stdout);

    pid_t pid = fork();
    if (pid == 0) {
        /* 자식: SIGTERM을 받으면 정리하고 종료하는 서버 흉내 */
        struct sigaction sa_term;
        memset(&sa_term, 0, sizeof(sa_term));
        sa_term.sa_handler = handle_term;
        sigaction(SIGTERM, &sa_term, NULL);

        printf("[자식 %d] 일하는 중... SIGTERM 오면 정리하고 종료할게요\n",
               getpid());
        fflush(stdout);

        while (!got_term) {
            usleep(100000);      /* 일하는 척 (0.1초씩) */
        }
        printf("[자식] SIGTERM 수신! 뒷정리 후 우아하게 종료합니다\n");
        exit(0);
    }

    sleep(1);
    printf("[부모] 자식에게 SIGTERM 발사 (kill %d)\n", pid);
    fflush(stdout);
    kill(pid, SIGTERM);
    waitpid(pid, NULL, 0);

    printf("\n정리:\n");
    printf("1. sigaction > signal (이식성/제어력 - signal은 구식)\n");
    printf("2. 표준 시그널은 큐가 없다: 연속 발사는 합쳐질 수 있음\n");
    printf("3. SIGKILL/SIGSTOP만은 못 막는다 (커널의 최후 수단)\n");
    printf("4. SIGTERM 핸들러 = 데몬/서버의 '우아한 종료'의 표준 패턴\n");
    return 0;
}
새로 나온 것들입니다.
#include <signal.h>: 시그널 관련 선언 전부.sigemptyset(&sa.sa_mask):sa_mask는 “핸들러가 도는 동안 추가로 막을 시그널 집합”입니다. 비워 둔다는 뜻입니다. 집합(sigset_t)은 비트 집합이라 3주차 비트 연산으로 구현돼 있는데, 직접 만지지 말고sigemptyset/sigaddset함수를 쓰라고 정해져 있습니다.sa.sa_flags = SA_RESTART: 6.4절에서 설명합니다.kill(getpid(), SIGUSR1): 나 자신에게SIGUSR1을 보냅니다.sigprocmask(SIG_BLOCK, &block_set, &old_set): 시그널을 잠시 막습니다. 6.6절.usleep(100000): 100,000 마이크로초 = 0.1초 잠듭니다.
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/signal_basic.c -o build/signal_basic
$ ./build/signal_basic
=== 1. 시그널 기본: 종류와 번호 ===
  SIGINT  =  2 (Ctrl+C)
  SIGTERM = 15 (kill 기본값 - '정중한 종료 요청')
  SIGKILL =  9 (즉사 - 잡을 수도 무시할 수도 없다!)
  SIGSEGV = 11 (잘못된 메모리 접근)
  SIGCHLD = 17 (자식 종료 알림)
  SIGUSR1 = 10 (용도 자유 - 프로그램 마음대로)

=== 2. sigaction: 핸들러 등록 (signal()보다 이걸 쓰세요) ===
나 자신(PID 306821)에게 SIGUSR1을 3번 보낸다...
핸들러가 센 횟수: 3 (3보다 적을 수도 - 시그널은 '깃발'이지 '큐'가 아니다!)

=== 3. 시그널 잠시 막기 (중요 작업 보호) ===
SIGUSR1 블록 중... 이 사이에 온 시그널은 '보류'된다
블록 중 2발 발사. 핸들러 실행 횟수: 0 (아직 배달 안 됨!)
블록 해제! 핸들러 실행 횟수: 1 (보류됐던 게 배달됨. 단, 2발이 1발로 합쳐졌다!)

=== 4. 프로세스 간 시그널: 정중한 종료 요청 ===
[자식 306822] 일하는 중... SIGTERM 오면 정리하고 종료할게요
[부모] 자식에게 SIGTERM 발사 (kill 306822)
[자식] SIGTERM 수신! 뒷정리 후 우아하게 종료합니다

정리:
1. sigaction > signal (이식성/제어력 - signal은 구식)
2. 표준 시그널은 큐가 없다: 연속 발사는 합쳐질 수 있음
3. SIGKILL/SIGSTOP만은 못 막는다 (커널의 최후 수단)
4. SIGTERM 핸들러 = 데몬/서버의 '우아한 종료'의 표준 패턴
2번 실험에서 세 번 보낸 것이 세 번 다 세어졌습니다. 그런데 3번 실험에서는 두 번 보낸 것이 한 번으로 합쳐졌습니다. 같은 시그널을 연속으로 보냈는데 왜 결과가 다를까요? 2번은 막지 않은 상태라 kill 이 돌아오기도 전에 핸들러가 즉시 실행돼서, 다음 kill 때는 이미 처리가 끝나 있었습니다. 3번은 막아 둔 상태라 두 발이 대기 중인 채로 겹쳤고, 대기는 “왔다/안 왔다” 한 비트뿐이라 하나로 합쳐진 것입니다. 6.5절에서 다시 봅니다.
6.4 sigaction 으로 등록하기 — signal() 은 왜 안 쓰나
핸들러 등록에는 signal() 과 sigaction() 두 가지가 있는데, sigaction 을 쓰세요.
    struct sigaction sa;
    memset(&sa, 0, sizeof(sa));
    sa.sa_handler = handle_usr1;
    sigemptyset(&sa.sa_mask);    /* 핸들러 실행 중 추가로 막을 시그널: 없음 */
    sa.sa_flags = SA_RESTART;    /* 시그널로 끊긴 시스템 콜 자동 재시작 */

    if (sigaction(SIGUSR1, &sa, NULL) < 0) {
        perror("sigaction");
        return 1;
    }
signal() 은 역사적으로 유닉스 계열마다 동작이 달랐습니다. 어떤 시스템에서는 핸들러가 한 번 실행되면 기본 동작으로 되돌아갔고, 어떤 시스템에서는 유지됐습니다. 그래서 이식성이 없습니다. sigaction 은 동작이 표준으로 정해져 있고, 세밀한 제어도 됩니다. 다만 signal(SIGINT, SIG_IGN) 처럼 “무시” 나 “기본 동작”으로 설정할 때는 signal() 도 문제없어서, 미니 쉘은 그 용도로 씁니다.
구조체 필드를 하나씩 봅시다.
memset 으로 0 초기화: 구조체에 우리가 모르는 필드가 더 있을 수 있으니 통째로 0 으로 밀고 시작합니다. 8주차에서 배운 구조체 다루는 습관입니다.
sa_mask: 핸들러가 실행되는 동안 추가로 막을 시그널들입니다. 기본적으로 처리 중인 시그널 자신은 자동으로 막히므로, 대개 비워 둡니다.
sa_flags = SA_RESTART: 이게 중요합니다. 시그널이 도착하면 진행 중이던 느린 시스템 콜(read, write, wait, accept 등)이 중단되고 errno = EINTR 로 실패합니다. SA_RESTART 를 주면 커널이 그 시스템 콜을 자동으로 재시작해 줍니다. 이 플래그가 없으면 곳곳에 이런 코드를 써야 합니다.
    ssize_t n;
    do {
        n = read(fd, buf, size);
    } while (n < 0 && errno == EINTR);    /* 시그널로 끊겼으면 다시 */
미니 쉘이 SIGCHLD 핸들러에 SA_RESTART 를 준 것도 이 때문입니다. 백그라운드 자식이 죽어 시그널이 올 때, 사용자 입력을 기다리던 fgets 가 끊기지 않게 하려는 것입니다.
6.5 시그널은 큐가 아니다
3번 실험이 실측으로 보여 주는 중요한 진실입니다.
블록 중 2발 발사. 핸들러 실행 횟수: 0 (아직 배달 안 됨!)
블록 해제! 핸들러 실행 횟수: 1 (2발이 1발로 합쳐졌다!)
표준 시그널은 큐가 없습니다. 커널은 “이 시그널이 대기 중인가?”를 시그널마다 비트 하나로만 관리합니다. 같은 시그널이 막혀 있는 동안 열 번 와도, 대기 비트는 하나뿐이라 풀리면 한 번만 배달됩니다.
시그널은 “깃발”이지 “메시지 큐”가 아닙니다.
그래서 이런 코드는 틀립니다.
/* 잘못된 가정: 자식이 죽은 횟수만큼 SIGCHLD가 온다 */
void handler(int signo) {
    waitpid(-1, NULL, WNOHANG);    /* 한 번만 수거 -> 좀비 남음! */
}
5.4절에서 while 루프를 강조한 이유가 이것입니다. “몇 번 왔는지”가 아니라 “왔는가”만 알 수 있으므로, 올 때마다 가능한 일을 전부 처리해야 합니다.
(참고로 실시간 시그널(kill -l 의 SIGRTMIN 이상)은 큐가 있습니다. 다만 일반적인 용도에는 잘 쓰이지 않습니다.)
6.6 시그널 블로킹
중요한 작업 중에 시그널이 끼어들면 곤란할 때가 있습니다. 그럴 때 블록(마스킹) 합니다.
    sigset_t block_set, old_set;
    sigemptyset(&block_set);
    sigaddset(&block_set, SIGUSR1);

    sigprocmask(SIG_BLOCK, &block_set, &old_set);    /* 우편함 잠금 */
    /* ... 중요한 작업 ... */
    sigprocmask(SIG_SETMASK, &old_set, NULL);        /* 잠금 해제 */
블록은 무시가 아닙니다. 시그널이 사라지는 게 아니라 보류되었다가, 해제되는 순간 배달됩니다. 우편함을 잠가 두면 우편물이 쌓여 있다가 열면 들어오는 것과 같습니다. 다만 같은 종류는 하나로 합쳐집니다. old_set 에 이전 마스크를 받아 두고 나중에 복원하는 것도 좋은 습관입니다. 다른 코드가 설정해 둔 마스크를 함부로 지우지 않기 위해서입니다.
6.7 SIGKILL 과 SIGSTOP 은 못 막는다
두 시그널만은 예외입니다. 핸들러를 등록하려고 하면 커널이 거절합니다. 직접 해 봤습니다.
$ ./nokill
sigaction(SIGKILL): -1, errno=22 Invalid argument
sigaction(SIGSTOP): -1, errno=22 Invalid argument
sigaction(SIGTERM): 0 (성공)
SIGKILL(9): 즉시 종료. 핸들러 등록도, 무시도, 블록도 불가능SIGSTOP(19): 즉시 정지. 마찬가지로 불가능
커널의 최후 수단이기 때문입니다. 모든 시그널을 막을 수 있다면 절대 죽지 않는 프로세스를 만들 수 있고, 그러면 시스템 관리가 불가능해집니다. 4.5절에서 bash 가 SIGTERM 에는 “종료됨”, SIGKILL 에는 “죽었음”이라고 다르게 말한 것이 이 차이입니다. 하나는 요청이고 하나는 집행입니다.
그래서 실무에서는 이 순서를 씁니다.
$ kill PID           # SIGTERM. "정리하고 종료해 주세요" (정중한 요청)
$ kill -9 PID        # 몇 초 기다려도 안 죽으면. SIGKILL. "지금 죽어라" (최후 수단)
SIGTERM 을 먼저 보내는 이유는 프로그램에게 뒷정리할 기회를 주기 위해서입니다. 열린 파일을 닫고, 버퍼를 비우고, 데이터베이스 연결을 정리할 시간입니다. SIGKILL 은 그 기회가 없으므로 데이터가 손상될 수 있습니다. 예제의 4번 실험이 바로 이 우아한 종료(graceful shutdown) 패턴입니다. 모든 서버와 데몬의 표준 구조이고, 프로젝트 3 에서 다시 씁니다.
백그라운드로 띄운 프로그램은 왜 Ctrl+C 로 안 죽을까? 스크립트 안에서
./prog &로 띄운 프로그램에kill -INT를 보냈더니 죽지 않는 것을 이 글을 쓰면서 겪었습니다. 확인해 보니/proc/PID/status의SigIgn이0x6, 즉SIGINT(2)와SIGQUIT(3)이 무시로 설정돼 있었습니다. POSIX 규칙상, 대화형이 아닌 쉘이&로 띄운 명령은SIGINT를 무시하도록 물려받습니다(터미널의 Ctrl+C 가 백그라운드 작업까지 죽이지 않게 하려는 것입니다). 그리고 4.1절 표대로 “무시” 설정은exec를 넘어 유지됩니다. 시그널이 “안 오는” 것 같을 때는grep SigIgn /proc/PID/status를 먼저 보세요.
7. 핸들러의 지뢰밭: async-signal-safe
7.1 왜 핸들러에서 printf가 위험한가
시그널 핸들러는 어느 줄 사이에서든 끼어들 수 있습니다. malloc 하다가, printf 하다가, 연결 리스트를 수정하다가요. 여기서 무서운 시나리오가 나옵니다.
메인: printf(...) 실행 중 — 내부 버퍼를 잠그고 수정하고 있음
       ↓ 여기서 시그널 도착!
핸들러: printf(...) 호출 — 같은 잠금을 또 잡으려 함
       ↓
교착(deadlock) 또는 버퍼 파손
printf 는 내부적으로 전역 버퍼(1.3절의 그 버퍼)를 씁니다. 그 버퍼를 수정하는 도중에 끼어들어 같은 버퍼를 또 건드리면, 버퍼의 상태가 깨지거나 잠금을 두 번 잡으려다 영원히 멈춥니다. malloc 도 마찬가지입니다. 힙의 자유 블록 목록을 수정하는 도중에 또 malloc 이 불리면 힙 구조가 망가집니다(7주차에서 본 힙 손상이 이렇게도 생깁니다). 이런 버그는 아주 가끔, 재현 불가능하게 터집니다.
7.2 async-signal-safe 함수 목록
그래서 POSIX 는 핸들러에서 불러도 안전한 함수 목록을 정해 두었습니다. async-signal-safe 함수들입니다.
| 안전 (일부) | 금지 (일부) |
|---|---|
write, read, close, open |
printf, sprintf, puts |
kill, _exit, abort |
malloc, free, realloc |
sigaction, sigprocmask |
exit (atexit 핸들러와 버퍼 비우기 때문) |
waitpid, fork, execve |
fopen, fclose |
time, alarm |
strtok, localtime |
exit 이 금지 목록에 있는 것을 주목하세요. exit 은 atexit 으로 등록된 정리 함수를 실행하고 stdio 버퍼를 비우는데, 그 과정이 안전하지 않습니다. 핸들러에서 즉시 종료해야 한다면 _exit(밑줄!)을 쓰세요. 정리 없이 바로 커널에 종료를 요청합니다. 전체 목록은 man 7 signal-safety 에 있습니다.
examples/signal_safety.c:
/*
 * signal_safety.c - 시그널 핸들러의 지뢰밭
 * 18주차: POSIX 시스템 프로그래밍
 *
 * 시그널 핸들러는 "언제든, 어느 줄 사이에서든" 끼어들 수 있습니다.
 * malloc 하다가, printf 하다가, 링크드 리스트 수정하다가...
 *
 * 그래서 핸들러 안에서는 규칙이 엄격합니다:
 * 1. async-signal-safe 함수만 호출 (write는 OK, printf는 금지!)
 * 2. 공유 변수는 volatile sig_atomic_t 만
 * 3. 최선의 패턴: "핸들러는 깃발만 세우고, 일은 메인 루프가"
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <signal.h>

/* ---------- 올바른 패턴: 깃발만 세운다 ---------- */
static volatile sig_atomic_t tick_count = 0;
static volatile sig_atomic_t shutdown_requested = 0;

void good_handler(int signo) {
    if (signo == SIGALRM) {
        tick_count++;            /* sig_atomic_t 증가: 안전 */
    } else if (signo == SIGTERM || signo == SIGINT) {
        shutdown_requested = 1;  /* 깃발만! */
    }
    /* printf? malloc? 절대 금지! (아래 설명) */
}

/* 시연용: 핸들러에서 안전하게 출력하고 싶다면 write */
void handler_with_write(int signo) {
    (void)signo;
    const char msg[] = "[핸들러] write()는 async-signal-safe라 OK\n";
    write(1, msg, sizeof(msg) - 1);      /* printf 대신 write! */
}

int main(void) {
    printf("=== 1. 왜 핸들러에서 printf가 위험한가 ===\n");
    printf("printf는 내부 버퍼(전역 상태)를 잠그고 수정합니다.\n");
    printf("만약 printf 실행 '도중' 시그널이 오고, 핸들러가 또 printf를\n");
    printf("부르면? 같은 잠금을 또 잡으려다 교착(deadlock)이거나\n");
    printf("버퍼가 깨집니다. malloc도 같은 이유로 금지!\n\n");

    printf("=== 2. async-signal-safe 함수 (핸들러 허용 목록) ===\n");
    printf("  OK : write, read, close, kill, _exit, sigaction ...\n");
    printf("  금지: printf, malloc/free, exit(!), fopen, strtok ...\n");
    printf("  전체 목록: man 7 signal-safety\n\n");

    /* ---------- 3. 올바른 패턴 시연: 깃발 + 메인 루프 ---------- */
    printf("=== 3. 실전 패턴: 핸들러는 깃발, 일은 메인 루프 ===\n");

    struct sigaction sa;
    memset(&sa, 0, sizeof(sa));
    sa.sa_handler = good_handler;
    sigemptyset(&sa.sa_mask);
    sa.sa_flags = SA_RESTART;
    sigaction(SIGALRM, &sa, NULL);
    sigaction(SIGTERM, &sa, NULL);

    printf("0.3초마다 SIGALRM을 받으며 일하는 루프 (5틱 후 자체 종료):\n");

    /* ualarm: 마이크로초 단위 반복 알람 (300ms마다) */
    ualarm(300000, 300000);

    int last_seen = 0;
    while (!shutdown_requested) {
        if (tick_count != last_seen) {
            last_seen = tick_count;
            /* 무거운 일(printf, 파일 쓰기...)은 여기 메인 루프에서! */
            printf("  [메인 루프] 틱 %d 처리 (여기선 printf 안전!)\n",
                   last_seen);
            if (last_seen >= 5) {
                kill(getpid(), SIGTERM);     /* 데모: 스스로 종료 요청 */
            }
        }
        usleep(50000);           /* 실전에서는 pause()나 sigsuspend */
    }
    ualarm(0, 0);                /* 알람 해제 */
    printf("종료 깃발 확인! 정리 후 종료합니다.\n\n");

    /* ---------- 4. volatile sig_atomic_t의 이유 ---------- */
    printf("=== 4. volatile sig_atomic_t는 왜? ===\n");
    printf("volatile     : \"이 변수는 코드 밖에서 바뀔 수 있으니\n");
    printf("               레지스터에 캐시하지 말고 매번 읽어라\"\n");
    printf("               (없으면 컴파일러가 while(!flag)을 무한루프로 최적화!)\n");
    printf("sig_atomic_t : 읽기/쓰기가 중간에 끊기지 않는 크기 보장\n");
    printf("               (큰 구조체는 반쯤 쓰다 끼어들릴 수 있다)\n\n");

    printf("=== 요약: 핸들러 3계명 ===\n");
    printf("1. 깃발만 세워라 (volatile sig_atomic_t)\n");
    printf("2. 출력이 꼭 필요하면 write만\n");
    printf("3. 진짜 일은 메인 루프에서 깃발을 보고 처리\n");
    printf("(이 패턴이 이번 주 log_daemon 프로젝트의 뼈대입니다)\n");
    return 0;
}
새로 나온 것은 ualarm(300000, 300000) 입니다. 300,000 마이크로초(0.3초) 뒤에 SIGALRM 을 보내고, 그 뒤로도 0.3초마다 반복하라는 뜻입니다. ualarm(0, 0) 은 해제입니다. 핸들러가 signo 로 어떤 시그널인지 구분하는 것도 보세요. 핸들러 하나를 여러 시그널에 등록했기 때문입니다.
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/signal_safety.c -o build/signal_safety
$ ./build/signal_safety
=== 1. 왜 핸들러에서 printf가 위험한가 ===
...
=== 3. 실전 패턴: 핸들러는 깃발, 일은 메인 루프 ===
0.3초마다 SIGALRM을 받으며 일하는 루프 (5틱 후 자체 종료):
  [메인 루프] 틱 1 처리 (여기선 printf 안전!)
  [메인 루프] 틱 2 처리 (여기선 printf 안전!)
  [메인 루프] 틱 3 처리 (여기선 printf 안전!)
  [메인 루프] 틱 4 처리 (여기선 printf 안전!)
  [메인 루프] 틱 5 처리 (여기선 printf 안전!)
종료 깃발 확인! 정리 후 종료합니다.

=== 4. volatile sig_atomic_t는 왜? ===
...
=== 요약: 핸들러 3계명 ===
1. 깃발만 세워라 (volatile sig_atomic_t)
2. 출력이 꼭 필요하면 write만
3. 진짜 일은 메인 루프에서 깃발을 보고 처리
(이 패턴이 이번 주 log_daemon 프로젝트의 뼈대입니다)

시그널 핸들러에서 할 수 있는 일
7.3 핸들러 3계명
이 예제의 결론이자, 시그널을 다루는 모든 코드의 표준 패턴입니다.
계명 1 — 깃발만 세워라
static volatile sig_atomic_t shutdown_requested = 0;

void good_handler(int signo) {
    if (signo == SIGTERM || signo == SIGINT) {
        shutdown_requested = 1;  /* 깃발만! */
    }
}
핸들러는 변수 하나를 바꾸고 즉시 끝냅니다. 그러면 안전하지 않은 함수를 부를 일이 없습니다.
계명 2 — 출력이 꼭 필요하면 write 만
void handler_with_write(int signo) {
    const char msg[] = "[핸들러] write()는 async-signal-safe라 OK\n";
    write(1, msg, sizeof(msg) - 1);      /* printf 대신 write! */
}
sizeof(msg) - 1 은 널 종료 문자를 빼는 것입니다. 배열 리터럴이라 strlen 없이 컴파일할 때 크기를 알 수 있습니다. 1.3절의 mix 실험에서 쓴 것과 같은 방법입니다.
계명 3 — 진짜 일은 메인 루프에서
    while (!shutdown_requested) {
        if (tick_count != last_seen) {
            last_seen = tick_count;
            printf("  [메인 루프] 틱 %d 처리 (여기선 printf 안전!)\n", last_seen);
        }
        usleep(50000);
    }
메인 루프는 일반 코드이므로 printf 든 malloc 이든 자유롭게 쓸 수 있습니다. 핸들러가 세운 깃발을 보고 필요한 일을 하면 됩니다. 이 구조의 아름다움은 위험한 영역을 최소화한다는 데 있습니다. 핸들러는 세 줄, 나머지는 전부 안전 지대입니다.
7.4 volatile sig_atomic_t 는 왜?
깃발 변수의 타입이 왜 하필 volatile sig_atomic_t 일까요? 두 단어 모두 이유가 있습니다.
volatile: “이 변수는 코드 흐름 밖에서 바뀔 수 있으니, 레지스터에 두지 말고 매번 메모리에서 읽어라“는 지시입니다. 이게 없으면 컴파일러가 이 코드를 보고,
while (!shutdown_requested) { ... }
“이 루프 안에서 shutdown_requested 를 바꾸는 코드가 없네? 그럼 값이 안 변하니 한 번만 읽고 레지스터에 두자”라고 최적화합니다. 그러면 핸들러가 메모리의 값을 바꿔도 루프는 레지스터의 옛 값을 계속 보며 영원히 돕니다. -O0 에서는 잘 동작하다가 -O2 에서 무한 루프가 되는 무서운 버그입니다. 1주차 5절에서 “배우는 동안 최적화를 켜지 않는다”고 했는데, 최적화를 켜는 순간 이런 종류의 실수가 드러납니다. 최적화 레벨에 따라 동작이 바뀌는 코드는 대개 volatile 누락입니다.
sig_atomic_t: 읽기와 쓰기가 중간에 끊기지 않는 크기를 보장하는 타입입니다. 32비트 CPU 에서 64비트 변수를 쓰면 명령 두 개로 나뉘고, 그 사이에 시그널이 끼어들면 반쯤 쓰다 만 값을 핸들러가 보게 됩니다. sig_atomic_t 는 플랫폼에서 한 번에 읽고 쓸 수 있는 크기(보통 int)로 정의되어 이 문제를 막습니다.
주의: sig_atomic_t 는 “찢어지지 않음”만 보장하지, 원자적 증감(count++)을 보장하지는 않습니다. count++ 은 읽기-수정-쓰기 세 단계니까요. 예제처럼 “핸들러만 쓰고 메인은 읽기만” 하는 구조에서는 괜찮지만, 여러 곳에서 증감한다면 C11 의 atomic_int 를 고려하세요. 20주차 멀티스레딩에서 다시 다룹니다.
8. stat: 파일의 신상명세서
8.1 ls -l 이 아는 모든 것
1주차 2절에서 ls -l 의 한 줄을 칸마다 뜯어봤습니다. 타입, 권한, 링크 수, 소유자, 그룹, 크기, 수정 시각. ls 는 이 정보를 어디서 가져올까요? 전부 stat 시스템 콜 하나에서 나옵니다. 같은 이름의 명령도 있습니다.
$ stat /etc/hostname
  파일: /etc/hostname
  크기: 19        	블록: 8          입출력 블록: 4096   일반 파일
장치: 252,0	아이노드: 55574702    링크: 1
접근: (0644/-rw-r--r--)  UID: (    0/    root)   GID: (    0/    root)
접근: 2026-09-29 02:15:23.813353120 +0900
수정: 2026-01-12 16:17:48.488915541 +0900
변경: 2026-01-12 16:17:48.488915541 +0900
생성: 2026-01-12 16:13:20.251840173 +0900
ls -l 보다 훨씬 많습니다. 이 명령이 커널에서 받아 오는 것이 struct stat 이고, 우리도 같은 것을 받을 수 있습니다.
struct stat {
    mode_t  st_mode;     /* 타입 + 권한 (비트 마스크!) */
    off_t   st_size;     /* 크기 (바이트) */
    uid_t   st_uid;      /* 소유자 ID */
    gid_t   st_gid;      /* 그룹 ID */
    nlink_t st_nlink;    /* 하드 링크 수 */
    time_t  st_mtime;    /* 마지막 수정 시각 */
    ino_t   st_ino;      /* 아이노드 번호 (22주차) */
    ...
};
examples/file_stat.c:
/*
 * file_stat.c - stat: 파일의 신상명세서 (ls -l 미니)
 * 18주차: POSIX 시스템 프로그래밍
 *
 * ls -l이 보여주는 모든 정보(타입, 권한, 크기, 시간...)는
 * stat() 시스템 콜 하나에서 나옵니다.
 *
 * struct stat의 주요 멤버:
 *   st_mode  : 타입 + 권한 (비트 마스크!)
 *   st_size  : 크기 (바이트)
 *   st_uid   : 소유자
 *   st_mtime : 마지막 수정 시각
 *   st_nlink : 하드 링크 수
 */
#include <stdio.h>
#include <string.h>
#include <time.h>
#include <unistd.h>
#include <sys/stat.h>
#include <sys/types.h>
#include <pwd.h>         /* getpwuid: uid -> 사용자 이름 */
#include <fcntl.h>

/* 파일 타입 문자 (ls의 첫 글자) */
char type_char(mode_t mode) {
    if (S_ISREG(mode))  return '-';      /* 일반 파일 */
    if (S_ISDIR(mode))  return 'd';      /* 디렉토리 */
    if (S_ISLNK(mode))  return 'l';      /* 심볼릭 링크 */
    if (S_ISCHR(mode))  return 'c';      /* 문자 장치 (터미널 등) */
    if (S_ISBLK(mode))  return 'b';      /* 블록 장치 (디스크) */
    if (S_ISFIFO(mode)) return 'p';      /* 파이프 */
    if (S_ISSOCK(mode)) return 's';      /* 소켓 */
    return '?';
}

/* rwxrwxrwx 문자열 만들기 - st_mode의 비트를 하나씩 검사 */
void perm_string(mode_t mode, char out[10]) {
    const char *rwx = "rwxrwxrwx";
    mode_t bits[] = {S_IRUSR, S_IWUSR, S_IXUSR,
                     S_IRGRP, S_IWGRP, S_IXGRP,
                     S_IROTH, S_IWOTH, S_IXOTH};
    for (int i = 0; i < 9; i++) {
        out[i] = (mode & bits[i]) ? rwx[i] : '-';
    }
    out[9] = '\0';
}

/* ls -l 한 줄 흉내 */
void print_stat_line(const char *path) {
    struct stat st;
    if (lstat(path, &st) < 0) {          /* lstat: 링크 자체를 조사 */
        perror(path);
        return;
    }

    char perms[10];
    perm_string(st.st_mode, perms);

    /* 소유자 이름 */
    struct passwd *pw = getpwuid(st.st_uid);
    const char *owner = pw ? pw->pw_name : "?";

    /* 수정 시각 */
    char timestr[32];
    struct tm *tm = localtime(&st.st_mtime);
    strftime(timestr, sizeof(timestr), "%m-%d %H:%M", tm);

    printf("%c%s %2lu %-8s %8ld %s %s\n",
           type_char(st.st_mode), perms,
           (unsigned long)st.st_nlink, owner,
           (long)st.st_size, timestr, path);
}

int main(void) {
    printf("=== 1. ls -l 미니: stat이 아는 모든 것 ===\n");
    print_stat_line("/etc/hostname");
    print_stat_line("/etc");
    print_stat_line("/dev/null");
    print_stat_line("/tmp");
    printf("(첫 글자: -=파일 d=디렉토리 c=문자장치, 그다음 rwx 3벌)\n\n");

    /* ---------- 2. st_mode 해부 ---------- */
    printf("=== 2. st_mode = 타입 + 권한이 한 정수에 ===\n");
    struct stat st;
    stat("/etc/hostname", &st);
    printf("/etc/hostname의 st_mode = %o (8진수)\n", st.st_mode);
    printf("  타입 검사: S_ISREG() -> %s\n",
           S_ISREG(st.st_mode) ? "일반 파일" : "아님");
    printf("  권한 부분: %o (마지막 3자리가 rwx 3벌)\n",
           st.st_mode & 0777);
    printf("  \"내가 읽을 수 있나?\": access(R_OK) -> %s\n\n",
           access("/etc/hostname", R_OK) == 0 ? "가능" : "불가");

    /* ---------- 3. 파일 만들어서 관찰 ---------- */
    printf("=== 3. 권한 변경 실험 (chmod) ===\n");
    int fd = open("stat_demo.txt", O_WRONLY | O_CREAT | O_TRUNC, 0644);
    write(fd, "hello\n", 6);
    close(fd);

    print_stat_line("stat_demo.txt");
    chmod("stat_demo.txt", 0400);        /* 소유자 읽기만 */
    printf("chmod 0400 후:\n");
    print_stat_line("stat_demo.txt");
    printf("이제 쓰기 시도하면? open(O_WRONLY) -> %s\n",
           open("stat_demo.txt", O_WRONLY) < 0 ? "거부! (권한이 지킨다)"
                                                : "성공(root인가요?)");

    /* ---------- 4. 크기의 진실 ---------- */
    printf("\n=== 4. 파일 크기 구하는 표준 방법 ===\n");
    stat("stat_demo.txt", &st);
    printf("stat으로: %ld바이트 (9주차 fseek+ftell보다 깔끔!)\n",
           (long)st.st_size);

    unlink("stat_demo.txt");
    printf("\n(stat_demo.txt 정리 완료)\n");

    printf("\n정리:\n");
    printf("1. stat = 경로로, fstat = 열린 fd로, lstat = 링크 자체를\n");
    printf("2. st_mode는 비트 마스크: S_ISxxx()로 타입, & 0777로 권한\n");
    printf("3. 0644, 0755 같은 8진수 권한 표기에 익숙해지세요\n");
    return 0;
}
새로 나온 것들입니다.
#include <sys/stat.h>:struct stat,stat/lstat/fstat,S_ISREG같은 매크로,chmod.#include <pwd.h>,getpwuid(uid): 사용자 번호(UID)를 이름으로 바꿉니다./etc/passwd를 찾아 주는 함수입니다. 1주차ls -l에서root나user로 보이던 그 이름이 실제로는 숫자였습니다.localtime,strftime:time_t초 단위 시각을 사람이 읽는 문자열로. 9주차에서 봤습니다.access(path, R_OK): “지금 이 사용자가 이 파일을 읽을 수 있는가”를 묻습니다.W_OK,X_OK도 있습니다.chmod(path, 0400): 1주차의chmod명령이 부르는 시스템 콜입니다.
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/file_stat.c -o build/file_stat
$ ./build/file_stat
=== 1. ls -l 미니: stat이 아는 모든 것 ===
-rw-r--r--  1 root           19 01-12 16:17 /etc/hostname
drwxr-xr-x 173 root        12288 09-23 22:22 /etc
crw-rw-rw-  1 root            0 09-23 21:55 /dev/null
drwxrwxrwx 270 root        36864 09-29 02:14 /tmp
(첫 글자: -=파일 d=디렉토리 c=문자장치, 그다음 rwx 3벌)

=== 2. st_mode = 타입 + 권한이 한 정수에 ===
/etc/hostname의 st_mode = 100644 (8진수)
  타입 검사: S_ISREG() -> 일반 파일
  권한 부분: 644 (마지막 3자리가 rwx 3벌)
  "내가 읽을 수 있나?": access(R_OK) -> 가능

=== 3. 권한 변경 실험 (chmod) ===
-rw-r--r--  1 user            6 09-29 02:14 stat_demo.txt
chmod 0400 후:
-r--------  1 user            6 09-29 02:14 stat_demo.txt
이제 쓰기 시도하면? open(O_WRONLY) -> 거부! (권한이 지킨다)

=== 4. 파일 크기 구하는 표준 방법 ===
stat으로: 6바이트 (9주차 fseek+ftell보다 깔끔!)

(stat_demo.txt 정리 완료)

정리:
1. stat = 경로로, fstat = 열린 fd로, lstat = 링크 자체를
2. st_mode는 비트 마스크: S_ISxxx()로 타입, & 0777로 권한
3. 0644, 0755 같은 8진수 권한 표기에 익숙해지세요

stat 으로 본 파일
ls -l 한 줄을 직접 만들어 본 것입니다. /etc/hostname 줄을 진짜 ls -l 과 비교해 보세요.
$ ls -l /etc/hostname
-rw-r--r-- 1 root root 19  1월 12  2026 /etc/hostname
권한, 링크 수, 소유자, 크기가 같습니다. 그룹 이름과 날짜 서식만 우리가 생략했을 뿐입니다. 3번 실험에서는 chmod 0400 뒤에 open(O_WRONLY) 가 거부되는 것도 확인했습니다. 1.4절 표의 EACCES 이고, 1주차 9절에서 chmod -x 한 뒤 실행이 거부된 것과 같은 원리입니다. 권한은 파일에 붙어 있고, 커널이 시스템 콜마다 검사합니다.
8.2 st_mode: 하나의 정수에 두 정보가
st_mode 는 타입과 권한이 함께 들어 있는 비트 마스크입니다.
/etc/hostname의 st_mode = 100644 (8진수)
                          ^^^ ^^^
                          타입 권한
앞부분(100)이 타입, 뒷부분(644)이 권한입니다. 8주차의 비트 필드 발상과 같습니다. 그래서 꺼내는 방법이 다릅니다.
타입은 매크로로:
char type_char(mode_t mode) {
    if (S_ISREG(mode))  return '-';      /* 일반 파일 */
    if (S_ISDIR(mode))  return 'd';      /* 디렉토리 */
    if (S_ISLNK(mode))  return 'l';      /* 심볼릭 링크 */
    if (S_ISCHR(mode))  return 'c';      /* 문자 장치 (터미널 등) */
    if (S_ISBLK(mode))  return 'b';      /* 블록 장치 (디스크) */
    if (S_ISFIFO(mode)) return 'p';      /* 파이프 */
    if (S_ISSOCK(mode)) return 's';      /* 소켓 */
    return '?';
}
ls -l 의 첫 글자가 바로 이것입니다. 1주차에서 -, d, l 세 가지만 배웠는데, 실제로는 일곱 가지입니다. 실행 결과에서 /dev/null 이 c(문자 장치)로 나온 것을 보세요. 2.1절에서 본 터미널 /dev/pts/14 도 c 입니다. “모든 것은 파일”이지만 그 안에도 종류가 있습니다. 19주차의 파이프(p), 21주차의 소켓(s)도 여기 미리 나와 있습니다.
권한은 비트 검사로:
void perm_string(mode_t mode, char out[10]) {
    const char *rwx = "rwxrwxrwx";
    mode_t bits[] = {S_IRUSR, S_IWUSR, S_IXUSR,
                     S_IRGRP, S_IWGRP, S_IXGRP,
                     S_IROTH, S_IWOTH, S_IXOTH};
    for (int i = 0; i < 9; i++) {
        out[i] = (mode & bits[i]) ? rwx[i] : '-';
    }
    out[9] = '\0';
}
9개 비트를 차례로 검사해 rwxr-xr-x 문자열을 만듭니다. 비트가 켜져 있으면 해당 글자, 아니면 -. 1주차 2절에서 “왜 하필 4, 2, 1 일까”라고 했던 답이 여기 있습니다. 4 = 100, 2 = 010, 1 = 001 이라 & 로 검사하면 서로 겹치지 않습니다. S_IRUSR 은 Read USR(소유자 읽기) = 0400, S_IWGRP 는 Write GRP(그룹 쓰기) = 0020 처럼 이름이 곧 뜻입니다.
8.3 stat 3형제
이름이 비슷한 함수가 셋 있고, 차이가 중요합니다.
| 함수 | 인자 | 심볼릭 링크를 만나면 |
|---|---|---|
stat(path, &st) |
경로 | 따라간다 (링크가 가리키는 대상의 정보) |
lstat(path, &st) |
경로 | 따라가지 않는다 (링크 자체의 정보) |
fstat(fd, &st) |
열린 fd | (해당 없음) |
예제가 lstat 을 쓰는 이유가 있습니다. 디렉터리를 재귀로 돌 때 stat 을 쓰면 심볼릭 링크를 따라가다 무한 루프에 빠질 수 있습니다. 링크가 상위 디렉터리를 가리키면 영원히 돕니다. ls -l 이 링크를 l 로 표시하려면 lstat 이어야 합니다. 1주차에서 ls -l /usr/bin/gcc* 를 쳐서 -> 가 붙은 줄을 본 것이 이것입니다.
fstat 은 이미 연 파일에 씁니다. 경로로 다시 찾을 필요가 없어 빠르고, 그 사이 경로가 바뀌는 경쟁 조건도 없습니다(TOCTOU 문제. 24주차 보안 편에서 다룹니다).
8.4 파일 크기 구하기: stat vs fseek
9주차에서 파일 크기를 구할 때 이렇게 했습니다.
fseek(fp, 0, SEEK_END);
long size = ftell(fp);
fseek(fp, 0, SEEK_SET);     /* 되돌리기까지 해야 함 */
이제 더 나은 방법을 압니다.
struct stat st;
stat(path, &st);
off_t size = st.st_size;
파일을 열 필요도 없고, 위치를 옮겼다 되돌릴 필요도 없습니다. 게다가 fseek 방식은 파이프나 소켓처럼 위치 이동이 안 되는 대상에서는 아예 실패합니다. 파일 크기가 필요하면 앞으로는 stat 을 쓰세요. 프로젝트 3 의 로그 데몬이 “로그가 한도를 넘었나?”를 검사할 때 쓰는 방법입니다.
9. readdir: 12주차 트리가 현실이 되다
9.1 진짜 디렉터리를 걷기
12주차에서 “가짜” 파일 시스템 트리를 만들어 순회했습니다. 이제 진짜를 걷습니다. 핵심 함수는 셋뿐이고, 9주차의 파일 함수와 닮은꼴입니다.
| 함수 | 하는 일 | 9주차의 짝 |
|---|---|---|
DIR *opendir(const char *path) |
디렉터리를 연다 | fopen |
struct dirent *readdir(DIR *) |
항목 하나를 준다. 끝이면 NULL |
fgets |
closedir(DIR *) |
닫는다 | fclose |
struct dirent 에서 믿을 수 있는 필드는 d_name(이름) 하나입니다. 그리고 재귀 구조는 12주차의 트리 DFS 그대로입니다.
examples/dir_walk.c:
/*
 * dir_walk.c - 디렉토리 순회: 12주차 트리가 현실이 되다
 * 18주차: POSIX 시스템 프로그래밍
 *
 * 12주차에서 "가짜" 파일 시스템 트리를 만들었죠.
 * 오늘은 opendir/readdir로 "진짜" 디렉토리를 걷습니다.
 *
 * 핵심 3종:
 *   opendir(경로) -> DIR*        (fopen과 닮은꼴)
 *   readdir(DIR*) -> 항목 하나씩 (NULL이면 끝)
 *   closedir(DIR*)
 *
 * 재귀 순회 = 12주차의 트리 DFS 그대로!
 * du(크기 합산)와 find(-name 검색)를 만들어 봅니다.
 */
#include <stdio.h>
#include <string.h>
#include <dirent.h>      /* opendir, readdir */
#include <sys/stat.h>
#include <unistd.h>
#include <fcntl.h>

static int dir_count, file_count;
static long total_bytes;

/* 재귀 순회: 트리 DFS의 실전판 */
void walk(const char *path, int depth, int max_depth) {
    DIR *dir = opendir(path);
    if (dir == NULL) {
        /* 권한 없는 디렉토리 등 - 견고한 도구는 계속 간다 */
        return;
    }

    struct dirent *entry;
    while ((entry = readdir(dir)) != NULL) {
        /* "."(자신)과 ".."(부모)는 건너뛴다 - 안 하면 무한 재귀! */
        if (strcmp(entry->d_name, ".") == 0 ||
            strcmp(entry->d_name, "..") == 0) {
            continue;
        }

        char full[1024];
        snprintf(full, sizeof(full), "%s/%s", path, entry->d_name);

        struct stat st;
        if (lstat(full, &st) < 0) continue;

        if (depth < max_depth) {         /* 너무 깊으면 출력 생략 */
            printf("%*s%s%s\n", depth * 2, "", entry->d_name,
                   S_ISDIR(st.st_mode) ? "/" : "");
        }

        if (S_ISDIR(st.st_mode)) {
            dir_count++;
            walk(full, depth + 1, max_depth);    /* 재귀! */
        } else if (S_ISREG(st.st_mode)) {
            file_count++;
            total_bytes += st.st_size;           /* du의 원리 (후위 합산) */
        }
    }
    closedir(dir);
}

/* find -name 미니: 이름에 부분 문자열이 들어간 파일 찾기 */
void find_name(const char *path, const char *keyword) {
    DIR *dir = opendir(path);
    if (dir == NULL) return;

    struct dirent *entry;
    while ((entry = readdir(dir)) != NULL) {
        if (strcmp(entry->d_name, ".") == 0 ||
            strcmp(entry->d_name, "..") == 0) continue;

        char full[1024];
        snprintf(full, sizeof(full), "%s/%s", path, entry->d_name);

        if (strstr(entry->d_name, keyword) != NULL) {
            printf("  %s\n", full);              /* 발견! */
        }

        struct stat st;
        if (lstat(full, &st) == 0 && S_ISDIR(st.st_mode)) {
            find_name(full, keyword);            /* 하위로 재귀 */
        }
    }
    closedir(dir);
}

/* 데모용 디렉토리 트리 생성 */
void make_demo_tree(void) {
    mkdir("demo_dir", 0755);
    mkdir("demo_dir/src", 0755);
    mkdir("demo_dir/docs", 0755);
    mkdir("demo_dir/src/utils", 0755);

    const char *files[] = {
        "demo_dir/README.md", "demo_dir/src/main.c",
        "demo_dir/src/util.c", "demo_dir/src/utils/helper.c",
        "demo_dir/docs/guide.md", "demo_dir/docs/api.md",
    };
    for (int i = 0; i < 6; i++) {
        int fd = open(files[i], O_WRONLY | O_CREAT | O_TRUNC, 0644);
        if (fd >= 0) {
            /* 파일마다 다른 크기 */
            for (int k = 0; k <= i; k++) write(fd, "0123456789", 10);
            close(fd);
        }
    }
}

void remove_demo_tree(void) {
    unlink("demo_dir/src/utils/helper.c");
    unlink("demo_dir/src/main.c");
    unlink("demo_dir/src/util.c");
    unlink("demo_dir/docs/guide.md");
    unlink("demo_dir/docs/api.md");
    unlink("demo_dir/README.md");
    rmdir("demo_dir/src/utils");
    rmdir("demo_dir/src");
    rmdir("demo_dir/docs");
    rmdir("demo_dir");
}

int main(void) {
    make_demo_tree();

    printf("=== 1. 재귀 순회 (tree 미니) ===\n");
    printf("demo_dir/\n");
    dir_count = file_count = 0;
    total_bytes = 0;
    walk("demo_dir", 1, 5);

    printf("\n=== 2. du 미니: 후위 합산 ===\n");
    printf("디렉토리 %d개, 파일 %d개, 총 %ld바이트\n",
           dir_count, file_count, total_bytes);
    printf("(12주차 file_tree의 du가 진짜가 됐다!)\n");

    printf("\n=== 3. find 미니: 이름 검색 ===\n");
    printf("'.c' 파일 찾기:\n");
    find_name("demo_dir", ".c");

    printf("\n=== 4. readdir의 진실 ===\n");
    printf("1. 순서 보장 없음! (ls는 받아서 따로 정렬하는 것)\n");
    printf("2. d_name만 믿을 수 있고, 타입은 lstat으로 확인이 정석\n");
    printf("3. '.'과 '..' 건너뛰기를 잊으면 무한 재귀!\n");

    remove_demo_tree();
    printf("\n(demo_dir 정리 완료)\n");
    return 0;
}
새로 나온 것들입니다.
#include <dirent.h>:DIR,struct dirent,opendir가족.mkdir("demo_dir", 0755),rmdir: 디렉터리 만들기와 지우기 시스템 콜. 1주차mkdir명령의 정체입니다. 권한 인자와 umask 의 관계는 2.3절과 같습니다.printf("%*s%s%s\n", depth * 2, "", ...):%*s는 “폭을 인자로 받는 문자열” 서식입니다. 빈 문자열을depth * 2칸 폭으로 찍어 들여쓰기를 만듭니다. 2주차printf의 폭 지정을 응용한 것입니다.strstr(entry->d_name, keyword): 4주차의 부분 문자열 찾기.
컴파일하고 실행합니다.
$ gcc -Wall -Wextra -std=gnu11 -g examples/dir_walk.c -o build/dir_walk
$ ./build/dir_walk
=== 1. 재귀 순회 (tree 미니) ===
demo_dir/
  src/
    util.c
    utils/
      helper.c
    main.c
  README.md
  docs/
    guide.md
    api.md

=== 2. du 미니: 후위 합산 ===
디렉토리 3개, 파일 6개, 총 210바이트
(12주차 file_tree의 du가 진짜가 됐다!)

=== 3. find 미니: 이름 검색 ===
'.c' 파일 찾기:
  demo_dir/src/util.c
  demo_dir/src/utils/helper.c
  demo_dir/src/main.c

=== 4. readdir의 진실 ===
1. 순서 보장 없음! (ls는 받아서 따로 정렬하는 것)
2. d_name만 믿을 수 있고, 타입은 lstat으로 확인이 정석
3. '.'과 '..' 건너뛰기를 잊으면 무한 재귀!

(demo_dir 정리 완료)

디렉터리 순회
tree, du, find 세 도구를 한 파일에서 만들었습니다. 전부 같은 재귀 순회 위에 서 있고, 다른 것은 “각 항목에서 무엇을 하느냐”뿐입니다. 210바이트는 파일 여섯 개의 크기 10 + 20 + 30 + 40 + 50 + 60 의 합입니다. make_demo_tree 가 i 번째 파일에 10바이트를 i + 1 번 쓰기 때문입니다.
9.2 반드시 건너뛰어야 할 두 항목
    while ((entry = readdir(dir)) != NULL) {
        /* "."(자신)과 ".."(부모)는 건너뛴다 - 안 하면 무한 재귀! */
        if (strcmp(entry->d_name, ".") == 0 ||
            strcmp(entry->d_name, "..") == 0) {
            continue;
        }
1주차 2절에서 ls -a 를 치면 . 과 .. 이 나온다고 했습니다. “모든 폴더 안에 이 두 이름이 실제로 들어 있다”고 했는데, readdir 이 정말로 그 둘을 돌려줍니다. 걸러내지 않으면 어떻게 될까요?
.으로 재귀하면 같은 디렉터리를 영원히 반복..으로 재귀하면 부모로 올라갔다 다시 내려와 영원히 반복
즉시 무한 재귀 → 5주차에서 본 스택 오버플로우입니다. 디렉터리 순회 코드에서 가장 먼저 확인해야 할 부분이고, 빠뜨리면 바로 프로그램이 죽으니 오히려 발견은 쉽습니다.
9.3 경로 조립과 lstat
        char full[1024];
        snprintf(full, sizeof(full), "%s/%s", path, entry->d_name);

        struct stat st;
        if (lstat(full, &st) < 0) continue;
readdir 이 주는 것은 이름뿐입니다(d_name). 경로가 아닙니다. 그래서 부모 경로와 이어 붙여 전체 경로를 만들어야 lstat 을 부를 수 있습니다. snprintf 를 쓴 이유는 4주차의 교훈, 버퍼 오버플로우 방지입니다. 경로가 아무리 길어도 1024바이트를 넘겨 쓰지 않습니다. 경로 길이 제한(PATH_MAX, 보통 4096)을 넘는 깊은 트리에서는 잘림이 생길 수 있으니, 견고한 도구라면 snprintf 의 반환값을 확인해야 합니다.
lstat 실패 시 continue 하는 것도 중요합니다. 순회 도중 파일이 삭제되거나 권한이 없을 수 있는데, 견고한 도구는 거기서 멈추지 않고 계속 갑니다. opendir 실패 시 그냥 return 하는 것도 같은 이유입니다. find / 를 쳤을 때 “허가 거부” 가 수십 줄 나오면서도 끝까지 도는 것이 이 처리 덕분입니다.
9.4 readdir 의 진실 두 가지
1. 순서 보장이 없습니다.
실행 결과를 다시 보세요. src/ 안이 util.c, utils/, main.c 순서입니다. 알파벳순도, 만든 순서(main.c 가 먼저)도 아닙니다. readdir 은 파일 시스템이 내부적으로 저장한 순서대로 돌려주는데, ext4 는 해시 순서라 사실상 무작위입니다. 그럼 ls 는 왜 정렬되어 보일까요? ls 가 전부 읽어서 직접 정렬하기 때문입니다. 우리가 만드는 도구도 정렬이 필요하면 직접 해야 합니다. 15주차의 qsort 가 여기서 쓰입니다(연습 문제 5).
2. d_type 보다 lstat 이 정석입니다.
struct dirent 에는 d_type 필드가 있어 타입을 바로 알 수 있을 것 같습니다. 그런데 이 필드는 POSIX 표준이 아니고, 일부 파일 시스템에서는 항상 DT_UNKNOWN 을 돌려줍니다. 이식성 있는 코드를 원한다면 lstat 으로 확인하세요. 성능이 중요하다면 d_type 을 먼저 보고 DT_UNKNOWN 일 때만 lstat 을 부르는 절충안도 있습니다. lstat 은 시스템 콜이라 항목마다 부르면 느립니다(1.2절).
9.5 12주차와 이어지는 지점
이 예제의 세 기능이 각각 12주차 트리 순회의 어느 부분에 대응하는지 보세요.
| 이번 주 도구 | 12주차 개념 |
|---|---|
tree (들여쓰기 출력) |
전위 순회 — 노드를 먼저 출력하고 자식으로 |
du (크기 합산) |
후위 순회 — 자식을 다 처리하고 합산 |
find (이름 검색) |
DFS 탐색 + 경로 조립(백트래킹) |
“가짜 데이터로 연습한 것이 진짜 세계에서 그대로 통한다.” 자료구조를 배우는 이유가 이것입니다. 12주차에 만든 것이 장난감이 아니었다는 증거입니다.
10. 실습 프로젝트
projects/ 폴더에는 실제로 쓰는 도구의 축소판 세 개가 있습니다. 이번 주에 배운 것이 전부 들어갑니다.
$ make
$ ./build/mini_shell        # 또는 sysmon, log_daemon --demo
프로젝트 1: 미니 쉘 (mini_shell.c)
매일 쓰는 bash 를 만듭니다. 4.6절의 3박자에 실전 기능을 얹었습니다.
/*
 * mini_shell.c - 미니 쉘 (bash 클론)
 * 18주차 프로젝트 1
 *
 * 여러분이 매일 쓰는 그 쉘을 만듭니다. fork+exec+wait 3박자에
 * 실전 기능을 얹습니다:
 *
 *   - 명령 파싱 (공백 분리)
 *   - 내장 명령: cd, pwd, exit, help  (fork 없이 직접 처리!)
 *   - 외부 명령: fork + execvp + waitpid
 *   - 리다이렉션: cmd > file, cmd < file
 *   - 백그라운드 실행: cmd &
 *   - Ctrl+C가 쉘은 안 죽이고 실행 중인 명령만 중단
 *
 * 사용: ./mini_shell 실행 후 명령 입력 (파이프 입력도 동작)
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <signal.h>
#include <fcntl.h>
#include <sys/wait.h>

#define MAX_LINE 1024
#define MAX_ARGS 64

/* ---------- SIGCHLD: 백그라운드 자식 수거 (좀비 방지!) ---------- */
void reap_children(int signo) {
    (void)signo;
    /* WNOHANG: 죽은 자식만 비차단으로 수거 (안전 규칙: 핸들러 최소화) */
    while (waitpid(-1, NULL, WNOHANG) > 0) {}
}

/* ---------- 명령줄 파싱 ---------- */
typedef struct {
    char *argv[MAX_ARGS];
    char *input_file;            /* < 파일 */
    char *output_file;           /* > 파일 */
    int   background;            /* & 여부 */
} Command;

/* 라인을 공백으로 잘라 Command 구성. 성공 1, 빈 줄 0 */
int parse_command(char *line, Command *cmd) {
    memset(cmd, 0, sizeof(*cmd));
    int argc = 0;

    char *token = strtok(line, " \t");
    while (token != NULL && argc < MAX_ARGS - 1) {
        if (strcmp(token, "<") == 0) {
            token = strtok(NULL, " \t");
            cmd->input_file = token;
        } else if (strcmp(token, ">") == 0) {
            token = strtok(NULL, " \t");
            cmd->output_file = token;
        } else if (strcmp(token, "&") == 0) {
            cmd->background = 1;
        } else {
            cmd->argv[argc++] = token;
        }
        token = strtok(NULL, " \t");
    }
    cmd->argv[argc] = NULL;      /* execvp의 NULL 종결! */
    return argc > 0;
}

/* ---------- 내장 명령 (fork 없이 쉘 자신이 처리) ---------- */
/* cd가 내장이어야 하는 이유: 자식에서 chdir 하면 자식만 이동하고
 * 끝! 쉘 자신의 디렉토리를 바꾸려면 쉘 프로세스가 직접 해야 한다 */
int run_builtin(Command *cmd) {
    if (strcmp(cmd->argv[0], "exit") == 0) {
        printf("mini shell을 종료합니다.\n");
        exit(0);
    }
    if (strcmp(cmd->argv[0], "cd") == 0) {
        const char *dest = cmd->argv[1] ? cmd->argv[1] : getenv("HOME");
        if (chdir(dest) < 0) perror("cd");
        return 1;
    }
    if (strcmp(cmd->argv[0], "pwd") == 0) {
        char buf[MAX_LINE];
        if (getcwd(buf, sizeof(buf)) != NULL) printf("%s\n", buf);
        return 1;
    }
    if (strcmp(cmd->argv[0], "help") == 0) {
        printf("내장: cd [dir] / pwd / help / exit\n");
        printf("기능: cmd args / cmd > out / cmd < in / cmd &\n");
        return 1;
    }
    return 0;                    /* 내장 아님 */
}

/* ---------- 외부 명령 실행: fork + exec + wait ---------- */
void run_external(Command *cmd) {
    pid_t pid = fork();

    if (pid < 0) {
        perror("fork");
        return;
    }

    if (pid == 0) {
        /* ===== 자식: 변신 준비 ===== */

        /* 자식은 Ctrl+C에 정상 반응해야 한다 (쉘은 무시하지만!) */
        signal(SIGINT, SIG_DFL);

        /* 리다이렉션: fd 복제의 마법 (dup2) */
        if (cmd->input_file != NULL) {
            int fd = open(cmd->input_file, O_RDONLY);
            if (fd < 0) { perror(cmd->input_file); exit(1); }
            dup2(fd, 0);         /* 표준 입력(0)이 이 파일을 가리키게! */
            close(fd);
        }
        if (cmd->output_file != NULL) {
            int fd = open(cmd->output_file,
                          O_WRONLY | O_CREAT | O_TRUNC, 0644);
            if (fd < 0) { perror(cmd->output_file); exit(1); }
            dup2(fd, 1);         /* 표준 출력(1) 교체 */
            close(fd);
        }

        execvp(cmd->argv[0], cmd->argv);         /* 변신! */
        fprintf(stderr, "%s: 명령을 찾을 수 없습니다\n", cmd->argv[0]);
        exit(127);
    }

    /* ===== 부모(쉘) ===== */
    if (cmd->background) {
        printf("[백그라운드 %d] 시작\n", pid);
        /* wait 안 함 -> SIGCHLD 핸들러가 나중에 수거 */
    } else {
        int status;
        waitpid(pid, &status, 0);
        if (WIFEXITED(status) && WEXITSTATUS(status) != 0) {
            printf("(종료 코드 %d)\n", WEXITSTATUS(status));
        } else if (WIFSIGNALED(status)) {
            printf("(시그널 %d로 종료)\n", WTERMSIG(status));
        }
    }
}

int main(void) {
    /* 쉘 자신은 Ctrl+C 무시 (자식만 죽도록) */
    signal(SIGINT, SIG_IGN);

    /* 백그라운드 자식 수거 준비 */
    struct sigaction sa;
    memset(&sa, 0, sizeof(sa));
    sa.sa_handler = reap_children;
    sa.sa_flags = SA_RESTART;            /* fgets가 끊기지 않게 */
    sigaction(SIGCHLD, &sa, NULL);

    printf("mini shell - fork+exec+wait로 만드는 bash (help 참고)\n");

    char line[MAX_LINE];
    Command cmd;

    while (1) {
        /* 프롬프트: 현재 디렉토리 표시 */
        char cwd[256];
        if (getcwd(cwd, sizeof(cwd)) == NULL) strcpy(cwd, "?");
        char *base = strrchr(cwd, '/');
        printf("mini:%s$ ", (base && base[1]) ? base + 1 : "/");
        fflush(stdout);

        if (fgets(line, sizeof(line), stdin) == NULL) {
            printf("\n(EOF) 종료합니다.\n");     /* Ctrl+D */
            break;
        }
        line[strcspn(line, "\r\n")] = '\0';

        if (!parse_command(line, &cmd)) continue;    /* 빈 줄 */
        if (run_builtin(&cmd)) continue;             /* 내장 처리됨 */
        run_external(&cmd);
    }
    return 0;
}
실행해 봅시다. 아래는 실제 세션이고, 입력한 명령을 알아보기 쉽게 프롬프트 뒤에 적었습니다.
$ ./build/mini_shell
mini shell - fork+exec+wait로 만드는 bash (help 참고)
mini:week18$ pwd
/home/user/c_programming/week18
mini:week18$ echo hello
hello
mini:week18$ ls -l /etc/hostname
-rw-r--r-- 1 root root 19  1월 12  2026 /etc/hostname
mini:week18$ no_such_cmd
no_such_cmd: 명령을 찾을 수 없습니다
(종료 코드 127)
mini:week18$ false
(종료 코드 1)
mini:week18$ echo 이 줄은 파일로 > out.txt
mini:week18$ cat out.txt
이 줄은 파일로
mini:week18$ sort < out.txt
이 줄은 파일로
mini:week18$ sleep 1 &
[백그라운드 316352] 시작
mini:week18$ cd /tmp
mini:tmp$ pwd
/tmp
mini:tmp$ cd
mini:user$ help
내장: cd [dir] / pwd / help / exit
기능: cmd args / cmd > out / cmd < in / cmd &
mini:user$ exit
mini shell을 종료합니다.
180줄짜리 프로그램이 pwd, echo, ls, sort, sleep 을 전부 실행합니다. 물론 그 명령들의 코드는 한 줄도 없습니다. 전부 fork 한 자식이 execvp 로 변신한 것입니다. 배울 것이 밀도 높게 담겨 있습니다.
① 명령줄 파싱 — strtok
    char *token = strtok(line, " \t");
    while (token != NULL && argc < MAX_ARGS - 1) {
        if (strcmp(token, "<") == 0) { ... cmd->input_file = token; }
        else if (strcmp(token, ">") == 0) { ... cmd->output_file = token; }
        else if (strcmp(token, "&") == 0) { cmd->background = 1; }
        else { cmd->argv[argc++] = token; }
        token = strtok(NULL, " \t");
    }
    cmd->argv[argc] = NULL;      /* execvp의 NULL 종결! */
4주차의 strtok 이 한 줄을 공백으로 잘라 argv 배열을 채웁니다. ls -l /tmp 는 {"ls", "-l", "/tmp", NULL} 이 됩니다. 4.4절에서 강조한 NULL 종결을 마지막 줄에서 꼭 합니다. <, >, & 는 명령의 인자가 아니라 쉘에게 주는 지시이므로 따로 뺍니다. 그래서 echo 이 줄은 파일로 > out.txt 에서 echo 는 > 를 보지 못합니다.
② cd 는 왜 내장 명령이어야 하는가
이 프로젝트에서 가장 중요한 통찰이고, 1주차 2절에서 미뤄 둔 질문의 답입니다. cd 를 다른 명령처럼 fork + exec 로 처리하면 어떻게 될까요?
쉘 → fork → 자식이 chdir("/tmp") → 자식 종료
쉘의 작업 디렉터리는? 그대로!
자식만 이동하고 끝납니다. 3.3절의 “복사이지 공유가 아니다” 때문입니다. 작업 디렉터리도 프로세스마다 따로 있는 속성이라, 자식의 변경은 부모에게 전달되지 않습니다. 그래서 cd 는 쉘 자신이 직접 chdir 을 불러야 합니다. run_builtin 이 fork 없이 처리하는 이유입니다. 같은 이유로 exit(쉘 자신을 끝내야 함), export(쉘 자신의 환경 변수를 바꿔야 함)도 내장입니다. 1주차에서 type cd 가 “셸 내장임”이라고 한 것을 이제 설명할 수 있습니다.
$ which cd
$ echo $?
1
which cd 는 아무것도 못 찾습니다. /usr/bin/cd 같은 파일이 없기 때문입니다.
③ 리다이렉션 = dup2 의 마법
        if (cmd->output_file != NULL) {
            int fd = open(cmd->output_file,
                          O_WRONLY | O_CREAT | O_TRUNC, 0644);
            if (fd < 0) { perror(cmd->output_file); exit(1); }
            dup2(fd, 1);         /* 표준 출력(1) 교체 */
            close(fd);
        }
dup2(fd, 1) 한 줄이 > file 의 전부입니다. “1번 fd 가 이제 이 파일을 가리키게 하라” 는 뜻입니다. 2.1절에서 ls -l /proc/self/fd > fdlist.txt 를 쳤을 때 1번만 파일로 바뀌어 있던 것이 바로 이 결과입니다. 작은 프로그램으로 다시 확인해 봅시다.
#include <stdio.h>
#include <unistd.h>
#include <fcntl.h>

int main(void) {
    printf("1. 이 줄은 화면에 나옵니다\n");
    fflush(stdout);
    int fd = open("dup2_out.txt", O_WRONLY | O_CREAT | O_TRUNC, 0644);
    printf("2. open 이 준 fd = %d\n", fd);
    fflush(stdout);
    dup2(fd, 1);                 /* 1번이 이제 dup2_out.txt 를 가리킨다 */
    close(fd);
    printf("3. 이 줄은 파일로 갑니다\n");
    printf("4. 이 줄도요. 코드는 그냥 printf 인데!\n");
    return 0;
}
$ ./dup2demo
1. 이 줄은 화면에 나옵니다
2. open 이 준 fd = 3
$ cat dup2_out.txt
3. 이 줄은 파일로 갑니다
4. 이 줄도요. 코드는 그냥 printf 인데!
dup2 뒤의 printf 는 코드가 똑같은데 파일로 갔습니다. open 이 3번을 줬고, dup2(3, 1) 로 1번도 같은 파일을 가리키게 한 다음, 필요 없어진 3번은 닫았습니다. 그 뒤 exec 된 프로그램은 아무것도 모른 채 평소대로 printf 를 하고, 그 출력이 파일로 갑니다. 프로그램 쪽 코드를 한 줄도 고치지 않고 출력 대상을 바꾸는 것. 이것이 유닉스 입출력 재지정의 우아함입니다. exec 가 fd 를 유지하기 때문에(4.1절의 표) 가능합니다. fork 로 자식을 만들고, 자식에서 fd 를 바꿔치기하고, exec 로 변신시키는 순서입니다.
④ Ctrl+C 처리
터미널에서 Ctrl+C 를 누르면 포그라운드 프로세스 그룹 전체에 SIGINT 가 갑니다. 쉘도 포함해서요. 그러면 명령을 중단하려고 Ctrl+C 를 눌렀는데 쉘까지 죽습니다. 해법은 이렇습니다.
쉘 자신      : signal(SIGINT, SIG_IGN)   — 무시
자식(exec 전): signal(SIGINT, SIG_DFL)   — 기본 동작(종료)으로 복원
명령만 죽고 쉘은 살아남는 동작이 이렇게 구현됩니다. bash 에서 긴 명령을 Ctrl+C 로 끊었을 때 프롬프트가 돌아오는 것이 이 처리 덕분입니다. 자식에서 굳이 SIG_DFL 로 되돌리는 이유는 4.1절 표의 “무시 설정은 exec 를 넘어 유지된다” 때문입니다. 되돌리지 않으면 sleep 100 이 Ctrl+C 를 무시하는 이상한 쉘이 됩니다. 6.7절 끝의 상자에서 본 현상이 바로 그것입니다.
⑤ 백그라운드 좀비 방지
void reap_children(int signo) {
    (void)signo;
    while (waitpid(-1, NULL, WNOHANG) > 0) {}
}
5.4절의 세 번째 방법입니다. & 로 실행한 명령은 쉘이 기다리지 않으므로, SIGCHLD 핸들러가 대신 수거합니다. while 루프인 이유는 6.5절의 “시그널은 합쳐질 수 있다” 때문이고, SA_RESTART 를 준 이유는 fgets 가 끊기지 않게 하려는 것(6.4절)입니다. 핸들러 안에서 waitpid 만 부르는 것은 7.2절의 안전 목록에 있으니 괜찮습니다.
이번 주에 배운 것이 전부 한 프로그램에 들어 있습니다. fork, exec, wait, 시그널, fd, dup2. 각각 배울 때는 따로 놀던 개념들이 여기서 하나로 엮입니다.
확장 아이디어: 파이프 | (19주차에서 재료를 배웁니다), 환경 변수 확장($HOME), 명령 히스토리, >> 추가 모드(연습 문제 8), 여러 명령 ; 연결.
프로젝트 2: 시스템 모니터 (sysmon.c)
top, free, ps 의 비밀은 데이터 소스가 전부 /proc 이라는 것입니다.
/*
 * sysmon.c - 시스템 모니터링 도구 (top 미니)
 * 18주차 프로젝트 2
 *
 * top, htop, free는 어디서 정보를 얻을까요? 정답: /proc!
 * 리눅스는 커널 내부 상태를 "가짜 파일 시스템"으로 노출합니다.
 * ("모든 것은 파일이다"의 극치 - 커널 상태도 파일로 읽는다!)
 *
 *   /proc/uptime    가동 시간
 *   /proc/loadavg   부하 평균
 *   /proc/meminfo   메모리 상태
 *   /proc/stat      CPU 사용 통계
 *   /proc/[PID]/    프로세스별 정보 (18주차 좀비 관찰에 이미 사용!)
 *
 * 사용법: ./sysmon           # 1회 스냅샷
 *         ./sysmon -w 3      # 3회 갱신 (1초 간격, top처럼)
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <ctype.h>
#include <unistd.h>
#include <dirent.h>

/* /proc 파일에서 한 줄 읽기 도우미 */
int read_first_line(const char *path, char *buf, size_t size) {
    FILE *fp = fopen(path, "r");
    if (fp == NULL) return 0;
    char *ok = fgets(buf, (int)size, fp);
    fclose(fp);
    if (ok) buf[strcspn(buf, "\n")] = '\0';
    return ok != NULL;
}

/* /proc/meminfo에서 "키:  값 kB" 찾기 */
long meminfo_kb(const char *key) {
    FILE *fp = fopen("/proc/meminfo", "r");
    if (fp == NULL) return -1;

    char line[256];
    long value = -1;
    size_t keylen = strlen(key);
    while (fgets(line, sizeof(line), fp) != NULL) {
        if (strncmp(line, key, keylen) == 0 && line[keylen] == ':') {
            sscanf(line + keylen + 1, "%ld", &value);
            break;
        }
    }
    fclose(fp);
    return value;
}

/* 게이지 바 그리기 */
void draw_gauge(const char *label, double percent) {
    int filled = (int)(percent / 5);     /* 20칸 = 100% */
    printf("  %-6s [", label);
    for (int i = 0; i < 20; i++) putchar(i < filled ? '#' : '.');
    printf("] %5.1f%%\n", percent);
}

/* ---------- CPU 사용률: /proc/stat 두 번 읽어 차이 계산 ---------- */
typedef struct {
    long long user, nice, system, idle, iowait, irq, softirq;
} CpuTimes;

int read_cpu(CpuTimes *t) {
    char line[256];
    if (!read_first_line("/proc/stat", line, sizeof(line))) return 0;
    return sscanf(line, "cpu %lld %lld %lld %lld %lld %lld %lld",
                  &t->user, &t->nice, &t->system, &t->idle,
                  &t->iowait, &t->irq, &t->softirq) == 7;
}

double cpu_percent(const CpuTimes *a, const CpuTimes *b) {
    long long busy = (b->user - a->user) + (b->nice - a->nice)
                   + (b->system - a->system) + (b->irq - a->irq)
                   + (b->softirq - a->softirq);
    long long total = busy + (b->idle - a->idle) + (b->iowait - a->iowait);
    return total > 0 ? 100.0 * (double)busy / (double)total : 0;
}

/* ---------- 프로세스 목록: /proc의 숫자 디렉토리들 ---------- */
typedef struct {
    int  pid;
    char name[64];
    char state;
    long rss_kb;                 /* 실제 메모리 사용량 */
} ProcInfo;

int read_proc(int pid, ProcInfo *info) {
    char path[64], line[256];
    snprintf(path, sizeof(path), "/proc/%d/status", pid);

    FILE *fp = fopen(path, "r");
    if (fp == NULL) return 0;    /* 그 사이 죽었을 수도 - 건너뜀 */

    info->pid = pid;
    info->name[0] = '\0';
    info->state = '?';
    info->rss_kb = 0;

    while (fgets(line, sizeof(line), fp) != NULL) {
        if (strncmp(line, "Name:", 5) == 0) {
            sscanf(line + 5, " %63s", info->name);
        } else if (strncmp(line, "State:", 6) == 0) {
            sscanf(line + 6, " %c", &info->state);
        } else if (strncmp(line, "VmRSS:", 6) == 0) {
            sscanf(line + 6, " %ld", &info->rss_kb);
        }
    }
    fclose(fp);
    return 1;
}

int proc_cmp(const void *a, const void *b) {
    long x = ((const ProcInfo *)a)->rss_kb;
    long y = ((const ProcInfo *)b)->rss_kb;
    return (x < y) - (x > y);    /* 메모리 내림차순 */
}

void show_snapshot(void) {
    char line[256];

    printf("========== 시스템 모니터 (PID %d) ==========\n\n", getpid());

    /* 가동 시간 */
    if (read_first_line("/proc/uptime", line, sizeof(line))) {
        double up;
        sscanf(line, "%lf", &up);
        printf("가동 시간: %d일 %d시간 %d분\n",
               (int)(up / 86400), (int)(up / 3600) % 24,
               (int)(up / 60) % 60);
    }

    /* 부하 평균 */
    if (read_first_line("/proc/loadavg", line, sizeof(line))) {
        printf("부하 평균: %s\n", line);
        printf("  (1분/5분/15분 평균 실행 대기 프로세스 수,\n");
        printf("   CPU %ld코어보다 크면 과부하)\n",
               sysconf(_SC_NPROCESSORS_ONLN));
    }

    /* CPU 사용률 (0.5초 간격 두 번 측정) */
    CpuTimes t1, t2;
    if (read_cpu(&t1)) {
        usleep(500000);
        read_cpu(&t2);
        printf("\n");
        draw_gauge("CPU", cpu_percent(&t1, &t2));
    }

    /* 메모리 */
    long total = meminfo_kb("MemTotal");
    long avail = meminfo_kb("MemAvailable");
    if (total > 0 && avail >= 0) {
        double used_pct = 100.0 * (double)(total - avail) / (double)total;
        draw_gauge("메모리", used_pct);
        printf("  (전체 %.1fGB, 사용 가능 %.1fGB)\n",
               total / 1048576.0, avail / 1048576.0);
    }

    /* 메모리 상위 프로세스: /proc의 숫자 디렉토리 순회 (dir_walk 응용!) */
    printf("\n메모리 사용 상위 5개 프로세스:\n");
    printf("  %6s %-20s %5s %10s\n", "PID", "이름", "상태", "메모리");

    static ProcInfo procs[4096];
    int count = 0;

    DIR *proc = opendir("/proc");
    if (proc != NULL) {
        struct dirent *entry;
        while ((entry = readdir(proc)) != NULL && count < 4096) {
            /* 이름이 전부 숫자인 항목만 = 프로세스 */
            if (!isdigit((unsigned char)entry->d_name[0])) continue;
            int pid = atoi(entry->d_name);
            if (read_proc(pid, &procs[count])) count++;
        }
        closedir(proc);
    }

    qsort(procs, (size_t)count, sizeof(ProcInfo), proc_cmp);
    for (int i = 0; i < 5 && i < count; i++) {
        printf("  %6d %-20s %4c %8.1fMB\n",
               procs[i].pid, procs[i].name, procs[i].state,
               procs[i].rss_kb / 1024.0);
    }
    printf("\n총 프로세스: %d개\n", count);
}

int main(int argc, char *argv[]) {
    int repeat = 1;
    if (argc >= 3 && strcmp(argv[1], "-w") == 0) {
        repeat = atoi(argv[2]);
        if (repeat < 1 || repeat > 60) repeat = 3;
    }

    for (int i = 0; i < repeat; i++) {
        if (i > 0) {
            sleep(1);
            printf("\n");
        }
        show_snapshot();
    }

    printf("\n원리 정리:\n");
    printf("1. top/free/ps의 데이터 소스는 전부 /proc (커널 상태의 파일화)\n");
    printf("2. CPU%%는 순간값이 아니라 '두 시점의 차이'로 계산한다\n");
    printf("3. /proc/[숫자] 순회 = 오늘 배운 readdir + 파일 읽기 조합\n");
    return 0;
}
$ ./build/sysmon
========== 시스템 모니터 (PID 316380) ==========

가동 시간: 5일 4시간 21분
부하 평균: 4.06 4.12 3.14 6/1320 316381
  (1분/5분/15분 평균 실행 대기 프로세스 수,
   CPU 12코어보다 크면 과부하)

  CPU    [######..............]  33.6%
  메모리 [####................]  23.1%
  (전체 31.3GB, 사용 가능 24.0GB)

메모리 사용 상위 5개 프로세스:
     PID 이름               상태  메모리
  123194 llama-server            R   2588.5MB
    7121 claude                  S   1728.1MB
  4020302 claude                  S    360.8MB
   13641 claude                  S    302.4MB
  245766 claude                  S    279.5MB

총 프로세스: 413개

원리 정리:
1. top/free/ps의 데이터 소스는 전부 /proc (커널 상태의 파일화)
2. CPU%는 순간값이 아니라 '두 시점의 차이'로 계산한다
3. /proc/[숫자] 순회 = 오늘 배운 readdir + 파일 읽기 조합
① /proc 은 커널 상태의 파일화
리눅스는 커널 내부 상태를 가짜 파일 시스템으로 노출합니다.
| 경로 | 내용 |
|---|---|
/proc/uptime |
가동 시간 (초) |
/proc/loadavg |
부하 평균 |
/proc/meminfo |
메모리 상태 |
/proc/stat |
CPU 사용 통계 (부팅 이후 누적) |
/proc/[PID]/stat |
프로세스별 정보 (5.2절에서 좀비 관찰에 씀) |
/proc/[PID]/status |
사람이 읽기 좋은 프로세스 정보 |
/proc/[PID]/fd |
그 프로세스가 연 파일들 (2.1절) |
디스크에 없는 파일인데 cat 으로 읽을 수 있습니다. 덕분에 커널 상태를 읽는 데 특별한 API 가 필요 없습니다. 9주차의 fopen 과 fgets 면 충분합니다. read_first_line, meminfo_kb 가 정확히 그렇게 합니다. meminfo_kb 는 MemTotal: 32778912 kB 같은 줄에서 키를 찾아 숫자만 sscanf 로 뽑습니다.
$ cat /proc/uptime
$ head -5 /proc/meminfo
$ cat /proc/self/status | head -8
Name:	head
Umask:	0002
State:	R (running)
Tgid:	315861
Ngid:	0
Pid:	315861
PPid:	315105
TracerPid:	0
/proc/self/status 에는 2.3절의 Umask 와 5.2절의 State 가 사람이 읽기 좋은 형태로 있습니다. sysmon 의 read_proc 은 이 파일에서 Name:, State:, VmRSS:(실제 사용 메모리) 세 줄만 골라 읽습니다.
② CPU 사용률은 “두 시점의 차이”
이 프로젝트의 가장 중요한 기술 포인트입니다. /proc/stat 의 첫 줄은 부팅 이후 CPU 가 각 상태(사용자 코드, 커널 코드, 유휴 등)로 보낸 누적 시간입니다. 순간 사용률이 아닙니다. 그래서 이렇게 계산합니다.
    CpuTimes t1, t2;
    read_cpu(&t1);
    usleep(500000);              /* 0.5초 */
    read_cpu(&t2);
    draw_gauge("CPU", cpu_percent(&t1, &t2));
두 번 읽어 차이를 구합니다. 그 0.5초 동안 늘어난 “바쁜 시간”을 늘어난 “전체 시간”으로 나눈 것이 사용률입니다. 이것이 모든 모니터링 도구의 공통 원리입니다. top 이 1초마다 갱신하는 이유도, 처음 켰을 때 첫 화면의 값이 이상한 이유도(비교할 이전 값이 없어서) 이 때문입니다. 네트워크 사용률, 디스크 I/O 등 “속도”를 재는 모든 지표가 같은 방식입니다.
③ /proc 순회 = 이번 주 배운 것의 조합
프로세스 목록은 /proc 에서 이름이 숫자인 디렉터리를 찾으면 됩니다. 9절의 readdir 과 파일 읽기가 여기서 합쳐집니다.
    while ((entry = readdir(proc_dir)) != NULL && count < 4096) {
        if (!isdigit((unsigned char)entry->d_name[0])) continue;
        int pid = atoi(entry->d_name);
        if (read_proc(pid, &procs[count])) count++;
    }
read_proc 이 실패하면(fopen 이 NULL) 건너뛰는 것을 보세요. readdir 로 목록을 받은 뒤 파일을 여는 사이에 그 프로세스가 끝났을 수 있습니다. 9.3절의 “견고한 도구는 계속 간다”입니다. 그리고 상위 5개를 뽑는 데 15주차의 qsort 가 쓰입니다. 비교 함수 proc_cmp 의 (x < y) - (x > y) 는 7주차에서 배운, 뺄셈 없이 내림차순을 만드는 안전한 관용구입니다.
확장 아이디어: -w 반복 모드에 화면 지우기(ANSI 이스케이프 \033[2J\033[H), 특정 PID 감시, CSV 기록(9주차 파일 I/O), 프로세스별 CPU 사용률, 26주차 TUI 로 진짜 top 만들기.
프로젝트 3: 로그 회전 데몬 (log_daemon.c)
데몬은 터미널 없이 백그라운드에서 사는 프로세스입니다. 웹 서버, 데이터베이스, cron. 시스템의 일꾼들이 전부 데몬입니다. 3.1절의 pstree 에서 본 systemd 도 그렇습니다.
/*
 * log_daemon.c - 로그 회전 데몬
 * 18주차 프로젝트 3
 *
 * 데몬(daemon) = 터미널 없이 백그라운드에서 사는 프로세스.
 * (웹 서버, DB, cron... 시스템의 일꾼들이 전부 데몬)
 *
 * 데몬화(daemonize)의 고전 의식:
 *   1. fork 후 부모 종료  -> 쉘로부터 독립
 *   2. setsid()           -> 새 세션 리더 (터미널과 결별)
 *   3. fork 한 번 더      -> 세션 리더도 아니게 (터미널 재획득 원천 봉쇄)
 *   4. chdir("/")         -> 마운트 해제 방해 금지
 *   5. 표준 입출력 -> /dev/null
 *
 * 이 데몬이 하는 일: 주기적으로 로그를 쓰고, 파일이 커지면
 * "회전"(log -> log.1로 밀고 새로 시작)합니다. logrotate의 원리!
 *
 * 사용법:
 *   ./log_daemon --demo   # 포그라운드 데모 (짧게 실행, 학습용)
 *   ./log_daemon          # 진짜 데몬으로 (kill로 종료)
 */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <signal.h>
#include <fcntl.h>
#include <time.h>
#include <sys/stat.h>
#include <sys/wait.h>

#define LOG_FILE     "mini_daemon.log"
#define PID_FILE     "mini_daemon.pid"
#define MAX_LOG_SIZE 512         /* 데모용으로 아주 작게 (실전은 수 MB) */
#define KEEP_ROTATIONS 3

static volatile sig_atomic_t running = 1;    /* 핸들러 안전 규칙! */

void handle_term(int signo) {
    (void)signo;
    running = 0;                 /* 깃발만 세운다 */
}

/* ---------- 데몬화 의식 ---------- */
void daemonize(void) {
    /* 1. 1차 fork: 부모(쉘의 자식)는 죽고 자식만 남는다 */
    pid_t pid = fork();
    if (pid < 0) exit(1);
    if (pid > 0) exit(0);        /* 부모 퇴장 -> 자식은 고아 -> init이 입양 */

    /* 2. 새 세션: 제어 터미널과 완전 결별 */
    if (setsid() < 0) exit(1);

    /* 3. 2차 fork: 세션 리더 지위도 버린다 (터미널 재획득 봉쇄) */
    pid = fork();
    if (pid < 0) exit(1);
    if (pid > 0) exit(0);

    /* 4. 루트로 이동 + 파일 생성 마스크 초기화 */
    if (chdir("/tmp") < 0) exit(1);      /* 데모라 /tmp (실전은 / 또는 작업 디렉토리) */
    umask(022);

    /* 5. 표준 입출력을 /dev/null로 (터미널에 쓰다 죽는 사고 방지) */
    int devnull = open("/dev/null", O_RDWR);
    if (devnull >= 0) {
        dup2(devnull, 0);
        dup2(devnull, 1);
        dup2(devnull, 2);
        if (devnull > 2) close(devnull);
    }
}

/* ---------- 로그 회전 ---------- */
void rotate_logs(void) {
    char oldname[64], newname[64];

    /* log.2 -> log.3, log.1 -> log.2, ... 뒤에서부터 밀기 */
    for (int i = KEEP_ROTATIONS - 1; i >= 1; i--) {
        snprintf(oldname, sizeof(oldname), "%s.%d", LOG_FILE, i);
        snprintf(newname, sizeof(newname), "%s.%d", LOG_FILE, i + 1);
        rename(oldname, newname);        /* 없으면 조용히 실패 - OK */
    }
    snprintf(newname, sizeof(newname), "%s.1", LOG_FILE);
    rename(LOG_FILE, newname);           /* 현재 로그 -> .1 */
}

/* 로그 한 줄 쓰기 (+크기 검사 후 회전) */
void write_log(const char *message) {
    /* 회전 검사 */
    struct stat st;
    if (stat(LOG_FILE, &st) == 0 && st.st_size >= MAX_LOG_SIZE) {
        rotate_logs();
    }

    int fd = open(LOG_FILE, O_WRONLY | O_CREAT | O_APPEND, 0644);
    if (fd < 0) return;

    char line[256];
    time_t now = time(NULL);
    struct tm *tm = localtime(&now);
    int len = snprintf(line, sizeof(line),
                       "[%02d:%02d:%02d] pid=%d %s\n",
                       tm->tm_hour, tm->tm_min, tm->tm_sec,
                       getpid(), message);
    write(fd, line, (size_t)len);
    close(fd);
}

/* ---------- 데몬 본체 ---------- */
void daemon_loop(int iterations, int interval_ms) {
    /* SIGTERM으로 우아하게 종료 */
    struct sigaction sa;
    memset(&sa, 0, sizeof(sa));
    sa.sa_handler = handle_term;
    sigaction(SIGTERM, &sa, NULL);
    sigaction(SIGINT, &sa, NULL);

    /* PID 파일: "나 여기 살아있어요" (systemd 이전의 전통 방식) */
    int fd = open(PID_FILE, O_WRONLY | O_CREAT | O_TRUNC, 0644);
    if (fd >= 0) {
        char buf[32];
        int len = snprintf(buf, sizeof(buf), "%d\n", getpid());
        write(fd, buf, (size_t)len);
        close(fd);
    }

    write_log("데몬 시작");

    int count = 0;
    while (running && (iterations < 0 || count < iterations)) {
        char msg[128];
        snprintf(msg, sizeof(msg), "하트비트 #%d (열심히 일하는 중)", ++count);
        write_log(msg);
        usleep((useconds_t)interval_ms * 1000);
    }

    write_log(running ? "반복 완료로 종료" : "SIGTERM 수신, 우아한 종료");
    unlink(PID_FILE);            /* 뒷정리 */
}

void show_logs(void) {
    printf("\n--- 생성된 로그 파일들 ---\n");
    const char *names[] = {LOG_FILE, LOG_FILE ".1", LOG_FILE ".2",
                           LOG_FILE ".3"};
    for (int i = 0; i < 4; i++) {
        struct stat st;
        if (stat(names[i], &st) == 0) {
            printf("%s (%ld바이트)\n", names[i], (long)st.st_size);
        }
    }
    printf("\n--- 현재 로그(%s) 마지막 5줄 ---\n", LOG_FILE);
    char cmd[128];
    snprintf(cmd, sizeof(cmd), "tail -5 %s", LOG_FILE);
    fflush(stdout);
    system(cmd);
}

int main(int argc, char *argv[]) {
    if (argc >= 2 && strcmp(argv[1], "--demo") == 0) {
        /* ===== 데모 모드: 포그라운드에서 전 과정 관찰 ===== */
        printf("로그 회전 데몬 - 데모 모드 (포그라운드)\n");
        printf("=====================================\n");
        printf("로그 한도 %d바이트, %d세대 보관. 30회 기록합니다...\n",
               MAX_LOG_SIZE, KEEP_ROTATIONS);

        daemon_loop(30, 20);     /* 30회, 20ms 간격 (빠른 데모) */
        show_logs();

        printf("\n회전 확인: 한도(%d바이트)를 넘길 때마다\n", MAX_LOG_SIZE);
        printf("  %s -> %s.1 -> %s.2 -> ... 로 밀려났습니다!\n",
               LOG_FILE, LOG_FILE, LOG_FILE);

        /* 데모 파일 정리 */
        unlink(LOG_FILE);
        unlink(LOG_FILE ".1");
        unlink(LOG_FILE ".2");
        unlink(LOG_FILE ".3");
        printf("(데모 파일 정리 완료)\n");
        return 0;
    }

    /* ===== 진짜 데몬 모드 ===== */
    printf("데몬으로 시작합니다. 확인/종료 방법:\n");
    printf("  tail -f /tmp/%s      # 로그 실시간 보기\n", LOG_FILE);
    printf("  cat /tmp/%s           # 데몬 PID 확인\n", PID_FILE);
    printf("  kill $(cat /tmp/%s)   # 우아한 종료 (SIGTERM)\n", PID_FILE);

    fflush(stdout);              /* fork 전에 버퍼 비우기! 안 하면 위 안내문이
                                  * 부모·자식에서 한 번씩, 두 번 찍힌다 (3.3절) */
    daemonize();                 /* 이 순간 터미널과 결별! */

    /* 여기부터는 printf 해도 아무 데도 안 나온다 (/dev/null) */
    daemon_loop(-1, 1000);       /* 무한 반복, 1초 간격 */
    return 0;
}
먼저 데모 모드로 전 과정을 관찰합니다.
$ ./build/log_daemon --demo
로그 회전 데몬 - 데모 모드 (포그라운드)
=====================================
로그 한도 512바이트, 3세대 보관. 30회 기록합니다...

--- 생성된 로그 파일들 ---
mini_daemon.log (436바이트)
mini_daemon.log.1 (520바이트)
mini_daemon.log.2 (519바이트)
mini_daemon.log.3 (548바이트)

--- 현재 로그(mini_daemon.log) 마지막 5줄 ---
[02:16:46] pid=316403 하트비트 #27 (열심히 일하는 중)
[02:16:46] pid=316403 하트비트 #28 (열심히 일하는 중)
[02:16:46] pid=316403 하트비트 #29 (열심히 일하는 중)
[02:16:46] pid=316403 하트비트 #30 (열심히 일하는 중)
[02:16:46] pid=316403 반복 완료로 종료

회전 확인: 한도(512바이트)를 넘길 때마다
  mini_daemon.log -> mini_daemon.log.1 -> mini_daemon.log.2 -> ... 로 밀려났습니다!
(데모 파일 정리 완료)
① 데몬화 5단계 의식
void daemonize(void) {
    /* 1. fork 후 부모 종료 -> 쉘로부터 독립 (고아 -> init 입양!) */
    /* 2. setsid()          -> 새 세션 리더 (터미널과 결별) */
    /* 3. fork 한 번 더     -> 세션 리더도 아니게 (터미널 재획득 봉쇄) */
    /* 4. chdir + umask     -> 환경 정리 */
    /* 5. 표준 입출력 -> /dev/null */
}
각 단계에 이유가 있습니다.
1단계 — fork 후 부모 종료: 부모가 죽으면 자식은 고아가 되어 입양됩니다. 5.3절에서 관찰한 바로 그 현상입니다. 쉘은 자기가 띄운 프로세스(부모)가 끝났으니 프롬프트를 돌려주고, 쉘을 닫아도 자식은 살아남습니다.
2단계 — setsid(): 새로운 세션을 만들고 그 리더가 됩니다. 제어 터미널과의 연결이 끊어지므로, 터미널이 닫힐 때 오는 SIGHUP 을 받지 않습니다.
3단계 — fork 한 번 더: 세션 리더는 터미널을 다시 획득할 수 있습니다. 한 번 더 fork 하면 자식은 세션 리더가 아니므로 영원히 터미널을 가질 수 없게 됩니다. 엄밀히 필수는 아니지만 고전적인 관례입니다.
4단계 — chdir, umask: 데몬이 어떤 디렉터리에 머물면 그 디렉터리가 속한 파일 시스템을 언마운트할 수 없습니다. 루트나 정해진 작업 폴더로 옮겨 두는 것이 예의입니다(데모라 /tmp). umask 도 정해 두어 파일 권한이 예측 가능하게 합니다(2.3절).
5단계 — 표준 입출력을 /dev/null 로: 터미널이 없는데 printf 를 하면 어떻게 될까요? 1번 fd 가 이미 닫힌 터미널을 가리키고 있다면 쓰기가 실패하거나, 더 나쁘게는 그 번호를 재사용한 다른 파일에 쓰게 됩니다(2.2절의 “빈 번호 중 최소” 규칙이 여기서는 함정입니다). dup2 로 0, 1, 2 를 전부 /dev/null 로 돌려 두면 안전합니다.
② 진짜 데몬으로 실행해 보기
인자 없이 실행하면 진짜 데몬이 됩니다. 5단계가 정말 일어났는지 커널에게 물어봅시다.
$ ./build/log_daemon
데몬으로 시작합니다. 확인/종료 방법:
  tail -f /tmp/mini_daemon.log      # 로그 실시간 보기
  cat /tmp/mini_daemon.pid           # 데몬 PID 확인
  kill $(cat /tmp/mini_daemon.pid)   # 우아한 종료 (SIGTERM)
$                                    ← 프롬프트가 바로 돌아온다 (1단계)
$ cat /tmp/mini_daemon.pid
316445
$ ps -o pid,ppid,sid,tty,stat,cmd -p 316445
    PID    PPID     SID TT       STAT CMD
 316445    1674  316444 ?        S    ./build/log_daemon
$ ls -l /proc/316445/fd
lrwx------ 1 user user 64  9월 29 02:16 0 -> /dev/null
lrwx------ 1 user user 64  9월 29 02:16 1 -> /dev/null
lrwx------ 1 user user 64  9월 29 02:16 2 -> /dev/null
$ readlink /proc/316445/cwd
/tmp
$ cat /tmp/mini_daemon.log
[02:16:46] pid=316445 데몬 시작
[02:16:46] pid=316445 하트비트 #1 (열심히 일하는 중)
[02:16:47] pid=316445 하트비트 #2 (열심히 일하는 중)
[02:16:48] pid=316445 하트비트 #3 (열심히 일하는 중)
한 줄씩 대조해 봅시다.
| 확인한 것 | 결과 | 단계 |
|---|---|---|
| 부모 PID | 1674 (systemd --user, 5.3절의 입양자) |
1단계: 고아가 됐다 |
| SID(세션 ID) | 316444, 자기 PID 와 다르다 | 2, 3단계: 세션 리더가 아니다 |
| TT(터미널) | ? |
2단계: 터미널이 없다 |
| fd 0, 1, 2 | 전부 /dev/null |
5단계 |
| 작업 디렉터리 | /tmp |
4단계 |
| 로그 | 1초마다 한 줄씩 쌓인다 | 살아서 일하는 중 |
이제 우아하게 종료시킵니다.
$ kill $(cat /tmp/mini_daemon.pid)
$ tail -2 /tmp/mini_daemon.log
[02:16:48] pid=316445 하트비트 #3 (열심히 일하는 중)
[02:16:49] pid=316445 SIGTERM 수신, 우아한 종료
$ cat /tmp/mini_daemon.pid
cat: /tmp/mini_daemon.pid: 그런 파일이나 디렉터리가 없습니다
SIGTERM 을 받은 핸들러가 running = 0 깃발을 세웠고(7.3절), 메인 루프가 그것을 보고 마지막 로그를 남긴 뒤 PID 파일을 지우고 끝났습니다. 6.7절에서 말한 “정중한 요청 → 뒷정리 → 종료”가 그대로입니다.
③ 이 프로젝트에 숨어 있던 버그 — fflush
3.4절에서 예고한 이야기입니다. 이 글을 쓰면서 데몬을 파이프에 물려 실행했더니(./build/log_daemon | cat) 시작 안내문이 두 번 찍혔습니다. 원인은 정확히 3.4절의 그것이었습니다. printf 로 안내문을 찍은 직후 daemonize() 가 fork 를 하는데, fflush 가 없었습니다. 터미널에서는 줄 버퍼링이라 드러나지 않았지만, 파이프나 파일로 보내는 순간 버퍼가 복제되어 부모(곧 죽는)와 자식이 각자 안내문을 내보낸 것입니다. 지금 코드의 daemonize() 호출 직전에 있는 fflush(stdout) 이 그 수정입니다. 데몬처럼 “출력이 어디로 갈지 모르는” 프로그램에서는 이 한 줄이 필수입니다.
④ 로그 회전의 원리
현재 로그가 한도를 넘으면:
  log.2 → log.3  (가장 오래된 것부터 뒤로)
  log.1 → log.2
  log   → log.1
  새 log 시작
뒤에서부터 밀어야 합니다. 앞에서부터 하면 덮어써서 데이터를 잃습니다. 4주차에서 배열 원소를 뒤로 밀 때와 같은 논리입니다. 옮기는 데는 rename 시스템 콜을 쓰는데, 파일 내용을 복사하는 게 아니라 이름표만 바꿔 다는 것이라 크기와 상관없이 순식간입니다(1주차의 mv 가 이것입니다). 한도 검사는 8.4절의 stat 입니다. 실제 리눅스의 logrotate 가 이 방식으로 동작합니다. /var/log 를 보면 syslog, syslog.1, syslog.2.gz 같은 파일들이 있을 텐데, 지금 만든 것과 같은 원리입니다.
확장 아이디어: SIGHUP 으로 설정 다시 읽기(데몬의 전통. nginx 도 이렇게 합니다), 날짜 기반 회전, 회전 후 압축(16주차의 허프만을 써도 됩니다), PID 파일로 중복 실행 방지.
11. 자주 하는 실수와 함정
1. fork 후 wait 안 함. 좀비가 쌓입니다(5.1절). 백그라운드가 필요하면 SIGCHLD + WNOHANG 패턴을 쓰세요.
2. fork 전 fflush 안 함. printf 버퍼가 복제되어 출력이 이중으로 나옵니다(3.4절). 터미널에서는 안 보이고 파일로 돌릴 때 드러납니다. 이번 주 프로젝트에도 하나 있었습니다.
3. exec 뒤에 코드가 실행된다고 기대. 성공하면 그 아래는 존재하지 않는 코드입니다(4.3절). 도달했다면 실패 처리 + exit(127).
4. exec 인자에 NULL 종결 누락. execlp/execvp 모두 NULL 이 끝 표시입니다. 잊으면 쓰레기 인자가 넘어갑니다.
5. read/write 가 요청한 만큼 처리했다고 가정. 반환값을 반드시 확인하고, 필요하면 루프로 채우세요(2.5절). 파이프와 소켓에서 특히 중요합니다.
6. write(fd, buf, sizeof(buf)). 실제 읽은 양(got)이 아니라 버퍼 크기를 쓰면 쓰레기가 붙습니다(2.4절).
7. O_CREAT 에 권한 인자 누락. -rws--s--T 같은 엉터리 권한이 나옵니다(2.3절). -O0 에서는 경고도 없습니다.
8. 핸들러에서 printf/malloc. async-signal-safe 위반입니다(7.1절). 깃발 + 메인 루프로.
9. volatile 없는 시그널 깃발. 최적화 빌드에서 while(!flag) 이 무한 루프가 됩니다(7.4절).
10. 시그널이 온 횟수를 셀 수 있다고 가정. 표준 시그널은 합쳐집니다(6.5절). “왔는가”만 알 수 있습니다.
11. readdir 에서 . 과 .. 처리 누락. 재귀 순회가 즉시 무한 루프에 빠집니다(9.2절).
12. 재귀 순회에 stat 사용. 심볼릭 링크를 따라가다 무한 루프에 빠질 수 있습니다. lstat 을 쓰세요(8.3절).
13. status 를 매크로 없이 읽기. 42 를 기대했는데 10752 가 나옵니다(4.5절). WIFEXITED 로 묻고 WEXITSTATUS 로 꺼내세요.
14. 시스템 콜 반환값 무시. 모든 시스템 콜은 실패할 수 있습니다. if (ret < 0) 이 기본기입니다(1.4절).
12. 연습 문제
기본 문제
cat만들기: 파일을 읽어 표준 출력으로 내보내는 프로그램을open/read/write로 작성하세요. 인자가 없으면 표준 입력(0번)을 읽게 하세요. 2.4절의 열 줄이 거의 그대로 답입니다.wc -l만들기: 파일의 줄 수를 세세요. 버퍼로 읽으며\n을 세는 방식으로 구현해 보세요. 버퍼 크기를 바꿔 가며strace -c로read횟수를 비교해 보세요(1.3절).- 자식 여러 개 관리: 자식 3개를 만들어 각각 다른 시간을 자게 하고, 끝나는 순서대로 수거하며 PID 와 종료 코드를 출력하세요.
wait(&status)를 세 번 부르면 됩니다. - 타이머 프로그램:
alarm(N)과SIGALRM핸들러로 N초 후 메시지를 출력하고 종료하는 프로그램을 만드세요. 핸들러는 깃발만 세우고, 메시지는 메인에서 찍으세요. ls만들기: 디렉터리 내용을 읽어 이름순으로 정렬해 출력하세요(15주차qsort활용).-l옵션도 추가해 보세요. 8절의print_stat_line을 그대로 쓸 수 있습니다.
심화 문제
strace로 관찰하기: 지금까지 만든 아무 프로그램이나strace -c로 실행해 어떤 시스템 콜을 몇 번 부르는지 확인하세요. 9주차의fread예제와 이번 주의read예제를 비교하면 버퍼링의 차이가 숫자로 보입니다.- 좀비 관찰 실험: 자식을 10개 만들고
wait을 하지 않은 채sleep(30)하는 프로그램을 띄운 뒤, 다른 터미널에서ps aux | grep defunct로 좀비 10개를 확인하세요. 그다음SIGCHLD핸들러를 추가해 좀비가 사라지는 것을 확인하세요. - 미니 쉘에
>>추가: 추가 모드 리다이렉션을 구현하세요.O_TRUNC대신O_APPEND를 쓰면 됩니다.parse_command에서>>를>보다 먼저 검사해야 하는 이유도 생각해 보세요. - 파일 감시기: 특정 파일의
st_mtime을 1초마다 확인해 변경되면 알리는 프로그램을 만드세요. 실전에서는inotify를 쓰지만, 폴링 방식으로 먼저 만들어 보세요. - 재귀
du완성: 디렉터리 크기를 재귀로 합산하고, 큰 것부터 정렬해 상위 10개를 출력하세요. 실제du -sh * | sort -h와 비교해 보세요. 숫자가 조금 다르다면du가st_size가 아니라st_blocks를 쓰기 때문입니다.
마치며
이번 주에 배운 것을 정리합니다.
- 시스템 콜:
printf밑에write가 있고,fopen밑에openat이 있습니다. 성공은 0 이상, 실패는 -1 과errno.strace가 청진기입니다. - 파일 디스크립터: 모든 것은 번호입니다.
read의 3형제(양수/0/음수)를 몸에 새기고,O_CREAT에는 권한을, 권한에는 umask 가 붙는다는 것을 기억하세요. - 프로세스:
fork(복제) →exec(변신) →wait(수거). 1주차의$?는wait가 받아 온status의 위쪽 8비트입니다. 좀비 방지는 철칙입니다. - 시그널:
sigaction+ 깃발 패턴. 핸들러는 최소한으로. Ctrl+C 의 정체는SIGINT이고, 130 은 128 + 2 입니다. - 파일 시스템:
st_mode의 비트 마스크,readdir의 재귀.ls -l을 직접 만들어 봤습니다.
그리고 이번 주의 큰 그림입니다.
첫째, 1주차의 수수께끼가 전부 풀렸습니다. ./hello 를 치면 쉘이 fork 하고, 자식이 execve 로 hello 가 되고, _start 가 main 을 부르고, return 0 이 exit_group(0) 으로 커널에 가고, 쉘이 wait4 로 그 0 을 받아 $? 에 넣습니다. “명령을 찾을 수 없습니다”는 execvp 가 PATH 를 다 뒤지고 ENOENT 를 돌려준 것이고, “허가 거부”는 EACCES 이고, cd 가 내장 명령인 이유는 fork 가 복사이기 때문입니다. 1주차에 외웠던 것들이 이제 설명할 수 있는 것이 됐습니다.
둘째, 추상화의 층이 보이기 시작했습니다. printf 밑에 write 가 있고, FILE * 속에 fd 가 있고, fopen("w") 안에 O_TRUNC 가 있습니다. 지금까지 “그냥 되는 것”으로 알던 것들의 아랫층이 열린 셈입니다. 이 감각이 앞으로 계속 확장됩니다.
셋째, 만든 것들이 진짜입니다. 오늘 만든 쉘, 모니터, 데몬은 장난감이 아니라 실물의 축소판입니다. bash 도, top 도, nginx 의 데몬화도 오늘 코드와 같은 뼈대 위에 서 있습니다. 규모와 예외 처리가 다를 뿐 구조는 같습니다.
다음 주는 IPC 와 동기화입니다. 프로세스들이 서로 대화하는 법, 즉 파이프, 메시지 큐, 공유 메모리, 세마포어를 배웁니다. 미니 쉘에 파이프 | 를 달아 줄 재료가 옵니다. ls | grep txt | wc -l 이 어떻게 동작하는지, 그 세 프로세스가 어떻게 데이터를 주고받는지 알게 됩니다. 2.5절에서 본 “요청보다 적게 받는 read” 가 그때부터 일상이 됩니다.
Part 3 의 첫 주가 가장 낯설었을 겁니다. 그런데 여기만 넘으면 나머지는 이 위에 쌓이는 구조라 훨씬 수월해집니다. 오늘 만든 프로그램들을 직접 실행하고 고쳐 보세요. 그리고 궁금한 것이 생기면 strace 로 들여다보세요. 이번 주의 모든 설명은 여러분의 터미널에서 직접 확인할 수 있게 썼습니다.
체크리스트
- [ ] 시스템 콜과 라이브러리 함수의 차이를 버퍼링으로 설명할 수 있다
- [ ]
strace로printf가write몇 번이 되는지 직접 세어 봤다 - [ ]
-std=gnu11이 필요한 이유(POSIX 선언)를 알고,_POSIX_C_SOURCE로도 해결할 수 있다 - [ ]
man섹션 번호(2=시스템 콜, 3=라이브러리)를 구분해 쓴다 - [ ]
errno를 즉시 저장해야 하는 이유를 알고,ENOENT/EACCES/EBADF를 이름으로 안다 - [ ] fd 0/1/2 가 무엇이고, 새 fd 가 “빈 번호 중 최소”로 배정됨을
/proc/self/fd로 확인했다 - [ ]
open의 세 인자와O_CREAT에 권한이 필요한 이유, umask 와의 관계를 안다 - [ ]
read/write루프로 파일 복사를 짤 수 있고,write에 읽은 양을 줘야 하는 이유를 안다 - [ ]
read반환값 3형제(양수/0/음수)의 의미를 알고, 요청보다 적게 올 수 있음을 실험으로 봤다 - [ ]
FILE *와 fd 의 관계를 설명하고, 섞어 쓰면 순서가 꼬이는 이유를 안다 - [ ]
fork의 “한 번 호출 두 번 반환”과 반환값 구분을 PID 로 확인했다 - [ ]
fork가 복사이지 공유가 아님을, Copy-On-Write 와 함께 설명할 수 있다 - [ ]
fork전fflush가 필요한 이유를 실험으로 봤다 - [ ]
fork뒤 부모와 자식의 실행 순서가 보장되지 않음을 안다 - [ ]
exec성공 시 다음 줄이 실행되지 않는 이유와 PID 가 유지됨을 안다 - [ ]
exec계열의 l/v/p 차이를 알고,execvp가 PATH 를 뒤지는 것을strace로 봤다 - [ ]
WIFEXITED/WEXITSTATUS로 종료 상태를 해부할 수 있고,$?의 128+N 규칙을 안다 - [ ] 좀비를 만들어
ps와/proc에서 Z 상태를 확인해 봤다 - [ ] 고아가 입양되는 것을 관찰했고, 입양자가 PID 1 이 아닐 수 있는 이유를 안다
- [ ] 좀비 방지 3가지 방법을 알고 상황에 맞게 고를 수 있다
- [ ]
sigaction으로 핸들러를 등록할 수 있고SA_RESTART의 역할을 안다 - [ ] 표준 시그널이 합쳐질 수 있음(큐 없음)을 안다
- [ ]
SIGKILL/SIGSTOP을 못 막는 이유를 알고,kill→kill -9순서의 이유를 안다 - [ ] 핸들러 3계명(깃발/write만/메인 루프)을 지킬 수 있다
- [ ]
volatile sig_atomic_t의 두 단어가 각각 왜 필요한지 안다 - [ ]
st_mode에서 타입과 권한을 꺼낼 수 있다 - [ ]
stat/lstat/fstat의 차이를 안다 - [ ]
readdir재귀 순회를 짤 수 있다 (./..처리 포함) - [ ]
readdir이 순서를 보장하지 않음을 안다 - [ ] 미니 쉘에서
cd가 내장이어야 하는 이유를 설명할 수 있다 - [ ]
dup2로 리다이렉션이 구현되는 원리를 실험으로 봤다 - [ ] 데몬화 5단계의 각 단계 이유를 설명하고,
ps와/proc으로 확인할 수 있다 - [ ] (도전) 미니 쉘에
>>를, 데몬에SIGHUP재설정을 추가해 봤다
참고 자료
- “The Linux Programming Interface” (Michael Kerrisk) — 이 분야의 성경. 1,500쪽이지만 필요한 장만 찾아 읽으면 됩니다
- “Advanced Programming in the UNIX Environment” (W. Richard Stevens) — 고전 중의 고전
man페이지 섹션: 2(시스템 콜), 3(라이브러리), 7(개념 —man 7 signal-safety,man 7 feature_test_macros).manpages-dev패키지가 필요합니다- Linux man-pages 온라인 —
man이 없을 때 - strace 공식 사이트
- 다음 주차: 19주차 IPC 와 동기화 (파이프, 공유 메모리, 세마포어)