들어가며
지금까지 우리는 설명하지 않고 넘어간 것이 세 가지 있습니다.
- 2주차에
scanf("%d", &age);를 쓰면서 “&를 빼먹으면 안 된다”고만 했습니다. 그런데printf("%d", age);에는&가 없습니다. 왜scanf에만&가 붙을까요? - 5주차에 두 값을 맞바꾸는
try_swap을 만들었습니다. 함수 안에서는 분명히 바뀌었는데, 밖에 나오면 그대로였습니다. 그때 “원본을 바꾸려면 주소를 넘겨야 한다”고만 하고 미뤄 두었습니다. - 1주차에
-g옵션을 설명하면서 “6주차에 포인터를 디버깅할 때gdb가 요긴하다”고 예고했습니다.
세 가지 모두 답이 같습니다. 포인터(pointer)입니다. 포인터는 “값” 대신 “값이 있는 곳의 주소”를 담는 변수입니다. 말로 하면 한 줄이지만, C를 배우는 사람 대부분이 여기서 한 번은 크게 넘어집니다. 이유는 포인터가 어려워서라기보다, 눈에 보이지 않는 메모리를 머릿속으로 상상해야 하기 때문입니다.
그래서 이번 주는 상상하지 않기로 합니다. 모든 주소를 실제로 찍어 보고, 메모리 그림은 그 실제 주소로 그리고, gdb 로 프로그램을 멈춰 세워서 메모리 바이트를 직접 들여다봅니다. 그리고 포인터를 잘못 쓰면 프로그램이 어떻게 죽는지도 일부러 여러 번 확인합니다. 한 번 눈으로 본 것은 상상할 필요가 없어집니다.
이번 주에 할 수 있게 될 일은 이렇습니다.
| 목표 | 이번 주에 확인하는 방법 |
|---|---|
| 메모리 주소가 무엇인지 설명한다 | 변수마다 주소를 찍고, 바이트 단위로 덤프해 본다 |
| 포인터를 선언하고 읽을 수 있다 | int *p 를 오른쪽에서 왼쪽으로 읽는 법을 익힌다 |
& 와 * 를 자유롭게 쓴다 |
gdb 로 &x, p, *p 를 하나씩 확인한다 |
| 포인터 산술을 이해한다 | p + 1 이 실제로 몇 바이트 움직이는지 타입별로 잰다 |
| 배열과 포인터의 관계를 안다 | arr[i] 와 *(arr + i) 가 같다는 것을 확인하고, 다른 점도 찾는다 |
| 함수로 원본을 바꾼다 | 5주차 try_swap 을 고쳐서 드디어 swap 을 완성한다 |
| 흔한 포인터 버그를 알아본다 | NULL 역참조, 초기화 안 한 포인터, 범위 초과를 실제로 내 본다 |
이번 주 준비
이번 주 예제는 저장소의 week06/ 폴더에 있습니다. 5주차에 배운 make 로 한 번에 빌드합니다.
$ cd week06
$ make
$ ls build/examples
pointer_address     pointer_array  pointer_const    pointer_function  pointer_swap
pointer_arithmetic  pointer_basic  pointer_dangers  pointer_string    pointer_void
make 는 examples/ 의 .c 파일을 하나씩 gcc -Wall -Wextra -std=c11 -g -O0 으로 컴파일해서 build/examples/ 에 실행 파일을 만듭니다. -g 가 들어 있으니 전부 gdb 로 들여다볼 수 있습니다. 본문에 나오는 짧은 실험 코드는 여러분 작업 폴더에 새 파일로 만들어서 1주차의 기본 명령으로 컴파일하면 됩니다.
$ gcc -Wall -Wextra -std=c11 -g 파일.c -o 파일 && ./파일
이 글의 주소값에 대해: 이 글에 나오는
0x7ffe...같은 주소는 모두 이 글을 쓰면서 실제로 실행해서 얻은 값입니다. 여러분이 실행하면 다른 값이 나오는 것이 정상입니다. 왜 매번 다른지는 2절에서 직접 확인합니다. 숫자 자체가 아니라 숫자 사이의 관계(몇 바이트 차이인지, 어느 쪽이 큰지)를 보세요.
1. 포인터란 무엇인가?
1.1 메모리와 주소
프로그램이 실행되면 변수는 메모리(RAM) 어딘가에 자리를 잡습니다. 메모리는 아주 긴 한 줄짜리 사물함이라고 생각하면 됩니다. 사물함 한 칸에는 1바이트(8비트, 0~255 사이의 숫자 하나)가 들어가고, 칸마다 번호가 붙어 있습니다. 이 번호가 주소(address)입니다.
int 는 4바이트이므로 사물함 네 칸을 연달아 씁니다. double 은 여덟 칸을 씁니다. 변수의 주소라고 하면 그 칸들 중 첫 번째 칸의 번호를 말합니다.
말로만 하면 감이 오지 않으니, 이번 주 프로젝트 중 하나인 메모리 시각화 도구로 실제 메모리를 들여다봅시다.
$ ./build/projects/memory_viewer

메모리 들여다보기
출력이 길어서, 이 절에서 볼 부분만 옮기면 이렇습니다.
=== 변수 메모리 정보 ===
┌──────────────────────────────────────────┐
│ 변수: int x = 0x12345678                 │
├──────────────────────────────────────────┤
│ 주소: 0x7fffc0467cf8                     │
│ 크기: 4                                  │
│ 바이트: 78 56 34 12                      │
└──────────────────────────────────────────┘

┌──────────────────────────────────────────┐
│ 변수: char str[] = "Hello"               │
├──────────────────────────────────────────┤
│ 주소: 0x7fffc0467d32                     │
│ 크기: 6                                  │
│ 바이트: 48 65 6C 6C 6F 00                │
└──────────────────────────────────────────┘
하나씩 읽어 봅시다.
- 주소
0x7fffc0467cf8: 변수x가 있는 사물함 번호입니다.0x는 “이 뒤는 16진수”라는 표시입니다. 주소는 거의 항상 16진수로 씁니다. 10진수로 바꾸면 140,736,419,233,016 이라는 아주 큰 번호입니다. - 크기 4:
int는 4바이트, 즉 사물함 네 칸입니다.x는...cf8,...cf9,...cfa,...cfb네 칸을 씁니다. - 바이트
78 56 34 12: 네 칸에 실제로 들어 있는 값입니다. 그런데 이상합니다. 우리는0x12345678을 넣었는데, 메모리에는 거꾸로78 56 34 12순서로 들어 있습니다.
이것이 1주차 7절에서 file 명령이 알려 준 LSB(Little Endian) 입니다. 우리 CPU(x86-64)는 여러 바이트짜리 숫자를 저장할 때 작은 자리(little end)부터 낮은 주소에 넣습니다. 0x12345678 에서 가장 작은 자리 바이트는 78 이니 그것이 첫 칸에 들어갑니다. 사람이 숫자를 쓰는 순서와 반대라서 처음에는 헷갈리지만, 이번 주 내내 이 순서를 여러 번 만나게 됩니다.
문자열 "Hello" 는 어떨까요? 48 65 6C 6C 6F 00 입니다. 48 은 H 의 번호(10진수로 72), 65 는 e 입니다. 그리고 맨 끝의 00. 1주차 6절에서 “모든 문자열 끝에는 눈에 보이지 않는 \0 이 붙어 있다”고 했던 바로 그것입니다. 크기가 5가 아니라 6인 이유도 이것이고요. 드디어 눈으로 확인했습니다.
그림으로 그리면 이렇습니다(주소는 끝자리만 적었습니다).
주소:    ...cf8  ...cf9  ...cfa  ...cfb
       ┌───────┬───────┬───────┬───────┐
x      │  78   │  56   │  34   │  12   │   ← int x = 0x12345678
       └───────┴───────┴───────┴───────┘
        ↑
        &x (x 의 주소) = 이 첫 칸의 번호

주소:    ...d32  ...d33  ...d34  ...d35  ...d36  ...d37
       ┌───────┬───────┬───────┬───────┬───────┬───────┐
str    │  48   │  65   │  6C   │  6C   │  6F   │  00   │   ← "Hello"
       │  'H'  │  'e'  │  'l'  │  'l'  │  'o'  │ '\0'  │
       └───────┴───────┴───────┴───────┴───────┴───────┘
실험: 변수는 메모리 어디에 있을까?
변수마다 주소가 있다면, 종류가 다른 것들은 서로 가까이 있을까요, 멀리 있을까요? regions.c 를 만들어 봅시다.
#include <stdio.h>

int global = 1;

int main(void) {
    int local = 2;
    const char *lit = "Hello";

    printf("main 함수(코드)   : %p\n", (void *)main);
    printf("문자열 \"Hello\"    : %p\n", (void *)lit);
    printf("전역 변수 global  : %p\n", (void *)&global);
    printf("지역 변수 local   : %p\n", (void *)&local);
    return 0;
}
아직 모르는 문법(%p, (void *), const char *)이 섞여 있지만 이번 주에 전부 배웁니다. 지금은 결과만 봅시다. 두 번 실행했습니다.
$ ./regions
main 함수(코드)   : 0x5a8b12695169
문자열 "Hello"    : 0x5a8b12696004
전역 변수 global  : 0x5a8b12698010
지역 변수 local   : 0x7ffe13b6f2ec
$ ./regions
main 함수(코드)   : 0x58c2a4219169
문자열 "Hello"    : 0x58c2a421a004
전역 변수 global  : 0x58c2a421c010
지역 변수 local   : 0x7ffd44a8c88c
세 가지가 보입니다.
- 코드, 문자열, 전역 변수는
0x5...근처에 모여 있고, 지역 변수만0x7ff...로 멀리 떨어져 있습니다. 프로그램의 메모리는 용도별로 구역이 나뉘어 있기 때문입니다.main함수의 기계어 자체도 메모리 어딘가에 있고 주소가 있다는 것도 흥미롭습니다. 1주차 7절에서objdump로 본 그 기계어입니다. - 실행할 때마다 앞자리가 바뀝니다. 2절에서 이유를 봅니다.
- 그런데 끝 세 자리(
169,004,010)는 두 번 다 같습니다. 구역의 시작 위치만 통째로 옮겨지고, 구역 안에서의 상대 위치는 그대로이기 때문입니다.
메모리 구역 이야기는 7주차 동적 메모리에서 본격적으로 다룹니다. 지금은 “모든 변수는 주소가 있고, 주소는 그냥 큰 숫자다” 만 기억하면 충분합니다.
1.2 포인터의 정의
이제 포인터를 정의할 수 있습니다.
포인터는 주소를 값으로 담는 변수입니다.
int x = 42; 의 x 는 42라는 정수를 담습니다. 포인터 p 는 0x7fff9910439c 같은 주소를 담습니다. 주소도 결국 숫자이니, 포인터는 “숫자를 담는 변수”라는 점에서 보통 변수와 다를 게 없습니다. 차이는 그 숫자를 “어디를 가리키는 번호”로 해석한다는 것뿐입니다.
실제로 확인해 봅시다. addr.c:
#include <stdio.h>

int main(void) {
    int x = 42;
    int *p = &x;

    printf("x 의 값      : %d\n", x);
    printf("x 의 주소 &x : %p\n", (void *)&x);
    printf("p 의 값      : %p\n", (void *)p);
    printf("p 가 가리키는 값 *p : %d\n", *p);
    printf("p 자신의 주소 &p : %p\n", (void *)&p);
    printf("sizeof(x) = %zu, sizeof(p) = %zu\n", sizeof(x), sizeof(p));
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g addr.c -o addr && ./addr
x 의 값      : 42
x 의 주소 &x : 0x7fff9910439c
p 의 값      : 0x7fff9910439c
p 가 가리키는 값 *p : 42
p 자신의 주소 &p : 0x7fff991043a0
sizeof(x) = 4, sizeof(p) = 8
이 출력 여섯 줄이 이번 주의 거의 전부입니다. 실제 주소로 그림을 그리면 이렇습니다.
           주소 0x7fff9910439c                  주소 0x7fff991043a0
          ┌───────────────────┐                ┌───────────────────┐
     x    │        42         │ ◀───────────── │  0x7fff9910439c   │    p
          └───────────────────┘   가리킨다      └───────────────────┘
            int, 4바이트                          int *, 8바이트
x는0x7fff9910439c번지에 있고, 안에 42 가 들어 있습니다.p는0x7fff991043a0번지에 있고, 안에0x7fff9910439c, 즉x의 주소가 들어 있습니다.p도 변수라서 자기 주소가 따로 있습니다(&p). “포인터의 값”과 “포인터 자신의 주소”는 다른 것입니다. 이 구분을 놓치면 7주차 이중 포인터에서 크게 헷갈립니다.p의 크기는 8바이트입니다. 64비트 컴퓨터에서 주소는 64비트(8바이트) 숫자이기 때문입니다. 가리키는 대상이 4바이트int든 8바이트double이든, 포인터 자신은 항상 8바이트입니다(9절에서 확인합니다).- 두 주소의 차이를 보세요.
...39c와...3a0은 4 차이입니다. 컴파일러가x바로 뒤에p를 놓았습니다. 지역 변수들이 서로 붙어 있는 모습입니다.
왜 주소가 14글자일까?
0x7fff9910439c는0x를 빼면 16진수 12자리, 48비트입니다. 포인터는 8바이트(64비트)인데 왜 16자리가 아닐까요? 지금의 x86-64 CPU는 64비트 중 실제로 대부분 48비트만 주소로 쓰고, 그중 사용자 프로그램에는 아래쪽 절반(0x7fffffffffff까지)을 줍니다. 앞자리 0은%p가 생략하므로 보통 14글자로 보입니다. 이 숫자로 가리킬 수 있는 공간이 128TB 라서 아직은 충분합니다.
1.3 포인터가 필요한 이유
“주소를 담는 변수”가 왜 그렇게 중요할까요? 변수 이름으로 잘 써 왔는데 말이죠. 이름은 그 함수 안에서만 통하기 때문입니다.
5주차에서 본 것처럼 함수를 부르면 인자의 복사본이 넘어갑니다. 함수 안의 x 와 밖의 num 은 이름도, 사물함도 다른 별개의 변수입니다. 함수가 x 를 아무리 바꿔도 num 의 사물함은 건드릴 방법이 없습니다. 그런데 사물함 번호(주소)를 넘겨주면 이야기가 달라집니다. 번호만 알면 누구든 그 사물함을 열 수 있으니까요.
포인터가 필요한 곳을 정리하면 이렇습니다.
| 하고 싶은 일 | 포인터가 없으면 | 포인터가 있으면 | 배우는 곳 |
|---|---|---|---|
| 함수로 원본 바꾸기 | 불가능 (5주차 try_swap) |
주소를 넘겨 원본 수정 | 이번 주 6절 |
scanf 로 입력받기 |
입력값을 넣을 곳을 알려 줄 수 없음 | &age 로 사물함 번호 전달 |
이번 주 3절 |
| 큰 데이터 넘기기 | 수천 바이트를 통째로 복사 | 주소 8바이트만 넘김 | 8주차 구조체 |
| 실행 중 메모리 확보 | 불가능 | malloc 이 준 주소를 보관 |
7주차 |
| 연결 리스트, 트리 | 불가능 | “다음 칸의 주소”를 저장 | 10주차 |
이번 주가 끝나면 표의 위 두 줄은 손에 익고, 나머지는 앞으로 몇 주 동안 차례로 만나게 됩니다.
2. 포인터 선언과 초기화
2.1 포인터 선언 문법
포인터 변수는 이렇게 만듭니다.
타입 *이름;
int *p;        // int 를 가리키는 포인터
char *cp;      // char 를 가리키는 포인터
double *dp;    // double 을 가리키는 포인터
여기서 * 는 “곱하기”도 아니고 뒤에서 배울 “역참조”도 아닙니다. 선언문 안의 * 는 “이 변수는 포인터다”라는 표시입니다. 같은 기호가 자리에 따라 뜻이 다르다는 것이 포인터가 처음에 헷갈리는 가장 큰 이유입니다. 3.4에서 정리합니다.
“무엇을 가리키는지”를 왜 적어야 할까요? 주소는 결국 “첫 칸의 번호”일 뿐이라서, 거기서부터 몇 칸을 읽어서 어떻게 해석할지는 주소만 봐서는 알 수 없습니다. int * 라고 적어 두면 컴파일러는 “이 주소에서 4바이트를 읽어서 정수로 해석하라”는 것을 압니다. double * 면 8바이트를 읽어 실수로 해석합니다. 1.1에서 본 78 56 34 12 네 바이트도, int 로 읽으면 0x12345678 이지만 char 로 읽으면 첫 칸의 0x78(문자 'x') 하나일 뿐입니다.
선언은 오른쪽에서 왼쪽으로 읽습니다
포인터 선언은 변수 이름에서 출발해서 왼쪽으로 읽으면 헷갈리지 않습니다.
int  *  p ;
 ③   ②  ①

① p 는
② 포인터(*)인데
③ int 를 가리킨다
→ "p 는 int 를 가리키는 포인터"
지금은 단순해 보이지만, 8절에서 const 가 섞이면 이 읽기 방법이 유일한 길잡이가 됩니다.
2.2 여러 포인터 선언 — 가장 흔한 함정
2주차에 int a, b, c; 처럼 한 줄에 변수 여러 개를 선언했습니다. 포인터도 그렇게 하면 될까요?
int *p1, p2;
많은 사람이 “p1, p2 둘 다 int *“라고 읽습니다. 틀렸습니다. 확인해 봅시다. twostar.c:
#include <stdio.h>

int main(void) {
    int x = 5;
    int *p1, p2;
    printf("sizeof(p1) = %zu, sizeof(p2) = %zu\n", sizeof(p1), sizeof(p2));
    p1 = &x;
    p2 = &x;
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g twostar.c -o twostar
twostar.c: In function ‘main’:
twostar.c:8:8: warning: assignment to ‘int’ from ‘int *’ makes integer from pointer without a cast [-Wint-conversion]
    8 |     p2 = &x;
      |        ^
$ ./twostar
sizeof(p1) = 8, sizeof(p2) = 4
p1 은 8바이트(포인터), p2 는 4바이트(int)입니다. * 는 타입에 붙는 게 아니라 바로 뒤의 이름 하나에만 붙기 때문입니다. int *p1, p2; 는 “*p1 은 int 이고, p2 도 int 다”로 읽힙니다. 그래서 8번째 줄에서 int 인 p2 에 주소를 넣으려 하자 GCC가 “포인터를 정수로 바꿔 넣고 있다(makes integer from pointer)”고 경고합니다.
둘 다 포인터로 만들려면 이름마다 * 를 붙입니다.
int *p1, *p2; // 둘 다 int *
이 강좌에서는 헷갈림을 막으려고 포인터는 한 줄에 하나씩 선언하고, * 는 이름 쪽에 붙여 씁니다(int* p 가 아니라 int *p). int* p1, p2; 처럼 쓰면 int* 가 타입처럼 보여서 함정에 빠지기 더 쉽기 때문입니다.
2.3 주소 연산자 (&)
변수 앞에 & 를 붙이면 그 변수의 주소가 나옵니다. 우리말로 “~의 주소”라고 읽으면 됩니다. &x 는 “x 의 주소”입니다. 저장소의 예제를 실행해 봅시다.
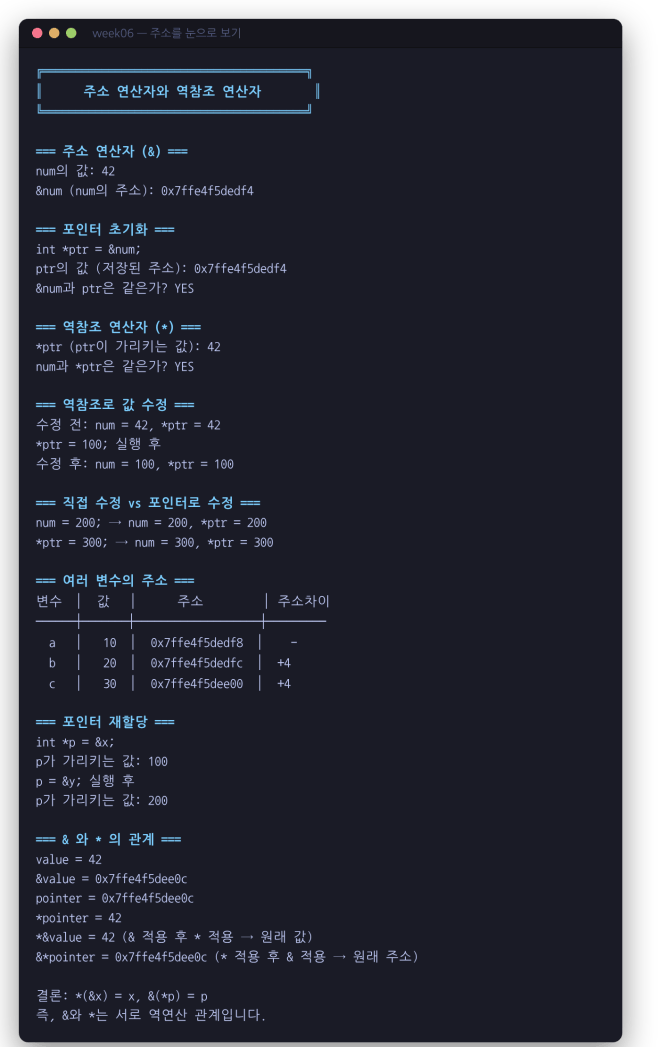
$ ./build/examples/pointer_address
주소를 눈으로 보기
출력 앞부분과 “여러 변수의 주소” 부분을 옮기면 이렇습니다.
=== 주소 연산자 (&) ===
num의 값: 42
&num (num의 주소): 0x7ffec0f0b944
...
=== 여러 변수의 주소 ===
변수  │  값   │      주소         │ 주소차이
──────┼───────┼───────────────────┼─────────
  a   │   10  │  0x7ffec0f0b948  │    -
  b   │   20  │  0x7ffec0f0b94c  │  +4
  c   │   30  │  0x7ffec0f0b950  │  +4
int 변수 세 개가 정확히 4바이트 간격으로 붙어 있습니다. int 가 4바이트라서 한 칸을 비우지 않고 빽빽하게 놓은 것입니다.
%p 와 (void *) — 주소를 출력하는 법
주소를 출력할 때는 서식 지정자 %p(pointer)를 씁니다. 그리고 이 글의 모든 예제가 주소 앞에 (void *) 를 붙이고 있습니다. 이건 뭘까요?
%p 는 표준에서 “void * 타입의 값을 받는다”고 정해져 있습니다. void * 는 “타입이 정해지지 않은 주소”로 9절에서 다룹니다. 우리가 넘기는 &x 는 int * 라서 엄밀히는 타입이 맞지 않습니다. (void *) 는 “이 값을 void * 로 바꿔서 넘겨라”라는 형 변환(cast) 입니다. 빼 보면 어떻게 될까요?
printf("%p\n", &x);
$ gcc -Wall -Wextra -std=c11 pnocast.c -o pnocast
$ gcc -Wall -Wextra -Wpedantic -std=c11 pnocast.c -o pnocast
pnocast.c: In function ‘main’:
pnocast.c:5:14: warning: format ‘%p’ expects argument of type ‘void *’, but argument 2 has type ‘int *’ [-Wformat=]
    5 |     printf("%p\n", &x);
      |             ~^     ~~
      |              |     |
      |              |     int *
      |              void *
평소 옵션으로는 조용하지만, 1주차에서 배운 -Wpedantic(표준을 한 글자씩 따지는 옵션)을 켜면 경고가 나옵니다. 우리 컴퓨터에서는 모든 포인터가 같은 8바이트라 결과는 똑같이 나오지만, 표준대로 쓰는 습관을 들이기 위해 이 강좌는 항상 (void *) 를 붙입니다.
%p 는 주소를 0x 로 시작하는 16진수로 찍어 주고, 주소가 0 이면 (nil) 이라고 찍습니다(2.5에서 봅니다).
실험: 주소는 왜 실행할 때마다 바뀔까?
1.2의 addr 을 두 번 실행해 봅시다.
$ ./addr | grep "&x"
x 의 주소 &x : 0x7fff9910439c
$ ./addr | grep "&x"
x 의 주소 &x : 0x7ffda4e1573c
같은 프로그램, 같은 코드인데 주소가 다릅니다. 이것은 버그가 아니라 일부러 그렇게 하는 보안 장치입니다. 이름은 ASLR(Address Space Layout Randomization, 주소 공간 배치 무작위화)입니다. 프로그램을 실행할 때마다 메모리 구역의 시작 위치를 무작위로 옮겨서, 공격자가 “이 프로그램의 변수는 항상 이 주소에 있다”고 미리 알 수 없게 만듭니다. 24주차 보안 프로그래밍에서 이 장치가 왜 중요한지 자세히 다룹니다.
정말 그 장치 때문인지 확인할 수 있습니다. 리눅스에는 무작위화를 끄고 프로그램을 실행하는 명령이 있습니다.
$ setarch "$(uname -m)" -R ./addr | grep "&x"
x 의 주소 &x : 0x7fffffffd2fc
$ setarch "$(uname -m)" -R ./addr | grep "&x"
x 의 주소 &x : 0x7fffffffd2fc
setarch 는 “이 아키텍처 설정으로 프로그램을 실행하라”는 명령이고, -R 이 무작위화를 끄는 옵션입니다($(uname -m) 은 지금 CPU 이름 x86_64 로 바뀌어 들어갑니다). 이번에는 두 번 다 똑같은 주소가 나왔습니다. 무작위화가 기본으로 켜져 있다는 것은 설정 파일로도 볼 수 있습니다.
$ cat /proc/sys/kernel/randomize_va_space
2
2 는 “전부 무작위화”라는 뜻입니다. 그러니 주소값 자체를 외우거나 비교하는 것은 의미가 없습니다. 의미가 있는 것은 “&x 와 p 가 같은가”, “b 가 a 보다 4 큰가” 같은 관계입니다.
2.4 포인터 초기화
포인터에 주소를 넣는 것을 “가리키게 한다”고 합니다.
int x = 42;
int *p = &x;    // p 가 x 를 가리키게 한다
int *p = &x; 를 오른쪽에서 왼쪽으로 읽으면 “x 의 주소를, int 를 가리키는 포인터 p 에 넣는다”입니다. 타입도 딱 맞습니다. &x 의 타입은 “int 의 주소”, 즉 int * 이고, p 도 int * 입니다.
타입이 맞지 않게 넣으면 어떻게 될까요? 두 가지 실수를 해 봅시다.
#include <stdio.h>

int main(void) {
    int x = 5;
    int *p = x;          // & 를 빼먹음
    double d = 1.5;
    int *q = &d;         // double 의 주소를 int * 에
    (void)p; (void)q;
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g intptr.c -o intptr
intptr.c: In function ‘main’:
intptr.c:5:14: warning: initialization of ‘int *’ from ‘int’ makes pointer from integer without a cast [-Wint-conversion]
    5 |     int *p = x;
      |              ^
intptr.c:7:14: warning: initialization of ‘int *’ from incompatible pointer type ‘double *’ [-Wincompatible-pointer-types]
    7 |     int *q = &d;
      |              ^
((void)p; 는 “이 변수를 일부러 안 쓴다”고 컴파일러에게 알려서 “안 쓴 변수” 경고를 끄는 관용구입니다.)
- 첫 경고:
int값 5를 포인터에 넣었습니다. “정수로 포인터를 만든다(makes pointer from integer)”는 경고입니다. 이p를 역참조하면 5번지라는 엉터리 주소에 접근하게 됩니다.&를 빼먹는 실수는 아주 흔해서, 이 경고 문구는 꼭 기억해 두세요. - 두 번째 경고:
double *를int *에 넣었습니다. “호환되지 않는 포인터 타입(incompatible pointer type)”입니다. 주소 자체는 맞지만,q로 읽으면 8바이트짜리 실수의 앞 4바이트를 정수로 해석하게 됩니다. 10.5에서 실제로 무슨 값이 나오는지 봅니다.
둘 다 경고라서 실행 파일은 만들어집니다. 1주차에서 말한 “경고 0개” 원칙이 포인터에서 특히 중요한 이유입니다. 포인터 경고의 대부분은 실행하면 곧바로 죽거나, 더 나쁘게는 조용히 틀린 값을 내는 코드입니다.
참고: GCC 14부터는 이 두 경고가 오류로 바뀌어서 아예 컴파일되지 않습니다. 그만큼 위험하다는 뜻입니다. 우분투 24.04의 GCC 13에서는 아직 경고입니다.
2.5 NULL 포인터
“아직 가리킬 대상이 없다”는 것을 어떻게 표시할까요? 포인터를 선언만 하고 비워 두면 될까요?
int *p = NULL;    // "지금은 아무것도 가리키지 않는다"고 분명히 표시

if (p != NULL) {
    // p 가 무언가를 가리킬 때만 여기서 쓴다
}
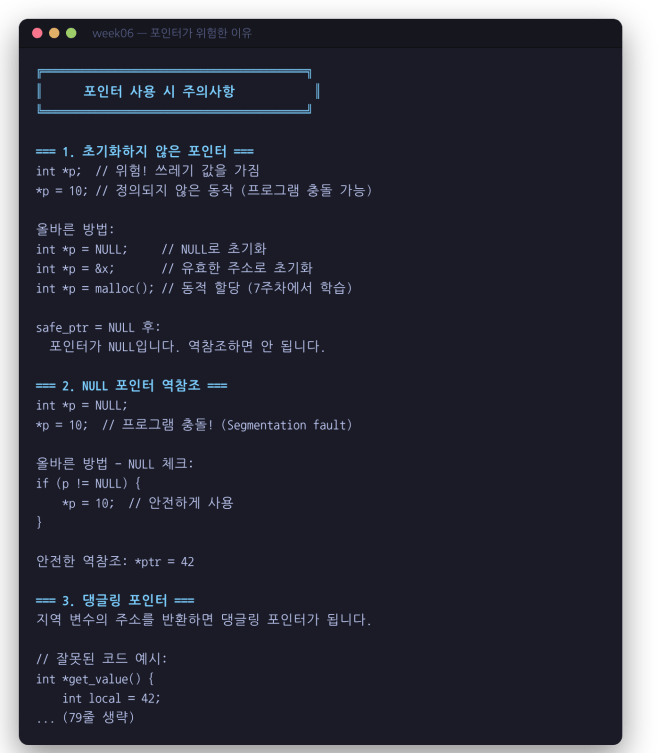
포인터가 위험한 이유
NULL 은 “아무 데도 가리키지 않는 주소”를 뜻하는 약속된 값입니다. 실제 값은 0번지입니다. 0번지에는 어떤 변수도 두지 않기로 운영체제와 약속이 되어 있어서, “주소가 0이면 가리키는 게 없다”고 판단할 수 있습니다. NULL 은 stdio.h 같은 헤더에 정의돼 있습니다.
위 스크린샷은 pointer_dangers 예제로, 포인터가 위험해지는 경우를 일곱 가지 보여 줍니다. 이 절에서는 NULL 을 보고, 1~5번은 10절에서 하나씩 직접 일으켜 봅니다. free 와 관련된 6번(해제 후 사용)과 7번(이중 해제)은 malloc 을 배우는 7주차에서 다룹니다.
%p 로 NULL 을 찍으면 이렇게 나옵니다(pointer_basic 예제 출력).
=== NULL 포인터 ===
NULL 포인터의 값: (nil)
포인터가 NULL입니다 (아무것도 가리키지 않음)
(nil) 은 “없음”이라는 뜻의 라틴어에서 온 말로, GNU C 라이브러리가 0번지를 찍을 때 쓰는 표기입니다.
실험: NULL 을 역참조하면?
“NULL 을 역참조하면 프로그램이 죽는다”고들 합니다. 정말 죽는지, 어떻게 죽는지 봅시다. 역참조(*p)는 3절에서 배우지만, 지금은 “p 가 가리키는 곳에 값을 넣는다”로 읽으면 됩니다. null.c:
#include <stdio.h>

int main(void) {
    int *p = NULL;
    printf("역참조 직전\n");
    *p = 10;
    printf("여기는 오지 않습니다\n");
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g null.c -o null
$ ./null
역참조 직전
세그멘테이션 오류 (코어 덤프됨)
$ echo $?
139
컴파일은 경고 없이 통과했습니다. GCC도 실행 전에는 p 가 NULL 인지 모를 수 있으니까요. 그리고 실행하자 6번째 줄에서 죽었습니다. 두 번째 printf 는 실행되지 않았습니다.
세그멘테이션 오류(영어로 Segmentation fault, 줄여서 segfault)는 “허락되지 않은 메모리 구역에 접근했다”는 뜻입니다. 0번지 근처는 어떤 프로그램에게도 허락되지 않은 구역이라, CPU가 접근을 막고 운영체제가 프로그램을 강제로 끝냈습니다. 종료 코드 139 는 128 + 11 입니다. 11은 이 신호(SIGSEGV)의 번호이고, 쉘은 “신호로 죽은 프로그램”을 128 + 신호 번호로 알려 줍니다. 1주차에서 본 0(성공), 1(실패), 126(권한 없음), 127(명령 없음)에 139(세그멘테이션 오류)를 더해 두세요. 앞으로 가장 자주 볼 숫자입니다.
역설적이게도 이것이 NULL 을 쓰는 이유입니다. NULL 역참조는 반드시, 즉시, 요란하게 죽습니다. 어디서 죽었는지도 3.5에서 gdb 로 정확히 찾을 수 있습니다. 반면 초기화하지 않은 포인터는 어디를 가리킬지 몰라서, 10.1에서 보겠지만 죽지도 않고 조용히 엉뚱한 메모리를 망가뜨릴 수 있습니다. 조용한 버그보다 요란한 버그가 훨씬 고치기 쉽습니다.
그래서 규칙은 이것입니다.
포인터는 선언할 때 반드시 초기화한다. 가리킬 대상이 아직 없으면
NULL로. 역참조하기 전에, NULL 일 수 있는 포인터는if (p != NULL)로 확인한다.wild 와 dangling: 앞으로 두 가지 위험한 포인터 이름을 듣게 됩니다. wild 포인터는 처음부터 초기화된 적이 없는 포인터(10.1), dangling(댕글링) 포인터는 한때는 유효했지만 가리키던 대상이 사라진 포인터(10.2)입니다. 원인은 달라도 예방책은 같습니다. 선언할 때 초기화하고, 대상이 사라지면
NULL을 넣어 두는 것입니다.
3. 역참조 연산자 (*)
주소를 담아 두기만 해서는 아무 일도 일어나지 않습니다. 포인터의 진짜 쓸모는 그 주소로 찾아가서 값을 읽거나 쓸 때 나옵니다. 이것을 역참조(dereference)라고 하고, 포인터 앞에 * 를 붙여서 합니다.
| 연산자 | 읽는 법 | 하는 일 | 방향 |
|---|---|---|---|
&x |
“x 의 주소” | 변수 → 주소 | 값에서 주소로 |
*p |
“p 가 가리키는 것” | 주소 → 변수 | 주소에서 값으로 |
두 연산자는 정확히 반대 방향입니다.
3.1 역참조(Dereference)란?
int x = 42;
int *p = &x;

printf("%p\n", (void *)p);   // p 의 값: x 의 주소
printf("%d\n", *p);          // p 가 가리키는 곳의 값: 42
*p 를 만나면 컴파일러는 이렇게 일합니다.
p에 들어 있는 주소(0x7fff9910439c)를 꺼낸다.p의 타입이int *이니, 그 주소에서부터 4바이트를 읽는다.- 읽은 4바이트를 정수로 해석한다 → 42.
2.1에서 “무엇을 가리키는지”를 선언에 적어야 한다고 한 이유가 2번과 3번입니다.
3.2 역참조로 값 읽기
#include <stdio.h>

int main(void) {
    int x = 100;
    int *p = &x;

    printf("x = %d\n", x);    // 이름으로 직접
    printf("*p = %d\n", *p);  // 주소를 거쳐서
    return 0;
}
x = 100
*p = 100
같은 사물함을 이름으로 여느냐, 번호로 여느냐의 차이입니다. 결과는 같습니다.
3.3 역참조로 값 수정
*p 는 읽기만 하는 게 아니라 = 의 왼쪽에 와서 값을 넣을 수도 있습니다.
#include <stdio.h>

int main(void) {
    int x = 100;
    int *p = &x;

    printf("수정 전: x = %d\n", x);
    *p = 200;                          // p 가 가리키는 곳(x)에 200 을 넣는다
    printf("수정 후: x = %d\n", x);
    return 0;
}
수정 전: x = 100
수정 후: x = 200
x = 200; 이라고 쓴 적이 없는데 x 가 바뀌었습니다. *p 가 x 의 사물함 자체를 가리키기 때문입니다. pointer_address 예제는 이것을 양쪽 방향으로 보여 줍니다.
=== 직접 수정 vs 포인터로 수정 ===
num = 200; → num = 200, *ptr = 200
*ptr = 300; → num = 300, *ptr = 300
num 을 바꾸면 *ptr 도 바뀌고, *ptr 을 바꾸면 num 도 바뀝니다. 둘은 같은 사물함의 두 가지 이름입니다. 이렇게 한 메모리를 여러 이름으로 부르는 것을 별칭(aliasing)이라고 합니다. 6.3의 swap 에서 이 성질이 뜻밖의 버그를 만드는 것을 보게 됩니다.
3.4 * 의 세 가지 얼굴
지금까지 * 가 세 가지 뜻으로 나왔습니다. 자리를 보면 구분할 수 있습니다.
| 모양 | 자리 | 뜻 |
|---|---|---|
int *p; |
선언문에서 타입 뒤 | “p 는 포인터다” |
*p = 10; / y = *p; |
식 안에서 포인터 앞 (단항) | “p 가 가리키는 것” (역참조) |
a * b |
식 안에서 두 값 사이 (이항) | 곱하기 |
그리고 int *p = &x; 처럼 선언과 초기화를 한 줄에 쓰면, 여기의 * 는 첫 번째(선언) 입니다. “*p 에 &x 를 넣는다”가 아니라 “포인터 p 에 &x 를 넣는다”로 읽어야 합니다. 초보자가 가장 많이 헷갈리는 한 줄이니 천천히 읽어 보세요.
& 와 * 는 서로를 지웁니다
pointer_address 예제의 마지막 부분입니다.
=== & 와 * 의 관계 ===
value = 42
&value = 0x7ffec0f0b95c
pointer = 0x7ffec0f0b95c
*pointer = 42
*&value = 42 (& 적용 후 * 적용 → 원래 값)
&*pointer = 0x7ffec0f0b95c (* 적용 후 & 적용 → 원래 주소)
*&value 는 “value 의 주소가 가리키는 것”, 즉 value 자신입니다. &*pointer 는 “pointer 가 가리키는 것의 주소”, 즉 pointer 의 값입니다. 곱하기와 나누기처럼 & 와 * 는 서로를 되돌립니다.
3.5 gdb 로 포인터 들여다보기
1주차에서 “-g 는 디버거를 위한 정보”라고 하고 미뤄 두었던 gdb 를 드디어 씁니다. gdb 는 실행 중인 프로그램을 원하는 줄에서 멈춰 세우고, 그 순간의 변수 값과 메모리를 들여다보게 해 주는 도구입니다. printf 를 코드에 넣었다 뺐다 하지 않아도 됩니다.
1.2의 addr.c 를 다시 씁니다. 줄 번호를 보고 시작합시다.
$ cat -n addr.c | sed -n 3,8p
     3  int main(void) {
     4      int x = 42;
     5      int *p = &x;
     6
     7      printf("x 의 값      : %d\n", x);
     8      printf("x 의 주소 &x : %p\n", (void *)&x);
sed -n 3,8p 는 3~8번째 줄만 보여 줍니다. 5번째 줄에서 p 에 주소를 넣으니, 7번째 줄에서 멈추면 x 와 p 가 모두 준비된 상태를 볼 수 있습니다.
$ gdb -q ./addr
(gdb) break 7
Breakpoint 1 at 0x1193: file addr.c, line 7.
(gdb) run
Breakpoint 1, main () at addr.c:7
7       printf("x 의 값      : %d\n", x);
gdb ./addr:addr을gdb안에서 열기만 하고, 아직 실행하지 않습니다. 프롬프트가(gdb)로 바뀝니다.break 7: 7번째 줄에 중단점(breakpoint) 을 겁니다. 실행하다가 이 줄에 닿으면 실행하기 직전에 멈춥니다.run: 실행을 시작합니다. 7번째 줄에서 멈췄다고 알려 주고, 곧 실행할 줄을 보여 줍니다. (실제 화면에는Starting program: ...같은 안내가 몇 줄 더 나오는데, 여기서는 생략했습니다.-q는 시작할 때 나오는 긴 저작권 안내를 끄는 옵션입니다.)
이제 물어봅시다. print(줄여서 p) 명령은 C 식을 계산해서 보여 줍니다.
(gdb) print x
$1 = 42
(gdb) print &x
$2 = (int *) 0x7fffffffd20c
(gdb) print p
$3 = (int *) 0x7fffffffd20c
(gdb) print *p
$4 = 42
(gdb) print &p
$5 = (int **) 0x7fffffffd210
(gdb) ptype p
type = int *
(gdb) print sizeof(p)
$6 = 8
$1, $2 는 gdb 가 결과에 붙이는 번호입니다. 결과마다 타입을 함께 알려 주는 것을 보세요.
&x의 타입은(int *), 즉 “int 의 주소”입니다. 값은p와 똑같습니다.&p의 타입은(int **), “int 를 가리키는 포인터의 주소”입니다. 포인터의 주소를 담으려면 포인터의 포인터가 필요하다는 뜻으로, 7주차 이중 포인터의 예고편입니다.ptype은 식의 타입만 보여 줍니다.
주소가 왜
0x7fffffffd20c처럼 반듯할까? 2.3에서setarch -R로 무작위화를 껐을 때 나온 주소와 비슷하죠.gdb는 디버깅을 편하게 하려고 기본으로 주소 무작위화를 끄고 프로그램을 실행합니다. 그래서gdb안에서는 실행할 때마다 같은 주소가 나옵니다.
x 명령: 메모리를 바이트로 보기
print 는 변수를 타입대로 해석한 값을 보여 줍니다. 해석하기 전의 날것, 메모리의 바이트를 보려면 x(examine) 명령을 씁니다.
(gdb) x/4xb &x
0x7fffffffd20c: 0x2a    0x00    0x00    0x00
x/4xb &x 는 “&x 번지부터, 4개를, 16진수(x)로, byte 단위로 보여라”입니다. 0x2a 는 10진수로 42입니다. 1.1에서 본 대로 작은 자리가 앞에 오니 2a 00 00 00 입니다.
이제 포인터 p 자체의 메모리를 봅시다. p 는 8바이트입니다.
(gdb) x/8xb &p
0x7fffffffd210: 0x0c    0xd2    0xff    0xff    0xff    0x7f    0x00    0x00
0c d2 ff ff ff 7f 00 00. 이것을 거꾸로 읽어 보세요. 00 00 7f ff ff ff d2 0c, 즉 0x7fffffffd20c. x 의 주소입니다! 포인터란 정말로 “주소라는 숫자를 8바이트에 담아 둔 변수” 라는 것을 메모리 바이트로 확인했습니다. 사물함 p 를 열었더니 안에 사물함 x 의 번호표가 들어 있는 것입니다.
그림으로 정리하면 이렇습니다.
 주소 0x7fffffffd20c                     주소 0x7fffffffd210
┌──────┬──────┬──────┬──────┐          ┌──────┬──────┬──────┬──────┬──────┬──────┬──────┬──────┐
│  2a  │  00  │  00  │  00  │ ◀─────── │  0c  │  d2  │  ff  │  ff  │  ff  │  7f  │  00  │  00  │
└──────┴──────┴──────┴──────┘          └──────┴──────┴──────┴──────┴──────┴──────┴──────┴──────┘
  x = 42 (int, 4바이트)                   p = 0x7fffffffd20c (int *, 8바이트)
gdb 로 값 바꾸기
gdb 는 보기만 하는 게 아니라 값을 바꿀 수도 있습니다. 포인터를 통해 바꿔 봅시다.
(gdb) set var *p = 100
(gdb) print x
$7 = 100
(gdb) continue
x 의 값      : 100
x 의 주소 &x : 0x7fffffffd20c
p 의 값      : 0x7fffffffd20c
p 가 가리키는 값 *p : 100
p 자신의 주소 &p : 0x7fffffffd210
sizeof(x) = 4, sizeof(p) = 8
[Inferior 1 (process 2481973) exited normally]
(gdb) quit
set var *p = 100 은 3.3의 *p = 200; 을 gdb 에서 한 것입니다. x 가 100이 됐고, continue 로 실행을 이어 가자 프로그램이 42가 아니라 100을 출력합니다. 코드는 한 글자도 안 바꿨는데 말이죠. exited normally 는 정상 종료, quit 은 gdb 를 나가는 명령입니다.
자주 쓰는 명령을 정리합니다.
| 명령 | 줄임 | 하는 일 |
|---|---|---|
break 줄번호 / break 함수이름 |
b |
중단점 걸기 |
run |
r |
실행 시작 |
next |
n |
한 줄 실행 (함수 안으로 들어가지 않음) |
step |
s |
한 줄 실행 (함수 안으로 들어감) |
continue |
c |
다음 중단점까지 계속 |
print 식 |
p |
식의 값 보기 |
ptype 식 |
식의 타입 보기 | |
x/개수 형식 단위 주소 |
메모리를 날것으로 보기 (x/4xb, x/2xw) |
|
set var 변수 = 값 |
값 바꾸기 | |
backtrace |
bt |
지금 어느 함수를 거쳐 여기 왔는지 |
quit |
q |
나가기 |
gdb 로 세그멘테이션 오류 추적하기
2.5의 null 이 어디서 죽었는지 gdb 로 찾아봅시다. run 만 하면 됩니다.
$ gdb -q ./null
(gdb) run
Program received signal SIGSEGV, Segmentation fault.
0x0000555555555170 in main () at null.c:6
6       *p = 10;
(gdb) bt
#0  0x0000555555555170 in main () at null.c:6
(gdb) print p
$1 = (int *) 0x0
gdb 가 죽는 바로 그 순간에 멈춰서, null.c 의 6번째 줄 *p = 10; 에서 SIGSEGV(세그멘테이션 오류 신호)를 받았다고 알려 줍니다. print p 로 보니 0x0, NULL 입니다. 원인과 위치를 한 번에 찾았습니다. 프로그램이 크면 bt(backtrace)가 “main 이 load 를 부르고, load 가 parse 를 부르다가 여기서 죽었다”처럼 경로를 보여 줘서 더 유용해집니다.
세그멘테이션 오류가 나면 제일 먼저 할 일:
-g로 컴파일하고,gdb ./프로그램→run→bt. 이 세 단계로 어느 줄에서 죽었는지 거의 항상 알 수 있습니다.
3.6 수수께끼 풀기: scanf 에는 왜 & 가 붙을까
들어가며에서 던진 첫 번째 질문입니다. 이제 답할 수 있습니다.
printf("%d", age); 는 age 의 값을 출력하면 되니 값의 복사본을 넘겨도 충분합니다. 그런데 scanf 는 키보드로 읽은 값을 age 에 넣어야 합니다. 5주차에서 봤듯 함수는 복사본만 받으니, age 의 값을 넘겨서는 age 를 바꿀 방법이 없습니다. 그래서 age 의 사물함 번호, 즉 &age 를 넘겨서 “읽은 값을 이 번지에 넣어 줘”라고 부탁하는 것입니다. scanf 의 %d 자리에 int 가 아니라 int * 가 와야 하는 이유입니다. 바로 아래 GCC 경고가 이것을 그대로 말해 줍니다.
그럼 & 를 빼먹으면 어떻게 될까요? noamp.c:
#include <stdio.h>

int main(void) {
    int age = 0;
    printf("나이: ");
    scanf("%d", age);
    printf("입력한 나이: %d\n", age);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g noamp.c -o noamp
noamp.c: In function ‘main’:
noamp.c:6:13: warning: format ‘%d’ expects argument of type ‘int *’, but argument 2 has type ‘int’ [-Wformat=]
    6 |     scanf("%d", age);
      |            ~^   ~~~
      |             |   |
      |             |   int
      |             int *
$ echo 25 | ./noamp
세그멘테이션 오류 (코어 덤프됨)
(echo 25 | 는 키보드 대신 25 를 입력으로 넣어 주는 방법입니다.)
GCC가 “%d 자리에는 int * 가 와야 하는데 int 가 왔다”고 정확히 짚어 줍니다. 무시하고 실행하면 죽습니다. 왜 죽는지 따라가 봅시다. scanf 는 받은 값을 주소로 믿고 그 번지에 25를 넣으려 합니다. 받은 값은 age 의 값 0 입니다. 0번지, 즉 NULL 에 쓰려고 했으니 2.5와 똑같은 이유로 죽었습니다. age 가 0이 아니었다면 엉뚱한 번지에 25를 써 넣고 안 죽었을 수도 있습니다. 그게 더 무섭습니다.
한 가지 더. 나이: 도 출력되지 않았습니다. printf 는 출력을 곧바로 화면에 보내지 않고 버퍼라는 임시 공간에 모았다가, 줄바꿈(\n)을 만나거나 버퍼가 차거나 프로그램이 정상 종료할 때 한꺼번에 내보냅니다. "나이: " 에는 줄바꿈이 없어서 버퍼에 남아 있었는데, 프로그램이 비정상 종료하면서 버퍼째 사라졌습니다. 그래서 프로그램이 죽기 직전에 찍은 메시지가 안 보일 수 있습니다. 디버깅할 때 printf 로 “여기까지 왔나?”를 확인하려면 메시지 끝에 \n 을 붙이세요. 2.5의 null 에서 역참조 직전\n 이 보였던 것은 \n 덕분입니다. (단, 출력을 파이프나 파일로 보내면 \n 이 있어도 모았다가 내보냅니다. 버퍼는 9주차 파일 입출력에서 자세히 다룹니다.)
4. 포인터 연산
포인터는 주소, 즉 숫자이므로 더하고 뺄 수 있습니다. 그런데 포인터의 덧셈은 우리가 아는 덧셈과 조금 다릅니다. 그 차이가 이 절의 핵심이고, 5절의 “배열과 포인터”로 가는 다리입니다.
4.1 포인터 산술 연산
int 배열을 가리키는 포인터에 1을 더하면 주소가 얼마나 커질까요? 1? 아닙니다.
int arr[5] = {10, 20, 30, 40, 50};
int *p = arr;                          // 배열의 첫 요소를 가리킴 (5절에서 설명)

printf("*p     = %d\n", *p);           // 10
printf("*(p+1) = %d\n", *(p + 1));     // 20
printf("*(p+2) = %d\n", *(p + 2));     // 30
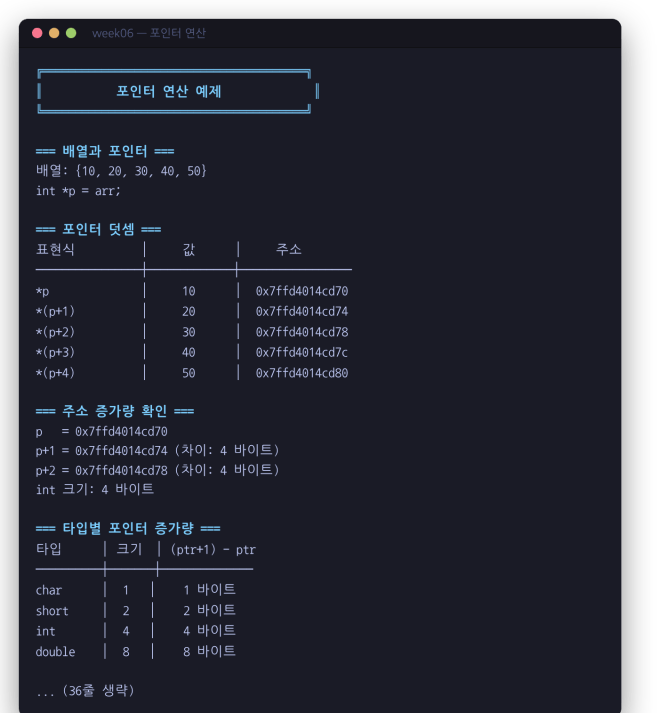
포인터 연산
위 스크린샷은 pointer_arithmetic 예제입니다. 주소 부분을 옮기면 이렇습니다.
=== 포인터 덧셈 ===
표현식          │     값      │     주소
────────────────┼─────────────┼─────────────────
*p              │     10      │  0x7ffd0e268760
*(p+1)          │     20      │  0x7ffd0e268764
*(p+2)          │     30      │  0x7ffd0e268768
*(p+3)          │     40      │  0x7ffd0e26876c
*(p+4)          │     50      │  0x7ffd0e268770

=== 주소 증가량 확인 ===
p   = 0x7ffd0e268760
p+1 = 0x7ffd0e268764 (차이: 4 바이트)
p+2 = 0x7ffd0e268768 (차이: 4 바이트)
int 크기: 4 바이트
p + 1 은 p 보다 4 큽니다. 1을 더했는데 4가 늘었습니다. 포인터에 정수 n 을 더하면, 주소는 n × (가리키는 타입의 크기) 만큼 커집니다. int 는 4바이트이니 p + 1 은 4, p + 2 는 8바이트 뒤입니다.
실제 주소로 그리면 이렇습니다.
 주소:  ...760     ...764     ...768     ...76c     ...770
      ┌──────────┬──────────┬──────────┬──────────┬──────────┐
 arr  │    10    │    20    │    30    │    40    │    50    │
      └──────────┴──────────┴──────────┴──────────┴──────────┘
        ↑          ↑          ↑          ↑          ↑
        p         p+1        p+2        p+3        p+4
      (각 칸은 int 하나 = 4바이트)
왜 이렇게 만들었을까요? 이 규칙 덕분에 p + 1 은 타입이 무엇이든 항상 “다음 원소” 를 가리킵니다. 만약 포인터 덧셈이 1바이트씩이라면, int 배열의 다음 원소를 가리키려고 p + 4 라고 써야 하고, 그 4 는 타입마다 달라서 실수하기 딱 좋았을 겁니다. C는 “주소 계산은 컴파일러가, 원소 세기는 사람이” 하도록 나눴습니다.
4.2 포인터 증감 연산
++, -- 도 같은 규칙입니다. p++ 은 p = p + 1, 즉 다음 원소로 한 칸 이동입니다.
int arr[5] = {10, 20, 30, 40, 50};
int *p = arr;

printf("%d\n", *p);    // 10
p++;                   // 다음 원소로
printf("%d\n", *p);    // 20
p--;                   // 이전 원소로
printf("%d\n", *p);    // 10
p++, ++p, ++*p — 한 글자 차이, 전혀 다른 뜻
C 코드에서 자주 보는 짧은 표현들입니다. pointer_arithmetic 의 마지막 부분이 이것을 보여 줍니다. 각 표현 전에 p = arr; 로 첫 원소부터 다시 시작한다는 점을 기억하고 보세요(배열은 {10, 20, 30, 40, 50}).
=== 복합 포인터 연산 ===
*p++ = 10 (현재 값 사용 후 포인터 증가)
현재 *p = 20
*++p = 20 (포인터 증가 후 값 사용)
현재 *p = 20
++*p = 11 (값을 먼저 증가)
현재 arr[0] = 11
| 표현 | 계산 순서 | 결과값 | 이후 p |
이후 arr[0] |
|---|---|---|---|---|
*p++ |
*p 값(10)을 쓰고, p 를 한 칸 이동 |
10 | arr[1] 을 가리킴 |
10 |
*++p |
p 를 먼저 한 칸 이동하고, 그 값(20) | 20 | arr[1] 을 가리킴 |
10 |
++*p |
*p, 즉 값을 1 증가 |
11 | arr[0] 그대로 |
11 |
규칙은 이렇습니다. 뒤에 붙는 p++ 는 앞에 붙는 * 보다 먼저 묶입니다. 그래서 *p++ 는 *(p++) 로 읽고, “p 를 증가시키되, 식의 값은 증가 전 의 p 를 역참조한 것”입니다. 앞에 붙는 * 와 ++ 는 오른쪽부터 묶이므로 *++p 는 *(++p), ++*p 는 ++(*p) 입니다. 헷갈리면 괄호를 쓰세요. (*p)++ 처럼 쓰면 누구도 헷갈리지 않습니다.
*p++ 는 특히 자주 보입니다. “지금 값을 쓰고 다음 칸으로”라는, 배열을 훑을 때 딱 필요한 동작이기 때문입니다. 7절에서 문자열을 훑을 때 다시 봅니다.
4.3 타입에 따른 이동 크기
정말 타입마다 이동 폭이 다를까요? 직접 재 봅시다. ptypes.c:
#include <stdio.h>

int main(void) {
    char c[2];
    short s[2];
    int i[2];
    double d[2];
    char *pc = c;
    short *ps = s;
    int *pi = i;
    double *pd = d;

    printf("char   : pc = %p, pc+1 = %p\n", (void *)pc, (void *)(pc + 1));
    printf("short  : ps = %p, ps+1 = %p\n", (void *)ps, (void *)(ps + 1));
    printf("int    : pi = %p, pi+1 = %p\n", (void *)pi, (void *)(pi + 1));
    printf("double : pd = %p, pd+1 = %p\n", (void *)pd, (void *)(pd + 1));
    return 0;
}
$ ./ptypes
char   : pc = 0x7fffaa258c96, pc+1 = 0x7fffaa258c97
short  : ps = 0x7fffaa258c74, ps+1 = 0x7fffaa258c76
int    : pi = 0x7fffaa258c78, pi+1 = 0x7fffaa258c7c
double : pd = 0x7fffaa258c80, pd+1 = 0x7fffaa258c88
| 타입 | sizeof |
+1 했을 때 주소 차이 |
|---|---|---|
char * |
1 | ...c96 → ...c97: 1 |
short * |
2 | ...c74 → ...c76: 2 |
int * |
4 | ...c78 → ...c7c: 4 |
double * |
8 | ...c80 → ...c88: 8 |
정확히 타입 크기만큼입니다. 덤으로 하나 더 보입니다. short 배열은 짝수 번지에서, int 배열은 4의 배수 번지에서, double 배열은 8의 배수 번지(...c80)에서 시작합니다. CPU는 크기에 맞춰 줄 선 주소에서 읽을 때 가장 빠르기 때문에, 컴파일러가 이렇게 정렬(alignment)해서 놓습니다. 8주차 구조체에서 이 정렬 때문에 생기는 빈 공간을 직접 보게 됩니다.
4.4 포인터 간 뺄셈
같은 배열 안의 두 포인터를 빼면 몇 칸 떨어져 있는지(원소 개수)가 나옵니다. 바이트 수가 아닙니다.
#include <stdio.h>
#include <stddef.h>

int main(void) {
    int arr[5] = {10, 20, 30, 40, 50};
    int *p1 = &arr[1];
    int *p2 = &arr[4];
    ptrdiff_t n = p2 - p1;
    printf("p2 - p1 = %td\n", n);
    return 0;
}
p2 - p1 = 3
arr[1] 과 arr[4] 사이는 3칸입니다. 주소로는 12바이트 차이지만, 뺄셈도 덧셈처럼 타입 크기로 나눠서 알려 줍니다. pointer_arithmetic 예제는 두 가지를 나란히 보여 줍니다.
p2 - p1 = 3 (요소 개수)
(char *)p2 - (char *)p1 = 12 (바이트)
char * 로 바꾸면 한 칸이 1바이트가 되니 바이트 수가 나옵니다. 포인터의 타입이 “한 칸의 크기”를 정한다는 것을 다시 확인할 수 있습니다.
포인터 뺄셈의 결과 타입은 ptrdiff_t 입니다(stddef.h 에 정의). printf 로 찍을 때는 전용 서식 %td 를 씁니다. 우리 컴퓨터에서는 ptrdiff_t 가 long 이라 %ld 로 찍어도 같은 값이 나오지만, 다른 컴퓨터에서는 크기가 다를 수 있어서 %td 가 정확한 표기입니다. sizeof 의 결과가 size_t 이고 %zu 로 찍는 것과 같은 관계입니다.
4.5 포인터 비교 연산
같은 배열 안의 두 포인터는 크기를 비교할 수 있습니다. 앞쪽 원소일수록 주소가 작습니다.
int arr[5];
int *p1 = &arr[0];
int *p2 = &arr[3];

if (p1 < p2) {
    printf("p1 이 p2 보다 앞에 있음\n");
}
if (p1 == p2) {
    printf("같은 위치를 가리킴\n");
}
p1 이 p2 보다 앞에 있음
이 비교 덕분에 “포인터가 배열 끝에 닿을 때까지 반복”하는 코드를 쓸 수 있습니다.
for (int *p = arr; p < arr + 5; p++) {
    printf("%d ", *p);
}
여기서 arr + 5 는 마지막 원소(arr[4])의 바로 다음 칸을 가리킵니다. 배열 밖이지만, C 표준은 “배열 끝 바로 다음”을 가리키는 포인터를 만드는 것까지는 허락합니다. 비교용 표지판으로만 쓰고 역참조하지는 않기 때문에 안전합니다. *(arr + 5) 처럼 역참조하는 순간 10.3의 범위 초과가 됩니다.
주의: 비교는 같은 배열 안에서만.
==,!=는 아무 포인터끼리나 비교해도 되지만,<,>는 같은 배열(또는 그 끝 바로 다음)을 가리키는 포인터끼리만 뜻이 있습니다. 서로 다른 변수의 주소를<로 비교한 결과는 표준이 정하지 않았습니다. 1.1에서 본 것처럼 변수들이 메모리 어디에 놓일지는 컴파일러 마음이기 때문입니다.
5. 포인터와 배열
4주차에 배열을 배우면서 몇 가지 의문을 남겨 두었습니다. 배열 이름을 printf("%p", arr) 로 찍으면 왜 주소가 나올까? 5주차에서는 함수 안에서 sizeof(arr) 가 왜 배열 크기가 아니었을까? 4절의 포인터 산술을 알고 나면 이 의문들이 한 문장으로 풀립니다.
배열 이름은 대부분의 식에서 “첫 원소의 주소”로 바뀝니다.
이 변환을 감쇠(decay)라고 부릅니다. 배열이 식 안에 들어가면 “배열 전체”라는 정보를 잃고 “첫 원소를 가리키는 포인터”로 줄어든다는 뜻입니다.
5.1 배열 이름과 포인터
pointer_array 예제의 첫 부분입니다.
$ ./build/examples/pointer_array
=== 배열 이름은 포인터? ===
arr     = 0x7fff5e896470
&arr[0] = 0x7fff5e896470
p       = 0x7fff5e896470
세 값이 모두 같습니다!
int *p = arr; 로 만든 p, 배열 이름 arr, 첫 원소의 주소 &arr[0] 이 모두 같은 주소입니다. 그래서 int *p = arr; 는 int *p = &arr[0]; 과 똑같은 뜻입니다. 4절에서 int *p = arr; 라고 쓴 것이 이것이었습니다.
5.2 배열 요소 접근 방법 — arr[i] 의 정체
이제 C 배열의 가장 큰 비밀을 밝힐 차례입니다. arr[i] 라는 대괄호 문법은 사실 포인터 산술의 줄임말입니다.
arr[i]는 정확히*(arr + i)입니다.
컴파일러는 arr[i] 를 보면 이렇게 계산합니다. ① arr 을 첫 원소의 주소로 바꾼다(감쇠). ② 거기에 i 를 더한다(4.1의 규칙대로 i × 4 바이트 뒤). ③ 그 주소를 역참조한다. 그러니 배열이든 포인터든 대괄호를 쓸 수 있습니다.
=== 배열 요소 접근 4가지 방법 ===
인덱스 │ arr[i] │ *(arr+i) │ p[i] │ *(p+i)
───────┼────────┼──────────┼──────┼───────
  0    │   10   │    10    │  10  │   10
  1    │   20   │    20    │  20  │   20
  2    │   30   │    30    │  30  │   30
  3    │   40   │    40    │  40  │   40
  4    │   50   │    50    │  50  │   50
네 가지 표기가 모두 같은 값을 냅니다.
배열 인덱스가 왜 0부터 시작하는지도 여기서 풀립니다. arr[0] 은 *(arr + 0), 즉 “첫 원소에서 0칸 떨어진 곳”입니다. 인덱스는 “몇 번째”가 아니라 “처음에서 몇 칸 떨어져 있나” 입니다.
실험: 2[arr] 도 될까?
arr[i] 가 *(arr + i) 라면, 덧셈은 순서를 바꿔도 같으니 *(i + arr) 이고, 그러면 i[arr] 이라고 써도 되지 않을까요? 해 봅시다.
#include <stdio.h>

int main(void) {
    int arr[5] = {10, 20, 30, 40, 50};
    printf("arr[2] = %d\n", arr[2]);
    printf("*(arr + 2) = %d\n", *(arr + 2));
    printf("2[arr] = %d\n", 2[arr]);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 idx.c -o idx && ./idx
arr[2] = 30
*(arr + 2) = 30
2[arr] = 30
경고 하나 없이 30이 나옵니다. 대괄호가 정말로 “더하고 역참조”의 줄임말이라는 증거입니다. 물론 실제 코드에 2[arr] 이라고 쓰면 읽는 사람이 괴로우니 쓰지 마세요. 원리를 확인하는 장난감일 뿐입니다.
5.3 배열과 포인터의 차이점
그렇다면 배열과 포인터는 같은 것일까요? 아닙니다. 대부분의 식에서 똑같이 행동할 뿐, 정체는 다릅니다. 차이가 드러나는 곳이 세 군데 있습니다.
차이 1: sizeof
=== 배열과 포인터의 차이점 ===
sizeof(arr) = 20 (전체 배열 크기: 5 × 4 = 20바이트)
sizeof(p)   = 8 (포인터 크기: 64비트 시스템)
sizeof 안에서는 배열이 감쇠하지 않습니다. sizeof(arr) 는 배열 전체 20바이트, sizeof(p) 는 포인터 하나 8바이트입니다. 배열 원소 개수를 sizeof(arr) / sizeof(arr[0]) 로 구할 수 있는 이유가 이것입니다.
차이 2: 배열 이름에는 대입할 수 없다
#include <stdio.h>

int main(void) {
    int arr[3] = {1, 2, 3};
    arr++;
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g arrinc.c -o arrinc
arrinc.c: In function ‘main’:
arrinc.c:5:8: error: lvalue required as increment operand
    5 |     arr++;
      |        ^~
“증가 연산의 대상은 lvalue 여야 한다”는 오류입니다. lvalue 는 “값을 넣을 수 있는 자리”, 즉 = 의 왼쪽(left)에 올 수 있는 것을 말합니다. p 는 주소를 담는 진짜 변수라서 p++ 로 옮길 수 있지만, arr 은 “배열 20바이트 그 자체”의 이름이라서 다른 곳을 가리키게 바꿀 수 없습니다. 식 안에서 주소로 바뀌기는 하지만, 그 주소를 담아 둔 별도의 상자가 있는 것은 아니기 때문입니다.
“배열 이름은 상수 포인터”라는 설명을 자주 보는데, 편하긴 해도 정확하지는 않습니다. 배열 이름은 포인터가 아니라, 포인터로 바뀌어 쓰이는 배열입니다.
차이 3: &arr 과 arr
=== &arr vs arr ===
arr     = 0x7fff5e896470 (첫 번째 요소의 주소)
&arr    = 0x7fff5e896470 (배열 전체의 주소)
값은 같지만 타입이 다릅니다!
arr + 1  = 0x7fff5e896474 (다음 int로 이동: +4)
&arr + 1 = 0x7fff5e896484 (다음 배열로 이동: +20)
arr 과 &arr 은 같은 번지를 가리킵니다. 하지만 1을 더해 보면 차이가 납니다. arr + 1 은 4바이트, &arr + 1 은 20바이트 뒤입니다. arr 은 “int 하나의 주소”(int *)로 감쇠하고, &arr 은 “int 5개짜리 배열 전체의 주소”(int (*)[5])이기 때문입니다. 4.1의 규칙(“가리키는 것의 크기만큼 이동”)이 여기서도 정확히 지켜집니다. 가리키는 것이 배열 전체라서 한 칸이 20바이트인 것이죠. int (*)[5] 같은 타입은 7주차에서 본격적으로 다룹니다.
5.4 포인터로 배열 순회
배열을 훑는 방법은 여러 가지입니다. pointer_arithmetic 예제가 네 가지를 보여 줍니다.
int arr[5] = {10, 20, 30, 40, 50};
int *p;

// 방법 1: 인덱스
for (int i = 0; i < 5; i++) printf("%d ", arr[i]);

// 방법 2: 포인터 산술
for (int i = 0; i < 5; i++) printf("%d ", *(arr + i));

// 방법 3: 포인터를 옮기며
p = arr;
for (int i = 0; i < 5; i++) printf("%d ", *p++);

// 방법 4: 끝 주소와 비교 (4.5)
for (p = arr; p < arr + 5; p++) printf("%d ", *p);
방법 1: 인덱스 사용
  10 20 30 40 50
방법 2: 포인터 산술
  10 20 30 40 50
방법 3: 포인터 증가
  10 20 30 40 50
방법 4: 포인터와 끝 주소 비교
  10 20 30 40 50
결과는 같습니다. 무엇을 쓸까요? 읽기 쉬운 것을 쓰세요. 요즘 컴파일러는 어느 쪽이든 같은 기계어를 만들어 내기 때문에, “포인터가 더 빠르다”는 옛말은 대부분 사실이 아닙니다. 보통은 방법 1이 가장 읽기 쉽고, 문자열처럼 “끝 표시가 나올 때까지” 훑을 때는 방법 3이 자연스럽습니다(7.2).
5.5 2차원 배열과 포인터 (맛보기)
2차원 배열도 메모리에서는 한 줄로 이어져 있습니다.
=== 2차원 배열과 포인터 ===
matrix[2][3]:
1 2 3
4 5 6

주소 분석:
matrix        = 0x7fff5e896490 (전체 배열 시작)
matrix[0]     = 0x7fff5e896490 (첫 번째 행)
matrix[1]     = 0x7fff5e89649c (두 번째 행)
&matrix[0][0] = 0x7fff5e896490 (첫 번째 요소)
matrix[1] 은 matrix[0] 보다 0x9c - 0x90 = 12 바이트 뒤입니다. 한 행이 int 3개, 12바이트이니 두 번째 행은 첫 번째 행 바로 뒤에 붙어 있습니다. 그래서 1차원 포인터 하나로 전부 훑을 수 있습니다.
matrix[i][j] = flat_p[i * 열수 + j]
matrix[1][2] = flat_p[1 * 3 + 2] = flat_p[5] = 6
i * 열수 + j 공식은 이미지 처리(픽셀), 행렬 계산 등에서 계속 나옵니다. 2차원 배열을 함수에 넘기는 방법 같은 자세한 내용은 7주차에서 다룹니다.
6. 포인터와 함수
드디어 포인터가 제값을 하는 절입니다. 5주차에서 막혔던 swap 을 드디어 완성합니다.
6.1 값에 의한 전달 (Call by Value) — 주소로 다시 보기
5주차에서 “함수는 인자의 복사본을 받는다”고 배웠습니다. 이제 주소를 찍을 수 있으니, 정말 복사본인지 주소로 확인해 봅시다. byval.c:
#include <stdio.h>

void add_ten(int x) {
    printf("  add_ten 안: x 의 주소 = %p, 값 = %d\n", (void *)&x, x);
    x = x + 10;
    printf("  add_ten 안: x 를 바꾼 뒤 값 = %d\n", x);
}

void add_ten_ptr(int *p) {
    printf("  add_ten_ptr 안: p 의 값(받은 주소) = %p\n", (void *)p);
    printf("  add_ten_ptr 안: p 자신의 주소     = %p\n", (void *)&p);
    *p = *p + 10;
}

int main(void) {
    int num = 5;
    printf("main: num 의 주소 = %p, 값 = %d\n", (void *)&num, num);

    add_ten(num);
    printf("main: add_ten 뒤 num = %d\n\n", num);

    add_ten_ptr(&num);
    printf("main: add_ten_ptr 뒤 num = %d\n", num);
    return 0;
}
$ ./byval
main: num 의 주소 = 0x7fff2c8bdc24, 값 = 5
  add_ten 안: x 의 주소 = 0x7fff2c8bdc0c, 값 = 5
  add_ten 안: x 를 바꾼 뒤 값 = 15
main: add_ten 뒤 num = 5

  add_ten_ptr 안: p 의 값(받은 주소) = 0x7fff2c8bdc24
  add_ten_ptr 안: p 자신의 주소     = 0x7fff2c8bdc08
main: add_ten_ptr 뒤 num = 15
위 두 줄을 비교해 보세요. num 은 ...dc24 번지, add_ten 안의 x 는 ...dc0c 번지입니다. 값은 5로 같지만 사물함이 다릅니다. x 를 15로 바꿔도 ...dc0c 칸이 바뀔 뿐, ...dc24 칸의 num 은 그대로 5입니다. 5주차에서 말로만 들은 “복사본”을 주소로 확인했습니다.
 main                             add_ten
┌──────────────────────┐         ┌──────────────────────┐
│ num  (...dc24)       │  복사    │ x    (...dc0c)       │
│        5             │ ──────▶ │        5 → 15        │
└──────────────────────┘         └──────────────────────┘
   그대로 5                          바뀐 것은 복사본뿐
6.2 주소에 의한 전달 (Call by Reference)
이번에는 주소를 넘겼습니다(add_ten_ptr(&num)). 출력의 아래 두 줄을 보세요.
p 의 값(받은 주소) = 0x7fff2c8bdc24:num의 주소와 똑같습니다.p 자신의 주소 = 0x7fff2c8bdc08:p라는 매개변수 상자는num과 다른 곳에 새로 생겼습니다.
즉 C는 이번에도 복사를 했습니다. 다만 복사한 것이 num 의 값(5)이 아니라 num 의 주소입니다. 주소를 복사해도 가리키는 곳은 같으니, *p = *p + 10 은 ...dc24 칸, 즉 num 을 직접 바꿉니다.
 main                             add_ten_ptr
┌──────────────────────┐         ┌──────────────────────┐
│ num  (...dc24)       │ ◀────── │ p    (...dc08)       │
│        5 → 15        │ 가리킴   │  0x7fff2c8bdc24      │
└──────────────────────┘         └──────────────────────┘
   *p 로 바꾸면 num 이 바뀐다        주소를 복사해 받았다
엄밀히 말하면 C에는 “참조에 의한 전달”이 따로 없습니다. C의 인자 전달은 언제나 값의 복사이고, 그 값이 주소일 때 참조처럼 흉내 낼 수 있을 뿐입니다. “call by reference”라는 말은 편의상 쓰는 이름이라고 알아 두세요.
6.3 두 변수 값 교환 (swap) — 5주차 숙제 완성
5주차의 try_swap 이 실패한 이유를 이제 정확히 압니다. 복사본끼리 맞바꿨기 때문입니다. 주소를 받아서 원본을 바꾸면 됩니다.
#include <stdio.h>

// 5주차 방식 (값 전달) - 동작하지 않음
void wrong_swap(int a, int b) {
    int temp = a;
    a = b;
    b = temp;
}

// 이번 주 방식 (포인터 전달)
void swap(int *a, int *b) {
    int temp = *a;   // ① a 가 가리키는 값을 temp 에 보관
    *a = *b;         // ② b 가 가리키는 값을 a 가 가리키는 곳에
    *b = temp;       // ③ 보관한 값을 b 가 가리키는 곳에
}

int main(void) {
    int x = 10, y = 20;
    wrong_swap(x, y);
    printf("wrong_swap 후: x=%d, y=%d\n", x, y);
    swap(&x, &y);
    printf("swap 후: x=%d, y=%d\n", x, y);
    return 0;
}
저장소의 pointer_swap 예제는 함수 안의 상태까지 출력해서 차이를 보여 줍니다.
$ ./build/examples/pointer_swap
=== 잘못된 swap (값 전달) ===
호출 전: x=10, y=20
  wrong_swap 내부 (교환 전): a=10, b=20
  wrong_swap 내부 (교환 후): a=20, b=10
호출 후: x=10, y=20 (변화 없음!)
...
=== 올바른 swap (포인터 전달) ===
호출 전: x=10, y=20
  swap 내부 (교환 전): *a=10, *b=20
  swap 내부 (교환 후): *a=20, *b=10
호출 후: x=20, y=10 (교환됨!)
wrong_swap 은 안에서는 분명히 바뀌었는데 밖에서는 그대로입니다. swap 은 안팎이 같이 바뀝니다. 주소를 찍어 보면 swap 의 a, b 가 정말 x, y 의 주소를 받았는지 확인할 수 있습니다.
main: &x = 0x7ffc99f24e60, &y = 0x7ffc99f24e64
  swap 안: a = 0x7ffc99f24e60, b = 0x7ffc99f24e64
main: x = 20, y = 10
swap 을 세 단계로 그려 봅시다(주소는 끝자리만).
처음            ① temp = *a       ② *a = *b         ③ *b = temp
 x(...e60): 10   x: 10  temp:10    x: 20  temp:10    x: 20
 y(...e64): 20   y: 20             y: 20             y: 10
temp 가 왜 필요할까요? ②에서 x 에 20을 넣는 순간 원래 값 10이 지워지기 때문입니다. 컵 두 개의 음료를 바꾸려면 빈 컵이 하나 더 있어야 하는 것과 같습니다.
swap(&x, &y) 를 호출할 때 & 를 붙인다는 것을 보세요. 3.6의 scanf(&age) 와 똑같은 모양입니다. “이 함수가 내 변수를 바꿀 것”이라는 표시가 호출하는 쪽 코드에 드러나는 것이죠.
실험: 임시 변수 없이 바꾸는 요령과 그 함정
pointer_swap 예제에는 임시 변수 없이 덧셈과 뺄셈만으로 바꾸는 방법도 들어 있습니다.
void swap_arithmetic(int *a, int *b) {
    *a = *a + *b;    // a = 원래a + 원래b
    *b = *a - *b;    // b = (원래a + 원래b) - 원래b = 원래a
    *a = *a - *b;    // a = (원래a + 원래b) - 원래a = 원래b
}
영리해 보이지만 함정이 있습니다. a 와 b 가 같은 변수를 가리키면 어떻게 될까요? 배열을 정렬하다 보면 swap(&arr[i], &arr[j]) 에서 i 와 j 가 우연히 같아지는 일은 흔합니다. 이 글을 쓰면서 저장소 예제를 그대로 가져와 시험해 봤습니다.
int arr[3] = {7, 8, 9};
int i = 1, j = 1;
swap_arithmetic(&arr[i], &arr[j]);   /* i 와 j 가 같을 때 */
printf("arr[1] = %d\n", arr[1]);
arr[1] = 0
8이 0이 됐습니다. a 와 b 가 같은 칸을 가리키니, 첫 줄에서 그 칸이 16이 되고, 둘째 줄 *b = *a - *b 에서 16 − 16 = 0 이 되어 버립니다. 3.3에서 본 별칭이 만든 버그입니다. 두 포인터가 같은 곳을 가리킬 수 있다는 것을 잊으면 이런 일이 생깁니다. 게다가 *a + *b 가 int 의 최댓값(약 21억)을 넘으면 결과를 보장할 수 없습니다.
그래서 저장소 예제를 고쳐서, a 와 b 가 같으면 아무것도 하지 않도록 if (a != b) 를 넣었습니다(같은 파일의 XOR 판은 원래 이 검사가 있었습니다). 하지만 교훈은 따로 있습니다. 요령보다 temp 를 쓰는 평범한 swap 이 낫습니다. 같은 주소에서도 안전하고, 넘칠 일도 없고, 읽기도 쉽습니다. 요즘 컴파일러는 temp 를 쓴 코드를 충분히 빠르게 만듭니다.
6.4 함수에서 여러 값 반환
return 은 값을 하나만 돌려줄 수 있습니다. 몫과 나머지처럼 두 개를 돌려주고 싶으면 어떻게 할까요? 결과를 넣을 사물함 번호를 받으면 됩니다.
#include <stdio.h>

void divide(int dividend, int divisor, int *quotient, int *remainder) {
    *quotient = dividend / divisor;
    *remainder = dividend % divisor;
}

int main(void) {
    int q, r;
    divide(17, 5, &q, &r);
    printf("17 / 5 = %d ... %d\n", q, r);
    return 0;
}
17 / 5 = 3 ... 2
quotient, remainder 는 출력용 매개변수(output parameter) 라고 부릅니다. 함수가 값을 “받는” 게 아니라 “돌려주는” 데 쓰는 매개변수입니다. scanf 가 바로 이 방식입니다. 입력값 여러 개를 &a, &b, &c 로 한꺼번에 받죠.
q 와 r 을 초기화하지 않았는데 괜찮을까요? 이번에는 괜찮습니다. divide 가 읽기 전에 쓰기 때문입니다. 하지만 divide 가 어떤 경우에 값을 안 채우고 돌아온다면(예: divisor 가 0일 때 그냥 return), 1주차에서 본 “초기화하지 않은 변수”가 됩니다. 출력용 매개변수로 받을 변수도 초기화해 두는 편이 안전합니다.
6.5 배열을 함수에 전달
배열을 함수에 넘기면 무슨 일이 일어날까요? 5절의 감쇠 규칙 그대로입니다. 배열 이름이 첫 원소의 주소로 바뀌어서 넘어갑니다. 그래서 매개변수를 어떻게 적든 실제로는 포인터입니다.
void print_array(int arr[], int size);     // 셋 다
void print_array(int *arr, int size);      // 완전히
void print_array(int arr[10], int size);   // 같은 선언 (10은 무시됨)
5주차에서 “함수 안에서 sizeof(arr) 는 쓸 수 없다”고 한 이유를 확인해 봅시다.
#include <stdio.h>

void show(int arr[]) {
    printf("함수 안: sizeof(arr) = %zu\n", sizeof(arr));
}

int main(void) {
    int arr[5] = {1, 2, 3, 4, 5};
    printf("main  : sizeof(arr) = %zu\n", sizeof(arr));
    show(arr);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g sizefn.c -o sizefn
sizefn.c: In function ‘show’:
sizefn.c:4:50: warning: ‘sizeof’ on array function parameter ‘arr’ will return size of ‘int *’ [-Wsizeof-array-argument]
    4 |     printf("함수 안: sizeof(arr) = %zu\n", sizeof(arr));
      |                                                  ^
sizefn.c:3:15: note: declared here
    3 | void show(int arr[]) {
      |           ~~~~^~~~~
$ ./sizefn
main  : sizeof(arr) = 20
함수 안: sizeof(arr) = 8
GCC가 “배열 매개변수에 sizeof 를 쓰면 int * 의 크기가 나온다”고 경고까지 해 줍니다. main 에서는 20, 함수 안에서는 8. 함수 안의 arr 은 int arr[] 라고 적었어도 사실 int * 이기 때문입니다. 그래서 배열을 넘길 때는 크기를 따로 넘겨야 합니다.
반대로 좋은 점도 있습니다. 배열 20바이트를 복사하지 않고 주소 8바이트만 넘기니 빠르고, 함수가 원본 배열을 직접 고칠 수 있습니다.
=== 배열을 함수에 전달 ===
원본 배열: 1 2 3 4 5
double_array 후: 2 4 6 8 10
pointer_function 예제의 double_array 는 arr[i] *= 2 로 원소를 두 배로 만듭니다. main 의 배열이 실제로 바뀌었습니다. 원본을 바꾸지 않을 함수라면 8절에서 배울 const 로 표시해 둡니다.
7. 포인터와 문자열
C에는 문자열 타입이 따로 없습니다. 1주차에서 봤듯 문자열은 \0 으로 끝나는 char 배열이고, 배열은 5절에서 봤듯 포인터로 다뤄집니다. 그러니 문자열을 제대로 알려면 포인터로 봐야 합니다.
7.1 문자열 리터럴과 포인터
같은 "Hello" 인데 선언 방법이 두 가지입니다.
char arr[] = "Hello";       // 방법 1: 문자 배열
char *lit  = "Hello";       // 방법 2: 문자열을 가리키는 포인터
비슷해 보이지만 하나는 고칠 수 있고, 하나는 고치면 프로그램이 죽습니다. 실험해 봅시다. strlit.c:
#include <stdio.h>

int main(void) {
    char arr[] = "Hello";
    char *lit = "Hello";
    arr[0] = 'J';
    printf("arr = %s\n", arr);
    lit[0] = 'J';
    printf("lit = %s\n", lit);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g strlit.c -o strlit
$ ./strlit
arr = Jello
세그멘테이션 오류 (코어 덤프됨)
경고 하나 없이 컴파일됐는데, arr 은 Jello 로 잘 바뀌고 lit 을 바꾸려는 순간 죽었습니다. 무엇이 다를까요?
char arr[] = "Hello";는 지역 변수arr이라는 6바이트짜리 배열을 새로 만들고,"Hello"의 글자들을 그 안에 복사합니다.arr은 내 사물함이니 마음대로 고칠 수 있습니다.char *lit = "Hello";는 8바이트짜리 포인터만 만들고, 프로그램 안 어딘가에 있는"Hello"원본을 가리키기만 합니다. 그 원본은 1.1의regions실험에서 본0x5...구역, 그중에서도 읽기 전용 구역에 있습니다. 1주차 7절의 어셈블리에서.section .rodata(read-only data)라고 나왔던 곳이죠. 읽기 전용 메모리에 쓰려고 했으니 세그멘테이션 오류가 난 것입니다.
 스택 (내 사물함, 고칠 수 있음)          읽기 전용 구역 (.rodata)
┌───┬───┬───┬───┬───┬────┐
│ J │ e │ l │ l │ o │ \0 │ arr        ┌───┬───┬───┬───┬───┬────┐
└───┴───┴───┴───┴───┴────┘            │ H │ e │ l │ l │ o │ \0 │ ← "Hello" 원본
                                      └───┴───┴───┴───┴───┴────┘
┌──────────────────┐                    ↑
│  0x5...          │ lit ───────────────┘  여기에 쓰면 세그멘테이션 오류
└──────────────────┘
크기도 다릅니다. pointer_string 예제의 출력입니다.
char str_array[] = "Hello";
  - sizeof = 6 (배열 전체 크기)

const char *str_pointer = "World";
  - sizeof = 8 (포인터 크기)
const 로 실수를 컴파일할 때 잡기
C에서는 char *lit = "Hello"; 가 경고 없이 통과합니다. 옛날 코드와의 호환 때문입니다. 그래서 문자열 리터럴을 가리킬 때는 const char * 로 선언하는 습관이 중요합니다. const 를 붙이면 같은 실수를 컴파일할 때 잡아 줍니다.
    const char *lit = "Hello";
    lit[0] = 'J';
$ gcc -Wall -Wextra -std=c11 -g constlit.c -o constlit
constlit.c: In function ‘main’:
constlit.c:5:12: error: assignment of read-only location ‘*lit’
    5 |     lit[0] = 'J';
      |            ^
“읽기 전용 위치에 대입했다”는 오류입니다. 실행해서 죽는 것보다 컴파일에서 막히는 편이 백배 낫습니다. const 의 자세한 규칙은 8절에서 봅니다.
7.2 포인터로 문자열 훑기
문자열은 끝에 \0 이 있으니, 길이를 몰라도 \0 이 나올 때까지 포인터를 옮기면 됩니다.
#include <stdio.h>

int main(void) {
    const char *str = "Hello, World!";

    while (*str != '\0') {       // 가리키는 글자가 끝 표시가 아닌 동안
        printf("%c", *str);      // 그 글자를 찍고
        str++;                   // 다음 글자로
    }
    printf("\n");
    return 0;
}
Hello, World!
const char *str 인데 str++ 을 해도 될까요? 됩니다. const 가 막는 것은 *str (가리키는 글자)을 바꾸는 것이고, str 자신(어디를 가리키는지)은 옮길 수 있습니다. 8.1에서 정확히 구분합니다.
이 패턴으로 표준 함수 strlen 을 직접 만들 수 있습니다. 4.4의 포인터 뺄셈이 딱 들어맞습니다.
#include <stdio.h>

size_t my_strlen(const char *str) {
    const char *p = str;       // 시작 위치를 기억해 두고
    while (*p != '\0') {       // 끝까지 가서
        p++;
    }
    return p - str;            // 끝 - 시작 = 글자 수
}

int main(void) {
    const char *str = "Hello, World!";
    printf("길이: %zu\n", my_strlen(str));
    return 0;
}
길이: 13
p - str 은 “끝과 시작 사이가 몇 칸인가”입니다. char 한 칸은 1바이트이니 곧 글자 수(바이트 수)입니다. 1주차 6절에서 본 한글 3바이트를 기억하나요? my_strlen("안녕") 은 2가 아니라 6 을 돌려줍니다. strlen 도 마찬가지입니다. C의 문자열 길이는 “글자 수”가 아니라 “\0 앞까지의 바이트 수”입니다.
pointer_string 예제에는 strcpy, strcmp, 문자열 뒤집기도 포인터로 직접 구현돼 있습니다.
=== 직접 구현한 문자열 함수 ===
my_strlen("Hello") = 5
my_strcpy 결과: "Copied string"
my_strcmp("abc", "abd") = -1
my_strcmp("abc", "abc") = 0
my_strcmp("abd", "abc") = 1

=== 문자열 뒤집기 ===
원본: "Hello World"
뒤집기: "dlroW olleH"
strcmp 는 두 문자열이 같으면 0, 앞 문자열이 사전순으로 앞이면 음수, 뒤면 양수를 돌려줍니다. 이 예제는 −1과 1을 돌려주지만, 표준 strcmp 는 “음수”와 “양수”만 약속하므로 결과를 == -1 이 아니라 < 0 으로 검사해야 합니다.
7.3 문자열 배열 — 포인터의 배열
문자열 여러 개를 모을 때는 포인터의 배열을 씁니다.
const char *fruits[] = {"Apple", "Banana", "Cherry", "Date", "Elderberry"};
fruits 는 const char * 다섯 개짜리 배열입니다. 각 원소는 문자열 원본을 가리키는 주소입니다. pointer_string 예제가 그 주소를 찍어 줍니다.
=== 문자열 배열 (포인터 배열) ===
과일 목록:
  1. Apple (주소: 0x5f1ca2fbc4fc)
  2. Banana (주소: 0x5f1ca2fbc502)
  3. Cherry (주소: 0x5f1ca2fbc509)
  4. Date (주소: 0x5f1ca2fbc510)
  5. Elderberry (주소: 0x5f1ca2fbc515)
주소 차이를 계산해 보세요.
| 문자열 | 주소 끝자리 | 다음 주소까지 | 글자 수 + \0 |
|---|---|---|---|
Apple |
4fc |
6 | 5 + 1 = 6 |
Banana |
502 |
7 | 6 + 1 = 7 |
Cherry |
509 |
7 | 6 + 1 = 7 |
Date |
510 |
5 | 4 + 1 = 5 |
문자열 원본들이 읽기 전용 구역에 \0 까지 포함해서 빈틈없이 이어 붙어 있습니다. 주소가 0x5... 로 시작하는 것도 1.1의 regions 실험과 같습니다(지역 변수는 0x7ff... 였죠). 그림으로 그리면 이렇습니다.
 fruits (스택, 8바이트 × 5)            읽기 전용 구역
┌──────────────┐
│ ...4fc  ─────┼──────────────────▶ A p p l e \0
├──────────────┤
│ ...502  ─────┼──────────────────▶ B a n a n a \0
├──────────────┤
│ ...509  ─────┼──────────────────▶ C h e r r y \0
├──────────────┤
│   ...        │
2차원 char 배열(char fruits[5][11])로 만들 수도 있지만, 그러면 가장 긴 "Elderberry" 에 맞춰 모든 칸을 11바이트로 잡아야 합니다. 포인터 배열은 각 문자열이 자기 길이만큼만 차지합니다. 프로그램의 main(int argc, char *argv[]) 가 받는 명령줄 인자 argv 가 바로 이 모양입니다. pointer_string 예제 마지막에 그 흉내가 있고, 7주차에서 진짜 argv 를 다룹니다.
8. const와 포인터
7.1에서 const 가 실수를 컴파일할 때 잡아 주는 것을 봤습니다. 그런데 포인터에는 바꿀 수 있는 것이 두 가지입니다. 가리키는 대상의 값(*p)과, 어디를 가리키는지(p)입니다. const 를 어디에 붙이느냐에 따라 둘 중 무엇을 막는지가 달라집니다.
8.1 const의 위치에 따른 의미
int x = 10, y = 20;

const int *p1 = &x;         // ① 가리키는 값을 못 바꾼다
int *const p2 = &x;         // ② 가리키는 곳을 못 바꾼다
const int *const p3 = &x;   // ③ 둘 다 못 바꾼다
정말 막히는지 해 봅시다.
#include <stdio.h>

int main(void) {
    int x = 10, y = 20;
    const int *p1 = &x;
    int *const p2 = &x;
    *p1 = 30;
    p2 = &y;
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g consterr.c -o consterr
consterr.c: In function ‘main’:
consterr.c:7:9: error: assignment of read-only location ‘*p1’
    7 |     *p1 = 30;
      |         ^
consterr.c:8:8: error: assignment of read-only variable ‘p2’
    8 |     p2 = &y;
      |        ^
consterr.c:6:16: warning: variable ‘p2’ set but not used [-Wunused-but-set-variable]
    6 |     int *const p2 = &x;
      |                ^~
(마지막 경고는 “p2 에 값을 넣기만 하고 쓰지 않았다”는 것으로, 이 실험 코드가 짧아서 생긴 부수적인 경고입니다.)
두 오류 메시지의 차이를 보세요.
*p1 = 30;: “읽기 전용 위치*p1” 에 대입했다.p1이 가리키는 값이 보호됩니다.p2 = &y;: “읽기 전용 변수p2” 에 대입했다.p2자신이 보호됩니다.
반대 방향은 모두 허락됩니다. p1 = &y; (다른 곳을 가리키게)와 *p2 = 30; (가리키는 값 바꾸기)은 문제없습니다. pointer_const 예제가 정리해 둔 표입니다.
┌─────────────────────────┬──────────┬──────────┐
│        선언 형태        │ 값 수정  │포인터 수정│
├─────────────────────────┼──────────┼──────────┤
│ int *ptr                │    O     │    O     │
│ const int *ptr          │    X     │    O     │
│ int *const ptr          │    O     │    X     │
│ const int *const ptr    │    X     │    X     │
└─────────────────────────┴──────────┴──────────┘
한 가지 중요한 점. const int *p1 = &x; 로 막는 것은 p1 을 통해서 바꾸는 것뿐입니다. x 자체는 const 가 아니니 x = 30; 은 여전히 됩니다. const int * 는 “이 포인터로는 안 바꾸겠다”는 약속이지, 대상을 얼리는 것이 아닙니다.
8.2 읽는 방법 — 다시, 오른쪽에서 왼쪽으로
2.1에서 배운 대로 이름에서 출발해 왼쪽으로 읽으면 헷갈리지 않습니다.
const int * p1        p1 은 → 포인터(*)인데 → int 를 가리키고 → 그 int 는 const
                      "읽기 전용 int 를 가리키는 포인터"      → *p1 을 못 바꿈

int * const p2        p2 는 → const 인데 → 포인터(*)이고 → int 를 가리킨다
                      "int 를 가리키는 읽기 전용 포인터"      → p2 를 못 바꿈

const int * const p3  p3 는 → const 포인터이고 → 읽기 전용 int 를 가리킨다
                                                              → 둘 다 못 바꿈
요령은 const 가 * 의 왼쪽이면 값, 오른쪽이면 포인터입니다. 참고로 const int *p 와 int const *p 는 완전히 같은 뜻입니다(const 가 둘 다 * 왼쪽).
8.3 함수 매개변수에서 const — 가장 흔한 쓰임
실무에서 const 가 가장 많이 쓰이는 곳은 함수 매개변수입니다.
void print_array(const int *arr, int size) {
    for (int i = 0; i < size; i++) {
        printf("%d ", arr[i]);
        // arr[i] = 0;   // 오류! const 로 보호됨
    }
}
const int *arr 은 호출하는 사람에게 보내는 약속입니다. “이 함수는 당신의 배열을 읽기만 하고 절대 바꾸지 않는다.” 6.5에서 봤듯 배열은 주소로 넘어가서 함수가 원본을 바꿀 수 있으니, 이 약속이 있으면 안심하고 넘길 수 있습니다. 함수를 만드는 사람이 실수로 바꾸려 하면 컴파일러가 막아 줍니다.
표준 라이브러리도 이 규칙을 따릅니다. size_t strlen(const char *s); 는 문자열을 읽기만 하니 const 이고, char *strcpy(char *dest, const char *src); 는 src 는 읽기만, dest 는 쓰기 때문에 const 가 없습니다. 선언만 봐도 무엇을 읽고 무엇을 쓰는지 알 수 있는 것이죠. 7.2의 my_strlen(const char *str) 에 const 를 붙인 이유도 이것입니다.
9. void 포인터
지금까지의 포인터는 모두 “무엇을 가리키는지”가 정해져 있었습니다. 그런데 가끔 무엇이든 가리킬 수 있는 포인터가 필요합니다. int 배열이든 double 배열이든 가리지 않고 복사하는 함수 같은 것 말이죠. 그것이 void * 입니다.
9.1 void 포인터란?
void * 는 “타입이 정해지지 않은 주소”입니다. 어떤 포인터든 담을 수 있습니다.
int x = 10;
double y = 3.14;
char c = 'A';

void *vp;
vp = &x;   // int * 를 담고
vp = &y;   // double * 도 담고
vp = &c;   // char * 도 담는다
pointer_void 예제는 모든 포인터의 크기가 같다는 것도 보여 줍니다.
=== void 포인터 크기 ===
sizeof(void *) = 8
sizeof(int *) = 8
sizeof(double *) = 8
sizeof(char *) = 8
주소는 주소일 뿐이니, 가리키는 대상이 무엇이든 8바이트입니다. 그래서 어떤 포인터든 void * 에 담을 수 있습니다. 2.3에서 %p 에 넘길 때 (void *) 로 바꿨던 것도 이 “범용 주소” 타입으로 맞춘 것입니다.
9.2 void 포인터 사용 시 주의 — 역참조할 수 없다
대신 대가가 있습니다. 2.1에서 “포인터 타입은 몇 바이트를 어떻게 읽을지 정한다”고 했습니다. void * 는 그 정보를 버렸으니 역참조할 수 없습니다.
    int x = 42;
    void *vp = &x;
    printf("%d\n", *vp);
$ gcc -Wall -Wextra -std=c11 -g voidderef.c -o voidderef
voidderef.c: In function ‘main’:
voidderef.c:6:20: warning: dereferencing ‘void *’ pointer
    6 |     printf("%d\n", *vp);
      |                    ^~~
voidderef.c:6:20: error: invalid use of void expression
“void * 를 역참조했다”, “void 식을 잘못 썼다”는 오류입니다. 몇 바이트를 읽어야 할지 모르니까요. 값을 꺼내려면 원래 타입으로 되돌려야 합니다.
printf("%d\n", *(int *)vp); // vp 를 int * 로 바꾼 뒤 역참조 → 42
(int *)vp 는 “vp 를 int 를 가리키는 포인터로 보라”는 형 변환이고, 그 앞의 * 가 역참조입니다. 여기서 원래 타입을 정확히 알고 있어야 한다는 게 핵심입니다. double 을 가리키던 void * 를 int * 로 바꿔 읽으면 컴파일러는 막지 않고, 10.5에서 보는 엉뚱한 값이 나옵니다. void * 는 타입 검사를 끄는 것이라, 책임이 프로그래머에게 넘어옵니다.
void * 에는 산술도 표준에 없습니다. vp + 1 이 몇 바이트 뒤인지 정할 수 없으니까요. GCC는 확장 기능으로 1바이트씩 움직이게 해 주는데, 1주차에서 배운 -Wpedantic 을 켜면 경고합니다.
$ gcc -Wall -Wextra -Wpedantic -std=c11 vparith.c -o vparith
vparith.c:6:21: warning: pointer of type ‘void *’ used in arithmetic [-Wpointer-arith]
    6 |     void *next = vp + 1;
      |                     ^
바이트 단위로 움직이고 싶으면 4.4처럼 char * 로 바꿔서 계산하는 것이 표준 방법입니다.
9.3 void 포인터의 활용 — 타입을 가리지 않는 함수
void * 가 빛나는 곳은 어떤 타입이든 다루는 함수입니다. pointer_void 예제의 generic_swap 은 6.3의 swap 을 모든 타입용으로 만든 것입니다.
#include <string.h>

void generic_swap(void *a, void *b, size_t size) {
    char temp[size];            // size 바이트짜리 임시 공간
    memcpy(temp, a, size);      // a 의 size 바이트를 temp 로 복사
    memcpy(a, b, size);
    memcpy(b, temp, size);
}
void * 는 몇 바이트인지 모르니, 크기를 따로 받습니다(size). memcpy 는 string.h 의 표준 함수로, “이 주소에서 저 주소로 n 바이트를 그대로 복사하라”는 뜻입니다. 타입을 해석하지 않고 바이트만 옮기니 어떤 타입에도 쓸 수 있습니다.
=== 제네릭 swap 함수 ===
int 교환 전: a=10, b=20
int 교환 후: a=20, b=10

double 교환 전: d1=1.5, d2=2.5
double 교환 후: d1=2.5, d2=1.5

char 교환 전: c1='X', c2='Y'
char 교환 후: c1='Y', c2='X'
호출은 generic_swap(&a, &b, sizeof(int)) 처럼 합니다. int * 인 &a 가 void * 매개변수로 자동 변환되어 들어갑니다. C에서는 어떤 포인터든 void * 로, void * 는 다시 어떤 포인터로든 형 변환 없이 대입할 수 있습니다.
char temp[size];처럼 크기를 변수로 정하는 배열을 가변 길이 배열(VLA) 이라고 합니다. C99에서 들어왔지만 C11부터는 컴파일러가 지원하지 않아도 되는 선택 기능이 됐습니다. GCC는 지원합니다. 7주차에서 배울malloc으로 공간을 잡는 것이 더 일반적인 방법입니다.
표준 라이브러리의 memcpy, memset, 정렬 함수 qsort, 7주차의 malloc 이 모두 void * 로 이런 일을 합니다. 7주차에 qsort 를 쓸 때 오늘 배운 것이 그대로 나옵니다.
10. 포인터 사용 시 주의사항
포인터 버그가 무서운 이유는 바로 티가 나지 않는 경우가 많기 때문입니다. 2.5의 NULL 역참조처럼 즉시 죽어 주면 오히려 고맙습니다. 이 절에서는 대표적인 함정을 하나씩 일부러 일으켜서, 컴파일러가 무엇을 경고하고, 실행하면 어떻게 되고, 어떤 도구로 잡을 수 있는지 봅니다.
| 함정 | 컴파일러 경고 | 실행하면 | 잡는 도구 |
|---|---|---|---|
| 10.1 초기화 안 한 포인터 | -Wuninitialized |
멀쩡히 돌 수도 있음 | 경고, Valgrind |
| 10.2 댕글링 포인터 | -Wreturn-local-addr, -Wdangling-pointer |
죽거나, 멀쩡해 보임 | 경고, ASan |
| 10.3 배열 범위 초과 | 대개 없음 | 쓰레기 값, 조용함 | ASan, Valgrind |
| 10.4 NULL 역참조 | 대개 없음 | 즉시 세그멘테이션 오류 | gdb |
| 10.5 타입 불일치 | -Wincompatible-pointer-types |
엉뚱한 값 | 경고 |
10.1 초기화하지 않은 포인터 (Wild Pointer)
#include <stdio.h>

int main(void) {
    int *p;
    *p = 10;
    printf("*p = %d\n", *p);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g wild.c -o wild
wild.c: In function ‘main’:
wild.c:5:8: warning: ‘p’ is used uninitialized [-Wuninitialized]
    5 |     *p = 10;
      |     ~~~^~~~
wild.c:4:10: note: ‘p’ was declared here
    4 |     int *p;
      |          ^
$ ./wild
*p = 10
$ echo $?
0
죽지 않았습니다. 오히려 제대로 동작한 것처럼 *p = 10 을 찍고 정상 종료(0)했습니다. 이것이 초기화하지 않은 포인터가 NULL 보다 훨씬 위험한 이유입니다. p 에는 그 자리에 우연히 남아 있던 값이 들어 있고, 이번에는 그 값이 우연히 쓸 수 있는 메모리의 주소였습니다. 그래서 어딘가 다른 변수의 자리에 10을 써 버렸을 수 있습니다. 코드를 조금만 고쳐도, 다른 컴퓨터에서 돌려도, 최적화 옵션을 바꿔도 결과가 달라질 수 있습니다. 1주차에서 “경고는 지금은 돌아가지만 언젠가 사고가 날 곳”이라고 한 것의 가장 전형적인 예입니다.
컴파일러 경고를 못 봤다면 Valgrind 가 잡아 줍니다. 1주차에 설치한, 메모리를 잘못 쓰는 곳을 찾아 주는 검사기입니다.
$ valgrind -q ./wild
==2484640== Use of uninitialised value of size 8
==2484640==    at 0x109159: main (wild.c:5)
==2484640==
==2484640== Use of uninitialised value of size 8
==2484640==    at 0x109163: main (wild.c:6)
==2484640==
*p = 10
-q 는 요약 없이 문제만 보여 달라는 옵션입니다. “초기화되지 않은 8바이트 값을 썼다”며 5번째와 6번째 줄을 짚습니다. 8바이트, 즉 포인터 p 자체가 초기화되지 않았다는 뜻입니다. 앞의 ==2484640== 은 프로그램의 프로세스 번호입니다. Valgrind는 7주차 동적 메모리에서 매일 쓰게 됩니다.
예방: 선언할 때 반드시 초기화합니다. int *p = NULL; 또는 int *p = &x;.
10.2 댕글링 포인터 (Dangling Pointer)
한때는 유효했지만 가리키던 대상이 사라진 포인터입니다. 가장 흔한 경우는 함수가 자기 지역 변수의 주소를 돌려줄 때입니다.
#include <stdio.h>

int *make_value(void) {
    int local = 42;
    return &local;
}

int main(void) {
    int *p = make_value();
    printf("p = %p\n", (void *)p);
    printf("*p = %d\n", *p);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g retlocal.c -o retlocal
retlocal.c: In function ‘make_value’:
retlocal.c:5:12: warning: function returns address of local variable [-Wreturn-local-addr]
    5 |     return &local;
      |            ^~~~~~
$ ./retlocal
p = (nil)
세그멘테이션 오류 (코어 덤프됨)
GCC가 “함수가 지역 변수의 주소를 돌려준다”고 경고합니다. 지역 변수 local 은 make_value 가 끝나는 순간 사라지기 때문입니다. 그 자리는 다음에 부르는 함수가 재사용합니다.
그런데 실행 결과가 흥미롭습니다. p 가 (nil), 즉 NULL 입니다. 분명 &local 을 돌려줬는데요? GCC가 이 코드를 보고 “어차피 쓸 수 없는 주소”라고 판단해서, 일부러 NULL 을 돌려주도록 바꿔 버린 것입니다. 1주차 7절처럼 objdump 로 make_value 의 기계어를 보면 확인할 수 있습니다.
$ objdump -d retlocal | grep -A10 "<make_value>:"
...
    1184:   c7 45 f4 2a 00 00 00    movl   $0x2a,-0xc(%rbp)
    118b:   b8 00 00 00 00          mov    $0x0,%eax
...
movl $0x2a 는 local = 42 (0x2a = 42)이고, 그다음 줄에서 돌려줄 값을 담는 eax 에 주소가 아니라 0 을 넣습니다. 1주차 7절에서 “돌려줄 값은 eax 에 넣는다”고 했던 바로 그 자리입니다. 조용히 엉뚱한 값을 읽게 두느니 2.5처럼 확실하게 죽게 만드는 쪽이 낫다는 판단입니다. 다른 컴파일러나 다른 버전은 이렇게 해 주지 않을 수도 있으니, 이 동작에 기대면 안 됩니다. 경고를 고치는 것이 답입니다.
중괄호 블록을 벗어나도 같은 일이 생깁니다.
    int *p = NULL;
    {
        int x = 10;
        p = &x;
    }               // 여기서 x 가 사라짐
    *p = 20;
$ gcc -Wall -Wextra -std=c11 -g scope.c -o scope
scope.c:9:8: warning: using dangling pointer ‘p’ to ‘x’ [-Wdangling-pointer=]
    9 |     *p = 20;
      |     ~~~^~~~
scope.c:6:13: note: ‘x’ declared here
    6 |         int x = 10;
      |             ^
...
$ ./scope
*p = 20
GCC 12부터 들어온 경고로 “x 를 가리키는 댕글링 포인터 p 를 쓴다”고 정확히 짚어 줍니다. 그리고 이번에는 죽지 않고 20 을 찍었습니다. 사라진 x 의 자리를 아직 아무도 쓰지 않았을 뿐입니다. 10.1과 같은 “우연히 돌아가는” 코드입니다.
예방: 지역 변수의 주소를 함수 밖으로 내보내지 않습니다. 함수가 결과를 돌려줘야 한다면 6.4처럼 호출하는 쪽이 공간을 마련해서 주소를 넘기거나, 7주차의 malloc 으로 함수가 끝나도 사라지지 않는 공간을 씁니다.
10.3 배열 범위 초과
#include <stdio.h>

int main(void) {
    int arr[5] = {1, 2, 3, 4, 5};
    int *p = arr;
    printf("arr[4] = %d\n", p[4]);
    printf("arr[5] = %d\n", p[5]);
    printf("arr[10] = %d\n", p[10]);
    return 0;
}
$ gcc -Wall -Wextra -std=c11 -g oob.c -o oob
$ ./oob
arr[4] = 5
arr[5] = 32767
arr[10] = 1061331402
경고도 없고, 죽지도 않습니다. 게다가 한 번 더 실행하면 arr[5] = 32765, arr[10] = 952279498 처럼 매번 다른 값이 나옵니다. arr[5] 와 arr[10] 은 배열 밖인데, C는 5.2의 공식대로 *(p + 5) 번지를 계산해서 거기 있는 4바이트를 정수로 읽어 줄 뿐입니다. 그 자리에 무엇이 있었는지는 아무도 모릅니다. 읽기만 해도 틀린 값이고, 쓰기까지 하면 다른 변수를 망가뜨립니다. C가 범위 검사를 하지 않는 이유는 속도 때문입니다. 매번 검사하면 느려지니, 그 책임을 프로그래머에게 맡긴 것입니다.
이런 버그를 잡는 강력한 도구가 GCC에 들어 있습니다. AddressSanitizer(ASan) 입니다. 컴파일할 때 -fsanitize=address 만 붙이면 됩니다.
$ gcc -Wall -Wextra -std=c11 -g -fsanitize=address oob.c -o oob
$ ./oob
arr[4] = 5
=================================================================
==2488607==ERROR: AddressSanitizer: stack-buffer-overflow on address 0x74c966e00034 at pc 0x55dda06ee4c0 bp 0x7ffc928431c0 sp 0x7ffc928431b0
READ of size 4 at 0x74c966e00034 thread T0
    #0 0x55dda06ee4bf in main .../oob.c:7
    ...
  This frame has 1 object(s):
    [32, 52) 'arr' (line 4) <== Memory access at offset 52 overflows this variable
(경로와 뒷부분 일부를 줄였습니다.) arr[4] 는 통과하고, arr[5] 를 읽는 7번째 줄에서 멈췄습니다. 메시지를 읽어 봅시다.
stack-buffer-overflow: 스택(지역 변수 구역)에 있는 배열을 넘어섰다.READ of size 4: 4바이트(int하나)를 읽으려 했다.[32, 52) 'arr' (line 4): 4번째 줄의arr은 32~52 바이트 위치(20바이트)를 차지하는데,<== Memory access at offset 52 overflows this variable52번째 바이트, 즉 딱 한 칸 넘어서 접근했다.
어느 변수를, 몇 바이트, 어디서 넘었는지 전부 알려 줍니다. ASan은 프로그램을 느리게 만들어서 배포할 때는 빼지만, 개발하고 테스트할 때는 켜 두는 것이 좋습니다. 24주차 보안 프로그래밍에서 다시 만납니다.
예방: 배열 크기를 함께 넘기고(6.5), 반복문의 조건을 i < size 로 씁니다. i <= size 는 가장 흔한 한 칸 초과 실수입니다.
10.4 NULL 포인터 역참조
2.5에서 직접 해 봤습니다. 즉시 세그멘테이션 오류가 나고, 3.5처럼 gdb 로 위치를 찾을 수 있습니다. NULL 이 될 수 있는 포인터는 쓰기 전에 확인합니다.
if (p != NULL) {
    *p = 10;
}
pointer_dangers 예제에 이 패턴이 들어 있습니다.
올바른 방법 - NULL 체크:
if (p != NULL) {
    *p = 10;  // 안전하게 사용
}

안전한 역참조: *ptr = 42
10.5 타입 불일치 — 3.14159 가 -266631570 이 되는 이유
2.4에서 경고만 보고 넘어간 실수를 끝까지 따라가 봅시다. pointer_dangers 예제에는 double 을 int * 로 읽는 코드가 있습니다.
double d = 3.14159;
int *ip = (int *)&d;      // 형 변환으로 경고를 억지로 막음
printf("%d", *ip);
실제 결과: *wrong_ptr = -266631570 (쓰레기 값)
올바른 값: d = 3.141590
쓰레기 값이라고 적혀 있지만, 사실 이 값은 쓰레기가 아니라 정확히 계산된 값입니다. memory_viewer 를 실행하면 double d = 3.14159 의 바이트가 이렇게 나옵니다.
│ 바이트: 6E 86 1B F0 F9 21 09 40 │
int * 로 읽으면 앞 4바이트 6E 86 1B F0 만 읽습니다. 작은 자리부터 저장돼 있으니 거꾸로 읽으면 0xF01B866E 이고, 맨 앞 비트가 1이라 int 로는 음수가 되어 계산하면 −266,631,570 입니다. 메모리의 바이트는 그대로인데, 어떤 타입의 눈으로 읽느냐에 따라 3.14159 가 되기도 하고 −266631570 이 되기도 합니다. 2.1에서 “포인터 타입이 해석 방법을 정한다”고 한 것의 가장 극적인 예입니다.
실수를 이런 바이트로 저장하는 규칙을 IEEE 754 라고 합니다. 궁금하면 memory_viewer 의 코드를 고쳐서 1.0, 2.0, 0.5 같은 값의 바이트를 찍어 보세요. 규칙이 보이기 시작할 겁니다.
형 변환 (int *) 은 컴파일러에게 “내가 책임질 테니 경고하지 마”라고 말하는 것입니다. 그러니 형 변환은 정말로 그 타입이 맞다고 확신할 때만 씁니다. 9.2의 void * 를 되돌릴 때처럼요.
11. 실전 예제
지금까지의 조각들이 실제 코드에서 어떻게 맞물리는지 봅시다. 네 예제 모두 이번 주에 배운 것만 씁니다.
11.1 배열에서 최소값/최대값 찾기
6.4의 “여러 값 반환”과 8.3의 const 가 함께 나옵니다.
#include <stdio.h>

void find_min_max(const int *arr, int size, int *min, int *max) {
    *min = *max = arr[0];

    for (int i = 1; i < size; i++) {
        if (arr[i] < *min) *min = arr[i];
        if (arr[i] > *max) *max = arr[i];
    }
}

int main(void) {
    int numbers[] = {34, 12, 78, 56, 23, 89, 45};
    int size = sizeof(numbers) / sizeof(numbers[0]);
    int min, max;

    find_min_max(numbers, size, &min, &max);

    printf("최소값: %d\n", min);
    printf("최대값: %d\n", max);
    return 0;
}
최소값: 12
최대값: 89
매개변수의 역할을 선언만으로 읽어 보세요. const int *arr 은 “읽기만 할 입력”, int *min, int *max 는 “결과를 써 넣을 출력”입니다. const 의 유무가 곧 입력과 출력의 표시입니다.
*min = *max = arr[0]; 은 대입이 오른쪽부터 묶이는 것을 이용해 두 곳에 한 번에 넣는 표현입니다. *max = arr[0] 을 먼저 하고 그 값을 *min 에도 넣습니다.
실험:
size에 0을 넘기면 어떻게 될까요? 첫 줄의arr[0]이 빈 배열의 0번째를 읽습니다. 10.3의 범위 초과입니다. 함수 맨 앞에if (size <= 0) return;을 넣어 막아 보고, 이때 호출한 쪽의min,max에는 무엇이 남는지도 생각해 보세요(6.4의 주의점).
11.2 문자열 길이 계산 (포인터 버전)
7.2에서 만든 my_strlen 입니다. 표준 strlen 과 결과를 비교해 보면 같다는 것을 확인할 수 있습니다.
#include <stdio.h>

size_t my_strlen(const char *str) {
    const char *p = str;

    while (*p != '\0') {
        p++;
    }

    return p - str;
}

int main(void) {
    const char *str = "Hello, World!";
    printf("길이: %zu\n", my_strlen(str));
    return 0;
}
길이: 13
11.3 배열 뒤집기 (포인터 버전)
양 끝에서 두 포인터가 가운데로 모여드는 패턴입니다. 4.5의 포인터 비교와 6.3의 swap 이 합쳐졌습니다.
#include <stdio.h>

void reverse_array(int *arr, int size) {
    int *left = arr;                  // 맨 앞
    int *right = arr + size - 1;      // 맨 뒤 (arr + size 는 끝 바로 다음)

    while (left < right) {            // 두 포인터가 만나기 전까지
        int temp = *left;
        *left = *right;
        *right = temp;

        left++;                       // 앞은 뒤로
        right--;                      // 뒤는 앞으로
    }
}

int main(void) {
    int arr[] = {1, 2, 3, 4, 5};
    int size = sizeof(arr) / sizeof(arr[0]);

    printf("원본: ");
    for (int i = 0; i < size; i++) printf("%d ", arr[i]);
    printf("\n");

    reverse_array(arr, size);

    printf("뒤집기: ");
    for (int i = 0; i < size; i++) printf("%d ", arr[i]);
    printf("\n");
    return 0;
}
원본: 1 2 3 4 5
뒤집기: 5 4 3 2 1
진행을 따라가 보면 이렇습니다.
| 단계 | left |
right |
바꾼 뒤 배열 |
|---|---|---|---|
| 1 | arr[0] (1) |
arr[4] (5) |
5 2 3 4 1 |
| 2 | arr[1] (2) |
arr[3] (4) |
5 4 3 2 1 |
| 3 | arr[2] |
arr[2] |
left < right 가 거짓 → 끝 |
원소가 홀수 개면 가운데(arr[2])는 자기 자리에 그대로 둡니다. 조건이 left < right 라서 두 포인터가 같은 칸에서 만나면 멈추기 때문입니다. 조건을 left != right 로 쓰면 어떻게 될까요? 원소가 짝수 개일 때 두 포인터가 서로 엇갈려 지나가서 영원히 같아지지 않고 배열 밖으로 달려 나갑니다. 4.5에서 < 비교를 배운 이유입니다.
11.4 포인터로 구조체 접근 (미리보기)
8주차에 배울 구조체를 살짝 앞당겨 봅니다. 여러 값을 하나로 묶은 구조체도 포인터로 넘길 수 있고, 그때 -> 라는 새 연산자를 씁니다.
#include <stdio.h>

struct Point {
    int x;
    int y;
};

void move_point(struct Point *p, int dx, int dy) {
    p->x += dx;      // (*p).x 와 같다
    p->y += dy;
}

int main(void) {
    struct Point pt = {10, 20};

    printf("이동 전: (%d, %d)\n", pt.x, pt.y);
    move_point(&pt, 5, -3);
    printf("이동 후: (%d, %d)\n", pt.x, pt.y);
    return 0;
}
이동 전: (10, 20)
이동 후: (15, 17)
p->x 는 (*p).x, “p 가 가리키는 구조체의 x”를 줄여 쓴 것입니다. 모양은 새롭지만 6.2의 add_ten_ptr 과 똑같은 원리입니다. 구조체 하나가 수백 바이트가 되기도 하니, 1.3의 표에서 말한 “큰 데이터는 주소만 넘긴다”가 8주차부터 본격적으로 쓰입니다.
12. 포인터 디버깅 도구 정리
이번 주에 쓴 도구를 한곳에 모읍니다. 증상에 따라 골라 쓰세요.
| 증상 | 먼저 쓸 도구 | 명령 |
|---|---|---|
| 값이 이상하다, 어디서 바뀌는지 모르겠다 | printf 로 주소와 값 찍기 |
printf("%p %d\n", (void *)p, *p); |
| 세그멘테이션 오류로 죽는다 | gdb |
gdb ./프로그램 → run → bt → print p |
| 가끔만 이상하다, 멀쩡히 돌 때도 있다 | Valgrind | valgrind ./프로그램 |
| 배열을 넘어서는 것 같다 | AddressSanitizer | gcc -g -fsanitize=address ... |
| 무엇보다 먼저 | 컴파일러 경고 | gcc -Wall -Wextra ... 로 경고 0개 |
12.1 printf 로 주소 확인
가장 단순하지만 여전히 강력합니다. 포인터를 쓰는 곳마다 네 가지를 찍어 보면 대부분의 착각이 드러납니다.
printf("x 의 주소 : %p\n", (void *)&x);
printf("p 의 값   : %p\n", (void *)p);     // &x 와 같아야 한다
printf("p 의 주소 : %p\n", (void *)&p);    // 이것은 다른 게 정상
printf("*p 의 값  : %d\n", *p);
3.6에서 봤듯 메시지 끝에 \n 을 붙이세요. 줄바꿈이 없으면 프로그램이 죽을 때 마지막 메시지가 사라질 수 있습니다.
12.2 GDB
3.5에서 자세히 봤습니다. 핵심 순서만 다시 적습니다.
$ gcc -Wall -Wextra -std=c11 -g program.c -o program    # -g 필수
$ gdb -q ./program
(gdb) break main          # main 에서 멈추기 (줄 번호도 됨)
(gdb) run
(gdb) next                # 한 줄씩
(gdb) print p             # 포인터의 값
(gdb) print *p            # 가리키는 값
(gdb) print &x            # 변수의 주소
(gdb) x/4xb p             # p 가 가리키는 곳의 바이트 4개
(gdb) bt                  # 죽었을 때 어디서
(gdb) quit
12.3 Valgrind 와 AddressSanitizer
둘 다 메모리를 잘못 쓰는 곳을 찾지만 방식이 다릅니다.
| Valgrind | AddressSanitizer | |
|---|---|---|
| 쓰는 법 | 다시 컴파일할 필요 없이 valgrind ./prog |
-fsanitize=address 로 다시 컴파일 |
| 속도 | 아주 느림 (수십 배) | 조금 느림 (2배 안팎) |
| 잘 잡는 것 | 초기화 안 한 값(10.1), 메모리 누수(7주차) | 범위 초과(10.3), 해제 후 사용 |
두 도구를 동시에 쓸 수는 없습니다. 보통은 ASan 을 켜고 개발하다가, 초기화 문제나 누수가 의심될 때 Valgrind 를 씁니다. 7주차에 malloc 과 free 를 배우면 둘 다 매일 쓰게 됩니다.
13. 정리
이번 주의 핵심을 한 문단으로 줄이면 이렇습니다. 포인터는 주소를 담는 변수입니다. & 로 주소를 얻어 담고, * 로 그 주소를 찾아가 값을 읽거나 씁니다. 포인터의 타입은 “그 주소에서 몇 바이트를 어떤 방식으로 읽을지”를 정합니다. 이 한 가지로 5주차의 swap 이 동작하고, 2주차 scanf 의 & 가 설명되고, 배열은 arr[i] ≡ *(arr + i) 라는 정체를 드러냅니다.
그리고 이번 주에 여러 번 확인했듯, 포인터 버그는 죽어 주면 다행입니다. 초기화 안 한 포인터, 댕글링 포인터, 범위 초과는 멀쩡히 돌아가는 척합니다. 그래서 컴파일러 경고와 도구가 중요합니다.
핵심 개념
| 개념 | 뜻 | 확인한 곳 |
|---|---|---|
| 주소 | 메모리 칸의 번호. 실행마다 바뀜(ASLR) | 1.1, 2.3 |
| 포인터 | 주소를 값으로 담는 변수. 64비트에서 8바이트 | 1.2, 3.5 (x/8xb &p) |
&x |
x 의 주소 | 2.3 |
*p |
p 가 가리키는 것 (역참조) | 3.1 |
NULL |
아무것도 안 가리킴(0번지). 역참조하면 즉시 죽음 | 2.5 |
p + n |
n × sizeof(*p) 바이트 뒤 |
4.1, 4.3 |
p2 - p1 |
두 포인터 사이의 원소 개수 (ptrdiff_t, %td) |
4.4 |
| 감쇠 | 배열 이름이 첫 원소의 주소로 바뀌는 것 | 5 |
const int *p / int *const p |
값을 못 바꿈 / 가리키는 곳을 못 바꿈 | 8 |
void * |
타입 없는 주소. 역참조·산술 불가, 되돌려서 씀 | 9 |
포인터와 배열 관계
int arr[5];
int *p = arr;

arr[i]    ≡  *(arr + i)  ≡  p[i]   ≡  *(p + i)
&arr[i]   ≡  arr + i     ≡  &p[i]  ≡  p + i

// 다른 점
sizeof(arr) == 20,  sizeof(p) == 8
arr++  →  오류 (lvalue 아님),  p++  →  OK
arr + 1 → +4 바이트,  &arr + 1 → +20 바이트
함수와 포인터
void func(int x);          // 값 전달: 복사본. 원본은 못 바꿈
void func(int *p);         // 주소 전달: 주소의 복사본. *p 로 원본을 바꿈
void func(const int *p);   // 읽기 전용 주소 전달: 원본을 안 바꾼다는 약속
void func(int arr[]);      // 배열 전달: 실제로는 int *. 크기는 따로 넘김
주의사항 체크리스트
- □ 포인터를 선언할 때 초기화했는가? (
NULL또는 유효한 주소) - □ NULL 일 수 있는 포인터를 역참조하기 전에 확인했는가?
- □ 반복문 조건이
i < size인가? (<=아님) - □ 지역 변수의 주소를 함수 밖으로 내보내지 않았는가?
- □ 두 포인터가 같은 곳을 가리킬 수 있는 경우를 생각했는가? (6.3)
- □ 읽기만 하는 포인터 매개변수에
const를 붙였는가? - □ 형 변환으로 경고를 막고 있지는 않은가?
- □
-Wall -Wextra로 컴파일해서 경고 0개인가?
연습 문제
각 문제는 gcc -Wall -Wextra -std=c11 -g 로 경고 없이 컴파일되고, -fsanitize=address 로 돌렸을 때도 오류가 없어야 합니다.
기초
- 두 정수를 맞바꾸는
swap을 작성하세요.swap(&x, &x)처럼 같은 변수를 두 번 넘겨도 값이 그대로여야 합니다(6.3의 함정). - 배열의 모든 원소를 2배로 만드는 함수를 인덱스(
arr[i]) 없이 포인터 산술만으로 작성하세요. int x = 0x11223344;의 바이트를unsigned char *로 하나씩 찍어서, 우리 컴퓨터가 리틀 엔디언인지 직접 확인하세요.gdb의x/4xb &x결과와도 비교해 보세요.
중급
- 배열에서 특정 값을 찾아 그 원소의 주소를 돌려주는 함수를 작성하세요. 못 찾으면
NULL을 돌려주고, 호출하는 쪽에서 NULL 을 확인하도록 하세요. 찾은 주소에서 배열 시작 주소를 빼면 인덱스가 되는지도 확인하세요(4.4). - 문자열을 제자리에서 뒤집는 함수
void reverse(char *s)를 포인터 두 개로 작성하세요(11.3 참고).char s[] = "Hello";로는 잘 되는데char *s = "Hello";로 넘기면 어떻게 되는지, 왜 그런지 설명하세요(7.1). find_min_max(11.1)를 고쳐서, 배열이 비어 있으면(크기 0) 실패를 알릴 수 있게 만드세요. 성공/실패는 반환값(int)으로, 결과는 출력용 매개변수로 돌려주세요.
심화
- 정렬된 배열에서 이진 탐색을 포인터 두 개(
low,high) 로 구현하세요. 가운데 포인터는low + (high - low) / 2로 구합니다. 왜(low + high) / 2는 안 되는지 생각해 보세요(힌트: 포인터끼리는 더할 수 없습니다). - 9.3의
generic_swap을 이용해, 어떤 타입의 배열이든 뒤집는void generic_reverse(void *arr, size_t count, size_t size)를 작성하세요.int배열과double배열 모두로 시험하세요(9.2:void *산술 대신char *로 계산). - 문자열에서 특정 문자를 모두 제거하는 함수
void remove_char(char *s, char c)를 읽는 포인터와 쓰는 포인터 두 개로 한 번만 훑어서 작성하세요.
다음 주 예고
이번 주에 포인터의 기초를 다졌습니다. 다음 주에는 포인터가 진짜 힘을 발휘하는 곳으로 갑니다.
7주차: 포인터 심화
- 이번 주 3.5에서
gdb가&p의 타입을int **라고 했습니다. 포인터를 가리키는 포인터는 어디에 쓸까요? - 함수에도 주소가 있었습니다(1.1의
main주소). 그럼 함수를 가리키는 포인터로 함수를 골라 부를 수 있을까요? - 10.2에서 “지역 변수는 함수가 끝나면 사라진다”고 했습니다. 함수가 끝나도 사라지지 않는 메모리는 어떻게 얻을까요? (
malloc,free) - 그 메모리를 돌려주는 걸 잊으면 무슨 일이 생길까요? Valgrind 가 다시 등장합니다.
예제 코드
이 글의 예제는 저장소의 week06/ 폴더에 있습니다. make 로 한 번에 빌드하면 build/examples/, build/projects/ 에 실행 파일이 생깁니다.
$ cd week06
$ make            # 전부 빌드
$ make help       # 쓸 수 있는 명령 보기
$ ./build/examples/pointer_basic
examples/:
pointer_basic.c– 포인터 기초, 변수와 포인터의 주소, NULLpointer_address.c–&와*, 여러 변수의 주소 간격pointer_arithmetic.c– 포인터 덧셈·뺄셈·비교,*p++류pointer_array.c– 배열과 포인터의 같은 점과 다른 점, 2차원 배열pointer_function.c– 값 전달과 주소 전달, 배열 넘기기, 여러 값 반환pointer_swap.c–swap과 그 변형들pointer_string.c– 문자 배열과 문자열 포인터, 직접 만든 문자열 함수pointer_const.c–const의 위치에 따른 의미pointer_void.c–void *와 타입을 가리지 않는 함수pointer_dangers.c– 포인터 함정 모음
projects/:
array_utils.c– 배열 통계·검색·뒤집기·회전·정렬 함수 모음string_utils.c– 문자열 대소문자 변환·trim·검색·회문 검사 함수 모음memory_viewer.c– 변수의 주소와 바이트를 직접 보여 주는 메모리 시각화 도구 (1.1)pointer_quiz.c– 포인터 이해도 퀴즈. 학습 모드(2번)는 문제와 해설을 함께 보여 줍니다